
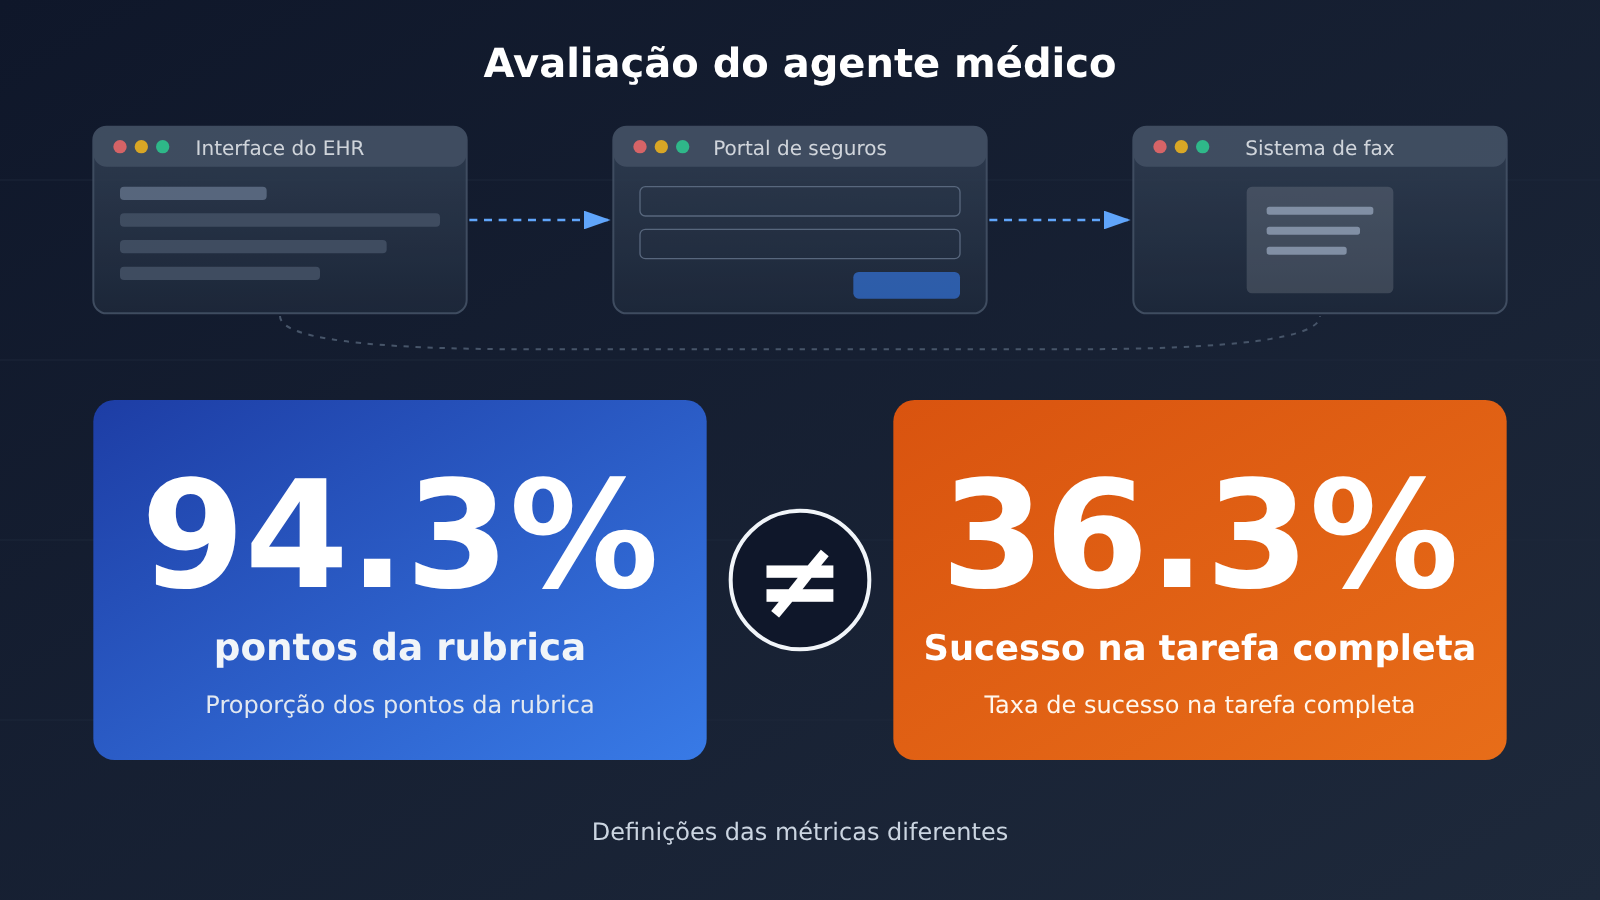
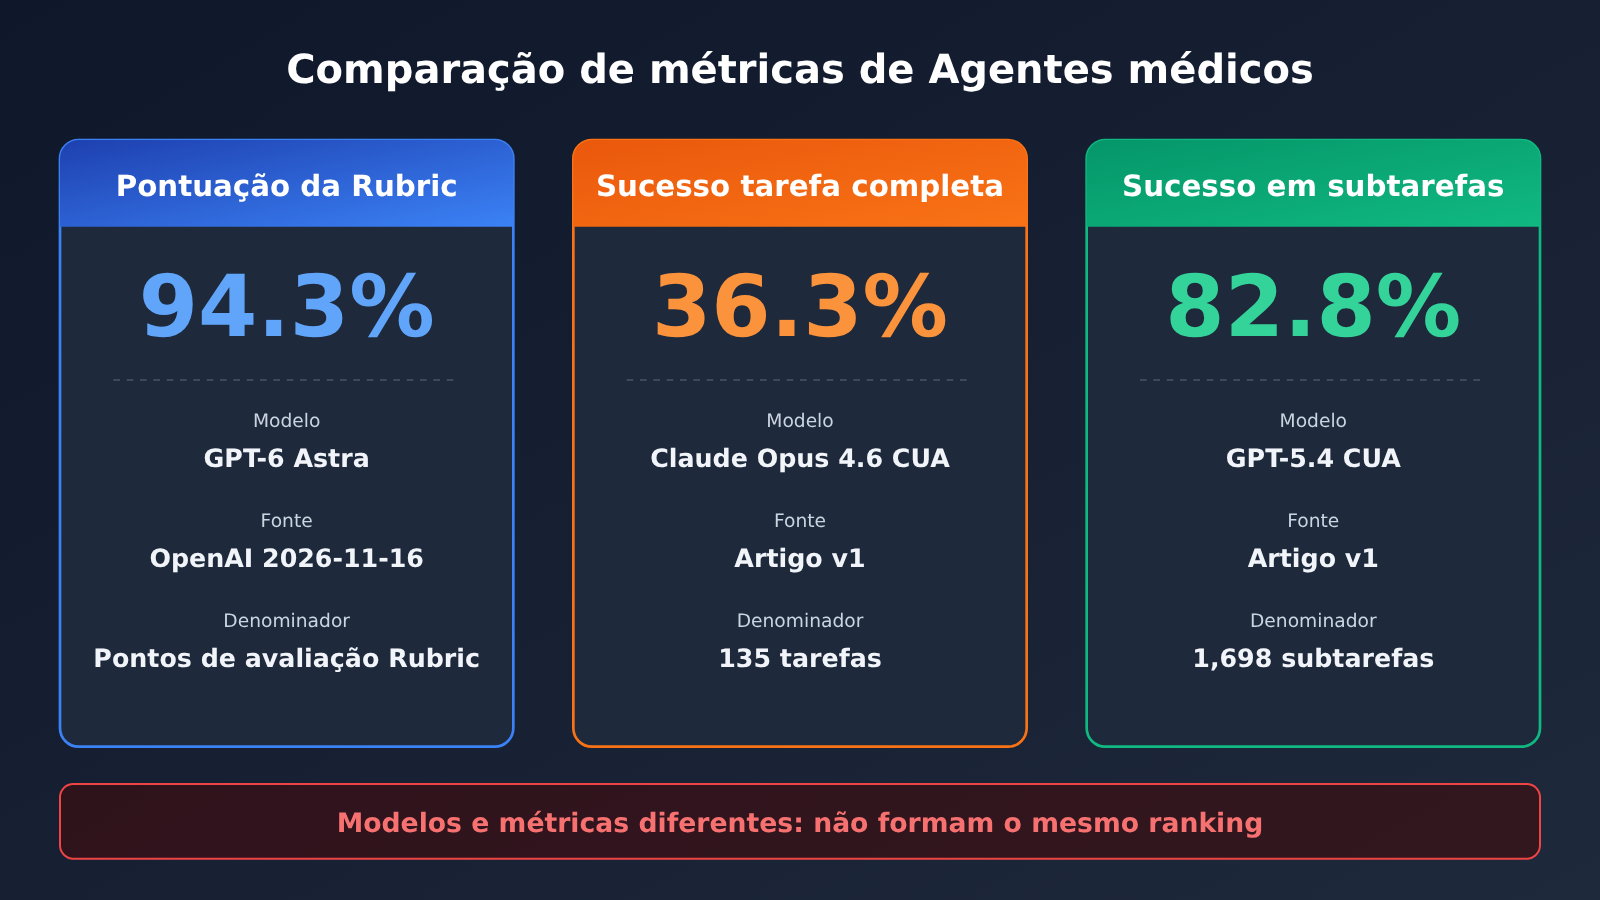
94.3% não significa que 94.3% das tarefas administrativas médicas foram concluídas por completo. Os 94.3% do GPT-6 Astra, divulgados pela OpenAI em 16 de novembro de 2026, são a proporção de acertos em rubric points (pontos de avaliação) do HealthAdminBench; já os 36.3% do Claude Opus 4.6 CUA, no artigo do Shah Lab de Stanford, são a taxa de sucesso em tarefas completas (full-task success). O primeiro mede “quantos pontos de avaliação foram atendidos”; o segundo mede “quantas tarefas cumpriram todas as condições de sucesso”. Não são a mesma métrica e não podem entrar na mesma lista de ranking.
Um agente médico pode ter um desempenho excelente em operações isoladas como busca de informações, processamento de documentos e preenchimento de formulários, e ainda assim não conseguir percorrer de forma estável um processo de negócio que atravessa vários sistemas. Para julgar se um agente tem valor em produção, é preciso olhar ao mesmo tempo para o desempenho em subtarefas, a taxa de sucesso ponta a ponta, os tipos de erro, o custo de execução e o nível de intervenção humana. Qualquer número isolado não basta.
O que você vai encontrar neste artigo?
- O que os 94.3% e os 36.3% medem, respectivamente, e por que não dá para compará-los diretamente
- Como o HealthAdminBench é composto, de onde vêm os pontos de avaliação e quais são os dois mecanismos de validação
- Um conjunto de dimensões de avaliação voltado para produção e transferível para agentes de outras empresas
Índice: a parte de fatos objetivos explica, em ordem, por que o resultado de 94.3% chamou atenção, o que o HealthAdminBench realmente mede, a diferença entre sucesso em subtarefas e sucesso em tarefas completas, os pontos em que agentes médicos mais falham e por que o mesmo modelo pode ter desempenho diferente dependendo do arcabouço de execução; a parte de análise e julgamento discute como construir um framework de avaliação abrangente, como calcular custos e como as empresas devem fazer escolhas na prática.
Para saber: entendendo os 7 conceitos da avaliação de agentes médicos
| Conceito | Explicação breve |
|---|---|
| Computer Use | Capacidade de concluir tarefas observando a interface do software e simulando cliques, digitação, rolagem e outras operações |
| EHR | Sistema de registro eletrônico de saúde, o software central usado pelos hospitais para armazenar informações clínicas dos pacientes |
| MCP | Protocolo padrão para descobrir e invocar ferramentas externas |
| RPA | Forma de automação que executa processos repetitivos por meio de regras ou scripts previamente configurados |
| Rubric points | Pontos de rubrica obtidos de acordo com as regras de avaliação, usados para medir o cumprimento de requisitos parciais |
| Taxa de sucesso ponta a ponta | Proporção de tarefas completas que atendem a todas as condições de sucesso; se qualquer condição crítica falhar, a tarefa é considerada falha |
| Trace | Evidência de trajetória que registra o processo de execução, as ações realizadas e o estado da interface |
Visão rápida dos impactos da avaliação de agentes médicos
- Desenvolvedores e líderes técnicos: não basta usar uma única pontuação divulgada pelo fornecedor para escolher a solução. É preciso validar, nas próprias tarefas, o mecanismo de execução, a taxa de conclusão ponta a ponta e o custo completo, incluindo capturas de tela, novas tentativas e ambiente de execução.
- Instituições de saúde e responsáveis por fluxos de trabalho: é preciso distinguir quatro tipos de evidência — demonstrações em ambiente sintético, avaliações de benchmark, pilotos institucionais e casos em produção — e, durante a implantação, implementar aprovação humana, privilégio mínimo e auditoria de operações.
Fatos objetivos: por trás dos 94.3% e 36.3% nas avaliações de agentes médicos
Por que o resultado de 94.3% chamou atenção?
Em 16 de novembro de 2026, a OpenAI apresentou avanços em agentes de operação de computador voltados a equipes médicas e divulgou vários conjuntos de dados de avaliação. Entre eles, o GPT-6 Astra obteve 94.3% no HealthAdminBench, e o GPT-6 Luna, 91.8%; ambos foram avaliados com esforço máximo de raciocínio (maximum reasoning effort). A OpenAI também informou que o custo por tarefa do Luna é de US$ 0.085, 98% menor que o do Astra.
Esses números chamam atenção porque os resultados do HealthAdminBench divulgados anteriormente por Stanford eram bem mais baixos. Vale destacar que os 94.3% e 91.8% divulgados pela OpenAI são proporções de pontos de rubrica (rubric points), e não taxas independentes de sucesso em tarefas completas. Os demais dados do mesmo anúncio também vêm de etapas de avaliação diferentes, com denominadores distintos:
| Métrica | Valor | Denominador/critério | O que não significa |
|---|---|---|---|
| Pontuação no HealthAdminBench (Astra) | 94.3% | proporção de pontos de rubrica | taxa de sucesso em tarefas completas |
| Pontuação no HealthAdminBench (Luna) | 91.8% | proporção de pontos de rubrica | taxa de sucesso em tarefas completas |
| Segurança em tarefas clínicas (Astra) | 99% | 325 tarefas auditadas | precisão de diagnóstico médico |
| Proporção de avaliações médicas com alta aprovação (Astra) | 93% | 646 avaliações feitas por médicos | taxa de sucesso das tarefas; também não equivale a 646 médicos |
| Custo por tarefa do Luna | $0.085 | custo por tarefa sob condições específicas de avaliação | preço para implantação em produção |
Esses três conjuntos de dados têm denominadores diferentes e não podem ser combinados em uma única “taxa de precisão global”. Além disso, o texto do anúncio da OpenAI não divulgou resultados por tarefa, a configuração experimental completa, intervalos de confiança nem todos os casos de falha; no momento, não é possível verificar de forma independente como a pontuação de 94.3% foi composta. O custo por tarefa do Astra é de cerca de US$ 4.25; esse valor é uma estimativa inferida a partir da redução de 98%, e não um preço divulgado diretamente pela empresa.
O que o HealthAdminBench mede, afinal?
O HealthAdminBench foi proposto pelo Shah Lab da Universidade de Stanford e serve especificamente para avaliar o desempenho de Agentes de operação de computador em tarefas administrativas médicas. A versão pública passou por mudanças: a descrição inicial na página do estudo falava em 70 tarefas, 947 pontos de avaliação e 6 Agentes; já a versão 2604.09937v1 do artigo expande para 135 tarefas, 1.698 subtarefas verificáveis e 7 configurações de modelos. Este texto toma como base a versão do artigo, usando os dados iniciais da página apenas como comparação histórica.
Os quatro ambientes GUI simulados da versão do artigo são o EHR, o portal de pagamento de seguro A, o portal de pagamento de seguro B e o portal de fax. As 135 tarefas se dividem em três tipos de fluxo de trabalho administrativo:
| Tipo de tarefa | Quantidade | Conteúdo principal |
|---|---|---|
| Prior Authorization (autorização prévia) | 60 | Verificação de elegibilidade do seguro, coleta de prontuário médico, envio da solicitação de autorização prévia |
| Appeals and Denials Management (apelações e gestão de negativas) | 60 | Revisão das negativas, coleta de evidências, preparação e envio da apelação |
| DME Order Processing (pedidos de equipamentos médicos) | 15 | Coleta de documentação dos equipamentos médicos, envio do pedido, registro dos resultados |
Os 1.698 pontos de avaliação surgem de dois mecanismos. 1.177 usam verificações determinísticas, conferindo o estado do sistema por meios estruturados como JMESPath — por exemplo, se o paciente correto foi localizado, se os campos indicados foram preenchidos, se o pedido correto foi gerado; a lógica é parecida com a de testes de software tradicionais. Os outros 521 ficam por conta do LLM Judge, que avalia principalmente se o conteúdo dos documentos é suficiente e se os materiais enviados atendem aos requisitos, partes difíceis de validar diretamente com regras.
Todas as tarefas usam dados sintéticos de pacientes, e não registros reais. Isso significa que o benchmark oferece um ambiente de teste reproduzível: ele não testa em sistemas de produção de hospitais reais, nem mede diretamente os resultados do cuidado ao paciente.
Qual é a diferença entre o sucesso de uma subtarefa e o sucesso da tarefa completa?
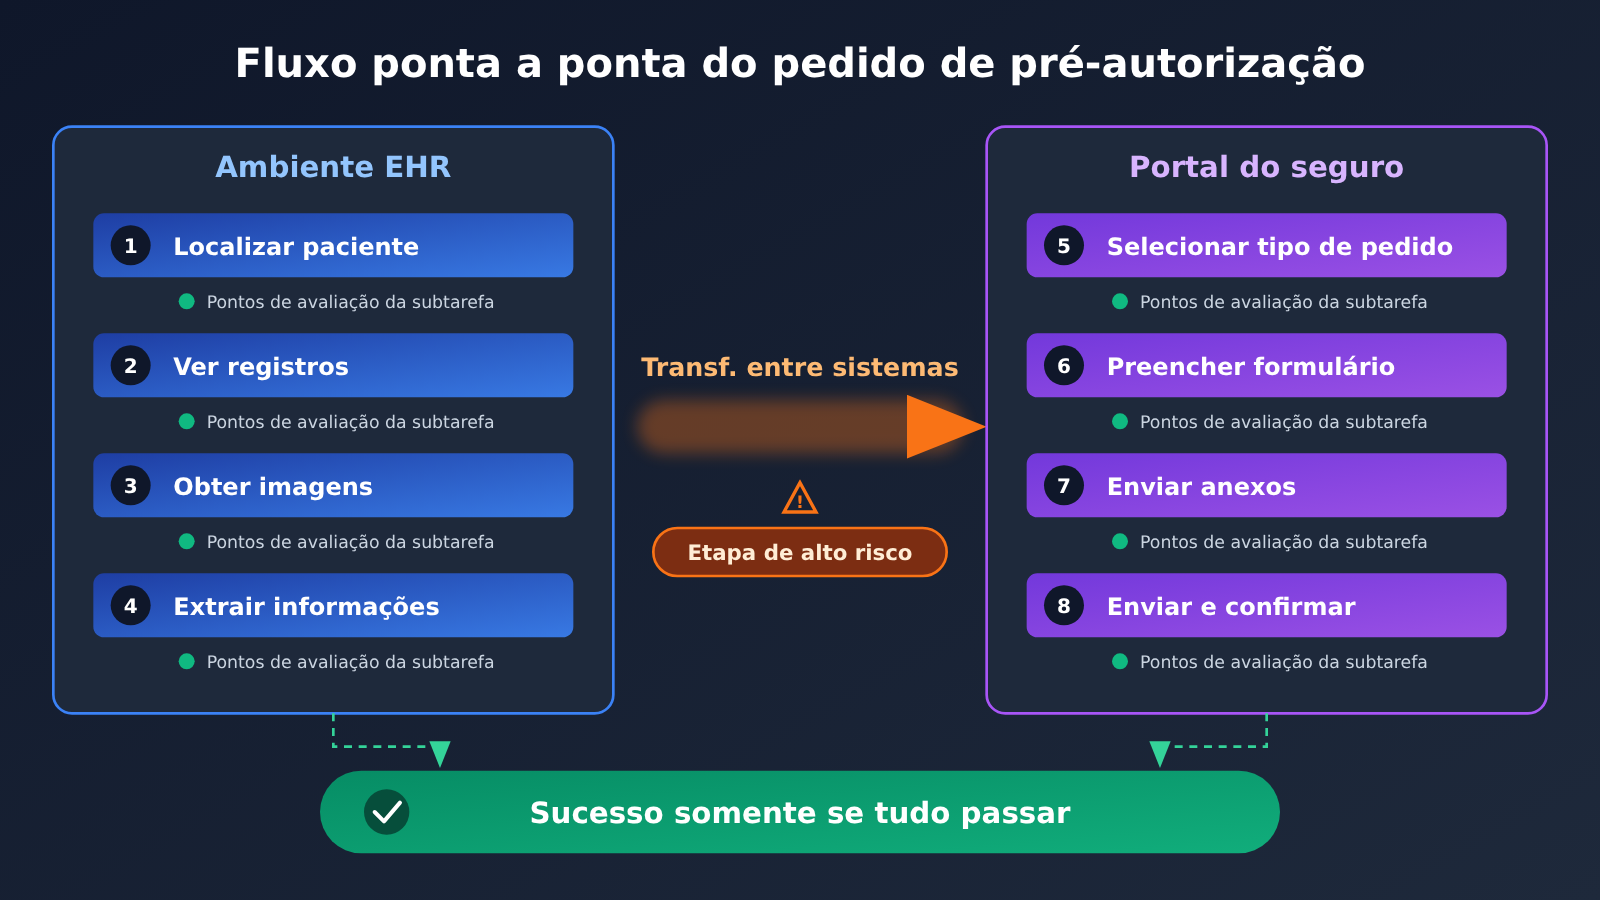
A forma mais fácil de enxergar a diferença é usar um fluxo de solicitação de pré-autorização. Segundo a descrição dos materiais de pesquisa, uma tarefa de pré-autorização pode exigir que o Agent realize, em sequência:
- Encontrar o paciente correto no EHR
- Consultar o histórico clínico do paciente
- Localizar exames de imagem e materiais de tratamentos anteriores
- Determinar quais comprovantes são necessários para a solicitação ao plano de saúde
- Extrair as informações necessárias do prontuário médico
- Acessar o portal de pagamento do plano de saúde
- Selecionar o tipo correto de solicitação
- Preencher o formulário de solicitação
- Anexar os documentos exigidos
- Enviar a solicitação e confirmar o status
Existe uma forte dependência entre esses dez passos. Se você errar o paciente no passo 1, cada passo seguinte estará errado por mais bem executado que seja; se os nove primeiros passos estiverem todos corretos, mas no passo 9 faltar um anexo ou no passo 10 a solicitação não for realmente enviada, a tarefa inteira ainda será considerada um fracasso. A taxa de sucesso de subtarefas mede “quantos dos dez passos foram feitos corretamente”, enquanto a taxa de sucesso de tarefas completas mede “se todos os dez passos foram feitos corretamente”.
Os dados apresentados no artigo deixam essa disparidade clara: o GPT-5.4 CUA tem uma taxa de sucesso de subtarefas de 82,8%, enquanto o Claude Opus 4.6 CUA tem uma taxa de sucesso de tarefas completas de 36,3%. Esses dois números pertencem a modelos diferentes e, da mesma forma, não podem ser comparados diretamente, mas juntos evidenciam um fato: concluir ações locais e concluir todo um processo de negócio são duas habilidades distintas.
Uma página de pesquisas anteriores também relatou uma disparidade semelhante: a melhor taxa de sucesso de tarefas completas do Claude Opus 4.5 foi de 22,9%, e a taxa de sucesso de subtarefas do Gemini 3 foi de 76,4%. Como a escala das tarefas e as versões são diferentes, esses números servem apenas para observar tendências e não podem ser colocados no mesmo ranking que a versão do artigo ou os resultados da OpenAI.
Em quais etapas um agente médico tem mais chance de falhar?
O artigo divulga os resultados de duas configurações de CUA por subcategoria de tarefa:
| Subcategoria da tarefa | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Recuperação de informações | 96.5% | 96.1% |
| Elaboração de documentos | 74.3% | 84.4% |
| Preenchimento de formulários | 88.9% | 84.9% |
| Resolução de tarefas | 70.7% | 66.2% |
| Processamento de documentos | 92.3% | 94.3% |
| Raciocínio clínico | 61.3% | 77.0% |
Um alerta importante: os 94.3% do GPT-5.4 CUA em processamento de documentos na tabela são apenas uma coincidência numérica com os 94.3% de pontos de rubrica (rubric points) gerais do GPT-6 Astra divulgados pela OpenAI; os modelos, as métricas e as fontes são completamente diferentes.
Olhando por subcategoria, a recuperação de informações já está perto da saturação, enquanto raciocínio clínico, resolução de tarefas e elaboração de documentos ainda estão relativamente fracos. O artigo também aponta que o processamento de documentos (Document Handling) e a transferência de dados entre sistemas (Cross-system Data Transfer) são os principais problemas que causam falhas de ponta a ponta. Uma versão anterior da página chegou a relatar que cinco dos seis modelos tinham acurácia abaixo de 20% na subtarefa de processamento de documentos, mas isso pertence a uma configuração de tarefa de outra versão e não pode ser comparado diretamente com a tabela acima.
Por que a transferência entre sistemas erra com tanta facilidade? No fluxo de pré-autorização, a mesma informação precisa ser lida do EHR, armazenada no contexto do agente e depois gravada em outra estrutura de formulário no portal da operadora de saúde; os anexos também podem circular pelo portal de fax. Cada transferência é uma chance de erro, e um erro a montante é copiado exatamente para o sistema a jusante. Entre os riscos listados nos materiais da OpenAI, também estão “propagar informações erradas de um sistema para outro” e “relatar incorretamente a conclusão da tarefa quando o estado do sistema não está claro”.
Por que o mesmo modelo pode se comportar de forma diferente dependendo do framework de execução?
O artigo realizou experimentos de ablação sobre os modos de comando e de observação, com três descobertas principais:
- O fornecimento do Portal Guidance (orientação para operação do portal) geralmente apresenta resultados melhores do que oferecer apenas a descrição da tarefa
- O modo de observação baseado na Accessibility Tree (árvore de acessibilidade) geralmente é superior ao modo de observação por captura de tela pura
- Quando a orientação para operação do portal é combinada com informações estruturadas da página, o desempenho de ponta a ponta costuma ser melhor
O artigo também aponta que ambientes de produção reais nem sempre conseguem fornecer uma Accessibility Tree completa. Em outras palavras, o desempenho do Agent não depende apenas do modelo subjacente, mas também do framework de execução (Harness), do modo de observação da página, do comando e da descrição da tarefa.
A documentação para desenvolvedores da OpenAI também reflete diferenças no caminho de execução. O guia oficial descreve separadamente o ComputerToolset, o BrowserToolset e a entrada de navegador hospedado; para o GPT-6 Astra, a documentação atual recomenda a abordagem Code Execution, ou seja, o modelo gera código como Playwright para operar a interface, enquanto a Computer Tool permanece como opção. A documentação também enfatiza que o modelo gerar instruções de operação não significa que a operação já tenha sido bem-sucedida: a aplicação precisa executá-las e depois verificar o resultado por meio de uma nova captura de tela ou de outro método.
Já o CUA Agent Kit (Apache-2.0), open source da CVS Health, oferece outra abordagem de engenharia. O mecanismo divulgado em seu README é o seguinte: primeiro, um Computer-use Agent explora o fluxo de trabalho e salva capturas de tela, ações e Trace como evidências; em seguida, o Codex Skill consolida a trajetória bem-sucedida em código determinístico, que passa por revisão de engenheiros; execuções determinísticas posteriores não precisam de chave do modelo. Isso separa “descobrir como fazer” e “fazer de forma estável e repetível” em dois problemas distintos.
分析与判断:如何评价一个真正可用的医疗 Agent
如何评价一个真正可用的 Agent?
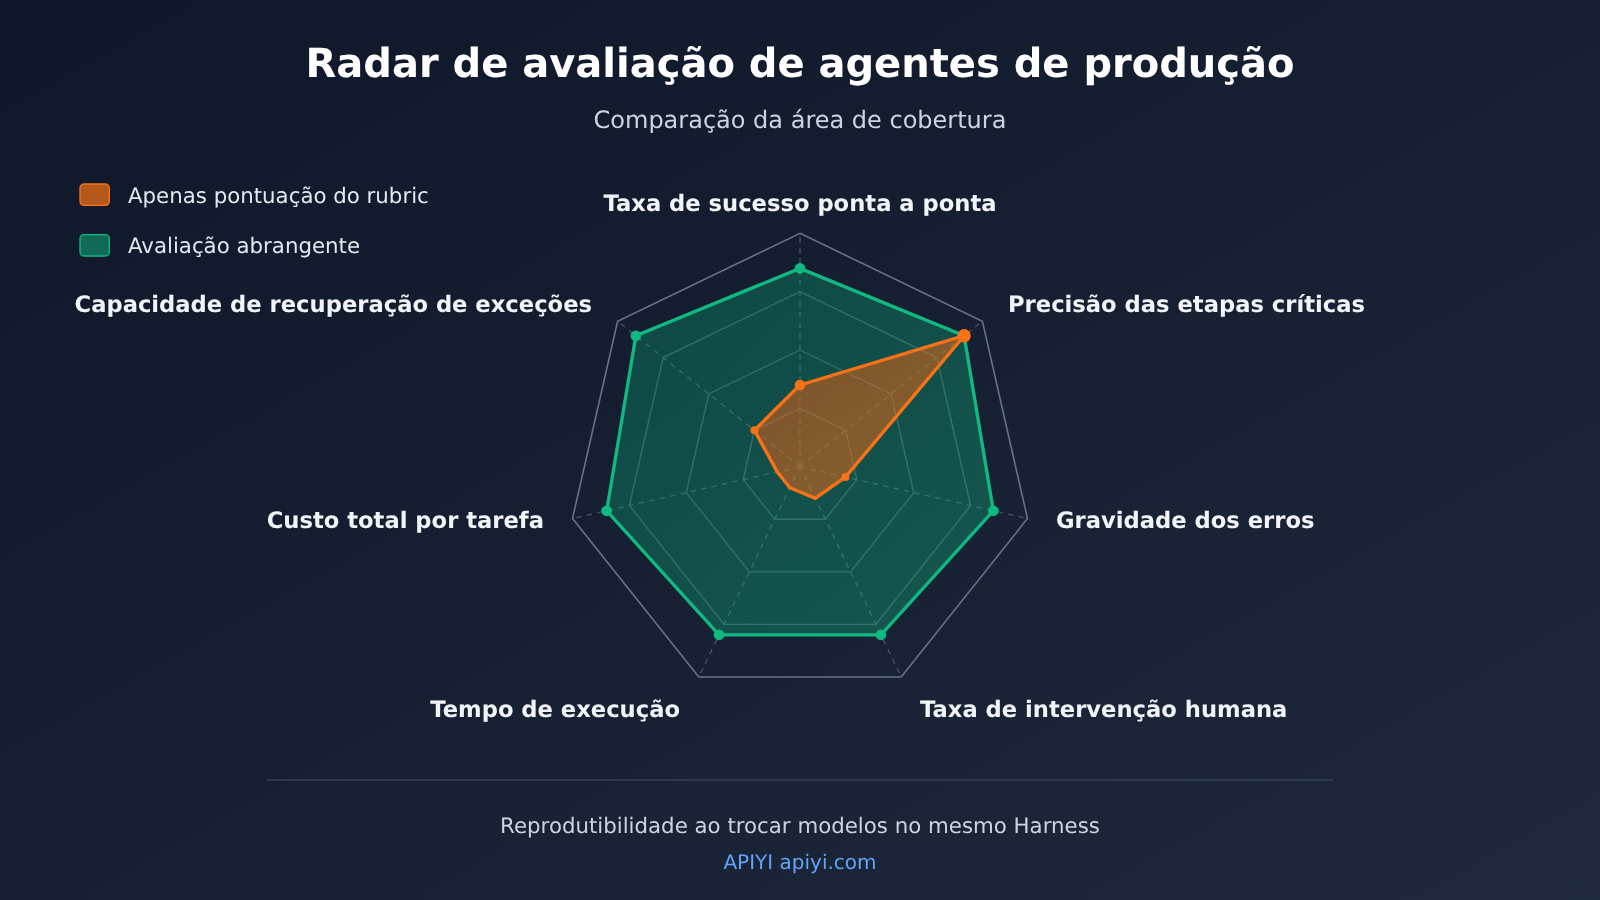
以下是本文的判断,不代表任何机构的官方标准。我们认为,94.3% 这类评分项分数(rubric points)适合回答“模型局部能力进步了多少”,但不足以回答“它能不能放进生产流程”。后一个问题需要一组相互制约的指标:
| 评价维度 | 衡量什么 | 为什么需要 | 数据来源 |
|---|---|---|---|
| 端到端成功率 | 完整任务全部满足成功条件的比例 | 业务只认最终结果 | 系统最终状态校验 |
| 关键步骤准确性 | 选择患者、提交、上传附件等关键节点的正确率 | 关键步骤一旦出错就会全盘失败 | 确定性检查 |
| 错误严重程度 | 失败是可恢复的遗漏,还是写错数据、错发消息 | 同样是失败率,风险差异巨大 | 人工复核 + 分级标签 |
| 人工介入率 | 需要人工接管或审批修正的比例 | 决定实际节省的人力 | 审批日志 |
| 执行时间 | 单任务耗时与长尾耗时 | 影响吞吐与排队 | Trace 时间戳 |
| 单任务完整成本 | 模型、截图、重试、运行环境、维护的总和 | Token 单价无法代表真实成本 | 账单 + 运行记录 |
| 异常恢复能力 | 遇到歧义、超时、页面变化时能否停止或回退 | 医疗场景必须“会停” | 故障注入测试 |
这套框架的核心,是把“做对了多少步”和“做成了多少件事”分开报告,再用错误严重程度和人工介入率修正两者。Ambience 展示的方案正好体现了“异常恢复”这一维度:当病历存在歧义时,Agent 停下来询问医生,并在医生批准后才提交预授权申请。这只是该公司展示的治理方案,并不意味着所有医疗 Agent 默认具备相同配置。
样本量和重复次数同样要公开。一项比较 RPA 与 Agent 的研究(DOI: 10.1080/23311975.2026.2724760)在 P2、P3 两个流程上对每种技术各执行 10 次,但在 P1 上 Agent 仅执行 1 次且失败,未纳入后续统计;该研究使用的是 2025 年的工具配置,不能当作 2026 年模型的直接成绩。这个例子说明,读评测结论时要先看每个数字背后跑了几次、哪些结果被排除。
Abordagem prática para avaliação de Agents médicos: rodar você mesmo no mesmo Harness
Para times de desenvolvimento, a abordagem mais prática é fixar o framework de execução e, no seu próprio conjunto de tarefas, medir ao mesmo tempo as duas métricas: subtarefas e ponta a ponta. O exemplo abaixo usa um LLM Judge para pontuar o material entregue pelo Agent — a interface é compatível com o OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada APIYI, permite alternar entre diferentes modelos de juiz
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Ver a implementação completa: cálculo simultâneo da taxa de sucesso de subtarefas e da taxa de sucesso ponta a ponta
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # Se é uma etapa crítica (falha nela = falha da tarefa inteira)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # Já inclui tokens de retry, não some novamente

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """Usa LLM Judge para subtarefas difíceis de avaliar por regras"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Recomendação técnica: o ideal é reportar a pontuação de subtarefas e a taxa de sucesso ponta a ponta lado a lado, no mesmo Harness e no mesmo lote de tarefas. Com a interface compatível com OpenAI da APIYI apiyi.com, você pode usar uma única chave API para alternar entre OpenAI, Claude, Gemini e outros modelos — seja o modelo de execução, seja o modelo juiz — reduzindo as variáveis causadas por formas diferentes de integração.
Custo de agentes médicos e estratificação de modelos
O preço unitário por token é apenas o ponto de partida. Segundo os preços Standard de contexto curto divulgados pela OpenAI em 17 de novembro de 2026, GPT-6 Astra tem entrada, saída e entrada em cache de US$ 10, US$ 50 e US$ 1 por milhão de tokens, respectivamente; GPT-6 Luna custa US$ 0,10, US$ 0,50 e US$ 0,01; a velocidade de processamento, o comprimento do contexto e a região geográfica afetam a cobrança real. O Computer Use envolve invocações de várias rodadas, e cada captura de tela conta como entrada visual, então, na hora de calcular, você deve contabilizar separadamente a entrada visual/textual e a saída cobrada de cada rodada, além de ferramentas, ambiente de execução e manutenção de engenharia; se os tokens consumidos em novas tentativas já estiverem incluídos no total, não os adicione novamente.
Olhando para a diferença entre US$ 0,085 e cerca de US$ 4,25, a estratificação de modelos provavelmente se tornará a norma: tarefas complexas que exigem raciocínio forte ficam com os modelos de alta capacidade; tarefas muito estruturadas e de alta frequência ficam com os modelos de baixo custo; e fluxos fixos já validados acabam se cristalizando em código determinístico, como a abordagem da CVS. Vale destacar que esses custos por tarefa vêm de condições de benchmark específicas e não podem ser usados como orçamento de produção.
💰 Otimização de custos: antes de definir a estratificação, recomenda-se primeiro medir, com um pequeno lote de tarefas reais, a taxa de sucesso de ponta a ponta e o custo completo por tarefa de cada modelo. A APIYI apiyi.com cobra por uso, novos usuários têm cota gratuita de teste, o que é ideal para realizar esse tipo de experimento comparativo com baixo custo na fase de iniciação do projeto.
Do Agente de Saúde ao Agente Corporativo: Uma Abordagem de Avaliação Transferível
A particularidade da administração em saúde está no alto risco e na forte regulação, mas os problemas que ela expõe também existem em processos corporativos como sinistros de seguros, conciliação financeira e documentos da cadeia de suprimentos: múltiplos sistemas, dependências fortes e movimentação de dados entre sistemas. Nossa avaliação é que as quatro diretrizes a seguir podem ser transferidas diretamente:
- Separe o relatório: a pontuação das subtarefas e a taxa de sucesso ponta a ponta ficam em colunas distintas, e jamais se usa a primeira para substituir a segunda
- Rotule o nível de evidência: demonstração em ambiente sintético, autoavaliação do fornecedor, benchmark de terceiros, piloto corporativo e casos de produção pertencem a categorias separadas, sem misturá-las
- Fixe o Harness antes de comparar: assim que o método de observação, os comandos e as orientações do portal mudam, as pontuações deixam de ser comparáveis
- Governança antes da pontuação: privilégio mínimo, aprovação humana para ações críticas, verificação de estado após a operação, rastreamento completo (Trace) e mecanismos de parada em caso de anomalia devem ser itens de aceitação antes do lançamento
Ao fazer um PoC dentro da empresa, é possível rotular o conjunto de tarefas por “etapas críticas”, obter primeiro uma linha de base ponta a ponta e depois introduzir gradualmente orientações do portal, observação estruturada ou solidificação em código, observando a contribuição real de cada mudança para a taxa de sucesso completa. Se for necessário reproduzir rapidamente o mesmo lote de tarefas entre vários modelos, é possível usar o acesso unificado via APIYI apiyi.com, reduzindo o custo de engenharia da comparação horizontal.
Desenvolvimentos futuros que merecem atenção contínua incluem: se a OpenAI vai divulgar os resultados tarefa por tarefa e as configurações experimentais por trás dos 94.3%; se as versões subsequentes do HealthAdminBench vão publicar a taxa de sucesso completa dos novos modelos sob o mesmo critério; e se mais instituições conseguirão divulgar dados sobre a taxa de intervenção humana e a classificação de erros em ambientes reais de produção. Até que essas informações apareçam, qualquer afirmação de que “a administração em saúde já pode ser totalmente automatizada” é especulação.
Os 94.3% comprovam o progresso significativo do modelo nos pontos de avaliação, enquanto os 36.3% lembram que: se um processo de negócio pode ser concluído de forma confiável precisa, em última análise, ser verificado em tarefas completas, sistemas reais e supervisão humana. Como diz o provérbio em inglês: “The proof of the pudding is in the eating.” (O pudim se prova ao comer; o efeito real se comprova na prática.)
Referências
- OpenAI: Advancing computer-use agents for healthcare teams: dados de avaliação e casos de parceria como 94.3%, 91.8%, 99% e 93%
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Link:
- Artigo HealthAdminBench 2604.09937v1: 135 tarefas, 1,698 subtarefas, resultados por subitem e experimentos de ablação
- Link:
arxiv.org/html/2604.09937v1
- Link:
- Página do projeto e repositório de código do HealthAdminBench: ambiente de benchmark e implementação da avaliação
- Link:
som-shahlab.github.io/health-admin-bench-website/ - Link:
github.com/som-shahlab/health-admin-bench
- Link:
- Página de pesquisa inicial do Stanford Shah Lab: versão histórica com 70 tarefas e 947 pontos de avaliação
- Link:
shahlab.stanford.edu/doku.php?id=healthadminbench
- Link:
- Documentação para desenvolvedores e preços da API do OpenAI Computer Use: caminho de execução e preço Standard
- Link:
developers.openai.com/api/docs/guides/tools-computer-use - Link:
developers.openai.com/api/docs/pricing
- Link:
- CVS Health CUA Agent Kit: mecanismos de exploração, evidência, consolidação de código e revisão por engenheiros
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Estudo comparativo entre RPA e Agent: contagem de execuções repetidas e explicação da exceção P1
- Link:
doi.org/10.1080/23311975.2026.2724760
- Link:
- Cambridge Dictionary: definição do provérbio proof of the pudding is in the eating
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: convidamos você a visitar a APIYI em apiyi.com para trocar ideias conosco sobre práticas de avaliação de Agent. Mais instruções de integração estão disponíveis no centro de documentação docs.apiyi.com.


