
Nota do autor: uma análise do 6º lugar do Qwen4-Max no ranking Code Arena WebDev: o cenário do top 6, as diferenças internas entre os modelos chineses, a distância de pontuação em relação aos modelos líderes e como interpretar corretamente votos e custo por tarefa.
Vamos direto à conclusão: no ranking Code Arena WebDev do arena.ai (categoria Overall, com data indicada na página: 2026-11-14), Qwen4-Max (xHigh) ocupa o 6º lugar com 1750 pontos. É a primeira vez que um modelo chinês entra no top 6 deste ranking, e também o único modelo de um laboratório não americano entre os seis primeiros.
Isto não é um texto promocional tentando vender o 6º lugar como se fosse o 1º. O Qwen4-Max aparece no ranking com a marcação Preliminary, tem apenas 1.814 votos e sua posição ainda pode mudar. No mesmo gráfico oficial da Alibaba, ele ainda está claramente atrás de Opus 5.5 e GPT-6 Astra no Terminal-Bench e no ProgramBench.
Valor central: ao terminar este artigo, você terá em mãos um conjunto de metadados do ranking que pode abrir e conferir por conta própria, e vai entender como usar — e como não usar — o 6º lugar do Qwen4-Max.
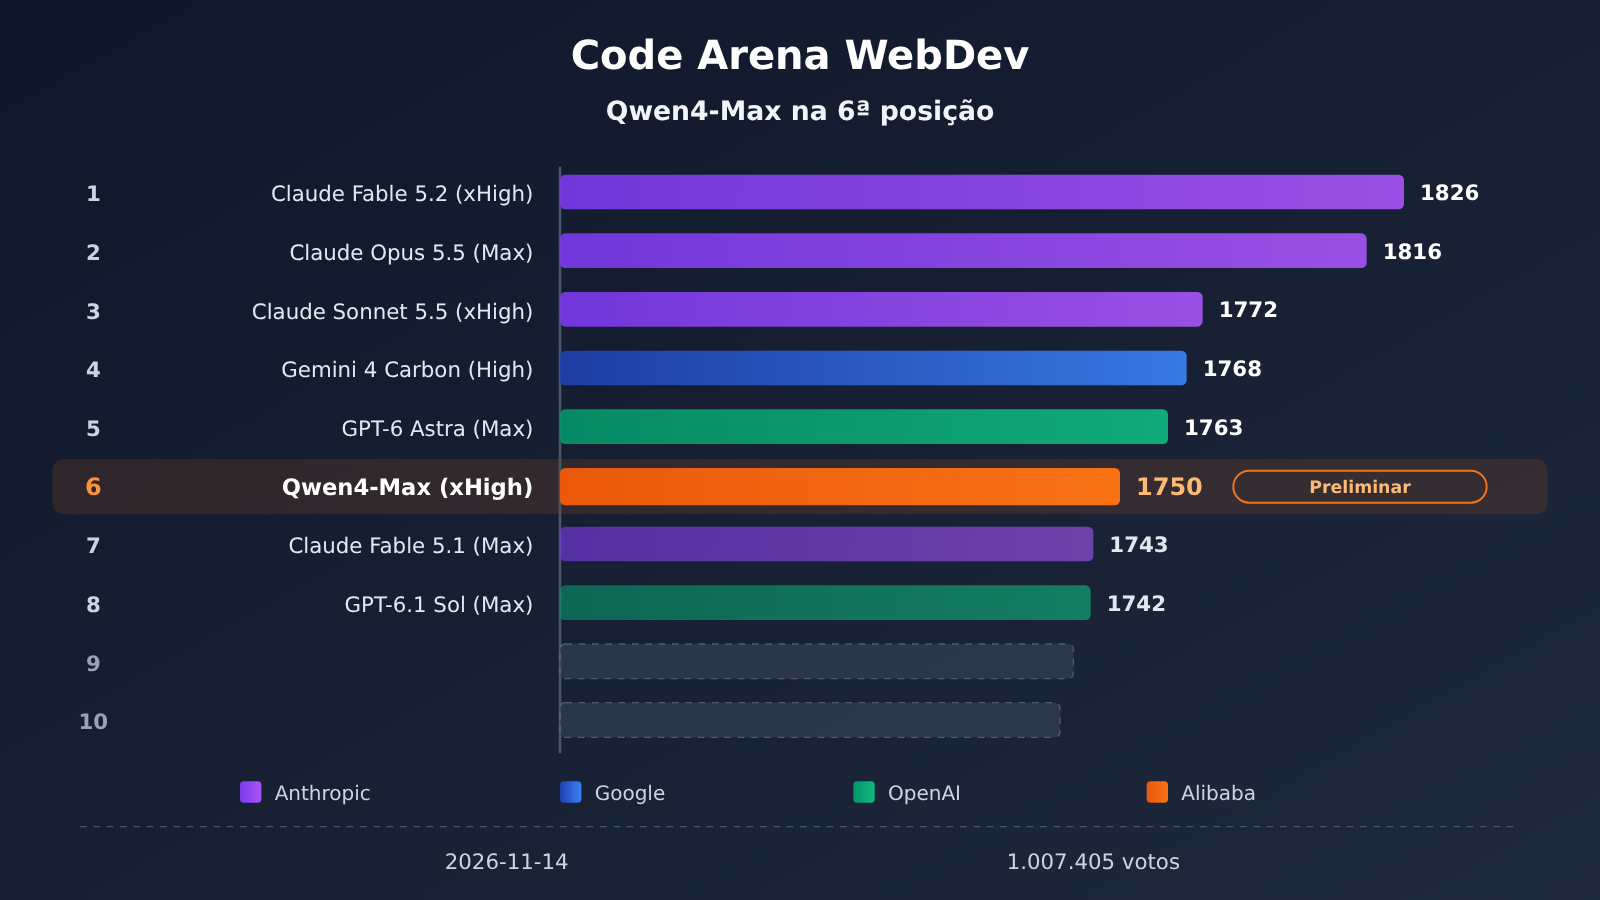
Qwen4-Max Code Arena WebDev: os 6 pontos centrais
Antes de discutir posições, vale colocar na mesa os metadados da lista. Qualquer afirmação do tipo “ficou em tal lugar” deveria primeiro conferir data, número de votos e quantidade de modelos avaliados — senão fica difícil saber se a posição realmente se sustenta.
| Ponto | Dado (dados públicos da mesma lista) | Como ler |
|---|---|---|
| Lista e categoria | arena.ai Code Arena WebDev, Overall | Representa apenas a preferência em testes cegos de desenvolvimento web |
| Data da página | 2026-11-14 | A posição muda continuamente conforme os votos |
| Total de votos / número de modelos | 1,007,405 votos / 159 modelos | Amostra grande, mas a contagem de votos por modelo varia muito |
| Posição e pontuação do Qwen4-Max | 6º lugar, 1750 pontos | O único modelo de laboratório não americano entre os seis primeiros |
| Votos e marcação do Qwen4-Max | 1,814 votos, Preliminary | Ainda em fase de avaliação preliminar |
| Custo por tarefa P50 | $4.18 | Mediana estatística da lista, não o preço unitário do modelo |
Entendendo os critérios do ranking do Qwen4-Max
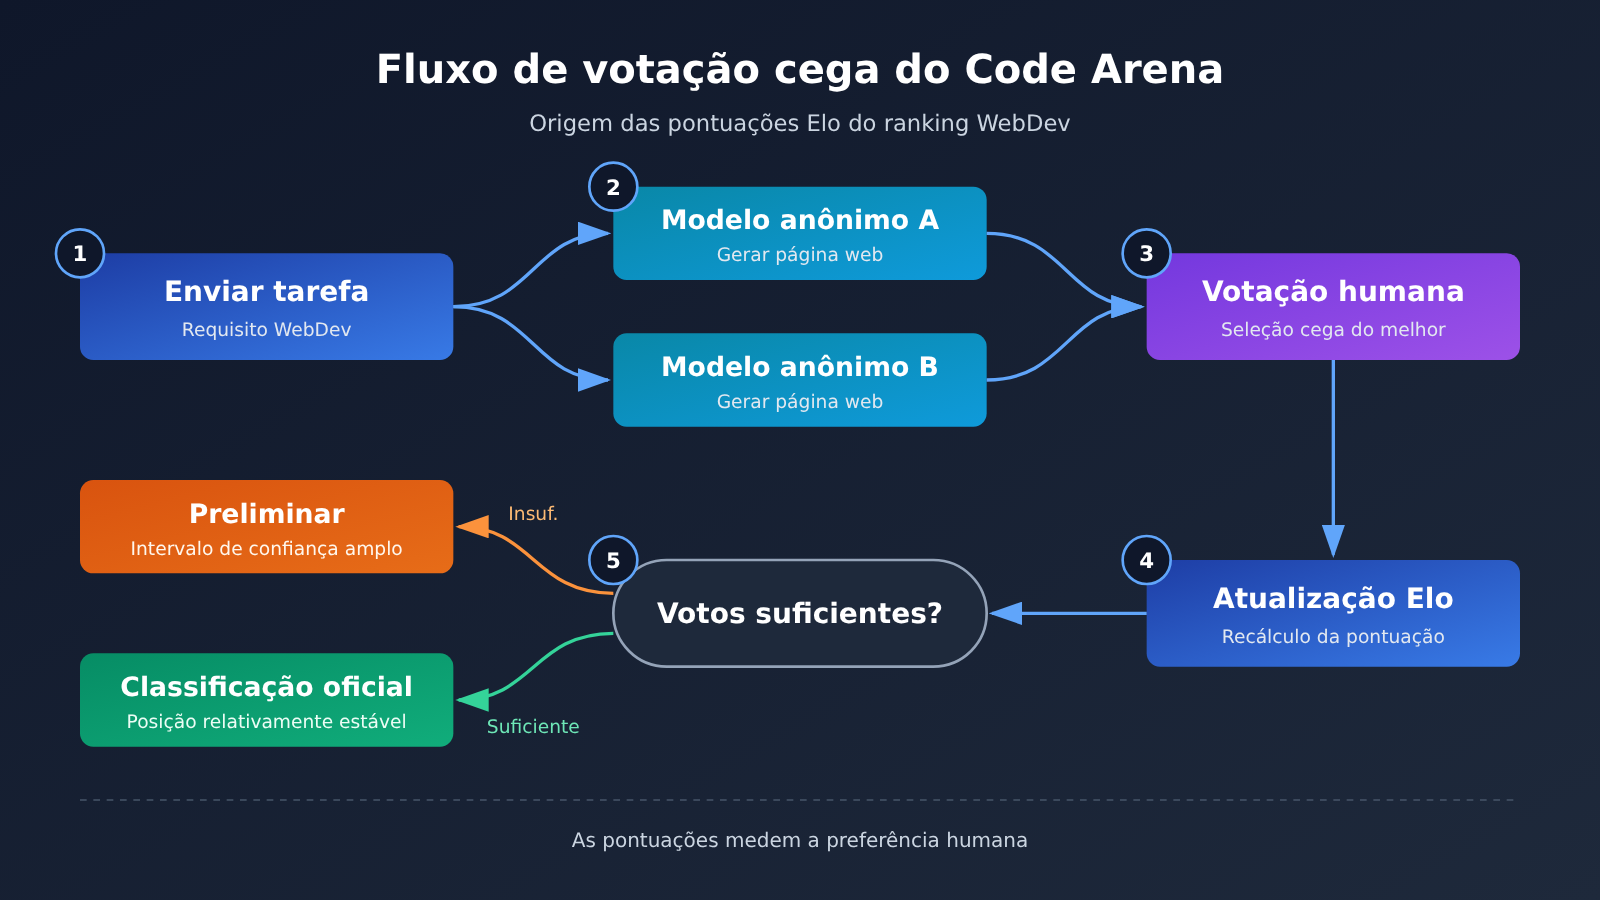
A pontuação Elo do Code Arena vem de votação humana em testes cegos: o usuário propõe uma mesma tarefa de desenvolvimento web, observa a saída de dois modelos anônimos e vota em qual achou melhor. A pontuação reflete “quem faz a página melhor aos olhos de avaliadores humanos” — ou seja, mede preferência, não uma nota total de produtividade.
Também é preciso entender o que a marcação Preliminary significa. Ela indica que o modelo ainda não participou de batalhas o suficiente, então o intervalo de confiança fica mais largo. O Gemini 4 Carbon (High), 4º colocado na mesma lista, carrega a mesma marcação — portanto não seria surpresa se, nas próximas semanas, as posições entre o 4º e o 6º lugar se alternarem.
Quem são os seis primeiros no Code Arena WebDev: o cenário de concorrência do Qwen4-Max
Listar os dez primeiros por completo deixa mais claro onde o Qwen4-Max está. O top 5 é dominado por três laboratórios americanos, e só a Anthropic ocupa três posições.
| Ranking | Modelo | Pontuação | Laboratório | Observações |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | Topo da lista |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 por tarefa $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminar | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 por tarefa $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Preliminar, 1.814 votos |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
O que o cenário do top 5 significa para o Qwen4-Max
Entre os seis primeiros, a Anthropic ocupa 3 posições (Fable 5.2, Opus 5.5 e Sonnet 5.5), Google e OpenAI têm 1 cada, e a Alibaba tem 1. Em outras palavras, o Qwen4-Max conquistou um lugar entre os modelos carro-chefe de três laboratórios líderes, e não apenas pescou uma posição num ranking disperso.
Outro detalhe que chama atenção é que o 6º ao 8º lugar são bem próximos: 1750, 1743 e 1742, uma diferença de menos de 10 pontos entre os três. A vantagem do Qwen4-Max sobre Claude Fable 5.1 e GPT-6.1 Sol é menor do que os 13 pontos que o separam do GPT-6 Astra. A estabilidade das posições só poderá ser avaliada quando o número de votos aumentar.
A posição do Qwen4-Max entre os modelos domésticos
Se olharmos apenas para o grupo dos modelos domésticos, a liderança do Qwen4-Max fica bem evidente. Ele é o único modelo doméstico a entrar no top 10, e o segundo colocado só aparece na 13ª posição.
| Ranking doméstico | Modelo | Pontuação | Posição no ranking | Diferença para o Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 6º | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 13º | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 16º | −74 |
| 4 | Qwen3.8-Max | 1670 | 18º | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 18º | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 19º | −89 |
| 7 | Kimi K3 (Max) | 1658 | 20º | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 26º | −111 |
| 9 | Hy4 preview | 1632 | 27º | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 31º | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 33º | −129 |
Os dois significados da diferença interna entre os modelos domésticos
O primeiro é o salto geracional. O Qwen4-Max tem 74 pontos a mais que a geração anterior da própria família, o Qwen3.8-Max (0902), e sobe da 16ª para a 6ª posição. No mesmo ranking e com o mesmo mecanismo de votação, esse ganho é bastante considerável.
O segundo é a distância para o segundo colocado doméstico. O Qwen4-Max tem 64 pontos a mais que o Kimi K3.1 Pro, uma diferença próxima dos 66 pontos que o separam do Opus 5.5. Ou seja, o Qwen4-Max está hoje em uma posição intermediária entre o grupo doméstico e a liderança global: abriu vantagem sobre os rivais domésticos, mas ainda tem um caminho a percorrer até o topo da tabela.
Vale lembrar que os modelos domésticos do 2º ao 7º lugar estão espremidos entre 1686 e 1658, com diferenças muito pequenas. Usar este ranking para definir a ordem entre essas empresas tem pouco significado.
Quão grande é a diferença entre o Qwen4-Max e os líderes globais
Diferença de pontos no Code Arena WebDev
Listar as diferenças entre o Qwen4-Max e os modelos líderes e fazer uma estimativa aproximada da “taxa de vitória em confronto direto” com a fórmula Elo geral (escala de 400 pontos) ajuda a entender o significado prático dessas diferenças. O método estatístico específico da arena pode divergir do Elo padrão; as taxas abaixo servem apenas como referência intuitiva:
- Contra o 5º colocado, GPT-6 Astra: 1750 vs 1763, diferença de 13 pontos, taxa estimada de vitória em confronto direto de cerca de 48%, praticamente um empate.
- Contra o 2º colocado, Opus 5.5: diferença de 66 pontos, taxa estimada de vitória em confronto direto de cerca de 41%.
- Contra o 1º colocado, Fable 5.2: diferença de 76 pontos, taxa estimada de vitória em confronto direto de cerca de 39%.
- Contra o Kimi K3.1 Pro, segundo melhor modelo chinês: 64 pontos à frente, taxa estimada de vitória em confronto direto de cerca de 59%.
A faixa de pontuação de toda a tabela vai de 1071 a 1826. Nessa escala, a diferença de 76 pontos entre o Qwen4-Max e o líder não é grande, mas também mostra que, em preferência por desenvolvimento web, os principais modelos da Anthropic ainda são mais apreciados pelos avaliadores.
Outros benchmarks no mesmo gráfico: Elo alto não significa desempenho forte em tarefas de terminal
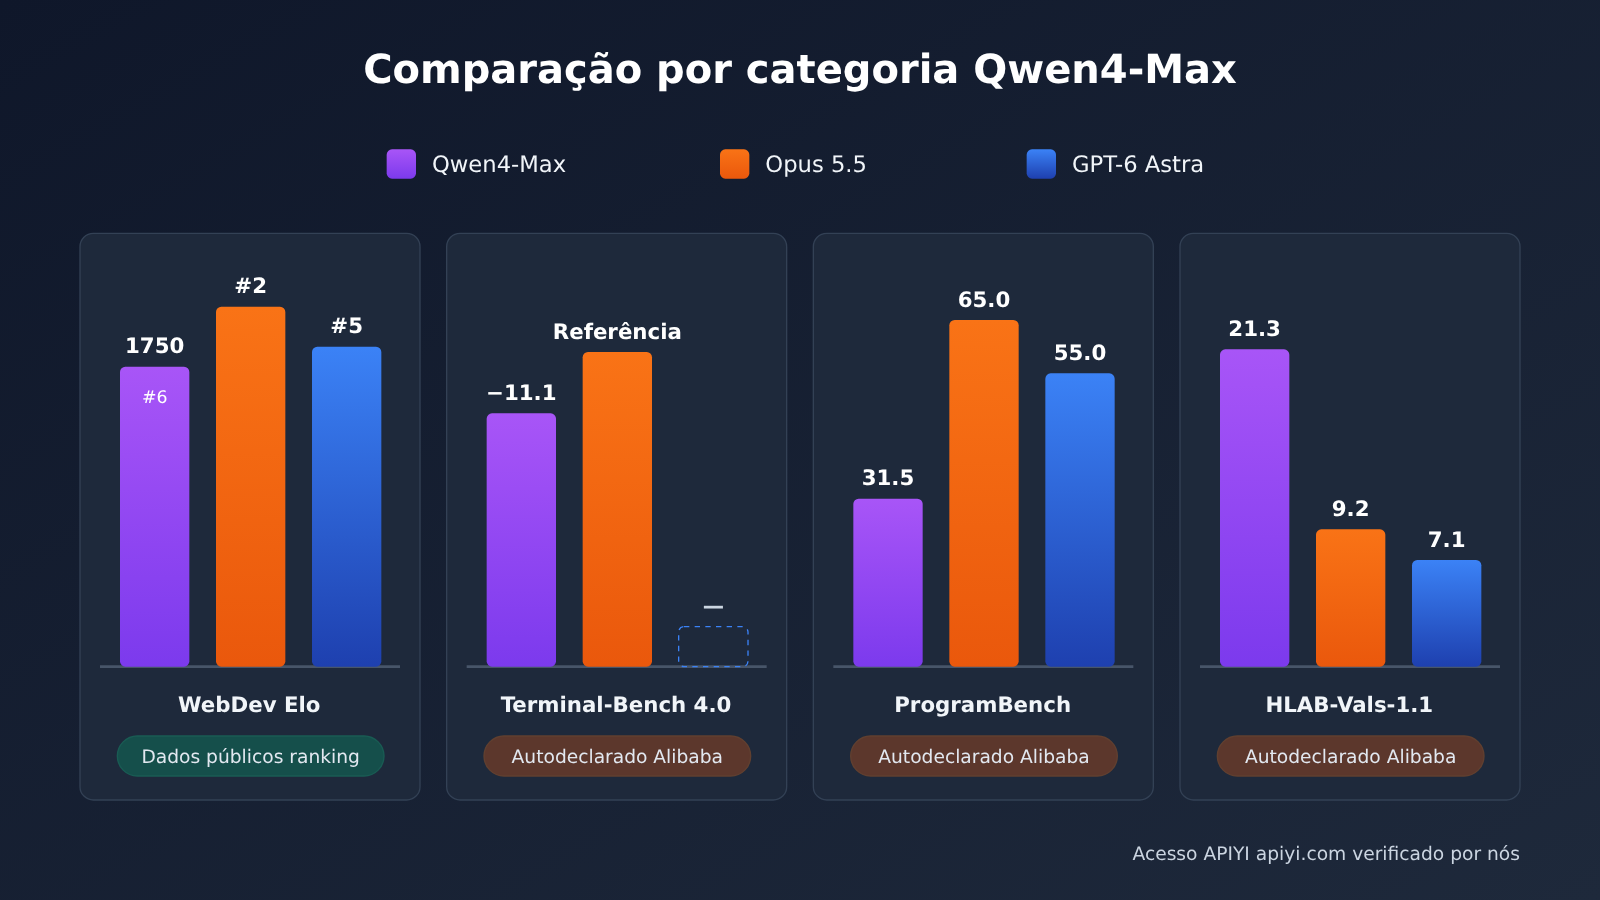
Quando a Alibaba lançou o Qwen4-Max, usou um gráfico com vários benchmarks. Os dados abaixo são todos autodeclarados oficialmente pela Alibaba, não são dados do ranking da arena nem resultados reproduzidos por terceiros.
| Benchmark (autodeclarado oficialmente) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Outros |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Esta tabela revela um ponto crucial: o Qwen4-Max tem pontuação alta no teste cego de desenvolvimento web, mas ainda há uma diferença clara nos benchmarks de operação de terminal e de programação de engenharia. No Terminal-Bench 4.0, ele fica 11.1 pontos abaixo do Opus 5.5, e o modelo Kimi no gráfico chega a 67.2, ainda mais alto; no ProgramBench, seus 31.5 não chegam nem à metade do Opus 5.5.
Ele também tem itens em que lidera claramente. No HLAB-Vals-1.1, o Qwen4-Max obtém 21.3, muito acima dos 9.2 do Opus 5.5 e dos 7.1 do GPT-6 Astra; no AA-Briefcase, também supera o GPT-6 Astra. Portanto, uma descrição mais precisa é: a distribuição de capacidades do Qwen4-Max é diferente da dos modelos líderes, e não uma “aproximação abrangente”.
Como interpretar os votos e o custo do Qwen4-Max
Votos: o que significam 1,814 votos
Manter a posição depende muito do número de votos. Os 1,814 votos do Qwen4-Max representam menos de 0.2% do total de cerca de 1 milhão de votos e também são bem inferiores aos de vários modelos chineses no mesmo ranking.
| Modelo | Posição | Votos | Custo por tarefa P50 | Status |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6º | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 13º | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 16º | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 2º | Dados públicos do mesmo ranking | $8.99 | — |
| GPT-6 Astra (Max) | 5º | Dados públicos do mesmo ranking | $9.43 | — |
O Qwen3.8-Max tem cerca de 12.7 vezes mais votos que o Qwen4-Max, e sua pontuação está mais próxima de um “valor estável”. A pontuação 1750 do Qwen4-Max hoje parece mais uma leitura inicial: pode ser ajustada para cima ou para baixo mais adiante. Ao citar essa posição, o ideal é incluir as três ressalvas: “Preliminary”, “1,814 votos” e “2026-11-14”.
Custo P50 por tarefa: não é o preço unitário do modelo
O custo P50 por tarefa mostrado no ranking refere-se ao valor mediano gasto em uma única tarefa naquele conjunto de tarefas. Ele é bastante influenciado pelo comprimento da saída do modelo e pelo nível de intensidade de raciocínio (como xHigh, Max), então não pode ser comparado como se fosse o preço por milhão de tokens do modelo.
Sob essa métrica, os $4.18 do Qwen4-Max equivalem a cerca de 46% dos $8.99 do Opus 5.5 e a 44% dos $9.43 do GPT-6 Astra, mas são aproximadamente 4,7 vezes os $0.89 do Kimi K3.1 Pro e 2,2 vezes os $1.91 do Qwen3.8-Max da geração anterior. Se o seu cenário é sensível ao custo por tarefa, vale a pena considerar o Kimi K3.1 Pro: ele alcançou 1686 pontos com cerca de um quinto do custo.
Preço oficial do Qwen4-Max e preço atual na APIYI
A seguir, os preços por 1M tokens, com dados de 2026-11-16:
- Preço oficial do Qwen4-Max: entrada $1.5, saída $4.5, leitura de cache $0.075.
- Qwen topo de linha vendido na APIYI
qwen3.8-max: entrada $1.65, saída $4.95, leitura de cache $0.20625.
Vale esclarecer que a APIYI ainda não disponibilizou o qwen4-max; vamos colocá-lo no catálogo o quanto antes. Como são modelos diferentes, os preços acima não podem ser comparados diretamente. Para os modelos e preços realmente disponíveis, consulte a lista de modelos da plataforma APIYI em apiyi.com.
Três passos: revisar o ranking, conferir os preços e trocar o endpoint
Depois de ler um ranking, o desenvolvedor costuma fazer três coisas: conferir as posições, conferir os preços e colocar o modelo no próprio projeto para testar. A recomendação é seguir esta ordem:
- Revisar o ranking: abra a página Code Arena WebDev em arena.ai e verifique se data, número de votos e a marcação Preliminary mudaram.
- Conferir os preços: na lista de modelos do APIYI apiyi.com, veja quais modelos Qwen estão à venda no momento e os preços em tempo real, confirmando se o
qwen4-maxjá está disponível. - Trocar o endpoint: no SDK compatível com OpenAI que você já usa, altere o base_url para
https://api.apiyi.com/v1e preencha primeiro o ID do modelo comqwen3.8-max; quando o novo modelo estiver disponível, troque paraqwen4-maxpara fazer a comparação.
🚀 Dica para começar rápido: se você quer validar, nas suas próprias tarefas de WebDev, a diferença entre a linha Qwen e Claude, GPT e Gemini, pode usar o APIYI apiyi.com para chamar vários modelos com uma única API Key. Novos usuários têm cota gratuita de teste, o que é ideal para rodar primeiro um lote pequeno de amostras e só depois decidir qual modelo escolher.
Análise de prós e contras do Qwen4-Max
Pontos fortes do Qwen4-Max
- Lidera o grupo de modelos chineses em pontuação de preferência em desenvolvimento web: 1750 pontos, 64 acima do segundo modelo chinês e 74 acima da geração anterior.
- A diferença para parte do topo já é pequena: apenas 13 pontos atrás do 5º colocado, GPT-6 Astra, e praticamente empatado com o 7º e o 8º.
- Custo por tarefa abaixo dos flagships do topo: P50 de $4.18, menos da metade de Opus 5.5 e GPT-6 Astra.
- Vantagem específica em alguns benchmarks: na HLAB-Vals-1.1, a pontuação autodeclarada oficial fica claramente à frente de Opus 5.5 e GPT-6 Astra.
Limitações do Qwen4-Max
- Posição ainda não estabilizada: marcação Preliminary e 1,814 votos; ao citar, é preciso indicar a ressalva.
- Fica atrás em benchmarks de terminal e engenharia de programação: no Terminal-Bench 4.0 e no ProgramBench, está claramente abaixo de Opus 5.5 e GPT-6 Astra; ao construir agentes ou automatizações de linha de comando, é preciso avaliar separadamente.
- Custo por tarefa acima de alguns modelos chineses: bem mais caro que Kimi K3.1 Pro e Qwen3.8-Max; em cenários sensíveis a custo, pode não valer a pena.
Quando não convém olhar só para o ranking Code Arena WebDev
Se o seu cenário principal é operação de terminal, modificações de código em cadeias longas ou tarefas de Agent com múltiplas etapas, olhar apenas o Elo do WebDev vai superestimar o desempenho real do Qwen4-Max. Nesse caso, benchmarks como o Terminal-Bench ficam mais próximos da sua necessidade. Da mesma forma, se o orçamento é uma restrição rígida, vale olhar o custo por tarefa junto com a pontuação, em vez de perseguir apenas a posição no ranking. Este ranking responde melhor a uma pergunta: “aos olhos de avaliadores humanos, quem faz as melhores páginas web?”
Perguntas frequentes (FAQ)
Q1: O 6º lugar do Qwen4-Max no ranking Code Arena WebDev é real?
Sim, é a posição real exibida na página do ranking (2026-11-14, categoria Overall, 1750 pontos). Mas ela traz a marcação Preliminary e tem apenas 1.814 votos, então a posição ainda pode mudar — ao citar, vale a pena registrar essas condições.
Q2: Qual é a diferença entre o Qwen4-Max e o GPT-6 Astra / Opus 5.5?
No Code Arena WebDev, o Qwen4-Max fica 13 pontos abaixo do GPT-6 Astra, 66 pontos abaixo do Opus 5.5 e 76 pontos abaixo do Fable 5.2, líder do ranking. Já no Terminal-Bench 4.0 e no ProgramBench, divulgados pela própria Alibaba, a diferença para esses dois modelos é bem maior.
Q3: O quanto o Qwen4-Max lidera entre os modelos chineses?
É o único modelo chinês entre os dez primeiros. Fica 64 pontos acima do segundo colocado chinês, o Kimi K3.1 Pro (13º lugar, 1686 pontos), e 74 pontos acima da geração anterior da própria família, o Qwen3.8-Max (0902).
Q4: Para quais cenários o Qwen4-Max é mais indicado?
Pelo critério deste ranking, ele é mais adequado a tarefas de WebDev como geração de front-end web, landing pages e protótipos interativos. Para automação de terminal, alterações de código em larga escala de nível empresarial e cenários semelhantes, recomendo consultar benchmarks específicos de terminal e validar com suas próprias amostras.
Q5: Como chamar os modelos da família Qwen via API para fazer testes comparativos?
Você pode se registrar em APIYI apiyi.com e obter uma chave API. No SDK compatível com OpenAI, defina o `base_url` como `https://api.apiyi.com/v1` e use o ID de modelo `qwen3.8-max`. O `qwen4-max` ainda não está disponível — vamos colocá-lo no ar o quanto antes, e depois basta trocar o ID do modelo para alternar a comparação.
Q6: O custo de US$ 4,18 por tarefa é o preço do Qwen4-Max?
Não. Os US$ 4,18 são o custo mediano por tarefa (P50) apurado pelo ranking, e variam conforme o comprimento da saída e o nível de raciocínio utilizado. O preço unitário do modelo deve ser consultado por 1M tokens de entrada, saída e leitura de cache; os preços atualizados podem ser conferidos na lista de modelos do APIYI apiyi.com.
Qwen4-Max Code Arena WebDev — Principais Takeaways
- Posição: 6º lugar no ranking de 2026-11-14, 1.750 pontos, primeira vez que um modelo nacional (chinês) entra no top 6.
- Cenário: os cinco primeiros são ocupados por três assentos da Anthropic, um da Google e um da OpenAI.
- Estabilidade: a marcação Preliminary soma 1.814 votos, então a posição ainda vai mudar.
- Diferença dos nacionais: lidera o Kimi K3.1 Pro por 64 pontos e a geração anterior por 74 pontos.
- Limites de capacidade: no Terminal-Bench e no ProgramBench, segundo os números oficiais, ainda fica atrás dos líderes.
- Base do custo: P50 de $4,18 é a mediana por tarefa única, não o preço unitário do modelo.
- Como começar: dá para montar primeiro o fluxo de comparação no APIYI usando
qwen3.8-maxe trocar quando o novo modelo estiver disponível.
Resumo
O desempenho do Qwen4-Max no ranking Code Arena WebDev pode ser resumido em três pontos:
- Primeira entrada no top 6: 1.750 pontos, o único modelo de laboratório não-americano entre os seis primeiros, a apenas 13 pontos do 5º lugar.
- A posição ainda é uma leitura inicial: Preliminary, 1.814 votos — ao citar, deixe claro a data e o número de votos.
- Elo não significa força abrangente: nos benchmarks de terminal e de engenharia de programação que a própria empresa reporta, ainda fica atrás do Opus 5.5 e do GPT-6 Astra.
Se você está fazendo seleção de modelos, sugiro tratar esse ranking como uma dimensão de referência para “preferência em desenvolvimento web” e depois cruzar com suas próprias amostras de tarefas e o orçamento de custo para decidir. Recomendo usar o APIYI apiyi.com para colocar os modelos candidatos na mesma bateria de tarefas através de uma interface unificada e chegar às conclusões com seus próprios dados.
📚 Referências
- Ranking Code Arena WebDev do arena.ai: fonte da classificação, pontuação, votos e custo por tarefa deste artigo
- Link:
arena.ai -
Observação: a página indica 2026-11-14, categoria Overall; você pode conferir por conta própria a classificação mais recente e a marcação Preliminary
-
Gráfico de lançamento oficial do Qwen4-Max da Alibaba: fonte das pontuações de benchmarks como Terminal-Bench 4.0 e ProgramBench
- Link: consulte os canais oficiais de lançamento do Qwen
- Observação: os dados citados no texto são todos autodeclarados oficialmente, não são reproduções de terceiros
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para falar com a gente pela página inicial do site APIYI; as instruções sobre listagem de modelos e integração estão disponíveis no centro de documentação docs.apiyi.com


