
Nota do autor: ambos são flagships de nível 2.4T. O preço de tabela do Qwen4-Max caiu 25%, o limite de saída quase triplicou e o uso de tokens na mesma tarefa é 20% a 30% menor. Este artigo destrincha a arquitetura, as pontuações autodeclaradas oficialmente e os preços de tabela das duas gerações, e traz um checklist de migração a partir do qwen3.8-max.
Em 2026-11-16, a Alibaba lançou o Qwen4-Max. Vamos direto à conclusão: em comparação com o Qwen3.8-Max, a nova geração tem preços de tabela de entrada e saída 25% menores, saída máxima que sobe de 128K para 393K, cerca de três vezes mais e, na avaliação oficial Work360, uso de tokens 20% a 30% menor na mesma tarefa. Para equipes que já rodam qwen3.8-max em produção, essa atualização merece uma avaliação séria — mas não exige começar do zero.
Este não é um texto promocional do tipo “a nova geração atropela tudo”. As pontuações abaixo são sempre marcadas como autodeclaradas pela fabricante; os rankings de terceiros são marcados como um instantâneo de rankings públicos (2026-11-14). Dois números fáceis de exagerar — a queda de 62% no custo por tarefa e o 6º lugar na Arena — são analisados separadamente.
O valor central: depois da leitura, você consegue julgar três coisas: quanto da economia é real, quais benchmarks subiram de forma evidente e quais praticamente não se moveram, e o que mais precisa ser ajustado na migração além de trocar o ID do modelo. Aliás, se você faz chamadas via APIYI apiyi.com, até 2026-11-16 11:00 a plataforma ainda não havia disponibilizado o qwen4-max; por enquanto, é só continuar usando o qwen3.8-max — vamos disponibilizar esse modelo o mais rápido possível.
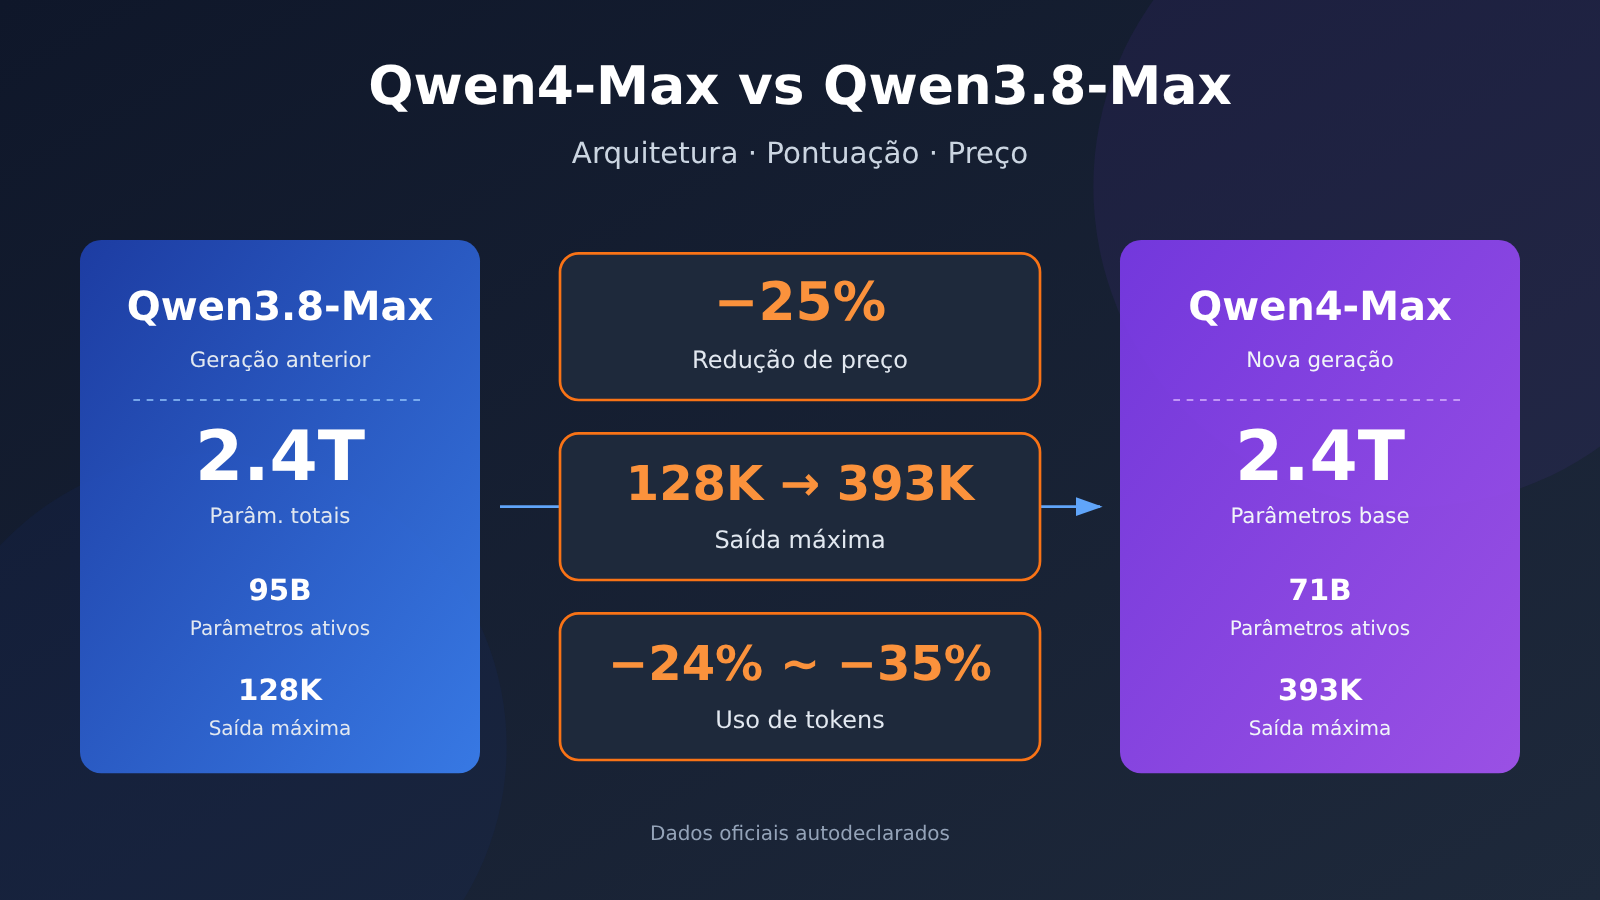
Qwen4-Max vs Qwen3.8-Max: visão rápida das diferenças principais
Os dois modelos estão na mesma faixa de escala total, mas o Qwen4-Max fez ajustes nos parâmetros ativos, no limite de saída e no nível de raciocínio padrão. A tabela abaixo reúne primeiro as diferenças em nível de especificação; o preço fica na seção de custos mais adiante.
| Dimensão de comparação | Qwen3.8-Max | Qwen4-Max | Mudança |
|---|---|---|---|
| Escala de parâmetros | 2.4T de parâmetros totais | 2.4T de backbone + 328B de N-gram Embedding | Backbone no mesmo nível, nova tabela de embeddings |
| Ativos por chamada | 95B | 71B | Cerca de 25% menos |
| Janela de contexto | 1M | 1M (entrada máxima 991K, modo de raciocínio 983K) | Limite de entrada ligeiramente reduzido |
| Saída máxima | 128K | 393K | Cerca de 3x |
| Cadeia de pensamento máxima | Não listado separadamente pela documentação oficial | 262K | Novo limite explícito |
| reasoning_effort padrão | xhigh | high | Nível padrão reduzido em um grau |
| Capacidade visual | Suporta entrada de imagens | Visão nativa | A visão passa a ser uma capacidade nativa |
| Pesos abertos | Qwen3.8-2.4T-A95B | Não mencionado nos materiais | — |
Dá para perceber a lógica desta atualização pela tabela: escala total igual, menos cálculo por chamada, mais espaço para a saída. Os parâmetros ativos caíram de 95B para 71B, e esse é o pré-requisito por trás da possibilidade de reduzir o preço de tabela; já a saída máxima em 393K muda diretamente a viabilidade de tarefas como relatórios longos e geração de grandes blocos de código.
Vale um alerta: o reasoning_effort padrão passou de xhigh para high. Se o seu código não define esse parâmetro explicitamente, ao trocar o ID do modelo o nível de raciocínio efetivamente executado vai mudar — e isso será reforçado de novo no checklist de migração.
Mudanças na arquitetura do Qwen4-Max: como três alterações afetam o uso
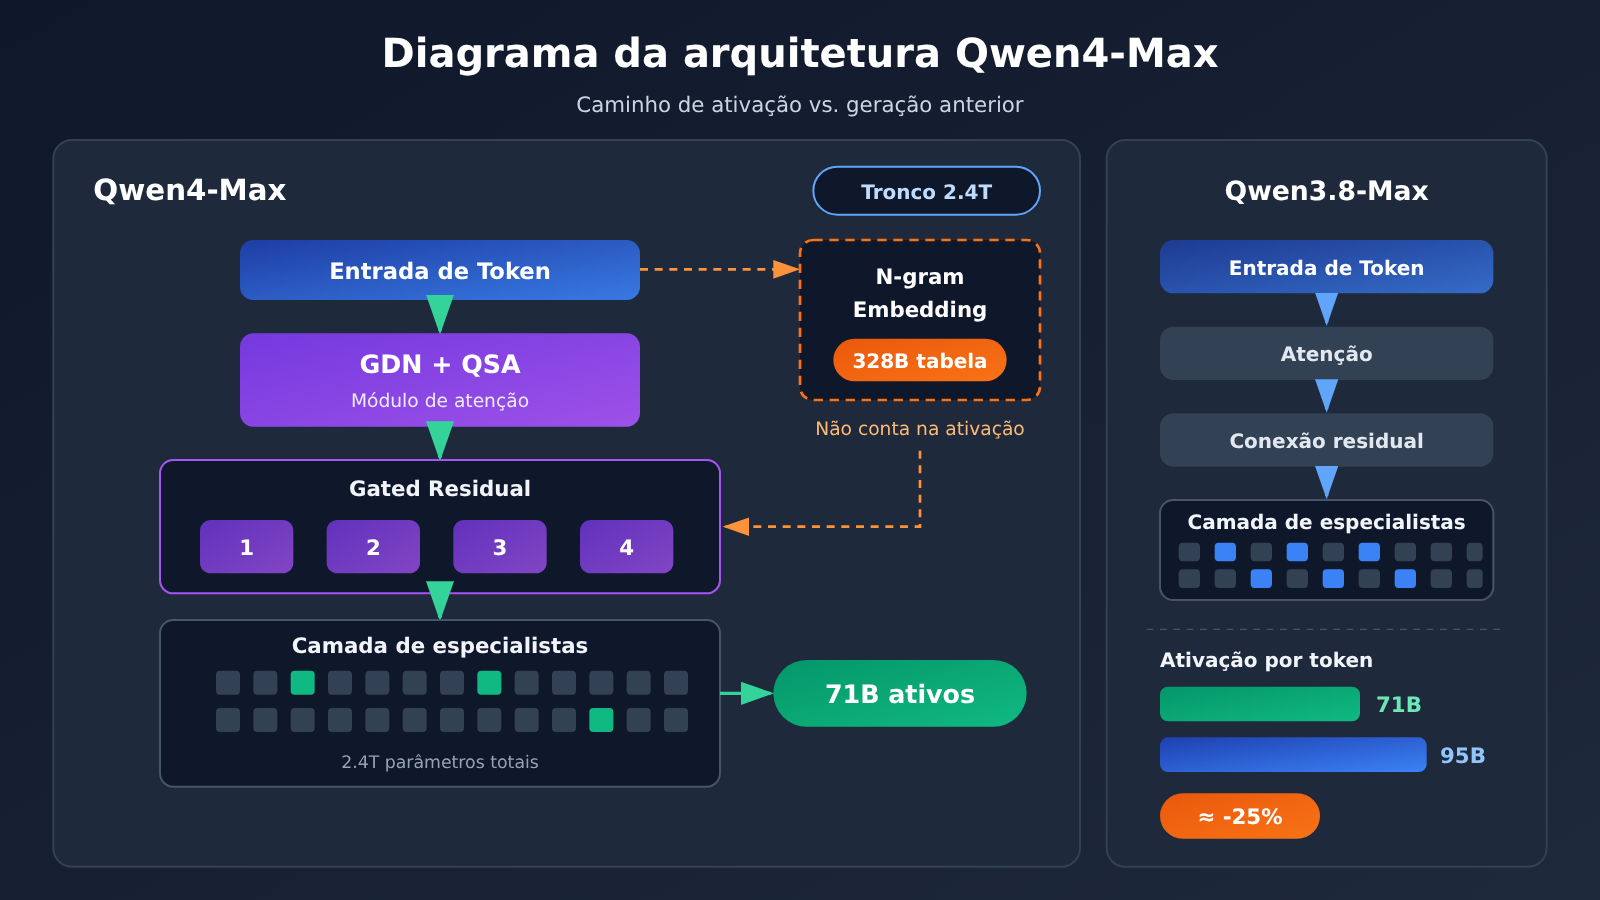
O blog oficial resume as mudanças de arquitetura do Qwen4-Max em três pontos: GDN + QSA, Gated Residual com quatro ramos e N-gram Embedding. Para quem usa a API, não é preciso entender os detalhes de implementação camada por camada, mas vale saber o que cada uma dessas mudanças afeta.
GDN + QSA: mudança na camada de atenção
Trata-se de um ajuste na estrutura de atenção. A apresentação oficial coloca isso junto com a janela de contexto de 1M e a saída máxima de 393K; nosso entendimento é que essa mudança serve principalmente à eficiência computacional em cenários de sequências longas. Para quem usa a API, o resultado perceptível é direto: com a mesma janela de contexto de 1M, o Qwen4-Max consegue produzir saídas mais longas e, ainda assim, com preço unitário menor.
Gated Residual com quatro ramos
As conexões residuais foram expandidas para quatro ramos com gating. Esse tipo de mudança normalmente afeta a estabilidade do treinamento e o fluxo de informação entre diferentes habilidades, e acaba aparecendo no comportamento do modelo. O impacto prático é que, mesmo com o comando exatamente igual, o estilo de saída e o comprimento das etapas de raciocínio do Qwen4-Max podem ser diferentes da geração anterior. Por isso, comandos refinados especificamente para o Qwen3.8-Max precisam passar por testes de regressão.
N-gram Embedding: parâmetros de 328B não significam volume de computação
A especificação de parâmetros do Qwen4-Max é “tronco de 2.4T / 71B ativados + 328B de N-gram Embedding”. No design usual, esse tipo de embedding é um parâmetro de consulta em tabela e não entra no cálculo de ativação do tronco por token. Portanto, não se deve somar os 328B diretamente ao volume de ativação para fazer a comparação. O que realmente está relacionado ao custo de inferência é 71B contra 95B, ou seja, cerca de 25% menos ativação por passo.
No pré-treinamento, os dados oficiais mostram que o Qwen4-Max-Base tem o BPB (bits por byte, quanto menor, melhor) mais baixo em todas as quatro categorias de avaliação interna: conhecimento, código, perguntas e respostas e STEM. O valor fica cerca de 5–13% abaixo do Qwen3.8-Max-Base. É uma avaliação interna oficial, mas ao menos mostra que o modelo base em si melhorou, e que os ganhos posteriores em benchmarks não vieram apenas do pós-treinamento.
Comparação de benchmarks do Qwen4-Max: o que subiu muito e o que praticamente não mudou
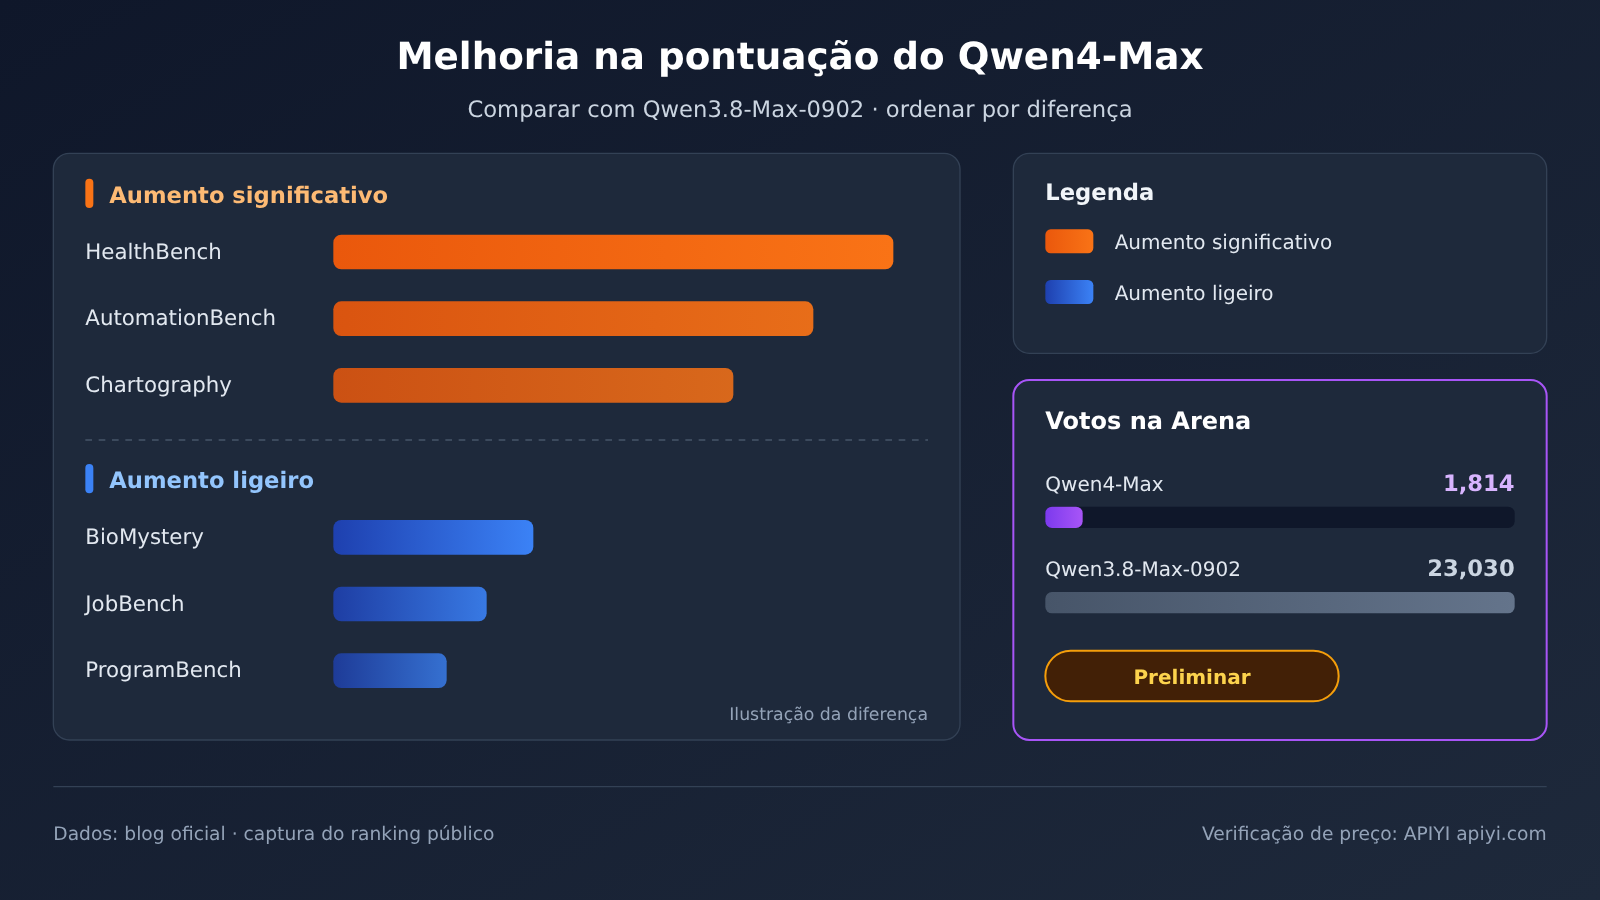
Todos os dados abaixo vêm da mesma tabela comparativa divulgada pela Alibaba, são autodeclarados pela fabricante e o objeto de comparação é o Qwen3.8-Max-0902 (versão atualizada em setembro). Organizamos a lista da maior para a menor melhoria, para que você veja de imediato onde os ganhos do upgrade se concentram.
| Benchmark (autodeclarado oficial) | Qwen3.8-Max-0902 | Qwen4-Max | Diferença | Magnitude da melhoria |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | Expressiva |
| CodeArena | 1676 | 1750 | +74 | Expressiva |
| HealthBench | 39.6 | 60.0 | +20.4 | Muito expressiva |
| AutomationBench | 56.2 | 72.5 | +16.3 | Muito expressiva |
| Chartography | 42.0 | 54.2 | +12.2 | Expressiva |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | Expressiva |
| APEX-Agents | 63.3 | 72.1 | +8.8 | Expressiva |
| HLE | 43.9 | 51.7 | +7.8 | Expressiva |
| DeepSWE | 69.3 | 75.7 | +6.4 | Moderada |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | Moderada |
| Video-Index | 63.2 | 68.1 | +4.9 | Moderada |
| ProgramBench | 28.0 | 31.5 | +3.5 | Pequena |
| JobBench | 65.3 | 68.5 | +3.2 | Pequena |
| BioMystery | 84.1 | 85.0 | +0.9 | Praticamente estável |
Onde os ganhos se concentram mais é nas tarefas de agente e invocação de ferramentas: AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Se o seu negócio envolve invocação de ferramentas em múltiplas rodadas, operações de terminal ou fluxos automatizados, é aí que o upgrade rende mais. O HealthBench foi de 39.6 para 60.0 e o Chartography subiu 12.2, o que mostra que perguntas e respostas na área médica e compreensão de gráficos também são prioridades desta geração.
No outro extremo, o BioMystery subiu apenas 0.9, enquanto JobBench e ProgramBench avançaram pouco mais de 3 pontos. Nessas categorias de tarefa, o ganho marginal do upgrade é limitado; se o seu cenário principal está justamente próximo delas, o benchmark sozinho não sustenta a decisão de upgrade — vale olhar mais para o custo. O Work360, também divulgado oficialmente, ficou em 52.69 contra 47.74, ou seja, 4.95 a mais, o que igualmente configura uma melhoria moderada.
Na área de segurança, a taxa de dupla aprovação em nível de função no Last Secure Code Bench, divulgada oficialmente, passou de 22.0% para 31.8%, e a segurança simultânea nas três granularidades foi de 8% para 14.7%. Os valores absolutos continuam baixos e o código gerado ainda precisa passar por revisão de segurança, mas o avanço relativo é expressivo.
Ranking de terceiros do Arena: a posição Preliminary com 1,814 votos
Os 1750 pontos do CodeArena oficial também aparecem no ranking Code Arena WebDev do arena.ai, que é de terceiros. A seguir, uma captura do ranking público, 2026-11-14:
- Qwen4-Max (xHigh): 1750 pontos, 6º lugar, marcado como Preliminary, 1,814 votos, $4.18/tarefa
- Qwen3.8-Max (0902): 1676 pontos, 16º lugar, 23,030 votos, $1.91/tarefa
- Qwen3.8-Max: 1670 pontos, 18º lugar
Aqui está o segundo ponto que pode ser facilmente exagerado: o Qwen4-Max tem apenas 1,814 votos, enquanto a versão 0902 da geração anterior tem 23,030, uma diferença de cerca de 12 vezes. A marcação Preliminary significa que o ranking ainda está se estabilizando, e o 6º lugar ainda pode mudar; ao citar agora, é melhor escrever “6º lugar preliminar”.
Há outro detalhe na captura que vale a pena observar: o Qwen4-Max compete no nível xHigh, com custo de $4.18 por tarefa, superior ao $1.91 do Qwen3.8-Max 0902. Isso não contradiz a afirmação oficial de “queda do custo por tarefa”, porque o nível testado e os tipos de tarefa são diferentes, mas serve de alerta: no nível de raciocínio mais alto, o Qwen4-Max não é necessariamente mais econômico.
Qwen4-Max preços e custos: quanto da economia é real
Atualizar, no fim das contas, é trocar de modelo. Antes de decidir, é preciso comparar os preços. A tabela abaixo mostra os preços de tabela oficiais das duas gerações e o preço atual do qwen3.8-max vendido na APIYI. Todos os valores são por 1M tokens, com data de coleta em 2026-11-16.
| Item de cobrança (por 1M tokens) | Qwen3.8-Max oficial (região de Singapura) | Qwen4-Max oficial | Qwen4-Max oficial em RMB | Preço atual do qwen3.8-max na APIYI |
|---|---|---|---|---|
| Entrada | $2 | $1,5 | ¥10 | $1,65 |
| Saída | $6 | $4,5 | ¥30 | $4,95 |
| Leitura de cache | $0,25 | $0,075 | ¥0,5 | $0,20625 |
| Escrita de cache (5 minutos) | Não listado no blog oficial | $1,875 | ¥12,5 | Não detalhado separadamente na documentação |
| Escrita de cache (1 hora) | Não listado no blog oficial | $3 | ¥20 | Não detalhado separadamente na documentação |
Entrada e saída caem 25% cada. A leitura de cache vai de $0,25 para $0,075, uma redução de cerca de 70% — o maior item deste ajuste de preços. Por outro lado, o Qwen4-Max lista explicitamente dois níveis de preço para escrita de cache, 5 minutos e 1 hora. Aplicações que reutilizam prefixos longos com alta frequência precisam incluir esse custo de escrita no orçamento.
Economia de tokens: 20% a 30% no Work360, 40% a 50% no Terminal-Bench
Os números oficiais de economia de tokens vêm em dois conjuntos. No Work360, o nível Xhigh reduz 24% e o nível High reduz 35% — é daí que vem o “20% a 30%”. No Terminal-Bench 4.0 é ainda mais exagerado: 48% e 49%, respectivamente.
A economia em tarefas de terminal é claramente maior, o que pode estar relacionado à redução no número de rodadas de ferramentas nesse tipo de tarefa. Ao fazer orçamento, estimar em 20% a 30% para tarefas gerais de escritório é mais seguro; 40% a 50% só se aplica a cenários de operação de terminal semelhantes ao Terminal-Bench.
Os 11 pontos que não batem entre 62% e 51%
Este é o primeiro ponto em que é fácil exagerar. Os dados oficiais mostram o custo por tarefa caindo de $4.43 para $1.67, uma queda de cerca de 62% em dólares; já os números em yuan mostram ¥26.58 caindo para ¥11.16, cerca de 58% de queda. As duas métricas já divergem entre si.
Fazendo as contas com os próprios dados oficiais: 35% menos tokens e 25% menos no preço unitário. Multiplicando os dois, chega-se a apenas cerca de 51% de redução, ou seja, 0.65 × 0.75 ≈ 0.49. Os cerca de 11 pontos restantes não são explicados oficialmente. Nossa inferência é que podem vir de um grande corte no preço de leitura de cache (cerca de −70%), gerando ganho com acerto de cache, e também da redução nas rodadas de chamadas de ferramentas — mas isso é apenas uma inferência, não uma explicação oficial.
O caminho seguro é tratar 51% como teto de referência “com a mesma taxa de acerto de cache”; 62% só deve chegar perto em cenários com alta taxa de acerto de cache e muitas rodadas de ferramentas. No seu caso específico, a base mais confiável é rodar uma comparação de custo por tarefa com tráfego real.
Preço atual e status de listagem na APIYI
A APIYI está vendendo atualmente o qwen3.8-max, com entrada a $1.65, saída a $4.95 e leitura de cache a $0.20625. Segundo a documentação, isso é 17.5% abaixo dos $2 / $6 da Alibaba Cloud. Pelo mesmo preço, há também o qwen3.8-max-0902; a versão de pesos abertos qwen3.8-2.4t-a95b custa $1.72 / $5.16 / $0.215.
Na verificação de 2026-11-16 às 11:00, o qwen4-max ainda não aparecia nem na documentação de modelos nem na lista de preços da APIYI (284 modelos no total), ou seja, ainda não foi listado. Vamos disponibilizar esse modelo o mais breve possível; o nome do modelo e o preço terão como referência a lista de modelos da plataforma APIYI apiyi.com. Francamente, o preço unitário oficial de tabela do Qwen4-Max já está abaixo do preço atual do qwen3.8-max na plataforma; quando ele for listado, vale a pena refazer as contas.
Migrando do Qwen3.8-Max para o Qwen4-Max: checklist
Muita gente acha que a atualização é só trocar o ID do modelo, mas os parâmetros padrão, os limites de contexto e a cobrança de cache também mudaram. A checklist abaixo está organizada pela prioridade de “se não mudar, pode dar problema”.
| Item de verificação | Situação atual no Qwen3.8-Max | Depois de migrar para o Qwen4-Max | Ação recomendada |
|---|---|---|---|
| ID do modelo | qwen3.8-max / qwen3.8-max-0902 |
Conforme a lista de modelos da plataforma | Trocar depois que estiver listado, começando com rollout gradual |
| Valor padrão de reasoning_effort | xhigh | high | Declarar explicitamente o nível, para evitar mudanças silenciosas de comportamento |
| Limite de max_tokens | 128K | 393K | Verificar truncamento, armazenamento e timeouts a jusante |
| Entrada máxima | 1M | 991K (983K no modo de raciocínio) | Entradas muito longas, próximas de 1M, precisam ser cortadas |
| Cobrança de cache | Leitura de cache $0.25 | Leitura de cache $0.075, mais preço de gravação para 5 minutos / 1 hora | Reavaliar a estratégia de prefixo de cache e TTL |
| Entrada visual | Entrada de imagem | Visão nativa | Refazer os testes de regressão dos casos que envolvem imagens |
| Comando e formato de saída | Já otimizado para a geração anterior | Mudança de arquitetura, o comportamento pode diferir | Fazer regressão com um conjunto de avaliação fixo |
| Monitoramento de custos | Cobrado por token | Token e preço unitário caem ao mesmo tempo | Passar a olhar o custo por tarefa em vez do preço unitário |
O item mais fácil de passar despercebido na checklist é o reasoning_effort. O Qwen3.8-Max usa xhigh por padrão e o Qwen4-Max usa high; se o código não definir isso explicitamente, após a troca você pode tanto economizar tokens quanto ter resultados abaixo do esperado em tarefas de raciocínio complexo. Os dados oficiais de economia de tokens trazem os dois níveis, Xhigh e High, então vale a pena testar cada um e só depois decidir qual usar em produção.
O segundo ponto é o comprimento da saída. O teto de 393K significa que uma única resposta pode ser bem mais longa do que antes; se o sistema de logs, os campos do banco de dados ou os timeouts do gateway foram dimensionados para saídas de 128K, é preciso ampliá-los com antecedência. A entrada máxima passou de 1M para 991K (983K no modo de raciocínio). Para negócios que normalmente não chegam perto disso, o impacto é pequeno, mas cenários que empurram documentos até o limite vão receber erro direto.
Como fazer hoje usando a APIYI
Se você já está integrado via APIYI, com base_url https://api.apiyi.com/v1, usando o protocolo compatível com OpenAI, basta preencher o campo model com qwen3.8-max para continuar rodando em produção. Se precisar travar o comportamento da versão atualizada de setembro, pode usar qwen3.8-max-0902, com o mesmo preço.
Quando o qwen4-max estiver disponível na plataforma, como o protocolo não muda, a migração no código exige apenas alterar o campo model e, seguindo a checklist acima, acertar reasoning_effort e max_tokens. A recomendação é direcionar primeiro de 5% a 10% do tráfego para um rollout gradual, comparar o custo por tarefa e as métricas de negócio e só então liberar tudo.
🚀 Dica de migração: os projetos que hoje passam pela APIYI apiyi.com devem continuar com
qwen3.8-maxe, ao mesmo tempo, preparar o conjunto de avaliação e a flag de rollout gradual; troque o ID quando oqwen4-maxestiver disponível. Assim você evita ficar com o negócio parado “esperando o modelo novo”.
Recomendações de cenários para Qwen4-Max e Qwen3.8-Max
Cenários em que vale priorizar a avaliação do upgrade para o Qwen4-Max
- Chamadas de ferramentas em múltiplas rodadas e automação: AutomationBench, Terminal-Bench e APEX-Agents apresentam ganhos claros, e a economia de tokens também é maior nas tarefas de terminal.
- Tarefas com saídas muito longas: quando é preciso gerar de uma só vez relatórios, códigos ou documentos com mais de 128K, só os 393K do Qwen4-Max dão conta.
- Perguntas e respostas na área médica e compreensão de gráficos: HealthBench +20.4 e Chartography +12.2 — as áreas com os ganhos mais expressivos desta geração.
- Exigência de segurança no código: a taxa de aprovação dupla em segurança subiu de 22,0% para 31,8%, mas ainda precisa ser combinada com processos de revisão.
- Aplicações com alta taxa de reutilização de cache: o preço de leitura de cache cai cerca de 70%, e os cenários com prompts de sistema longos e prefixos fixos de base de conhecimento são os mais beneficiados.
Cenários em que vale continuar com o Qwen3.8-Max
- Serviço em produção já estável, com prompts profundamente ajustados: o Qwen3.8-Max continua sendo um modelo de produção confiável; não há por que fazer upgrade só por fazer.
- Tarefas principais parecidas com BioMystery e JobBench: nessas direções o ganho é limitado, e o custo de migração pode superar o benefício.
- Necessidade de auto-hospedagem com pesos abertos: o Qwen3.8-2.4T-A95B tem pesos abertos, e os materiais não mencionam uma versão com pesos abertos do Qwen4-Max.
- Chamada via APIYI com necessidade de uso imediato: enquanto o
qwen4-maxainda não estiver disponível na plataforma, oqwen3.8-maxé a opção pronta para usar.
| Sua situação | Recomendação |
|---|---|
| Uso predominante de agentes e chamadas de ferramentas, com foco em reduzir custos | Priorize avaliar o Qwen4-Max e meça o custo real no nível High |
| Precisa de mais de 128K em uma única saída | Só o Qwen4-Max atende |
| Produção estável, principalmente perguntas e respostas gerais | Mantenha o Qwen3.8-Max e faça avaliações de regressão quando houver folga |
| Precisa de auto-hospedagem com pesos abertos | Continue com o Qwen3.8-2.4T-A95B |
| O acesso atual é via APIYI | Continue com qwen3.8-max e faça a migração gradual depois que estiver disponível |
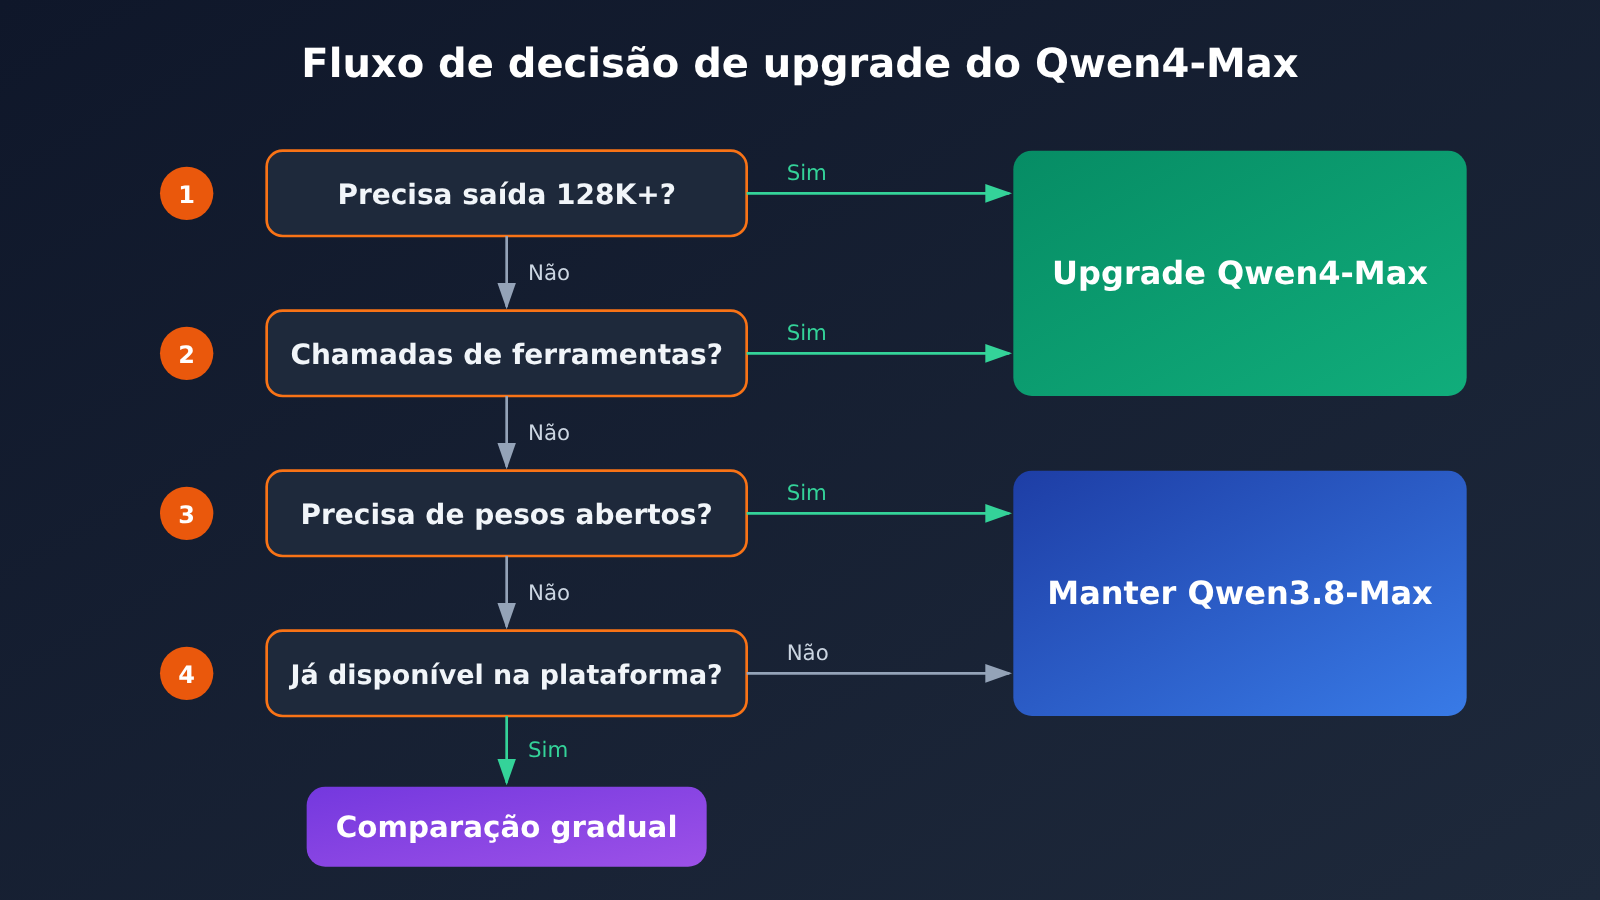
Recomendações de decisão: Qwen4-Max vs Qwen3.8-Max
Se for para resumir em uma frase: agentes, saídas longas e negócios intensivos em cache valem a atualização; negócios gerais e estáveis podem esperar sem pressa. Entre os três ganhos da atualização, a queda de 25% no preço unitário é certa; a economia de 20% a 30% em tokens são dados oficiais em benchmarks específicos; e a redução de 62% por tarefa só deve chegar perto disso se as condições de cache e de rodadas de ferramentas do seu próprio cenário acompanharem.
💡 Sugestão de escolha: antes de decidir, vale a pena rodar um conjunto com suas próprias tarefas reais e comparar o custo por tarefa e a qualidade dos resultados, em vez de olhar apenas para as tabelas de pontuação. Com o APIYI apiyi.com, você pode usar a mesma chave API para primeiro rodar a linha de base do
qwen3.8-maxe, quando oqwen4-maxestiver disponível, comparar diretamente no mesmo código.
Perguntas frequentes (FAQ)
P1: Qual é a relação entre o Qwen4-Max e o Qwen3.8-Max?
Os dois são flagships de nível 2.4T da família Qwen. O Qwen3.8-Max foi lançado em 2026-08-03, e a 0902 é a versão atualizada de setembro; o Qwen4-Max saiu em 2026-11-16, com arquitetura nova, parâmetros ativados por vez reduzidos de 95B para 71B, limite de saída elevado para 393K e preço de tabela 25% mais baixo.
P2: Se economizo 20% a 30% de tokens, a conta cai 20% a 30%?
Mais do que isso, e nem sempre. O preço unitário em si já caiu 25% e, somando a redução de tokens, em teoria o custo da mesma tarefa pode cair cerca de 51%. Só que os dados de economia de tokens vêm do benchmark oficial Work360 — quanto o seu negócio vai economizar só dá para saber testando. E se você usar o nível xhigh, como mostra o snapshot da Arena, o custo por tarefa pode até ficar maior.
P3: O Qwen4-Max está em 6º na Arena. Esse ranking é confiável?
Dá para encarar só como resultado preliminar. No snapshot público do leaderboard (2026-11-14), o Qwen4-Max tem apenas 1,814 votos e está marcado como Preliminary; a geração anterior, a 0902, tem 23,030 votos — uma diferença de cerca de 12 vezes. A pontuação 1750 bate com o que a própria empresa divulgou, mas a posição ainda vai mudar conforme os votos se acumulam.
P4: Já dá para chamar o qwen4-max pela APIYI agora?
Até 2026-11-16 11:00 ainda não: o `qwen4-max` ainda não está no catálogo, mas vamos disponibilizar o quanto antes. No momento estão disponíveis `qwen3.8-max`, `qwen3.8-max-0902` e a versão de pesos abertos `qwen3.8-2.4t-a95b`. Para os modelos e preços mais recentes, consulte a lista de modelos da plataforma APIYI em apiyi.com; novos usuários podem usar a cota gratuita de teste para rodar a linha de base primeiro.
P5: Na migração, basta trocar o ID do modelo?
Não basta. No mínimo você também precisa definir explicitamente o `reasoning_effort` (o padrão muda de xhigh para high), relaxar `max_tokens` e os limites de armazenamento downstream conforme a necessidade, verificar entradas muito longas que cheguem perto de 1M e reavaliar o custo de escrita em cache. No nível de protocolo, usando a interface compatível com OpenAI `https://api.apiyi.com/v1`, basta alterar o campo `model` no código.
P6: Ainda vale a pena continuar usando o Qwen3.8-Max?
Vale. Ele continua sendo um flagship de nível 2.4T, com janela de contexto de 1M, saída de 128K, modos de raciocínio e não-raciocínio completos, além da versão de pesos abertos. O Qwen4-Max tem ganhos bem pequenos em benchmarks como BioMystery e JobBench; para esse tipo de negócio, um Qwen3.8-Max rodando estável dá conta tranquilamente do tráfego de produção.
Qwen4-Max vs Qwen3.8-Max: principais conclusões
- Mesma escala, menos ativação: o backbone de 2.4T continua o mesmo, e a ativação por vez cai de 95B para 71B, cerca de 25% menos.
- Preço unitário 25% menor: entrada $2→$1.5, saída $6→$4.5, leitura de cache cai cerca de 70%, e passa a haver cobrança por escrita em cache.
- Saída quase triplica: o máximo de saída vai de 128K para 393K, enquanto o máximo de entrada foi reduzido para 991K.
- Ganhos concentrados em agentes: AutomationBench, Terminal-Bench e HealthBench avançaram de forma clara; BioMystery quase não mudou.
- Dois pontos para não exagerar: dos 62% de redução de custo, apenas cerca de 51% se explica; o 6º lugar na Arena tem apenas 1,814 votos e é um resultado preliminar.
- Migração não é só trocar o ID: atenção ao valor padrão de
reasoning_effort, ao limite demax_tokense à política de cache. - Situação atual na APIYI:
qwen4-maxainda não está disponível; continue usandoqwen3.8-maxe, quando ele entrar, faça a migração gradual.
Resumo
Principais conclusões da comparação entre Qwen4-Max e Qwen3.8-Max:
- Custo: a queda de 25% no preço unitário é um ganho garantido; a economia de tokens de 20% a 30% precisa ser comprovada com testes no seu próprio negócio; e a redução de 62% tem cerca de 11 pontos percentuais sem origem esclarecida.
- Capacidade: os avanços são claros em agentes, chamada de ferramentas, saúde e gráficos; alguns benchmarks ficaram praticamente empatados; e as pontuações são todas autodeclaradas pelo fornecedor.
- Migração: o protocolo não muda, mas o nível padrão de raciocínio, o limite de saída e a cobrança de cache mudaram; é preciso conferir item por item na lista.
O Qwen3.8-Max continua sendo um modelo de produção confiável. A atualização deve ser uma decisão gradual baseada em dados, e não uma troca total só porque surgiu uma versão nova. A recomendação é primeiro usar o qwen3.8-max via APIYI apiyi.com para estabelecer uma linha de base de custo e qualidade; quando o qwen4-max estiver disponível, compare os dois diretamente na mesma interface.
📚 Referências
- Blog oficial do Qwen3.8: notas de lançamento do Qwen3.8-Max, com parâmetros, janela de contexto e preço oficial
- Link:
qwen.ai/blog?id=qwen3.8 -
Observação: de onde vêm as especificações e os preços da região de Singapura da geração anterior
-
Hugging Face – Qwen3.8-2.4T-A95B: versão de pesos abertos do Qwen3.8
- Link:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Observação: model card e download dos pesos para quem precisa fazer o self-hosting
-
Blog oficial do Qwen: post de lançamento do Qwen4-Max e o comparativo de pontuações no mesmo gráfico
- Link:
qwen.ai/blog -
Observação: de onde vêm as mudanças de arquitetura, as pontuações autodeclaradas e os dados de tokens e de custo por tarefa
-
arena.ai Code Arena WebDev: ranking de batalha de modelos mantido por terceiros
- Link:
arena.ai - Observação: este artigo usa o snapshot de 2026-11-14; as posições mudam conforme o número de votos
Autor: Equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial do site da APIYI. Modelos e preços podem ser consultados no centro de documentação em docs.apiyi.com


