
Nota do autor: Este artigo compara Qwen4-Max e GPT-6 Astra em benchmarks, especificações de contexto e preços de entrada e saída, e mostra, por tipo de tarefa, qual lado compensa mais.
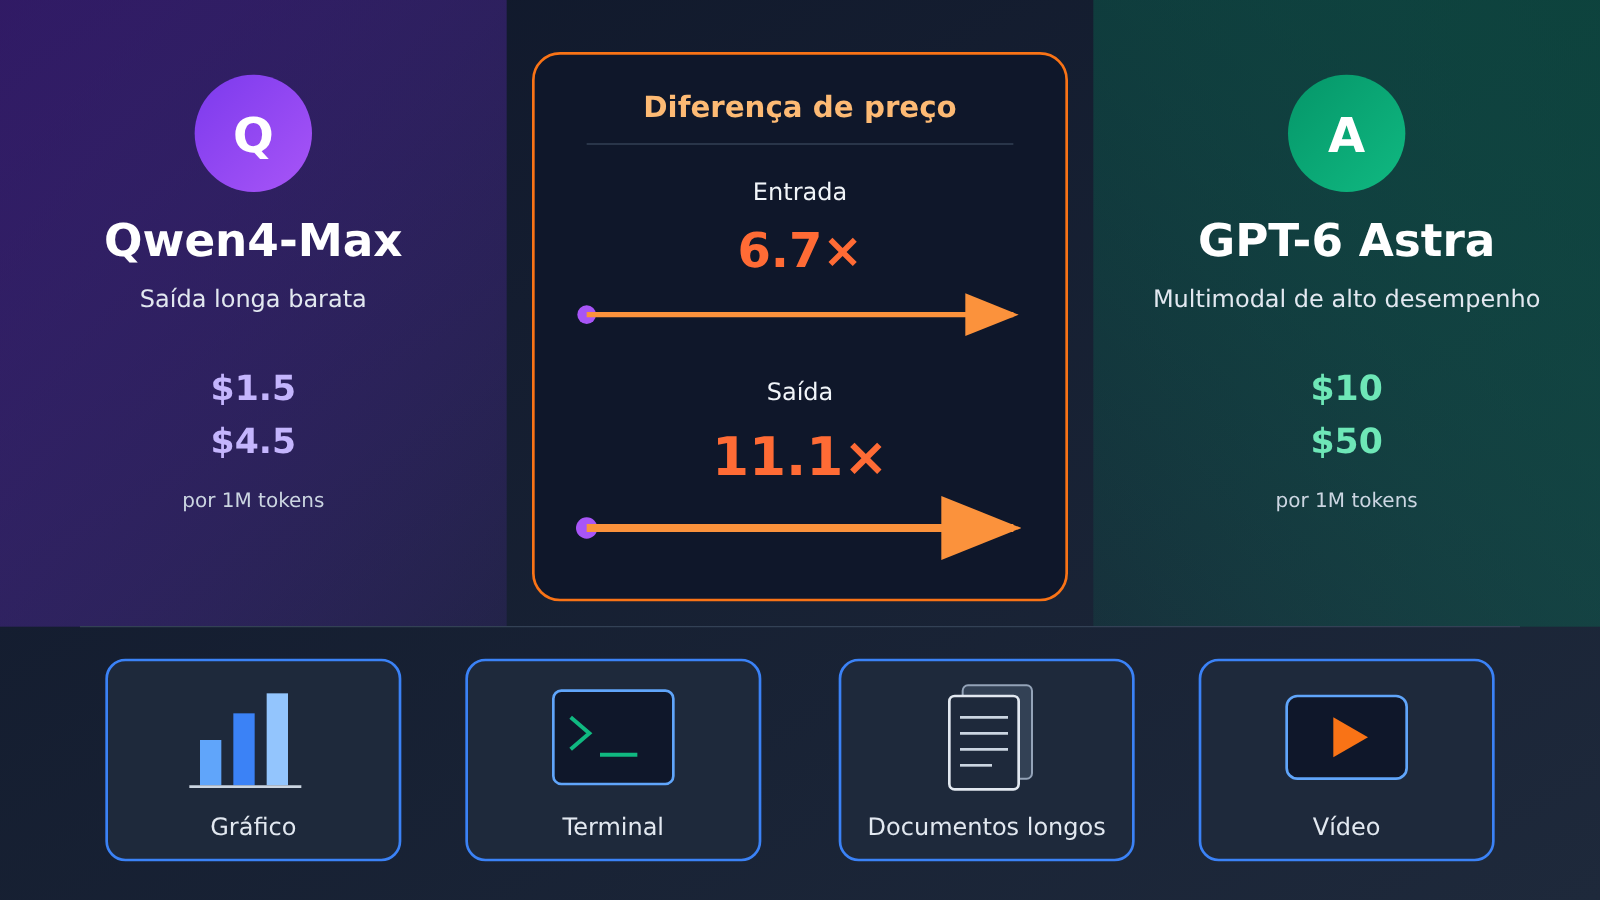
Conclusão antecipada: o preço de entrada do GPT-6 Astra é cerca de 6.7 vezes o do Qwen4-Max, e o preço de saída é cerca de 11.1 vezes. Esse prêmio paga por coisas bem concretas: principalmente pontuações mais altas em três tipos de tarefa — compreensão de gráficos, operação de terminal e repositórios de código, e compreensão de vídeo. Em agentes de escritório e em algumas avaliações especializadas, o Qwen4-Max, por sua vez, sai na frente.
Este não é um artigo sobre “quem esmaga quem em tudo”. Os dois modelos têm pontos fortes claros e pontos fracos claros. Este artigo compara apenas esses dois modelos. As fontes factuais são de quatro tipos: a comparação oficial da Qwen no mesmo gráfico, o texto original da documentação da OpenAI, um snapshot do ranking público da Arena (2026-11-14) e a tabela de preços da plataforma APIYI.
Valor central: depois de ler este artigo, você terá uma tabela de seleção organizada por tarefa e orçamento, saberá onde o dinheiro extra do Astra está sendo gasto e também entenderá como funciona a regra de acréscimo sobre a solicitação inteira quando a entrada do Astra ultrapassa 272K.
Qwen4-Max vs. GPT-6 Astra: principais diferenças
Primeiro, vamos colocar as especificações e os preços em uma tabela. Os dados de especificações e preços vêm, respectivamente, da tabela de preços do QwenCloud e da documentação oficial da OpenAI, com data de coleta em 2026-11-16; todos os preços são por 1M tokens.
| Critério de comparação | Qwen4-Max | GPT-6 Astra | Vantagem |
|---|---|---|---|
| Arquitetura / posicionamento | Backbone de 2.4T / 71B ativos + 328B N-gram Embedding, visão nativa | O modelo generalista mais forte da OpenAI em produção no momento | Cada um com seu posicionamento |
| Janela de contexto | 1M | 1,050,000 | Praticamente empatado |
| Entrada máxima | 991K (983K no modo de raciocínio) | 922K | Qwen4-Max |
| Saída máxima | 393K (cadeia de raciocínio máxima de 262K) | 128K | Qwen4-Max |
| Níveis de raciocínio | Modo de raciocínio | reasoning.effort: low / medium / high / xhigh / max |
Astra é mais granular |
| Preço de entrada | $1.5 | $10 (multiplicado por 2 quando a entrada ultrapassa 272K) | Qwen4-Max |
| Preço de saída | $4.5 | $50 (multiplicado por 1.5 quando a entrada ultrapassa 272K) | Qwen4-Max |
| Data de corte de conhecimento | Não informado na referência | 2026-04-30 | — |
Diferenças de janela de contexto entre Qwen4-Max e GPT-6 Astra
Os dois modelos anunciam janelas de contexto na casa de 1M; a diferença está na distribuição entre entrada e saída. O Qwen4-Max consegue gerar até 393K tokens por chamada, e esse limite é bastante útil para gerar relatórios longos, reescrever blocos grandes de código e fazer extração estruturada em lote. O limite de saída do Astra é 128K, suficiente para tarefas do dia a dia; para gerações muito longas, é preciso dividir.
No quesito entrada máxima, os 991K do Qwen4-Max também são um pouco superiores aos 922K do Astra. Na prática, na hora de escolher, vale mais a pena ficar de olho no gatilho de cobrança do Astra: assim que a entrada ultrapassa 272K, o preço unitário da solicitação inteira sobe. A seção de custos mais abaixo detalha essa conta.
Qwen4-Max vs GPT-6 Astra: análise detalhada dos resultados de benchmark
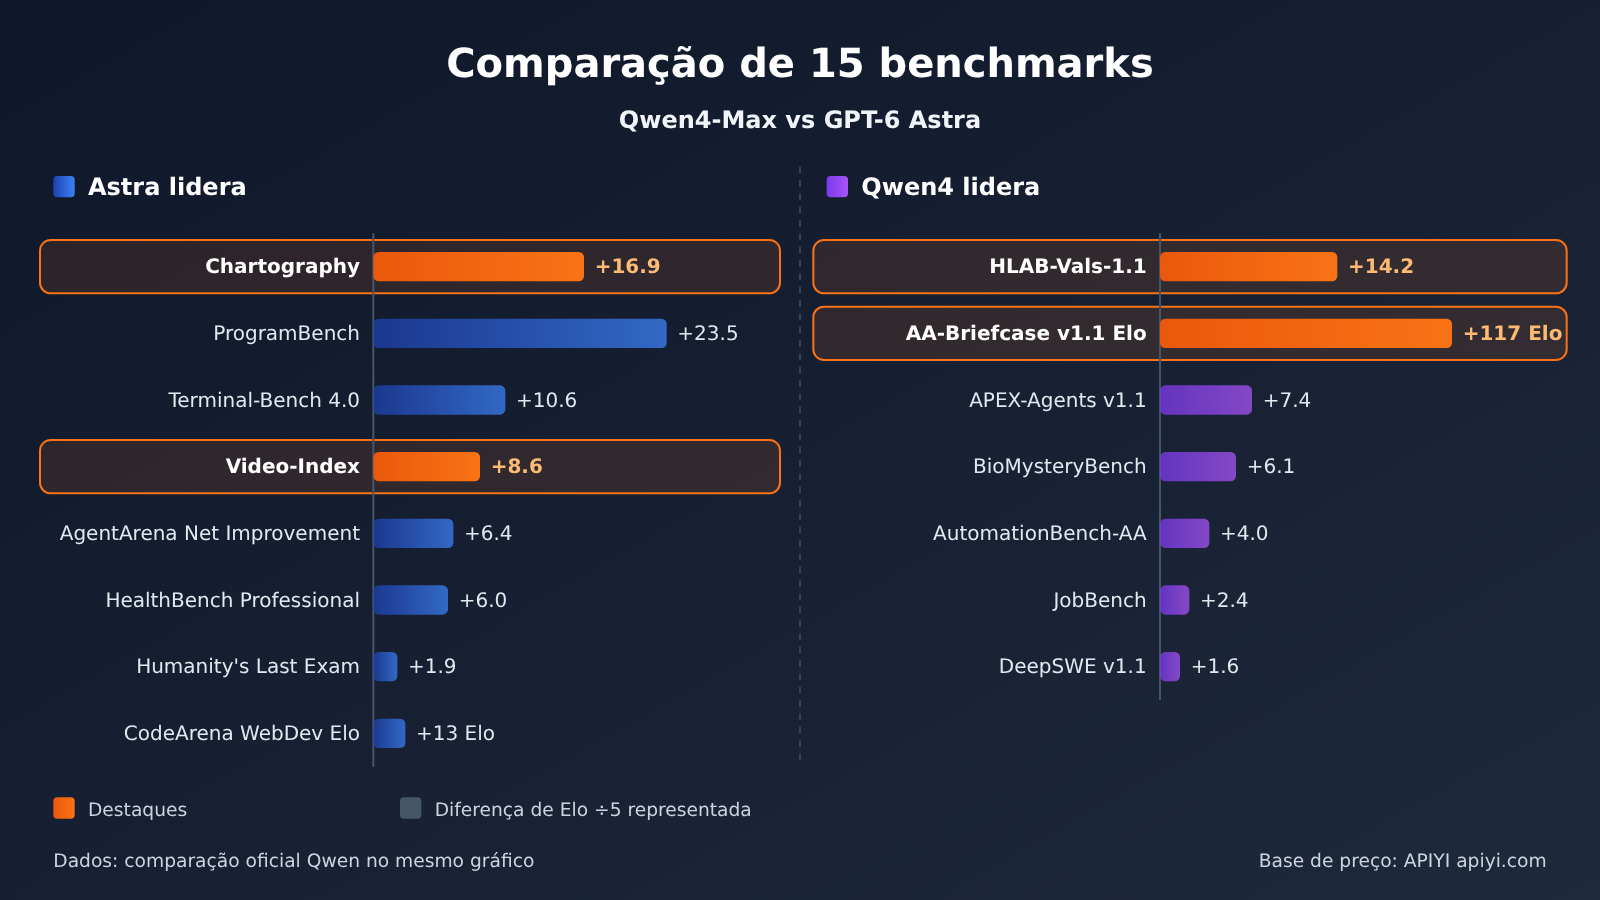
Os scores abaixo vêm todos de uma comparação no mesmo gráfico, auto-relatada pela própria Qwen. Esse tipo de comparação, quando publicada por apenas uma das partes, precisa ser lida com certa margem de cautela. Ainda assim, várias vantagens evidentes do Astra na tabela também foram listadas pela própria Qwen oficial, o que aumenta relativamente a confiabilidade.
| Benchmark | Qwen4-Max | GPT-6 Astra | Diferença | Quem lidera |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
Vantagens reais do GPT-6 Astra: gráficos, terminal e vídeo
A maior diferença está na compreensão de gráficos. No Chartography, o Astra marca 71,1 e o Qwen4-Max, 54,2 — uma diferença de 16,9 pontos. Se o seu negócio precisa ler gráficos de relatórios financeiros, capturas de tela de painéis de monitoramento ou gráficos científicos, essa diferença aparece diretamente na precisão de extração e é muito difícil recuperar só com comandos.
Terminal e repositórios de código formam o segundo bloco. No Terminal-Bench 4.0, a diferença é de 10,6 pontos; no ProgramBench, de 23,5 pontos. Esses dois testes avaliam a execução de comandos em várias etapas e a construção completa de programas — justamente as partes mais exigentes para agentes de programação. No DeepSWE, o Qwen4-Max leva uma pequena vantagem de 1,6 ponto, o que mostra que ele não é fraco para corrigir um problema isolado. Mas quando a tarefa vira “montar um projeto no terminal ao longo de uma cadeia longa”, o Astra é mais estável.
A compreensão de vídeo não pode ficar de fora. No Video-Index, o Astra faz 76,7 contra 68,1, uma liderança de 8,6 pontos. O Qwen4-Max até tem suporte nativo a visão, mas ainda fica atrás na compreensão de vídeo. Equipes que precisam fazer moderação de conteúdo de vídeo, busca de trechos ou resumo de vídeos educacionais devem colocar esse item no topo da lista de seleção.
Vantagens reais do Qwen4-Max: agentes de escritório e avaliações especializadas
O HLAB-Vals-1.1 é o item em que o Qwen4-Max lidera com mais clareza, com 21,3 contra 7,1 — diferença absoluta de 14,2 pontos, quase 3 vezes em termos proporcionais. No AA-Briefcase v1.1 Elo, a vantagem é de 117 pontos (1686 contra 1569). Esse tipo de avaliação tende a favorecer tarefas de agentes voltadas a documentos comerciais e fluxos de escritório; no sistema Elo, uma diferença de 117 pontos é bastante significativa.
APEX-Agents (+7,4), AutomationBench-AA (+4,0) e JobBench (+2,4) também são itens em que o Qwen4-Max lidera. Vistos em conjunto, a conclusão é: em cenários de automação de fluxos e agentes de escritório, o Qwen4-Max não é apenas mais barato — as pontuações também são maiores.
Captura do ranking público do Code Arena (2026-11-14)
O ranking de terceiros pode servir como referência cruzada. A captura do ranking público do Code Arena WebDev, da arena.ai, mostra que GPT-6 Astra (Max) ocupa o 5º lugar, com 1763 pontos, 8.685 votos e custo de US$ 9,43 por tarefa. Já Qwen4-Max (xHigh) está em 6º lugar, com 1750 pontos, marcado como Preliminary, 1.814 votos e custo de US$ 4,18 por tarefa.
Uma diferença de 13 pontos de Elo no cenário WebDev coloca os dois no mesmo patamar, mas o custo por tarefa é mais que o dobro. Vale notar que Qwen4-Max ainda tem menos votos, então a posição pode continuar oscilando; é bom acompanhar de perto.
Comparação de preços de entrada e saída entre Qwen4-Max e GPT-6 Astra
A tabela de preços é dividida em duas partes: preço oficial e preço atual da APIYI. Os preços oficiais vêm dos textos originais da documentação da QwenCloud e da OpenAI, com data de coleta em 16/11/2026, em US$ por 1M tokens.
| Item de cobrança | Qwen4-Max (QwenCloud) | GPT-6 Astra (documentação da OpenAI) | Múltiplo |
|---|---|---|---|
| Entrada | $1.5 | $10 | 6.7× |
| Saída | $4.5 | $50 | 11.1× |
| Leitura de cache | $0.075 | $1 | 13.3× |
| Gravação de cache | 5 minutos $1.875 / 1 hora $3 | $12.5 | 4.2–6.7× |
| Entrada acima de 272K | A documentação de referência não lista faixas | toda a solicitação: entrada e cache ×2, saída ×1.5 | — |
A armadilha da cobrança em dobro do GPT-6 Astra para entradas acima de 272K
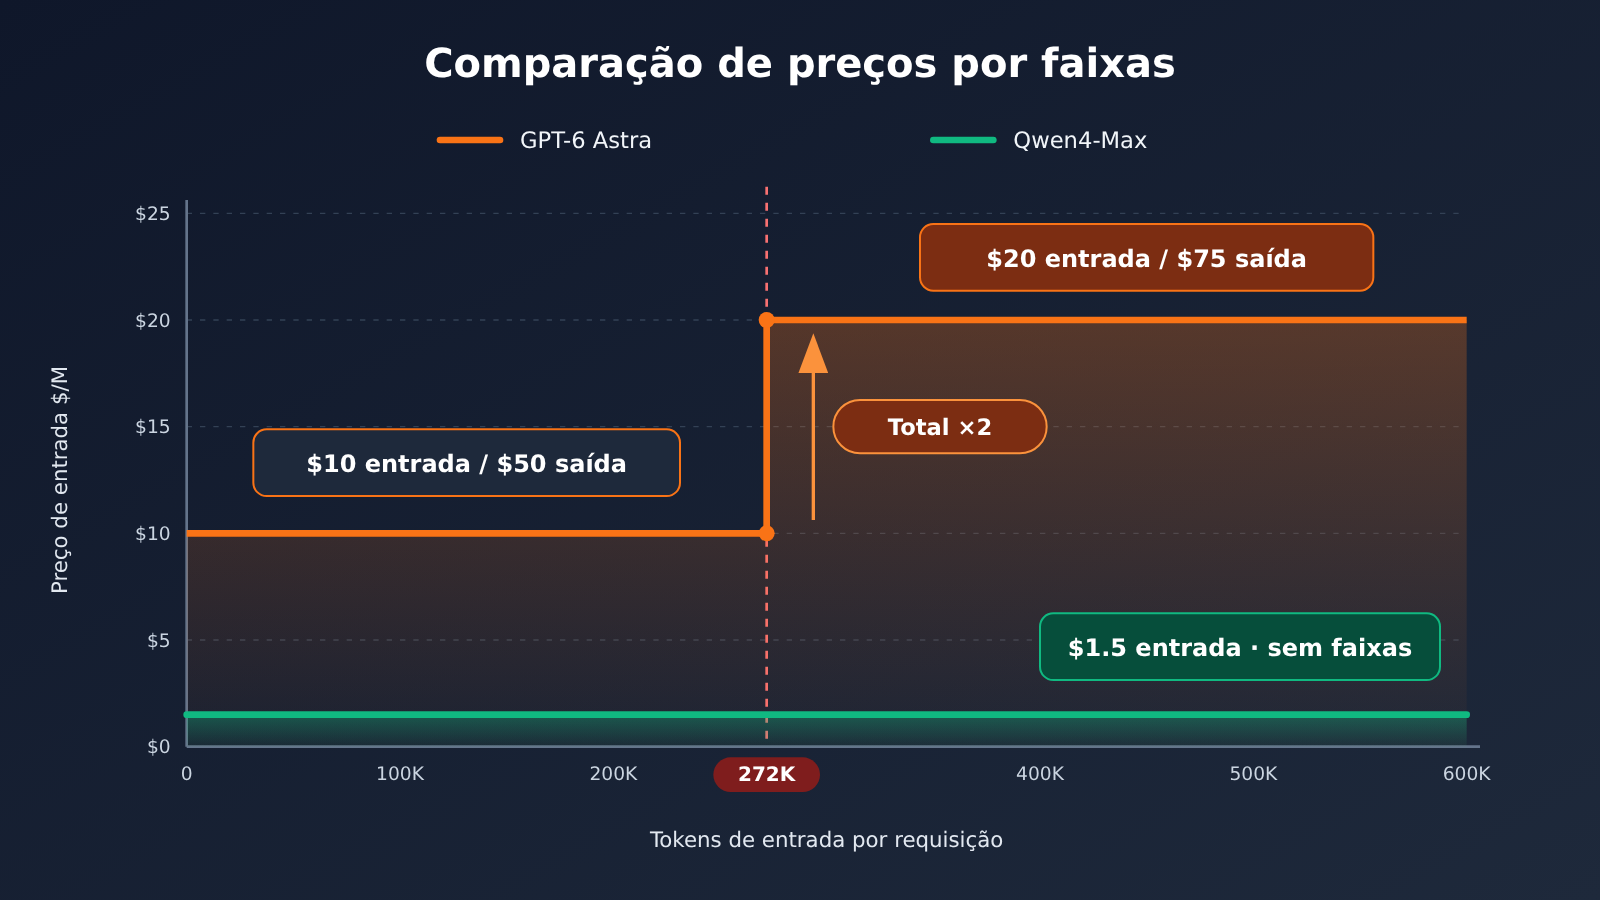
A regra na documentação da OpenAI é a seguinte: quando a entrada de uma única requisição ultrapassa 272K, o pedido inteiro passa a ser cobrado em dobro na entrada e no cache, e a saída em 1,5×. O aumento não incide só sobre a parte que excede 272K — a requisição toda é cobrada pelo preço mais alto. Muitas equipes, ao estimar o custo de RAG com documentos longos ou de contexto completo de um repositório de código, deixam esse detalhe passar.
Vamos fazer as contas com alguns tipos típicos de requisição. Os preços seguem a tabela oficial, sem considerar cache por enquanto.
| Cenário | Qwen4-Max | GPT-6 Astra | Diferença |
|---|---|---|---|
| 270K de entrada + 20K de saída em uma única requisição | cerca de $0.50 | cerca de $3.70 | cerca de 7,4× |
| 400K de entrada + 20K de saída em uma única requisição | cerca de $0.69 | cerca de $9.50 (regra de 272K já acionada) | cerca de 13,8× |
| Mensal: 100 milhões de entrada + 10 milhões de saída (todas as requisições dentro de 272K) | cerca de $195 | cerca de $1.500 | cerca de 7,7× |
| O mesmo, mas com todas as requisições acima de 272K de contexto longo | cerca de $195 (estimativa pelo preço padrão) | cerca de $2.750 | cerca de 14× |
A segunda linha é a que deixa tudo mais claro. A entrada vai de 270K para 400K, os tokens aumentam menos de 50%, mas o custo por requisição do Astra salta de $3.70 para $9.50. Por isso, ao desenhar fluxos de contexto longo para o Astra, o ideal é manter a entrada de cada requisição abaixo de 272K. Dá para fazer um recorte na recuperação ou resumir em blocos primeiro e só então entregar o resultado ao Astra para a inferência final.
Preços atuais e disponibilidade dos modelos no APIYI
Os preços atuais do APIYI (2026-11-16) são os seguintes. A lista de modelos da plataforma é a referência final.
gpt-6-astra: entrada US$ 10, saída US$ 50, leitura de cache US$ 1; na faixa de 272.001–1.050.000 tokens a entrada é de US$ 20, alinhado com os degraus oficiais.qwen3.8-max: entrada US$ 1,65, saída US$ 4,95, leitura de cache US$ 0,20625.qwen4-max: ainda não disponível — vamos subir esse modelo o mais rápido possível. Depois do lançamento, consulte o ID do modelo e o preço na lista de modelos em apiyi.com.
💰 Dica de custo: antes de o
qwen4-maxentrar no ar, você pode usar oqwen3.8-maxpara validar os prompts e os fluxos de chamada de ferramentas da família Qwen; quando o novo modelo estiver disponível, basta trocar o parâmetromodel. As duas famílias usam a mesma Key no APIYI apiyi.com, e a cobrança também fica no mesmo lugar, o que facilita comparar o gasto real dos dois lados.
Como escolher entre Qwen4-Max e GPT-6 Astra conforme a tarefa
Juntando benchmarks e preços, dá para dar uma recomendação por tipo de tarefa.
| Tipo de tarefa | Recomendação | Base | Plataformas disponíveis |
|---|---|---|---|
| Compreensão de gráficos / capturas de tela | GPT-6 Astra | Chartography lidera por 16,9 pontos | APIYI apiyi.com, OpenAI oficial |
| Operação de terminal e construção de repositório de código completo | GPT-6 Astra | Terminal-Bench +10,6, ProgramBench +23,5 | APIYI, OpenAI oficial |
| Compreensão de vídeo | GPT-6 Astra | Video-Index lidera por 8,6 pontos | APIYI, OpenAI oficial |
| Correção de issue única / WebDev | Qwen4-Max (custo-benefício) | Ligeira vantagem no DeepSWE, apenas 13 Elo de diferença no WebDev, custo por tarefa cerca de metade | QwenCloud; APIYI aguardando lançamento |
| Agentes de escritório e automação de processos | Qwen4-Max | AA-Briefcase +117, APEX +7,4, HLAB-Vals +14,2 | QwenCloud; APIYI aguardando lançamento |
| Processamento em lote com contexto longo (>272K) | Qwen4-Max | Sem o acréscimo de preço por pedido inteiro do Astra, saída máxima de 393K | QwenCloud; APIYI aguardando lançamento |
| Perguntas médicas especializadas | GPT-6 Astra | HealthBench Professional lidera por 6,0 | APIYI, OpenAI oficial |
Cenários em que vale escolher o GPT-6 Astra
- Controle de qualidade multimodal: gráficos, capturas de painéis e trechos de vídeo precisam de interpretação com alta precisão, e o custo de errar é muito maior do que o gasto com tokens.
- Agentes de código autônomos: quando é preciso executar comandos em cadeias longas dentro de um terminal sandbox e montar programas completos, a diferença no ProgramBench afeta diretamente a taxa de sucesso das tarefas.
- Requisições de baixo volume e alto valor: o volume de chamadas não é grande, mas cada resultado influencia decisões; nesse caso, o preço de saída 11 vezes maior tem peso limitado no orçamento total.
Cenários em que vale escolher o Qwen4-Max
- Tarefas de texto com alto throughput: processamento de documentos, resumos e extração em grande volume diário, onde a diferença de 11,1 vezes no preço de saída determina diretamente a fatura mensal.
- Agentes de escritório: circulação de formulários, tratamento de documentos comerciais e fluxos de automação — o Qwen4-Max já tem pontuação mais alta nesses casos.
- Entradas e saídas muito longas: contratos de centenas de K, revisão completa de repositórios de código e relatórios que precisam ser gerados de uma vez com centenas de milhares de tokens.
Recomendações de decisão entre Qwen4-Max e GPT-6 Astra
Para equipes que já usam o Astra e estão com o orçamento apertado, a abordagem mais segura é o roteamento híbrido, em vez de uma migração total. As três categorias de requisições — gráficos, terminal e vídeo — continuam indo para o Astra; as demais requisições de texto e de Agents de escritório migram para a linha Qwen; e as requisições de contexto longo do Astra ficam limitadas a 272K. Assim você preserva as capacidades em que o Astra realmente lidera e corta justamente a parte da conta em que a diferença de preço é maior.
Antes de trocar de modelo, vale conferir estes três passos:
- Confira o modelo: na lista de modelos da APIYI apiyi.com, verifique se
gpt-6-astraeqwen3.8-maxestão disponíveis, e fique de olho no status de disponibilidade doqwen4-max. Não preencha o ID do modelo de memória. - Compare os preços: confira o preço unitário de entrada, de saída e de leitura de cache, além da faixa de entrada de $20 do Astra acima de 272,001 tokens. Calcule a fatura mensal com base na distribuição real de tokens dos seus logs.
- Verifique o protocolo: os dois modelos podem ser chamados pela interface compatível com OpenAI em
https://api.apiyi.com/v1— basta definirbase_urlcom esse endereço na inicialização do SDK. O Astra também suporta os dois endpoints/v1/responsese/v1/chat/completions; quando precisar ajustar o nível de raciocínio comreasoning.effort, recomendo validar o comportamento dos parâmetros primeiro no endpoint Responses.
💡 Sugestão de escolha: envie o mesmo lote de amostras de negócio para
gpt-6-astrae para os modelos da linha Qwen, registrando a taxa de acerto e o custo por requisição — isso é mais confiável do que olhar rankings. Com a APIYI apiyi.com, dá para fazer a comparação trocando apenas o parâmetromodelcom uma única Key, e novos usuários ainda têm cota gratuita de teste para rodar primeiro com uma amostra pequena.
Perguntas frequentes (FAQ)
P1: Qual é o posicionamento do Qwen4-Max e do GPT-6 Astra?
O Qwen4-Max foi lançado em 2026-11-16, com estrutura de backbone de 2.4T / 71B ativados, visão nativa e contexto de 1M. Já o GPT-6 Astra é o modelo generalista mais forte da OpenAI atualmente em produção, com janela de contexto de 1,050,000 tokens e cinco níveis de raciocínio, de low a max.
P2: O Astra custa bem mais — os pontos extras valem a pena?
Depende da tarefa. Em compreensão de gráficos (+16.9), ProgramBench (+23.5), Terminal-Bench (+10.6) e compreensão de vídeo (+8.6), a vantagem do Astra é concreta, e para essas tarefas vale pagar o prêmio. Já em Agent de escritório, HLAB-Vals e AA-Briefcase, o Qwen4-Max tem pontuação mais alta e preço mais baixo — continuar pagando a mais pelo Astra simplesmente não compensa.
P3: Esses benchmarks são confiáveis?
Os 15 benchmarks são todos comparações feitas no mesmo gráfico e divulgadas pela própria Qwen — são dados de primeira parte, então é bom ler deixando uma margem de segurança. O snapshot do ranking público da arena (2026-11-14) serve como referência cruzada de terceiros, e a diferença entre os dois em WebDev também é de apenas 13 Elo. Só que o Qwen4-Max ainda aparece marcado como Preliminary no ranking, e com menos votos.
P4: Como funciona a regra do Astra para entradas acima de 272K?
Quando a entrada de uma única requisição passa de 272K, a entrada e o cache de toda a requisição são cobrados em dobro (2x) e a saída a 1.5x, com o acréscimo incidindo sobre a requisição inteira, não apenas sobre o excedente. Por exemplo: 400K de entrada mais 20K de saída custa cerca de $9.50, aproximadamente 2.5 vezes o valor de 270K de entrada com a mesma saída.
P5: Já dá para chamar o Qwen4-Max via APIYI?
No momento o `qwen4-max` ainda não está disponível no catálogo, mas vamos colocá-lo no ar o quanto antes. Enquanto isso, você pode usar o `qwen3.8-max` ($1.65 / $4.95 / leitura de cache $0.20625) para validar fluxos de trabalho da família Qwen. O `gpt-6-astra` já está disponível, com endereço de acesso unificado em `https://api.apiyi.com/v1`; os modelos exatos são os da lista de modelos em apiyi.com.
P6: Quais são as fraquezas claras do Qwen4-Max?
Compreensão de gráficos, compreensão de vídeo, operações de terminal em cadeias longas e ProgramBench ficam claramente atrás do Astra, e no HealthBench Professional também fica 6 pontos abaixo. Se o core do seu negócio está nesses cenários, migrar para o Qwen4-Max só para economizar pode acabar anulando a economia com uma taxa de sucesso menor.
Qwen4-Max vs GPT-6 Astra: Principais Pontos (Key Takeaways)
- Diferença de preço: o preço de entrada do Astra é 6,7 vezes o do Qwen4-Max, o de saída é 11,1 vezes e a leitura de cache é 13,3 vezes.
- Vantagens reais do Astra: Chartography 71,1 contra 54,2, Video-Index 76,7 contra 68,1, e também lidera na construção em terminal e repositório de código.
- Vantagens reais do Qwen4: HLAB-Vals 21,3 contra 7,1, AA-Briefcase 1686 contra 1569, e o agente de escritório é mais forte no geral.
- Armadilha do contexto longo: quando a entrada do Astra passa de 272K, todo o pedido recebe acréscimo — entrada ×2, saída ×1,5.
- Limite de saída: o Qwen4-Max gera no máximo 393K, o Astra 128K.
- Como começar: no APIYI, use a mesma Key para comparar
gpt-6-astracom os modelos da linha Qwen; oqwen4-maxestá em processo de disponibilização.
Resumo
Comparando Qwen4-Max com GPT-6 Astra, há três conclusões centrais:
- O preço premium do Astra corresponde a três capacidades reais: compreensão de gráficos, construção em terminal e repositório de código, e compreensão de vídeo — tarefas que valem o investimento.
- O Qwen4-Max não é apenas mais barato: ele pontua mais alto em agente de escritório e em vários benchmarks profissionais, além de ter um limite de saída maior.
- O contexto longo precisa ser calculado à parte: o limite de 272K do Astra faz o custo por requisição disparar; cortar a entrada para abaixo desse limite com recuperação de contexto é a forma mais direta de economizar.
Para a maioria das equipes, rotear de forma híbrida por tipo de tarefa é mais vantajoso do que trocar tudo de uma vez. A recomendação é fazer um teste A/B no APIYI apiyi.com com amostras reais do seu negócio e, só então, definir a proporção de alocação para cada tipo de requisição.
📚 Materiais de referência
- Documentação de modelos da OpenAI – GPT-6 Astra: especificações, contexto e níveis de raciocínio
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Descrição: fonte original do comprimento da janela de contexto, do máximo de entrada e saída e dos níveis de
reasoning.effort -
Página de preços da OpenAI: preço padrão e regra de cobrança acima de 272K
- Link:
developers.openai.com/api/docs/pricing -
Descrição: preço unitário de entrada, saída e leitura/escrita de cache, além da regra de acréscimo sobre o valor total da fatura em contextos longos
-
Ranking Code Arena WebDev do arena.ai: ranking público de terceiros (data do snapshot 2026-11-14)
- Link:
arena.ai - Descrição: referência cruzada entre posição no Elo, número de votos e custo por tarefa
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI; há mais materiais disponíveis no centro de documentação docs.apiyi.com


