
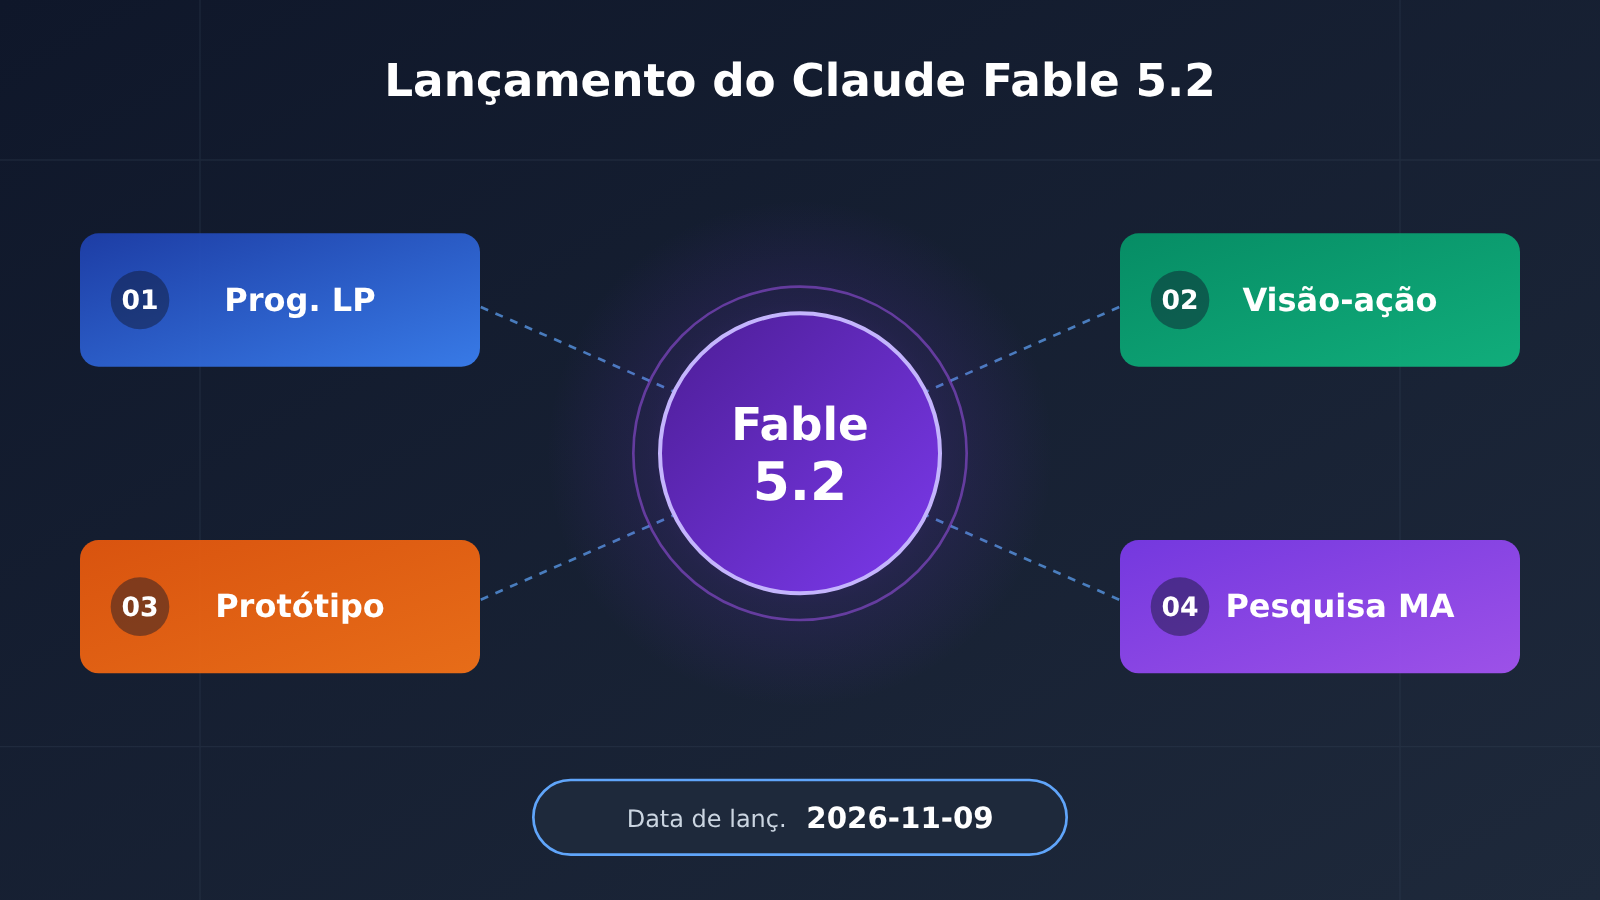
A Anthropic lançou oficialmente o Claude Fable 5.2 em 9 de novembro de 2026. Tanto a tabela oficial de capacidades quanto os rankings de terceiros mostram que ele supera claramente o 5.1 em tarefas difíceis e colaboração de longo prazo. Além disso, o preço padrão da API é 20% menor que o do 5.1.
Principal vantagem: este artigo segue a ordem “primeiro a conclusão, depois as evidências e, por fim, os limites” para ajudar você a entender em que o Claude Fable 5.2 se destaca, até que ponto ele é melhor e se vale a pena migrar agora para as suas tarefas.
Guia rápido de termos para entender as avaliações do Claude Fable 5.2
Algumas métricas de avaliação aparecem repetidamente a seguir. Se você as interpretar errado, pode confundir uma demonstração do fornecedor com uma validação independente ou entender uma pontuação parcial como uma taxa de aprovação.
- Agent: sistema de modelo capaz de usar ferramentas e executar tarefas em várias etapas consecutivas.
- Intelligence Index: índice geral de capacidades da Artificial Analysis (AA). É uma pontuação composta, não uma taxa de acerto.
- OSWorld partial: métrica de avaliação de operações em desktops que atribui pontos conforme o grau de conclusão. Não equivale à taxa de aprovação estrita de tarefas completas.
- RoboDojo Sim: avaliação de controle em um ambiente de robótica simulado. Não representa a taxa de sucesso de robôs reais.
- PCB: placa de circuito impresso, usada para acomodar e conectar componentes eletrônicos.
- Lean / prova formal: Lean é uma linguagem e ferramenta que permite ao computador verificar provas. Uma prova formal consiste em reescrever um argumento matemático como uma sequência rigorosa de etapas que a máquina possa verificar.
- Colaboração entre múltiplos Agents: vários instâncias de modelo dividem o trabalho, trocam informações e, por fim, consolidam os resultados.
Claude Fable 5.2 é tão bom assim? Primeiro, a conclusão; depois, o contexto do lançamento
Em uma frase: Claude Fable 5.2 teve avanços expressivos em programação difícil, tarefas de longo prazo e avaliações de visão para ação, mas não dá para dizer que ele é “o melhor em tudo”. Em algumas avaliações automatizadas e pontuações de preferência, ele ainda fica atrás de outros modelos.
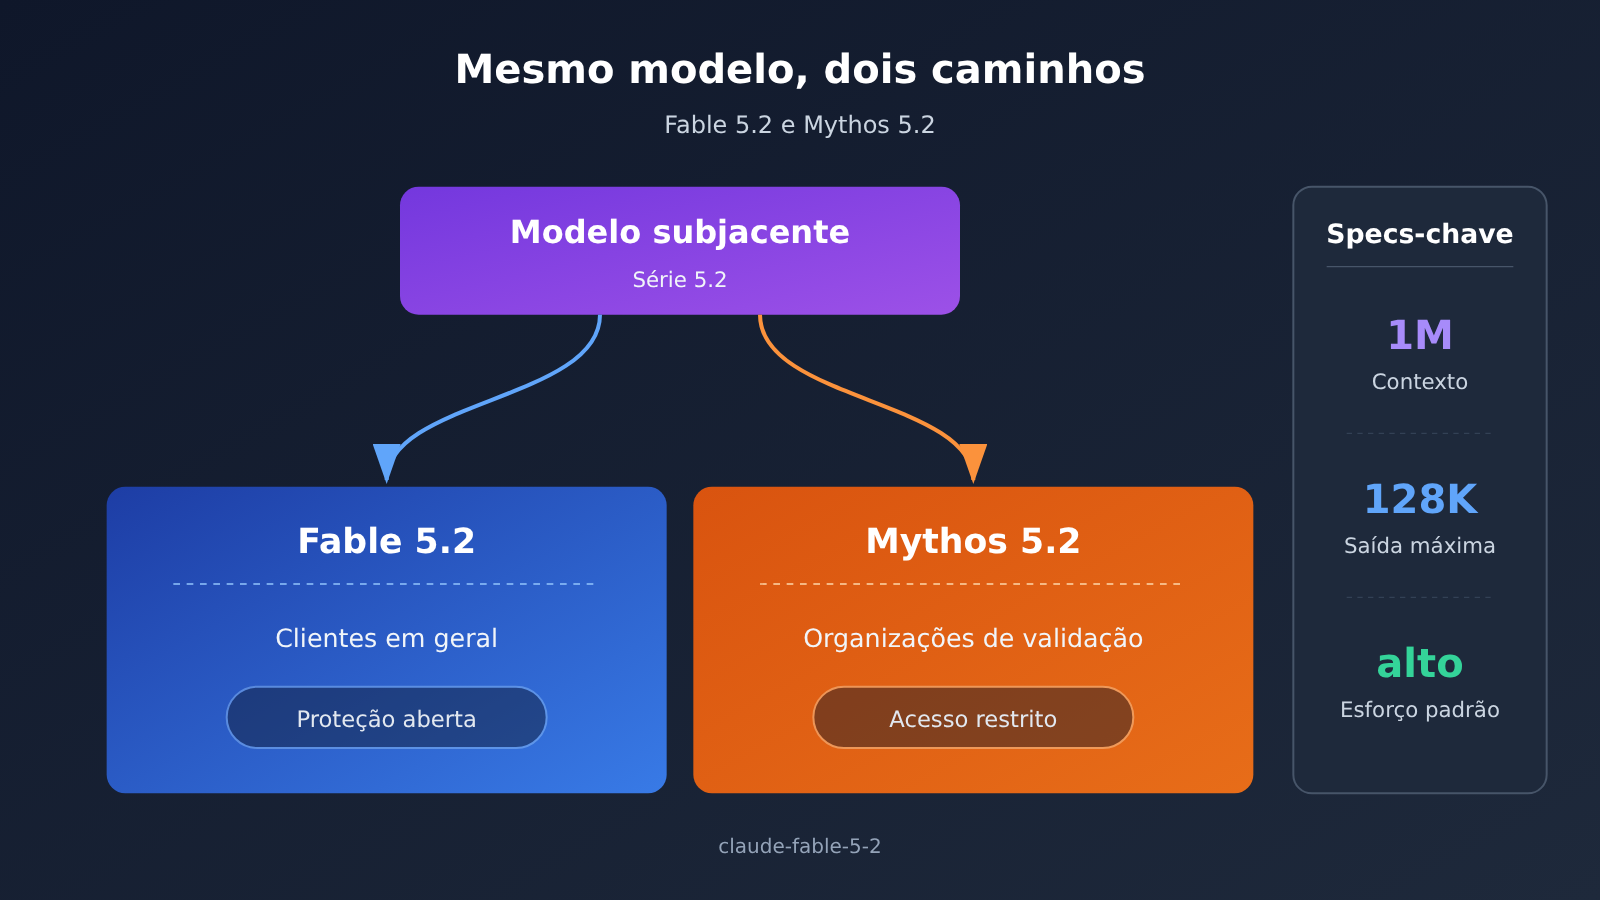
Antes, vale explicar o contexto do lançamento. Segundo a empresa, Fable e Mythos usam o mesmo modelo-base. As proteções de cibersegurança e biossegurança do Fable permitem que ele seja disponibilizado ao público em geral. Já o Mythos é restrito a organizações aprovadas. Por isso, não dá para atribuir diretamente ao Fable comum as capacidades ou pontuações exclusivas do Mythos.
Claude Fable 5.2: informações essenciais
| Informação | Detalhes | Tipo de fonte |
|---|---|---|
| Data de lançamento | 9 de novembro de 2026 | Anúncio oficial |
| Nome do modelo na API | claude-fable-5-2 |
Documentação oficial do modelo |
| Contexto / saída máxima | 1M de tokens / 128K tokens | Documentação oficial do modelo |
| Modalidades de entrada e saída | Entrada de texto e imagens; saída de texto | Documentação oficial do modelo |
| Modo de raciocínio | Pensamento adaptativo sempre ativado; esforço padrão da API: high | Documentação oficial do modelo |
| Limite de conhecimento | Junho de 2026 (isso não significa que tenha acesso à internet em tempo real) | Documentação oficial do modelo |
| Preço padrão | US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída; 20% abaixo do preço do 5.1 | Página oficial de preços |
| Velocidade | Geração de saída “até 30% mais rápida” que a do 5.1 | Limite informado pela empresa |
Há dois pontos que podem ser mal interpretados. Primeiro, “até 30% mais rápido” é o limite de velocidade de saída informado pela empresa — não significa que todo tipo de tarefa levará 30% menos tempo. Segundo, o preço padrão do Fable 5.2 ainda é o dobro do Opus 5.5 (US$ 4/20).
A empresa também recomenda explicitamente que, para a maioria das tarefas cotidianas de programação e conhecimento, as pessoas comecem pelo Opus 5.5 e deixem o Fable para tarefas mais complexas.
Evidências de melhorias do Claude Fable 5.2 em programação e tarefas de longo prazo
Programação é o foco principal deste lançamento. Primeiro, veja os dados divulgados pelo fabricante e, em seguida, dois conjuntos de dados de terceiros, obtidos em ambientes diferentes.
Tabela oficial de desempenho: Fable 5.2 em comparação com 5.1 e Opus 5.5
| Avaliação (divulgada pelo fabricante) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Observações |
|---|---|---|---|---|
| FrontierCode 2.0 | 49,1% | 32,4% | — | As configurações de effort são diferentes |
| FrontierSWE v2 | 69,9% | 56,3% | 62,3% | Tarefas de engenharia de software de longo prazo |
| AutomationBench | 51,4% | 31,4% | 42,5% | Tarefas de automação |
| OSWorld 2.1, subconjunto offline parcial | 89,3% | 83,5% | 87,2% | Critério de pontuação parcial |
| RoboDojo Sim | 64,9% | 27,6% | 39,4% | Controle de robôs em simulação |
A tabela confirma que o Fable 5.2 supera o 5.1 em 13,6 pontos percentuais no FrontierSWE v2, além de ficar à frente do Opus 5.5. O avanço no FrontierCode 2.0 é ainda maior, mas as duas linhas usam configurações de effort diferentes, então parte desse aumento pode vir do nível de raciocínio.
Dados de terceiros: desempenho do Claude Fable 5.2 na AA e no Cursor
| Ambiente de avaliação | Configuração | Pontuação | Custo por tarefa (US$) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3,80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9,08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14,83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26,54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10,04 |
| CursorBench 4.0 | Fable 5.2 High | 56,9% | 9,70 |
| CursorBench 4.0 | Fable 5.2 Max | 60,0% | 32,79 |
| CursorBench 4.0 | Opus 5.5 High | 56,0% | 3,97 |
A AA é uma instituição de avaliação independente. No Intelligence Index, o Fable 5.2 max marca 65, acima dos 59 do Opus 5.5 max, em linha com a tendência mostrada na tabela oficial.
Os dados do Cursor vêm de tarefas e ferramentas próprias da plataforma. O Fable 5.2 Max alcança 60,0%, mas, na configuração High, fica apenas 0,9 ponto percentual à frente do Opus 5.5 High.
Os dois conjuntos de dados de terceiros mostram que um desempenho máximo mais alto costuma vir acompanhado de um custo maior por tarefa. Na AA, a pontuação aumenta 3 pontos de high para max, enquanto o custo por tarefa fica cerca de 2,92 vezes maior.
🎯 Recomendação técnica: os rankings ajudam a restringir as opções, mas a conclusão final deve vir de testes com seu próprio conjunto de tarefas. Recomendamos usar a APIYI, apiyi.com, com a mesma interface compatível com OpenAI para comparar modelos como Opus e Fable com os mesmos comandos e critérios de aceitação. Depois, registre a qualidade e os custos de cada configuração.
Até onde chegaram as capacidades visuais e de engenharia do Claude Fable 5.2
Da compreensão da tela ao controle de ações
Os dois resultados mais importantes na área visual são os do OSWorld 2.1 e do RoboDojo Sim. No subconjunto offline do OSWorld 2.1, a pontuação parcial subiu de 83,5% para 89,3%. O Opus 5.5, porém, já alcançou 87,2%, então a diferença não é muito grande.
A mudança no RoboDojo Sim foi maior: a pontuação passou de 27,6% para 64,9%. Isso indica um avanço significativo na capacidade do modelo de transformar a compreensão visual em ações de controle contínuo.
Fable 5.2 participa do projeto de protótipos eletrônicos
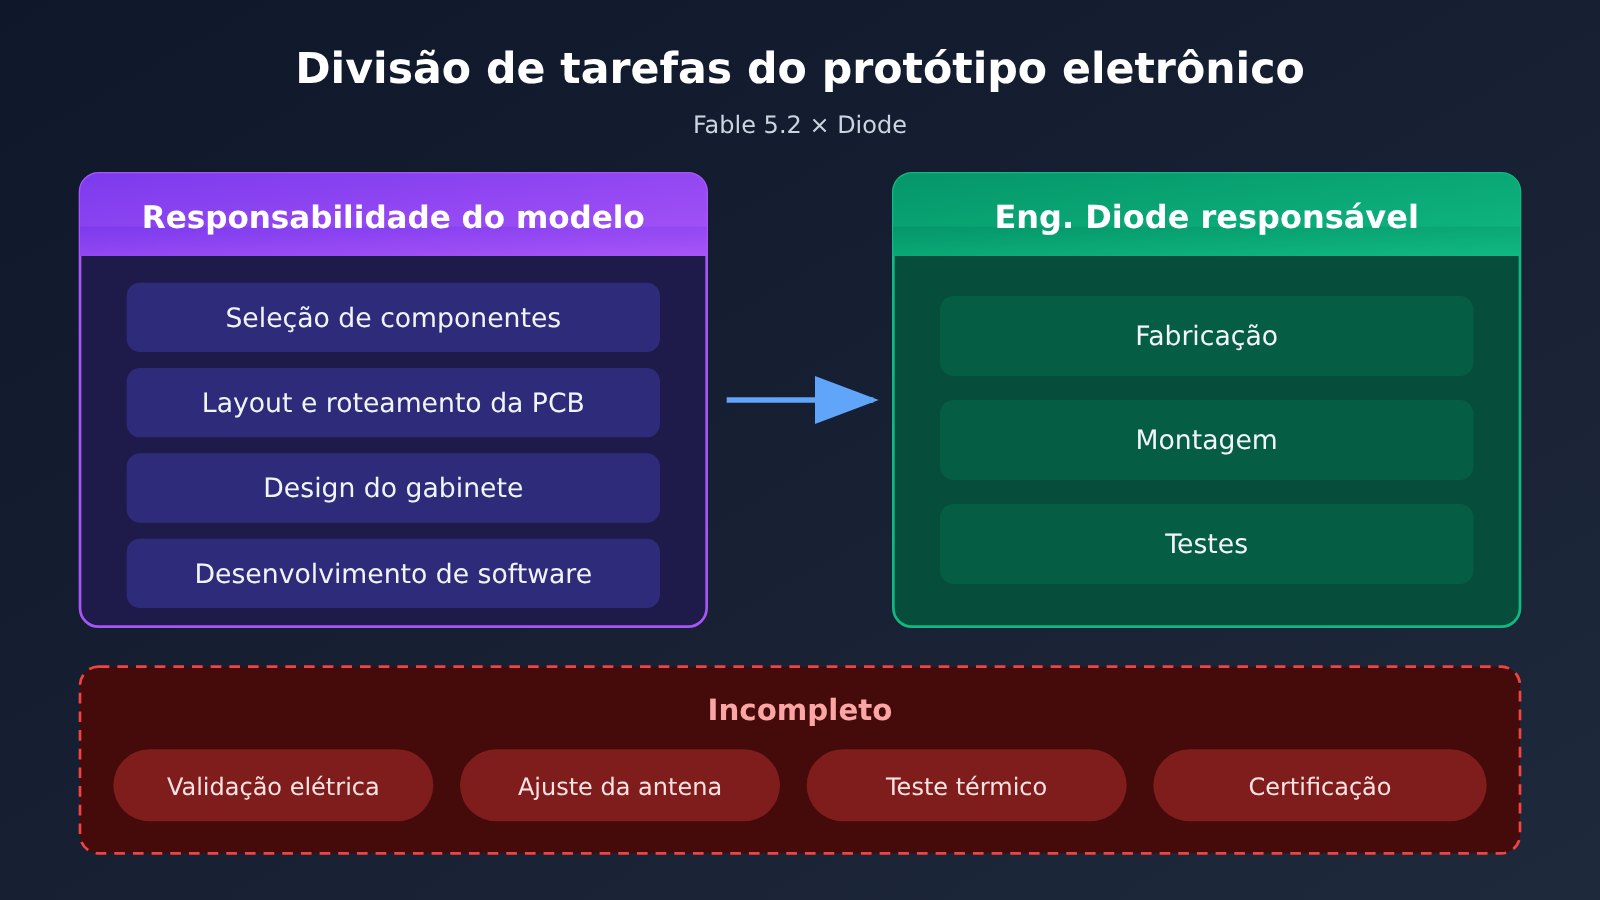
A Anthropic e a Diode trabalharam juntas para criar protótipos de três dispositivos eletrônicos: um assistente de voz, um viva-voz USB e um bichinho virtual. O modelo participou da seleção de componentes, do layout e roteamento da PCB, do projeto do gabinete e da programação do software. Os engenheiros da Diode ficaram responsáveis pela fabricação, montagem e pelos testes. Como existe uma parceria comercial entre as duas empresas, é importante levar isso em conta ao analisar o caso.
Os limites desse caso são bem claros. Os três dispositivos são apenas protótipos: não passaram por validação elétrica, ajuste de antena, testes térmicos ou certificação, e não foram projetados para produção em massa. O modelo também não foi conectado a equipamentos de fábrica nem a instrumentos de teste. Portanto, a descrição precisa é: “o modelo pode participar profundamente do projeto de protótipos eletrônicos”, e não “o modelo fabricou sozinho um produto pronto para produção em massa”.
O mesmo documento de pesquisa apresenta mais dois resultados relacionados a design. O primeiro é o PCB Gym, uma avaliação interna conduzida pela Diode. O Fable 5.2 obteve 69%, em comparação com os 25% do Fable 5 — não do 5.1. O segundo é o benchmark público BenchCAD 2.1, usado para reconstruir peças 3D, conjuntos e placas de circuito a partir de desenhos de engenharia e imagens renderizadas. Segundo a empresa, o Fable 5.2 obteve 83,5%. O benchmark é público, mas essa pontuação ainda não foi verificada de forma independente.
Por que os casos de pesquisa científica e multiagentes do Claude Fable 5.2 chamam atenção
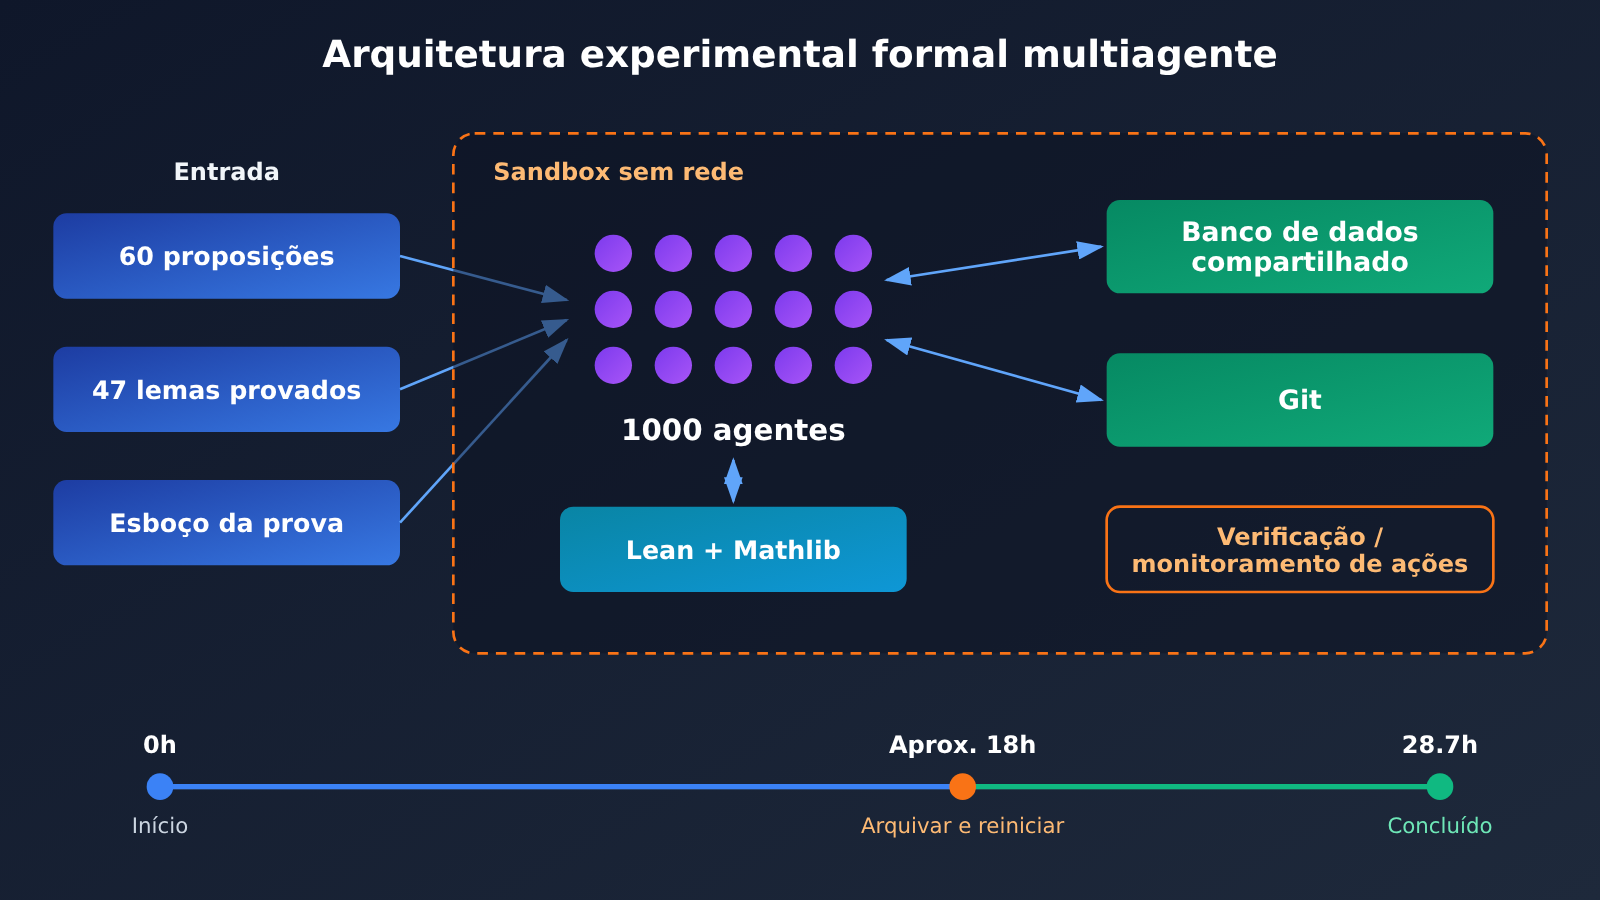
O caso que mais chamou atenção foi o experimento de formalização matemática. Segundo o blog oficial para desenvolvedores, 1.000 agentes da versão inicial do Fable 5.2 reproduziram, em Lean, a prova formal do Último Teorema de Fermat ao longo de 28,7 horas.
O valor desse caso está na capacidade de organizar tarefas de grande escala e longa duração, não em uma nova descoberta matemática.
É importante descrever por completo as condições do experimento:
- As entradas foram fornecidas: 60 proposições e definições, um esboço de uma frase com o caminho clássico da prova e 47 lemas já demonstrados anteriormente.
- Ferramentas e ambiente: Lean, Mathlib, Git, um banco de dados compartilhado e uma sandbox sem conexão com a internet, com verificação de ações e monitoramento offline.
- Processo de execução: após cerca de 18 horas, os agentes foram reiniciados a partir do estado salvo e executaram por mais 12 horas.
- Como os autores definem o experimento: os próprios autores o chamam de toy experiment e observam que um harness especializado e a orientação humana sobre o caminho da prova poderiam aumentar ainda mais a eficiência.
Portanto, trata-se da formalização de uma prova matemática já existente.
Mesmo com essas ressalvas, o caso aponta para uma direção importante: várias instâncias de modelo podem dividir o trabalho, enviar contribuições e revisar resultados usando um estado compartilhado, avançando continuamente em uma tarefa de longa duração. Essa capacidade também pode ser útil em trabalhos de engenharia, como migrações de código em larga escala e refatorações de sistemas complexos.
Em quais aspectos Claude Fable 5.2 não foi superior em tudo
Uma análise responsável das capacidades também precisa apresentar exemplos em contrário. Na própria tabela do anúncio oficial, há dois resultados em que Fable 5.2 não leva vantagem.
| Avaliação | Fable 5.2 | Modelo de comparação | Observação |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | O concorrente teve um resultado melhor |
| AA-Briefcase (rubric) | 66.1% | Opus 5.5 61.2% | Fable ficou à frente segundo os critérios de avaliação |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Opus ficou à frente na comparação por preferência |
O resultado de AA-Briefcase é o exemplo mais representativo. Na mesma tarefa, Fable fica à frente quando a pontuação segue os critérios de avaliação (rubric), mas Opus vence quando se considera a preferência nas comparações por Elo. A classificação pode se inverter quando muda o critério de avaliação; por isso, não é confiável anunciar “o primeiro lugar absoluto” com base em um ou dois rankings.
Outro custo é o preço. No ambiente do Cursor, o Fable 5.2 Max custa US$ 32,79 por tarefa, enquanto o Opus 5.5 High custa US$ 3,97 — uma diferença de cerca de 8 vezes, para uma diferença de apenas 4 pontos percentuais na pontuação. Um experimento de pequena escala do desenvolvedor independente Lex Toumbourou também mostrou que o 5.2 high é mais preciso que o 5.1, mas gera aproximadamente o dobro de saída e de custo por rodada.
Além disso, as pontuações específicas de segurança e biologia do Mythos não devem ser contabilizadas como capacidades do Fable padrão.
Para quais usuários vale a pena experimentar o Claude Fable 5.2 agora
Com base no guia oficial de seleção de modelos e nos dados acima, dá para fazer uma divisão geral:
- Vale a pena testar primeiro: tarefas de programação complexas e de longa duração, projetos de engenharia complexos e pesquisas que exigem várias etapas de chamadas a ferramentas. Use seu próprio conjunto de tarefas para verificar se há uma melhora de fato.
- Comece com um modelo para o dia a dia: para perguntas gerais e programação comum, siga a recomendação oficial e comece com modelos de uso diário, como o Opus 5.5. Faça o upgrade apenas se encontrar limitações.
Cinco aspectos a avaliar antes de testar o Claude Fable 5.2
| Aspecto | O que confirmar | O que fazer |
|---|---|---|
| Disponibilidade | O modelo já está disponível na plataforma que você usa? Qual é o ID do modelo e o endpoint? | Consulte a lista de modelos da plataforma no dia do teste; não presuma que ele já está disponível |
| Dados | Os dados da tarefa podem ser enviados para um modelo de terceiros? | Confira as regras de retenção de dados e os requisitos de conformidade da empresa |
| Critérios de aceitação | O que conta como conclusão da tarefa? | Prepare os casos de teste ou os critérios de avaliação com antecedência |
| Tempo | O tempo de espera é importante? | Registre também o tempo total de ponta a ponta, não apenas a velocidade de geração da resposta |
| Orçamento | Qual é o custo máximo por tarefa concluída com sucesso? | Registre tokens e tarefas concluídas por faixa de preço e calcule o custo por sucesso |
Teste comparativo do Claude Fable 5.2 com uma interface unificada
O exemplo minimalista abaixo usa uma interface compatível com OpenAI para chamar o modelo. Basta substituir MODEL por um ID que esteja na lista de modelos da plataforma para alternar entre diferentes modelos e compará-los sem alterar o código.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

MODEL = "your-model-id"  # Consulte a lista de modelos da plataforma no dia
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Ver código de comparação entre vários modelos e registro de uso
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Consulte a lista de modelos da plataforma no dia para conferir os IDs candidatos
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Executa uma tarefa e registra o tempo, os tokens e o resultado da validação."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Use sua própria função de validação
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
Depois de concluir a comparação, confira também a fatura real. A documentação de logs da APIYI lista campos como model_name, prompt_tokens, completion_tokens, quota e request_id. O valor de quota dividido por 500000 corresponde à cobrança em dólares, o que permite conferir, tarefa por tarefa, os gastos antes e depois da atualização. Vale lembrar que o valor calculado com base nas tarifas oficiais é apenas uma estimativa; use os logs reais da plataforma como referência.
🚀 Comece agora: você pode se cadastrar em APIYI, no site apiyi.com, e receber créditos de teste gratuitos para novos usuários. Primeiro, teste o fluxo de comparação com 10 a 20 tarefas reais; depois, decida se vale a pena ampliar o volume para o nível Fable. Confira as informações divulgadas pela plataforma no dia para saber se o novo modelo está disponível e quanto custa.
Perguntas frequentes (FAQ)
Q1: O que é o Claude Fable 5.2? Qual é a relação dele com o Mythos 5.2?
O Fable 5.2 é um modelo lançado pela Anthropic em 9 de novembro de 2026, com o identificador de API `claude-fable-5-2` e suporte a uma janela de contexto de 1M. Ele compartilha o mesmo modelo subjacente que o Mythos 5.2. A diferença é que as proteções de segurança do Fable permitem disponibilizá-lo ao público em geral, enquanto o Mythos é oferecido apenas a organizações aprovadas.
Q2: O Claude Fable 5.2 é quanto melhor que o Opus 5.5?
Na tabela oficial, o resultado no FrontierSWE v2 é de 69,9% contra 62,3%. No índice AA, a pontuação na faixa max é de 65 contra 59. No CursorBench 4.0, a diferença na faixa High é de apenas 0,9 ponto percentual. No geral, o Fable 5.2 tem um limite de capacidade mais alto, mas custa o dobro do Opus 5.5. Nas faixas mais caras, a diferença no custo por tarefa pode ser ainda maior.
Q3: O Claude Fable 5.2 fica em primeiro lugar em todas as tarefas?
Não. No AutomationBench, o Gemini 4 Carbon obteve 53,9%, acima dos 51,4% do Fable 5.2. Na pontuação Elo do AA-Briefcase, o Opus 5.5 fica em uma posição melhor. Os resultados variam conforme o critério de avaliação.
Q4: Usar o Fable 5.2 sempre sai mais barato que usar o 5.1?
Não necessariamente. O preço por unidade caiu 20%, mas a economia só será de 20% se o volume de uso permanecer igual. Suponha que uma tarefa tenha 100 mil tokens de entrada e 20 mil de saída: o custo do 5.2 será de 1,60 dólar, e o do 5.1, de 2 dólares. Mas, se a saída aumentar para 40 mil tokens, o custo do 5.2 será de 2,40 dólares, ou seja, mais alto. Esse exemplo serve apenas para ilustrar a relação entre as variáveis; não é uma previsão de que o modelo necessariamente vai gerar mais tokens. Recomendamos conferir o consumo real de tokens por tarefa nos registros de chamadas da APIYI, em apiyi.com.
Q5: Como comparar rapidamente o Claude Fable 5.2 com outros modelos pela API?
1. Cadastre-se na APIYI, em apiyi.com, e obtenha uma chave API e créditos gratuitos para testes;
2. Confira quais IDs estão disponíveis na lista de modelos da plataforma naquele dia;
3. Use o código deste artigo, configure `base_url` como `https://api.apiyi.com/v1` e faça chamadas para os modelos usando o mesmo conjunto de tarefas;
4. Registre o número de tarefas concluídas com sucesso, o tempo gasto e os tokens consumidos para calcular o custo por tarefa bem-sucedida.
Q6: O experimento do último teorema de Fermat mostra que o Fable 5.2 consegue fazer descobertas matemáticas originais?
Não. O experimento forneceu 60 proposições, 47 lemas já demonstrados e um esboço de prova. Mil agentes baseados em snapshots iniciais foram executados durante 28,7 horas em um sandbox offline. O que eles fizeram foi formalizar uma prova existente, e isso ocorreu em apenas uma execução. O experimento demonstra capacidade de organização em tarefas de longa duração, mas não prova que o modelo seja capaz de fazer descobertas matemáticas originais.
Claude Fable 5.2: principais pontos
- Posicionamento no lançamento: lançado em 9 de novembro, usa o mesmo modelo-base do Mythos e está disponível para o público geral.
- Limite em programação: alcançou 69,9% no FrontierSWE v2, superando o 5.1 e o Opus 5.5 na tabela oficial.
- Confirmação de terceiros: marcou 65 no nível AA max e 60,0% no CursorBench Max, mas o custo por tarefa é significativamente maior.
- Da visão à ação: o RoboDojo Sim subiu de 27,6% para 64,9%, mas esse resultado considera apenas simulações.
- Engenharia e pesquisa: pode ajudar no projeto de protótipos eletrônicos e em formalizações Lean de grande escala, mas ambos os casos dependem de condições específicas.
- Não vence em tudo: outros modelos lideram em algumas avaliações do AutomationBench e em métricas Elo.
- Como começar: no APIYI apiyi.com, você pode usar uma interface unificada para comparar modelos com suas próprias tarefas antes de decidir se vale a pena fazer o upgrade.
Resumo
Os principais pontos sobre o Claude Fable 5.2:
- Avanço expressivo em tarefas difíceis: teve uma grande evolução em relação ao 5.1 em avaliações de programação de longo prazo e controle visual.
- É importante analisar as evidências por categoria: avaliações do próprio fornecedor, rankings independentes da AA e ambientes internos do Cursor têm aplicações diferentes. Não dá para misturar os números e compará-los diretamente.
- Um limite mais alto tem seu custo: capacidades de ponta costumam vir acompanhadas de um custo por tarefa várias vezes maior. Um preço unitário menor não significa necessariamente um custo menor por tarefa.
Se seu trabalho envolve principalmente programação complexa de longo prazo, engenharia avançada ou pesquisa, vale testar agora o Fable 5.2 com seu próprio conjunto de tarefas. Para o trabalho do dia a dia, ainda recomendamos começar com modelos como o Opus. Use o APIYI apiyi.com para comparar vários modelos pela mesma interface e calcular os custos com base nos registros. Assim, você decide se vale a pena fazer o upgrade com dados, e não apenas com rankings.
📚 Referências
- Anúncio de lançamento da Anthropic: escopo do lançamento do Fable e do Mythos 5.2, além da tabela oficial de recursos
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Observação: fonte primária para a data de lançamento, os critérios de velocidade e os dados comparativos (avaliação da própria empresa)
-
Especificações do modelo Fable 5.2: contexto, limite de saída e modo de raciocínio
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Observação: documentação oficial da API
-
Ranking de modelos da Artificial Analysis: Intelligence Index e custo por tarefa
- Link:
artificialanalysis.ai/leaderboards/models -
Observação: retrato dinâmico de uma instituição independente
-
CursorBench 4.0: avaliação no ambiente próprio do Cursor
- Link:
prod.cursor.com/evals -
Observação: avaliação feita por um fornecedor de ferramentas, não uma reprodução independente e generalizável
-
Pesquisa sobre design eletrônico com Claude: três protótipos desenvolvidos em parceria com a Diode
- Link:
anthropic.com/research/claude-electronics-design -
Observação: inclui dados do PCB Gym e do BenchCAD 2.1, além das limitações dos protótipos
-
Experimento com equipes multiagente do Fable 5.2: condições do experimento de formalização Lean
- Link:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
Observação: uma execução em grande escala, baseada em um retrato inicial divulgado pela própria empresa
-
Guia de seleção de modelos Claude: recomendações de uso para Opus e Fable
- Link:
claude.dev/blog/which-claude-model-should-you-build-with/ - Observação: guia oficial para desenvolvedores
Autor: equipe técnica da APIYI
Contato técnico: fale com a gente na página inicial do site da APIYI. Os campos de log e as informações de cobrança estão disponíveis no centro de documentação em docs.apiyi.com.


