
Resumo: Este artigo responde a uma pergunta: o GPT-6.2 Sol consegue lidar com perguntas de dados feitas por usuários de front-end, e quais perguntas ainda precisam de verificação adicional.
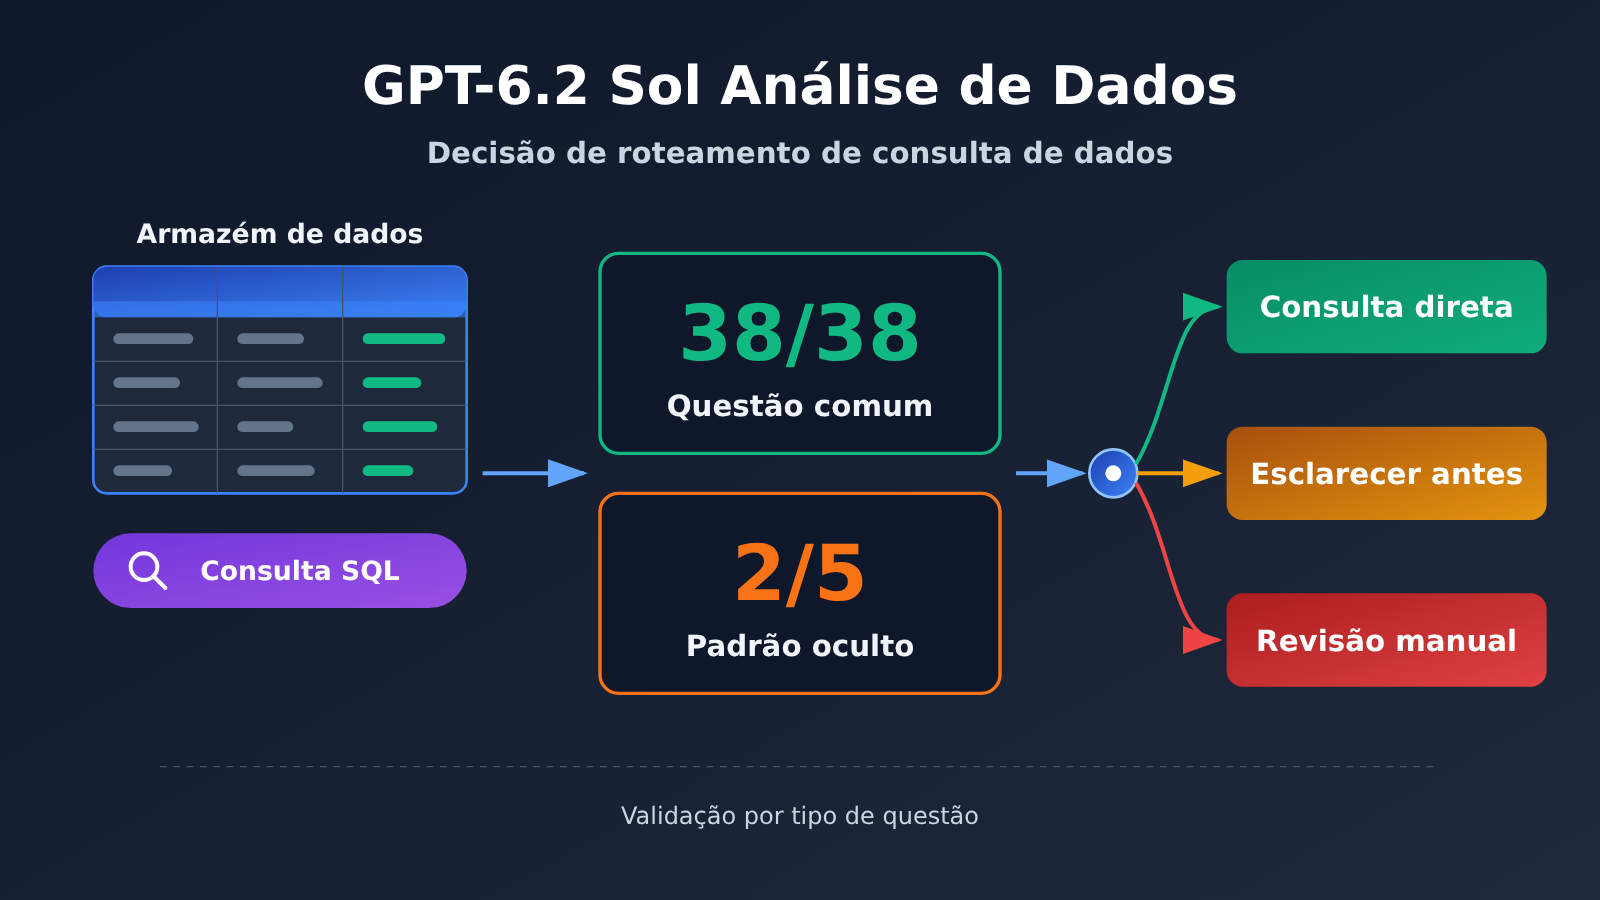
O desempenho do GPT-6.2 Sol em análise de dados pode ser dividido em duas partes. No teste dedicado de rodada única publicado pela Plotly em 17 de novembro de 2026, ele acertou todas as 38 questões das cinco categorias: análise convencional, identificação de ambiguidade, dados não respondíveis, qualidade de dados e armadilhas estatísticas. O tempo mediano por questão foi de cerca de 10,5 segundos. Na mesma rodada, das 5 questões de padrões ocultos, ele passou em apenas 2.
Com base nisso, é possível concluir: consultas agregadas com critérios claros e impacto pequeno podem ser testadas com o Sol respondendo diretamente sob permissão somente leitura; quando faltarem critérios, primeiro peça esclarecimento; atribuições abertas e decisões externas devem ser revisadas por analistas. Esta conclusão tem três premissas: o teste foi executado em apenas uma rodada; o banco de questões é formado por questões em inglês que simulam uma empresa de energia eólica; e os custos vêm do canal OpenRouter. Depois de aplicar aos seus próprios dados e canais, é preciso validar novamente por tipo de questão.
Mapa de conhecimento e índice de leitura para análise de dados do GPT-6.2 Sol
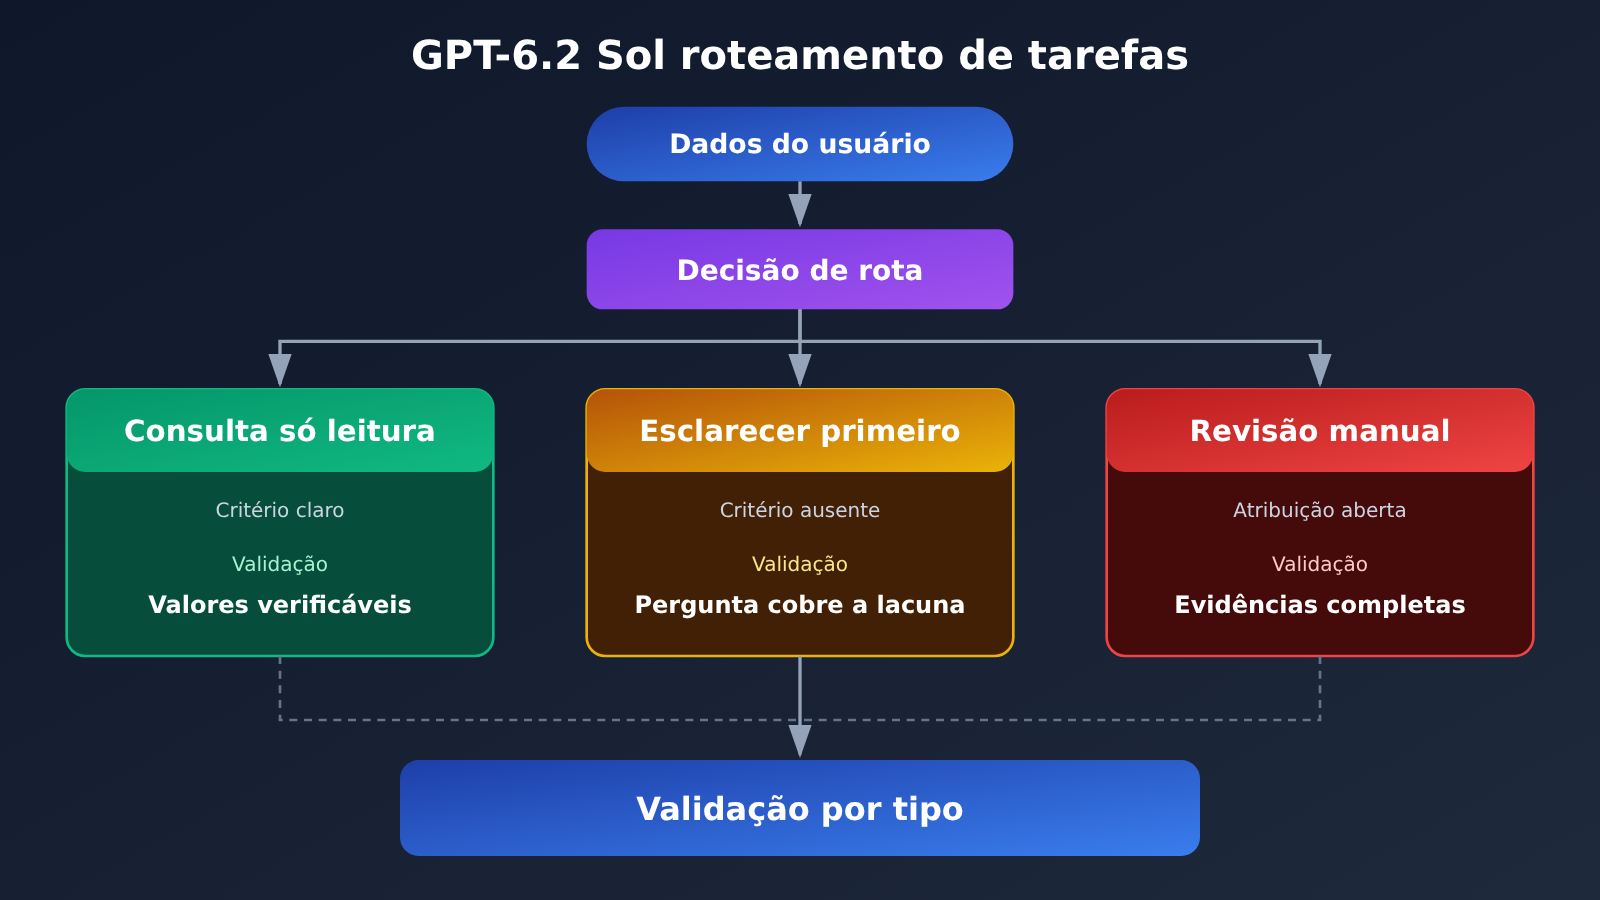
A figura abaixo mostra a lógica de triagem de tarefas do texto completo. Cada ramificação indica as condições de entrada, a saída que o modelo deve fornecer e o número dessa ramificação no corpo do texto.
Usuário faz uma pergunta sobre dados
 │
 ├─ Critério definido + resumo de baixo impacto ──→ [1] Sol: consulta de dados somente leitura
 │                               Saída: valor + numerador/denominador + intervalo de tempo e fuso horário + consulta SQL
 │
 ├─ Critério ausente / dados insuficientes ────→ [3.2] esclarecer primeiro
 │                               Saída: uma pergunta de acompanhamento específica + lista de critérios alternativos
 │
 └─ Atribuição aberta / decisão externa ──→ [3.3] enviar para revisão de analista
                                 Saída: registro de triagem inicial + evidências de suporte + verificação de explicações alternativas
            ↓
   [2] usar latência e custo por pergunta para decidir se deve ir para a interface voltada ao usuário
            ↓
   [4] validar com seus próprios dados por tipo de pergunta e entregar resultados com data dos dados e evidências de consulta
A ordem das seções é a seguinte. A seção 3, que é paralela às demais, pode ser consultada conforme a necessidade; as outras seções devem ser lidas em ordem.
| Seção | Pergunta respondida | O que entrega para a próxima seção | O que você pode fazer depois de ler |
|---|---|---|---|
| 1 | Em que tipo de pergunta o Sol é estável | Limite por tipo de pergunta: 38/38 e 2/5 | Delimitar o alcance em que dá para consultar dados diretamente |
| 2 | Se vale a pena colocá-lo na interface voltada ao usuário | Latência, custo por pergunta e premissas de extrapolação | Avaliar orçamento e tempo de espera em cenários interativos |
| 3 | Quais sinais exigem esclarecimento ou transferência para atendimento humano | Três formas de perda de pontos e três exemplos de saída | Projetar regras de roteamento |
| 4 | Como validar com seus próprios dados | Métricas e limites por tipo de pergunta | Produzir uma entrega verificável |
Para saber: termos relacionados à análise de dados do GPT-6.2 Sol
| Termo | Explicação breve |
|---|---|
| Data warehouse | Conjunto de dados que reúne dados históricos dispersos nos sistemas de negócio para consultas e análises |
| Definição do indicador | Definição, condições de filtro, numerador/denominador e limites de tempo de um indicador |
| SQL somente leitura | Forma de consulta que apenas recupera e agrega dados, mantendo a fonte de dados com permissão somente leitura |
| Pergunta de padrão oculto | O conjunto de dados já contém anomalias estruturais plantadas; a pergunta fornece apenas pistas e o modelo precisa encontrar ativamente o padrão específico |
| Evidência de consulta | Consulta, critério, resultado e data dos dados que permitem a outra pessoa verificar a conclusão |
| Latência p50 / p95 | Tempo em que metade das requisições é concluída / tempo em que 95% das requisições são concluídas |
| Entrada em cache | Tokens de entrada identificados na cobrança upstream como reutilizáveis, com preço unitário muito menor que o de entrada comum |
| Validação por tipo de pergunta | Pontuar separadamente tipos como consulta de dados, esclarecimento, recusa e exploração, evitando que a pontuação total esconda um tipo específico de erro |
1. GPT-6.2 Sol em análise de dados: primeiro, os resultados de perguntas de dados que podem ser aceitos de forma estável
1.1 O que o teste da Plotly fez
A Plotly, dentro do framework de testes Plotly Studio Embedded, chamou o modelo via OpenRouter e disponibilizou apenas quatro ferramentas somente leitura: listar conjuntos de dados, executar consultas SQL, gerar gráficos e exibir tabelas. O repositório de teste simula uma empresa de energia eólica, com cerca de 19,9 milhões de linhas de dados, 44 tabelas e 554 colunas. As 43 perguntas em inglês foram avaliadas questão por questão, de acordo com o gabarito e as regras de pontuação. O modelo de pontuação foi Claude Sonnet 5, com temperature=0; as questões que perderam pontos passaram por revisão manual da equipe.
Essa configuração chega perto do formato real de perguntas de dados em BI empresarial: o modelo não vê todos os dados e só pode encontrar as tabelas sozinho, escrever SQL, ler o resultado e então responder. O banco de perguntas e o gabarito ficam sob responsabilidade da Plotly, e agentes externos não conseguem reproduzir questão por questão. Por isso, os números abaixo devem ser entendidos como uma observação de rodada única, com método descrito, e não como um ranking estável.
| Tipo de questão | Nº de questões | Resultado do GPT-6.2 Sol | Implicação para o negócio |
|---|---|---|---|
| Análise de rotina | 20 | 20/20 | Resumos com critérios fixos podem ser testados em respostas diretas |
| Julgamento de ambiguidade | 5 | 5/5 | Consegue identificar que a própria pergunta admite várias interpretações |
| Perguntas sem dados suficientes | 5 | 5/5 | Recusa responder quando os dados não sustentam, sem inventar números |
| Qualidade dos dados | 3 | 3/3 | Consegue notar problemas como valores ausentes e duplicados |
| Armadilhas estatísticas | 5 | 5/5 | Consegue evitar leituras estatísticas equivocadas comuns |
| Padrões ocultos | 5 | 2/5 | A busca aberta de padrões ainda exige validação humana |
| Total | 43 | 40/43 | As 38 primeiras questões passaram; todas as perdas se concentraram nas questões exploratórias |
A Plotly também menciona que outros modelos, em execuções repetidas, apresentaram variações de até três questões. O resultado 40/43 fica a apenas três questões da pontuação máxima, exatamente dentro dessa faixa de variação. Portanto, o mais relevante é a distribuição das perdas de pontos: todas ficaram nas questões de padrões ocultos, e nas cinco primeiras categorias não houve nenhum erro.
1.2 Por que perguntas de dados com critérios fixos podem ser verificadas
Tomemos como exemplo o relatório de pós-venda, “taxa de devolução por armazém nos últimos 7 dias”. Ele pode ser aceito de forma estável desde que três coisas já estejam definidas de antemão: o denominador é o total de pedidos entregues ou o total de pedidos; o intervalo de tempo é cortado em qual fuso horário; e as condições de filtro excluem pedidos de teste e pedidos internos. Depois que esses três pontos entram na documentação de critérios, o SQL gerado pelo modelo e o resultado podem ser comparados item por item com uma consulta manual.
Critérios fixos transformam “o modelo é inteligente?” em “os números são consistentes?”. Esta segunda pergunta pode ser comparada automaticamente. É também por isso que as 38 questões conseguem passar totalmente, e essa aprovação tem significado: a maioria delas tem uma única resposta padrão.
2. Latência e custo da análise de dados do GPT-6.2 Sol: vale a pena colocar no front-end?
2.1 Comparação da rodada completa entre as duas gerações do Sol
Quando o usuário faz perguntas sobre dados no front-end, o tempo de espera determina diretamente a experiência. O relatório do Plotly traz uma comparação entre GPT-6.2 Sol e GPT-6.1 Sol na mesma rodada de 43 perguntas:
| Métrica | GPT-6.1 Sol | GPT-6.2 Sol | Variação |
|---|---|---|---|
| Custo da rodada completa | $2.61 | $1.22 | cerca de 53.3% menor |
| Mediana do tempo por pergunta | 17.6 segundos | 10.5 segundos | cerca de 40.3% menor |
| Número de chamadas de ferramentas | 258 | 158 | redução evidente |
| Número de invocações do modelo | 227 | 173 | redução |
| Volume de entrada | cerca de 7.8 milhões de tokens | cerca de 4.6 milhões de tokens | redução |
| Volume de saída | cerca de 70 mil tokens | cerca de 45 mil tokens | redução |
| Proporção de entrada em cache | 94% | 97% | aumento |
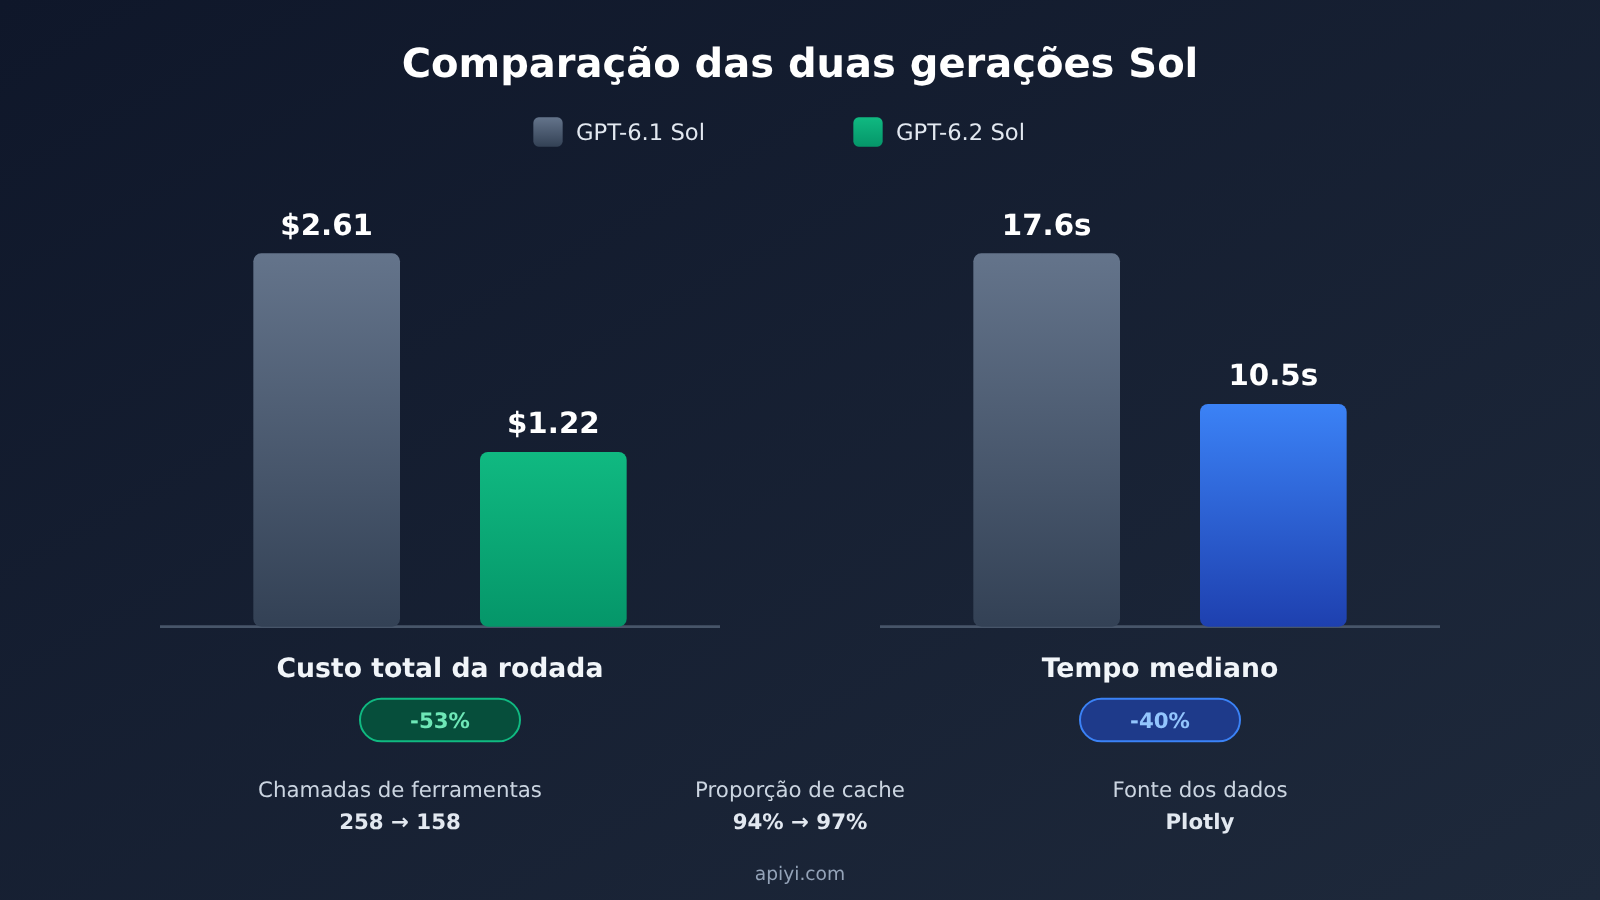
As duas gerações do Sol têm o mesmo preço-base Standard de contexto curto, mas o custo da rodada completa cai quase pela metade. A diferença vem do processo da tarefa: menos rodadas de chamada, menos tokens lidos e gravados, maior taxa de acerto do cache. Por isso, ao avaliar o custo de cenários de análise de dados, devemos usar como unidade “quanto custa concluir uma pergunta”; o preço por milhão de tokens é apenas um dos fatores.
2.2 Extrapolação e premissas de cerca de $28.4 por mil perguntas
Dividindo o total da rodada de $1.22 por 43 perguntas, chegamos a cerca de $0.0284 por pergunta; extrapolando para mil perguntas, cerca de $28.4. Para que esse número seja válido, é preciso atender simultaneamente às seguintes premissas:
- A distribuição dos tipos de pergunta é igual à das 43 perguntas do Plotly, com cerca de 12% de perguntas exploratórias;
- Usa o mesmo canal OpenRouter e a mesma tabela de preços;
- A proporção de cache permanece em torno de 97%, com as perguntas compartilhando o mesmo comando de sistema e a mesma descrição do esquema das tabelas;
- Cada pergunta é executada apenas uma vez, sem novas tentativas.
Outro número no ranking do Plotly é o custo mediano por pergunta, $0.017, que é uma estatística diferente do valor médio rateado. Perguntas exploratórias chamam mais ferramentas e demoram mais, o que puxa a média para cima; a mediana fica mais próxima do custo de uma pergunta comum sobre dados. Ao fazer orçamento, pode-se usar a mediana para estimar consultas diárias e depois adicionar à parte uma parcela conforme a proporção de perguntas exploratórias.
O preço oficial da OpenAI para Standard de contexto curto é: entrada normal $2.00, leitura de cache $0.10, saída $10.00 (USD / milhão de tokens; a saída já inclui tokens de raciocínio). Quando o volume total de entrada da solicitação ultrapassa 272K, o pedido inteiro é migrado para a faixa de contexto longo. A interface pública de preços da APIYI (apiyi.com) é igual à oficial na faixa curta; na faixa longa, entrada $3, leitura de cache $0.15, gravação em cache $3.75 e saída $11.25. Em cenários de consulta a dados, uma única solicitação normalmente fica bem abaixo de 272K; só é preciso ficar atento à mudança de faixa quando se despeja de uma vez uma grande quantidade de esquemas de tabela ou resultados históricos.
3. GPT-6.2 Sol e os três tipos de sinal na análise de dados: quando esclarecer e quando transferir para um humano
3.1 Por que questões com padrões ocultos perdem pontos
Nas 38 questões sem padrões ocultos, o 6.2 Sol fez, em média, cerca de 2,9 chamadas de ferramenta por questão, e o 6.1 Sol cerca de 4,3; ambos acertaram todas. Já nas 5 questões com padrões ocultos, o relatório dedicado do Sol registra que o 6.2 Sol fez, em média, cerca de 9 consultas ao banco de dados, e o 6.1 Sol cerca de 16. (No artigo do ranking geral da Plotly, ao dar exemplos, a geração anterior usou a métrica de cerca de 18 consultas; neste artigo, sigo o relatório dedicado.)
Após revisão manual, as três questões que perderam pontos foram:
- não isolaram o padrão inserido;
- não indicaram quais objetos específicos foram afetados;
- não encontraram a parte dos dados em que o efeito realmente existia.
As três perdas de pontos têm algo em comum: as consultas ficaram na superfície. Podemos registrar isso como uma observação: a nova versão faz buscas mais superficiais nas questões de exploração. Já a relação causal de que “menos consultas levam à perda de pontos” só pode ser confirmada com um experimento com variáveis controladas. Para o negócio, a conclusão é a mesma: em qualquer questão de atribuição que exija buscar evidências ativamente, não se pode tratar a primeira resposta do modelo como conclusão.
3.2 Definição de métrica ausente: pergunte antes de responder
A seguir, uso um conjunto de dados fictício de chamados de pós-venda para demonstrar três tipos de saída. O conjunto de dados contém quatro tabelas: pedidos, chamados, lotes de produtos e armazéns. As saídas abaixo são exemplos projetados, não resultados reais.
Resposta normal (definição de métrica clara). Quando o usuário pergunta “liste a taxa de devolução dos últimos 7 dias por armazém”, uma saída adequada deve incluir, além do valor de cada armazém: numerador (número de chamados de devolução física), denominador (número de pedidos entregues no mesmo período), intervalo de datas e fuso horário (por exemplo, horário de Pequim, de 11-13 a 11-19), dimensão de agregação (armazém), e incluir o SQL executado.
Perguntar pela definição primeiro (definição de métrica ausente). Se o usuário apenas pergunta “qual foi a taxa de devolução na semana passada?”, o modelo deve primeiro perguntar: “A taxa de devolução é calculada com base em solicitações de reembolso ou em devoluções físicas? A diferença entre as duas é grande em cenários de somente reembolso.” Em seguida, deve listar as duas definições para o usuário escolher e não deve exibir números antes da escolha.
3.3 Atribuição aberta: encaminhar ao analista
Quando o usuário pergunta “a taxa de devolução de um canal dobrou; em quais lotes as anomalias estão concentradas?”, já entramos no território das questões com padrões ocultos. O modelo pode fazer uma triagem inicial: verificar se faltam dados, se o tamanho total da amostra é suficiente e, em seguida, segmentar por canal, categoria, armazém e lote, nesta ordem. Na saída, deve registrar pelo menos uma evidência de suporte e uma verificação para excluir explicações alternativas (por exemplo, confirmar que o volume de pedidos do canal naquela semana não caiu de forma anormal, descartando que a duplicação tenha sido causada por um denominador menor).
Depois disso, a saída deve ser marcada como “aguardando revisão do analista”, e não como “conclusão”. As regras de roteamento podem ser resumidas na tabela a seguir:
| Sinal | Pergunta típica | Roteamento | Saída do modelo | Foco da validação |
|---|---|---|---|---|
| Definição de métrica clara e baixo impacto | Taxa de devolução de 7 dias por armazém | Sol apenas para consulta de dados, em modo somente leitura | Valor + definição da métrica + SQL | Valor consistente com a consulta manual |
| Definição de métrica ou dados insuficientes | Qual foi a taxa de devolução na semana passada | Esclarecer primeiro | Uma pergunta de esclarecimento + definições candidatas | A pergunta de esclarecimento aponta a lacuna |
| Atribuição aberta, decisão externa | Em quais lotes as anomalias estão concentradas | Encaminhar para revisão do analista | Registro da triagem + evidência de suporte + verificação de explicações alternativas | Cobertura das evidências, falsos positivos e falsos negativos |
4. Validar a capacidade de análise de dados do GPT-6.2 Sol com seus próprios dados
4.1 Código de integração e roteamento
gpt-6.2-sol pode ser chamado pelos endpoints Responses e Chat Completions; chamadas de função e ferramentas internas seguem o caminho Responses. Nenhum dos dois endpoints aceita o nível de raciocínio none, então é preciso verificar esse parâmetro ao migrar código antigo. Abaixo está um exemplo mínimo de classificação de roteamento com Chat Completions:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Ver o exemplo completo de chamada de ferramenta SQL somente leitura (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Abre o banco no nível do banco de dados em modo somente leitura; a verificação por regex é apenas a segunda camada de proteção
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# Processa as chamadas de ferramentas em loop até o modelo fornecer a resposta final
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Início rápido: Para validar com amostras do seu próprio negócio, você pode solicitar uma cota de teste gratuita para novos usuários via APIYI apiyi.com. A mesma chave API permite alternar entre
gpt-6.2-sole outros modelos principais e comparar lado a lado no mesmo conjunto de tarefas; basta manter a fonte de dados somente leitura.
4.2 Métricas de aceitação por tipo de questão
Recomenda-se que o banco de questões de aceitação cubra os três tipos de roteamento da seção 3, com pontuação separada para cada tipo de questão.
| Tipo de questão | Métrica principal | Método de julgamento | Registro sugerido |
|---|---|---|---|
| Consulta numérica com critério fixo | Taxa de acerto numérico | Comparação linha a linha com o resultado do SQL manual | Custo por questão, latência p50/p95 |
| Critério faltante | Taxa de esclarecimento adequado | Verificar se a pergunta de acompanhamento atinge o critério realmente faltante | Ocorrência de “perguntar quando não deveria” |
| Dados não respondíveis | Taxa de recusa correta | Não inventar números | Número de respostas erradas |
| Atribuição aberta | Cobertura de evidências, falsos positivos e falsos negativos | Verificar se evidências de suporte + explicações alternativas estão completas | Consistência em múltiplas re-execuções |
O relatório do Plotly forneceu apenas a mediana do tempo de execução; a sua própria aceitação precisa incluir o p95. A experiência do usuário final costuma ser prejudicada por poucas requisições de cauda longa, e questões exploratórias são especialmente propensas a esse fenômeno. Em termos de custo, leia o volume de saída em usage.output_tokens, os tokens de raciocínio geralmente aparecem no subcampo output_tokens_details.reasoning_tokens, e combine com o volume de leitura de cache para calcular o custo real por questão.
4.3 Limites de amostras pequenas e re-execuções
As regras ocultas do Plotly têm apenas 5 questões; o intervalo de confiança de 2/5 é muito amplo, e trocar o conjunto de questões pode resultar em 1/5 ou até 4/5. Ao re-executar com outros modelos, foram observadas flutuações de até três questões, portanto, a diferença de pontuação total em uma única rodada não é suficiente para embasar a seleção. Na sua própria aceitação, execute as questões exploratórias pelo menos algumas rodadas, e alinhe cinco variáveis: snapshot de dados, conjunto de ferramentas, nível de raciocínio do modelo, canal de invocação, tabela de pontuação. Se qualquer um desses itens mudar, os resultados anteriores e posteriores não podem ser comparados diretamente.
💡 Sugestão de aceitação: o canal é uma variável facilmente negligenciada. Os custos do Plotly vêm do OpenRouter, e a cobrança e a estratégia de cache do seu canal de produção podem ser diferentes. Recomenda-se re-executar no APIYI apiyi.com com o mesmo snapshot de dados, recalcular o custo por mil questões com base na fatura real, e então decidir a cota do front-end.
4.4 Um entregável que dá para aceitar
O critério de aceite é simples: todo resultado de consulta precisa permitir que uma terceira pessoa o revise de forma independente. Veja abaixo o formato de um entregável que passa (dados fictícios):
question: Taxa de devolução dos últimos 7 dias, por armazém
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: Número de ordens de devolução física (status = returned)
  denominator: Número de pedidos entregues no mesmo período (excluindo pedidos de teste e pedidos internos)
  time_range: 2026-11-13 ~ 2026-11-19, horário de Pequim
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: Armazém Leste 1, rate: 3.1%}, {warehouse: Armazém Sul 2, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: Sem necessidade de revisão (consulta com métrica fixa)
Um entregável traz a data dos dados, a definição da métrica, a consulta e o resultado. Com o GPT-6.2 Sol, essa etapa de consulta em primeiro plano já pode ser aceita. Saídas sem esses itens, mesmo que os números estejam certos por acaso, não deveriam entrar no relatório. Se você quer rodar esse fluxo no seu próprio armazém, pode começar pela interface compatível com OpenAI do APIYI apiyi.com: primeiro coloque no ar as consultas com métrica fixa e depois vá ampliando aos poucos para esclarecimento e atribuição de causas.
Referências
- Plotly – Relatório dedicado de análise de dados do GPT-6.2 Sol: resultados por questão das 43 tarefas, comparação de custos e tempo de execução
- Link:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Link:
- Plotly – Metodologia de teste do DataAnalyticsBench: design dos tipos de questão, regras de pontuação e critérios estatísticos do ranking
- Link:
plotly.com/blog/introducing-dataanalyticsbench
- Link:
- OpenAI – Model Card do GPT-6.2 Sol: janela de contexto, suporte a endpoints e regras de cobrança para contexto longo
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- OpenAI – Preços da API: preço unitário de entrada no modo Standard, cache e saída
- Link:
developers.openai.com/api/docs/pricing
- Link:
- Interface pública de preços do APIYI: expressões de precificação para faixas curta e longa do
gpt-6.2-sol- Link:
api.apiyi.com/api/pricing
- Link:
Autor: Equipe Técnica da APIYI
Contato técnico: Fale conosco pela página inicial do site oficial do APIYI. Há mais materiais de integração disponíveis no centro de documentação em docs.apiyi.com


