
비용을 아낄 수는 있지만, 조건이 있어요. Google 공식 문서에 제시된 두 가지 가상 계산 사례에 따르면, 200개 도구와 2,000 토큰 기본 컨텍스트 시나리오에서는 Gemini Tool Retrieval의 입력 토큰이 164,000에서 23,650으로 줄어 약 85.6% 감소했어요. 10개 도구와 30,000 토큰 기본 컨텍스트 시나리오에서는 입력 토큰이 68,000에서 92,830으로 늘어 약 36.5% 증가했어요. 비용이 유리한지는 한 가지 질문에 달려 있어요: 절약된 전체 도구 스키마가 서버 측 검색에서 추가로 발생하는 컨텍스트 오버헤드를 상쇄할 수 있는지요.
이 글을 읽고 나면 무엇을 알 수 있을까요?
- Tool Retrieval이 어느 부분의 토큰을 절약하고, 어느 부분의 토큰을 새로 추가하는지.
- 공식 200개 도구 계산 사례와 10개 도구 계산 사례의 전체 전제와 항목별 분석.
- 공식 파라미터를 기반으로 도출한 손익분기 공식, 그리고 ‘도구 수가 몇 개는 되어야 활성화할 가치가 있는지’ 판단 방법.
interaction.usage필드와 캐시 규칙으로 에이전트 작업 한 번의 실제 비용을 계산하는 방법.
목차 안내: 먼저 개념 표와 영향 요약으로 용어를 통일하고, 내가 어떤 유형의 독자인지 판단하는 데 도움을 드릴게요. ‘객관적 사실’ 부분에서는 Google이 공개한 메커니즘, 과금 규칙, 두 계산 사례의 원문 기준을 설명해요. ‘분석과 판단’ 부분에서는 공식 파라미터로 도출한 임계점, 세 가지 ‘절약’의 차이, 단일 작업 청구서 공식, 활성화 의사결정 표를 제시해요.
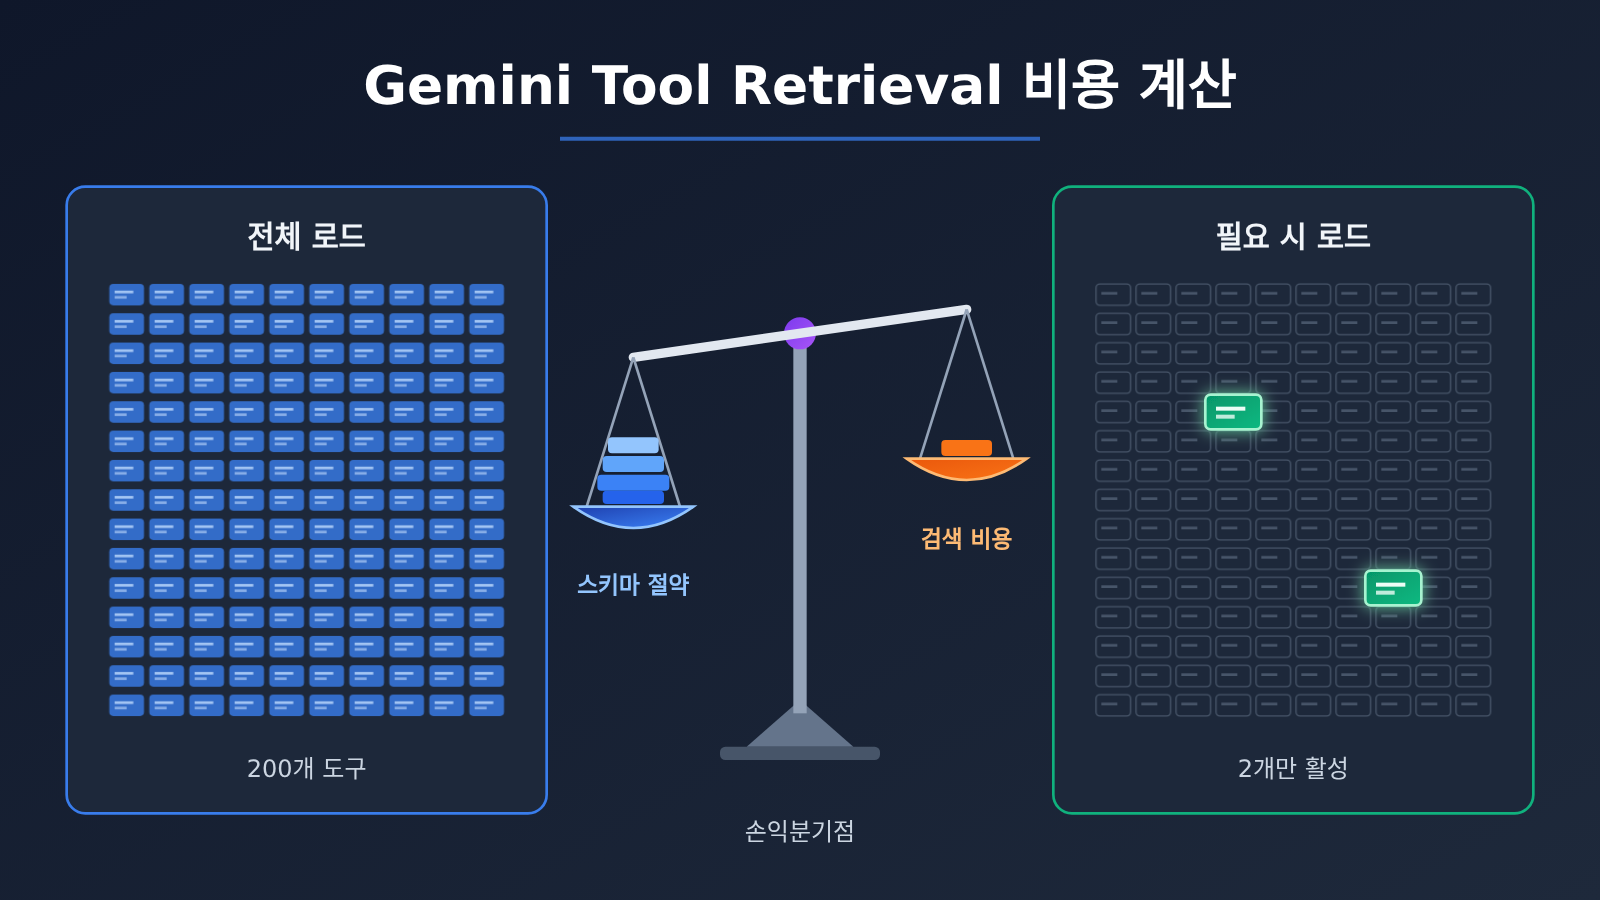
Gemini Tool Retrieval 비용 분석 알아두기: 개념 설명
| 개념 | 간략 설명 |
|---|---|
| 입력 토큰 | 모델에 전달되어 처리되는 텍스트, 이전 컨텍스트, 도구 선언 등의 계량 단위 |
| 도구 스키마 | 모델이 함수 호출을 생성할 때 기준으로 삼는 완전한 매개변수 정의로, 산출 예시에서는 각각 약 400 토큰 |
| 지연 도구 목록 | defer_loading: true를 설정하면 모델이 최초에 보는 것은 도구 이름과 간략 설명뿐이며, 공식 초기 테스트에서는 항목당 약 26 토큰 |
| 기본 컨텍스트 B | 산출 예시에서 모델 호출마다 원래 처리해야 하는 이전 대화와 작업 정보 |
| 검색 후 추론 | 서버 측에서 도구를 검색한 뒤, 기존 컨텍스트와 새로 추가된 스키마를 가지고 한 번 더 실행하는 모델 호출 |
total_tool_use_tokens |
하나의 요청 안에서 서버 측 도구 및 검색으로 인해 발생한 추가 모델 호출 입력량 |
total_cached_tokens |
입력 사용량 중 캐시로 처리되어 캐시 요율로 과금되는 부분 |
| 손익분기점 | 동일한 가정 아래에서 정적 로딩과 온디맨드 로딩의 입력 비용이 같아지는 경계 |
| 단일 성공 작업 비용 | 하나의 업무 목표를 완료하기 위해 지출된 각 라운드의 모델 호출 비용과 도구 비용의 합계 |
Gemini Tool Retrieval 영향 한눈에 보기
- 대규모 도구 라이브러리를 연동하는 에이전트 개발자: 도구 수는 많지만 한 번의 작업에서 소수만 사용한다면, 반복되는 스키마 입력 비용을 크게 줄일 기회가 있어요. 공식 200개 도구 산출 예시가 바로 이 시나리오에 해당합니다.
- 도구 집합이 작고 컨텍스트가 긴 애플리케이션 개발자: 서버 측 검색마다 모델 추론을 한 번 더 실행하고 긴 컨텍스트를 다시 처리해야 하므로, 활성화하면 오히려 더 비쌀 수 있어요. 공식 10개 도구 산출 예시가 반례입니다.
- 비용 산정을 담당하는 엔지니어링 및 FinOps 인원: 첫 요청의
total_input_tokens만 보면 비용을 과소평가하게 되므로,total_tool_use_tokens, 캐시 적중률, 출력 토큰을 함께 계산해야 합니다. - 기업 도구 레지스트리를 운영하는 플랫폼 팀: 클라이언트 측 검색 모드를 활용하면 자체 권한 필터링과 동적 도구를 결합할 수 있지만, 검색마다 API 왕복이 한 번 더 발생하므로 비용 기준을 별도로 평가해야 해요.
객관적 사실: Gemini Tool Retrieval 출시와 과금 메커니즘
Gemini Tool Retrieval이란 무엇이며 언제 출시됐나요?
2026년 11월 19일, Google은 공식 블로그에서 Gemini Interactions API에 Tool Retrieval 미리보기 기능을 공개했어요. 이 기능은 Preview 단계로, v1beta API 버전을 사용해야 하며 기존 generateContent 방식은 지원하지 않아요. 서버 측 모드 활성화 방법은 tools에 {"type": "tool_search"}를 추가하고, 지연 로딩을 원하는 function 또는 mcp_server에 defer_loading: true를 설정하는 것이에요.
개발 문서가 2026년 11월 20일 기준으로 명확히 나열한 호환 모델 ID는 네 가지예요: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. 공지에서는 “Gemini 3.6 및 그 이상 모델”이라고 더 넓게 표현했지만, 문서에 포함되지 않은 모델은 직접 검증해야 하며, 지원되지 않는 모델에 defer_loading을 설정하면 HTTP 400이 반환돼요.
한 가지 쉽게 오해할 수 있는 점을 강조할게요. 서버 측 모드에서도 개발자는 매 요청마다 전체 tools 배열을 제출해야 하며, 여기에는 지연 로딩 대상 도구의 전체 파라미터도 포함돼요. previous_interaction_id를 사용하더라도 마찬가지예요. Tool Retrieval이 바꾸는 것은 전체 스키마가 모델 컨텍스트에 들어가는 시점이지, 요청 본문에서 해당 정의를 더 이상 보내지 않는 것이 아니에요.
정적 로딩과 Gemini Tool Retrieval 비용은 어디서 발생할까요
정적 로딩에서는 모델을 호출할 때마다 모든 도구의 전체 스키마를 읽어야 해요. 이번 턴에서 환불 함수 하나만 쓰더라도 말이죠. Tool Retrieval은 이 긴 전체 정의를 짧은 도구 목록으로 대체합니다. 모델이 필요할 때 tool_search_call을 보내면 서버가 전체 스키마가 담긴 tool_search_result를 돌려주고, 모델은 이를 바탕으로 function_call을 생성해요.
Google은 Tool Retrieval에 별도의 기능 비용이 없다고 분명히 밝혔지만, 아래 항목들은 여전히 선택한 모델의 요율로 과금돼요.
- 지연된 모든 도구의 짧은 목록 항목.
tool_search를 켜면 추가되는 고정 검색 지시문.- 서버 측 검색마다 발생하는 추가 모델 추론 — 전체 컨텍스트와 새로 로드된 스키마를 다시 처리해요.
- 로드된 도구의 전체 스키마, 그리고 이후 턴에서 이 스키마가 계속 차지하는 분량(현재 문서에는 언로드 메커니즘이 없어요).
- 일반 출력, Thinking, 도구 실행 결과와 관련된 토큰.
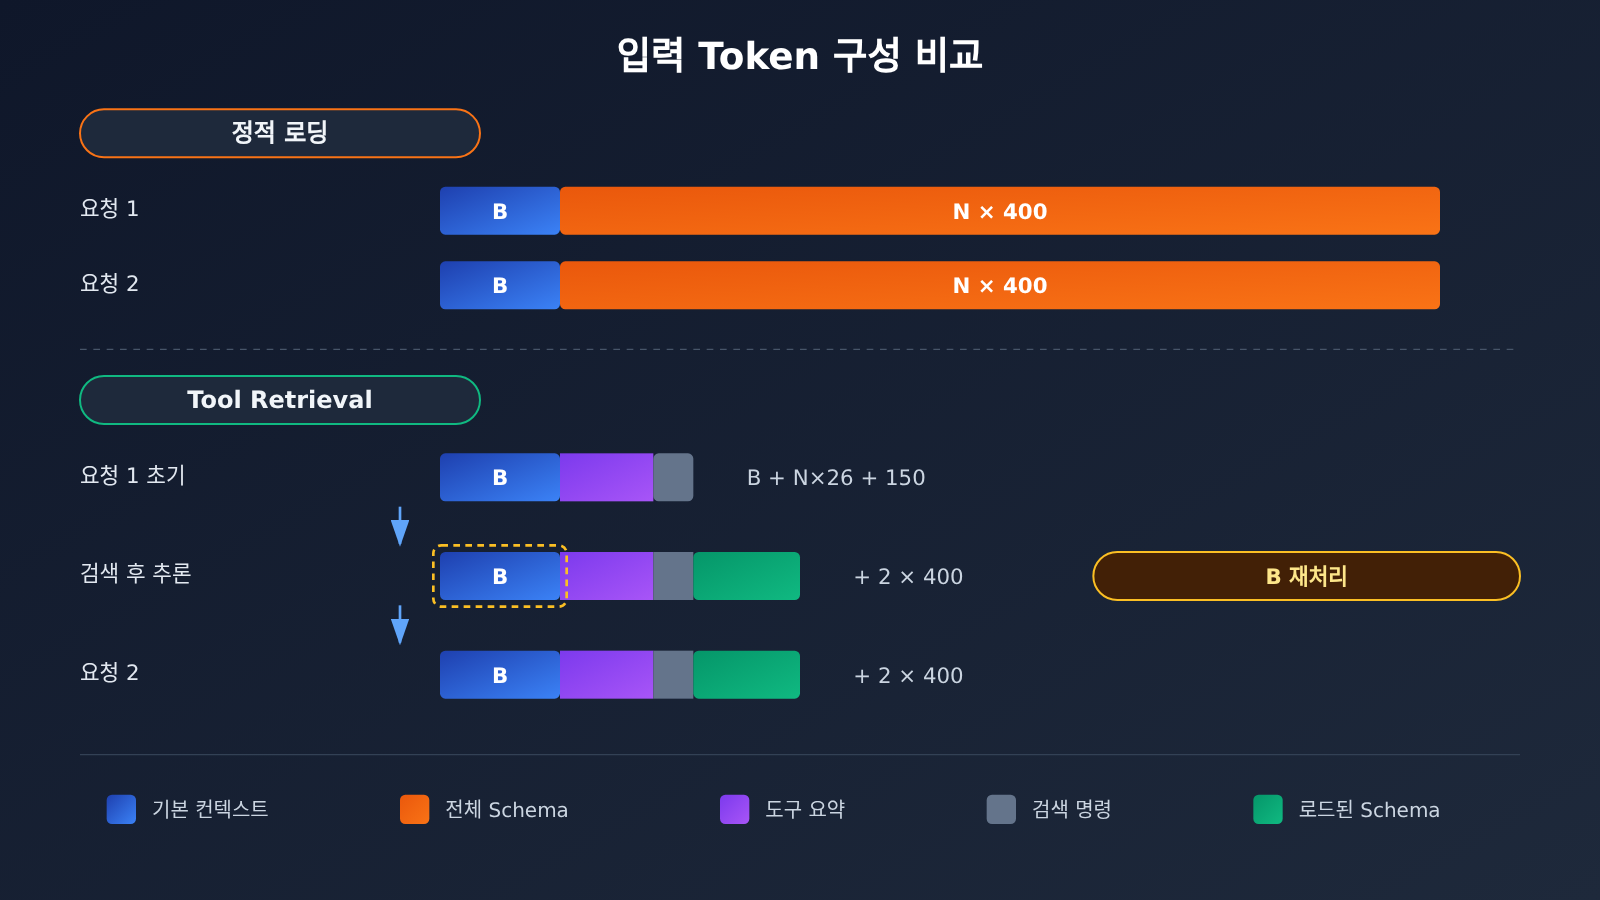
Gemini Tool Retrieval 공식 예시: 도구 200개와 도구 10개
두 예시는 모두 Google Tool Retrieval 문서에서 가져온 공식 가정 계산이에요. 프로덕션 환경 벤치마크가 아니며, 출력 토큰과 캐시 이점은 모두 무시했어요. 공통 전제는 다음과 같아요. 전체 Schema 하나당 400토큰, 지연 로딩 도구의 간략 설명 하나당 약 26토큰, 검색 지시문 150토큰, 작업 하나에 외부 요청 2회, 첫 번째 요청에서 서버 측 검색 1회 수행, 총 2개 도구 로드.
| 계산 항목 | 도구 200개, B=2,000 | 도구 10개, B=30,000 |
|---|---|---|
| 정적 로딩: 2 × (B + N × 400) | 164,000 | 68,000 |
| 요청 1 초기 입력 (B + N × 26 + 150) | 7,350 | 30,410 |
| 요청 1 검색 후 추론 (Schema 2개 추가) | 8,150 | 31,210 |
| 요청 2 입력 | 8,150 | 31,210 |
| Tool Retrieval 합계 | 23,650 | 92,830 |
| 변화량 | -140,350 | +24,830 |
| 변화 폭 (공식 수치 기준 재계산) | 약 -85.6% | 약 +36.5% |
도구 200개 시나리오에서 절감이 두드러지는 이유는 정적 방식이 매번 80,000토큰의 도구 정의를 함께 실어야 하는 반면, 기본 컨텍스트는 2,000토큰뿐이라 검색으로 추론을 한 번 더 수행하는 비용이 작기 때문이에요. 도구 10개 시나리오는 정반대예요. 도구 정의가 총 4,000토큰에 불과해 절감할 공간은 제한적인데, 검색 후 추론이 30,000토큰의 긴 컨텍스트를 다시 처리해야 하므로 추가 비용이 절감분을 바로 넘어서요.
Gemini Tool Retrieval의 Usage 필드, 가격과 캐시 규칙
Google은 interaction.usage에서 Tool Retrieval 비용을 분석하는 데 필요한 필드를 제공합니다:
| 필드 | 의미 | 비용 분석에서의 역할 |
|---|---|---|
total_input_tokens |
요청 내 첫 번째 모델 호출의 입력 | “초기 컨텍스트가 얼마나 짧아졌는지”만 반영 |
total_tool_use_tokens |
서버 측 도구와 검색으로 인해 발생한 추가 모델 호출 입력 | 검색 비용의 주요 원천이자 가장 쉽게 간과되는 부분 |
total_cached_tokens |
입력에 이미 포함되어 캐시로 처리된 부분 | 캐시 요율로 계산되며, 다시 중복 합산할 수 없음 |
total_output_tokens |
모델이 생성한 출력 | 출력 요율로 계산 |
total_thought_tokens |
추론 과정에서 생성된 Token | 선택한 모델의 출력 요율로 계산 |
가격 측면에서, Google 가격 페이지의 Standard 표준 가격을 보면 Gemini 4 Hydrogen의 입력은 백만 Token당 $1.50, 출력(Thinking 포함)은 $7.50, 캐시 입력은 $0.075입니다. 이 입력 단가 하나만으로 공식 산출 예시를 산술 변환해 보면, 200개 도구 시나리오는 약 $0.246 대 $0.0355, 10개 도구 시나리오는 약 $0.102 대 $0.139가 됩니다. 이는 가정한 Token 수에 공식 요율을 곱한 것일 뿐, 실제 청구서가 아닙니다.
캐시 규칙에는 두 가지 기준을 구분해서 이해해야 합니다. 첫째, Interactions API는 암시적 캐시만 지원하며, 2026년 11월 20일 기준 Gemini 4 시리즈, Gemini 3.8 Flash, Gemini 3.6 Flash의 암시적 캐시 최소 입력 규모는 모두 4,096 Token입니다. 둘째, Gemini 4의 멀티턴 대화와 Agent Loop에서는 새 요청에 최소 2,050 Token이 추가되어야 시스템이 이전 요청 전체를 캐시합니다. 부족할 경우 이전 요청 마지막의 2,050 Token이 표준 입력가로 다시 청구되며, 모델 출력, Thinking, 함수 결과가 모두 이 추가량에 포함됩니다.
자료 확인일 기준으로, Google은 실제 작업 세트에서의 Tool Retrieval Token 절감 비율, 지연 개선 폭, 도구 선택 정확도 향상을 공개하지 않았으며, 충분히 검증 가능한 독립 개발자의 프로덕션 실측 자료도 보이지 않습니다.
분석 판단: Gemini Tool Retrieval은 언제 진짜 Token을 절약할까
Gemini Tool Retrieval의 손익분기점: 도구 수가 몇 개일 때 활성화할 가치가 있을까
아래 내용은 공식 산출 예시의 파라미터로 도출한 확장 예시이며, Google이 공식 발표한 범용 임계값은 아닙니다. N을 전체 도구 수, B를 기본 컨텍스트라고 할 때, S=400, D=26, H=150, K=2와 “요청 2회, 검색 1회”라는 기준을 그대로 적용합니다:
- 정적 로딩: T_static = 2 × (B + 400N)
- 온디맨드 로딩: T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
이 공식은 공식 예시의 두 결과를 완전히 재현할 수 있습니다. T_retrieval < T_static이라고 두고 정리하면 722N > B + 2050, 즉 N > (B + 2050) / 722가 됩니다. 여기서 2050은 3 × 150 + 1600에서 나온 값으로, 단순한 대수적 결과일 뿐이며 캐시 문서에 나오는 Gemini 4 다중 턴 캐시의 2,050 Token 추가량 조건과는 전혀 관계가 없으니 절대 혼용하지 마세요.
| 기본 컨텍스트 B | 도구 수 N | 정적 로딩 | Tool Retrieval | 변화 | 폭 | 데이터 속성 |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | 공식 산출 예시 |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | 공식 산출 예시 |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | 확장 도출 |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | 확장 도출 |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | 확장 도출 |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | 확장 도출 |
B=30,000일 때 임계값은 N > 44.39, 즉 45번째 도구부터 온디맨드 로딩이 아주 약간 우세해지며, 임계점 근처에서는 절감 효과가 거의 무시할 수준입니다. 같은 공식에서 B=2,000이면 임계값은 약 5.6, 즉 도구 6개만으로도 판도가 뒤집힙니다. 여기서 알 수 있듯이 기본 컨텍스트가 길수록 검색 시 컨텍스트를 다시 처리하는 비용을 분산시키기 위해 더 큰 도구 라이브러리가 필요합니다.
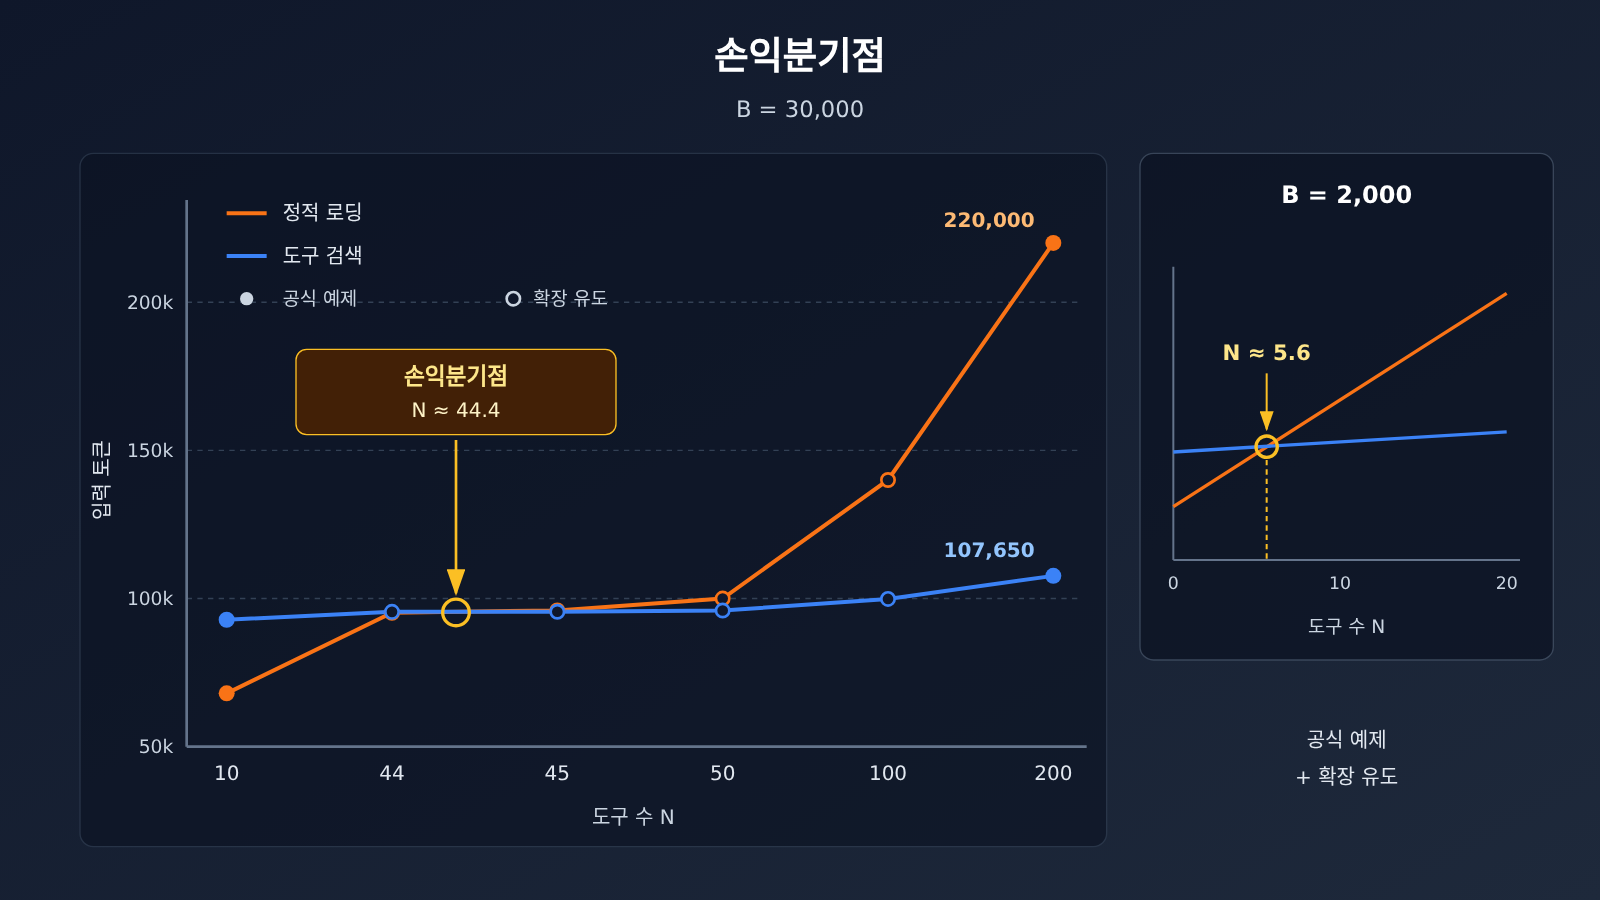
캡션: 처음 두 행의 데이터는 Google 공식 산출 예시이고, 나머지는 동일 기준으로 도출한 값입니다. 실제 작업에서는 검색 횟수와 로딩 수량에 따라 곡선이 달라지므로, 자체 비즈니스 요청으로 다시 측정해 보시길 권합니다. APIYI apiyi.com의 통합 인터페이스를 통해 여러 모델의 정적 로딩 기준선을 빠르게 띄워 대조해 볼 수 있습니다.
실제 작업은 이 가정을 엄격히 따르는 경우가 드물며, 다음 변수들이 임계점을 움직입니다:
- 검색 횟수: 서버 측 검색이 한 번 늘어날 때마다 “B + 도구 목록 + 이미 로딩된 Schema” 규모에 가까운 모델 입력이 한 번 더 생기며, 긴 컨텍스트 상황에서는 매번 B를 다시 지불하는 셈입니다.
- 실제 로딩 수량 K: 로딩하는 도구가 많을수록 절감은 줄어듭니다. 한번 로딩된 Schema는 내려놓을 수 없어 긴 세션에서 계속 누적됩니다.
- 개별 Schema 크기 S: 파라미터가 복잡하고 설명이 장황한 도구일수록 온디맨드 로딩의 이득이 큽니다. Schema가 아주 짧으면 이득이 목록 항목과 검색 지시문에 잠식됩니다.
- 세션 턴 수: 정적 방식은 매 턴마다 전체 Schema를 반복해야 하므로, 턴 수가 많고 새로운 검색이 더 이상 발생하지 않을 때 온디맨드 로딩의 우위가 더 뚜렷해집니다.
입력 토큰 감소, 총요금 하락, 더 빠른 응답: Gemini Tool Retrieval의 세 가지 “절약”
이 세 가지는 자주 혼동되지만 서로 같은 의미가 아니에요. 입력 토큰 감소는 가장 직관적이지만, total_input_tokens만 보면 total_tool_use_tokens에 기록된 검색 후 추론을 놓치게 되어 절감 폭을 과대평가할 수 있어요.
총요금 하락은 캐시와 단가에도 달려 있어요. 온디맨드 로딩은 초기 프롬프트를 짧게 만들지만, 원래 대량의 스키마 덕분에 4,096 토큰의 암시적 캐시 임계값을 넘고 있었다면, 활성화 후 오히려 캐시를 잃을 수 있어요. 함수 호출과 결과 반환의 짧은 루프에서 새로 추가된 내용이 2,050 토큰에 못 미치면 Gemini 4도 이전 요청의 전체 캐시를 받지 못해요. 즉, 토큰은 줄었는데 단가 구조는 오히려 나빠질 수 있다는 뜻이에요.
더 빠른 응답은 현재 공식 또는 독립 데이터로 뒷받침되지 않아요. 서버 측 검색은 클라이언트 왕복을 늘리지 않지만, 요청 내부에서 실제로 모델 추론이 추가로 실행돼요. 반면 클라이언트 측 검색은 검색할 때마다 API 왕복이 한 번 더 발생해요. 지연이 빨라지는지 느려지는지는 여러분의 엔드투엔드 테스트로만 답할 수 있어요.
Gemini Tool Retrieval Agent 작업의 실제 청구 금액 계산법
공식 Usage 의미에 따라, 표준 과금, 캐시 토큰이 입력에 포함됨, 그 외 건당 과금 도구가 없다는 전제에서 단일 요청은 이렇게 추정할 수 있어요:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
여기서 I, U, C, O, T는 위 표의 다섯 필드에 차례로 대응해요. Agent 작업은 보통 여러 요청에 걸쳐 이루어지므로, 각 요청의 Usage를 모두 합산한 뒤 계산하고, 최종적으로 “총비용 ÷ 성공적으로 완료된 작업 수”로 성공 작업 1건당 비용을 구해요.
Tool Retrieval을 켜기 전에 정적 로딩 베이스라인을 먼저 측정하는 것이 가장 안전한 방법이에요. 아래에서는 OpenAI 호환 인터페이스로 정적 Function Calling을 한 번 실행해 베이스라인 Usage를 기록해요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 정적 로딩 베이스라인 실행용
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # 모델명은 플랫폼 모델 목록 기준
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # 정적 전체 로딩 시의 입력 및 출력 토큰 기록
참고로 Tool Retrieval 자체는 Google Interactions API의 v1beta 버전에 의존해요. 위 예시는 정적 로딩 대조 데이터를 얻기 위한 것일 뿐이고, 온디맨드 로딩 쪽은 Interactions API를 지원하는 호출 방식을 사용한 뒤, 양쪽 Usage를 같은 비용 공식에 넣어 비교해야 해요.
전체 구현 코드 보기: 손익분기점 추정 + Usage 청구 금액 추산
import openai

# ---------- 1. 공식 예시 기준으로 이론적 추산 (확장 예시, 공식 임계값 아님) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # S=400, D=26, H=150, K=2일 때만 성립

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 임계 도구 수:", round(breakeven_tools(30000), 2))

# ---------- 2. Usage 필드 기준으로 단일 요청 비용(달러) 추산 ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T는 각각 total_input / tool_use / cached / output / thought tokens에 대응"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# 예시: Gemini 4 Hydrogen 표준가 1.50 / 0.075 / 7.50 (백만 Token당)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. 정적 로딩 베이스라인(OpenAI 호환 인터페이스) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # 다중 턴 작업을 집계할 때는 요청별로 누적
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 하나의 Key로 정적 로딩 베이스라인을 실행해 보세요. 실제 업무 작업 세트의 Token과 완료율을 기록한 뒤, Agent를 온디맨드 로딩으로 전환할지 판단하는 게 좋아요. 공식 안내 숫자만 보고 아키텍처를 바로 바꾸는 일은 피해야 해요.
Gemini Tool Retrieval 활성화 결정: 도구 라이브러리가 조건을 갖추었는가
공식 엔지니어링 권장 사항과 위의 추론을 종합하면, 아래 표로 우선 판단할 수 있어요. 최종적으로는 실제 작업의 단일 성공 작업 비용과 완료율을 기준으로 결정해야 해요:
| 워크로드 특성 | 권장 전략 | 이유 |
|---|---|---|
| 약 20개 미만의 안정적인 도구, 대부분 매 라운드 사용 | 계속 정적 로딩 | 공식 권장 사항이며, 절약되는 스키마가 적고 검색 오버헤드 비중이 큼 |
| 도구는 적지만 기본 컨텍스트가 매우 긴 경우 | 정적 로딩, 또는 소수의 큰 스키마 도구만 지연 로딩 | 매 검색마다 긴 컨텍스트를 다시 처리해야 하며, 10개 도구 계산 예시가 반례임 |
| 수십에서 수백 개 도구, 한 번에 소수만 사용 | 서버 측 검색 우선 평가 | 대형 롱테일 도구 라이브러리는 공식 200개 도구 계산 예시에 해당하는 시나리오 |
| 고빈도 도구 + 다수의 저빈도 전문 도구 혼합 | 고빈도는 직접 로딩, 저빈도는 defer_loading |
공식 권장 혼합 방식으로, 단순한 작업에서도 먼저 검색하는 일을 피함 |
| 멀티테넌시, 동적 도구, 사용자 권한별 필터링 필요 | 클라이언트 측 검색 평가 | 자체 레지스트리를 연결할 수 있지만 검색마다 왕복이 한 번 더 발생 |
| 시스템 지시에서 자주 지정되는 도구 | 직접 로딩 유지 | 공식 경고: 이름이 언급된 지연 도구가 검색을 우회해 직접 호출되면 오류가 날 수 있음 |
💡 선택 제안: 동일한 작업 배치를 정적 로딩과 필요 시 로딩 두 방식으로 각각 실행하고, 모델, 도구 라이브러리, 컨텍스트 길이, 캐시 조건을 동일하게 유지하세요. APIYI apiyi.com을 통해 통합 인터페이스에서 다양한 Gemini 및 기타 주류 모델을 전환해 베이스라인 비교를 할 수 있어, 비용 차이를 도구 로딩 전략 자체로 귀속시키기 쉬워요.
청구서에 직접 영향을 주는 엔지니어링 디테일도 몇 가지 있어요. store=false로 이력을 직접 관리할 때는 tool_search_call, tool_search_result 및 그 signature를 원형 그대로 보존해야 하며, 그렇지 않으면 이후 요청에서 HTTP 400이 발생할 수 있어요. 요청 본문을 줄이려고 지연 도구의 parameters를 생략해서는 안 되고, 디버깅할 때는 interaction.steps의 function_call을 확인해야 하며 interaction.status만 보면 안 돼요. 이러한 문제가 한 번 재시도를 유발하면 반복 요청의 Token도 비용에 포함돼요.
결국 Tool Retrieval은 “소수 도구는 자주 쓰이고 다수 도구는 오랫동안 유휴 상태”라는 전제 위에서 동작하는 비용 도구예요. 공식의 방향이 반대인 두 계산 예시가 경계를 이미 분명히 보여줘요: 도구 라이브러리가 클수록, 컨텍스트가 짧을록, 검색이 적을수록 절약될 가능성이 크고, 반대라면 더 쓸 수 있어요. 진짜 최적화 대상은 첫 요청의 Token 수가 아니라 성공한 작업당 총비용이에요.
청나라 진담연(陳澹然)이 《오언·천도건번의》에서 쓴 것처럼, “전체를 도모하지 않는 자는 한 영역도 도모할 수 없다.”
참고 자료
- Google 공식 발표: Introducing Tool Retrieval in the Gemini API(2026-11-19)
- 링크:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- 링크:
- Google Tool Retrieval 기술 문서: 구성, 과금, 공식 예제 및 제한 사항
- 링크:
aistudio.google.com/docs/tool-retrieval
- 링크:
- Google Context caching 문서: 암시적 캐싱 기준과 Gemini 4 멀티턴 캐싱 규칙
- 링크:
aistudio.google.com/docs/caching
- 링크:
- Google Gemini Developer API 가격: 모델 입력, 출력 및 캐시 요율
- 링크:
aistudio.google.com/docs/pricing
- 링크:
작성자: APIYI 기술팀
기술 교류: Gemini 등 여러 모델을 Agent 시나리오에서 활용할 때의 Token 비용을 비교해 보고 싶다면, APIYI apiyi.com을 방문해 테스트 크레딧을 받아보세요. 더 자세한 연동 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.


