
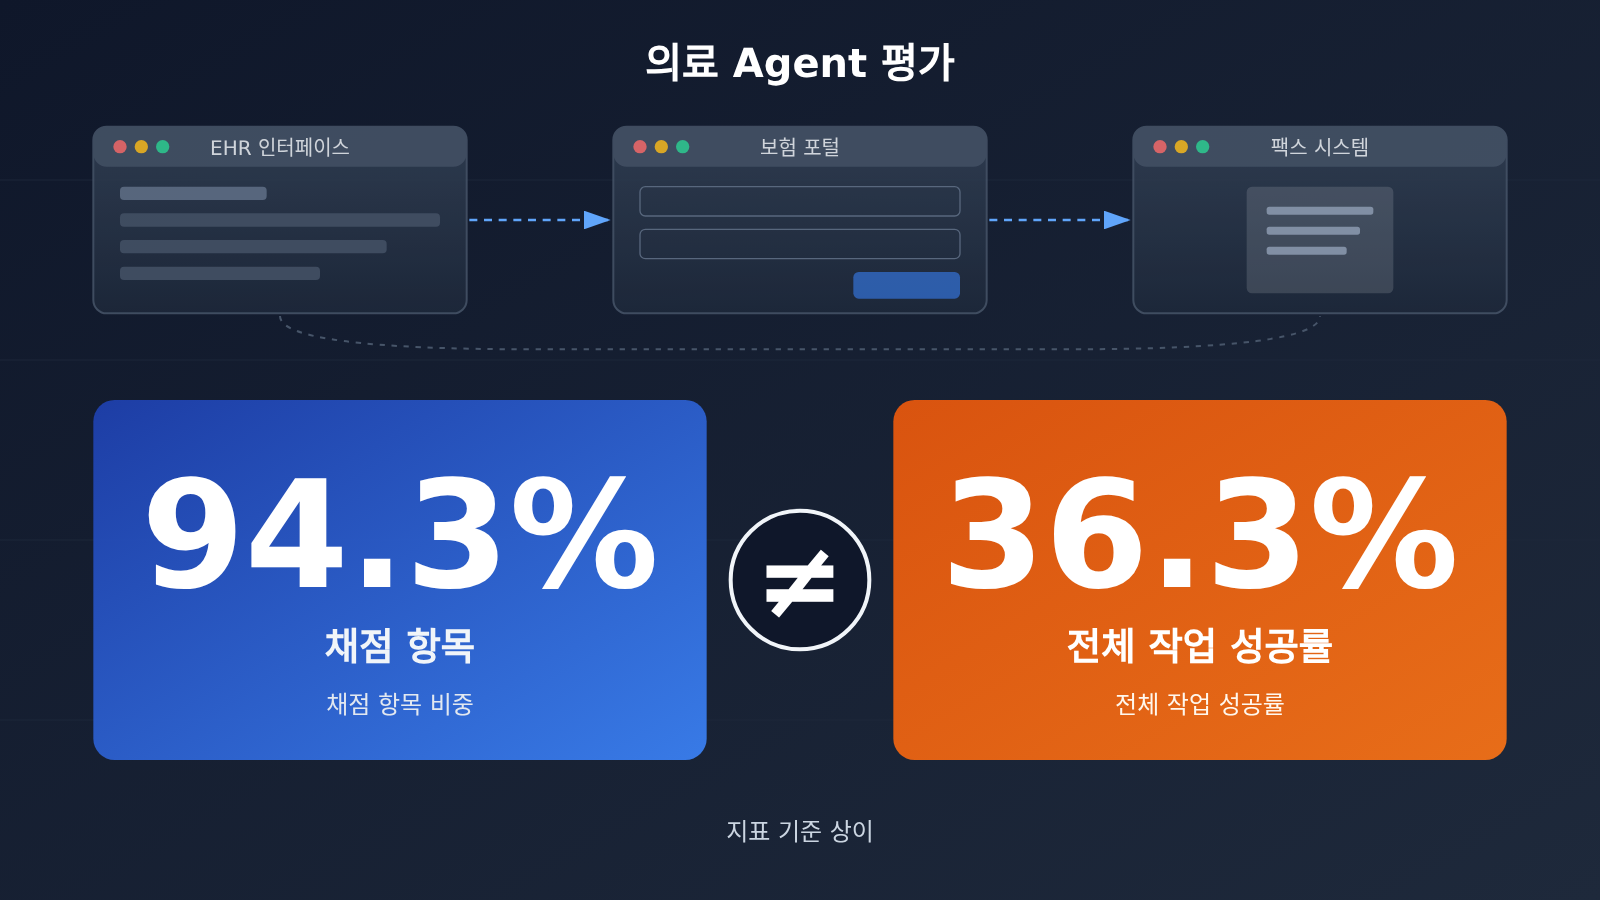
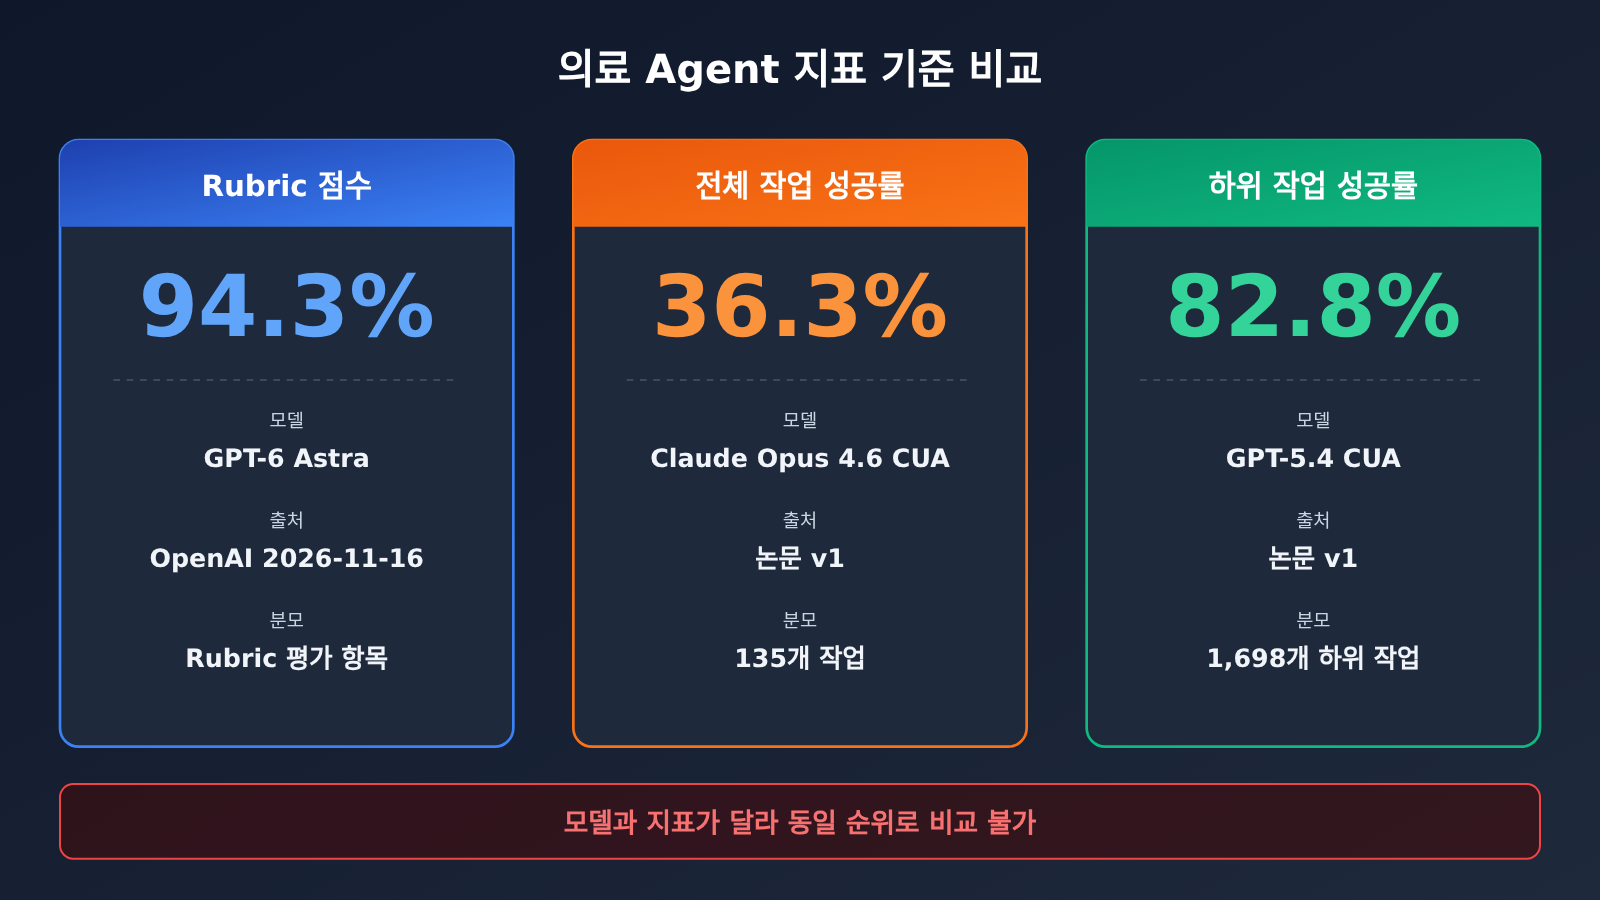
94.3%는 의료 행정 작업의 94.3%가 완전히 완료되었다는 뜻이 아니에요. OpenAI가 2026년 11월 16일에 공개한 GPT-6 Astra의 94.3%는 HealthAdminBench의 rubric points(채점 포인트) 점수 비율이고, 스탠퍼드 Shah Lab 논문에서 Claude Opus 4.6 CUA가 기록한 36.3%는 전체 작업 성공률(full-task success)이에요. 앞의 지표는 “채점 포인트를 얼마나 충족했는가”를, 뒤의 지표는 “성공 조건을 모두 충족한 작업이 얼마나 되는가”를 측정해요. 두 지표는 같은 지표가 아니고, 같은 리더보드에 올릴 수도 없어요.
의료 에이전트는 정보 검색, 문서 처리, 양식 작성 같은 단일 작업에서는 좋은 성과를 낼 수 있지만, 시스템을 넘나드는 업무 프로세스 한 건을 안정적으로 끝까지 완료하지는 못할 수 있어요. 에이전트가 프로덕션에서 가치가 있는지 판단하려면 하위 작업 성과, 엔드투엔드 성공률, 오류 유형, 실행 비용, 사람의 개입 여부를 함께 봐야 하고, 어떤 단일 점수도 충분하지 않아요.
이 글에서 알 수 있는 것
- 94.3%와 36.3%가 각각 무엇을 집계하는지, 왜 직접 비교할 수 없는지
- HealthAdminBench의 작업 구성, 채점 포인트 출처, 두 가지 검증 메커니즘
- 프로덕션 환경을 겨냥하고 다른 기업 에이전트에도 이식할 수 있는 평가 차원
목차: 객관적 사실 부분에서는 94.3%라는 성과가 왜 주목받는지, HealthAdminBench가 무엇을 측정하는지, 하위 작업 성공과 전체 작업 성공의 차이, 의료 에이전트가 가장 취약한 단계는 어디인지, 그리고 같은 모델이 실행 프레임워크에 따라 왜 다른 성과를 내는지를 차례로 설명해요. 분석·판단 부분에서는 종합 평가 프레임워크를 어떻게 구축할지, 비용을 어떻게 산정할지, 기업이 실제 적용에서 어떻게 선택하고 조정해야 할지를 논의해요.
알아두기: 의료 에이전트 평가를 이해하는 7가지 개념
| 개념 | 간단한 설명 |
|---|---|
| Computer Use | 소프트웨어 인터페이스를 관찰하고 클릭, 입력, 스크롤 등의 동작을 시뮬레이션해 작업을 완료하는 능력 |
| EHR | 전자 건강 기록 시스템으로, 병원이 환자 진료 정보를 저장하는 핵심 소프트웨어 |
| MCP | 외부 도구를 발견하고 호출하기 위한 표준 프로토콜 |
| RPA | 미리 설정한 규칙이나 스크립트로 반복 프로세스를 수행하는 자동화 방식 |
| Rubric points | 평가 규칙에 따라 받는 점수 항목으로, 부분 요구사항의 달성 정도를 측정 |
| 엔드투엔드 성공률 | 전체 작업이 모든 성공 조건을 충족한 비율로, 핵심 조건이 하나라도 실패하면 실패로 판정 |
| Trace | 실행 과정, 조작 동작, 인터페이스 상태를 기록한 추적 증거 |
의료 에이전트 평가 영향 한눈에 보기
- 개발자와 기술 리더: 벤더가 공개한 단일 점수만 보고 선택해서는 안 되며, 자체 작업으로 실행 메커니즘, 엔드투엔드 완료율, 스크린샷·재시도·실행 환경을 포함한 전체 비용을 검증해야 해요.
- 의료 기관과 워크플로 담당자: 합성 환경의 데모, 벤치마크 평가, 기관 파일럿, 프로덕션 사례라는 네 가지 증거를 구분해야 하고, 배포할 때는 사람의 승인, 최소 권한, 작업 감사를 적용해야 해요.
객관적 사실: 94.3%와 36.3% 뒤에 숨은 의료 에이전트 평가
94.3%라는 성적이 왜 주목받았을까요?
2026년 11월 16일, OpenAI는 의료팀을 위한 컴퓨터 조작 에이전트의 진전을 발표하며 여러 평가 데이터를 공개했어요. 그중 GPT-6 Astra는 HealthAdminBench에서 94.3%를, GPT-6 Luna는 91.8%를 기록했는데, 두 모델 모두 최대 추론 강도(maximum reasoning effort)에서 평가됐어요. OpenAI는 동시에 Luna의 작업당 비용이 0.085달러로 Astra보다 98% 낮다고 밝혔습니다.
이 숫자들이 눈에 띄는 이유는 앞서 스탠퍼드가 공개한 HealthAdminBench 결과가 훨씬 낮았기 때문이에요. 여기서 짚고 넘어갈 점은 OpenAI가 공개한 94.3%와 91.8%가 독립적인 전체 작업 성공률이 아니라 루브릭 포인트(rubric points) 득점 비율이라는 사실이에요. 같은 발표에 포함된 다른 두 데이터 역시 서로 다른 평가 단계에서 나온 것이고, 분모도 각기 다릅니다:
| 지표 | 수치 | 분모/기준 | 의미하지 않는 것 |
|---|---|---|---|
| HealthAdminBench 점수(Astra) | 94.3% | 루브릭 포인트 비율 | 전체 작업 성공률 |
| HealthAdminBench 점수(Luna) | 91.8% | 루브릭 포인트 비율 | 전체 작업 성공률 |
| 임상 작업 안전성(Astra) | 99% | 검토된 작업 325개 | 의학적 진단 정확도 |
| 의사 고도 인정 비율(Astra) | 93% | 의사 평가 646회 | 작업 성공률이며, 의사 646명과도 같지 않음 |
| Luna 작업당 비용 | $0.085 | 특정 평가 조건에서의 작업당 비용 | 실제 운영 배포 견적 |
이 세 가지 데이터는 분모가 서로 달라서 하나의 “종합 정확도”로 합칠 수 없어요. 게다가 OpenAI 발표 본문에는 작업별 결과, 전체 실험 설정, 신뢰 구간, 모든 실패 사례가 공개되지 않아서 외부에서 94.3%라는 점수의 구성을 독립적으로 검증할 방법이 현재로선 없습니다. Astra의 작업당 비용 약 4.25달러는 98% 하락 폭을 역산한 추정치이며, 공식적으로 직접 공개된 가격은 아니에요.
HealthAdminBench는 정확히 무엇을 측정할까요?
HealthAdminBench는 스탠포드 대학 Shah Lab이 제안한 벤치마크로, 컴퓨터를 조작하는 에이전트가 의료 행정 작업을 얼마나 잘 수행하는지 평가하는 데 특화돼 있어요. 공개된 버전은 시점에 따라 내용이 달라요. 초기 연구 웹페이지에서는 70개 작업, 947개 채점 포인트, 6개 에이전트를 설명했고, 논문 2604.09937v1 버전에서는 135개 작업, 1,698개의 검증 가능한 하위 작업, 7개 모델 구성으로 확장됐어요. 이 글에서는 논문 버전을 기준으로 하고, 초기 웹페이지 데이터는 역사적 비교용으로만 다뤄요.
논문 버전의 네 가지 시뮬레이션 GUI 환경은 EHR, 보험 지급 포털 A, 보험 지급 포털 B, 팩스 포털이에요. 135개 작업은 세 가지 행정 워크플로로 나뉘어요.
| 작업 유형 | 수량 | 주요 내용 |
|---|---|---|
| 사전 승인(Prior Authorization) | 60 | 보험 자격 확인, 의료 기록 수집, 사전 승인 신청 제출 |
| 이의 제기 및 거절 관리(Appeals and Denials Management) | 60 | 거절된 청구 검토, 증빙 자료 수집, 이의 제기 준비 및 제출 |
| DME 주문 처리(의료 장비 주문) | 15 | 의료 장비 자료 수집, 주문 제출, 결과 기록 |
1,698개의 채점 포인트는 두 가지 방식으로 생성돼요. 1,177개는 결정론적 검사를 사용해요. JMESPath 같은 구조화된 도구로 시스템 상태를 확인하는 방식이죠. 예를 들어 올바른 환자를 찾았는지, 지정된 필드를 입력했는지, 올바른 주문을 생성했는지 등을 확인하며, 접근 방식은 전통적인 소프트웨어 테스트와 비슷해요. 나머지 521개는 LLM Judge가 판단하도록 맡겨요. 주로 문서 내용이 충분한지, 제출 자료가 요구 사항을 충족하는지처럼 규칙만으로 직접 검증하기 어려운 부분을 평가해요.
모든 작업은 실제 환자 기록이 아니라 합성 환자 데이터를 사용해요. 즉, 이 벤치마크가 제공하는 것은 재현 가능한 테스트 환경이며, 실제 병원의 운영 시스템에서 테스트하는 것도 아니고, 환자 진료 결과를 직접 측정하지도 않아요.
하위 작업 성공과 전체 작업 성공의 차이는 무엇인가요?
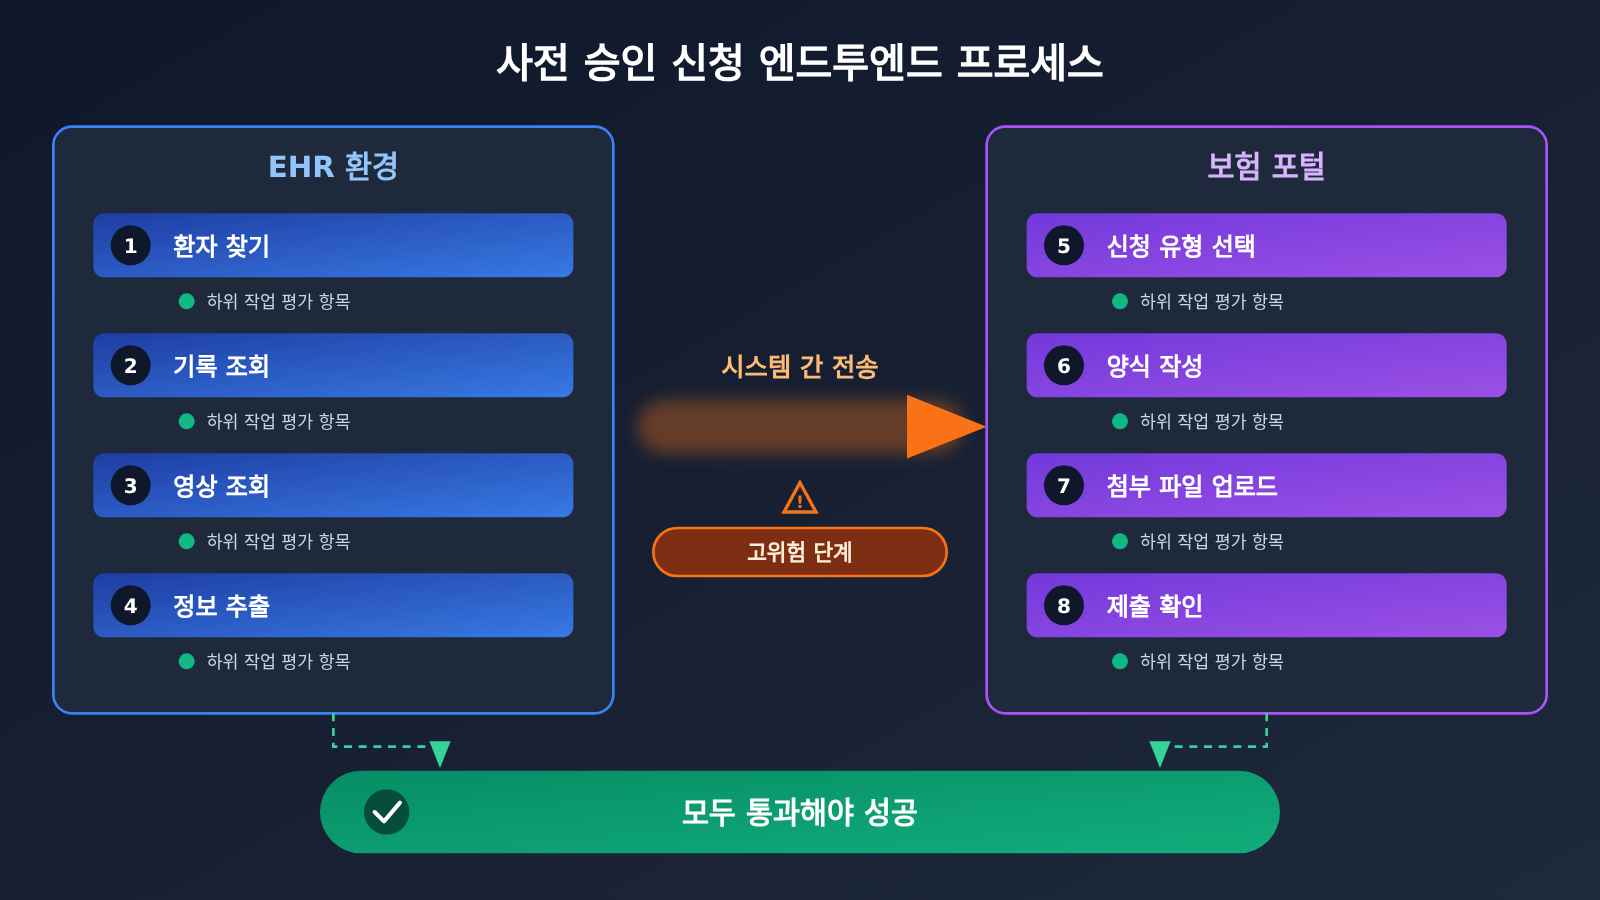
사전 승인 신청 절차를 따라가 보면 두 가지 차이를 가장 쉽게 알 수 있어요. 연구 자료의 설명에 따르면, 하나의 사전 승인 작업에서는 Agent가 다음 단계를 순서대로 수행해야 하는 경우가 있어요.
- EHR에서 올바른 환자 찾기
- 환자의 진료 기록 확인하기
- 영상 검사와 과거 치료 자료 찾기
- 보험 신청에 필요한 증빙이 무엇인지 판단하기
- 진료 기록에서 필요한 정보 추출하기
- 보험 지급 포털에 접속하기
- 올바른 신청 유형 선택하기
- 신청서 작성하기
- 필요한 서류 첨부하기
- 신청서 제출 및 상태 확인하기
이 열 단계는 서로 강하게 의존해요. 1단계에서 환자를 잘못 선택하면 이후 단계를 아무리 제대로 해도 모두 잘못된 결과가 돼요. 앞의 아홉 단계가 모두 올바르더라도, 9단계에서 첨부 파일을 빠뜨리거나 10단계에서 실제로 제출하지 않으면 전체 작업은 여전히 실패로 판정돼요. 하위 작업 성공률은 ‘열 단계 중 몇 단계를 올바르게 했는가’를 집계하고, 전체 작업 성공률은 ‘열 단계를 모두 올바르게 했는가’를 집계해요.
논문이 제시한 데이터는 이런 격차를 분명하게 보여줘요. GPT-5.4 CUA의 하위 작업 성공률은 82.8%, Claude Opus 4.6 CUA의 전체 작업 성공률은 36.3%예요. 두 수치는 서로 다른 모델에 속하므로 역시 직접 비교할 수는 없지만, 함께 한 가지 사실을 말해줘요. 개별 동작을 완료하는 것과 전체 업무 흐름을 완료하는 것은 서로 다른 능력이라는 점이에요.
초기 연구 웹페이지에서도 비슷한 격차를 보고했어요. Claude Opus 4.5의 최고 전체 작업 성공률은 22.9%, Gemini 3의 하위 작업 성공률은 76.4%였어요. 작업 규모와 버전이 달라서 이 수치들은 추세를 관찰하는 데만 쓸 수 있고, 논문 버전이나 OpenAI의 결과와 같은 순위에 넣을 수는 없어요.
의료 Agent는 가장 쉽게 어느 단계에서 실패할까요?
논문은 하위 작업 범주별로 두 가지 CUA 구성의 성적을 공개했어요:
| 하위 작업 범주 | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| 정보 검색 | 96.5% | 96.1% |
| 문서 작성 | 74.3% | 84.4% |
| 양식 작성 | 88.9% | 84.9% |
| 작업 해결 | 70.7% | 66.2% |
| 문서 처리 | 92.3% | 94.3% |
| 임상 추론 | 61.3% | 77.0% |
여기서 특히 주의할 점이 있어요. 표에 나온 GPT-5.4 CUA의 문서 처리 성적 94.3%는 OpenAI가 공개한 GPT-6 Astra의 전체 rubric points 94.3%와 단지 숫자가 우연히 맞아떨어진 것일 뿐, 모델도 지표도 출처도 완전히 달라요.
세부 항목으로 보면 정보 검색은 이미 포화 상태에 가깝고, 임상 추론과 작업 해결, 문서 작성은 상대적으로 취약한 편이에요. 논문은 동시에 문서 처리(Document Handling)와 시스템 간 데이터 전송(Cross-system Data Transfer)이 엔드투엔드 실패를 일으키는 주요 원인이라고 지적해요. 초기 웹 버전에서는 여섯 개 모델 중 다섯 개가 문서 처리 하위 작업에서 정확도 20% 미만을 기록했다고 보고했는데, 이는 다른 버전의 작업 설정에 해당하므로 위 표와 직접 비교할 수는 없어요.
시스템 간 전송은 왜 유독 오류가 잦을까요? 사전 승인 절차에서는 동일한 정보를 EHR에서 읽어내고, Agent의 컨텍스트에 저장한 뒤, 보험 포털의 또 다른 양식 구조에 다시 써 넣어야 해요. 첨부 파일은 팩스 포털을 거쳐 흐를 수도 있고요. 정보가 옮겨질 때마다 오류가 생길 기회가 생기고, 상류에서 발생한 하나의 오류는 그대로 하류 시스템에 복사돼요. OpenAI 자료에 정리된 위험 요소에는 “오류 정보를 한 시스템에서 다른 시스템으로 전파하는 것”과 “시스템 상태가 불분명할 때 작업 완료를 잘못 보고하는 것”도 포함돼 있어요.
왜 같은 모델이 실행 프레임워크에 따라 다른 성능을 보일까요?
논문은 프롬프트 방식과 관찰 모드에 대한 소거 실험(ablation)을 진행했고, 주요 발견은 세 가지예요:
- Portal Guidance(포털 조작 안내)를 제공하는 것이 단순히 태스크 설명만 제공하는 것보다 대체로 더 좋은 성과를 보여요
- Accessibility Tree(접근성 트리) 관찰 방식이 순수 스크린샷 관찰보다 대체로 우수해요
- 포털 조작 안내와 구조화된 페이지 정보를 결합할 때 엔드투엔드 성과가 대체로 더 좋아져요
논문은 또한 실제 프로덕션 환경이 항상 완전한 Accessibility Tree를 제공하지는 못할 수 있다고 지적해요. 다시 말해 Agent의 성과는 기반 모델뿐만 아니라 실행 프레임워크(Harness), 페이지 관찰 방식, 프롬프트, 태스크 설명에도 달려 있어요.
OpenAI의 개발자 문서 역시 실행 경로의 차이를 보여줘요. 공식 가이드는 ComputerToolset, BrowserToolset, 호스팅 브라우저 진입점을 각각 설명하고 있어요. GPT-6 Astra의 경우 현재 문서는 Code Execution 방식을 권장하는데, 즉 모델이 Playwright 같은 코드를 생성해 인터페이스를 조작하는 방식이에요. Computer Tool은 여전히 선택적 방안으로 남아 있어요. 문서는 또 모델이 생성한 조작 지시가 곧 조작 성공을 의미하지는 않으며, 애플리케이션이 실제로 실행한 뒤 새로운 스크린샷이나 다른 방법으로 결과를 검증해야 한다고 강조해요.
CVS Health가 오픈소스로 공개한 CUA Agent Kit(Apache-2.0)는 또 다른 엔지니어링 접근법을 제시해요. README에 공개된 메커니즘은 이러해요: 먼저 Computer-use Agent가 워크플로를 탐색하고 스크린샷, 액션, Trace를 증거로 저장하고, 그다음 Codex Skill이 성공한 궤적을 결정적 코드로 고정화한 뒤 엔지니어의 검토를 거쳐요. 이후의 결정적 실행에는 모델 Key가 필요 없어요. 이는 “어떻게 할지 발견하기”와 “안정적으로 반복 수행하기”를 두 개의 문제로 분리했어요.
분석 판단: 진정으로 활용 가능한 의료 Agent를 어떻게 평가할 것인가
진정으로 활용 가능한 Agent를 어떻게 평가할까?
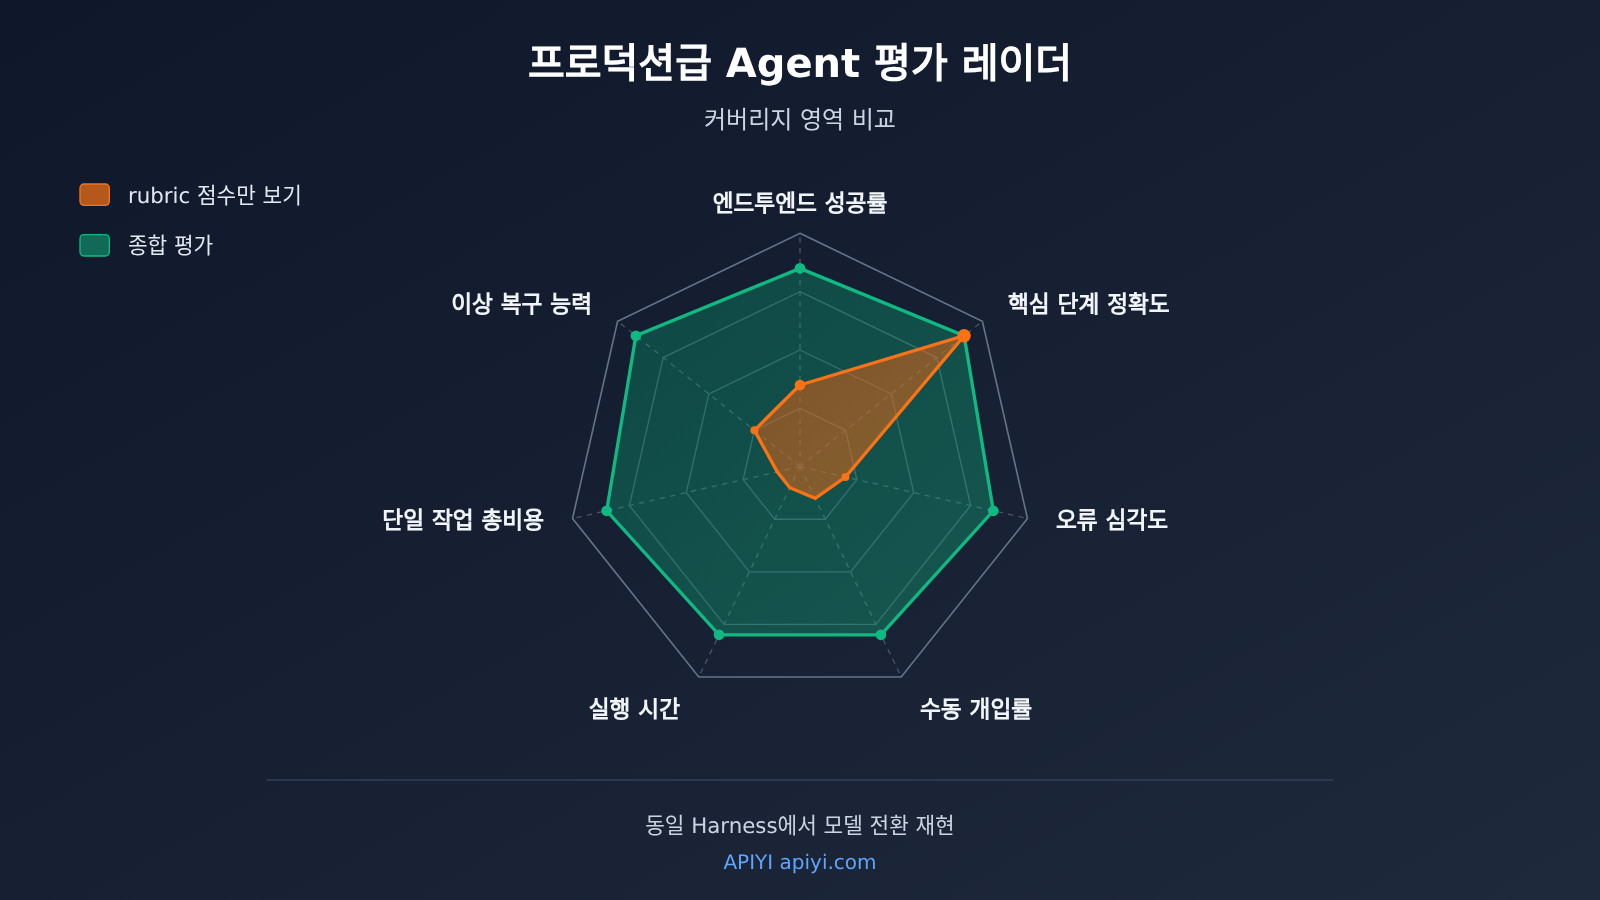
다음은 이 글의 판단이며, 어떤 기관의 공식 기준도 아닙니다. 우리는 94.3%와 같은 rubric point 점수가 “모델의 국소 능력이 얼마나 개선되었는가”를 답하기에는 적합하지만, “생산 프로세스에 투입할 수 있는가”를 답하기에는 부족하다고 생각합니다. 후자의 질문에는 서로를 제약하는 지표 세트가 필요합니다:
| 평가 차원 | 무엇을 측정하는가 | 왜 필요한가 | 데이터 출처 |
|---|---|---|---|
| 엔드투엔드 성공률 | 전체 태스크가 모든 성공 조건을 만족하는 비율 | 업무는 최종 결과만 인정함 | 시스템 최종 상태 검증 |
| 핵심 단계 정확성 | 환자 선택, 제출, 첨부 파일 업로드 등 핵심 노드의 정확도 | 핵심 단계 하나만 틀려도 전부 틀림 | 결정적 검사 |
| 오류 심각도 | 실패가 복구 가능한 누락인지, 아니면 데이터를 잘못 쓰거나 메시지를 잘못 보낸 것인지 | 동일한 실패율이라도 리스크 차이가 큼 | 수동 검토 + 등급 태그 |
| 수동 개입률 | 수동 인수인계 또는 승인 수정이 필요한 비율 | 실제 절감되는 인력을 결정 | 승인 로그 |
| 실행 시간 | 단일 태스크 소요 시간 및 롱테일 소요 시간 | 처리량과 대기에 영향 | Trace 타임스탬프 |
| 단일 태스크 전체 비용 | 모델, 스크린샷, 재시도, 실행 환경, 유지보수의 총합 | Token 단가로는 실제 비용을 대표할 수 없음 | 청구서 + 실행 기록 |
| 이상 복구 능력 | 모호함, 타임아웃, 페이지 변경에 직면했을 때 멈추거나 롤백할 수 있는지 | 의료 시나리오에서는 반드시 “멈출 줄 알아야” 함 | 장애 주입 테스트 |
이 프레임워크의 핵심은 “몇 단계를 올바르게 했는가”와 “몇 가지 일을 완수했는가”를 별도로 보고하고, 이어서 오류 심각도와 수동 개입률로 둘을 보정하는 것입니다. Ambience가 보여준 방안은 “이상 복구”라는 차원을 정확히 구현합니다: 진료 기록에 모호함이 있을 때 Agent가 멈추고 의사에게 질의하며, 의사가 승인한 후에야 사전 허가 신청을 제출합니다. 이는 해당 회사가 시연한 거버넌스 방안일 뿐, 모든 의료 Agent가 기본적으로 동일한 구성을 갖추고 있다는 의미는 아닙니다.
표본 크기와 반복 횟수도 공개해야 합니다. RPA와 Agent를 비교한 한 연구(DOI: 10.1080/23311975.2026.2724760)는 P2, P3 두 프로세스에서 각 기술마다 10회씩 실행했지만, P1에서는 Agent가 단 1회만 실행되고 실패하여 이후 통계에서 제외했습니다; 이 연구는 2025년 도구 구성을 사용했으므로 2026년 모델의 직접적인 성적으로 볼 수 없습니다. 이 사례는 평가 결론을 읽을 때 각 숫자 뒤에 몇 번이 실행되었고, 어떤 결과가 제외되었는지부터 살펴봐야 함을 보여줍니다.
의료 Agent 평가의 실무 적용: 동일한 Harness에서 직접 실행하기
개발 팀에게 가장 현실적인 방법은 실행 프레임워크를 고정하고, 자체 태스크 세트에서 서브태스크 지표와 엔드투엔드 지표를 동시에 집계하는 거예요. 아래 예시는 LLM Judge를 사용해 Agent가 제출한 자료에 점수를 매기며, 인터페이스는 OpenAI SDK와 호환돼요:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 다양한 심사 모델로 전환 가능
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
전체 구현 보기: 서브태스크 성공률과 엔드투엔드 성공률 동시 계산
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # 핵심 단계 여부 (실패하면 전체 태스크 실패)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # 재시도 Token 포함, 중복 누적 금지

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """규칙으로 정의하기 어려운 서브태스크에 LLM Judge 사용"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 기술 제안: 서브태스크 점수와 엔드투엔드 성공률은 가급적 동일한 Harness, 동일한 태스크 배치에서 나란히 보고하는 게 좋아요. APIYI apiyi.com의 OpenAI 호환 인터페이스를 이용하면 하나의 API 키로 OpenAI, Claude, Gemini 등의 모델 사이에서 실행 모델이나 심사 모델을 전환할 수 있어서, 접속 방식이 달라서 생기는 변수를 줄일 수 있답니다.
의료 Agent 비용 산정과 모델 계층화
Token 단가는 시작점일 뿐이에요. 2026년 11월 17일 OpenAI가 공개한 Standard 짧은 컨텍스트 가격을 기준으로 보면, GPT-6 Astra의 입력·출력·캐시 입력은 각각 100만 Token당 10달러, 50달러, 1달러이고, GPT-6 Luna는 0.10달러, 0.50달러, 0.01달러예요. 처리 속도, 컨텍스트 길이, 지역에 따라 실제 과금은 달라질 수 있어요. Computer Use는 여러 턴을 호출하는 방식이라 매 턴의 스크린샷이 모두 비전 입력으로 잡히기 때문에, 비용을 계산할 때는 턴별 비전/텍스트 입력과 과금 대상 출력을 각각 집계한 뒤 도구, 실행 환경, 엔지니어링 유지보수 비용을 더해야 해요. 재시도로 소모된 Token이 이미 총량에 포함돼 있다면 다시 한 번 중복해서 더하지 않도록 해요.
0.085달러와 약 4.25달러의 격차를 보면, 모델 계층화는 상당히 일반화된 방식이 될 가능성이 커요. 복잡하고 강한 추론이 필요한 작업은 고성능 모델에, 구조화 수준이 높고 빈도가 큰 작업은 저비용 모델에 맡기고, 이미 검증된 고정 프로세스는 CVS의 접근처럼 결정적 코드로 고정하는 거죠. 다만 여기서 말하는 단일 작업 비용은 특정 기준 조건에서 나온 값이라 생산 견적서로 쓸 수는 없다는 점을 밝혀 둘게요.
💰 비용 최적화: 계층별 모델 선택을 하기 전에, 소량의 실제 작업으로 각 모델의 엔드투엔드 성공률과 작업당 전체 비용을 먼저 측정해 보길 권해요. APIYI apiyi.com은 사용량 기반 과금을 적용하고 신규 사용자에게 무료 테스트 크레딧을 제공하기 때문에, 프로젝트 초기 단계에서 이런 대조 실험을 저비용으로 진행하기에 적합해요.
의료 Agent에서 기업 Agent로: 전이 가능한 평가 접근법
의료 행정의 특수성은 고위험과 강한 규제에 있지만, 그것이 드러내는 문제는 보험 청구, 재무 대사, 공급망 서류 등 기업 프로세스에도 똑같이 존재해요. 다중 시스템, 강한 의존성, 시스템 간 데이터 이동이 바로 그것이죠. 우리의 판단은 다음 네 가지 원칙을 그대로 전이할 수 있다는 것이에요.
- 보고서 분리: 하위 작업 점수와 엔드투엔드 성공률을 별도로 기재하고, 절대 전자로 후자를 대체하지 않기
- 증거 등급 표기: 합성 환경 데모, 벤더 자체 평가, 제3자 벤치마크, 기업 파일럿, 프로덕션 사례를 각각 구분해 귀속하고 혼용하지 않기
- Harness 고정 후 비교: 관찰 방식, 프롬프트, 포털 가이드가 한 번이라도 바뀌면 성적은 더 이상 비교 가능하지 않음
- 통제가 점수보다 우선: 최소 권한, 핵심 작업에 대한 인간 승인, 작업 후 상태 검증, 전 과정 Trace 기록, 이상 중지 메커니즘은 출시 전에 인수 항목으로 삼아야 함
기업 내부에서 PoC를 할 때는 작업 집합을 “핵심 단계”별로 태깅하고, 먼저 엔드투엔드 베이스라인을 뽑은 뒤 포털 가이드, 구조화된 관찰, 코드 고정화를 점진적으로 도입하면서 각 변경이 전체 성공률에 실제로 기여하는 바를 관찰할 수 있어요. 여러 모델 사이에서 같은 배치의 작업을 빠르게 재현해야 한다면 APIYI apiyi.com을 통해 통합 접속해 횡적 비교의 엔지니어링 비용을 낮출 수 있어요.
계속 주목할 만한 후속 발전으로는 OpenAI가 94.3%의 이면에 있는 작업별 결과와 실험 구성을 공개할지, HealthAdminBench 후속 버전이 동일한 기준 아래 새 모델의 전체 작업 성공률을 발표할지, 그리고 더 많은 기관이 실제 프로덕션 환경의 인간 개입률과 오류 등급 데이터를 공개할 수 있을지가 있어요. 이러한 정보가 나오기 전까지 “의료 행정이 이미 전면 자동화 가능하다”는 어떤 주장도 추측에 불과해요.
94.3%는 모델이 채점 포인트에서 뚜렷이 진보했음을 증명하고, 36.3%는 사람들에게 일깨워줘요. 하나의 비즈니스 프로세스가 안정적으로 완수될 수 있는지는 결국 완전한 작업, 실제 시스템, 인간 감독 아래에서 검증해야 한다는 것을요. 영어 속담처럼요: “The proof of the pudding is in the eating.”(푸딩이 맛있는지는 먹어봐야 알 수 있다; 실제 효과는 실천으로 검증해야 한다.)
참고 자료
- OpenAI: 의료 팀을 위한 컴퓨터 사용 에이전트의 발전(Advancing computer-use agents for healthcare teams): 94.3%, 91.8%, 99%, 93% 등의 평가 데이터와 협업 사례
- 링크:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- 링크:
- HealthAdminBench 논문 2604.09937v1: 135개 작업, 1,698개 하위 작업, 항목별 결과 및 절제 실험(ablation)
- 링크:
arxiv.org/html/2604.09937v1
- 링크:
- HealthAdminBench 프로젝트 페이지 및 코드 저장소: 벤치마크 환경과 평가 구현
- 링크:
som-shahlab.github.io/health-admin-bench-website/ - 링크:
github.com/som-shahlab/health-admin-bench
- 링크:
- Stanford Shah Lab 초기 연구 페이지: 70개 작업, 947개 채점 항목으로 구성된 과거 버전
- 링크:
shahlab.stanford.edu/doku.php?id=healthadminbench
- 링크:
- OpenAI Computer Use 개발자 문서 및 API 가격: 실행 경로와 Standard 가격
- 링크:
developers.openai.com/api/docs/guides/tools-computer-use - 링크:
developers.openai.com/api/docs/pricing
- 링크:
- CVS Health CUA Agent Kit: 탐색, 근거, 코드 고정화(固化) 및 엔지니어 검토 메커니즘
- 링크:
github.com/cvs-health/cua-agent-kit
- 링크:
- RPA와 Agent 비교 연구: 반복 실행 횟수와 P1 예외 설명
- 링크:
doi.org/10.1080/23311975.2026.2724760
- 링크:
- Cambridge Dictionary: 속담 proof of the pudding is in the eating의 뜻
- 링크:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com을 방문해 Agent 평가 실무를 함께 이야기해 보세요. 더 많은 연동 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.


