
작성자 노트: 이 글은 Tencent 연구 페이지의 블라인드 테스트, 부록 벤치마크, 제품 측 증언을 뜯어보며 Hy4 flash와 GLM-5.3-Flash를 일상 작업, 터미널 코딩, 비용, 연동 프로토콜 측면에서 비교하고, 오늘 APIYI에서 어느 쪽을 호출할 수 있는지도 정리합니다.
Tencent Hunyuan은 2026-11-16에 Hy4 flash를 출시했고, 공식적으로는 “일상 생산성에서 가장 저렴한 모델”로 자리매김했어요. 지금 많은 분이 GLM-5.3-Flash와 이 모델 중 하나를 일상 주력으로 고르고 있습니다. Tencent 연구 페이지는 세 가지 자료를 내놓았어요. 수동 블라인드 테스트, 부록 벤치마크 표, 제품 측 증언입니다. 그런데 세 곳의 결론 방향이 완전히 일치하지는 않아요.
이건 “각자 장점이 있다”는 식의 절충안이 아니에요. 아래에서는 세 곳의 데이터를 따로 제시하고, 모든 수치에 출처를 표시합니다. 마지막으로 시나리오별로 명확한 선택을 제시하고, 오늘 APIYI에서 바로 호출할 수 있는 모델이 어느 쪽인지도 설명할게요.
핵심 가치: 이 글을 다 읽으면 Hy4 flash가 블라인드 테스트에서 어디서 이겼는지, GLM-5.3-Flash가 부록 벤치마크에서 어디서 이겼는지, 그리고 연동할 때 주의해야 할 프로토콜과 가격 기준까지 알게 됩니다.
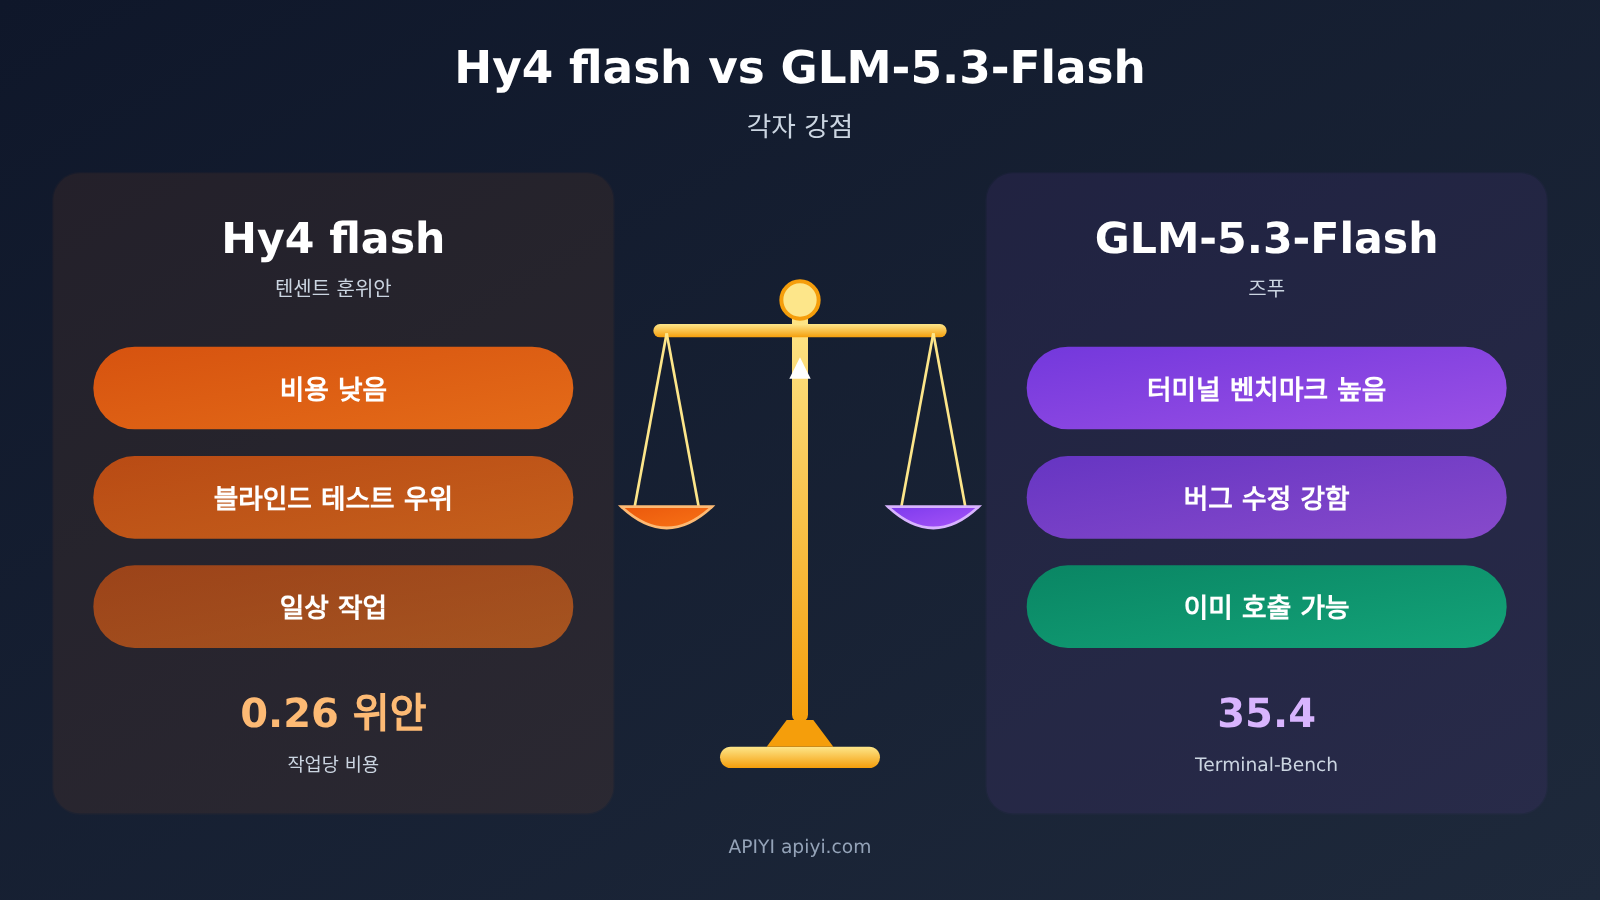
Hy4 flash와 GLM 5.3 Flash의 핵심 차이
먼저 결론부터 말하면, 어느 쪽이 모든 걸 압도하는 건 아니에요. 텐센트의 블라인드 테스트에서는 Hy4 flash의 만족도가 더 높고, 더 빠르고, 더 저렴했어요. 반면 부록에 있는 Terminal-Bench 4.0과 PPTFixBench처럼 ‘수정, 터미널 작업’에 치우친 항목에서는 GLM-5.3-Flash의 점수가 더 높았습니다.
| 비교 기준 | Hy4 flash | GLM-5.3-Flash | 데이터 출처 |
|---|---|---|---|
| 블라인드 테스트 만족도(4점 척도) | 2.79 | 2.53 | 텐센트 연구 페이지 블라인드 테스트 표(공식 자체 보고) |
| 중앙값 엔드투엔드 시간 | 6.7분 | 7.6분 | 위와 같음 |
| 블라인드 테스트 작업당 비용 | 0.26위안 | 0.81위안 | 위와 같음, 인민폐 |
| Terminal-Bench 4.0 | 19.2 | 35.4 | 텐센트 연구 페이지 부록 |
| PPTFixBench | 23.7 | 28.6 | 텐센트 연구 페이지 부록 |
| MdCoEditBench(Markdown 공동 작성) | 56.9 | 32.3 | 텐센트 연구 페이지 부록 |
| 사양 | 총 224B 파라미터(64B Engram 포함), 활성 12B, 1M 컨텍스트 | 총 320B 파라미터, 활성 18B, 1M 컨텍스트, 최대 출력 128,000 | 연구 페이지 / APIYI 모델 페이지 |
| 사용 가능 플랫폼 | 텐센트 클라우드 TokenHub, WorkBuddy 등; APIYI에는 아직 미등록 | APIYI apiyi.com에 glm-5.3-flash 등록됨 |
연구 페이지 / APIYI 모델 목록 |
이 표의 모든 점수는 텐센트 한쪽에서 나온 것이고, GLM은 나와서 자신을 변호하지 않았어요. 볼 때 기억해야 할 점은, 블라인드 테스트와 부록 모두 텐센트의 공식 자체 보고이며, 평가 세트 대부분이 텐센트 내부 세트라 공개 최종 순위가 아니라는 거예요.
Hy4 flash와 GLM 5.3 Flash의 세 가지 데이터 기준
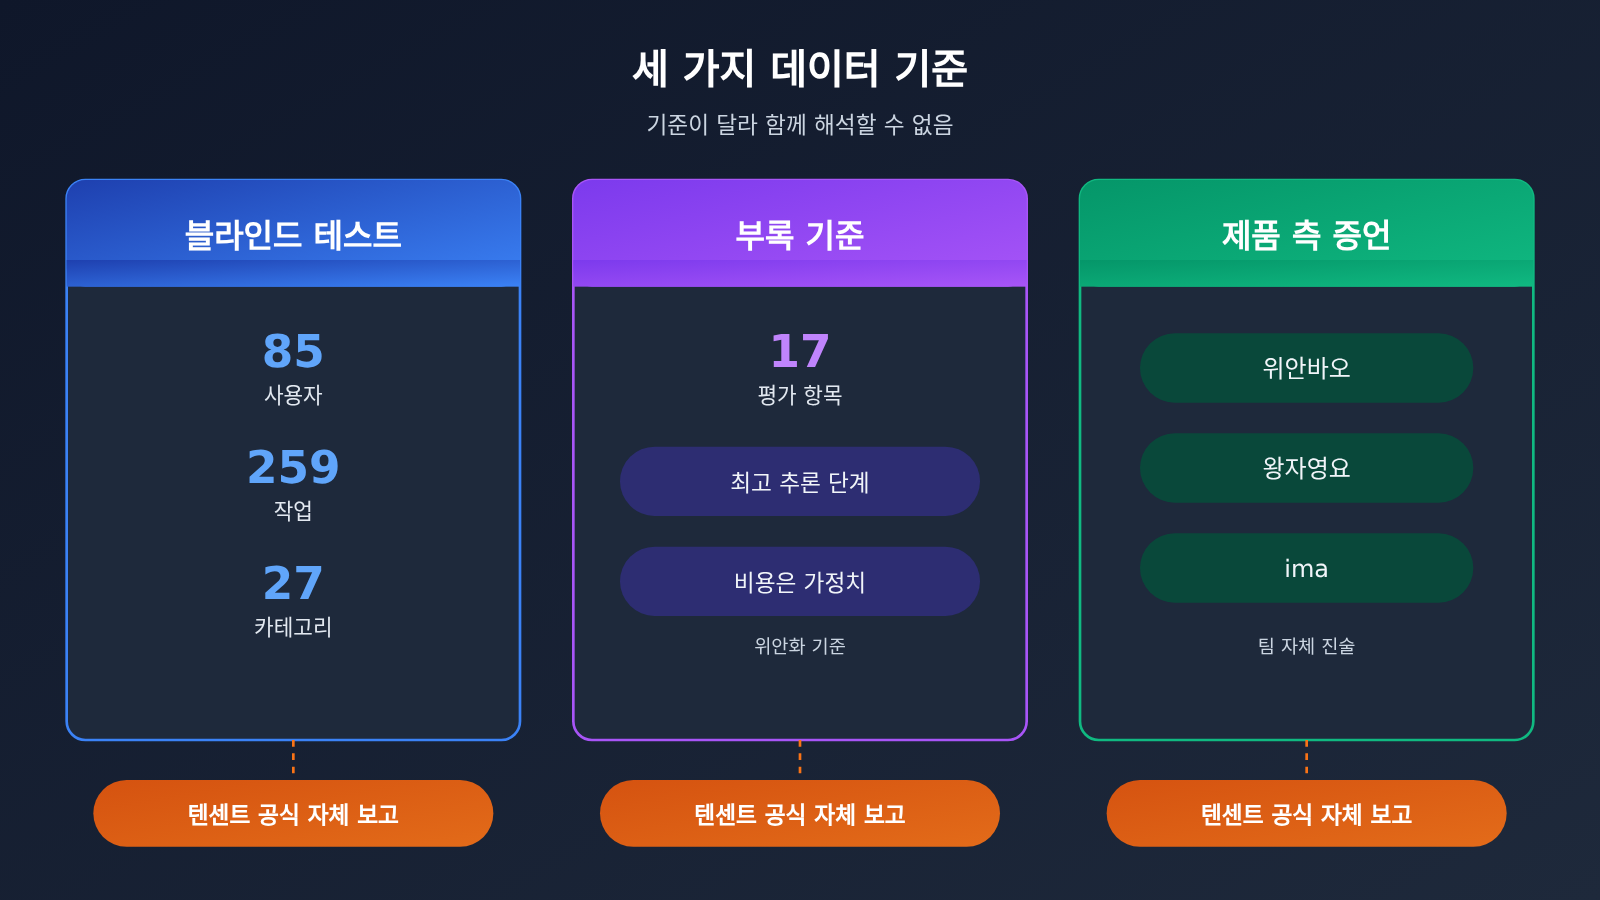
세 자료의 기준이 완전히 달라서, 섞어서 읽으면 쉽게 오판할 수 있어요:
- 블라인드 테스트: 내부 WorkBuddy 사용자 85명, 작업 259개, 카테고리 27개. 외부 모델(GLM 포함)은 high 티어를 사용했고, Hy4 flash 항목에는 티어가 표시되지 않았어요.
- 부록 표: 평가 항목 17개, 모든 모델은 각자 최고 추론 티어를 적용했어요. 각 칸에는 작업당 비용이 붙어 있고, 비용은 텐센트가 자체 정한 위안화 고정가로 계산했어요.
- 제품 측 증언: 위안바오, 왕자영요, ima 등 팀이 스스로 밝힌 수치로, 각자의 시나리오와 각자의 베이스라인을 사용해 가로로 나란히 붙여 비교할 수는 없어요.
Hy4 flash 대 GLM 5.3 Flash 블라인드 테스트 결과 비교
블라인드 테스트는 Hy4 flash에 가장 유리한 근거 중 하나예요. 연구 페이지의 전체 블라인드 테스트 표는 네 개의 행으로 이루어져 있으며, 원문 그대로 다음과 같습니다(텐센트 공식 자체 보고 기준).
| 모델 | 만족도(4점 척도) | 중위 엔드투엔드 시간 | 단일 작업 비용(위안) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017(high) | 3.09 | 10.3분 | 1.20위안 |
| Hy4 flash(등급 미표기) | 2.79 | 6.7분 | 0.26위안 |
| Claude-Haiku-5.5(high) | 2.81 | 6.8분 | 4.73위안 |
| GLM-5.3-Flash(high) | 2.53 | 7.6분 | 0.81위안 |
Hy4 flash와 GLM-5.3-Flash 두 행만 보면, Hy4 flash의 만족도가 0.26점 더 높고, 시간은 약 0.9분 더 짧으며, 단일 작업 비용은 GLM의 약 3분의 1 수준이에요. 이게 “일상 블라인드 테스트에서 더 저렴하다”는 주장을 뒷받침하는 직접적인 근거입니다.
세 가지는 정확히 짚고 넘어가야 해요. 첫째, 만족도가 가장 높은 건 DeepSeek의 3.09이지 Hy4 flash가 아니에요. 둘째, Hy4 flash는 Haiku보다 0.02점 낮으며, 연구 페이지에서 쓴 표현은 “초과”가 아니라 “근접”(close to)이에요. 셋째, 공식 게시물의 “18배 작업 비용 절감”은 4.73위안을 0.26위안으로 나눈 값으로, 비교 대상이 GLM이 아니라 Haiku입니다.
Hy4 flash와 GLM 5.3 Flash의 블라인드 테스트 비용은 어떻게 산출되나
블라인드 테스트 표의 위안 비용은 텐센트가 자사의 가격 산정 기준에 따라 계산한 것이에요. 이는 “같은 배치의 작업에서 누가 더 적게 지출했는가”를 반영할 뿐이며, 어느 플랫폼에서든 여러분이 실제로 청구되는 요금과는 같지 않아요. Hy4 flash의 비용이 낮은 이유는 일부는 낮은 표면 가격(권리 가격)에서 비롯되고, 일부는 연구 페이지에서 언급한 강화 학습이 엔드투엔드 평균 출력 토큰을 50% 줄인 데서 비롯됩니다.
연구 페이지에는 또 하나의 WorkIndex 결론이 있어요. 단일 작업 평균 비용이 Hy4 preview의 1/13, Hy4의 1/20이라는 내용입니다. 이 문장들은 WorkIndex에만 속하는 내용이니, 블라인드 테스트 표의 위안 숫자를 대체하는 데 사용해서는 안 되고, GLM과도 관련이 없습니다.
Hy4 flash 대 GLM 5.3 Flash 부록 벤치마크
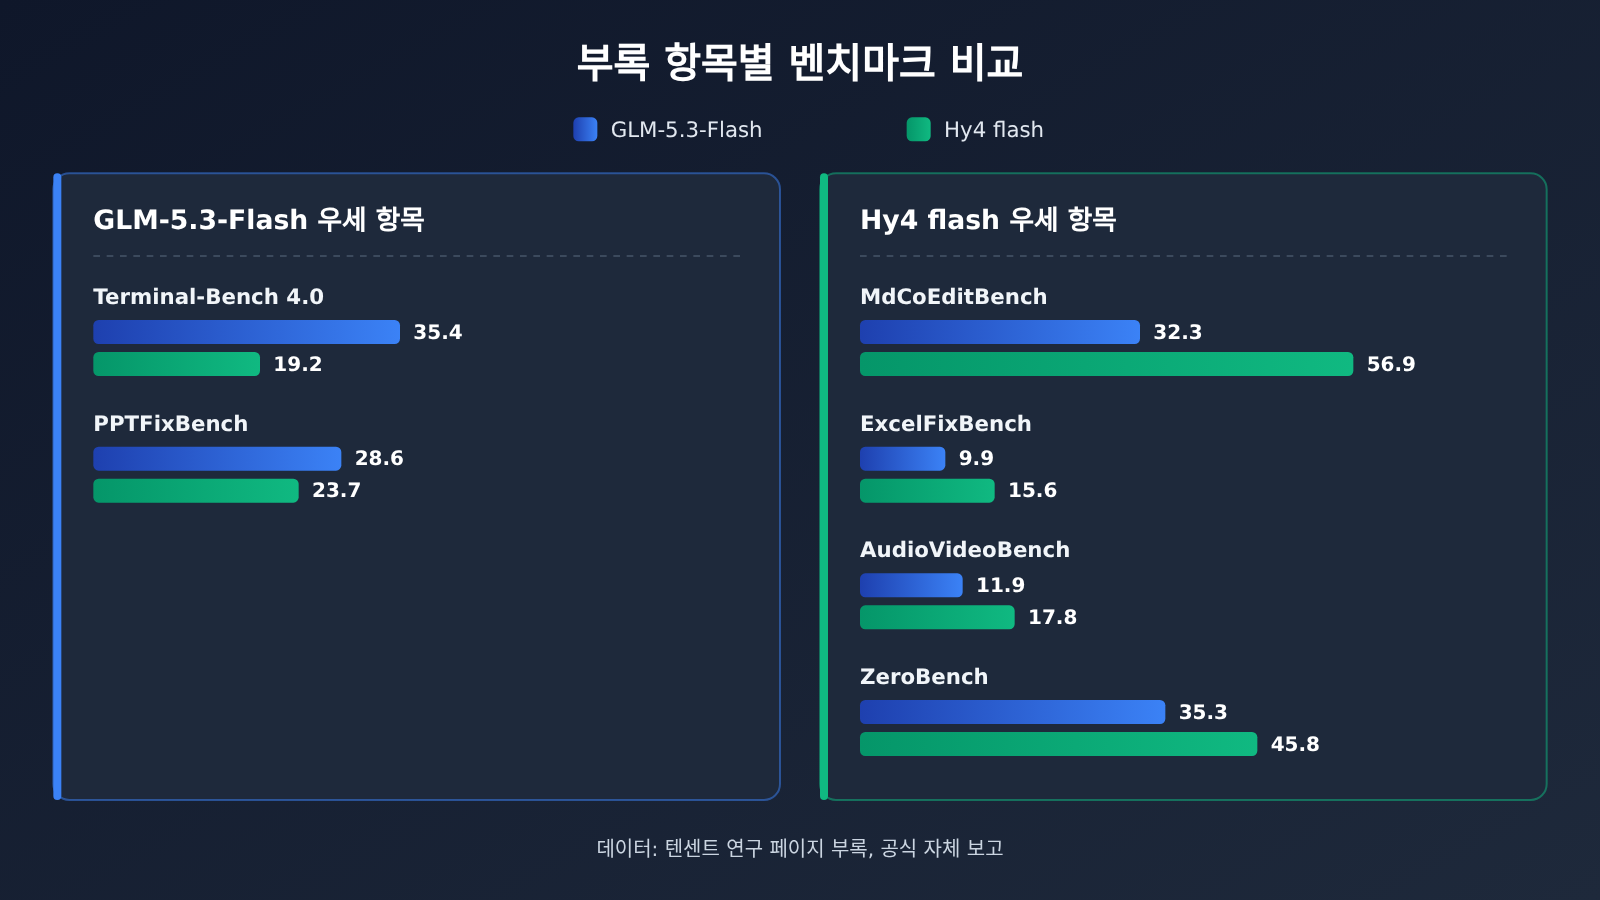
부록은 GLM-5.3-Flash가 판세를 뒤집은 부분이에요. 아래 표는 텐센트 연구 페이지의 Appendix 전체 이미지에서 그대로 옮겨 왔고, 두 열만 남겼어요. 형식은 “점수 / 단일 작업 비용(위안)”이에요:
| 평가 항목 | Hy4 flash | GLM-5.3-Flash | 점수가 더 높은 쪽 |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (도구 미사용) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (도구 사용) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (도구 사용) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
격차가 가장 큰 항목은 Terminal-Bench 4.0이에요. GLM은 35.4, Hy4 flash는 19.2로 거의 두 배 차이예요. 이 벤치마크는 Claude Code harness를 사용하고, 최대 500회, 단일 최장 13시간까지 진행하며, 장기 터미널 조작 능력을 평가해요. PPTFixBench에서도 GLM이 약 5점 앞서요. 또한 DeepSWE, WordEditBench, BuddyVQA, MMMU-Pro 등에서도 GLM이 소폭 앞서요.
반대로 Hy4 flash가 격차를 벌린 항목은 Markdown 공동 작성(56.9 대 32.3), 표 수정, 오디오·비디오 처리, ZeroBench예요. 이런 항목들은 “문서 작성, 표 수정, 소재 처리”라는 일상 업무에 더 가까워요. 이는 연구 페이지의 권장 사항과도 일치해요. 장기 소프트웨어 엔지니어링에는 Hy4를 계속 쓰고, Hy4 flash는 쓰지 않는 거예요.
부록의 비용 열은 텐센트의 가정일 뿐, 플랫폼 청구서가 아니에요
부록 원문에는 이렇게 설명되어 있어요: 비용은 각 모델의 공식 API 가격을 기준으로 했고, 1달러는 7.2위안으로 환산했어요. GLM-5.3-Flash에 적용된 고정 가격은 100만 토큰당 입력 0.8위안, 캐시 적중 0.23위안, 출력 2.8위안이며 “표준 API 가격”이라고 명시되어 있어요. 이것은 텐센트가 표를 작성할 때 사용한 부록 가정일 뿐, APIYI의 정가가 아니에요. 이 수치를 근거로 여러분의 APIYI 청구서를 환산해서도 안 돼요.
Hy4 flash와 GLM 5.3 Flash 비교: 제품팀 증언
연구 페이지에는 텐센트 각 제품팀의 증언도 덧붙어 있는데, 그중 세 가지는 GLM-5.3-Flash를 직접 언급했어요. 이들은 모두 제품팀의 자체 진술이며, 시나리오와 기준선은 각각 달라요:
- 위안바오(제품팀 자체 진술): 일반 대화에서 GLM-5.3-Flash보다 2.52% 높았고, 특히 멀티턴 대화에서 두드러졌어요. 이는 위안바오 팀의 내부 평가이지 공개 리더보드가 아니에요.
- 왕자영요(제품팀 자체 진술): DeepSeek-V4.1-Flash-1017과 GLM-5.3-Flash 대비 근본 원인 파악은 비슷했어요. 모델 요청 수는 22.0%에서 39.1% 적었고, 토큰 사용량은 40.5%에서 61.2% 적었으며, 도구 호출은 각각 51.2%, 7.7% 많았어요.
- ima(제품팀 자체 진술): 앞서 언급한 두 모델 대비 평균 대기 시간은 18%에서 35% 짧았고, 응답 점수는 1.8% 높았으며, 콘텐츠 품질은 8.1% 높았어요.
이 진술들의 공통점은 Hy4 flash가 “토큰을 덜 쓰고, 덜 기다리는” 부분에서 우위에 있고, 품질 측면에서는 비슷하거나 소폭 앞선다는 거예요. 이들은 블라인드 테스트의 결론을 뒷받침하지만, 부록에 나온 Terminal-Bench 격차를 반박하지는 못해요. 애초에 같은 종류의 작업이 아니기 때문이에요.
Hy4 flash와 GLM 5.3 Flash 가격 및 연동 비교
가격은 가장 실수하기 쉬운 부분이에요. 출처가 다른 숫자를 섞어 쓰면 안 되는데, 아래 표는 각 가격의 출처를 따로 적어 두었습니다(단위는 모두 100만 토큰당 미국 달러입니다):
| 모델 / 출처 | 입력 | 출력 | 캐시 읽기 | 비고 |
|---|---|---|---|---|
| Hy4 flash(텐센트 연구 페이지 정가) | 0.070 | 0.281 | 0.003 | APIYI 표가 아님, TokenHub 2026-11-30까지 50% 할인 |
glm-5.3-flash(APIYI apiyi.com 모델 페이지) |
0.15 | 0.50 | 0.03 | 이미 등록됨, 그룹 CodexResponses, Default, SVIP, 배율 1배 |
glm-5-3-flash-260828(APIYI 통합 표) |
0.15 | 0.499995 | 0.03 | 또 다른 채널이며 위 항목과 충돌하지 않음 |
hy4(APIYI 통합 표) |
0.85 | 2.55 | 0.045 | 이건 Hy4이고 Hy4 flash가 아님 |
| Hy4(텐센트 연구 페이지 정가) | 0.834 | 2.501 | 0.042 | 연구 페이지 정가이며, APIYI 가격과 별도로 봐야 함 |
Hy4 flash의 50% 할인은 TokenHub의 한시적 윈도우 가격이에요. 연구 페이지에는 할인 후 가격표가 따로 표기되어 있지 않으니, 임의로 2로 나누어 추산하더라도 11월 30일 이후에는 정가로 복귀된다는 점을 기억하세요.
Hy4 flash는 아직 등록되지 않았고, 최대한 빠르게 해당 모델을 등록하겠습니다. 모델명과 가격은 플랫폼 모델 목록을 기준으로 합니다. 현재 APIYI에는 hy4만 있고 flash 버전의 훈위안은 전혀 없습니다. 필요한 게 텐센트 훈위안의 상한이 높은 버전이라면 먼저 hy4를 쓸 수 있고, 정말로 원하는 게 Hy4 flash라면 현 단계에서는 텐센트 클라우드 TokenHub, WorkBuddy 등 공식 채널로만 접근할 수 있어요. 연구 페이지에도 API 모델 ID가 없으니, 호출 전에는 TokenHub 콘솔에 표시된 이름을 기준으로 하세요.
APIYI에서 GLM-5.3-Flash 호출하는 방법
glm-5.3-flash는 오늘 바로 호출할 수 있어요. APIYI에서 OpenAI Chat Completions만 지원하며, Anthropic Messages는 지원하지 않고, Responses도 지원하지 않습니다. 이 점이 이 모델을 특정 클라이언트에 직접 연결할 수 있는지를 결정해요:
- apiyi.com 콘솔에서 키를 생성합니다.
- 클라이언트의 base_url을
https://api.apiyi.com/v1로 설정하고, 요청 경로는/chat/completions입니다. - 요청 본문의
model에glm-5.3-flash를 넣고,messages는 OpenAI 형식으로 전달합니다. - 사고(thinking) 기능은 기본으로 켜져 있고, 입력은 텍스트, 이미지, 영상이 가능하며 출력은 텍스트입니다.
사용 중인 도구가 Anthropic Messages 형식 요청만 보낼 수 있다면 glm-5.3-flash를 직접 쓸 수 없어요. 이런 경우에는 Chat Completions를 지원하는 클라이언트로 바꾸거나, chat과 messages 엔드포인트를 모두 제공하는 모델로 바꿔야 합니다. 컨텍스트, 최대 출력, 엔드포인트 등 파라미터는 APIYI 모델 페이지를 기준으로 하세요.
🚀 연동 제안: 이미 APIYI에 등록된 모델은 apiyi.com의 키를 사용해
https://api.apiyi.com/v1로 요청을 보내면 됩니다. OpenAI 호환 클라이언트라면 설정 두 곳만 바꾸면 바로 동작해요. 신규 사용자에게는 무료 테스트 크레딧이 있으니, 자신의 일상 작업으로glm-5.3-flash를 먼저 시험해 보세요.
Hy4 flash vs GLM 5.3 Flash: 상황별 추천
Hy4 flash를 선택하면 좋은 경우
- 문서 및 Markdown 공동 작성: 부록 MdCoEditBench에서 56.9 대 32.3으로 격차가 뚜렷해요.
- 표 복구, 오디오·비디오 소재 처리: ExcelFixBench, AudioVideoBench 두 항목 모두 Hy4 flash가 앞서요.
- 비용에 민감한 고빈도 일상 작업: 블라인드 테스트 기준 단일 작업당 0.26위안 대 0.81위안(텐센트 공식 자체 보고).
- 멀티턴 대화형 제품: 위안바오(元宝) 제품 측 자체 설명에 따르면 일반 대화에서 2.52% 높고, 멀티턴에서 차이가 가장 뚜렷해요.
GLM-5.3-Flash를 선택하면 좋은 경우
- 터미널 조작 및 장기 실행 명령줄 작업: Terminal-Bench 4.0에서 35.4 대 19.2로, 격차가 가장 큰 항목이에요.
- 수정형 슬라이드 작업: PPTFixBench 28.6 대 23.7.
- 오늘 바로 출시해야 하는 경우:
glm-5.3-flash는 이미 APIYI에 출시되어 있지만 Hy4 flash는 아직이에요. - 툴체인이 Chat Completions 기반인 경우: OpenAI 포맷 클라이언트를 바로 연결할 수 있어요.
Hy4 flash vs GLM 5.3 Flash: 의사결정 가이드
| 상황 | 권장 사항 |
|---|---|
| 주로 글쓰기, 문서, 표, 소재 처리를 한다면 | Hy4 flash가 출시될 때까지 기다리거나, 먼저 텐센트 공식 채널로 시험해 보세요 |
| 주로 터미널 조작, 명령줄 Agent를 한다면 | GLM-5.3-Flash를 선택하세요 |
| 오늘 APIYI에 올려야 한다면 | glm-5.3-flash를 선택하고 Chat Completions를 사용하세요 |
| 클라이언트가 Anthropic Messages만 지원한다면 | glm-5.3-flash는 적용되지 않으니, messages를 지원하는 모델로 바꾸세요 |
| 장기 소프트웨어 엔지니어링 | 둘 다 최우선은 아니며, 연구 페이지에서는 Hy4 사용을 권장해요 |
💡 선택 가이드: 블라인드 테스트와 부록이 제시하는 방향이 서로 다르니, 가장 안전한 방법은 본인의 작업으로 각각 한 배치씩 돌려보는 거예요.
glm-5.3-flash는 지금 APIYI apiyi.com에서 바로 검증할 수 있고, Hy4 flash가 출시되면model파라미터만 바꾸면 같은 코드에서 비교할 수 있어요.
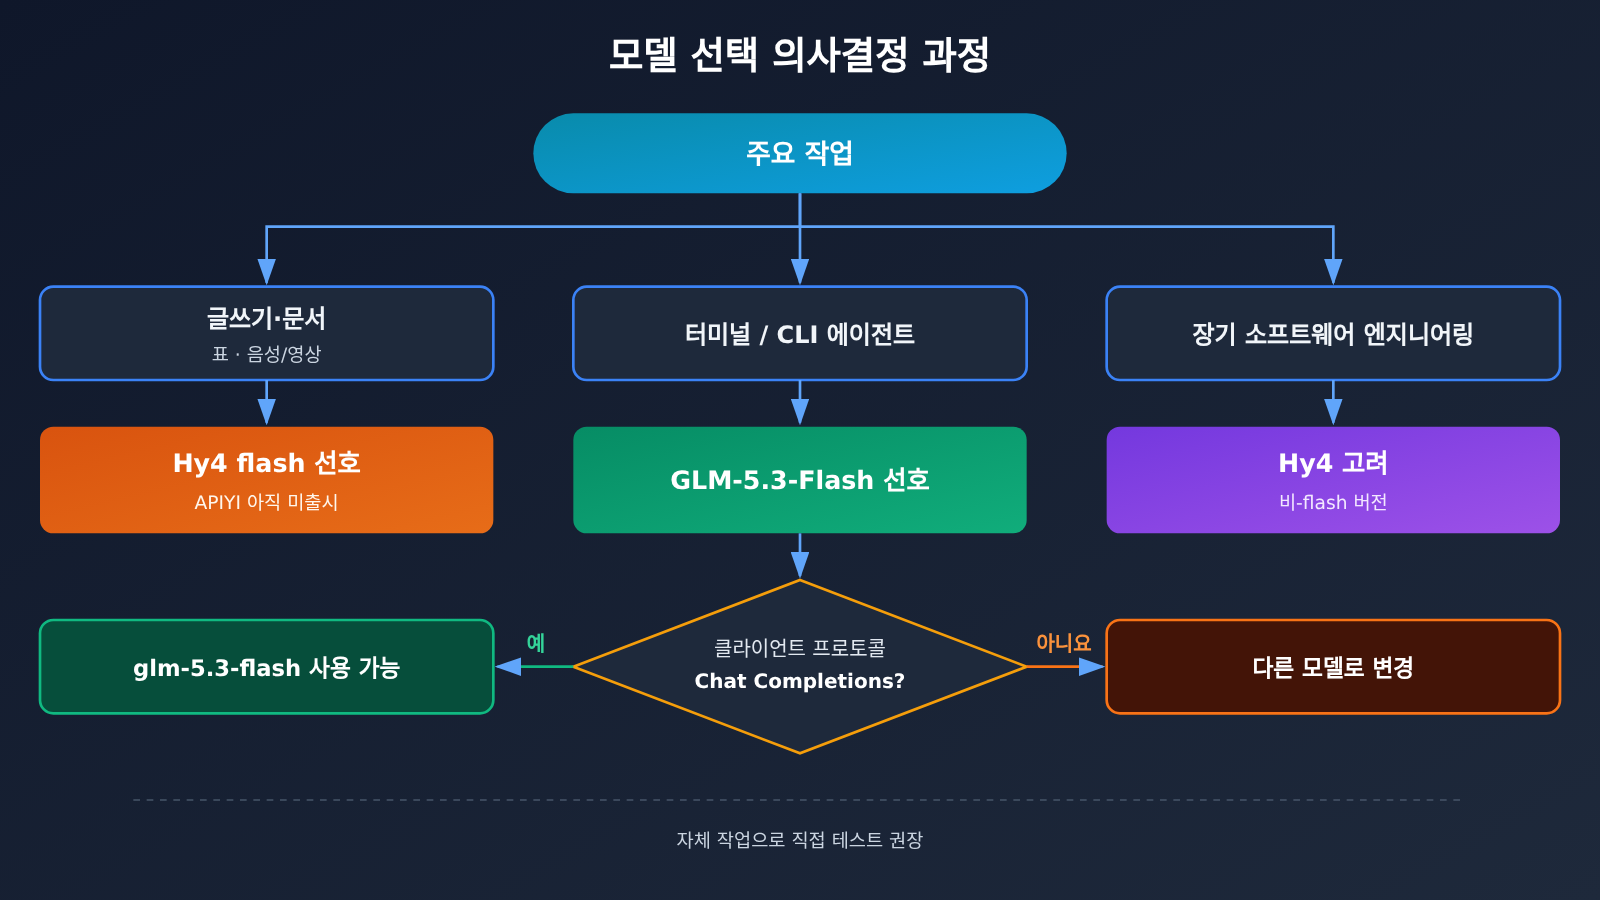
자주 묻는 질문 FAQ
Q1: Hy4 flash와 GLM-5.3-Flash는 각각 무엇인가요?
Hy4 flash는 텐센트 훈위안이 2026-11-16에 공개한 일상 작업용 모델이에요. 총 224B 파라미터, 활성 12B, 1M 컨텍스트 윈도우를 갖추고 있어요. GLM-5.3-Flash는 APIYI 모델 페이지 기준 총 320B 파라미터, 활성 18B, 1M 컨텍스트 윈도우이며, 공급사 공개일은 2026-08-26이에요.
Q2: Hy4 flash와 GLM 5.3 Flash, 과연 어느 쪽이 더 강할까요?
작업 유형에 따라 달라요. 텐센트 블라인드 테스트에서는 Hy4 flash 만족도가 2.79, GLM이 2.53이었어요. 부록에서는 Terminal-Bench 4.0과 PPTFixBench에서 GLM이 더 높았고, Markdown 공동 작성, 표, 오디오/비디오, ZeroBench에서는 Hy4 flash가 더 높았어요. 모든 데이터는 텐센트가 자체적으로 공개한 공식 수치예요.
Q3: 위안바오가 범용 대화에서 GLM-5.3-Flash보다 2.52% 높다고 하는데, 믿을 만한가요?
이건 위안바오 제품팀의 자체 평가라서 공개 리더보드도 아니고, 방법론 세부 정보도 공개되지 않았어요. “멀티턴 대화 영역에서는 Hy4 flash가 우세할 수 있다”는 단서로는 볼 수 있지만, 확정된 결론으로 받아들이기는 어려워요.
Q4: 부록에 나온 GLM의 0.8위안, 0.23위안, 2.8위안은 APIYI 가격인가요?
아니요. 이건 텐센트가 부록 표를 만들 때 적용한 위안화 고정 가격 가정이에요. `glm-5.3-flash`의 APIYI 모델 페이지 가격은 입력 0.15, 출력 0.50, 캐시 읽기 0.03 USD/100만 token이며, 플랫폼 모델 목록이 기준이에요.
Q5: 지금 APIYI에서 Hy4 flash를 호출할 수 있나요?
Hy4 flash는 아직 APIYI 모델 목록에 없고, 가능한 한 빠르게 이 모델을 추가할 예정이에요. 모델과 가격은 플랫폼 모델 목록이 기준이에요. 현재 APIYI에서 호출할 수 있는 모델은 `glm-5.3-flash`와 `hy4`이며, `hy4`는 flash 버전이 아니에요. 공개 소식은 apiyi.com의 모델 목록에서 확인할 수 있어요.
Q6: `glm-5.3-flash`를 Anthropic 형식만 지원하는 클라이언트에 연결할 수 있나요?
안 돼요. APIYI에서 `glm-5.3-flash`는 OpenAI Chat Completions 엔드포인트만 제공하고, Messages와 Responses는 지원하지 않아요. 클라이언트가 base_url을 `/v1`로 지정하고 Chat Completions 요청을 보낼 수 있어야 해요.
Q7: 두 모델의 알려진 약점은 무엇인가요?
Hy4 flash는 Terminal-Bench 4.0에서 19.2점에 불과하고, 연구 페이지에서도 장기 소프트웨어 엔지니어링 작업에서 Hy4보다 뒤진다고 인정했어요. 가중치는 아직 공개 계획만 있는 상태예요. GLM-5.3-Flash는 블라인드 테스트 만족도와 Markdown 공동 작성에서 뒤지고, Chat Completions만 지원해요. 두 모델의 비교 데이터는 모두 텐센트 쪽에서 나온 거예요.
Hy4 flash 대 GLM 5.3 Flash 핵심 요점 Key Takeaways
- 블라인드 테스트에서 Hy4 flash 우세: 만족도 2.79 대 2.53, 6.7분 대 7.6분, 0.26위안 대 0.81위안.
- 터미널 벤치마크에서는 GLM이 더 높음: Terminal-Bench 4.0은 35.4 대 19.2이고, PPTFixBench에서도 GLM이 앞서요.
- 일상 업무 항목은 Hy4 flash가 더 높음: Markdown 공동 작성, 표 수정, 오디오·비디오, ZeroBench 점수가 더 높아요.
- 증언은 자기 보고일 뿐: 텐센트 위안바오의 “2.52% 더 높음”은 제품 측 자체 설명이지 공개 리더보드가 아니에요.
- 가격은 출처를 구분해야 함: 부록의 위안화 가격은 텐센트의 가정치이고, 연구 페이지의 달러는 리스트 가격(정가)이며, 모두 APIYI 표시 가격이 아니에요.
- 오늘 호출할 수 있는 건 GLM:
glm-5.3-flash는 이미 APIYI apiyi.com에 올라와 있고, Chat Completions만 지원해요.
요약
Hy4 flash 대 GLM 5.3 Flash 비교의 핵심 결론:
- 일상 작업엔 Hy4 flash: 텐센트 블라인드 테스트에서 만족도가 더 높고, 더 빠르고, 더 저렴했으며, 문서와 표 관련 벤치마크도 더 높았어요.
- 터미널 작업엔 GLM-5.3-Flash: Terminal-Bench 4.0 격차가 거의 두 배에 달하니, 장시간 명령줄 작업에는 Hy4 flash를 선택하면 안 돼요.
- 실제 도입은 가용성과 프로토콜을 봐야 해요: 오늘 APIYI에서 호출할 수 있는 건
glm-5.3-flash이고, Chat Completions만 사용해요. Hy4 flash는 아직 올라오지 않았어요.
작업이 주로 글쓰기와 문서라면 Hy4 flash의 출시 진행 상황을 지켜보세요. 터미널 작업 위주이거나 바로 서비스에 올려야 한다면 glm-5.3-flash가 더 직접적인 선택이에요. apiyi.com의 무료 테스트 크레딧으로 자신의 실제 작업을 한 차례 돌려본 뒤 결정하는 걸 권장해요.
📚 참고 자료
-
Tencent Hunyuan Hy4 flash 연구 페이지: 블라인드 테스트 표, 부록 벤치마크, 제품 측 증언, 공시 가격
- 링크:
hy.tencent.ai/research/hy4-flash - 설명: 이 글의 모든 블라인드 테스트, 부록 점수, 증언은 이 페이지에서 가져온 것으로, Tencent의 공식 자체 보고예요
- 링크:
-
Tencent Hunyuan 공식 발표 게시물: Hy4 flash 출시 및 API 공시 가격
- 링크:
x.com/TencentHunyuan/status/2122217770314301469 - 설명: “18배 작업 비용 절감”의 출처이며, 비교 대상은 Claude Haiku 5.5예요
- 링크:
-
APIYI GLM-5.3-Flash 모델 페이지: 파라미터, 컨텍스트, 엔드포인트, 가격
- 링크:
docs.apiyi.com/models/glm-5-3-flash - 설명:
glm-5.3-flash의 사양과 프로토콜은 이 페이지를 기준으로 해요
- 링크:
작성자: APIYI 기술 팀
기술 교류: APIYI 웹사이트 첫 페이지에서 저희에게 연락해 주시면 좋고, 더 많은 모델과 연동 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있어요


