
작성자 노트: 멀티 프로젝트 Agent에는 독립 컨텍스트, 영속 상태, 작업 스케줄링, 복구 메커니즘이 필요해요. 그래야 병렬 작업을 추적 가능하게 하고 서로 간섭하지 않도록 할 수 있죠.
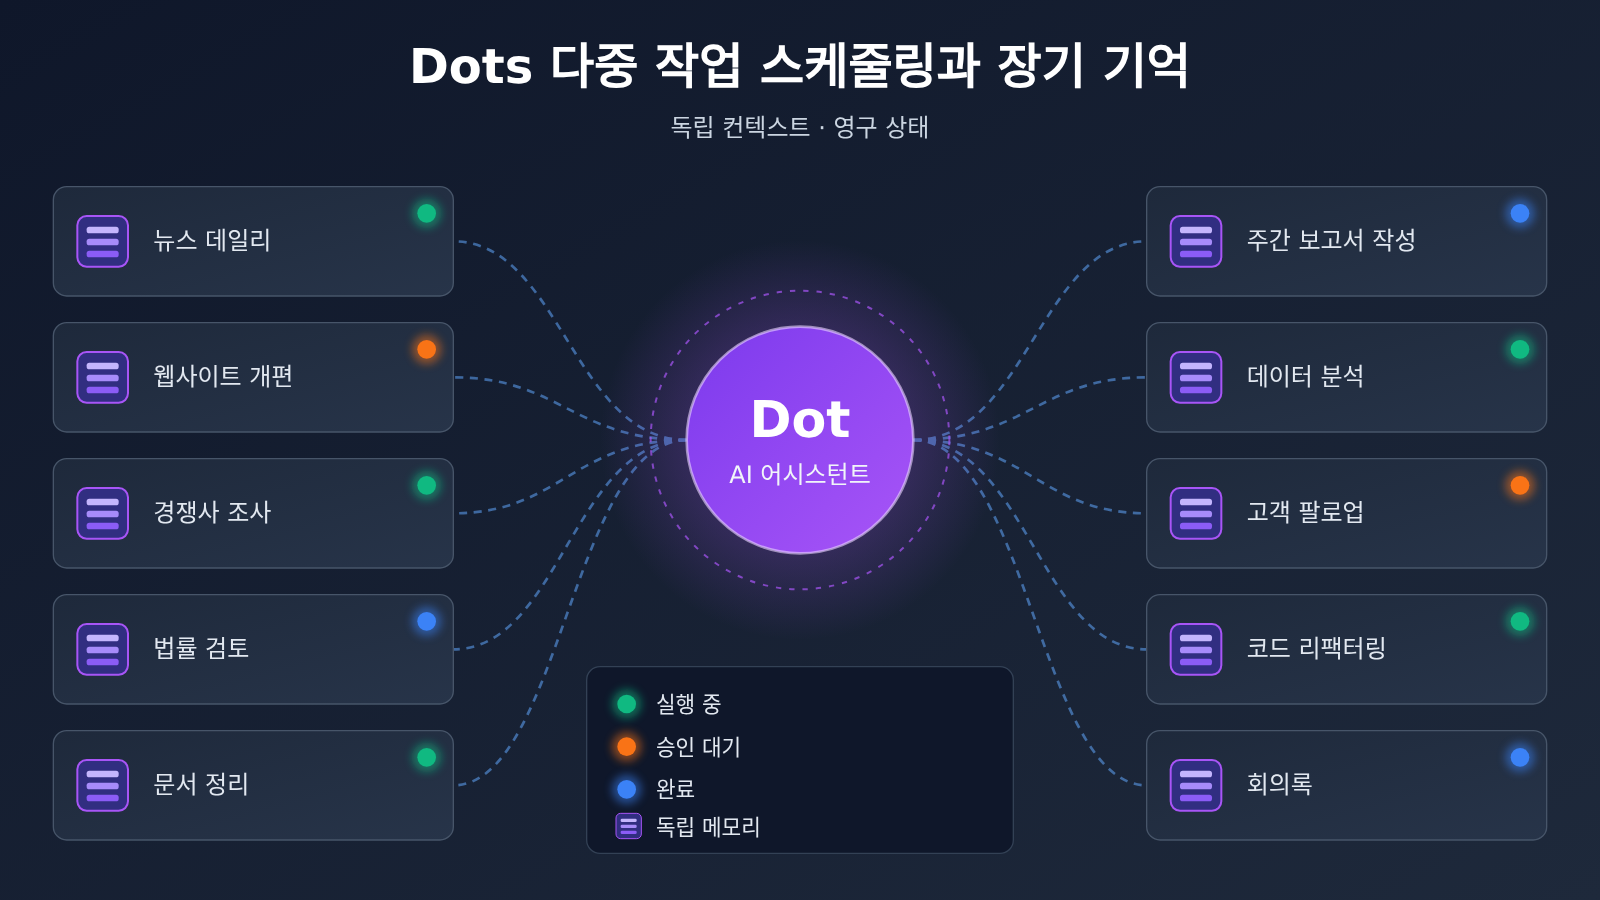
AI 어시스턴트가 여러 프로젝트를 동시에 진행할 수 있는지는 네 가지에 달려 있어요. 각 작업이 독립 컨텍스트를 갖는 것, 실행 상태가 영속적으로 저장되는 것, 스케줄러가 우선순위와 동시성을 일괄 관리하는 것, 중단 후 체크포인트에서 복구할 수 있는 것이죠. 여러 모델을 동시에 호출하는 건 어렵지 않아요. 어려운 건 그 호출들이 각자 무엇을 하고 있는지 기억하게 만드는 일이에요. OpenAI가 2026년 9월 29일에 공개한 Dots는 이 패턴을 채택했어요. 공식 문서에 따르면 하나의 Dot은 여러 담당 항목을 유지할 수 있고, 작업을 백그라운드 Agent에 나눠 병렬로 처리할 수 있어요. 새로운 작업은 각자 자신의 대화 컨텍스트를 가지며, 사용자와 Dot의 전체 대화 기록을 자동으로 물려받지 않아요. 개발자는 Checkpointer, Store, 작업 큐, 상태 머신을 이용해 비슷한 멀티 프로젝트 관리 시스템을 만들 수 있어요.
아래에서는 먼저 공식 자료를 바탕으로 Dots의 다중 작업과 메모리 메커니즘을 분석한 뒤, 글 전체에 걸쳐 사용할 프로젝트 관리 예시로 네 계층의 작업 구조, 병렬 스케줄링, 중단 복구, 실행 추적, 비용 경계를 차례로 설계해 볼게요. 제목에 나오는 ‘열 개의 프로젝트’는 작업 방식을 보여 주기 위한 예시일 뿐이에요. Dots와 자체 구축 시스템 모두 고정된 10개 병렬 처리 경로를 제공하지 않으며, 무한 병렬도 불가능해요. 본문의 자체 구축 Agent 코드는 설계안에 속하며, 가상의 실행 결과를 덧붙이지 않았어요.
To Know: Dots 멀티태스크 스케줄링 관련 용어
| 용어 | 설명 |
|---|---|
| Workspace | 프로젝트와 권한을 정리하는 워크스페이스로, 보통 사용자 한 명이나 팀 하나에 대응해요. |
| Project | 목표, 자료, 관련 작업을 담는 프로젝트 단위예요. |
| Task | 명확한 목표가 있는 작업이에요. 예를 들면 “오늘 OpenAI 뉴스 검색” 같은 것이요. |
| Run | 작업을 실제로 한 번 실행한 기록이에요. 같은 Task는 여러 번 실행할 수 있어요. |
| 백그라운드 Agent | Dot이 내보내서 하위 작업을 병렬로 처리하는 실행 주체로, 작업을 마치면 Dot에 보고해요. |
| Checkpointer | 작업 실행 체크포인트를 저장하는 컴포넌트로, 중단 후 복구를 담당해요. |
| Store | 작업 간에 장기 정보를 저장하는 컴포넌트로, 프로젝트 맥락을 이어가는 역할을 해요. |
| 상태 머신 | 규칙에 따라 작업의 각 단계 전환을 관리하는 메커니즘이에요. 예: 대기 중, 실행 중, 승인 대기. |
| 동시성 제한 | 동시에 실행할 수 있는 작업 수의 상한으로, API 할당량, 서버 자원, 비용 제약을 받아요. |
| Tracing | 모델 호출, 도구 호출, 핸드오프 과정을 기록하는 추적 기능이에요. |
| Proactive Research | Dots가 새 메시지가 없을 때 승인된 자료 소스에 대해 수행하는 읽기 전용 백그라운드 리서치예요. |
1 Dots 멀티태스크 스케줄링: 하나의 Dot이 여러 책임을 동시에 맡을 수 있는 이유
1.1 Dots가 공식적으로 공개한 다중 프로젝트 역량
공식 포지셔닝에 따르면 Dots는 상주형 개인 에이전트예요. 자체 클라우드 컴퓨터와 브라우저를 갖고 있어서, 사용자가 자리를 비운 후에도 위임된 작업을 계속 진행할 수 있어요. 멀티태스크와 관련해 Tasks and memory 문서에는 다음 능력이 정리되어 있어요.
- 여러 작업 항목의 상태를 동시에 유지하고, 같은 대화 안에서 작업을 전환할 수 있어요.
- 사용자는 언제든 정보를 보충하고 우선순위를 조정할 수 있어요.
- 복잡한 작업을 여러 부분으로 나눠 백그라운드 에이전트에 병렬 처리를 맡길 수 있어요.
- 독립적으로 확인할 수 있는 작업 스레드를 만들고, 각 작업 결과를 모아 요약할 수 있어요.
- 작업이 막히면 사용자 개입을 요청하고, 백그라운드 작업이 실행되는 동안에도 사용자는 계속 메시지를 보낼 수 있어요.
이런 능력을 종합하면 Dot이 맡는 역할은 프로젝트 코디네이터에 가까워요. 무엇을 먼저 할지, 무엇을 떼어낼지, 무엇을 사용자에게 되돌릴지 결정하고, 개별 작업의 실제 실행은 백그라운드 에이전트나 ChatGPT Work 작업, Codex 작업이 처리할 수 있어요.
1.2 멀티 대화, 멀티태스크, 멀티 에이전트의 차이
이 세 개념은 자주 혼용되지만 해결하는 문제가 각기 달라요. 통일된 예시로 살펴볼게요. 사용자 워크스페이스에 AI Radar(AI 뉴스 데일리), Website(웹사이트 개편), Research(경쟁사 리서치) 세 프로젝트가 있다고 가정해 볼게요.
| 모드 | 작동 방식 | 예시에서의 모습 | 해결하는 문제 |
|---|---|---|---|
| 멀티 대화 | 사용자가 프로젝트마다 채팅 창을 하나씩 열어요 | Research가 어디까지 진행됐는지 사용자가 직접 기억해야 해요 | 채팅 내용은 분리되지만, 진행 상황은 여전히 사람이 관리해요 |
| 멀티태스크 | 하나의 코디네이터가 여러 작업의 상태를 유지해요 | Dot이 세 프로젝트의 진행 상황과 우선순위를 각각 기록해요 | 통합 스케줄링과 상태 추적을 해결해요 |
| 멀티 에이전트 | 코디네이터가 하위 작업을 여러 실행자에게 배정해요 | 백그라운드 에이전트가 자료를 모으고, 다른 실행자가 보고서를 작성해요 | 병렬 실행과 전문 분업을 해결해요 |
Dots는 이 세 가지를 겹쳐 놓았어요. 사용자는 하나의 진입점에서 Dot과 대화하고, Dot은 여러 작업을 유지하며 필요할 때 백그라운드 에이전트를 내보내요. 직접 시스템을 만들어 이 효과를 재현하려면 세 계층의 능력을 모두 구현해야 하고, 채팅 창만 여러 개 여는 것으로는 턱없이 부족해요.
1.3 한 사용자가 직접 밝힌 병렬 실행 관찰
Reddit에서 한 사용자가 하루 동안의 테스트를 공유했어요. 그는 수백 개의 PDF와 수천 페이지 분량의 문서를 Dot에 넘겨 검토하게 하면서, 동시에 법률 리서치 작업을 돌렸어요. 그리고 세 실행 과정이 동시에 존재하는 것을 관찰했어요. Dot 자체의 클라우드 컴퓨터가 작업 A를 처리하고, 그가 연결한 Linux 컴퓨터가 작업 B를 처리하며, 또 다른 백그라운드 리서치 에이전트가 작업 C를 처리하는 모습이었어요. 그는 독립적인 법률 리서치 작업을 시작할 때 실행 환경을 사용할 수 없었던 상황을 겪었고, 로컬 컴퓨터를 연결한 뒤에야 작업을 성공적으로 배포했다고도 언급했어요.
이 개인적인 관찰은 Dot의 클라우드 컴퓨터, 로컬 컴퓨터, Work/Codex 환경이 서로 다른 실행 리소스임을 보여줘요. 작성자 본인도 이 경로들이 각각 독립적이고 무제한인 할당량을 갖는지는 검증하지 못했다고 밝혔어요. 따라서 이번 테스트는 Dots가 작업을 서로 다른 환경에 분배할 수 있다는 것만 보여줄 뿐, 모든 Pro 사용자가 같은 병렬 실행 규모를 누릴 수 있다고 단정할 수는 없어요.
2 Dots의 장기 기억: 하나의 작업에 왜 독립적인 기억이 필요할까요
2.1 새 작업의 컨텍스트 경계
공식 문서에는 이렇게 나와 있어요. 새 작업마다 자체 대화 컨텍스트를 가지며, Dot과 사용자 사이의 전체 대화 이력을 자동으로 넘겨받지는 않아요. Dot은 과거 ChatGPT 대화를 검색해 배경을 찾을 수 있는데, 이렇게 검색된 내용은 현재 작업의 컨텍스트로만 사용돼요.
이 설계는 꽤 실용적이에요. 모든 작업에 전체 이력을 불러온다면 Research 프로젝트의 경쟁사 보고서에 Website 프로젝트의 리뉴얼 논의가 섞여 들어갈 수 있고, 컨텍스트도 점점 길어지고 비용도 커지겠죠. 장기 프로젝트에서는 “이 작업이 무엇을 알아야 하는가”를 명시적으로 관리해야 하는데, 점점 길어지기만 하는 채팅 기록 하나로는 이걸 해내기 어려워요.
2.2 Dots 기억의 네 가지 데이터 계층
공식 자료에 따르면 Dot의 컨텍스트는 서로 다른 네 가지 출처에서 와요.
- ChatGPT Memory: Dot은 ChatGPT의 관련 기억과 최근 대화를 읽을 수 있어요.
- Dot 자체 노트: 사용자 선호, 업무 습관, 프로젝트 결정, 장기적으로 책임질 일을 축적해요.
- 현재 작업 컨텍스트: 이번 대화의 지시, 파일, 검색 결과, 도구 실행 결과예요.
- 연결된 앱 데이터: Dot은 권한이 부여된 앱의 데이터를 읽고, 능동적인 리서치를 통해 기억을 형성할 수 있어요.
이 계층들은 각기 수명 주기가 달라요. ChatGPT Memory와 Dot 노트는 서로 다른 데이터 계층에 속하며, ChatGPT Memory 공유를 끈다고 해서 Dot이 이미 가져온 정보가 자동으로 삭제되지는 않아요. 플러그인 연결을 끊어도 새로운 접근만 중단될 뿐이에요. 2026년 11월 16일 기준으로 사용자는 아직 Dot의 독립적인 기억을 하나하나 확인하거나 수정, 삭제할 수 없으며, Dot을 삭제하면 Dot 자체 컨텍스트의 삭제가 시작돼요. 자체 시스템에서 기억 계층을 설계할 때는 이 계층화 접근을 참고하되, 확인과 삭제가 가능한 관리 인터페이스를 함께 갖추면 좋아요.
3 Checkpointer와 Store: 멀티태스크 Agent의 두 가지 기억
LangGraph의 영속성 문서에서는 Agent의 기억을 두 가지로 나눕니다. 이 구분은 Dots의 “작업 컨텍스트”와 “장기 노트”에 정확히 대응해요. 아래에서도 Research 프로젝트의 월간 경쟁사 보고서를 예로 들어 설명할게요.
3.1 Checkpointer: 작업이 어디까지 진행됐는지 기억하기
체크포인터는 단일 작업 스레드의 실행 스냅샷을 저장합니다. 현재 단계, 이미 호출한 도구, 도구가 반환한 결과, 그리고 어느 단계가 사람의 승인을 기다리고 있는지가 포함되죠. 예시에서 월간 보고서 작업은 경쟁사 6곳의 가격 페이지 수집을 마치고 이제 분석에 들어가려는 참에 서비스가 재시작됐어요. 체크포인트가 있으면 작업은 “분석” 단계부터 이어서 진행할 수 있고, 이미 수집한 자료를 다시 받을 필요가 없습니다.
저장 매체가 체크포인트의 재시작 생존 여부를 결정해요. 인메모리 구현은 개발·테스트에 적합하지만 프로세스가 재시작되면 상태가 사라집니다. 로컬 영속화에는 SQLite를 쓸 수 있고, 장기간 운영되는 서비스에는 PostgreSQL이 더 적합하죠. 체크포인트는 계속 늘어나기 때문에 프로덕션 시스템에서는 오래된 상태를 정리하는 정책도 마련해야 해요.
3.2 Store: 프로젝트 배경 기억하기
스토어는 작업과 세션을 넘나드는 장기 자료를 저장합니다. 사용자 선호, 프로젝트 배경, 과거 의사결정, 여러 작업이 공유하는 지식 같은 것들이죠. 예시에서 “보고서 독자는 제품 팀”, “API 가격과 기능 업데이트만 추적”, “지난달에 이미 업데이트가 멈춘 특정 경쟁사는 더 이상 추적하지 않기로 결정”은 모두 스토어에 담기는 내용에 해당합니다. 다음 달에 새 보고서 작업을 만들면 이 작업은 이런 결정들을 읽어 들이므로, 사용자가 다시 설명할 필요가 없어요.
3.3 Checkpointer와 Store의 역할 비교
| 구분 | Checkpointer | Store |
|---|---|---|
| 적용 범위 | 단일 작업 스레드 | 다중 작업, 스레드 간 |
| 저장 내용 | 실행 상태 스냅샷 | 장기 자료와 사실 |
| 핵심 가치 | 중단 후 작업 복구 | 새 작업이 프로젝트 배경을 이어받음 |
| 예시 내용 | “가격 페이지 6곳 수집 완료, 다음은 분석” | “보고서 독자는 제품 팀” |
| 수명 주기 | 작업 상태를 따라가며, 완료 후 정리 가능 | 장기 기억 전략에 따라 보존·갱신 |
두 역할은 분명히 나뉘고 하나도 빠질 수 없어요. 체크포인터만 있으면 새 작업마다 신입 사원이 입사하는 것 같고, 스토어만 있으면 작업이 중단될 때마다 처음부터 다시 해야 하죠.
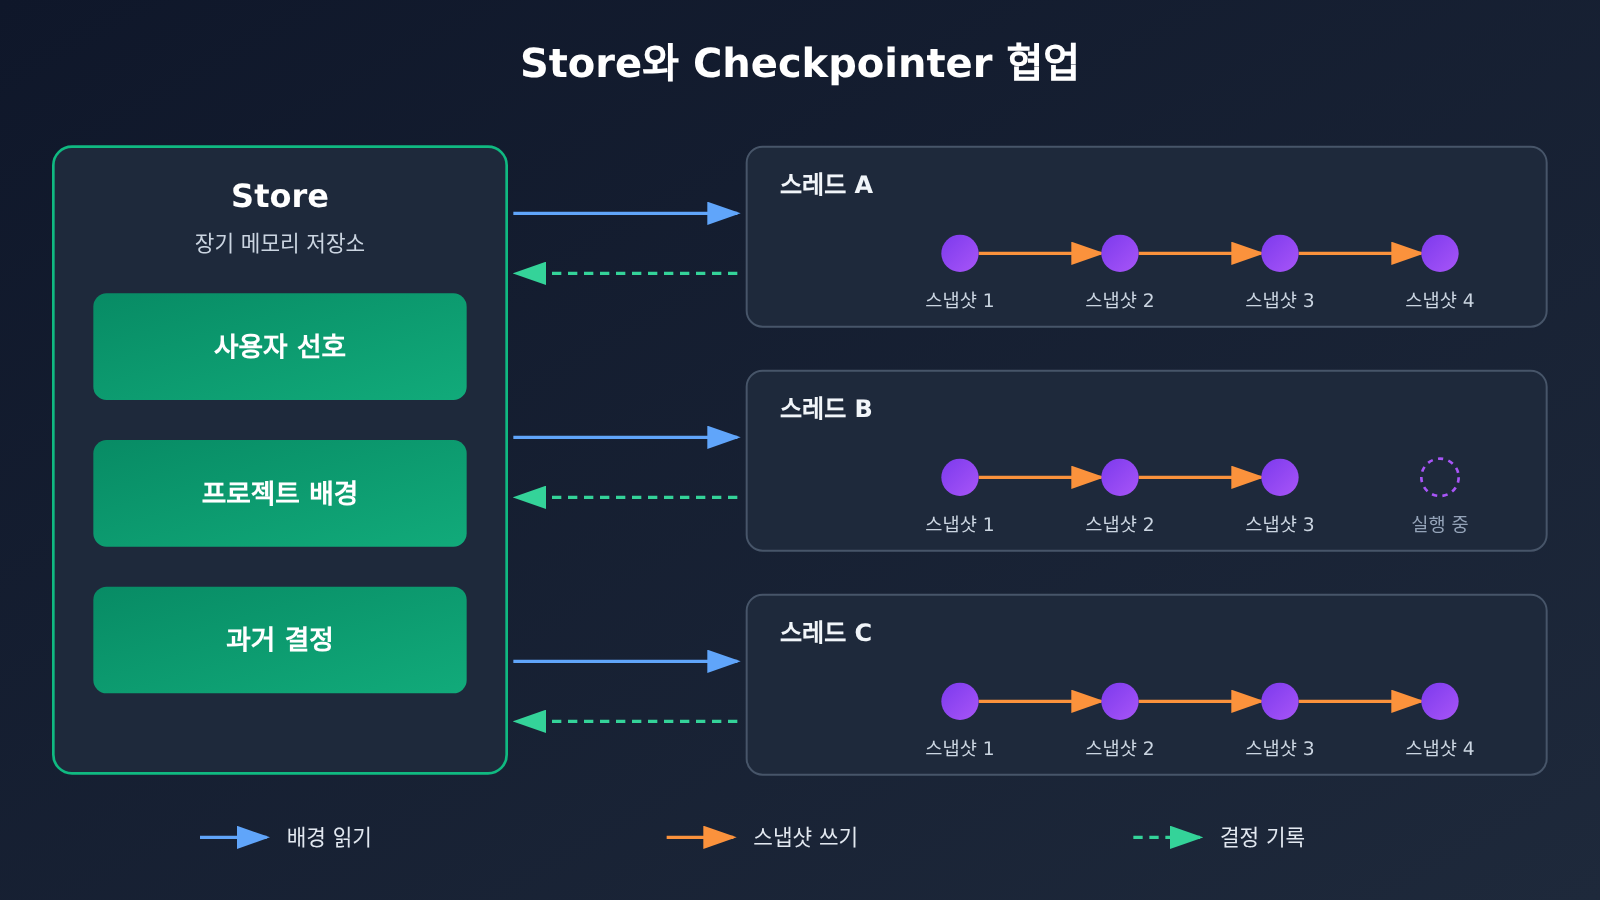
위 그림의 “배경 읽기—스냅샷 쓰기—의사결정 되쓰기” 순환은 6절 코드에 그대로 대응시킬 수 있습니다. 예제 코드는 APIYI apiyi.com의 OpenAI 호환 인터페이스로 모델을 호출하며, 모델을 바꿀 때는 모델 이름만 수정하면 돼요.
4 멀티 프로젝트 작업 관리 시스템 설계: Workspace, Project, Task, Run
4.1 4계층 구조와 독립 ID
자체 구축 멀티 프로젝트 Agent는 4계층 구조를 채택하는 것이 좋으며, 각 계층마다 독립적인 ID를 가집니다:
| 계층 | 역할 | 예시 |
|---|---|---|
| Workspace | 한 사용자의 워크스페이스와 권한 관리 | regulus |
| Project | 독립 프로젝트의 목표와 자료 관리 | AI Radar, Website, Research |
| Task | 구체적인 작업 관리 | Daily News, Monthly Report |
| Run | 특정 실행 기록 | Daily News의 2026-11-16 09:00 실행 |
대응되는 트리 구조는 다음과 같습니다:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Task와 Run을 분리해서 기록하는 것이 핵심입니다. Daily News는 매일 한 번 실행되고, 각 Run은 자신만의 입력, 출력, 소요 시간, 상태를 가지므로 문제가 생기면 특정 날짜의 특정 실행까지 정확히 짚어낼 수 있습니다.
4.2 메모리 접근 범위와 프로젝트 격리
하나의 Agent가 여러 프로젝트를 관리할 때, 각 프로젝트의 파일은 기본적으로 서로 읽을 수 없습니다. 계층별로 메모리 접근 범위를 나누는 것을 권장합니다:
- 사용자 공통 선호 (예: 보고서는 중국어로, 결론 먼저): 모든 권한이 부여된 프로젝트에서 읽을 수 있음;
- 프로젝트 배경 (예: Research의 독자와 추적 범위): 해당 프로젝트의 작업만 읽을 수 있음;
- 단일 작업 기록: 현재 작업과 명시적으로 권한이 부여된 연관 작업만 읽을 수 있음;
- 기업 고객 자료: 지정된 고객 프로젝트만 읽을 수 있음;
- 민감한 자격 증명: 독립된 보안 저장소에 보관하며, 절대 모델 컨텍스트에 들어가지 않음.
프로젝트 간에 자료를 공유할 때는 출처와 권한 범위를 기록해야 합니다. 이는 Dots의 방식과 일치합니다: 공식 문서에 따르면 Dot의 컨텍스트는 자격 증명, 이미지, 스크린샷을 보관하지 않으며, 권한 경계는 플러그인 권한 부여와 Custom Rules가 함께 제어합니다.
5 다중 작업 스케줄링: 작업을 병렬로 돌리면서 서로 간섭하지 않게 하려면
5.1 스케줄러와 Agent 추론의 분리
“언제 할지”와 “어떻게 할지”는 두 컴포넌트에 나눠 맡기는 걸 권장해요. 스케줄러는 시작 시점, 프로젝트 선택, 현재 실행 수, 우선순위, 타임아웃, 재시도를 담당하고, Agent는 작업을 이해하고 단계를 세우고 도구를 고르고 결과를 분석해 성과를 제출하는 일을 맡아요. 이렇게 하면 스케줄링 규칙은 결정적으로 실행되고, 모델은 추론이 필요한 부분만 처리하면 돼요.
기술 스택은 이런 조합을 참고할 수 있어요. APScheduler로 주기적 작업을 관리하고, Celery로 백그라운드 작업 큐를 만들고, Redis로 메시지와 단기 조정을 처리하고, PostgreSQL에 프로젝트와 실행 상태를 저장하고, LangGraph 같은 프레임워크로 Agent 흐름과 상태 영속화를 관리하는 식이에요. 소규모 프로토타입이라면 Python의 asyncio에 SQLite만 붙여도 돌아가요. 6절의 코드도 그렇게 설계했어요.
5.2 세 가지 병렬 방식
다중 작업 Agent에는 최소한 세 가지 병렬 방식이 있어요.
- 독립 작업 병렬: AI Radar의 일일 뉴스와 Research의 월간 보고서는 서로 의존하지 않으니 동시에 실행할 수 있어요.
- 하위 작업 병렬: 하나의 프로젝트를 자료 수집, 사실 검증 같은 하위 작업으로 쪼개 병행하는 방식이에요.
- 모델 역할 병렬: 서로 다른 모델이 각기 다른 전문 작업을 맡고 마지막에 결과를 모아요.
병렬로 돌릴 수 있는지는 API 동시 호출 한도, 서버 자원, 작업 의존성, 데이터베이스 쓰기 경합, 모델 비용, 결과 충돌, 중복 실행 같은 제약으로 결정돼요.
5.3 예시: 자료 수집, 데이터 분석, 보고서 생성
Research 프로젝트의 월간 보고서를 세 개의 하위 작업으로 나눠 볼게요. 자료 수집은 AI Radar의 일일 뉴스와 병렬로 돌릴 수 있어요. 데이터 분석은 자료 수집 결과에 의존하니 그것이 끝날 때까지 기다려야 하고, 보고서 생성은 분석 결론에 의존해요. 보고서 생성이 끝나면 승인 대기 상태로 넘어가고, 사용자가 확인해야 비로소 전달된 것으로 봐요.
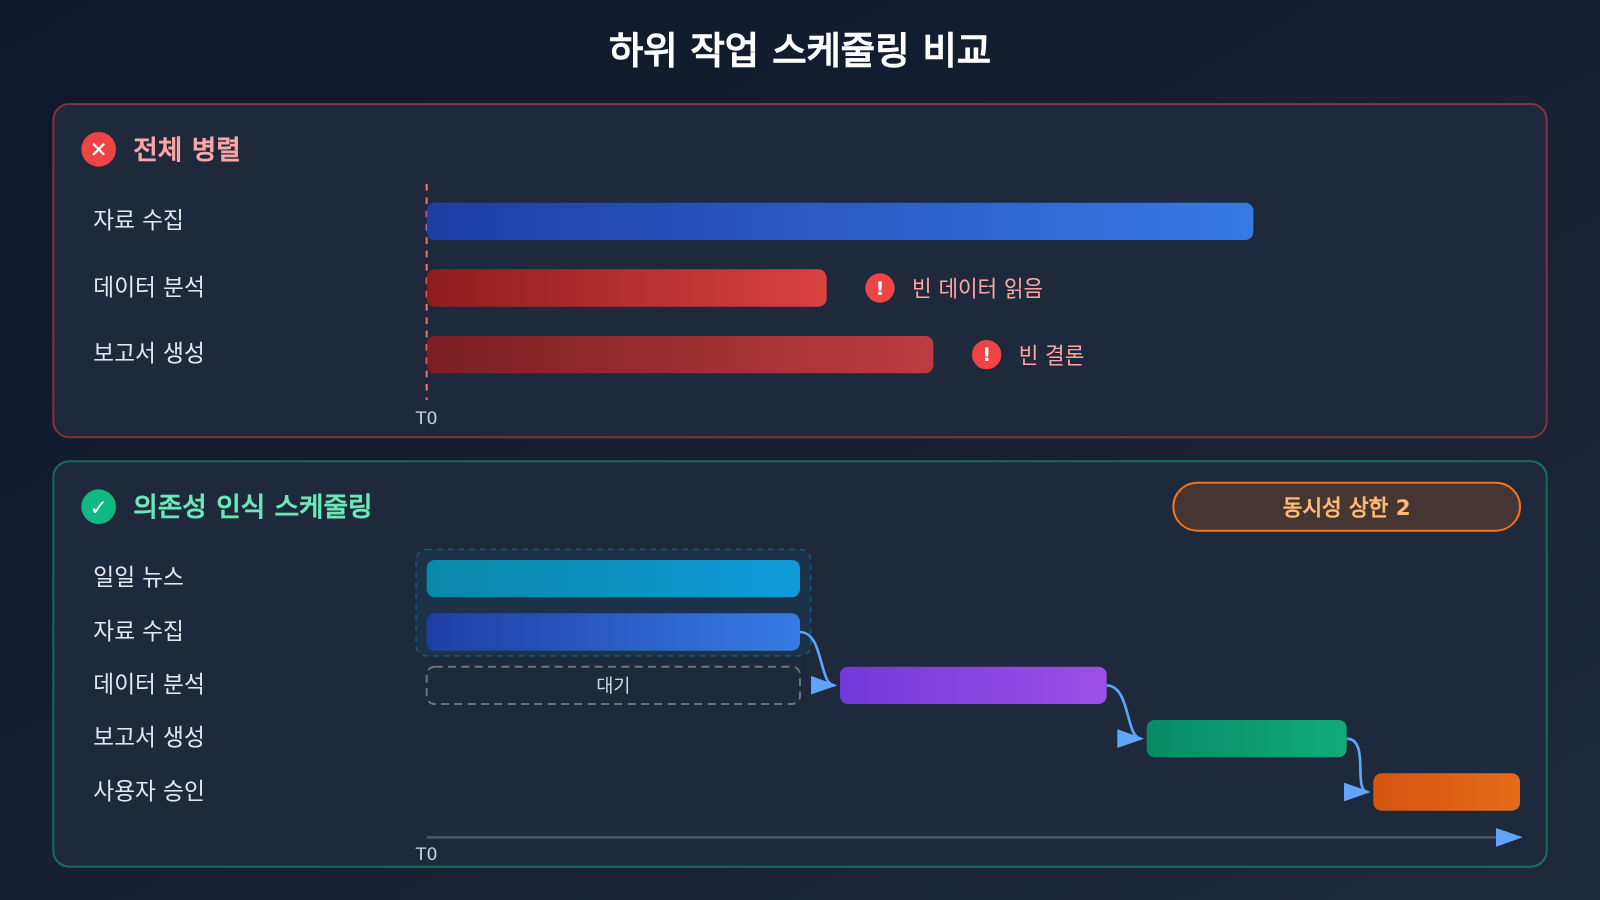
세 하위 작업을 한꺼번에 출발시키면 더 빨라 보이지만, 데이터 분석은 자료를 받지 못해 빈 결론을 내거나 심하면 데이터를 스스로 지어내기까지 해요. 의존 관계는 어떤 작업이 반드시 순차로 실행돼야 하는지를 정하고, 동시성 상한은 몇 개를 동시에 돌릴 수 있는지를 정해요. 두 가지 모두 스케줄러에 적어 넣어야 하고, 모델이 그때그때 판단하도록 맡기면 오류가 나기 쉬워요.
5.4 모델 역할 분담
| 하위 작업 | 권장 모델 유형 | 선택 이유 | 사용 가능 플랫폼 |
|---|---|---|---|
| 자료 수집 및 요약 | 경량 고속 모델 | 호출량이 많고 비용에 민감 | APIYI apiyi.com, 공식 API |
| 데이터 분석 | 추론 능력이 강한 모델 | 다단계 비교와 계산이 필요 | APIYI apiyi.com, 공식 API |
| 보고서 생성 | 장문 작성 능력이 강한 모델 | 구조와 표현 품질 요구가 높음 | APIYI apiyi.com, 공식 API |
| 사실 검증 | 작성 모델과 다른 모델 | 교차 검증으로 동일 출처 오류 감소 | APIYI apiyi.com, 공식 API |
구체적인 모델은 플랫폼의 현재 모델 목록을 기준으로 삼아요. 하나의 API 키로 여러 모델을 연결할 때는 역할 분담을 설정으로 조정할 수 있고, 코드 구조는 손대지 않아도 돼요.
6 빠르게 시작하기: 통합 인터페이스로 멀티태스크 Agent 프로토타입 만들기
6.1 최소 예제: 작업에 프로젝트 배경 주입하기
아래 코드는 가장 핵심적인 부분을 보여줘요. 작업을 실행하기 전에, 장기 메모리에서 해당 프로젝트의 배경만 꺼내오는 거예요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

# Store: 프로젝트별로 격리된 장기 배경
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 완전한 설계안: 상태 머신, 체크포인트, 의존성과 동시성
다음 코드는 하나의 설계안으로, Store, Checkpoint, 상태 머신, 의존성 스케줄링, 동시성 제한, 재시도, 타임아웃, 실행 기록을 포괄하며 각 컴포넌트가 어떻게 협력하는지 보여줘요. 이 코드는 프로덕션 환경에서 검증되지 않았고, 본문에서도 가상의 실행 결과를 제공하지 않아요.
전체 설계안 코드 보기
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 하나의 Key로 여러 모델 전환
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """권한이 부여된 스코프만 조회합니다: user 및 project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # 동시성 제한
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # 타임아웃 또는 API 오류: 지수 백오프 후 재시도
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # 선행 작업 실패, 승인 대기 또는 순환 의존성 존재
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
코드 곳곳에 앞서 설명한 설계가 반영되어 있어요. store_get은 user와 현재 프로젝트 스코프만 읽어 프로젝트 격리를 구현하고, checkpoint 테이블은 run 단위로 매 단계를 기록하며 runs 테이블과 함께 토큰과 최종 상태를 남겨요. schedule은 의존 관계로 직렬 실행을 결정하고 세마포어로 동시 실행 수를 제한해요. 실제 시스템에서는 도구 호출, 승인 콜백, 복구 진입점까지 추가로 갖춰야 해요.
🚀 빠른 시작: 프로토타입 구축 단계에서는 APIYI apiyi.com을 통해 무료 테스트 크레딧을 받아 보는 걸 추천해요. 같은 Key로 수집, 분석, 작성 세 역할에 각각 다른 모델을 배정해 효과와 비용을 비교한 뒤 분업을 정해 보세요.
7 멀티태스크 Agent는 중단, 실패, 사람의 승인을 어떻게 처리할까
7.1 작업 상태 머신
작업 진행 상황은 명확한 상태로 기록해야 하고, 모델이 채팅에서 설명하는 진행률은 참고용일 뿐이에요. 권장하는 주 흐름은 Pending(대기) → Running(실행 중) → Waiting(외부 조건 대기) 또는 Approval(승인 대기) → Completed(완료)이고, 여기에 Failed, Cancelled, Paused 세 가지 종료·일시정지 상태를 따로 둬요. 상태가 바뀔 때마다 데이터베이스에 기록하고, 스케줄러는 오직 데이터베이스에 저장된 상태만 근거로 의사결정을 내려요.
7.2 재시도, 타임아웃, 일시정지와 복구
- 재시도: API 오류나 타임아웃이 나면 지수 백오프로 재시도하고 retry_count를 기록해서 자주 실패하는 단계를 쉽게 찾아낼 수 있게 해요.
- 타임아웃: 각 Run에 실행 시간 제한을 두고, 초과하면 Failed로 전환하면서 알림을 보내요. 멈춰 버린 작업이 오랫동안 동시 실행 슬롯을 차지하는 걸 막기 위해서예요.
- 일시정지와 복구: 일시정지할 때 체크포인트를 저장하고, 복구할 때는 마지막 체크포인트부터 이어서 실행해요. 이미 완료된 도구 호출은 다시 실행할 필요가 없어요.
- 멱등성: 이메일 발송이나 데이터베이스 쓰기처럼 부작용이 있는 단계는 재시도 전에 이미 실행됐는지 먼저 확인해서 중복 작업을 피해요.
Dots 공식 자료에는 관련된 디테일이 하나 있어요. 실행 중인 작업을 중지하는 것과 이미 생성된 주기 계획을 취소하는 것은 별개의 일이고, Dot을 일시정지해도 독립적인 Work, Codex, 계획 작업은 계속 실행될 수 있다는 거예요. 자체 구축 시스템에서는 “이번 Run 중지”, “Task 일시정지”, “주기 계획 취소”를 세 가지 독립적인 작업으로 설계해야 해요.
7.3 사람의 승인: Dots의 Custom Rules 참고하기
Dots는 Custom Rules로 행동을 네 단계로 나눠요. 묻지 않고 바로 실행, 사전 승인 후 실행, 실행 전 질문, 사용자에게 되돌리기가 그것이에요. 비밀번호 변경이나 자금 이체 같은 작업은 반드시 사용자가 직접 처리해야 하고, 데이터 영구 삭제나 소프트웨어 설치 같은 작업은 매번 승인을 요구할 수도 있어요. 사용자가 승인하더라도 핵심 보안 제한을 덮어쓸 수는 없어요.
자체 구축 시스템도 이 방식대로 도구에 태그를 달 수 있어요. 읽기 전용 검색은 바로 실행하고, 보고서 초안 작성이 끝나면 Approval로 넘어가고, 외부 발송·결제·삭제는 전부 사람에게 넘겨요. 예시의 보고서 작업은 needs_approval=True로 설정되어 생성 후 승인 대기 상태에 멈추고, 사용자가 확인한 뒤에야 Completed로 기록돼요.
8 멀티태스크 Agent의 실행 추적: Tracing과 로그
여러 프로젝트를 병행할 때 사용자가 가장 자주 묻는 질문은 “이게 대체 뭘 한 거지?”예요. OpenAI Agents SDK의 Tracing은 어떤 Agent를 호출했는지, 어떤 모델을 사용했는지, 어떤 도구 호출이 일어났는지, 어디서 handoff가 발생했는지, 어떤 안전 검사가 트리거됐는지, 그리고 작업이 최종적으로 어떻게 끝났는지를 기록할 수 있어요.
Tracing은 단일 실행 과정을 복원하는 데 강점이 있고, 프로젝트 수준의 통계는 비즈니스 로그로 보완해야 해요. 각 Run마다 최소한 project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count, final_status를 기록하는 걸 권장해요. 이런 필드가 있으면 “Research 프로젝트가 이번 달에 토큰을 얼마나 썼지”, “어느 단계에서 재시도가 가장 많았지”, “어느 모델의 분석 작업이 가장 자주 타임아웃됐지” 같은 관리 질문에 답할 수 있어요. 6장의 runs 테이블이 바로 이 필드들의 최소 구현이에요.
9 멀티태스크 Agent의 비용과 관리 경계
9.1 Dots의 비용 구조
2026년 11월 16일 기준, 개인 사용자는 ChatGPT Pro 100, Pro 200, Pro 500 세 가지 구독으로 Dots를 사용할 수 있고, 월 요금은 각각 100, 200, 500달러예요. 공식 개인 Pro용 Dots 안내에는 Dot의 별도 월 요금이 따로 명시되어 있지 않아요. Dot이 위임한 ChatGPT Work 또는 Codex 작업은 해당 제품의 한도와 규칙에 따라 계산되며, 소모량은 모델, 컨텍스트, 추론, 도구 호출, 검색에 따라 달라져요. 개인 Pro 사용에는 연령(18세 이상)과 지역 제한이 있고, 유럽경제지역, 영국, 스위스는 포함되지 않아요.
기업 워크스페이스는 과금 방식이 달라요. 현행 공식 문서에 따르면 조건을 충족하는 기업 워크스페이스는 작업 유형별 고정 요율 또는 사용량 기반 과금 중 하나를 선택할 수 있어요. 프리뷰 기간은 무료이고, 2026년 11월 18일부터 이미 활성화된 Dots에 대해 과금이 시작되며, Work 또는 Codex로 위임된 작업은 별도로 청구돼요. 구체적인 금액은 워크스페이스에 실제로 적용되는 견적을 기준으로 해요.
9.2 자체 구축 시스템의 비용 원천
자체 구축한 멀티태스크 Agent의 비용은 주로 네 곳에서 나와요:
- 컨텍스트 반복 읽기: 각 작업에 프로젝트 배경을 주입하는데, 배경이 길수록 매 호출의 입력 토큰이 늘어나요. Store 안의 내용은 주기적으로 간소화해야 해요.
- 재시도와 실패: 한 번 실패한 분석 작업은 업스트림 자료를 다시 모델에 넣게 돼요.
- 모델 선택: 모든 하위 작업에 가장 강한 모델을 쓰면 비용이 배로 올라가요.
- 동시성 한도: API의 속도 제한이 실제 사용 가능한 병렬 수를 결정해요.
9.3 병렬 수와 유효 작업량
병렬 수와 유효 작업량은 별개예요. 의존성이 충족되지 않은 작업을 미리 시작하면 쓸모없는 결과만 나오고, 서로 충돌하는 결론은 사람이 합치는 데 시간을 써야 하며, 한 프로젝트의 잘못된 데이터가 공유 메모리를 통해 다른 프로젝트로 전달되면 재작업 비용은 더 커져요. 합리적인 방법은 먼저 프로젝트 격리와 의존성 정확성을 보장한 뒤, 모니터링 데이터에 따라 동시성 상한을 점진적으로 높이는 거예요.
10 자주 묻는 질문 FAQ
Q1: Dots의 멀티태스크 스케줄링이란 무엇인가요?
하나의 Dot이 여러 책임 항목을 동시에 관리해요. 사용자는 작업을 전환하고 우선순위를 조정할 수 있으며, Dot은 복잡한 작업을 백그라운드 Agent에 나눠 병렬로 처리한 뒤 결과를 취합해 의사결정이 필요한 시점에 사용자에게 돌려줍니다.
Q2: Dots의 장기 기억은 모든 과거 대화를 기억하나요?
전부 불러오지는 않아요. 새 작업에는 자체 대화 컨텍스트가 있으며, Dot은 ChatGPT Memory, 자체 노트, 현재 작업 컨텍스트, 연결된 앱의 데이터를 활용해 동작하고, 필요할 때 과거 대화를 검색합니다.
Q3: Checkpointer와 Store는 서로 대체할 수 있나요?
두 가지는 역할이 달라요. Checkpointer는 단일 작업의 실행 스냅샷을 저장해 중단 복구에 사용하고, Store는 작업을 넘나드는 프로젝트 배경과 의사결정을 저장해 새 작업이 컨텍스트를 이어가게 해줍니다. 장기 프로젝트라면 둘 다 필요해요.
Q4: Dots는 동시에 몇 개의 작업을 병렬로 처리할 수 있나요?
공식 자료에는 고정된 동시 처리 수가 공개되어 있지 않아요. Dots는 병렬 처리를 지원하지만 실행 환경과 사용 할당량에 경계가 있습니다. Reddit 사용자가 실행 프로세스 세 개가 동시에 돌아가는 것을 관찰했다고 밝혔지만, 이는 개인 테스트 결과일 뿐이에요.
Q5: 직접 구축한 멀티 프로젝트 Agent에서 여러 모델을 빠르게 호출하려면 어떻게 하나요?
OpenAI 호환 집계 인터페이스를 사용하면 됩니다. APIYI apiyi.com에서 등록해 API 키와 무료 테스트 할당량을 받은 뒤, 본문 코드의 base_url을 `https://api.apiyi.com/v1`로 설정하면 동일한 코드로 서로 다른 하위 작업에 GPT, Claude, Gemini 등의 모델을 구성할 수 있어요.
Q6: 멀티태스크 Agent의 모델 비용은 어떻게 관리하나요?
역할별로 모델을 배분하세요. 자료 수집에는 가벼운 모델을, 분석과 작성에는 강력한 모델을 사용하고, Store의 프로젝트 배경은 간결하게 유지하며, runs 테이블로 프로젝트별 Token을 집계합니다. APIYI apiyi.com을 통해 사용량 기반 과금으로 호출하면 소규모 테스트 후 할당량을 결정하기 쉬워요.
Q7: Dots와 직접 구축 시스템에서 보안상 주의할 점은 무엇인가요?
Agent는 작업을 오해하거나 자료를 잘못 판단할 수 있고, Prompt Injection에 노출될 수도 있어요. 공식 측에서도 기존 방어 조치가 모든 위험을 없앨 수는 없다고 밝혔습니다. 계정, 자금, 외부 발송과 관련된 작업에는 사람의 승인 절차를 두고, 민감한 자격 증명은 모델 컨텍스트에 넣지 마세요.
—
## 11 Dots 멀티태스크 스케줄링과 장기 메모리 핵심 요점
– **핵심 난점**: 멀티태스크 Agent의 핵심은 독립 컨텍스트, 영속 상태, 스케줄링과 복구에 있어요.
– **Dots 메커니즘**: 하나의 Dot이 여러 작업을 조율하고, 백그라운드 Agent가 병렬로 실행되며, 새 작업의 컨텍스트는 서로 독립적이에요.
– **두 가지 메모리**: Checkpointer는 실행 복구를 담당하고, Store는 프로젝트 배경의 연속성을 담당해요.
– **4계층 구조**: Workspace, Project, Task, Run은 각각 독립 ID를 가지며, 프로젝트 간에 서로 격리돼요.
– **스케줄링 원칙**: 의존성이 직렬 실행을 결정하고, 동시성 상한이 규모를 결정하며, 규칙은 스케줄러에 명시해요.
– **추적 가능성**: 각 Run은 모델, Token, 소요 시간, 재시도 횟수, 최종 상태를 기록해요.
– **시작 방법**: APIYI apiyi.com의 통합 인터페이스를 통해 서로 다른 하위 작업에 서로 다른 모델을 설정할 수 있어요.
—
## 12 정리
Dots는 개인 Agent가 여러 장기 프로젝트를 관리하는 제품 형태를 보여줘요. 상시 실행되고, 작업 컨텍스트는 서로 독립적이며, 메모리는 계층적으로 저장되고, 백그라운드 Agent가 병렬로 실행되며, 고위험 작업은 사용자에게 다시 넘겨요. 이런 다중 프로젝트 능력은 상태 관리 위에 구축된 것이지, 단순히 병렬 수를 늘린다고 해서 얻을 수 있는 게 아니에요.
비슷한 시스템을 직접 구축할 때는 이 글의 순서대로 구현할 수 있어요. 먼저 4계층 구조와 스코프 구분으로 프로젝트 격리를 구현하고, 그다음 Store와 Checkpointer로 “배경 기억”과 “복구 가능”을 각각 해결하고, 이후 스케줄러로 의존성과 동시성을 관리하며, 마지막으로 상태 머신, 승인, 실행 로그로 각 단계를 제어하고 조회할 수 있게 만들어요. 프로토타입 단계에서는 APIYI apiyi.com을 통해 각 역할에서 서로 다른 모델의 효과를 빠르게 검증한 뒤, 로그 데이터를 바탕으로 분업과 동시성을 조정하는 것을 추천해요.
—
## 참고 자료
1. **OpenAI: Introducing dots**: 제품 출시 공지
– 링크: `openai.com/index/introducing-dots`
– 설명: 제품 포지셔닝, 클라우드 컴퓨터 및 멀티프로젝트 실행
2. **ChatGPT Learn: Tasks and memory**: Dots 작업 및 기억 문서
– 링크: `learn.chatgpt.com/docs/dots/tasks-and-memory`
– 설명: 백그라운드 Agent, 작업별 독립 컨텍스트, 능동 리서치
3. **OpenAI Help Center: Dots privacy, security, and safety FAQs**: 개인정보 및 보안 안내
– 링크: `help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs`
– 설명: 권한, 승인, 기억 삭제 및 데이터 보존
4. **ChatGPT Learn: Dots admin guide**: 기업판 관리 및 과금
– 링크: `learn.chatgpt.com/docs/enterprise/dots-admin-guide`
– 설명: 기업 워크스페이스 과금 방식과 과금 시작일
5. **About ChatGPT Pro tiers**: Pro 구독 요금제 안내
– 링크: `help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers`
– 설명: Pro 100, 200, 500의 가격과 할당량 규칙
6. **LangGraph Persistence 문서**: Checkpointer 및 Store
– 링크: `github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx`
– 설명: 단기 실행 상태와 장기 기억의 구분
7. **OpenAI Agents SDK**: Tracing 및 워크플로우
– 링크: `developers.openai.com/api/docs/guides/agents/sdk`
– 설명: Agent 실행 과정의 추적과 디버깅
—
> **작성자**: APIYI 기술팀
> **기술 교류**: APIYI apiyi.com 홈페이지에서 저희에게 연락해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.


