
저자 주석: Code Arena WebDev 순위 6위 Qwen4-Max를 해부합니다 — 상위 6위 구도, 중국산 모델 간 내부 격차, 선두 모델과의 점수 차이, 그리고 투표 수와 단일 작업 비용을 올바르게 읽는 법까지.
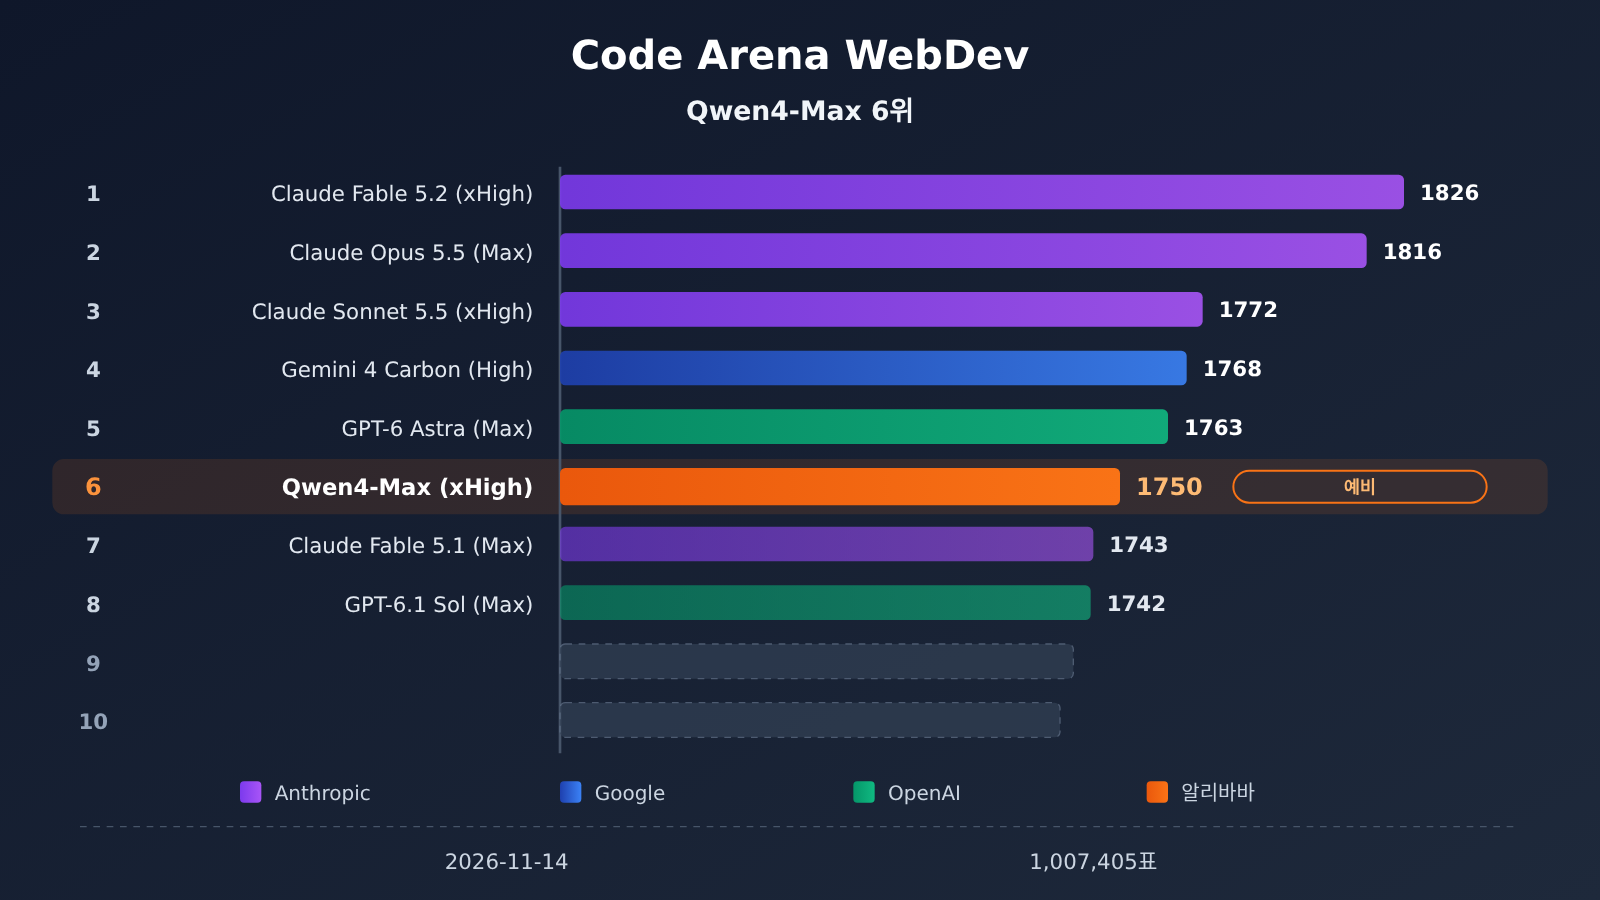
먼저 결론부터 말씀드릴게요. arena.ai의 Code Arena WebDev 리더보드(Overall 분류, 페이지 표기 2026-11-14)에서 Qwen4-Max(xHigh)가 1750점으로 6위에 올랐어요. 중국산 모델이 이 리더보드의 상위 6위에 진입한 것은 이번이 처음이며, 상위 6위 안에서 미국 연구소가 아닌 유일한 모델이기도 해요.
이건 6위를 1위로 포장하는 홍보 글이 아니에요. Qwen4-Max는 리더보드에서 Preliminary 표시가 붙어 있고, 투표 수가 1,814표에 불과해서 순위는 아직 움직일 수 있어요. 알리바바가 공개한 같은 공식 이미지에서도, 이 모델은 Terminal-Bench와 ProgramBench에서 여전히 Opus 5.5, GPT-6 Astra에 확연히 뒤지고 있어요.
핵심 가치: 이 글을 다 읽으면 직접 열어서 대조할 수 있는 리더보드 메타데이터를 손에 쥐게 되고, Qwen4-Max의 6위를 어떻게 활용해야 하고 어떻게 활용하면 안 되는지 이해하게 될 거예요.
Qwen4-Max Code Arena WebDev 6위 핵심 포인트
순위를 논하기 전에 먼저 리더보드의 메타데이터를 확인해 볼게요. ‘몇 위’라는 말은 날짜, 투표 수, 참여 모델 수를 먼저 대조해야 해요. 그렇지 않으면 그 순위가 믿을 만한지 판단하기 어려워요.
| 포인트 | 데이터 (같은 리더보드 공개 데이터) | 해석 방법 |
|---|---|---|
| 리더보드 및 분류 | arena.ai Code Arena WebDev, Overall | 웹 개발 부문 블라인드 테스트 선호도만 나타냄 |
| 페이지 날짜 | 2026-11-14 | 순위는 투표에 따라 계속 변동 |
| 총 투표 수 / 모델 수 | 1,007,405표 / 159개 모델 | 표본은 크지만 모델별 투표 수 차이가 매우 큼 |
| Qwen4-Max 순위 및 점수 | 6위, 1750점 | 상위 6개 중 유일한 비미국 연구소 모델 |
| Qwen4-Max 투표 수 및 표시 | 1,814표, Preliminary | 아직 초기 평가 단계 |
| 작업당 비용 P50 | $4.18 | 리더보드에서 집계한 중앙값이며, 모델 단가가 아님 |
Qwen4-Max 리더보드 기준 자세히 보기
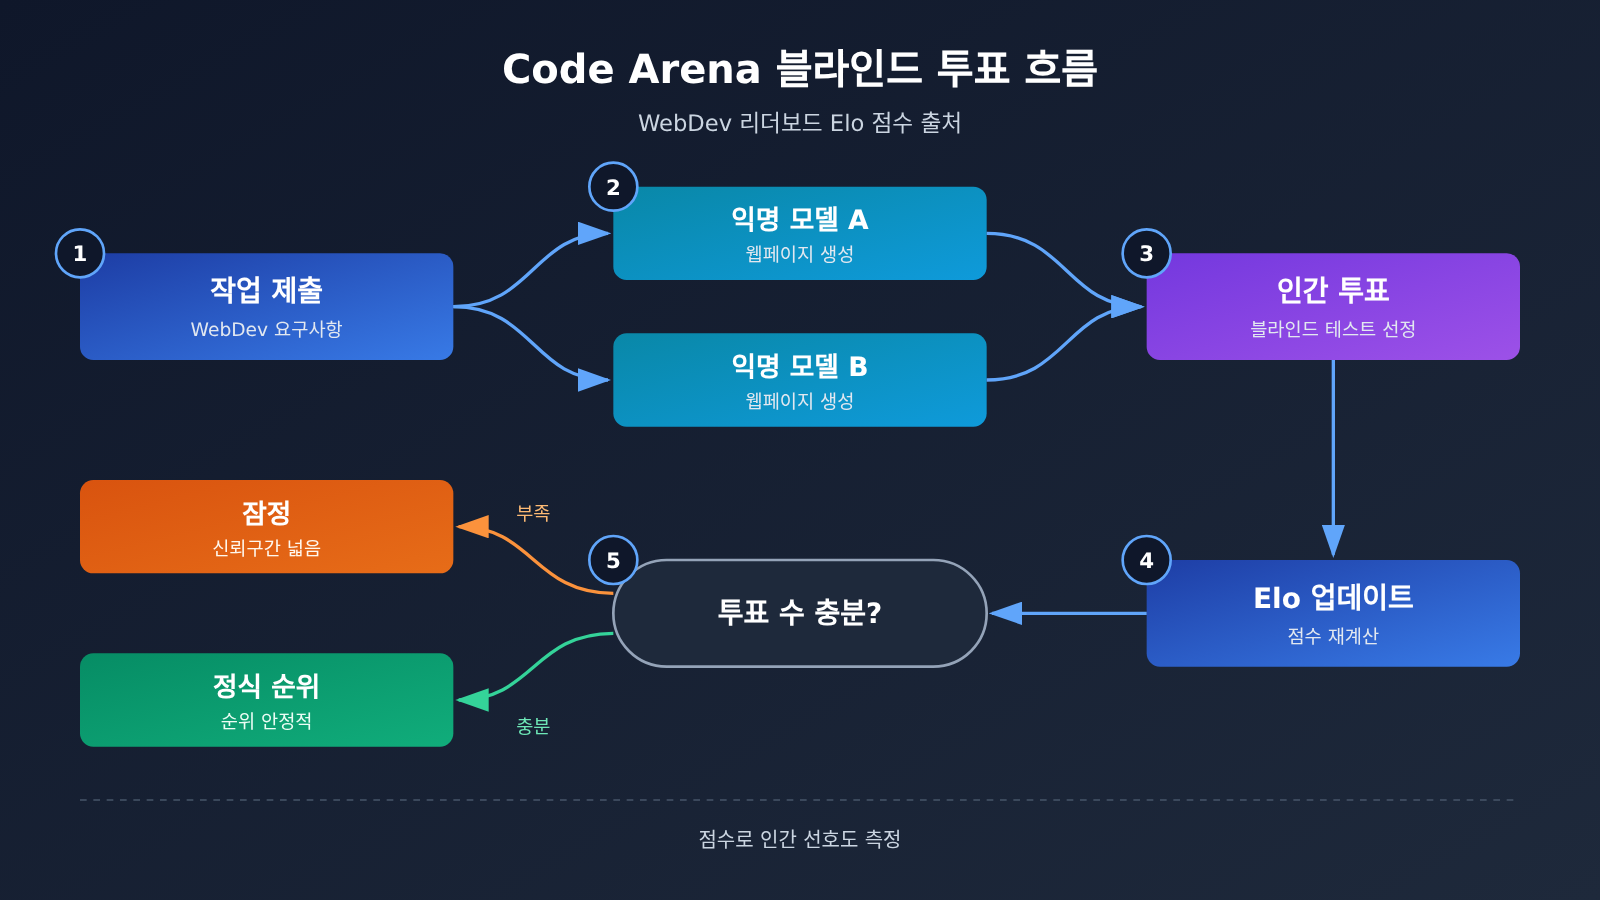
Code Arena의 Elo 점수는 사람이 참여하는 블라인드 테스트 투표에서 나와요. 사용자가 동일한 웹 개발 작업을 제시하고, 두 익명 모델의 결과물을 본 뒤 더 나은 쪽에 투표하는 방식이에요. 점수는 ‘인간 평가자 눈에 누가 더 나은 웹페이지를 만들었는가’를 반영하며, 종합 생산성 점수가 아니라 선호도를 측정한 값이에요.
Preliminary 표시의 의미도 이해해야 해요. 이 모델이 참여한 대결 횟수가 아직 충분히 많지 않아 신뢰 구간이 넓다는 뜻이에요. 같은 리더보드 4위인 Gemini 4 Carbon (High)도 이 표시를 달고 있어서, 4위부터 6위 구간에서 향후 몇 주 안에 순위가 뒤바뀌는 일은 놀랍지 않아요.
Code Arena WebDev 상위 6개 모델은 누구일까: Qwen4-Max의 경쟁 구도
상위 10개를 모두 나열하면 Qwen4-Max가 어디에 있는지 더 직관적으로 볼 수 있어요. 상위 5개는 미국 연구소 세 곳이 독차지했고, 그중 Anthropic 한 곳이 세 자리를 가져갔어요.
| 순위 | 모델 | 점수 | 소속 연구소 | 비고 |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | 1위 |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | 단일 작업 P50 $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | 예비 결과 | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | 단일 작업 P50 $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | 알리바바 | 예비 결과, 1,814표 |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
상위 5위 구도가 Qwen4-Max에 의미하는 것
상위 6개 안에서 Anthropic이 3석(Fable 5.2, Opus 5.5, Sonnet 5.5)을 차지했고, Google과 OpenAI가 각 1석, 알리바바가 1석이에요. 다시 말해 Qwen4-Max는 세 선도 연구소의 플래그십 모델 사이에서 비집고 들어가 한 자리를 차지한 것이지, 느슨한 순위표에서 이름을 주워 담은 게 아니에요.
또 하나 주목할 점은 6위부터 8위까지 점수가 아주 촘촘하다는 거예요: 1750, 1743, 1742로 세 모델의 차이가 10점이 안 돼요. Qwen4-Max가 Claude Fable 5.1과 GPT-6.1 Sol을 앞서는 폭은, GPT-6 Astra에 13점 뒤지는 폭보다 작아요. 순위의 안정성은 투표 수가 더 늘어난 뒤에 판단해야 해요.
중국산 모델 중 Qwen4-Max의 위치
중국산 모델만 놓고 보면 Qwen4-Max의 선두가 더 뚜렷해요. 중국산 모델 가운데 유일하게 톱 10에 들었고, 2위는 13위에서야 나타나요.
| 중국산 순위 | 모델 | 점수 | 리더보드 순위 | Qwen4-Max와 격차 |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 6위 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 13위 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 16위 | −74 |
| 4 | Qwen3.8-Max | 1670 | 18위 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 18위 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 19위 | −89 |
| 7 | Kimi K3 (Max) | 1658 | 20위 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 26위 | −111 |
| 9 | Hy4 preview | 1632 | 27위 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 31위 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 33위 | −129 |
중국산 모델 내부 격차의 두 가지 의미
첫 번째는 세대 도약이에요. Qwen4-Max는 자사 이전 세대인 Qwen3.8-Max(0902)보다 74점 높고, 순위도 16위에서 6위로 뛰었어요. 같은 리더보드, 같은 투표 방식 아래에서 이 정도 상승 폭은 꽤 눈에 띄는 수준이에요.
두 번째는 중국산 2위와의 거리예요. Qwen4-Max는 Kimi K3.1 Pro보다 64점 높은데, 이 격차는 Qwen4-Max가 Opus 5.5에 뒤진 66점과 비슷해요. 즉 Qwen4-Max는 지금 중국산 진영과 글로벌 선두 사이의 중간 지점에 서 있어요. 아래로는 중국산 경쟁자들을 벌려 놓았고, 위로는 아직 1위까지 거리가 남아 있어요.
참고로 중국산 모델 2위부터 7위까지는 1686에서 1658 사이에 몰려 있어서 점수 차이가 아주 작아요. 이 리더보드로 이 몇 곳의 순서를 매기는 건 큰 의미가 없어요.
Qwen4-Max는 글로벌 선두 모델과 얼마나 차이 날까
Code Arena WebDev에서의 점수 차이
Qwen4-Max와 선두 모델의 점수 차이를 나열하고, 일반적인 Elo 공식(400점 스케일)으로 맞대결 승률을 대략 추정해 보면 이 차이가 실제로 어떤 의미인지 이해하는 데 도움이 돼요. arena의 구체적인 집계 방식은 표준 Elo와 다를 수 있으니, 아래 승률은 직관적인 참고용으로만 봐 주세요.
- 5위 GPT-6 Astra와 비교: 1750 vs 1763, 13점 차이로 맞대결 승률은 약 48%로 추정돼요. 거의 막상막하 수준이에요.
- 2위 Opus 5.5와 비교: 66점 차이로 맞대결 승률은 약 41%로 추정돼요.
- 1위 Fable 5.2와 비교: 76점 차이로 맞대결 승률은 약 39%로 추정돼요.
- 중국 모델 2위 Kimi K3.1 Pro와 비교: 64점 앞서고, 맞대결 승률은 약 59%로 추정돼요.
리더보드 전체 점수 범위는 1071부터 1826까지예요. 이 스케일에서 Qwen4-Max와 1위의 76점 차이는 그렇게 크지 않지만, 웹 개발 선호도에서는 Anthropic의 선두 모델이 여전히 심사자들에게 더 좋은 평가를 받는다는 점도 보여 줘요.
같은 차트에 담긴 다른 벤치마크: Elo가 높다고 터미널 작업이 강한 건 아니에요
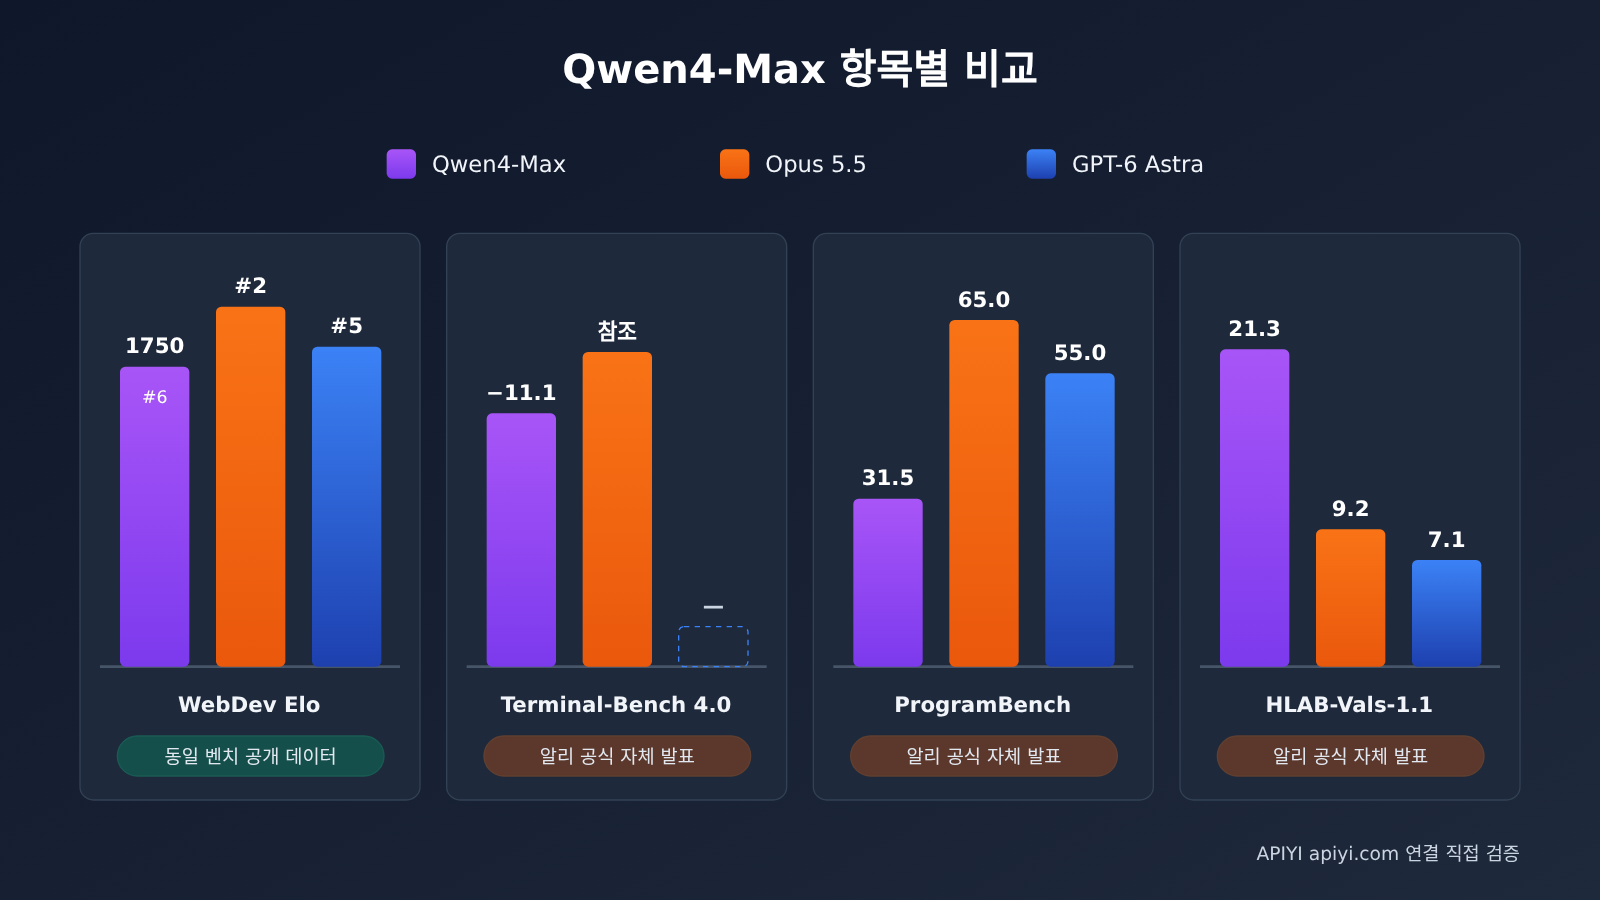
알리바바가 Qwen4-Max를 발표할 때 사용한 것은 여러 벤치마크를 한 장에 담은 차트예요. 아래 데이터는 모두 알리바바 공식 자체 보고 수치이며, arena 리더보드 데이터도, 제3자 재현 결과도 아니에요.
| 벤치마크(공식 자체 보고) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | 기타 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
이 표는 중요한 사실 하나를 보여 줘요. Qwen4-Max는 웹 개발 블라인드 테스트에서 점수가 높지만, 터미널 조작 및 엔지니어링 프로그래밍 벤치마크에서는 여전히 격차가 뚜렷해요. Terminal-Bench 4.0에서는 Opus 5.5보다 11.1점 낮고, 차트에 표시된 Kimi 모델은 67.2로 오히려 더 높아요. ProgramBench에서는 31.5로 Opus 5.5의 절반에도 못 미쳐요.
뚜렷하게 앞서는 항목도 있어요. HLAB-Vals-1.1에서 Qwen4-Max는 21.3을 기록해 Opus 5.5의 9.2, GPT-6 Astra의 7.1보다 훨씬 높았고, AA-Briefcase에서도 GPT-6 Astra보다 높아요. 그래서 더 정확하게 말하면, Qwen4-Max는 선두 모델과 능력 분포가 다르다는 것이지 “전반적으로 근접했다”는 건 아니에요.
Qwen4-Max의 투표 수와 비용, 어떻게 읽어야 할까요
투표 수: 1,814표가 의미하는 것
순위가 안정적으로 유지되는지는 상당 부분 투표 수에 달려 있어요. Qwen4-Max의 1,814표는 전체 약 100만 표 중 0.2%에 못 미치는 수준이고, 같은 리더보드의 다른 중국 모델들과 비교해도 적은 편이에요.
| 모델 | 순위 | 투표 수 | 단일 작업 비용 P50 | 상태 |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6위 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 13위 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 16위 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 2위 | 동일 리더보드 공개 데이터 | $8.99 | — |
| GPT-6 Astra (Max) | 5위 | 동일 리더보드 공개 데이터 | $9.43 | — |
Qwen3.8-Max의 투표 수는 Qwen4-Max의 약 12.7배이고, 점수도 ‘안정값’에 더 가까워요. 반면 Qwen4-Max의 1750점은 아직 초기 읽기에 가까워서, 이후에 올라갈 수도 있고 내려갈 수도 있어요. 이 순위를 인용할 때는 ‘Preliminary, 1,814표, 2026-11-14’라는 세 가지 단서를 함께 적어 두는 게 좋아요.
단일 작업 비용 P50: 모델 단가가 아니에요
리더보드의 단일 작업 비용 P50은 해당 리더보드 작업에서 한 번의 작업에 드는 비용의 중앙값을 뜻해요. 이 값은 모델의 출력 길이와 추론 강도 단계(예: xHigh, Max)에 따라 크게 달라지기 때문에 모델의 백만 토큰당 단가로 비교해서는 안 돼요.
이 기준으로 보면 Qwen4-Max의 $4.18은 Opus 5.5($8.99)의 약 46%, GPT-6 Astra($9.43)의 약 44% 수준이지만, Kimi K3.1 Pro($0.89)의 약 4.7배, 이전 세대 Qwen3.8-Max($1.91)의 약 2.2배예요. 쓰는 시나리오가 단일 작업 비용에 민감하다면, Kimi K3.1 Pro가 약 5분의 1 비용으로 1686점을 기록했다는 점도 평가에 함께 넣어볼 만해요.
Qwen4-Max 공식 가격과 APIYI 현재 가격
아래는 100만 토큰당 가격이고, 기준일은 2026-11-16이에요.
- Qwen4-Max 공식 가격: 입력 $1.5, 출력 $4.5, 캐시 읽기 $0.075.
- APIYI에서 판매 중인 Qwen 플래그십
qwen3.8-max: 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625.
참고로 APIYI에는 아직 qwen4-max가 등록되어 있지 않고, 조만간 이 모델을 등록할 예정이에요. 두 모델은 서로 다른 모델이라 위 가격을 그대로 가로 비교할 수는 없어요. 실제로 쓸 수 있는 모델과 가격은 APIYI apiyi.com 플랫폼의 모델 목록을 기준으로 확인해 주세요.
리더보드 재확인, 가격 비교, 엔드포인트 전환 — 세 단계
리더보드를 하나 읽고 나면, 개발자는 보통 세 가지를 해요. 순위를 확인하고, 가격을 확인하고, 모델을 자신의 프로젝트에 연결해 보는 거죠. 아래 순서대로 하는 걸 권해요:
- 리더보드 재확인: arena.ai의 Code Arena WebDev 페이지를 열어 날짜, 투표 수, Preliminary 표시가 달라졌는지 확인해요.
- 가격 비교: APIYI apiyi.com의 모델 목록에서 현재 판매 중인 Qwen 모델과 실시간 가격을 확인하고,
qwen4-max가 이미 올라왔는지 확인해요. - 엔드포인트 전환: 기존 OpenAI 호환 SDK에서 base_url을
https://api.apiyi.com/v1로 바꾸고, 모델 ID는 우선qwen3.8-max로 넣어요. 신형 모델이 올라오면qwen4-max로 바꿔서 비교해 보면 돼요.
🚀 빠른 시작 팁: 자신의 WebDev 작업에서 Qwen 시리즈와 Claude, GPT, Gemini의 차이를 확인해 보고 싶다면, APIYI apiyi.com을 통해 하나의 API 키로 여러 모델을 호출해 보세요. 신규 사용자에게는 무료 테스트 크레딧이 있어서, 작은 샘플을 먼저 돌려 본 뒤 모델을 고르기에 좋아요.
Qwen4-Max 장단점 분석
Qwen4-Max의 강점
- 웹 개발 선호도 점수에서 중국산 모델 진영을 앞서요: 1750점으로, 중국산 모델 2위보다 64점, 이전 버전보다 74점 높아요.
- 상위권과의 격차가 이미 꽤 작은 부분도 있어요: 5위 GPT-6 Astra와는 불과 13점 차이고, 7위·8위와는 거의 동점이에요.
- 작업당 비용은 상위권 플래그십보다 낮아요: P50 $4.18로, Opus 5.5와 GPT-6 Astra의 절반도 안 돼요.
- 일부 벤치마크에서는 뚜렷한 강점이 있어요: HLAB-Vals-1.1에서 공식 자체 보고 점수는 Opus 5.5와 GPT-6 Astra를 크게 앞서요.
Qwen4-Max의 한계
- 순위가 아직 안정적이지 않아요: Preliminary 표시에 1,814표라는 조건이 붙어 있어서, 인용할 때는 이 한계를 함께 밝혀야 해요.
- 터미널 및 엔지니어링 프로그래밍 계열 벤치마크에서는 뒤져요: Terminal-Bench 4.0과 ProgramBench에서는 Opus 5.5, GPT-6 Astra보다 확실히 낮아서, 에이전트나 명령줄 자동화를 할 때는 별도로 평가해야 해요.
- 작업당 비용은 일부 중국산 모델보다 높아요: Kimi K3.1 Pro, Qwen3.8-Max보다 꽤 비싸서 비용에 민감한 상황에서는 꼭 유리하다고 보기 어려워요.
Code Arena WebDev 리더보드만 보면 안 되는 때
주 사용 환경이 터미널 작업, 긴 흐름의 코드 수정, 다단계 에이전트 작업이라면 WebDev Elo만 보고 Qwen4-Max의 실제 성능을 과대평가할 수 있어요. 이럴 때는 Terminal-Bench 같은 벤치마크가 요구사항에 더 가깝죠. 마찬가지로 예산이 하드 제약이라면 순위만 쫓지 말고 작업당 비용과 점수를 함께 봐야 해요. 이 리더보드가 가장 잘 대답하는 질문은 이거예요. “인간 평가자 눈에 누가 만든 웹페이지가 더 나은가.”
자주 묻는 질문 FAQ
Q1: Qwen4-Max의 Code Arena WebDev 순위 6위는 진짜 순위인가요?
랭킹 페이지에 표시된 실제 순위가 맞아요(2026-11-14, Overall 분류, 1750점). 다만 Preliminary 표시가 붙어 있고 투표 수가 1,814표밖에 되지 않아서 이후 순위가 바뀔 수 있어요. 인용할 때는 이런 조건을 함께 밝히는 걸 권해요.
Q2: Qwen4-Max는 GPT-6 Astra, Opus 5.5와 얼마나 차이 나나요?
Code Arena WebDev에서 Qwen4-Max는 GPT-6 Astra보다 13점 낮고, Opus 5.5보다 66점 낮으며, 1위 Fable 5.2보다 76점 낮아요. 그런데 알리바바가 자체 보고한 Terminal-Bench 4.0과 ProgramBench에서는 이 두 모델과의 격차가 뚜렷하게 더 커요.
Q3: Qwen4-Max는 중국 모델 가운데 얼마나 앞서나요?
10위 안에 든 유일한 중국 모델이고, 중국 모델 2위인 Kimi K3.1 Pro(13위, 1686점)보다 64점 높으며, 자사 전작 Qwen3.8-Max(0902)보다 74점 높아요.
Q4: Qwen4-Max는 어떤 상황에 가장 잘 맞나요?
이 랭킹의 기준으로 보면 웹 프론트엔드 생성, 랜딩 페이지와 인터랙티브 프로토타입 같은 WebDev 작업에 더 잘 맞아요. 터미널 자동화나 대규모 엔지니어링급 코드 수정 같은 시나리오는 터미널 계열 벤치마크를 참고하고, 직접 샘플을 돌려 검증해 보시길 권해요.
Q5: API로 Qwen 계열 모델을 호출해 비교 테스트하려면 어떻게 하나요?
APIYI apiyi.com에서 가입하고 API 키를 발급받은 뒤, OpenAI 호환 SDK에서 base_url을 `https://api.apiyi.com/v1`로, 모델 ID를 `qwen3.8-max`로 설정하면 돼요. `qwen4-max`는 아직 출시되지 않았고 최대한 빠르게 출시할 예정이에요. 출시되면 모델 ID만 바꿔서 대조 테스트를 이어가면 됩니다.
Q6: 단일 작업 비용 $4.18은 Qwen4-Max의 가격인가요?
아니요. $4.18은 랭킹이 집계한 단일 작업 비용 중위값(P50)으로, 출력 길이와 추론 단계의 영향을 받아요. 모델 단가는 1M 토큰당 입력, 출력, 캐시 읽기 가격을 기준으로 봐야 하고, 실시간 가격은 APIYI apiyi.com의 모델 목록에서 확인할 수 있어요.
Qwen4-Max Code Arena WebDev 핵심 포인트 Key Takeaways
- 순위: 2026-11-14 순위표 기준 6위, 1750점, 중국산 모델로는 처음으로 톱6에 진입했어요.
- 구도: 톱5는 Anthropic 3석, Google 1석, OpenAI 1석이 차지하고 있어요.
- 안정성: Preliminary 표시가 붙어 있고 1,814표가 더해져 있어 순위는 아직 바뀔 수 있어요.
- 중국산 모델 격차: Kimi K3.1 Pro보다 64점 앞서고, 이전 세대보다 74점 앞서요.
- 능력의 경계: Terminal-Bench와 ProgramBench는 공식 자체 보고 기준에서 여전히 상위권에 뒤져요.
- 비용 기준: P50 $4.18은 단일 작업의 중앙값이지 모델 단가가 아니에요.
- 시작 방법: 먼저 APIYI에서
qwen3.8-max로 비교 워크플로를 구성하고, 새 모델이 출시되면 전환하면 돼요.
정리
Qwen4-Max가 Code Arena WebDev 순위표에서 보여준 성과는 세 가지로 정리할 수 있어요.
- 처음으로 톱6 진입: 1750점, 톱6 가운데 미국 연구소 모델이 아닌 유일한 모델이며 5위와는 불과 13점 차이예요.
- 순위는 아직 초기 판독값: Preliminary, 1,814표 기준이라 인용할 때는 날짜와 표 수를 분명히 밝혀야 해요.
- Elo가 전방위로 강하다는 뜻은 아니에요: 공식 자체 보고 기준의 터미널 계열 및 엔지니어링 프로그래밍 벤치마크에서는 여전히 Opus 5.5와 GPT-6 Astra에 뒤져요.
모델 선택 중이라면 이 순위표를 ‘웹 개발 선호도’의 참고 축 중 하나로 보고, 자신의 작업 샘플과 비용 예산을 함께 고려해 판단하세요. APIYI apiyi.com을 통해 통합 인터페이스로 후보 모델을 같은 작업 묶음에서 비교하고, 자신의 데이터로 결론을 내는 걸 권해요.
📚 참고 자료
- arena.ai Code Arena WebDev 순위: 본문의 순위, 점수, 득표수와 단일 작업 비용의 출처
- 링크:
arena.ai -
설명: 페이지에 2026-11-14로 표기되어 있고 Overall 분류 기준이에요. 최신 순위와 Preliminary 표시는 직접 확인하시면 됩니다
-
알리바바 Qwen4-Max 공식 발표 이미지: Terminal-Bench 4.0, ProgramBench 등 벤치마크 점수 출처
- 링크: Qwen 공식 발표 채널 기준
- 설명: 본문의 관련 데이터는 모두 공식적으로 자체 보고한 수치이며, 제3자가 재현한 결과는 아니에요
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 편하게 연락해 주세요. 모델 상장과 연동 안내는 docs.apiyi.com 문서 센터에서 확인할 수 있어요


