
작성자 주석: Codex 작업의 소요 시간은 모델, 추론 강도, 서비스 경로, 도구 루프, 캐시, 네트워크가 함께 결정해요. 같은 작업을 기준으로 비교하고 구간별로 시간을 재면 병목 지점을 찾을 수 있습니다.
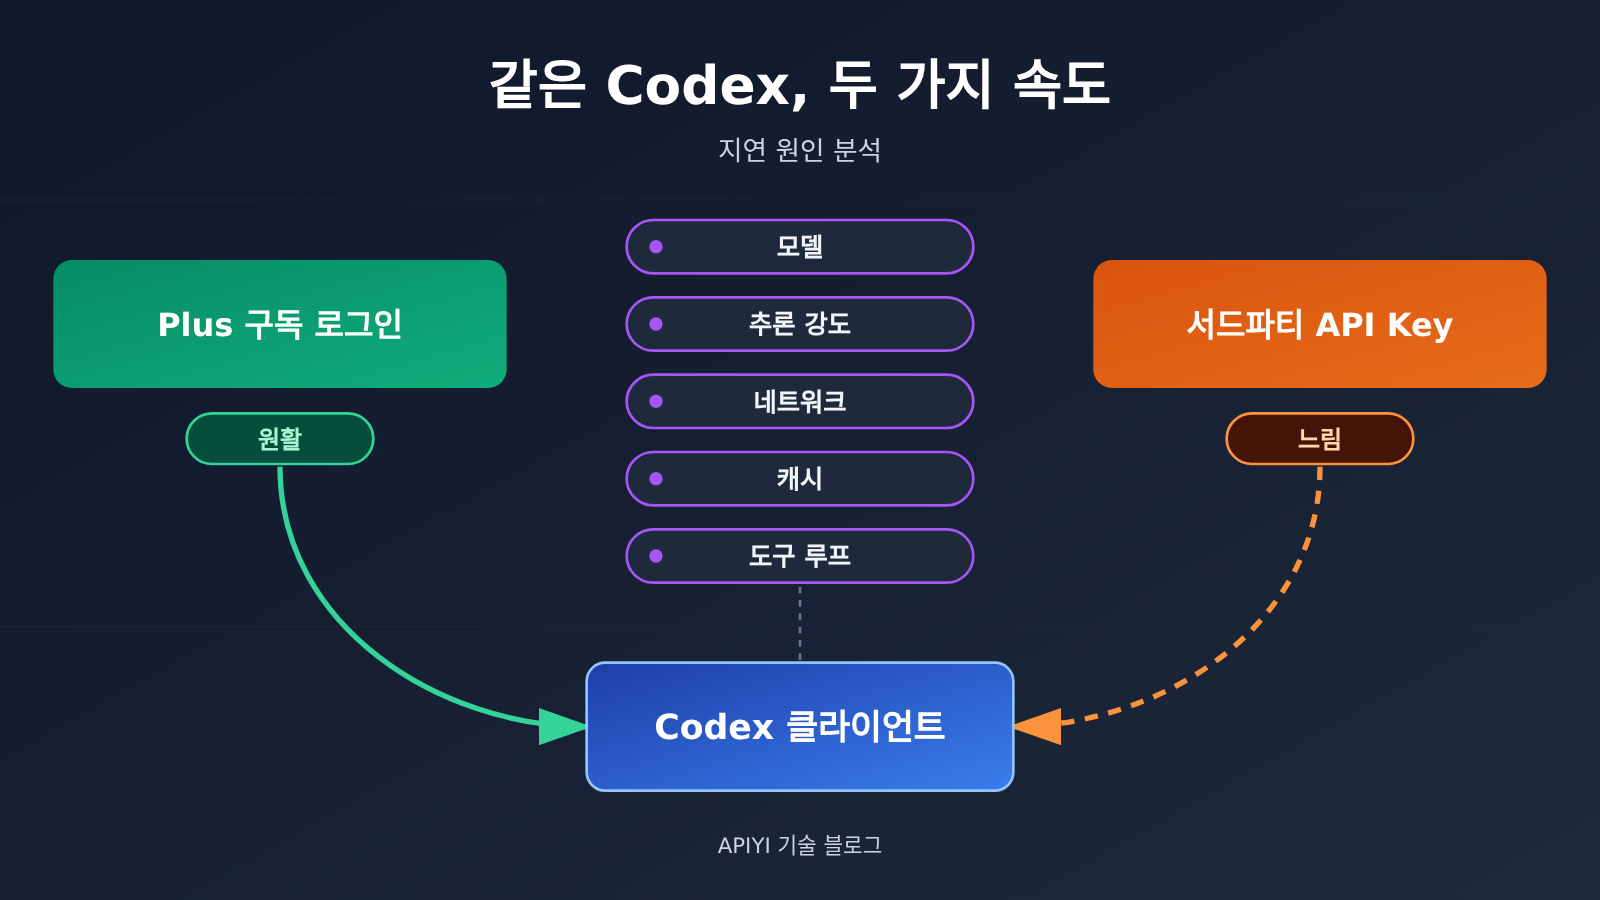
같은 Codex를 ChatGPT Plus로 로그인해 쓸 때는 매끄럽게 동작하다가, 서드파티 API 키로 바꾸면 느려지는 이유는 보통 두 방식이 서로 다른 서비스 경로를 타기 때문이에요. 게다가 Codex의 에이전트 루프는 요청마다 생기는 추가 지연을 매 라운드마다 몇 배로 누적하죠. 클라이언트 화면은 똑같지만 모델 배포, 추론 단계, 전송 프로토콜, 캐시 적중, 도구 이벤트 호환성은 얼마든지 달라질 수 있어요. 요청 한 번에 3초만 더 기다려도, 20번의 직렬 호출이 필요한 코딩 작업이라면 약 1분이 더 걸릴 수 있습니다.
아래에서는 먼저 Codex의 동작 방식과 두 가지 접속 경로를 뜯어보고, 이어서 서드파티 API에서 지연이 생기는 지점을 하나씩 설명할게요. 공개된 GitHub 이슈 두 건도 사례로 함께 살펴봅니다. 그다음에는 핵심 지표 네 가지, 대조 테스트 세 묶음, 증상별 최적화 방안을 제시해서 여러분의 Codex가 모델 때문에 느린지, 네트워크 때문인지, 캐시 때문인지, 아니면 도구 루프 때문인지 판단할 수 있게 도와드릴게요. 마지막으로 서드파티 API를 고를 때 단가보다 실제 비용을 더 잘 보여주는 지표가 무엇인지 이야기하겠습니다.
To Know: Codex 속도 차이를 이해하는 용어
| 용어 | 설명 |
|---|---|
| Codex 하네스 | Codex의 실행 프레임워크로, 모델·도구·컨텍스트·다중 턴 작업 루프를 조직하는 역할을 해요. |
| Responses API | OpenAI가 제공하는 인터페이스로, 모델 출력·도구 호출·다중 턴 상태 관리를 지원하며 Codex가 이것에 의존해 동작해요. |
| TTFT | Time To First Token, 요청을 보낸 뒤 첫 번째 출력 토큰을 받을 때까지의 대기 시간이에요. |
| TPS | Tokens Per Second, 초당 생성되는 토큰 수로 지속적인 출력 속도를 보여줘요. |
| 엔드투엔드 소요 시간 | 작업을 제출한 시점부터 최종 완료까지의 총 시간으로, 모든 모델 호출과 도구 실행을 포함해요. |
| 추론 강도 | 모델이 얼마나 깊이 생각할지를 정하는 단계로, low·medium·high 등이 있으며 단계가 높을수록 보통 출력이 많아지고 시간이 더 걸려요. |
| 도구 호출(Tool Calling) | 모델이 외부 프로그램에 파일 읽기나 명령 실행 등을 요청하고, 그 결과를 받아 추론을 이어가는 과정이에요. |
| 프롬프트 캐싱(Prompt Caching) | 입력 접두사가 반복되고 조건에 맞을 때 기존 계산 결과를 재사용해 처리 시간을 줄이는 방식이에요. |
| SSE | Server-Sent Events, 서버가 단방향 HTTP 연결을 통해 이벤트를 계속 밀어 보내는 방식이에요. |
| WebSocket | 지속적인 양방향 연결로, 여러 턴의 요청이 같은 연결을 재사용할 수 있어요. |
| previous_response_id | Responses API에서 이전 턴의 응답을 참조하는 파라미터로, 증분 입력과 함께 쓰면 중복 전송을 줄일 수 있어요. |
| 서비스 등급 | 같은 모델에서 제공되는 서로 다른 처리 옵션으로, Standard·Fast 등이 있으며 속도와 가격이 각기 달라요. |
1 왜 같은 Codex가 두 가지 속도를 보일까?
1.1 Codex 구독 로그인과 API 키는 서로 다른 서비스 경로를 이용해요
OpenAI의 인증 문서에 따르면 Codex CLI, IDE 확장, 데스크톱 앱은 모두 두 가지 로그인 방식을 지원해요. ChatGPT 계정 로그인, 또는 API 키 입력이에요. ChatGPT 로그인은 구독에 딸린 Codex 사용 권한과 그에 해당하는 한도를 소모하고, API 키는 API 계정의 사용량 기반 과금과 요청 제한 규칙을 따라요. Plus 구독 자체에도 임의의 OpenAI API를 무료로 호출할 수 있는 권리는 포함되지 않아요.
서드파티 API 키를 연결할 때 Codex 클라이언트는 작업을 구성하는 역할만 하고, 실제 추론은 그 인터페이스 뒤의 서비스에서 일어나요. 실제로 호출되는 모델, 과금 방식, 스트리밍 프로토콜, 서비스 품질은 모두 서드파티 인터페이스와 그 백엔드 구현이 결정해요. 그래서 클라이언트에 표시되는 모델 이름이 같다는 건 같은 이름을 골랐다는 것뿐이고, 두 요청이 동일한 모델 배포와 서비스 큐, 전송 경로를 거쳤다는 사실을 확인해 주지는 않아요.
1.2 Codex의 에이전트 루프는 모델을 반복 호출할 수밖에 없게 만들어요
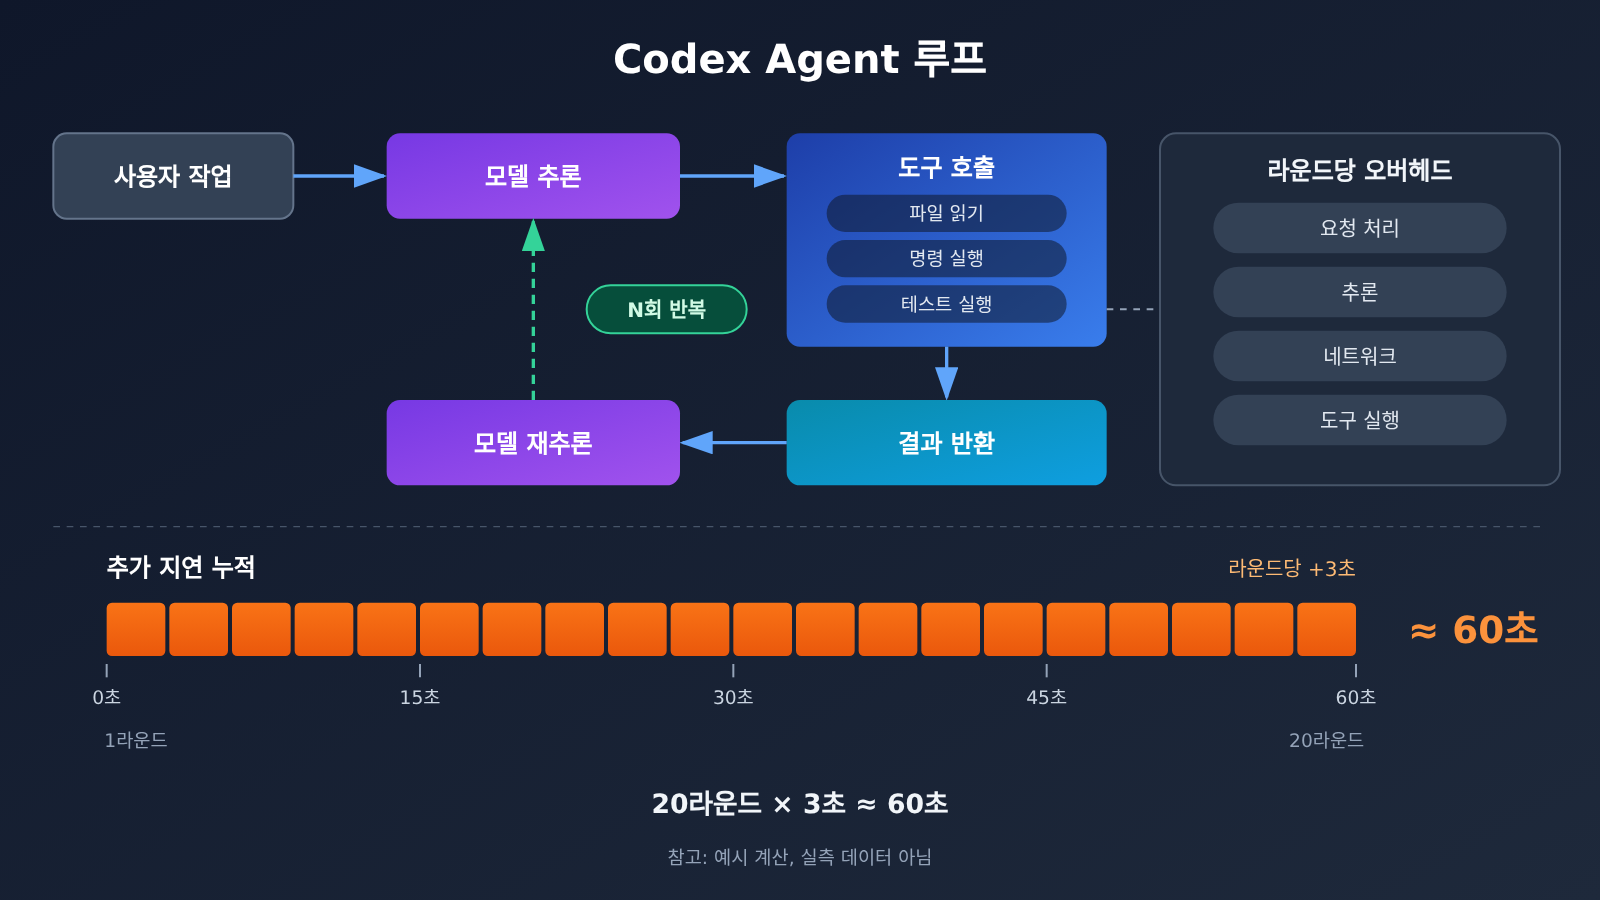
OpenAI가 2026년 8월 19일 발표한 “Codex as a platform”에서 설명하듯, Codex의 오픈소스 Agent Harness는 작업을 이해하고, 컨텍스트를 유지하고, 코드베이스를 검색하고, 셸을 호출하고, 파일을 편집하고, 테스트를 실행하며, 실패 복구와 사용자 승인, 실행 경계까지 처리해요. 본질적으로는 “모델 추론 → 도구 실행 → 다시 추론”으로 이어지는 루프 시스템이에요.
OpenAI는 2026년 4월 22일 엔지니어링 글에서 전형적인 흐름을 설명했어요. 사용자가 수정 작업을 제시하면 모델이 무엇을 해야 할지 판단하고, Codex가 파일을 읽거나 명령을 실행하고, 도구가 결과를 돌려주면 모델이 다시 분석한 뒤 계속 도구를 호출하고 코드를 수정하고 테스트를 실행하며 결과를 확인해요. 복잡한 작업은 모델과 도구 사이의 수십 번 왕복을 포함할 수 있고, 매 라운드가 곧 완전한 API 요청 한 번이에요.
2 Codex에서 서드파티 API를 연결할 때 속도 차이는 어디서 오나요?
먼저 다섯 가지 지연 원인을 표로 정리하고, 이어서 하나씩 살펴볼게요.
| 지연 원인 | 주로 영향을 주는 지표 | 전형적인 증상 | 점검 우선순위 |
|---|---|---|---|
| 모델 및 추론 강도 | TPS, 단일 추론 시간 | 출력이 계속 느리고 사고 시간이 김 | 높음 |
| 서비스 티어 및 라우팅 | TTFT, 변동 폭 | 첫 응답이 느리거나 빠르고 느림이 반복됨 | 높음 |
| 게이트웨이 및 네트워크 경로 | 라운드당 고정 추가 시간 | 호출할 때마다 안정적으로 몇 초가 더 붙음 | 중간 |
| 전송 프로토콜(SSE / WebSocket) | 다중 라운드 누적 오버헤드, 연결 안정성 | 장기 작업이 느리고 중간에 끊김 | 중간 |
| 캐시 및 도구 루프 | 입력 처리 시간, 호출 라운드 | 긴 대화에서 눈에 띄게 느려지고 라운드가 너무 많음 | 높음 |
2.1 모델 추론 속도와 추론 강도가 Codex 소요 시간에 미치는 영향
두 접속 방식을 비교하기 전에 실제 모델 ID, 추론 강도, 모델 버전, 서비스 티어가 일치하는지 먼저 확인해야 해요. 추론 강도가 low에서 xhigh, max로 올라갈수록 모델이 생성하는 사고 내용이 많아지고 단일 라운드 소요 시간이 길어져요.
OpenAI의 지연 최적화 가이드에서는 출력 토큰 수를 추론 소요 시간에 영향을 주는 핵심 변수로 꼽아요. 일부 시나리오에서는 출력 토큰이 약 50% 줄어들면 생성 지연도 거의 50% 가까이 감소할 수 있지만, 일반 입력 텍스트를 줄여서 얻는 효과는 보통 훨씬 작아요. 서비스 티어도 마찬가지로 중요해요. OpenAI의 Fast 모드는 해당 모델과 부하에서 최대 2.5배 속도를 낼 수 있지만, 유료 티어 선택지이고 일부 모델에만 적용돼요.
즉, 구독 쪽과 서드파티 쪽이 같은 모델을 표시하더라도 추론 티어나 서비스 티어가 다르면 속도 차이가 뚜렷하게 나타날 수밖에 없어요.
2.2 API 중계, 네트워크 경로, WebSocket이 다중 턴 작업에 미치는 영향
서드파티 API의 요청 경로는 보통 더 길어요. 클라이언트 → 서비스 제공자 게이트웨이 → 프록시 노드 → 국경을 넘는 경로가 있을 수 있음 → 최종 추론 서비스 순으로 이어지죠. 홉이 하나 늘어날 때마다 고정 지연과 네트워크 지터가 조금씩 더해질 수 있고, 이런 지연은 Agent 루프에서 턴마다 누적돼요.
전송 프로토콜도 또 다른 변수예요. 기존 Responses API는 대부분 HTTP/SSE로 전송하며, 매 턴 요청을 다시 맺고 컨텍스트를 함께 보내야 해요. WebSocket 모드는 영구 연결을 유지하고 previous_response_id와 증분 입력을 활용해 반복 전송과 처리를 줄여요. OpenAI가 공식 발표한 데이터는 다음과 같아요.
- 2025년 말 한 차례 API 최적화로 첫 토큰 지연이 거의 45% 개선됐어요.
- 도구 호출이 20회 이상 발생하는 특정 워크플로에서 WebSocket 모드는 최대 약 40%의 엔드투엔드 속도 향상을 가져왔어요.
- Vercel 관련 통합 보고서는 최대 약 40%의 지연 개선을, Cline의 다중 파일 워크플로는 약 39%의 속도 향상을, Cursor의 OpenAI 모델은 최대 약 30%의 개선을 보고했어요.
이 수치는 서로 다른 제품과 테스트 시나리오에서 나온 것이며, 특정 워크플로에서의 최대치예요. 일부 호환 게이트웨이는 HTTP/SSE만 구현했거나 Codex가 사용하는 WebSocket과 증분 상태 관리를 완전히 지원하지 않아요. 이런 연동 방식에서는 이 같은 이점을 얻을 수 없어요.
2.3 Codex의 컨텍스트 캐시와 도구 호출 횟수
긴 작업에서는 이전 메시지, 도구 정의, 반복되는 컨텍스트가 많은 입력 토큰을 차지해요. 프롬프트 캐시가 적중하면 이 접두사 부분의 처리 시간을 줄일 수 있어요. OpenAI 문서에 따르면 GPT-5.6 및 이후 시리즈는 새로운 캐시 쓰기, 읽기, TTL 제어를 지원해요.
문제는 캐시가 요청 접두사의 안정성에 의존한다는 점이에요. 중계 계층이 요청 접두사를 다시 쓰거나 도구 정의 순서를 조정하거나 캐시 경계를 바꾸면 캐시 재사용에 영향을 줄 수 있고, 그 결과 매 라운드마다 대량의 컨텍스트를 다시 처리하게 돼요. 도구 호출 횟수는 요청 라운드 수를 직접 결정해요. 라운드가 많을수록 모든 단일 라운드 오버헤드가 증폭되는 배수도 커져요.
2.4 Codex의 첫 응답은 정상인데, 이후에도 여전히 느린 이유는?
이건 제목에 나온 문제가 가장 흔하게 나타나는 형태예요. TTFT는 첫 토큰이 얼마나 빨리 오는지만 측정하고, Codex 작업의 총 소요 시간은 모든 라운드가 누적된 값이에요. 총 소요 시간은 이렇게 표현할 수 있어요:
T_total = Σ(API 요청 처리 시간 + 모델 추론 시간 + 네트워크 전송 시간 + 로컬 도구 실행 시간 + 대기 및 재시도 시간)
첫 응답은 정상인데 전체적으로 느린 경우는 보통 다음과 같은 상황에서 비롯돼요. 지속 출력 속도(TPS)가 낮아서 긴 응답이 매 라운드를 느리게 만들고, 도구 실행이 끝난 뒤 모델이 다시 추론하는데 재추론할 때마다 컨텍스트를 다시 처리해야 하며, 스트리밍 연결이 도중에 끊기거나 타임아웃이 나서 클라이언트가 재시도를 트리거하면 사용자 입장에서는 “모델이 멈춘” 것처럼 보여요. 메커니즘을 기준으로 계산해 보면, 20번의 직렬 모델 호출이 필요한 작업에서 매번 3초씩 더 기다리면 총 소요 시간이 약 60초 늘어나요. 이 숫자는 누적 효과를 설명하기 위한 것이며 실제 측정 결과는 아니에요.
3 공개 사례는 Codex가 느린 문제에 어떤 증거를 제공할까요?
아래 두 사례는 openai/codex 저장소의 사용자 보고에서 나온 것으로, 단일 사용자의 개별 로그예요. 메커니즘을 설명하기 위해 인용한 것이며 업계 전반의 일반적인 수준을 뜻하지는 않아요.
3.1 Issue #60831: 같은 세션에서 약 7배의 응답 시간 편차
2026년 11월에 제출된 Issue #60831에서 보고자는 같은 세션, 같은 클라이언트 프로세스, 동일한 추론 설정에서 두 번의 요청을 관찰했어요. 압축된 요청 본문은 모두 약 13.09 MB였고, 중간에 컨텍스트 압축이 일어나지 않았으며 이미지 히스토리도 변하지 않았어요. 느린 요청은 요청 압축 완료부터 HTTP 응답 헤더를 받을 때까지 109.317초가 걸렸고, 빠른 요청은 15.637초였으며 비율은 약 6.99배였어요.
측정 기준을 짚고 넘어가야 해요. 이 두 숫자는 “응답 헤더를 받을 때까지”의 시간, 즉 서비스 처리 단계를 재는 것이지 전체 작업 완료 시간이 아니에요. 두 요청 모두 같은 경로에서 나온 것이므로 구독과 서드파티를 비교한 것과는 무관해요. 이 사례가 보여주는 건 컨텍스트 크기가 변하지 않아도 서버 처리 시간 자체가 크게 흔들릴 수 있다는 점이에요. 다만 보고서만으로는 구체적으로 어느 서비스 단계가 병목을 일으켰는지 확정할 수 없어요.
3.2 Issue #44305: 도구 루프 때문에 단순 읽기 작업의 소요 시간이 급증
2026년 9월의 Issue #44305에서 보고자는 같은 종류의 읽기 전용 작업을 비교했어요. 다른 Agent는 병렬 읽기 3회로 약 10.6초 만에 끝냈지만, Codex는 91.5초를 실행한 뒤 타임아웃되었고 완전한 답변도 내놓지 못했어요. 그동안 Codex는 모델 추론을 약 11회, 도구 호출을 11회 수행했고 누적 입력은 약 295,042 tokens였으며 그중 캐시 입력이 약 260,608 tokens였어요.
이 숫자로 계산하면 캐시 입력 비중이 약 88.3%로 캐시 적중률은 좋은 편이었어요. 그런데도 11라운드에 걸친 직렬 루프 때문에 병렬 읽기 방식보다 소요 시간이 훨씬 길어졌어요. 두 Agent의 작업 전략 자체가 달라서 시간 차이를 전부 Codex나 모델 탓으로 돌릴 수는 없지만, 호출 횟수와 직렬 실행이 총 소요 시간을 얼마나 증폭시키는지는 분명하게 보여줘요.
여기에 서드파티 연동과 직접 관련된 문제도 두 가지 있어요. Issue #33029는 Codex Desktop이 서드파티 호환 인터페이스를 사용할 때 모델 엔드포인트는 정상 동작하는데도 데스크톱 앱이 일부 ChatGPT 보조 서비스를 계속 요청하고, 이 요청들이 타임아웃되면서 앱 응답이 느려진다고 보고했어요. Issue #41340과 #42471은 각각 서드파티 Responses 엔드포인트에서 “stream disconnected before completion”이 발생했고, 도구 호출 이벤트는 수신되지만 실행 흐름에는 들어가지 못했다고 보고했어요. 단순 채팅이 돌아가는 것과 완전한 Codex 도구 루프가 돌아가는 것은 호환성 요구 수준이 전혀 다른 문제예요.
4 내 Codex가 어디서 느린지 어떻게 찾을까요?
4.1 네 가지 핵심 지표로 Codex 병목 찾기
| 지표 | 기록 방식 | 보여주는 문제 |
|---|---|---|
| TTFT | 각 요청의 첫 유효 출력까지의 대기 시간 | 큐, 모델 시작, 네트워크 첫 패킷 |
| 엔드투엔드 소요 시간 | 작업 제출부터 완료까지의 총 시간 | 전체 경험, 최종 판단 기준 |
| 모델/도구 호출 횟수 | 추론 라운드, 도구 호출 횟수 및 도구 실행 시간을 집계 | Agent 전략과 직렬 증폭 |
| 캐시 적중 | 총 입력, 캐시 읽기, 캐시 쓰기, 출력 토큰 | 컨텍스트 반복 처리 오버헤드 |
이 네 가지 외에도 TPS, 단일 요청의 입력·출력 토큰, 사용하는 프로토콜(WebSocket 또는 SSE), 429, 5xx, 타임아웃, 재시도 횟수를 함께 기록하는 것이 좋아요. 이런 보조 데이터를 활용하면 “느린 것”과 “오류 후 재시도 때문에 느린 것”을 구분할 수 있어요.
4.2 세 그룹 Codex 대조 테스트 실행 단계
대조 테스트의 전제는 변수 통제예요. 모델 ID, 추론 강도, Codex 버전, 프로젝트 파일, 작업 설명을 동일하게 유지하고, 새 세션과 긴 세션 두 시나리오에서 각각 한 번씩 실행해 컨텍스트 길이의 영향을 확인합니다.
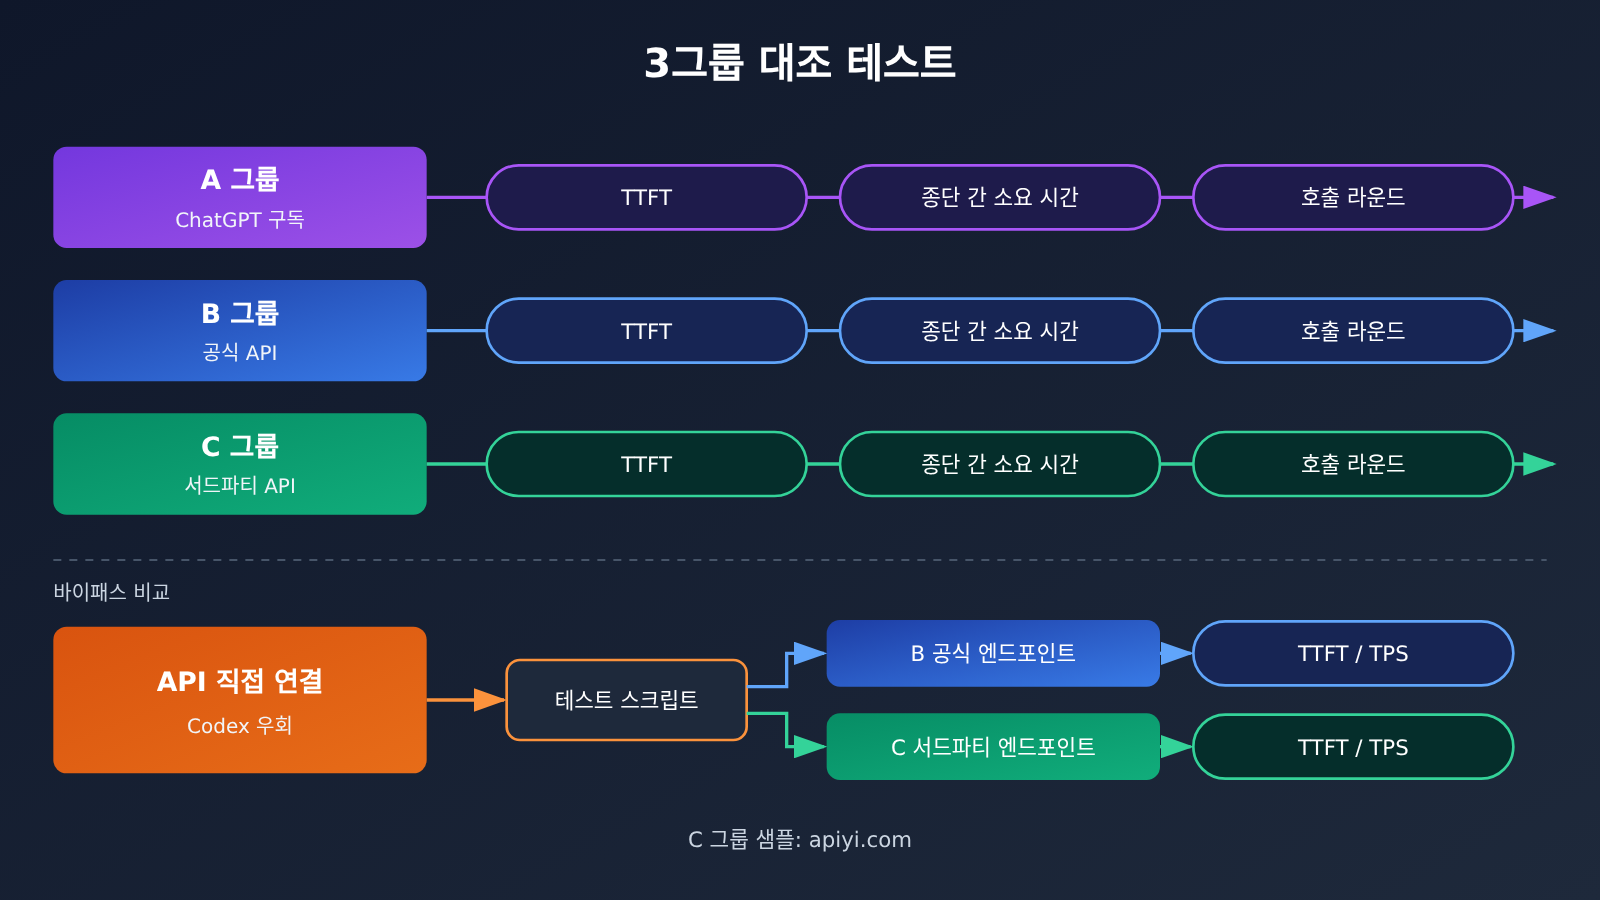
- A 그룹: ChatGPT 구독으로 Codex에 로그인해 표준 작업을 수행하고, 엔드투엔드 소요 시간과 호출 라운드를 기록합니다.
- B 그룹: 동일 모델의 공식 API 키로 Codex에 연결해 같은 작업을 수행합니다.
- C 그룹: 서드파티 호환 API로 Codex에 연결해 같은 작업을 수행합니다.
- 직접 연결 그룹: B, C 두 경로에 대해 Codex를 우회하고 스크립트로 동일한 단일 요청을 보내 TTFT와 TPS를 측정합니다.
A와 B의 차이는 주로 구독 경로와 API 경로의 서비스 차이를 반영하고, B와 C의 차이는 게이트웨이, 라우팅, 추론 서비스의 차이를 반영합니다. 직접 연결 결과와 Codex 내부 결과의 격차는 에이전트 루프, 프로토콜 호환성, 클라이언트에서 발생하는 추가 오버헤드를 보여줘요. 각 그룹은 여러 번 반복해 중앙값을 취하는 것이 좋습니다. 한 번의 우연한 변동을 결론으로 삼지 않도록 해요.
다음 스크립트는 “직접 연결 그룹” 테스트에 사용하며, 스트리밍 Responses 요청으로 TTFT, 총 소요 시간, 출력 토큰, TPS를 측정합니다.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 공식 주소로 바꾸면 B 그룹 대조 가능
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Codex에서 사용하는 모델 ID와 동일하게 유지
    reasoning={"effort": "medium"},   # Codex의 추론 강도와 동일하게 유지
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
다중 반복 테스트와 캐시 통계 전체 스크립트 보기
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # APIYI 인터페이스
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# 길이가 긴 고정 접두사로 Codex의 시스템 프롬프트와 도구 정의를 모사해 캐시 적중을 관찰하기 쉽게 함
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Codex 안에서 C 그룹 테스트를 진행할 때는 서드파티 엔드포인트를 모델 제공자로 설정해야 해요. 아래는 흔히 쓰는 ~/.codex/config.toml 작성 방식이며, 구체적인 필드 이름은 사용 중인 Codex 버전의 공식 문서를 기준으로 확인하세요:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 빠른 시작: C 그룹 대조 실험을 할 때는 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧을 신청한 다음, 동일한 Key로 여러 모델을 바꿔 가며 위 스크립트를 각각 실행하면 비교 가능한 TTFT와 총 소요 시간 데이터를 빠르게 얻을 수 있어요.
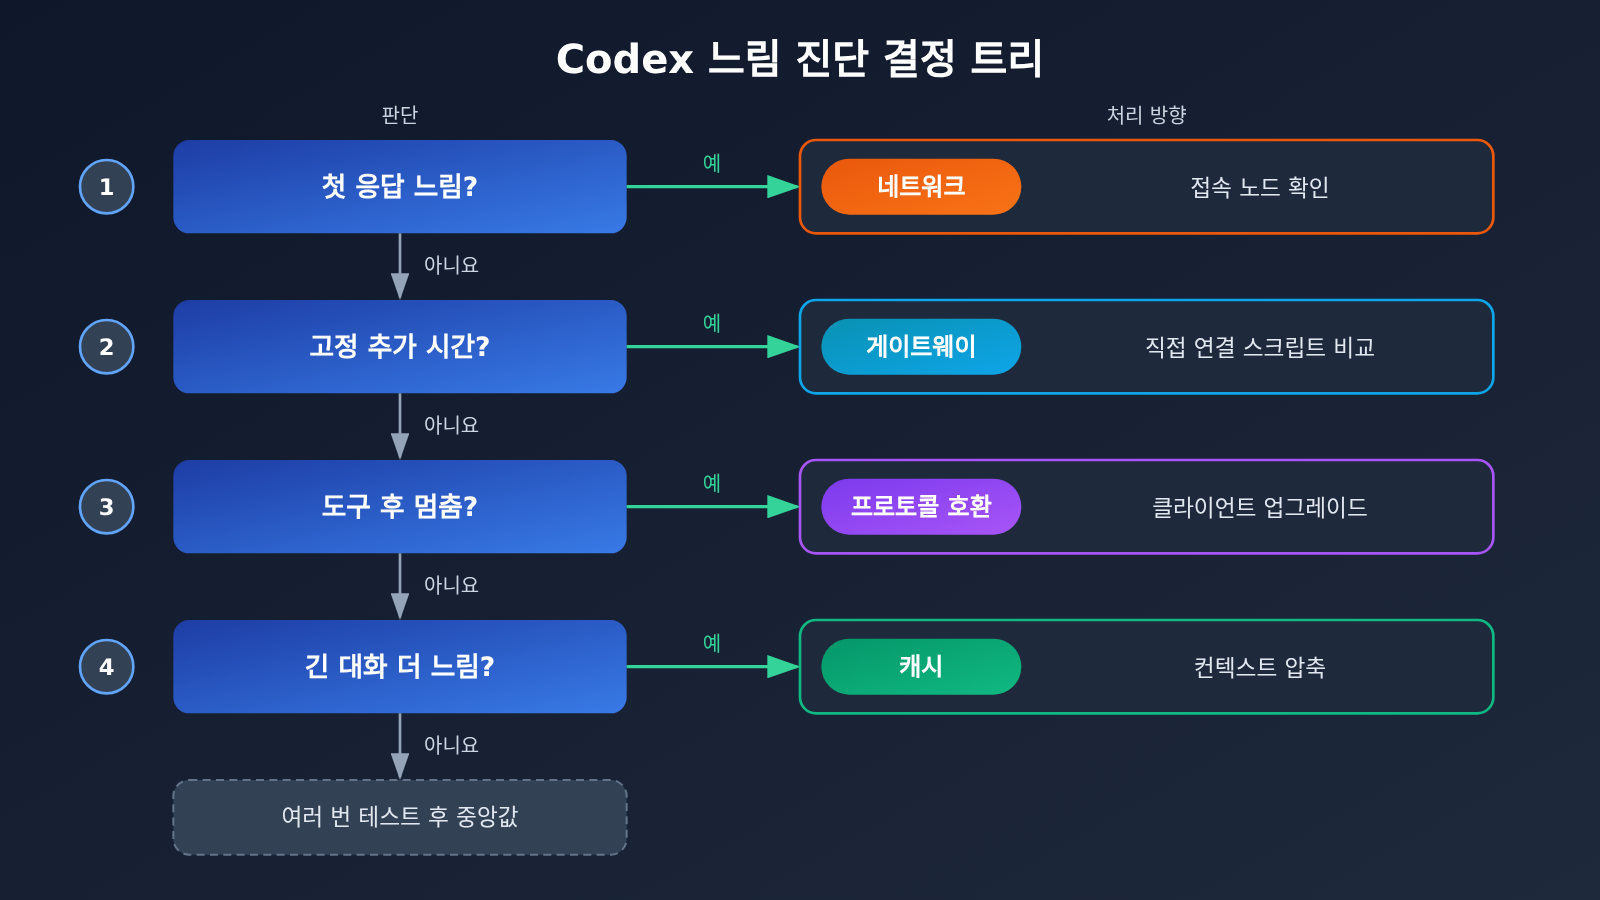
4.3 증상별 Codex 최적화 방안
| 증상 | 우선 확인 항목 | 처리 방법 |
|---|---|---|
| 첫 응답이 느림 | 대기열, 모델 시작, 네트워크 첫 패킷 | 더 가까운 접속 노드로 전환, 서비스 등급 확인, 혼잡 시간대를 피해 비교 |
| 첫 응답은 빠른데 이후가 느림 | TPS, 도구 호출 라운드, 캐시 | 추론 강도 낮추기, 출력 길이 제한, 캐시 적중률 확인 |
| 매 호출마다 일정 시간이 추가됨 | 중계 경로, 부가 요청 | 직접 연결 스크립트로 B·C 그룹을 비교해 게이트웨이 오버헤드 파악 |
| 도구 호출 후 멈춤 | Responses 이벤트, 도구 반환값 | 스트림 끊김 또는 도구 이벤트 누락 여부 확인, 클라이언트 버전 업그레이드 |
| 긴 대화가 새 대화보다 확연히 느림 | 히스토리 토큰, 압축, 캐시 | 적절히 새 세션을 열거나 컨텍스트 압축을 트리거하고 캐시 읽기 변화 관찰 |
| 속도가 들쭉날쭉함 | 서비스 부하, 재시도, 네트워크 변동 | 429/5xx와 타임아웃 횟수를 집계하고 여러 번 테스트해 중앙값 사용 |
| 데스크톱 전체가 버벅이는데 API는 정상 | ChatGPT 보조 서비스 요청 | Issue #33029 참고, 보조 요청 타임아웃 여부 확인, 필요 시 CLI로 전환 |
모델 차원의 최적화는 OpenAI 지연 가이드의 사고방식을 따릅니다. 출력 토큰을 줄이고, 입력 컨텍스트를 줄이고, 호출 횟수를 줄이고, 독립적인 단계는 병렬로 처리하며, 일반 프로그램으로 처리할 수 있는 일은 굳이 모델에 맡기지 않는 거예요. Codex에서는 가장 직접적인 수단이 작업 설명에 더 명확한 범위를 부여해서, Agent가 탐색적인 읽기 라운드를 덜 거치게 만드는 것입니다.
5 Codex용 서드파티 API를 선택할 때, 어떤 지표가 단가보다 더 중요할까요?
5.1 token 단가에서 작업 완료 비용으로
Codex 환경에서 진짜 비용은 “작업 하나를 완료하는 것”에 의해 결정돼요. 단가가 낮은 인터페이스라도 캐시 적중률이 나쁘고, 호출 라운드가 많고, 자주 끊겨 재시도한다면 최종적으로 소모되는 token과 시간은 오히려 더 높아져요. 평가할 때는 다음 항목들을 함께 보는 게 좋아요: 작업 성공률, 엔드투엔드 소요 시간, 단일 작업당 소모되는 총 token(캐시 읽기 포함), 실패와 재시도로 인한 추가 비용.
| 평가 차원 | 관심 포인트 | 테스트 방법 | 사용 가능 플랫폼 |
|---|---|---|---|
| 모델 신원과 버전 | 모델 ID와 버전이 명확하고 안정적으로 사용 가능한지 | 반환되는 모델 필드와 문서 대조 | APIYI apiyi.com, 공식 API |
| 첫 token과 지속 속도 | TTFT, TPS의 중앙값과 변동 | 직접 연결 스크립트 다중 라운드 테스트 | APIYI apiyi.com, 공식 API |
| 다중 라운드 Agent 완료 시간 | Codex 내 실제 작업의 총 소요 시간 | 세 그룹 대조 테스트 | APIYI apiyi.com, 공식 API |
| 프로토콜 호환 | Responses, WebSocket, 도구 이벤트 지원 | 파일 읽기 + 코드 수정 + 테스트 작업을 한 번 완전히 실행 | 서비스 제공사 문서에 따름 |
| 캐시 지원 | 캐시 읽기 token이 정상 반환되는지 | usage의 캐시 필드 통계 | 서비스 제공사 문서에 따름 |
| 안정성과 과금 | 실패율, 동시성, 과금 투명성 | 429/5xx와 청구서 세부 내역 기록 | 서비스 제공사 문서에 따름 |
5.2 실제 작업으로 APIYI 등 서드파티 인터페이스 평가하기
APIYI apiyi.com은 AI 대규모 언어 모델 API 집계 플랫폼으로, 하나의 API 키로 OpenAI, Claude, Gemini 등 주류 모델을 호출할 수 있고, 인터페이스는 OpenAI 프로토콜과 호환되며 사용량 기반 과금을 해요. Codex 환경에서 이 플랫폼의 가치는 주로 손쉬운 횡적 비교에 있는데, 동일한 설정에서 서로 다른 모델과 티어를 전환하기만 하면 여러분의 프로젝트에서 비교 가능한 데이터를 뽑아낼 수 있어요.
서로 다른 서드파티 서비스 제공사는 연결 경로, 프로토콜 지원, 안정성이 각기 다르기 때문에, 평가할 때는 구체적인 테스트 데이터와 서비스 약관을 근거로 삼아야 해요. 대표적인 작업 2~3개(예를 들어 한 번의 다중 파일 리팩터링, 한 번의 테스트 포함 버그 수정)를 골라 4절의 방법에 따라 각 연동 방식에서 각각 실행하고, 성공률과 총 token을 종합해 결정하는 것이 좋아요.
💡 선택 제안: 먼저 직접 연결 스크립트로 TTFT와 TPS가 눈에 띄게 벗어나는 옵션을 걸러낸 뒤, 남은 후보를 Codex에 넣어 전체 작업을 실행하세요. APIYI apiyi.com의 통합 인터페이스를 통해 코드 구조를 바꾸지 않고도 여러 모델을 비교할 수 있어요.
자주 묻는 질문 (FAQ)
Q1: Codex 구독과 서드파티 API의 속도 차이는 주로 어디에서 발생하나요?
서비스 경로 전반의 차이에서 발생해요. 실제 모델 배포, 추론 강도, 서비스 등급, 게이트웨이 연결 경로, 전송 프로토콜, 캐시 적중률, 도구 이벤트 호환 정도가 모두 영향을 줘요. Codex의 멀티턴 Agent 루프는 이런 단일 턴 차이를 턴마다 누적하기 때문에, 총 소요 시간의 차이는 단일 요청 차이보다 훨씬 크게 벌어지는 경우가 많아요.
Q2: TTFT는 정상인데 왜 Codex 작업은 여전히 느린가요?
TTFT는 첫 번째 토큰의 대기 시간만 측정해요. Codex의 한 작업에는 여러 턴의 추론과 도구 호출이 포함되며, 지속적인 출력 속도, 도구 실행 후 재추론, 캐시 미적중, 중간 재시도가 모두 총 시간을 늘려요. 체감 성능을 판단할 때는 엔드투엔드 소요 시간과 호출 턴 수를 함께 봐야 해요.
Q3: WebSocket 모드를 쓰면 Codex가 얼마나 빨라지나요?
OpenAI가 공개한 수치에 따르면, 도구 호출이 20회 이상인 특정 워크플로에서는 엔드투엔드 속도가 최대 약 40%까지 향상돼요. 이는 특정 시나리오에서의 상한값이며, 실제 이득은 작업 턴 수와 인터페이스가 WebSocket 및 증분 상태 관리를 완전히 지원하는지에 따라 달라져요.
Q4: 긴 대화에서 Codex가 점점 느려지는데 어떻게 처리해야 하나요?
먼저 매 턴의 총 입력 토큰 수와 캐시 읽기 토큰 수를 기록해 캐시가 정상적으로 적중하는지 확인해 보세요. 히스토리 컨텍스트가 너무 길다면 새로운 세션을 시작하거나 컨텍스트 압축을 트리거할 수 있어요. 동시에 작업 범위를 좁혀 탐색성 파일 읽기 턴 수를 줄이는 것도 좋아요.
Q5: 서드파티 API가 Codex에서 실제로 어떤 성능을 내는지 빠르게 측정하려면 어떻게 해야 하나요?
1. APIYI apiyi.com에서 가입하고 API 키와 무료 테스트 크레딧을 받으세요;
2. 이 글에 있는 직결 스크립트로 TTFT, TPS, 캐시 적중률을 측정하세요;
3. 4.2절에 따라 Codex를 구성하고, 구독 측과 동일한 작업을 실행해 엔드투엔드 소요 시간과 호출 턴 수를 비교하세요.
이렇게 하면 추론 서비스 차이와 Agent 루프에서 오는 차이를 구분해서 볼 수 있어요.
Q6: 공개 이슈에 있는 데이터가 Codex의 일반적인 성능을 대표할 수 있나요?
그대로 대표한다고 보기는 어려워요. 이슈 #60831과 #44305는 모두 단일 사용자의 로그로, 전자는 HTTP 응답 헤더까지의 시간을 측정한 것이고 후자는 한 번 타임아웃된 읽기 전용 작업이에요. 이들의 가치는 서버 측 변동성과 직렬 도구 루프가 소요 시간에 어떻게 영향을 미치는지를 보여준다는 데 있으며, 구체적인 결론은 직접 본인의 작업으로 테스트해 검증해야 해요.
Codex 속도 차이 핵심 요점(Key Takeaways)
- 경로가 달라요: 구독 로그인과 API 키는 서로 다른 과금 및 서비스 경로를 사용해요. 모델명이 같다고 해서 배포 환경까지 같다는 뜻은 아니에요.
- 루프 증폭: Codex의 Agent 루프는 매 라운드의 작은 지연을 누적해 총 소요 시간 차이를 크게 만들어요.
- 지표 계층화: TTFT는 첫 응답을 보고, 엔드투엔드 소요 시간과 호출 라운드 수가 실제 경험을 반영해요.
- 프로토콜 영향: WebSocket은 다중 툴 호출 시나리오에서 최대 약 40% 속도 향상을 기대할 수 있지만, 인터페이스의 완전한 지원이 필요해요.
- 캐시 확인: 중계 계층이 요청 프리픽스를 바꾸면 캐시에 영향을 줄 수 있으니 캐시 읽기 토큰을 집계해야 해요.
- 대조 테스트: 구독, 공식 API, 서드파티 API 세 그룹에서 같은 작업으로 비교하고, 직결 테스트를 추가해 병목을 찾아요.
- 작업별 선택: 실제 작업으로 APIYI(apiyi.com) 등 플랫폼에서 횡적 테스트를 하고, 단가가 아니라 작업 완료 비용을 보세요.
요약
같은 Codex에서 두 가지 속도가 나타나는 근본 원인은 서비스 경로와 Agent 루프의 중첩 효과예요:
- 메커니즘 측면: 모델, 추론 강도, 서비스 티어, 게이트웨이, 프로토콜, 캐시, 툴 루프가 함께 총 소요 시간을 결정하며, 단일 라운드의 차이는 다중 호출에서 증폭돼요.
- 증거 측면: 공식 데이터는 프로토콜과 티어 최적화가 상당한 속도 향상을 가져올 수 있음을 보여주고, 사용자 로그는 서버 측 변동과 직렬 루프가 작업을 눈에 띄게 늘린다는 것을 보여줘요.
- 방법 측면: 네 가지 핵심 지표를 기록하고, 세 그룹 비교와 직결 테스트를 한 뒤 증상별로 하나씩 최적화해요.
문제를 찾을 때는 먼저 모델과 추론 강도를 고정한 다음 데이터로 말하게 하세요. 여러 모델과 접속 방식 사이에서 비교해야 한다면 APIYI의 통합 인터페이스를 활용해 테스트 비용을 최소화할 수 있어요.
📚 참고 자료
- Codex as a platform: build on the open agent harness: OpenAI가 Codex Agent Harness의 역할을 소개
- 링크:
developers.openai.com/blog/codex-as-a-platform -
설명: Codex의 멀티턴 모델과 도구 루프를 이해하기 위한 공식 근거
-
Codex 인증 문서: ChatGPT 로그인과 API 키, 두 가지 접속 방식
- 링크:
learn.chatgpt.com/docs/auth?surface=cli -
설명: 구독 혜택과 API 과금, 속도 제한 규칙의 구분
-
Responses API에서 WebSocket으로 에이전트 워크플로 가속하기: OpenAI 엔지니어링 아티클
- 링크:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
설명: 에이전트 루프 흐름과 WebSocket 속도 향상 데이터
-
WebSocket 모드 문서: Responses API의 WebSocket 모드
- 링크:
developers.openai.com/api/docs/guides/websocket-mode -
설명: 지속 연결, 증분 입력과 적용 시나리오
-
Latency optimization 가이드: OpenAI 지연 최적화 원칙
- 링크:
developers.openai.com/api/docs/guides/latency-optimization -
설명: 출력 토큰, 호출 횟수, 병렬화 등 최적화 아이디어
-
Fast mode 문서: 서비스 등급과 가속 범위
- 링크:
developers.openai.com/api/docs/guides/fast-mode -
설명: 속도를 비교할 때 통제해야 하는 서비스 등급 변수
-
Prompt caching 문서: 캐시 쓰기, 읽기와 TTL
- 링크:
developers.openai.com/api/docs/guides/prompt-caching -
설명: 긴 대화의 캐시 적중 통계와 최적화
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: 사용자가 보고한 지연 및 호환성 문제
- 링크:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - 설명: 서버 측 변동, 도구 루프 증폭, 데스크톱 클라이언트 보조 요청, 서드파티 프로토콜 호환 사례 로그
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 사이트 홈페이지에서 저희에게 연락해 Codex 연동과 성능 테스트 경험을 나눠 주시면 좋겠습니다. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.


