
著者注:本記事は、Claude Fable 5.2 のマルチエージェントがブラックホール物理の2問を解き終えた公式研究記事をもとに、高負荷エージェントタスクにおけるモデル選択・役割分割・停止ライン設定について、実践可能な方法を整理したものです。
2026年11月17日、Anthropic は研究記事を公開しました:Claude Fable 5.2 の複数のコピーがバックグラウンドで約6週間稼働し、ブラックホール物理の2問を解き終えました。長時間タスクやマルチエージェントを動かす開発者にとって、この件で注目すべき点は物理学そのものではなく、長時間にわたる複数経路の並列実行と相互検証という働き方を示していることです。
これは物理学の解説記事ではありません。どのAPIエンドポイントがより安定しているかを判断するものでもありません。本記事が行うことは1つだけです。研究記事から学べるエンジニアリング上のシグナルを、あなたが高負荷エージェントタスクを実行するときにそのまま実践できる手順へと変換します。
本記事のコアバリュー:本記事を読むと、メイン推論と検証を別々の役割に分割する方法、各エージェント経路に停止ラインを明記する方法、そして価格が明示されているモデルの中からのみモデルを選ぶ方法がわかります。これにより、長時間タスクのコストを予測可能にし、上限を設定できます。
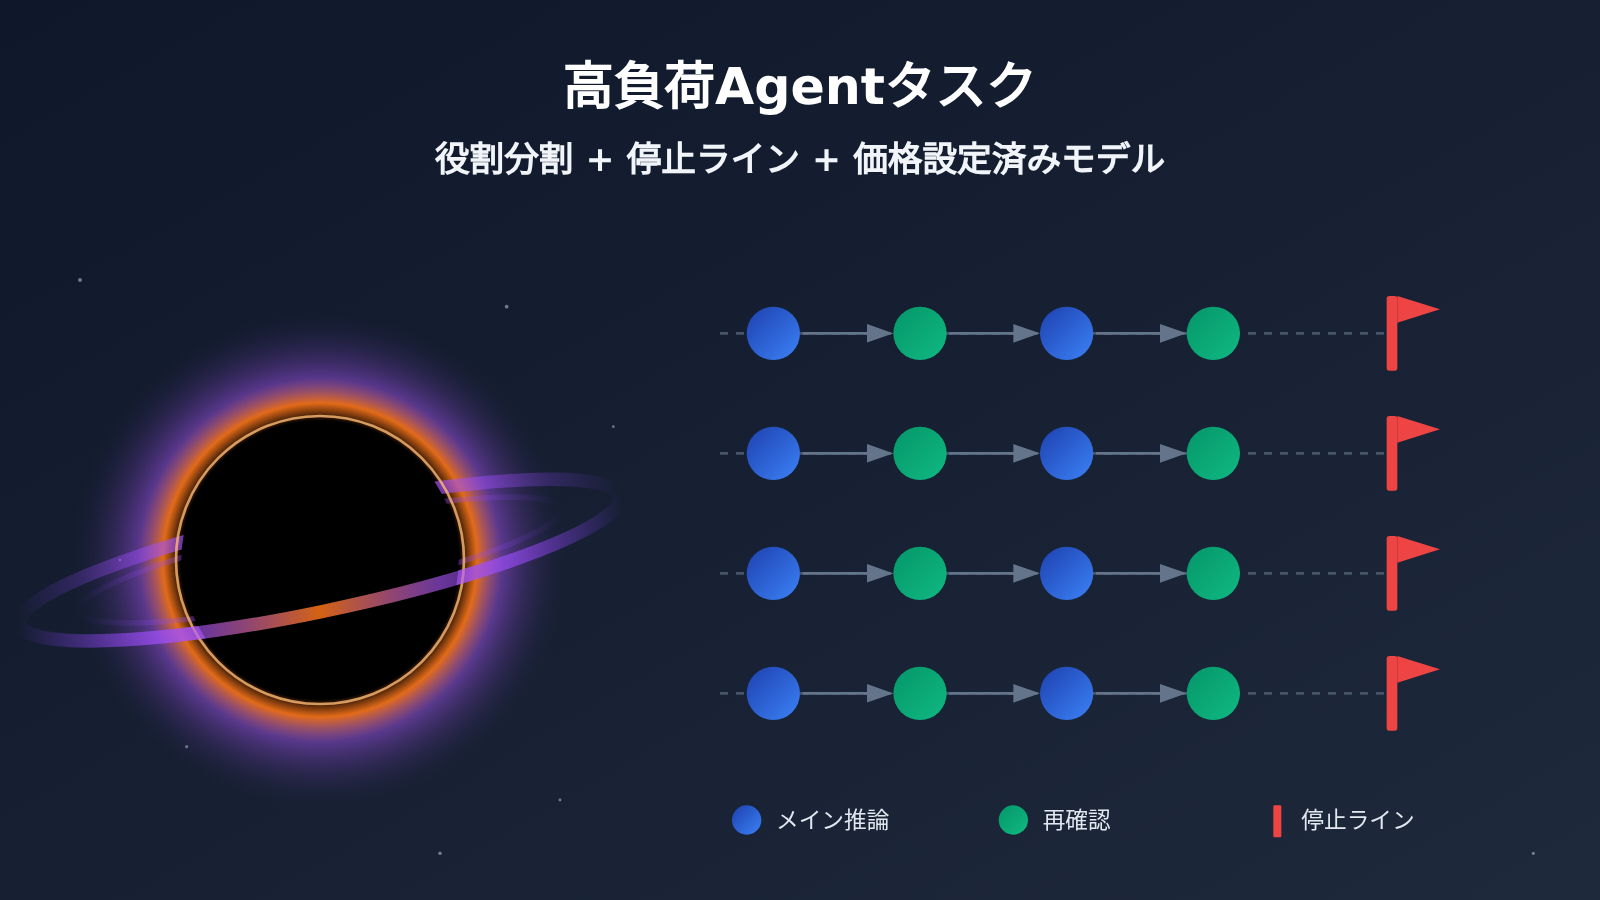
Claude Fable 5.2 の研究投稿から見るヘビーなAgentタスクの核心ポイント
まずは経緯をはっきりさせておきましょう。この研究投稿はAnthropicによる公式の説明で、言及されている2本の論文は現在プレプリントであり、査読を経た論文ではありません。2つの問題はいずれも理論物理学に属し、私たちが住む宇宙を記述したものではなく、実用的な用途もありません。したがってその意義は主に「方法」にあり、「結論がどれほど重要か」にはないのです。
投稿によると、2026年8月に研究者のHongbin ChenがClaudeにブラックホールとbootstrap方向の未解決問題を列挙させたところ、数時間後に22問を得たといいます。彼は各問題に個別のエージェントを割り当て、エージェント同士は互いの進捗を読めるようにし、その後バックグラウンドで約6週間実行しました。投稿の原文は「特別な設定はしていない」ですが、これは公式による構築方法の説明であり、ゼロコストを意味するわけではありません。投稿にはコストの内訳も示されていません。
| 研究投稿の事実 | ヘビーなAgentタスクへの示唆 | 実践できること |
|---|---|---|
| 1問につき1エージェント、エージェントは互いの進捗を読める | タスク分割の粒度を明確にし、共有状態を読めるようにする | 各サブタスクに独立したエージェントを置き、進捗を共有ストレージに書き込む |
| ほぼ各ステップを2つのエージェントが独立に実行し、その後文献と照合 | 重要ステップには独立したレビューが必要 | 主推論とレビューを2つの役割に分ける |
| 初期のエージェントが並列に61回試しても成し遂げられなかった | 失敗は常態であり、失敗には上限を設ける | 各経路ごとに最大失敗回数と予算を明記する |
| 結果はLeanで形式化して検証し、物理学者が確認 | 機械の結果は最終的に外部検証が必要 | 人手またはツールによる検証工程を設ける |
| バックグラウンドで約6週間実行 | 長時間タスクのコストは積み上がる | モデル別の料金表で見積もり、費用の上限を設定する |
高負荷なエージェントタスクの2つの問題がそれぞれ示すもの
1つ目は、2003年に提唱されて以来ずっと計算が完了していないホーキング=ペイジ相転移の計算です。投稿では、ほぼ各ステップを2つのエージェントが独立に実行し、その後で文献と照合したと述べられています。結論として、弱結合では転移が依然として急激に起こることが示されました。別の物理学者が異なる手法で独立に同じ答えに到達し、相互検証が成立しています。工学的実践の観点では、この問題は「独立した反復+外部照合」という検証の考え方を示しています。
2つ目は、モジュラー・ブートストラップの最も単純な版における上限問題です。以前の Claude エージェント群が並列に61回試しても成し遂げられませんでしたが、その後のエージェントが数値結果から規則性を見出し、別の球充填問題の手法を借用して、最軽量ブラックホールの質量の上限がおよそ c/9.1266 であることを証明しました。さらに、この手法では上限をこれ以上下げられないことも示しています。2026年9月、この結果は Lean で形式検証され、論文は Claude が執筆し、物理学者が主要な結果を確認しました。この問題の工学的な示唆は、多数の失敗試行がプロセスの一部である以上、各経路に必ず予算と停止条件を設ける必要がある、という点です。
特に断っておきたいのは、投稿で示された手法は「同じモデルの複数のコピー同士で相互確認する」ものであって、「計画には高価なモデル、検証には安価なモデルを使う」ものではない、という点です。後述する役割分割によるコスト削減案は、読者が試せる工学的アプローチであり、この研究ですでに検証済みの結論ではありません。
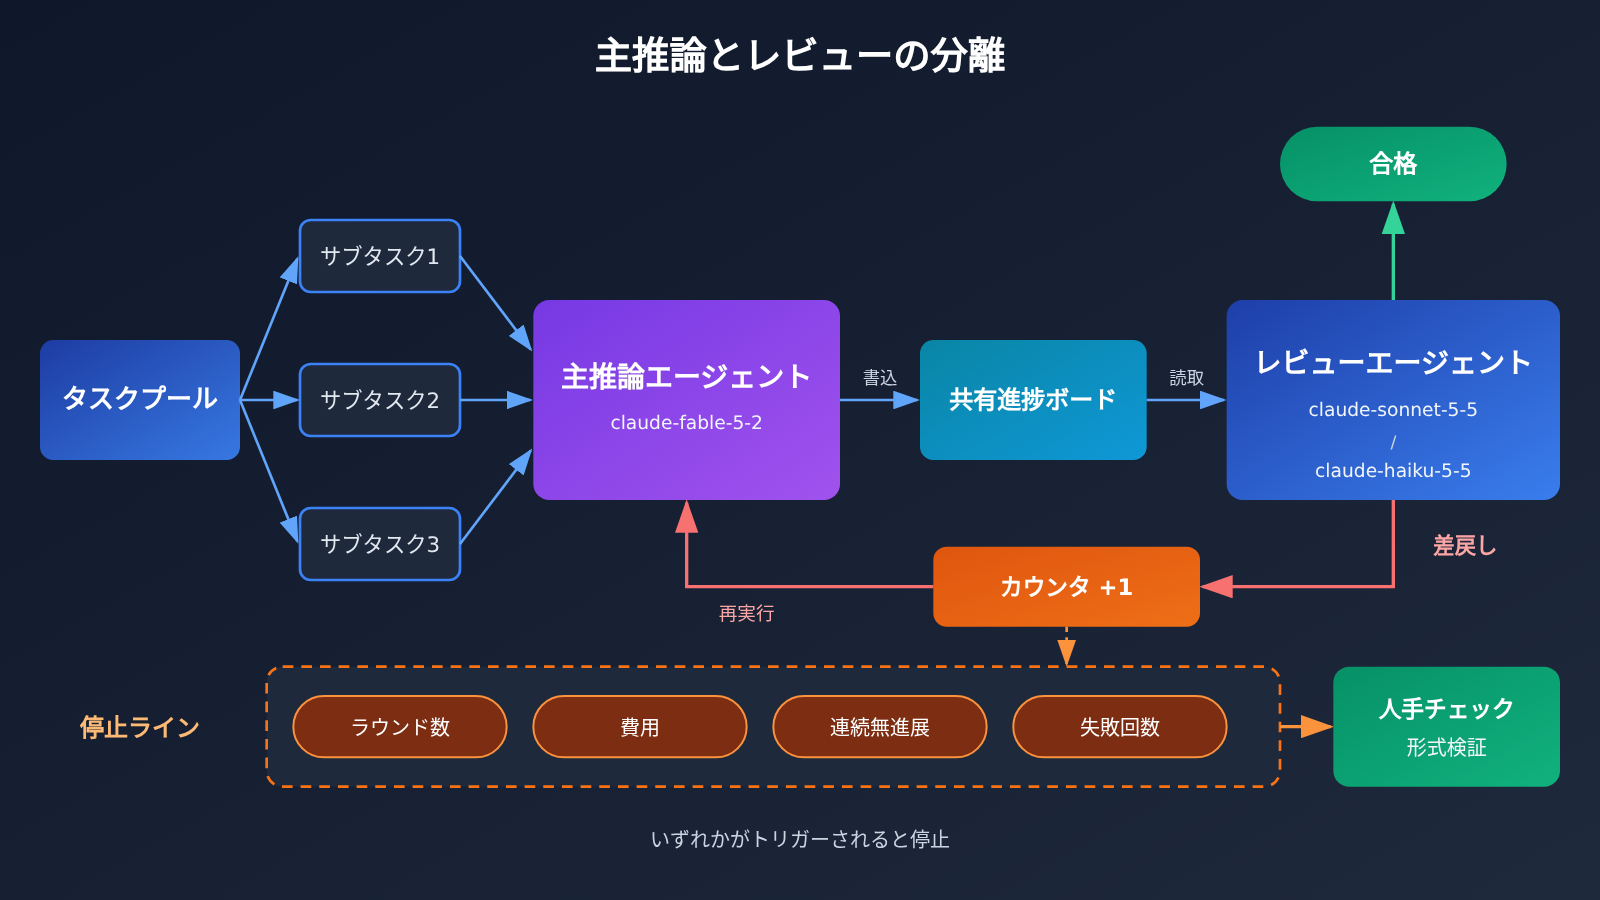
重いAgentタスクで役割をどう分けるか:主推論と検証を分離する
重いAgentタスクでは、最もコストが高いのは深い推論が必要な経路であり、最も頻繁に発生するのはチェック、照合、フォーマット検証といった検証作業です。すべての呼び出しを同じ最も高価なモデルに通すと、コストはラウンド数に対して線形、あるいはそれを超えるペースで増えていきます。「考える」と「確認する」を2つの役割に分けることが、コストを抑える最も直接的な手段です。
分割の原則は、次のようにまとめられます。オープンエンドな推論や長い連鎖の計画が必要なステップは主推論役割に任せ、「このステップは前のステップと一致しているか」「出力フォーマットは規約に沿っているか」「結論は既知の文献と矛盾しないか」といった明確な基準を持つチェックは検証役割に任せます。検証役割が返すべきは構造化された判断であり、推論をやり直すことではありません。
| 役割 | 担当内容 | 候補モデルID | 出力要件 |
|---|---|---|---|
| 主推論 | オープンエンドな導出、プラン生成、重要ステップ | claude-fable-5-2、claude-fable-5-2-thinking |
完全な推論プロセスと中間結論 |
| 一次検証 | 論理整合性、ステップ照合、引用確認 | claude-sonnet-5-5 |
PASS / FAIL と理由 |
| 軽量検証 | フォーマット検査、フィールドの完全性、簡単な照合 | claude-haiku-5-5 |
構造化されたJSON結果 |
| 外部検証 | 形式的証明、数値検証、人によるレビュー | ツールまたは人手 | 最終確認 |
このように分割すれば、すべての役割が同じ呼び出しエントリを利用できます。APIYI apiyi.com を通じれば、1つのAPIキーで上表のモデル間を切り替えられます。インターフェースはOpenAI互換なので、主推論と検証は model パラメータを変えるだけで済み、複数のSDKや複数のキーを管理する必要はありません。複数経路を並列で走らせる長いタスクでは、統一エントリによって使用量の統計も一箇所に集約でき、照合が容易になります。
ただし、検証モデルが安いからといって、より信頼できるとは限りません。検証役割を務められるかどうかは、与える判断基準が十分に明確かどうかにかかっています。まず既知の答えがある小規模なサンプルで一度実行し、検証モデルの合格・差し戻しの判断がおおむね期待どおりであることを確認してから、長いタスクに組み込むことをおすすめします。
重度AgentタスクでのAPI選び:価格とモデルID
長いタスクの予算管理は、1回の呼び出しあたりの単価が確定していることが前提になります。そこで次の原則を守ることをおすすめします。すなわち、型番表に明確な価格が記載されているモデルだけを呼び出し、コードの中にモデルIDと対応する単価を固定して書き込み、実行中にその場で別モデルに差し替えない、ということです。
Anthropicの公式モデルページによると、Claude Fable 5.2は2026年11月9日にリリースされ、モデルIDはclaude-fable-5-2、コンテキストは100万tokens、最大出力は12.8万tokens、思考(thinking)はデフォルトで有効です。次の表は、確認日(2026-11-19)時点のAPIYI apiyi.com 型番総表から、本記事に関連するモデルの価格を抜き出したものです。単位は100万tokensあたりの米ドルです。
| モデルID | 入力 | キャッシュ読み | 出力 | 本記事での推奨役割 |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | メイン推論 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | メイン推論(思考版) |
claude-fable-5-1 |
10 | 0.25 | 50 | 隣接バージョン(比較用) |
claude-sonnet-5-5 |
2 | 0.1 | 10 | 一次レビュー |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | 軽量チェック |
表からは、長いタスクにとって重要なポイントがいくつか読み取れます。第一に、claude-fable-5-2 の価格は隣接する claude-fable-5-1 より安いので、既存のメイン推論が旧バージョンなら移行を検討する価値があります。第二に、キャッシュ読みの価格は入力価格のわずか2.5%です。長いタスクではエージェントが共有の進捗状況、システムプロンプト、背景ドキュメントを繰り返し読み取るため、ここでキャッシュヒットが出ればコスト差ははっきりと現れます。ヒットするかどうかは呼び出し方法とプラットフォームのルールに依存しますので、ドキュメントの説明を正とします。第三に、レビュー用モデルとメイン推論の単価差は桁違いです。
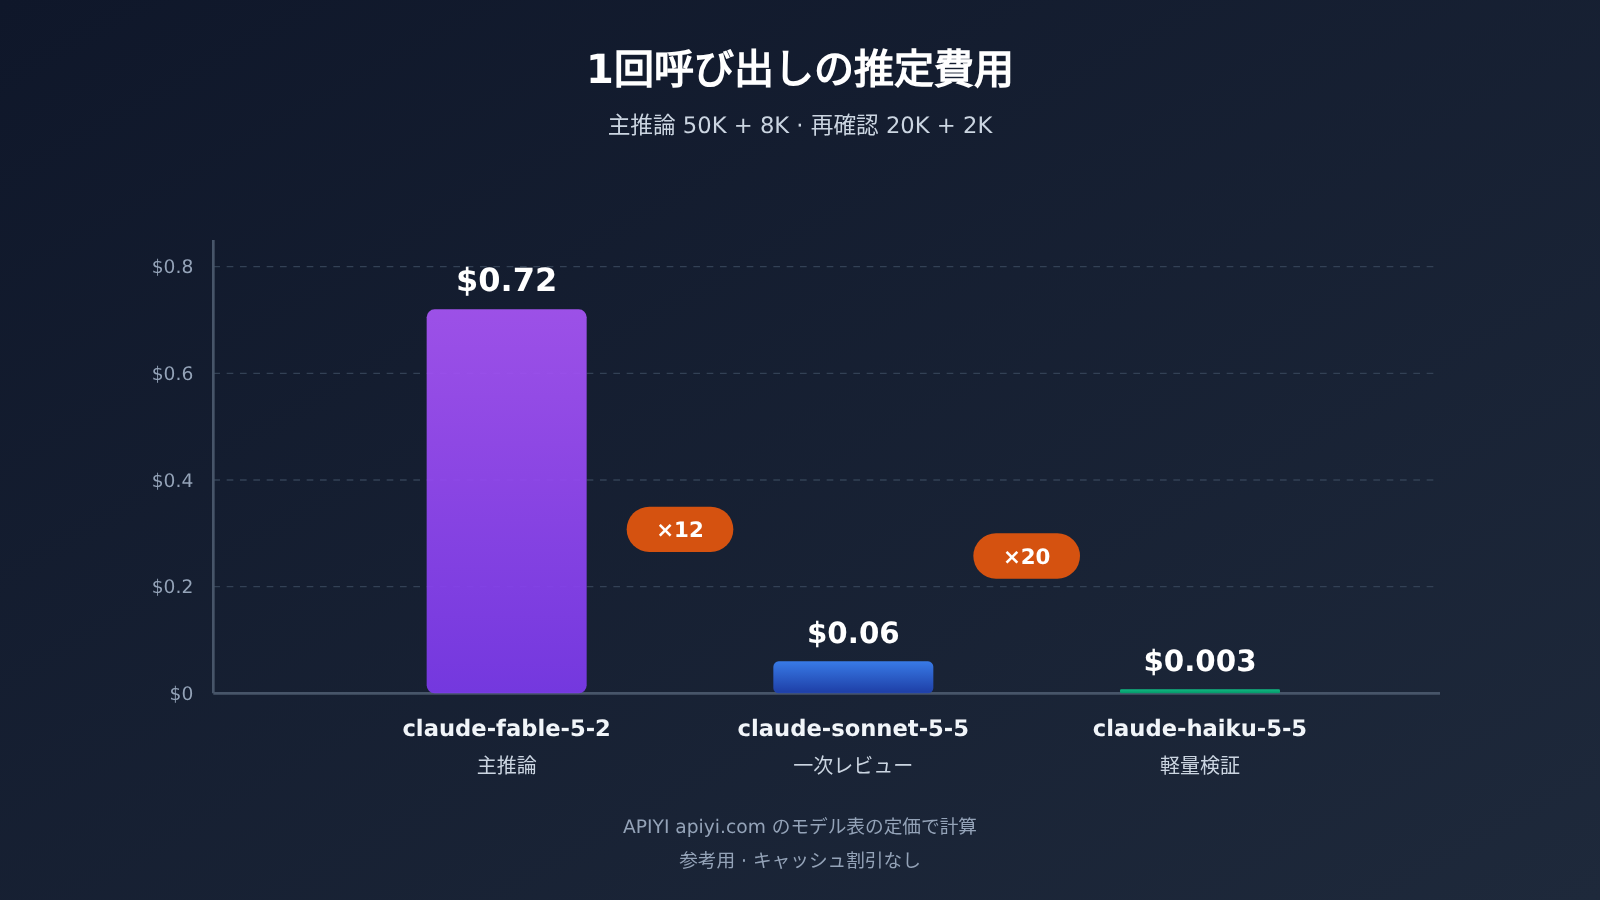
仮の数字で実感してみましょう。メイン推論の1回の呼び出しが入力5万tokens・出力8千tokensなら、claude-fable-5-2 では約 0.4 + 0.32 = 0.72米ドル。レビューの1回が入力2万・出力2千tokensなら、claude-sonnet-5-5 では約 0.04 + 0.02 = 0.06米ドル、claude-haiku-5-5 では約0.003米ドルです。もしレビューもメイン推論モデルで行うと、同じレビュー呼び出しが約 0.16 + 0.08 = 0.24米ドルになります。これはあくまで算術上の目安であり、実際のtoken数はあなたのタスク次第です。
なお、公式モデルページではOpus 5.5の価格が入力4・出力20、Sonnet 5.5が2と10、Haiku 5.5が0.10と0.50からとなっており、公式価格の段階を把握する際の参照になります。実際に呼び出す際の型番と価格はプラットフォームの型番リストを正とし、APIYI の claude-fable-5-2 シリーズは chat と messages の2種類のエンドポイントに対応しており、入口は https://api.apiyi.com/v1 に統一されています。
ヘビーな Agent タスクを素早く立ち上げる:停止ライン付きのスケジューリングコード
ミニマルな例
まず、メインの推論モデルが正常に呼び出せること、そして usage フィールドが取得できることを確認します。これは後でコスト集計を行うための基礎になります:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # token の集計と費用の見積もりに使用
各エージェント経路ごとに停止ラインを明確に定める
研究スレッドでは、初期のエージェント並列試行が 61 回に及んでも成功しなかった例がありました。これは、負荷の高い Agent タスクでは必ず大量の失敗試行が発生し、しかも失敗そのものにもコストがかかるということを示しています。停止ラインの役割は、各エージェント経路が制御不能になる前に自動的に停止させ、人間またはツールに判断を委ねることです。
| 停止ライン | 意味 | 推奨初期値(タスクに応じて調整) |
|---|---|---|
| 最大ラウンド数 | 主推論とレビューの往復回数の上限 | 10〜30 ラウンド |
| コスト上限 | 単一経路あたりの累計推定コスト上限 | 1 問あたりの予算に応じて設定 |
| 連続無進捗 | レビューで連続して差し戻され、新しい結論が出ない状態 | 3〜5 回 |
| 最大失敗回数 | 累計でレビューに差し戻された回数 | ラウンド数の半分程度 |
| 出力長 | 1 回の出力トークン上限 | 最大出力 12.8 万トークンを大きく下回る値 |
完全な実装コードを見る
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI の統合エンドポイント。メイン推論とレビューで共用
)

# 単価:USD / 100万 tokens。プラットフォームのモデル表に基づきハードコードし、変更時は手動で更新
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """表示価格に基づく概算。キャッシュ割引は含まないため、結果はやや保守的になります。"""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
このコードには、意図的に仕込まれた3つの設計があります。1つ目は、単価表をコード内にハードコードしている点です。モデルを変更する人は必ず単価も同時に変更しなければならず、「価格が定義されていないモデルに切り替わった」ことで予算が狂うのを防ぎます。2つ目は、レビュー担当に対して PASS または FAIL と理由だけを出力させ、再推論を許さないことです。これによりレビュー出力の長さを抑えています。3つ目は、停止後に現在の進捗と累計費用を返すことです。エージェントに無限リトライさせるのではなく、人間が引き継ぎやすくなります。
🚀 クイックスタート:まずは APIYI apiyi.com で新規ユーザー向けの無料テスト枠を使い、答えが分かっている小さな問題で上記のフローを一通り実行してみましょう。レビュー判定と費用見積もりが想定どおりであることを確認してから、並列パス数とラウンド数を徐々に増やしていくのがおすすめです。
ヘビーな Agent タスクにおける API 選定のよくある質問 FAQ
Q1:Claude Fable 5.2 がブラックホール物理学の難題を解いたという話は信頼できるのでしょうか?
これは Anthropic が 2026 年 11 月 17 日の研究投稿で述べた公式の見解です。関連する 2 本の論文はプレプリントであり、まだ査読を経ていません。このうち 2 問目の結果は 2026 年 9 月に Lean を用いて形式検証され、1 問目については別の物理学者が異なる手法で同じ答えを得ています。読む際は「公式の見解+プレプリント」というレベルで理解すべきです。
Q2:研究投稿に「特別な設定はない」とありますが、それは安価だという意味なのでしょうか?
いいえ、そうではありません。「特別な設定はない」は構築方法を説明したものであり、投稿にはコストの内訳は示されていません。22 問、各問に 1 つのエージェント、バックグラウンドで約 6 週間動かすとなると、呼び出し量そのものは小さくありません。同程度の規模のタスクを自分で実行する場合は、モデル表の定価に基づいて自分で見積もり、費用の上限を設定してください。
Q3:安価なモデルで検証を行うのは、研究投稿で検証済みの手法なのでしょうか?
いいえ、違います。投稿の手法は、同一モデルの複数のコピーが独立にやり直し、互いに照合するというものです。「主推論には高価なモデル、検証には安価なモデル」というのは本記事が試してみることを勧めるエンジニアリング手法であり、その効果は自分のタスクで検証する必要があります。正確性が極めて重要とされるステップでは、「2 つの主推論を独立にやり直す」方式を残すこともできます。
Q4:`claude-fable-5-2` と `claude-fable-5-2-thinking` はどう選べばよいですか?
両者は APIYI のモデル表における定価が同じで、いずれも入力 8、キャッシュ読み取り 0.2、出力 40 米ドル/百万 tokens です。公式モデルページでは、Fable 5.2 の思考はデフォルトで有効と説明されています。2 つの ID の呼び出し動作における具体的な違いはプラットフォームのモデル説明に従うものとし、同じタスクをそれぞれ数回実行して出力長と `usage` を比較したうえで、主推論にどちらを使うかを決めることをお勧めします。
Q5:1 つのインターフェースで主推論と検証モデルを同時に呼び出すにはどうすればよいですか?
APIYI の apiyi.com で登録して API キーを取得した後、SDK の base_url を `https://api.apiyi.com/v1` に設定すると、主推論と検証は `model` パラメータを切り替えるだけで済みます。たとえば `claude-fable-5-2` と `claude-sonnet-5-5` です。新規ユーザーには無料のテスト枠があり、まず停止ラインと検証ロジックを確認するのに適しています。
Q6:長いタスクにおいてキャッシュ読み取り価格にはどのような意味があるのでしょうか?
Fable 5.2 のキャッシュ読み取り価格は入力価格の 2.5%、つまり 0.2 米ドル/百万 tokens です。マルチエージェントの長いタスクでは、システムプロンプト、背景資料、共有の進捗状況を繰り返し読み取ります。これらの内容を安定させ、プロンプトの前部に配置することで、キャッシュにヒットする可能性が高まります。ヒットするかどうか、どのように課金されるかは、プラットフォームのドキュメントに従います。
Q7:停止ラインはどの程度に設定するのが適切ですか?
汎用的な数値はありません。まずは保守的な値から始めることをお勧めします。ラウンド数 10-30、連続して進展がない回数 3-5 回、各路の費用は問題の価値に応じて上限を設定します。1 バッチ実行した後に停止理由の分布を見てみましょう。もし大多数が「費用上限」で、しかも完了に近づいているなら、適度に緩めてください。もし大多数が「連続して進展がない」なら、タスクの分割が十分に細かくないことを示しています。
Q8:この手法にはどのような制限がありますか?
1つ目は、検証モデルが見落としや誤判定をする可能性があるため、正解が既知のサンプルでキャリブレーションする必要があることです。2つ目は、費用見積もりが定価に基づいており、キャッシュ割引や失敗時のリトライによる変動を含んでいないことです。3つ目は、研究スレッドのように、最終結論には依然として外部検証が必要だということです。たとえば形式証明や領域専門家のレビューです。エージェント同士が互いに合格と言い合っても、結果が正しいことにはなりません。
高負荷エージェントタスクにおけるAPI選定の核心ポイント Key Takeaways
- きっかけの位置づけ:Fable 5.2 のブラックホール研究は公式の自己申告であり、論文はプレプリントなので、結論ではなく手法を見る
- 役割を分解:オープンな推論は主推論モデルに、明確な基準があるチェックは検証モデルに任せる
- 検証は独立させる:検証は再推論せず判定のみを行い、PASS / FAIL と理由を出力する
- 停止条件は必ず書く:ラウンド数、費用、連続無進展、失敗回数の4条件はどれも欠かせない
- 価格が明示されたモデルだけを使う:モデルIDと単価をコードに固定し、モデルを変えるときは価格も必ず同期更新する
- キャッシュ読み取りを活用:安定した背景と進捗は前半に置く。キャッシュ読み取りは入力価格のわずか2.5%
- 統一エントリで手軽に始める:APIYI の1つのKeyで主推論モデルと検証モデルを切り替え、まず無料枠で小さいタスクを試す
まとめ
Claude Fable 5.2 がブラックホール物理の難題を攻略したこの事例から、ヘビーな Agent タスクで特に参考にすべきポイントは次の3つです。
- 主推論と検証を分ける:研究記事では同じモデルの複数コピーを互いに照合していました。これを土台に、役割ごとに価格帯の異なるモデルを選び、サンプルで検証品質を確かめてみるのもよいでしょう。
- 各経路に停止条件を明記する:61 回の失敗試行は、失敗が常態であることを物語っています。ラウンド数、コスト、進展なし、失敗回数のいずれにも上限を設けましょう。
- 料金表に価格が載っているモデルだけを使う:
claude-fable-5-2、claude-sonnet-5-5、claude-haiku-5-5などのモデル ID と単価をコードに書き込むことで、コストが見積もり可能・上限設定可能になります。
長期タスクの成否は、ある1回の呼び出しがいかに賢いかではなく、全体のフローが制御可能な予算内で持続的に進み、検証可能な結果を残せるかどうかにかかっています。まずは APIYI apiyi.com の無料テスト枠で小さな課題を1つ動かしてみて、そこから停止理由ごとに少しずつパラメータを調整し、規模を拡大していくのがおすすめです。
📚 参考資料
-
Anthropic 研究記事:Claude Fable 5.2 がマルチエージェントで2つのブラックホール物理問題を解いた公式の記述
- リンク:
anthropic.com/research/claude-black-hole-physics - 説明:エージェントの役割分担、所要時間、検証方法についての一次情報
- リンク:
-
プレプリント論文1:研究記事に関連するプレプリント(査読前)
- リンク:
hexagonmath.org/2611.00175v1 - 説明:結果の原文を確認したい読者向け
- リンク:
-
プレプリント論文2:研究記事に関連するもう1つのプレプリント(査読前)
- リンク:
hexagonmath.org/2611.00174v1 - 説明:上記と対比して読むと理解が深まります
- リンク:
-
Claude Fable 5.2 公式モデルページ:モデル ID、コンテキスト、最大出力、公式価格
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:モデル仕様と公式価格の段階設定を確認
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI サイトのトップページからお気軽にお問い合わせください。モデルと価格の説明は docs.apiyi.com のドキュメントセンターで確認できます


