
サードパーティの大規模言語モデル API を本番環境に組み込むとき、難しいのは最初の1行が動いた瞬間ではありません。プロジェクトを安定して納品できるかどうかは、リリース後の最初の1か月に出てくる、事前には見えない問題で決まります。たとえば次のようなものです。
- リクエストは返ってきたのに形式が違う
- クライアントはタイムアウトしたのに、プラットフォーム側では課金されている
- メイン経路が落ちたとき、フォールバックがこっそりもっと高価なモデルに切り替わっている
- 3か月後に振り返ろうとしたら、ログがすでに消えている
この記事は「どの API プラットフォームが使いやすいか」を勧める記事ではありません。 ベンダーの宣伝ページにある形容詞を繰り返すことも、プラットフォームのランキングを出すこともしません。扱うのは、実際に手を動かして確認できる次のことだけです。
リリース前に、どんな検証可能な証拠を手元に揃えれば、大規模言語モデル API の中継サービスやゲートウェイが信頼できるかを判断できるのか。
この記事で得られるもの:7項目の検収チェックリストと1枚の結論表からなる確認手順です。「なんとなく大丈夫そう」を「裏付けのある判断」に変えられます。
用語の整理:この6つの言葉を押さえてからリリースの話をしましょう
検収方法を説明する前に、何度も出てくる用語をそろえておきます。ベンダーのドキュメントや技術記事では、これらの言葉の使い方がバラバラなことがよくあります。定義がずれていること自体が、リリース時のリスクになります。
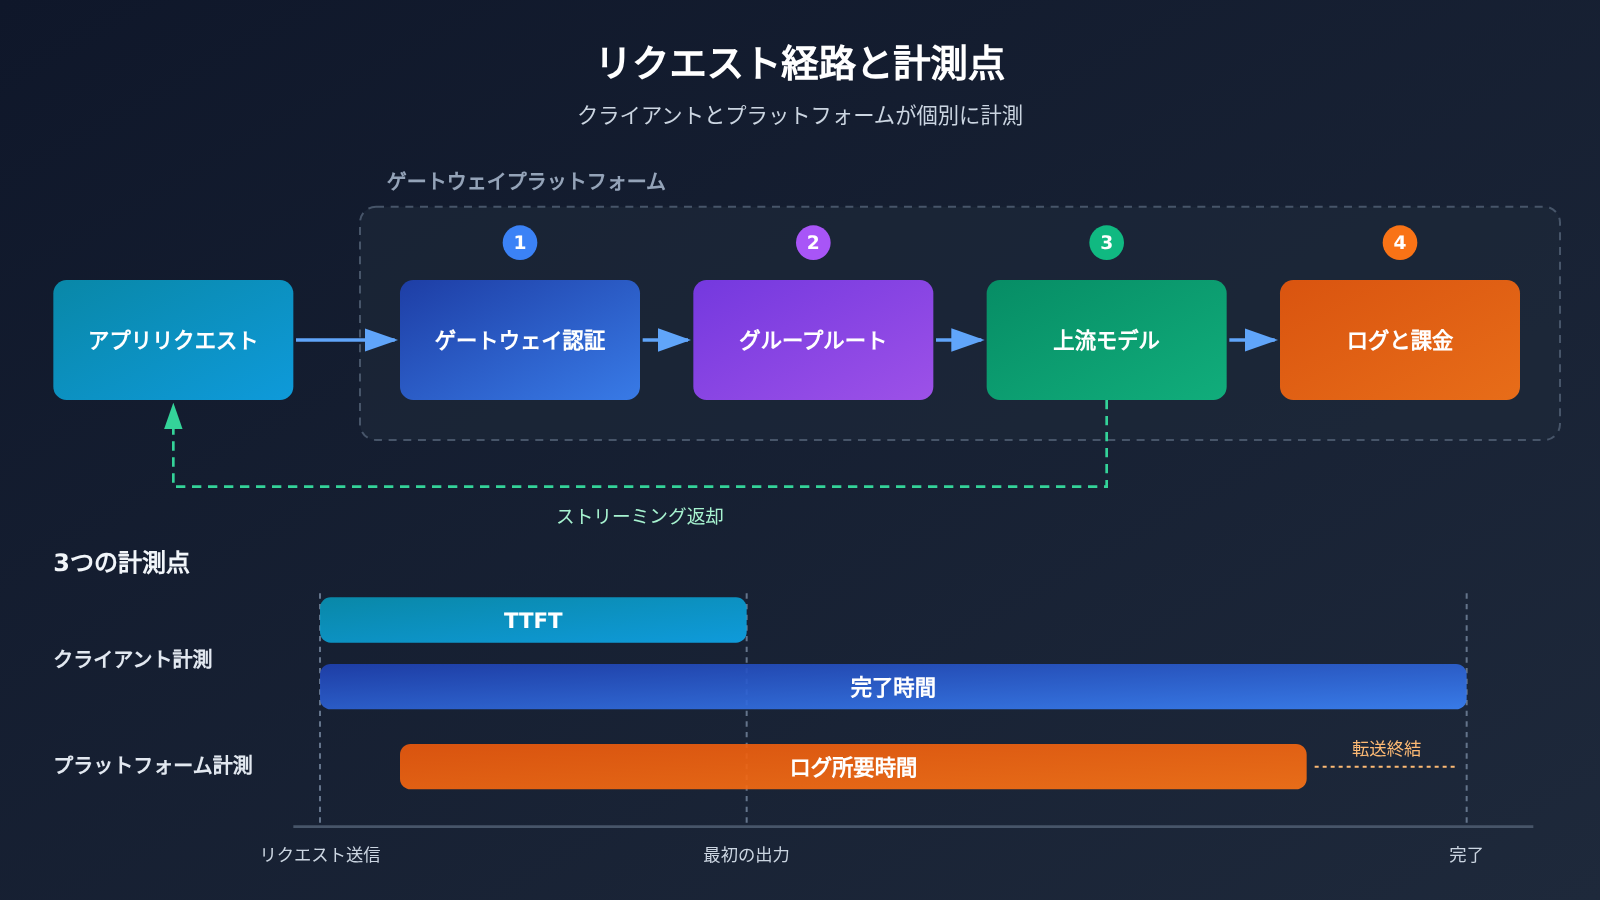
- API ゲートウェイ:アプリケーションからのリクエストを受け取り、上流のモデルサービスに渡す入口です。通常は認証、課金、ルーティング、ログの4つを兼ねています。そのため、1回の呼び出しの失敗はどの層でも起こりえます。最初に責任の所在を切り分けておく必要があります。
- TTFT(最初の有効な出力までの時間):リクエストを送ってから、最初の有効な出力トークンが届くまでの時間です。ストリーミングのやり取りでユーザーが体感するのは、返信全体の所要時間ではなくこの値です。
- p95:サンプルの約95%がその値以下に収まる指標です。平均値は遅いリクエストを覆い隠してしまいます。「ときどき十数秒止まる」ような一部の呼び出しは、p95 で初めて見えてきます。
- RPM と同時実行数:RPM は1分あたりに送信するリクエスト数、同時実行数は同じ時点でまだ処理中のリクエスト数です。1件の処理が長引くほど、RPM が低くても処理中のリクエストが積み上がり、同時実行数が高くなることがあります。このため、両者は別々に記録する必要があります。
- Fallback(フォールバック):メインのサービスがリクエストに応えられないとき、予備の経路やモデルに切り替える仕組みです。検収では、リクエストが成功したかどうかだけでなく、最終的に使われたモデル、中核機能、費用の上限、データポリシーまで確認します。
- SLA:サービスレベルアグリーメントのことで、指標の定義、集計範囲、障害時の責任、補償の条件を取り決めたものです。実際に運用できる取り決めであり、単独で引用できる1つのパーセンテージではありません。
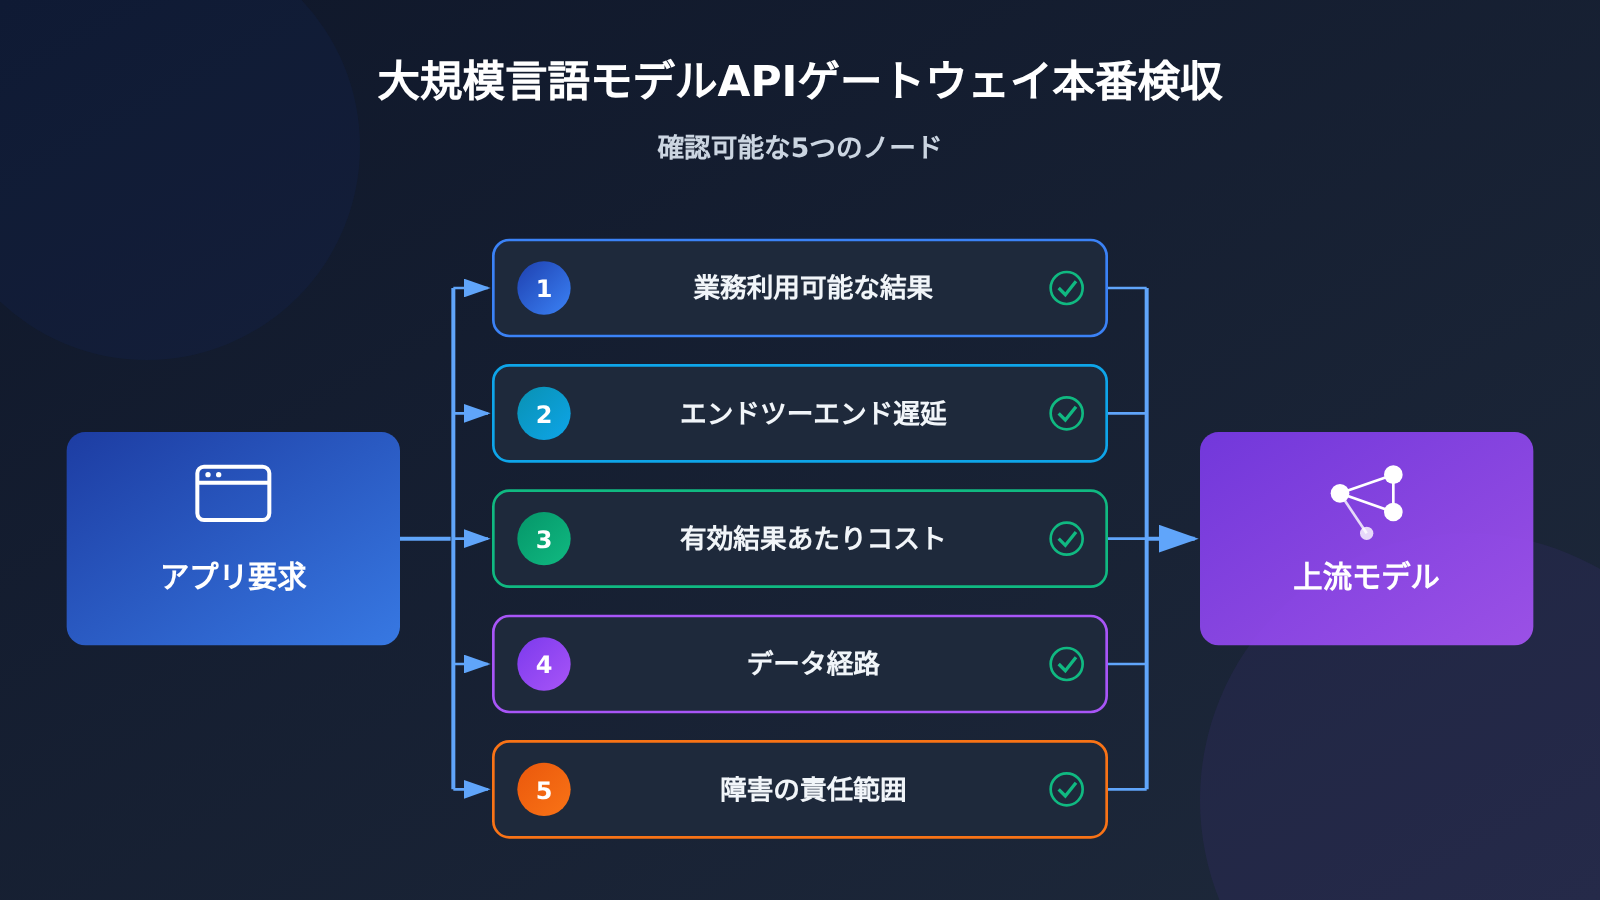
核心情報:ゲートウェイの信頼性は5つの確認観点に分けて考える
大規模言語モデルのAPI中継サービスやゲートウェイの価値は、インターフェースを統一できることにあります。ただ、その手軽さが、裏側にある違いを覆い隠してしまうこともあります。OpenAI互換の base_url の向こう側には、まったく異なる上流プロバイダー、異なるレート制限ポリシー、異なるログ保持ルール、異なる障害対応フローが存在しているかもしれません。
そのため、本番投入の判断は「呼び出しが通るかどうか」だけでは足りません。「結果が使えるか」「待ち時間が許容できるか」「異常を追跡できるか」の3点を同時に見る必要があります。次の表は、この3点を5つの確認観点に展開したもので、本記事の後半5つの節の骨組みにもなっています。
| 確認観点 | 答えるべき問い | 判断の根拠 | よくある誤判断 |
|---|---|---|---|
| 業務で使える結果 | 返ってきた内容をそのまま業務フローに流せるか | 完全に返ってきた件数、フォーマットが使える件数、業務判定を通過した件数 | HTTP 200 を成功とみなす |
| エンドツーエンドのレイテンシ | ユーザーが最初の有効な出力を見るまでにどれだけ待つか | TTFT と完了時間の p50・p95、クライアント側とプラットフォーム側それぞれの計測 | 平均所要時間だけを見る |
| 利用可能な結果あたりのコスト | 使える結果1件に実際いくらかかったか | 決済済みの全支出 ÷ 業務で使える結果の件数 | 単価だけを比べ、リトライやフォールバックを比べない |
| データ経路 | 入出力は誰を経由し、どれだけ保持され、誰が閲覧できるか | ゲートウェイ・上流・ログ・非同期成果物それぞれのポリシー | 通信の暗号化を、内容が読まれないことと同一視する |
| 障害時の責任 | 問題が起きたとき、どの基準で認定し、どう補償されるか | SLA の集計期間、除外項目、申請手順、補償の形式 | 公開されている説明を契約上の約束とみなす |
🎯 技術アドバイス:この表をそのままチーム独自の受け入れチェック表としてコピーし、各行に必ず根拠の出どころを記入してください。まず呼び出し経路を動かしてみたい場合は、APIYI(apiyi.com)でテスト用クレジットを入手し、同じスクリプトで複数のモデルを横並びで記録すると便利です。
なぜ信頼性をビジネス上の受け入れ条件として定義するのか
統一インターフェースによって接続コストは下がりましたが、本来はインフラ側で行っていた判断の一部が、アプリケーションチームに回ってくることにもなりました。以前はリトライ処理や複数の SDK を自分たちで管理する必要がありましたが、今は base_url を切り替えるだけで多くのモデルを呼び出せます。その代わり、通信経路の可視性は下がります。
そのため、受け入れ検証の最初のステップは性能テストではなく、まず「使える」とは何かを明確に定義することです。同じリクエストでも、プラットフォームで課金が成功したこと、クライアントが 200 を受け取ったこと、業務側でパースを通過したことは、それぞれ別の事象であり、別々に集計しなければなりません。構造が不正な JSON は、プラットフォーム上でリクエストが正常に完了していても、業務にとっては成果ゼロです。それでも費用は発生します。
2つ目のステップは、業務の形態ごとにテストセットを分けることです。対話型の Q&A では、最初の有効な出力が返るまでの時間と、回答全体の制限時間を見ます。ツール呼び出しでは、パラメータの構造が妥当か、フィールドが揃っているかを確認します。バッチ処理では、納期までにどれだけ使える結果を出せるかを見ます。この3種類を「平均所要時間」にまとめてしまうと、結論は必ず歪みます。
3つ目のステップは、時間の計測基準をそろえることです。クライアント側の待ち時間と、プラットフォームのログに記録される所要時間は、対象とする区間が同じではありません。公式ドキュメントにも、「プラットフォームでは成功・課金として記録されているのに、レスポンスの転送や接続の終了処理が原因でクライアント側ではタイムアウトした」というケースが明記されています。また、バックグラウンドで他の回線へ自動的に切り替えて試行すると、全体の待ち時間も長くなります。したがって、異常が起きるたびに、まず業務IDと request_id を使って、クライアント側の記録、プラットフォームのログ、残高の変動の3つを突き合わせ、そのうえでリトライするかどうかを判断してください。
固定タスクでゲートウェイの能力とピーク負荷をテストする方法
テストを再現可能にするには、まず変数を固定する必要があります。対象モデルのバージョン、チャネルまたはグループ、呼び出しインターフェース、主要パラメータ、ネットワーク入口、入出力の規模、ストリーミングの有無——このうちどれか一つでも変われば、前後のデータを並べて比較することはできません。サンプルは「こんにちは」のようなおもちゃの入力ではなく、実際の業務から取得したマスキング済みデータを使います。
次の表はそのまま導入できる受け入れ記録のテンプレートです。方法論の提案であり、特定プラットフォームの実測結論は含んでいません。しきい値は業務要件に合わせてご自身で決めてください。たとえば対話型タスクなら「最初の有効な出力まで何秒以内か」、オフライン処理なら「数時間以内に有効な結果をいくつ納品できるか」といった具合です。
| 観点 | 記録する項目(推奨) | 判断方法 |
|---|---|---|
| 業務上の納品成功 | リクエスト総数、完全に返却された数、形式として使える数、業務判定を通過した数 | 分母をすべて明記し、最終的には業務で利用可能な結果の割合を見る |
| レイテンシ | 開始時刻、最初の有効な出力時刻、完了時刻、プラットフォームログ上の所要時間 | クライアント側とプラットフォーム側で別々に計測し、p50 と p95 を集計する |
| コア能力 | ストリーミングの終端処理、ツールパラメータの妥当性、構造化出力のパース、長文入力の処理 | 本製品が実際に依存する能力ごとに合否を確認する |
| ピーク負荷 | 同時に処理中のリクエスト数、毎分リクエスト数、429 の割合、キューイングとリトライ | リクエスト規模を揃えたまま段階的に負荷を上げ、観察用の待ち時間を確保する |
| 費用 | 呼び出しごとの課金額、返金、フォールバック費用、業務で使えた結果の数 | 有効な結果 1 件あたりの総コストを算出する |
| 調査可能性 | 業務番号、request_id、モデルとグループ、エラーコード、サポートチケットの回答 | 異常な注文をプラットフォーム側の記録まで追跡できるか |
次のスクリプトがやることは一つだけです。ストリーミング呼び出しの中で、最初の有効な出力までの時間と総所要時間を同時に記録し、クライアント側の計測値とプラットフォームログを同じ時間軸で突き合わせられるようにします。
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
バッチ負荷テストとパーセンタイル統計のコードを見る
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
負荷テストでもっともよくある間違いは、RPMと同時実行数を混同してしまうことです。毎分リクエスト数、毎分トークン数、同時に実行中のリクエスト数は、それぞれ別の制約を表していて、互いに代用できません。レイテンシが上がるとリトライがシステムへの負荷をさらに増幅させるので、スクリプトにはローカルキュー、最大待機時間、上限付きのバックオフリトライを必ず組み込む必要があります。
ここで見落としやすいポイントがあります。APIYIのドキュメントでは、「同時実行」ページと「トークンとグループ」ページで、レート制限の適用範囲に関する記述が完全には一致していません。前者は複数のトークンクォータが独立していると述べ、後者はレート制限がアカウントに紐づくと説明しています。受け入れテストで正しいのは、**自分の対象アカウントと対象チャネルで実際のクォータを実測する**ことです。同時実行数とRPMを別々に記録し、他人のスクリーンショットにある固定値をそのまま当てはめたり、キーを増やして制限を回避しようとしたりしないでください。
—
## 有効な結果あたりのコストとフォールバック動作をどう確認するか
単価よりも比べる価値があるのは、「ビジネス上有効な結果1件あたりの実コスト」です。計算方法はシンプルで、分子には決済済みの支出全額(リトライとフォールバックを含む)を置き、分母にはビジネス上有効な結果数を置きます。確定した返金は分子から差し引きます。
以下は純粋な仮定の算例で、アルゴリズムの説明だけが目的であり、特定のベンダーの価格を示すものではありません。
| プラン | 決済済み純支出 | ビジネス上有効な結果 | 有効な結果あたりのコスト |
|——|————–|————–|——————|
| プランA | 3.0ドル | 90件 | 約0.0333ドル |
| プランB | 3.2ドル | 98件 | 約0.0327ドル |
支出だけを見ればプランAのほうが安く、有効な結果で割るとプランBのほうが割安になります。「どこが安いのか」という問いがビジネス側の分母なしでは意味を持たないのは、まさにこういう理由です。あわせて2点に注意してください。事前に確保されたまま未決済の非同期タスク枠は別途記載する必要があります。また、消費記録だけを積み上げると純支出を過大評価することがあります。非同期タスクの返金はマイナス値のレコードとして請求に現れるからです。
フォールバックは、まったく性格の異なる2種類の変化に分けて捉える必要があります。**チャネル切り替え**は同じモデルのまま経路を変えるもので、モデルの能力と価格は理論上変わりません。一方**モデル切り替え**は、メインモデルが使えないときにリストに沿って別のモデルを試すもので、業界では一般的な仕組みです。たとえばOpenRouterのmodel fallbacksは、最終的に実際に使用したモデルの価格で課金し、レスポンスのmodelフィールドに最終モデルを示すと明記しています。この例はあくまで仕組みの説明用であり、フィールドの意味を他のプラットフォームにそのまま持ち込むことはできません。
したがって、受け入れ項目は少なくとも次の4点をカバーする必要があります。フォールバック後の最終モデルはどれか、コア機能が依然として成立するか、1回あたりの費用に上限があるか、最大待機時間はどれくらいか。モデルの切り替えが許されない業務があるなら、フォールバックを無効にできるかも確認してください。ストリーミングの場合は別途テストが必要です。部分的な出力が返された後に失敗したとき、シームレスに継続できるかどうかは、非ストリーミングの成功フォールバックからは推測できません。
> 💡 **選択のヒント**:直結の価格とフォールバック経路を同じ表で並べて比べてこそ、本当のコストが見えてきます。複数モデルの実際の課金記録を手早く集めて比較したいなら、APIYI apiyi.com で小規模なサンプルを流し、その結果を自分の受け入れ表で精算してみてください。
—
## データ経路と障害時の責任をどう確認するか
「私たちは安全です」「私たちは安定しています」といった表現で済まされがちな2点ですが、実はトラブルが起きたときに頼れるのは、この2点だけです。確認の基本は、ゲートウェイ、上流のモデルプロバイダー、詳細なトラブルシューティングログ、非同期の成果物を同じデータ経路上に並べ、各層のポリシーを順番に確認していくことです。
| 経路上の要素 | 確認すべきポリシー | 確認方法 |
|———-|—————-|———-|
| ゲートウェイ自体 | 入出力をデフォルトで保存するか、トラブルシューティングログを誰が有効化できるか、保持期間はどのくらいか | 公式のデータセキュリティおよびログに関する説明を読む |
| 上流のモデルプロバイダー | 学習への利用、保持期間、オプトイン(明示的な許可)の要否 | 各上流のポリシーを個別に読み、1つにまとめない |
| 詳細なトラブルシューティングログ | 記録範囲、閲覧できる担当者、デフォルトの保持期間、無効化後の削除時点 | 無効化スイッチを切っても、既存の記録がすぐ削除されるわけではないことを確認する |
| 非同期タスクの成果物 | 成果物の保存場所、ダウンロードリンクの有効期限 | 自社側で早めに保存し、一時リンクに依存しない |
公開ドキュメントによると、APIYIの通常の運用方針では、顧客の入出力はデフォルトで保存されません。詳細なトラブルシューティングログは管理者が一時的に有効化でき、入力、コンテキスト、出力をすべて記録します。内容を閲覧できるのは管理者のみで、ページに記載されているデフォルトの保持期間は7〜30日です。同じページには、記録スイッチを無効にしても、既存の記録がすぐに削除されたとは解釈できないことも明記されています。こうした内容を扱うときは「公式ドキュメントの説明」という出典を明示しておきましょう。これはコンプライアンス認証ではなく、法的な結論でもありません。
見落とされがちな運用上の事実がもう1つあります。ログ自体にもライフサイクルがあることです。APIYIのログ保持に関する専用ページには、呼び出しログは直近約2か月分がローリング方式で保持され、毎月5日、15日、25日に、その日から2か月以上前の記録が削除されると書かれています。削除されたログは復元できないため、長期的な照合や監査に必要な明細は、自分でエクスポートして保管する必要があります。同期結果と非同期成果物では保存期間も異なり、成果物のダウンロードリンクは約1日で有効期限が切れるとされています。この期間を過ぎてから振り返ろうとしても、手元に証拠は残っていません。
障害時の責任については、実行可能な条項にまで落とし込んで確認します。APIYIのSLA専用ページで説明されているのは、プラットフォーム側の原因で損失が生じた場合のクレジット(利用額)の再付与と、企業が契約で保証範囲、可用性指標、対応時間、賠償上限を取り決められる点です。すべての顧客に共通する固定の可用率が示されているわけではありません。ベンダーを比較するときは、指標の集計期間、分母の定義、障害の除外項目、申請手続き、補償の形式を記録しておきましょう。また、サービスクレジットによる補償と現金での賠償では、調達上の価値が異なることも押さえておく必要があります。
—
## 検収表1枚で本番投入の範囲を決める
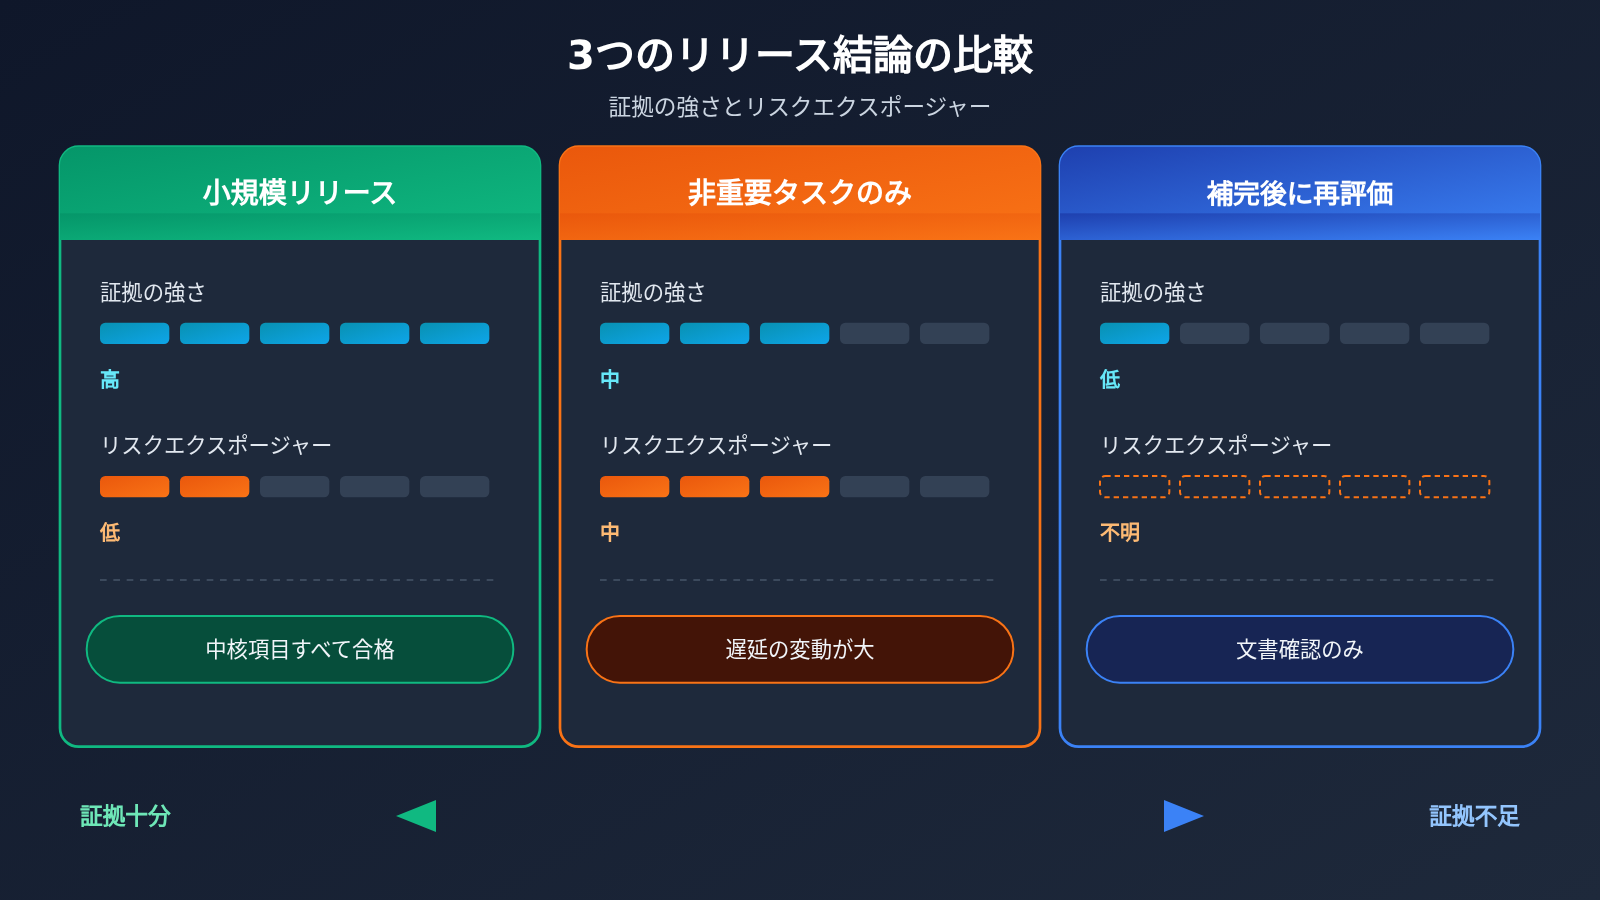
記録を結論にまとめるときは、「信頼性ランキング」ではなく、投入範囲の判断を出してください。同じベンダーでも、インタラクティブな業務では「重要度の低いタスク」までしか任せられない一方、オフラインのバッチ処理なら十分に使える、ということがあります。
| 結論 | 必要な根拠 | 切り替え・停止のトリガー条件 |
|——|—————-|———————-|
| 小規模での本番投入が可能 | 主要な機能がすべて合格している、p95 が業務のしきい値内に収まっている、利用可能な結果あたりのコストが許容範囲内、データ経路と SLA を確認済み | 業務での可用率がしきい値を下回る状態が続く、または課金の異常を突き合わせられない |
| 重要度の低いタスクのみに利用 | 機能は合格だがレイテンシの変動が大きい、またはフォールバックによってモデルや費用が変わる | 重要な経路は自社構築または直接接続に戻す、フォールバック設定を明示的に無効化する |
| 条件が整ってから再評価 | ドキュメントの確認のみで自アカウントでの実測がない、または SLA の条項が契約に反映されていない | 実測データと契約条項がそろった時点で、あらためて結論を出す |
ドキュメントの確認しかできていない場合は、結論を正直に「公開されている機能と調達条件を確認済み」と書き、実際の検収は次のラウンドに回しましょう。障害時の挙動を検証したいときは、ベンダーが認めているテスト用の設定や隔離環境を使ってください。共有の本番サービスに意図的に負荷や障害を与えてはいけません。また、タイムアウトして結果が不明なときは、まず実行状況と課金を確認し、同じ業務アクションを重複して実行しないようにしてください。
> 🚀 **クイックスタート**:テスト用スクリプトをゼロから作りたくない場合は、まず APIYI(apiyi.com)の無料テスト枠を使って、上記7項目チェックリストの「機能」と「レイテンシ」の2列を一通り試してみてください。そのうえで、より負荷の高いストレステストに進むかどうかを判断すると効率的です。
—
## よくある質問 FAQ
Q1:大規模言語モデルのAPI中継とゲートウェイとは、そもそも何ですか?
アプリケーションと上流のモデルサービスの間に置かれる入口レイヤーのことです。リクエストを受け取ると、認証、課金、ルーティング、ログ記録を行います。「中継」という言葉が表しているのは、複数のモデルを1つの互換インターフェースにまとめるという点です。そのため、導入は楽になりますが、その代わりに下層の経路が見えにくくなります。
Q2:公式APIに直接接続する場合と中継ゲートウェイを使う場合、信頼性にどんな違いがありますか?
違いは、経路の層の数と責任の境界にあります。直接接続なら、確認すべき上流は1つだけです。ゲートウェイを経由すると、ゲートウェイ自体、グループチャネル、上流サプライヤーの3層がそれぞれ障害点になり得ます。一方で、フォールバックの仕組みやログの一元化を得られる可能性もあります。判断するときは、どちらが速いかを比べるのではなく、本記事で挙げた5つの観点ごとに証拠を集めてください。
Q3:なぜ平均レイテンシだけを見てはいけないのですか?
平均値は、ごく一部の極端に遅いリクエストを覆い隠してしまうからです。ユーザーからの苦情は、そうした遅いリクエストから出ることが多いものです。ストリーミング形式のやり取りでは、TTFTと完了までの総時間を分けて集計しましょう。さらに、サンプル数、計測期間、失敗・キュー待ち・リトライを含めたかどうかを明記する必要があります。これを書かないと、p95も比較の材料になりません。
Q4:リクエストは成功したのに内容が使えない場合、プラットフォーム側の問題になりますか?
通常はプラットフォームの問題にはなりませんが、コストとしては計上する必要があります。プラットフォームがリクエストを正常に処理すれば課金されます。出力の構造が無効だった場合は、業務側でリトライすべき部分となり、その重複した支出は「利用可能な結果1件あたりのコスト」の分子に含めるべきです。そのため、検収表では「プラットフォーム側の実行成功」と「業務判定の合格」を別々の列に分けてください。
Q5:あるゲートウェイが自分の業務に耐えられるかを、手早く検証するにはどうすればよいですか?
マスキング済みの自社サンプルを使い、モデル、チャネル、パラメータ、入力規模を固定したうえで、小規模なサンプルで1回テストを行います。記録するのは、TTFT、p95、業務上利用可能な結果の割合、課金の明細です。この検証は、APIYI(apiyi.com)でテスト用クレジットを受け取って実施できます。得られたデータは検収表に記入してください。1回の疎通確認だけで結論を出すのは避けましょう。
Q6:この方法には、どんな既知の制約がありますか?
小規模サンプルのp95は大きく変動するため、長期的なサービス保証として扱うことはできません。また、時間帯によって上流の負荷が異なり、結論に影響します。複数の時間帯で繰り返し測定してください。さらに、本記事の計算方法はあくまで手法の提案です。特定のプラットフォームの実測性能データや実際の請求書は含まれていません。最終的な判断では、ご自身の業務上のしきい値や契約条件も踏まえる必要があります。
—
## 大規模言語モデルAPI中継ゲートウェイの核心ポイント
– **信頼性は業務側の合格判定で定義する**:プラットフォームでの課金成功、クライアントが200を受け取ったこと、業務側のパースが通ったこと。これはそれぞれ別々に数えるべき3つの事象です。
– **遅延は2つの計測点に分ける**:TTFTは対話体験を左右し、完了までの総時間はデリバリー能力を左右します。どちらもp95で見ます。
– **RPMと同時実行数は分けて記録する**:RPMが低くても、処理中の同時実行数は高く積み上がることがあります。制限の基準は、対象アカウントでの実測値に従います。
– **コストは「利用可能な結果」で割る**:精算済みの支出合計を、業務上利用可能だった結果の数で割ります。リトライとフォールバックの分も分子に入れます。
– **フォールバックはチャネル切り替えとモデル切り替えを区別する**:最終モデル、コア機能、コスト上限、最大待ち時間の4項目を一つずつ検証します。
– **データと責任は実行可能な条項で判断する**:ログには保持期間があり、SLAには統計の定義、除外項目、補償の形態が揃っていなければなりません。
– **導入の進め方**:まず APIYI apiyi.com の少ないサンプルで「能力」と「遅延」の2列を埋め、そのうえで負荷テストと契約内容の突き合わせに進みます。
—
## まとめ
ある大規模言語モデルAPIの中継・ゲートウェイが信頼できるかどうかを見極めるのは、突き詰めれば「印象」ではなく「証拠集め」の作業です。「使えるかどうか」を、業務上の利用可能な結果、エンドツーエンドの遅延、利用可能な結果あたりのコスト、データの経路、障害時の責任という5つの層に分解し、それぞれについて後から確認できる記録を残しておけば、多くの想定外をリリース前に「既知の項目」へと変えられます。
実際に進めるときは、次の3点を覚えておいてください。結論には範囲だけを書き、順位は書きません。基準には自分の実測値だけを書き、他人のスクリーンショットは書きません。証拠は再確認できる範囲までに留めます。ログはいずれ失効するからです。この3点を守れば、選定の議論は「声の大きさ」に依存しなくなります。
まずは APIYI apiyi.com で少サンプルの受け入れ検証を一巡することをおすすめします。統一インターフェースと無料のテスト枠が用意されているため、複数のモデルを同じ表で比較しやすくなります。
—
## 参考資料
1. **APIYI のトークンとグループ**:複数キー、クォータ、リソースグループ、フォールバックグループの解説
– リンク: `docs.apiyi.com/faq/token-and-groups`
– 説明: キーの割り当て、リソースグループ、メイン/バックアップ経路の仕組みを確認するための資料
2. **APIYI のログ保持・削除ポリシー**:ログのローテーション保持とエクスポートの解説
– リンク: `docs.apiyi.com/faq/log-retention-policy`
– 説明: 突合や監査に必要な明細を、自前でどこまで保存しておくべきかを確認
3. **APIYI 詳細ログの説明**:トラブルシューティング用ログの有効範囲と保持期間
– リンク: `docs.apiyi.com/faq/user-logs-control`
– 説明: データ経路上のどの階層でログが取られるかを確認
4. **APIYI データセキュリティの説明**:入出力をデフォルトで保存しない方針について
– リンク: `docs.apiyi.com/faq/data-security`
– 説明: 上流プロバイダのポリシーと階層を分けて読み比べるための資料
5. **APIYI の SLA 保証**:クォータの補填と契約で定められた範囲
– リンク: `docs.apiyi.com/faq/sla-guarantee`
– 説明: 障害時の責任がどのような補償の形で果たされ、どこまでが対象かを理解する
6. **ログの請求金額の読み方**:請求明細のフィールドと倍率の算出基準
– リンク: `docs.apiyi.com/faq/log-billing-explained`
– 説明: 有効な結果1件あたりの実際のコストを算出するために使用
7. **ログ上は完了・課金済みなのにクライアントに応答が届かない場合**:クライアント側タイムアウトとプラットフォーム側課金のずれ
– リンク: `docs.apiyi.com/faq/log-duration-vs-client-wait`
– 説明: 異常な注文を調査する際の必読資料
– リンク: `openrouter.ai/docs/guides/routing/provider-selection`
– 説明: 経路切り替えとモデル切り替えの違いを理解する
9. **OpenRouter Model Fallbacks**:モデルのフォールバックと実際の課金基準
– リンク: `openrouter.ai/docs/guides/routing/model-fallbacks`
– 説明: 最終的に使われたモデルと課金の帰属についての業界での一般的な扱いを解説
—
> **著者**:APIYI 技術チーム
> **技術交流**:APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。ドキュメントは docs.apiyi.com のドキュメントセンターでご覧いただけます


