
作者注:Anthropic のエンジニアリングブログで公開された Claude Dreaming の仕組みを読み解きます。本記事では、4層のメモリ構造、CL-Bench と Wiki 実験のデータ、誤り訂正の事例、エンジニアリング上のリスクを取り上げます。あわせて、「セッション間でメモリを整理する」という考え方を、開発者が自分の Agent のメモリシステムに取り入れる方法も紹介します。
2026年11月6日、Anthropic はエンジニアリングブログで The components of agent memory を公開しました。この記事では初めて、Claude Dreaming がセッションとセッションの合間にどのように誤りを訂正し、メモリを整理し、ナレッジベースを構築するのかが体系的に説明されています。公式 X アカウントでも同時に記事が紹介され、Claude Managed Agents のドキュメントには Dreams のリサーチプレビュー用インターフェースも登場しました。
これは「Agent にベクトルDBを足す」というよくある話とは違います。Anthropic は複数の実験を通じて、長期稼働する Agent には履歴を保存するだけでは足りないことを示しました。検証・訂正・統合・整理を継続的に行って初めて、過去の情報が次のタスクで本当に役立つというわけです。
この記事で得られること:Claude Dreaming の4層メモリ構造と、主要な実験データを理解できます。さらに、どんな場面で効果があり、どんな場面で逆効果になるのか、そして自分の Agent にどう取り入れればよいのかもわかります。
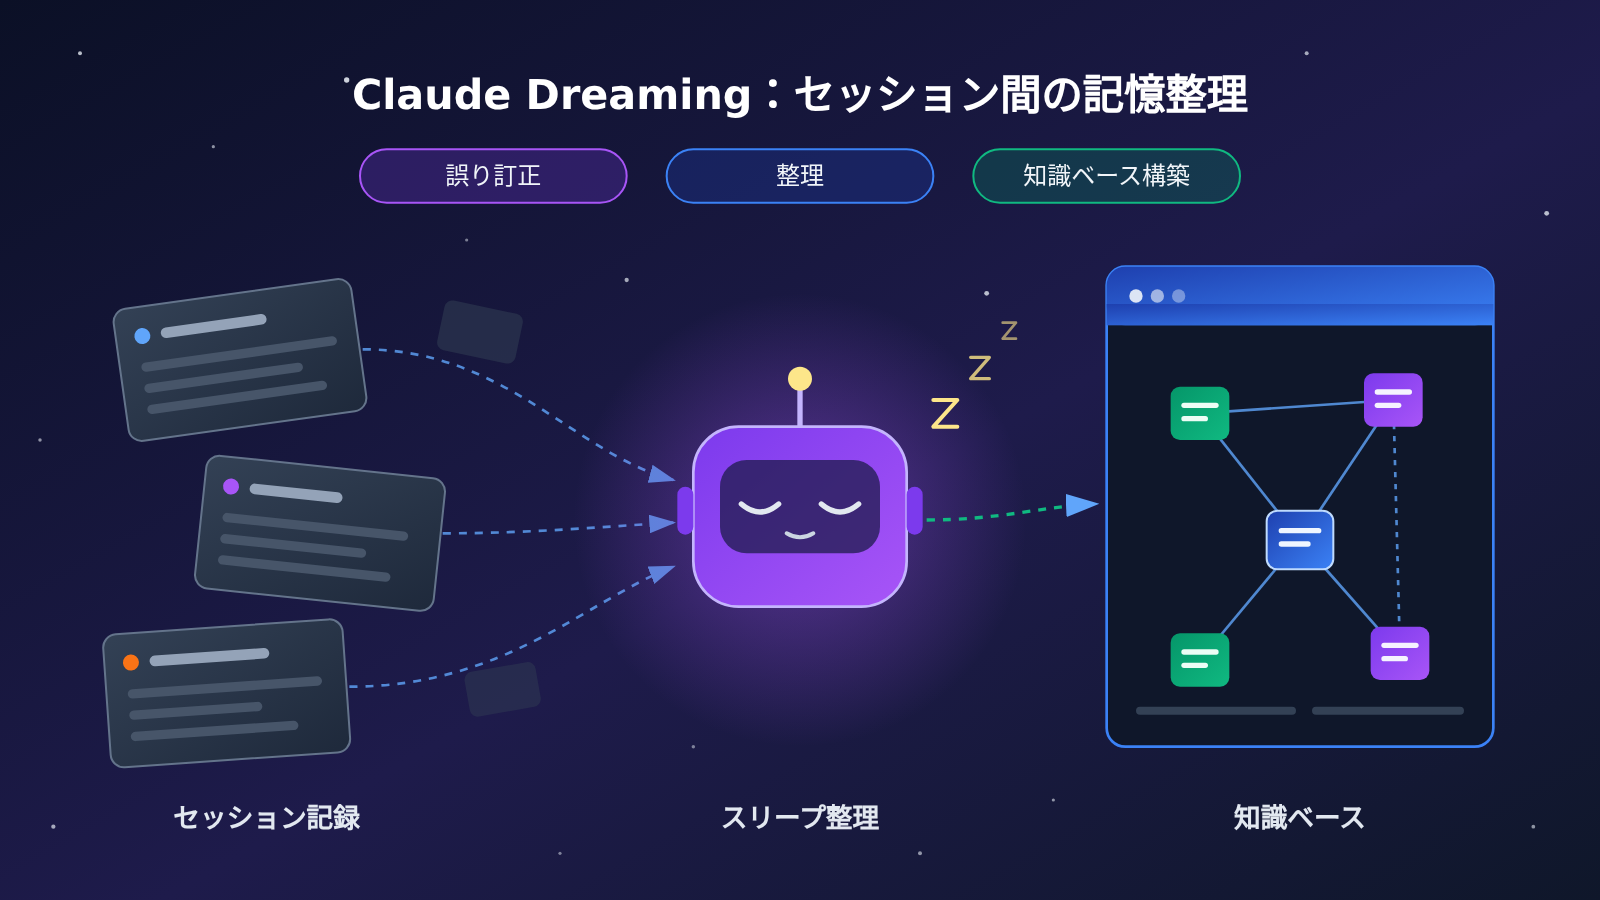
Claude Dreaming 核心情報まとめ
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026-11-06、Anthropic Engineering ブログ |
| 中心となる概念 | Dreaming:セッションの合間に、過去の履歴を使って記憶を再整理・メンテナンスするバックグラウンド処理 |
| 記憶の階層 | Transcripts、Memory notes、Memory representations、Injected context の計 4 層 |
| 製品としての形 | Claude Managed Agents の Dreams。現在は Research Preview で、利用にはアクセス申請が必要 |
| 関連資料 | 公式 Cookbook『Dreaming with a dynamic workflow』(2026-11-02 公開) |
| 影響範囲 | 長時間稼働する Agent、セッションをまたぐタスク、社内ナレッジベースの構築 |
Dreaming を理解する前に、いくつか用語を押さえておきましょう。Transcript は、ユーザーの入力、Agent の出力、ツール呼び出しとその結果を含む完全なセッション記録です。Memory Note は、過去の経験から抽出した、永続的な事実・ルール・知見のことです。Memory Store は、セッションをまたいで記憶ファイルを保存する永続ストレージを指します。Dreaming の考え方は Sleep-time Compute に近く、メインのやり取りとは別に、空いている計算リソースを使って既存のコンテキストを処理します。
Agent の記憶が過去の会話を保存するだけではうまくいかない理由
Agent の記憶を作るとき、多くのチームがまず考えるのは、すべての会話を保存しておき、必要なときに検索する方法です。しかし、過去のログ、セッションの要約、検索可能な知識は、それぞれ別物です。ログは生のイベントが積み上がったものにすぎず、要約は重要な詳細が抜け落ちることがあります。次のタスクを安定して支えられるのは、検証と整理を経た知識だけです。
会話をすべてそのまま保存すると、次の 3 つの問題が起こります。情報の重複、古くなった状態の残存、そして誤りの蓄積です。誤って書かれた記録は後続のセッションで何度も読み込まれ、間違いが事実として扱われたまま実行され続けてしまいます。Anthropic の結論は明快です。記憶は多ければ多いほどよいわけではなく、選択・検証・整理が必要です。
この違いは、Pokémon Red の実験にはっきり表れています。約 10,000 ステップの時点で、Sonnet 3.7 は 413 個のファイルと 225 個のフォルダを作成しましたが、獲得できたバッジは 1 個だけでした。一方 Fable 5 が作成したのは、通常の記憶ファイル 9 個、フォルダ 2 個、そして global.md 1 つだけでしたが、バッジは 4 個獲得しています。
差を生んだのは「何を記録するか」です。Sonnet 3.7 は、刻々と変わるゲームの状態を大量に保存していたため、記録はすぐに古くなりました。Fable 5 は、戦略、検証済みのルール、行動計画を重視していました。ここから導かれる設計原則は、長期記憶では、現在の環境から再び得ることが難しい知識を優先して残すべきだ、ということです。毎回そのまま読み取れるリアルタイムの状態は、記憶しておく必要はありません。
Claude のメモリ体系を構成する4つの層
Anthropic は、Agent のメモリを4つの層に分けています。層ごとに役割も、書き込む頻度も、読み取りにかかるコストも異なります。
| 層 | 内容 | 役割 | 読み取り方法 |
|---|---|---|---|
| Transcripts | セッションの完全な記録 | 検索可能なイベントログ。事実をさかのぼって確かめるための一次証拠 | 必要に応じて検索 |
| Memory notes | タスク中に書き留めた重要な事実、経験、ルール | 再利用できる経験を蓄積する | 必要に応じて読み取り |
| Memory representations | Wiki、インデックス、リンクなどの構造化された表現 | 知識同士の関係を整理し、ドキュメントをまたいだ検索を可能にする | ナビゲーションと検索 |
| Injected context | 価値の高い少数の記憶 | 新しいセッションの開始時にあらかじめ読み込む | 自動で注入 |
この4層は、「生の情報」から「精錬された情報」へと段階的に進んでいく構造です。Transcript は情報量が最も多い一方で、ボリュームが大きくノイズも多くなります。Injected context は最も精錬されていますが、1件ごとに新しいセッションのコンテキストウィンドウを消費します。そのため、顕著性(Salience)が最も高い情報だけに枠を絞る必要があります。
Dreaming は、これらの層をまたいでメンテナンスする役割を担います。Transcript に立ち返って古い記録を訂正し、Memory notes にある重複情報を統合します。さらに Wiki やインデックスを構築し、新しいセッションの開始時にどの内容を事前に注入するか(Context Injection)も決めます。
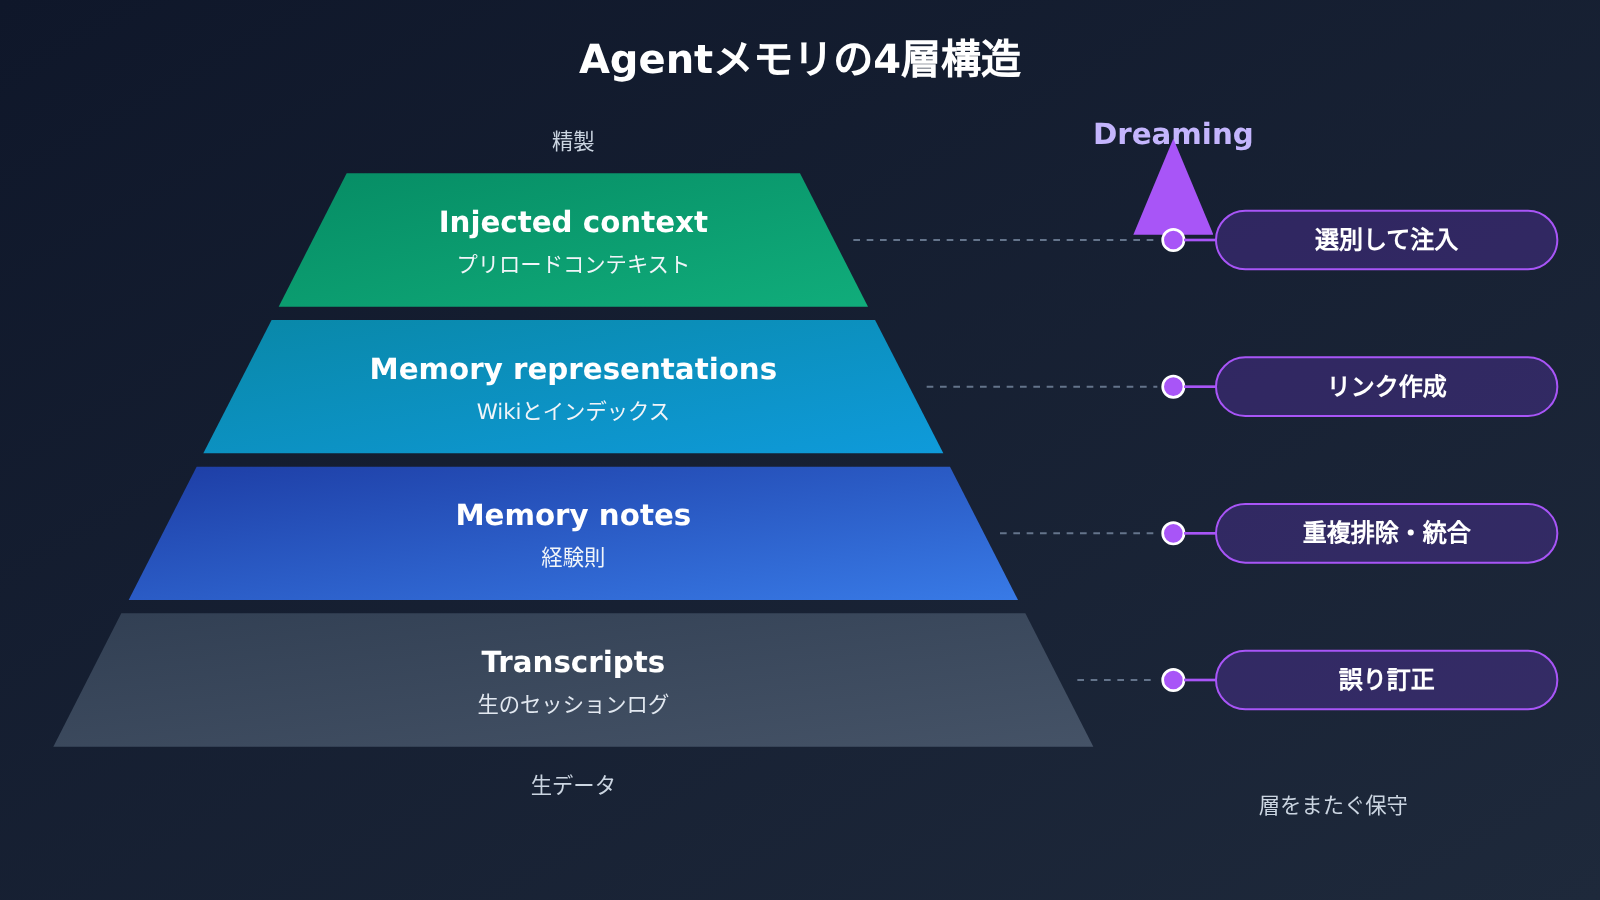
Claude Dreaming がどのように誤りを修正し、情報を整理し、ナレッジベースを構築するのか
Dreaming による誤りの修正:Mt. Moon のナビゲーション事例
Anthropic は、あるナビゲーションエラーを記録しています。Agent が Mt. Moon 付近にある Pokémon Center の方角を誤って記憶してしまい、その後のセッションでも、間違ったルートで何度も試行を繰り返していました。
Dreaming は過去の Transcript を改めて確認し、最初に誤りが記録された箇所を見つけて、メモリファイルを修正しました。修正後のメモリを使った Agent は、1,935 回目の操作で Cerulean City に到達しています。一方、誤りを修正しなかったバージョンは失敗を何度も繰り返し、最終的に目標を達成できませんでした。
この事例からわかるのは、Dreaming が単なる要約にとどまらないということです。元の経験に立ち返り、メモリの内容が今も正しいかどうかを検証できます。保存された Transcript にも新しい使い道が生まれました。何度でも見直せる証拠のライブラリになるのです。
Claude のメモリの効果:CL-Bench の実験データ
Anthropic は、CL-Bench 1.0 のデータベースタスクを使ってメモリの効果をテストしました。下の表は、公式レポートで報告されている mean reward です。
| モデル | メモリなし | メモリあり | 向上幅 |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
ご注意いただきたいのは、このデータが特定のタスクだけを対象にしたものであり、Agent のメモリ能力を汎用的に評価したスコアではないという点です。それよりも注目したいのは、モデルが強力であるほど、過去の会話をそのまま写すのではなく、検証済みのルール、エラーの原因、将来ぶつかりそうな落とし穴を記録する傾向が強いという現象です。Sonnet 4.6 では向上幅がごくわずかでした。このことから、メモリシステムの効果は、モデル自身の「記録の質」と深く結びついていると言えます。
Dreaming による Wiki ナレッジベース構築の効果
最大規模の実験では、約 350,000 件の社内ドキュメント、合計約 420M Token が使われました。Anthropic は 128 回の Dreaming セッションを通じて少しずつナレッジ Wiki を構築し、質問応答タスクで効果を評価しています。
| 検索方式 | スコア | 備考 |
|---|---|---|
| Wiki 単独(構築前 → 構築後) | 13% → 48% | Wiki が形になるにつれて効果が顕著に向上 |
| Search 単独 | 53% | ベースライン |
| Search + Wiki(構築前 → 構築後) | 54% → 61% | 1 問あたり平均で約 20,000 Token を節約 |
| M&A 関連の複数ファイルにまたがる統合タスク | Wiki 87% vs Search のみ 73% | 文書をまたぐ統合で優位性が最も明確 |
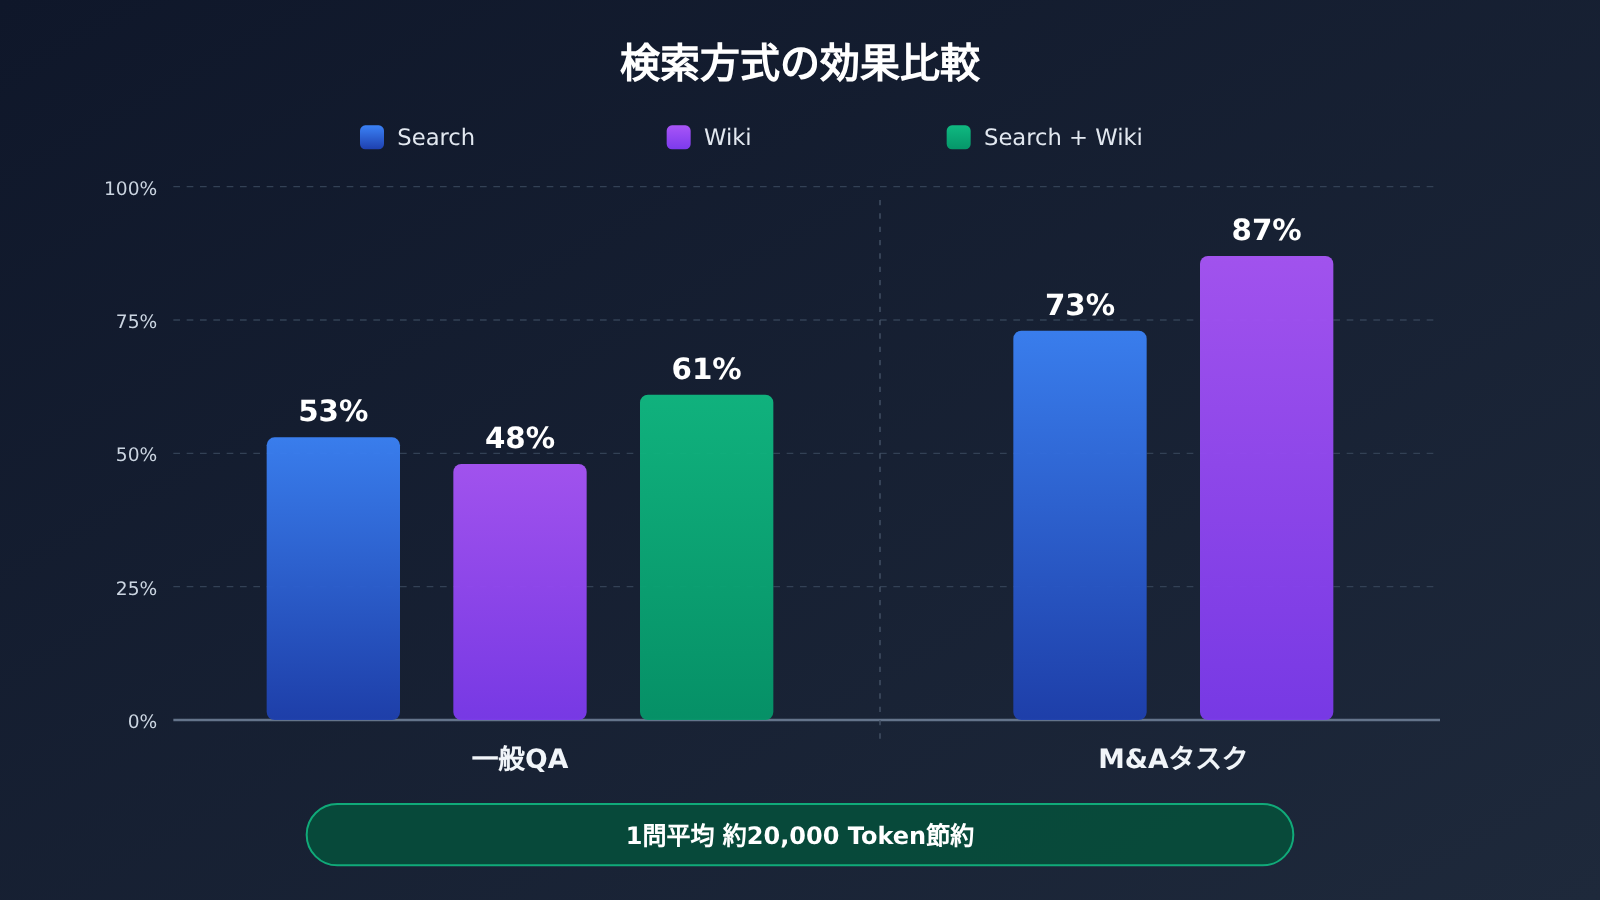
📊 図の説明:上記のデータはすべて、Anthropic のエンジニアリングブログで公開されている実験によるものです。ご自身のコーパスで同様の小規模な検証をしてみたい場合は、APIYI(apiyi.com)経由で Claude モデルを呼び出し、「検索のみ」と「検索 + 整理済み Wiki」の 2 つの方式で、効果と Token 消費量を比較してみてください。
構造化されたメモリの価値は、主に 2 つあります。1 つ目は、リンクやインデックスを作ることで、複数のファイルにまたがる情報を統合できるようになることです。2 つ目は、検索のたびに読み直す原文の量が減り、Token コストを下げられることです。
影響分析:Claude Dreaming によるメモリ整理が効く場合と逆効果になる場合
Anthropic は Dreaming を万能の解決策としては紹介しておらず、記事の中でいくつかの失敗例も挙げています。エンジニアリングの実践という点では、この部分のほうが良い結果を示すデータよりも参考になるかもしれません。
メモリ整理に伴う5種類のエンジニアリング上のリスク
- 過剰な記録:Sonnet 3.7 のように変化しやすい状態を大量に保存すると、メモリはすぐに膨れ上がり、同じ速さで古くなっていきます。
- 情報の陳腐化:環境が変わっても、メモリが古いバージョンのままになっていることがあります。情報源を照合しないと、Agent を誤った方向に導き続けてしまいます。
- 共有書き込みによる上書き:契約書整理の実験では、複数の Agent が同じ集計表に同時に書き込んだ結果、57 件の重要な事実のうち 41 件(約 72%)しか残りませんでした。契約書1件につき1ページを用意し、単一の Agent だけが書き込み、元の条項も残すようにしたところ、57 件すべてが保持されました。
- Wiki の肥大化:あるテストでは、元のファイルは 115 KB だったのに、生成された Wiki は 203 KB まで膨らみました。整理したはずが、かえって情報量が増えてしまったことになります。
- 単純なタスクでは効果なし:1つのファイルを直接検索すれば答えが見つかるような問題では、Wiki による目立った改善はなく、メンテナンスのコストが増えるだけでした。
開発者への影響
- メモリは階層化が必要:生ログ、経験則、構造化された知識、事前注入するコンテキストを分けて保存し、それぞれに異なる書き込み・読み取りの方針を持たせます。
- 情報源を追跡できること:すべてのメモリは、対応する Transcript までさかのぼれるようにしておくべきです。誤りを正すための前提条件になります。
- 書き込みは直列化するか、領域を分ける:複数の Agent が同じファイルに同時に書き込むのは避け、「1エンティティ1ページ」という構成を優先しましょう。
- 定期的なクリーンアップ:Wiki や Memory notes も、重複の排除、統合、淘汰が必要です。放っておけば、サイズは増え続ける一方です。
業界への影響
- Agent メモリの研究の重心は、「検索の精度」から「メモリそのものが正しいか、きちんとメンテナンスされているか」へと移りつつあります。
- Sleep-time Compute は標準的なアーキテクチャになる可能性があります。整理にかかるコストをアイドル時間に回すことで、メインの対話時のコンテキスト負担を減らせるからです。
- 構造化されたメモリは、複数ファイルにまたがり、やり取りが何度も続き、長期間にわたって蓄積されるタスクに向いています。一度きりの単純な質問応答であれば、純粋な検索のほうが引き続きコスト面で有利です。
開発者が Claude Dreaming の考え方を自分のエージェントに活かすには
公式 Dreams リサーチプレビューの利用条件
Anthropic の現行ドキュメントによると、Dreams は Claude Managed Agents の機能で、ステータスは Research Preview です。利用にはアクセス申請が必要です。呼び出す際は、managed-agents-2026-04-01 と dreaming-2026-04-21 の2つのベータヘッダー(Beta Header)を付ける必要があります。
入力は、既存の Memory Store と 1〜100 件の過去のセッション(Session)です。出力は新しい Memory Store で、元の Store は変更されません。タスクは非同期で実行され、通常は数分から数時間かかります。料金は、選択したモデルの標準トークン価格で課金されます。対応モデルは Opus 5.5 と Sonnet 5.5 が中心です。また、現時点では Zero Data Retention や HIPAA の要件を満たしていないため、機密データを扱う前に評価が必要です。
Cookbook に見る動的ワークフローの設計
公式の Cookbook では、自分で構築できるマルチ Agent ワークフローが紹介されています。デフォルトでは Lead Agent が全体の流れをオーケストレーションし、各 Analyzer Agent が 1 件ずつ Transcript を処理します。Organizer Agent は、重複の除去、リンクの修復、インデックスの管理を担当します。整理が完了した Memory Store は次回の Session にマウントされ、通常は読み取り専用で使います。Cron を使った定期実行にも対応していて、たとえば毎晩、直近 1 日分の Session をまとめて整理することもできます。
Cookbook にはコストの例も載っています。11 件のサンプル Transcript(合計 283 KB)では、実行時間が約 2.5 分、費用は約 $0.36 でした。長めの Transcript 50 件(約 12 MB)をコスト最適化設定で処理した場合は、約 $8、所要時間は約 10 分です。ただし、これらはあくまで特定の実験での結果であり、固定の料金ではありません。
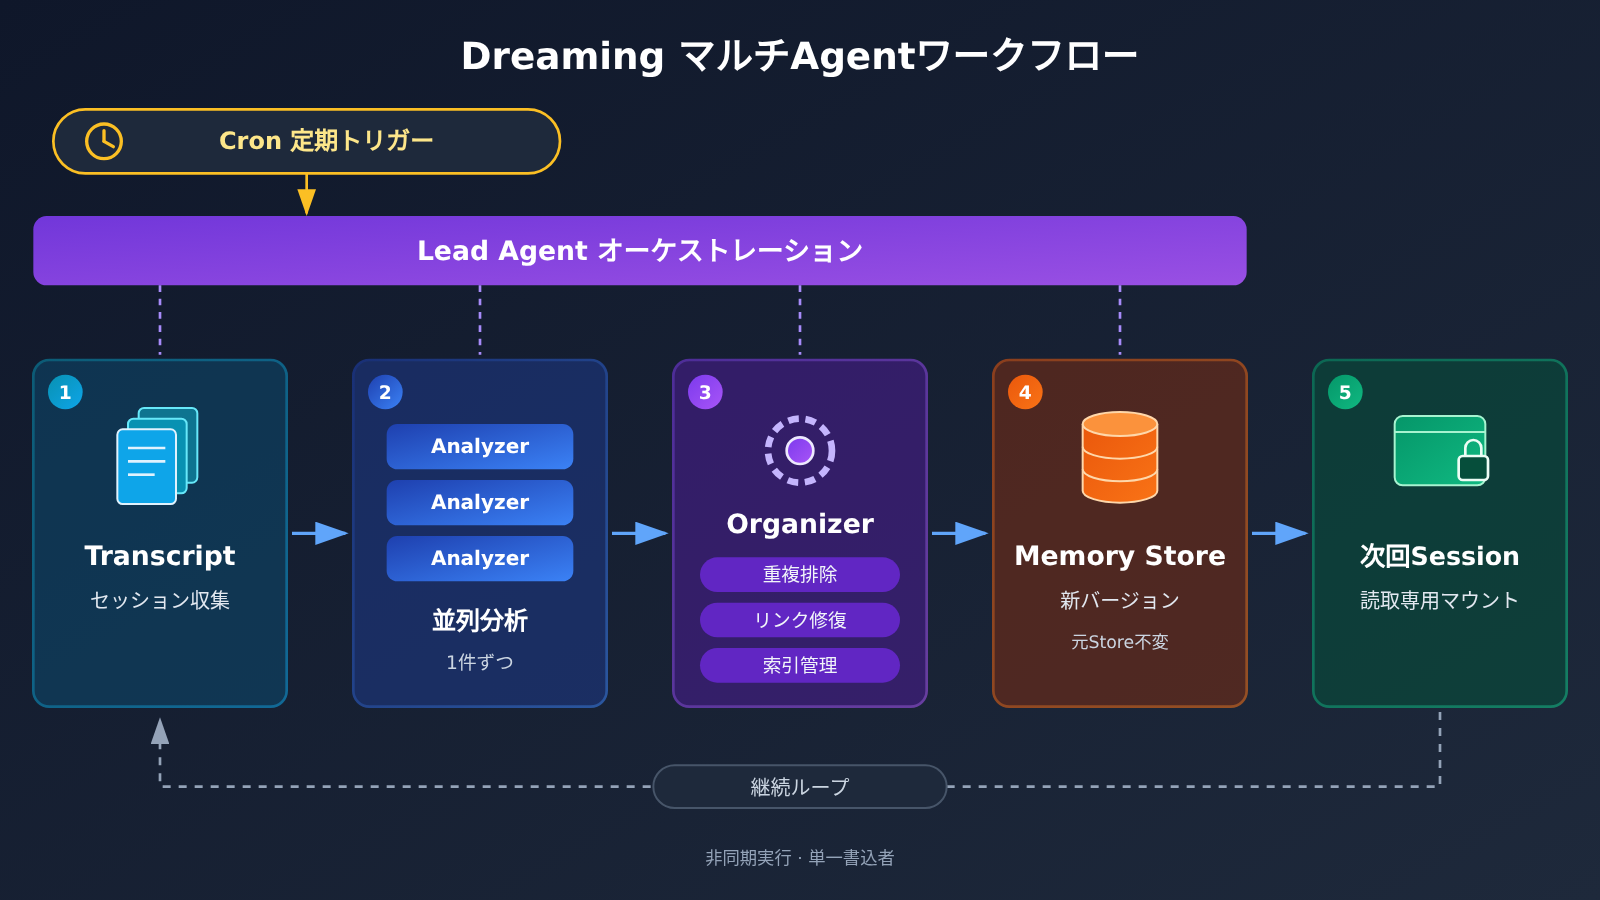
Claude モデルでセッション間のメモリ整理フローを自前で構築する
まずお断りしておきます。APIYI が提供しているのは Claude シリーズのモデル呼び出し用インターフェースで、Managed Agents、Memory Stores、Dreams API を提供しているわけではありません。ただ、Dreaming の核となる考え方、つまり「バックグラウンドで Transcript を読み、検証済みのルールを抽出し、単一の書き込み担当に整理を任せる」という流れは、通常のモデル呼び出しだけで自分で実装できます。以下は最小構成の例で、Claude にセッション記録を分析させ、メモリ候補を出力させます。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # モデル一覧で利用可能な Claude モデルに置き換えてください
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
完全な実装コードを見る(Analyzer + 単一書き込みの Organizer)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # 1 トピック 1 ページとし、単一のフローで直列に書き込むことで、並行書き込みによる上書きを防ぐ
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Cron で毎晩実行できます。次回のセッションでは memory_store のインデックスページを読み取り専用でロードします
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 すぐに試すためのヒント:プロトタイプを作るときは、APIYI(apiyi.com)を使えば、同じ API キーで複数の Claude モデルを Analyzer と Organizer として試せます。どの組み合わせがより正確にルールを抽出でき、トークン消費も少ないかを比べてから、本番環境の構成を決めましょう。
2 つのアプローチの違いは、次の表にまとめられます。
| 比較項目 | Anthropic Managed Agents Dreams | モデルAPIで自作する記憶整理 |
|---|---|---|
| 利用方法 | リサーチプレビュー。アクセス申請とBetaヘッダーが必要 | Claudeモデルのインターフェースを直接呼び出す |
| 記憶の保存先 | 公式のMemory Store。出力として新しいStoreを作成 | ファイル、データベース、Wikiなどを自分で実装 |
| スケジューリングと並行処理 | 公式の非同期タスク | Cron、キュー、単一書き込み制御を自分で実装 |
| 誤りの訂正と権限 | 公式フローに組み込み済み | 情報源の照合や権限を自分で設計する必要あり |
| 利用可能なプラットフォーム | Anthropic公式 | APIYI apiyi.com(モデル呼び出し)、公式API |
Claude Dreaming よくある質問 FAQ
Q1:Claude Dreamingとは何ですか?
Dreamingは、Anthropicが提唱するセッション間のバックグラウンド記憶メンテナンスの仕組みです。過去のTranscriptを使って古い記録を修正し、重複した情報を統合し、Wikiやインデックスを構築します。さらに、新しいセッションの開始時にあらかじめ注入しておくべき価値の高いコンテキストを選び出します。
Q2:Dreamingは、通常のセッション要約やベクトル検索と何が違いますか?
要約は情報を圧縮するだけで、検索は情報を見つけるだけです。一方Dreamingは、元のTranscriptに立ち返って、記憶が今も正しいかどうかを検証します。たとえばMt. Moonの事例では、誤っていた方角が修正されました。さらにドキュメント間のリンクも作成します。複数ファイルをまたぐ統合タスクでは、Wikiのスコアが87%、検索のみでは73%でした。
Q3:Claude Dreamingは今すぐ使えますか?
関連するエンジニアリングブログは2026年11月6日に公開されました。Dreamsは現在、Claude Managed Agentsの中でResearch Previewとして提供されています。利用にはアクセス申請が必要で、呼び出す際には2つのBetaヘッダーを付ける必要があります。
Q4:Managed Agentsへのアクセス権がなくても、Dreamingの考え方を取り入れられますか?
できます。「Transcriptの収集、バックグラウンド分析、単一書き込みでの整理、読み取り専用マウント、定期メンテナンス」という流れに沿えば、通常のモデル呼び出しだけで簡易版を実装できます。APIYI apiyi.com を使えば、OpenAI互換のインターフェースでClaudeモデルを呼び出し、分析や整理を行えます。ただし、ストレージ、スケジューリング、権限管理は自分で実装する必要があります。
Q5:APIYIはClaude Dreamingの機能を直接提供していますか?
提供していません。APIYI apiyi.com が提供しているのはClaudeなどのモデル呼び出し用インターフェースで、AnthropicのManaged Agents、Memory Stores、Dreams APIは含まれません。モデルを呼び出して独自の記憶整理フローを組む用途に向いています。新規ユーザーは、まず無料のテスト枠で方式を検証できます。
Q6:Dreamingにはどんな既知の制限がありますか?
1つのファイルだけで答えられるような単純な質問では、Wikiの効果ははっきり出ません。整理によってデータ量が膨らむこともあり、たとえば115 KBの原文から203 KBのWikiが生成された例があります。複数のAgentが共有して書き込むと、事実が失われる場合があります。また、公式のDreamsはZDRやHIPAAの要件にまだ対応しておらず、タスクの所要時間は数分から数時間までまちまちです。
Claude Dreaming の重要ポイント Key Takeaways
- メモリは「保存」だけでは足りない:会話をすべて保存すると、重複・古い情報・誤りが積み重なります。検証と整理が欠かせません。
- 4層のメモリ構造:Transcripts、Memory notes、Memory representations、Injected context が、それぞれ役割を分担します。
- 誤りの訂正は元の記録が頼り:Dreaming は Transcript に戻って内容を照合し、失敗を繰り返す原因だった誤った位置情報を修正しました。
- Wiki はドキュメントをまたぐタスクが得意:M&A タスクでは Wiki のスコアが 87%、検索のみでは 73% でした。1問あたり平均で約2万トークンの節約にもなります。
- 整理には副作用もある:同時書き込みで事実が失われることがあり、Wiki は肥大化しやすく、単純なタスクでは出番がありません。
- 自前での構築も可能:APIYI(apiyi.com)経由で Claude モデルを呼び出せば、セッション間のメモリ整理を簡易版として実現できます。
まとめ
Claude Dreaming から得られるヒントは、大きく3つあります。
- 長期メモリの核心はメンテナンス:検証・重複排除・整理を経たメモリだけが、次のタスクを安定して支えてくれます。
- 「何を覚えるか」は「どれだけ覚えるか」より重要:環境から再取得しにくいルール、エラーの原因、落とし穴を優先して記録しましょう。変化しやすい状態は記録しないのがコツです。
- 構造化メモリは場面に応じて選ぶ:ファイルをまたぐ、複数ターンにわたる、長期間蓄積されるタスクには Wiki を導入する価値があります。単純な検索タスクなら、わざわざメンテナンスの手間を増やす必要はありません。
すでに Agent を複数のセッションにまたがって運用しているなら、まずは「Transcript を保存し、毎晩1回シリアルに整理し、インデックスページを読み取り専用でマウントする」という最小構成から始めてみてください。この流れを手早く検証するには、APIYI(apiyi.com)経由で Claude モデルを呼び出すのがおすすめです。OpenAI 互換インターフェースを提供しており、新規ユーザーは無料のテストクレジットも利用できます。
📚 参考資料
- The components of agent memory:Anthropic エンジニアリングブログの原文。4層のメモリ構造と Dreaming の実験について紹介しています
- リンク:
anthropic.com/research/components-of-agent-memory -
補足: CL-Bench、Pokémon、Wiki、契約書整理などの実験データの一次情報です
-
Dreaming with a dynamic workflow:Claude 公式 Cookbook
- リンク:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
補足: Lead、Analyzer、Organizer によるマルチ Agent ワークフローの例と、コストの目安を掲載しています
-
Anthropic 公式 X の投稿:Dreaming エンジニアリングブログの公開告知
- リンク:
x.com/AnthropicAI/status/2118814753154064501 - 補足: 公開時期と公式の位置づけを確認できます
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。さらに詳しい資料は docs.apiyi.com のドキュメントセンターでご覧いただけます


