
著者注:OpenAI公式のchangelog原文をもとに、GPT-6-Cyberの位置づけ、利用前に必要な準備、現時点で公開されていない情報を整理します。
2026年11月5日、OpenAIは開発者ドキュメントのchangelogに新たな記録を追加し、セキュリティ用途に特化したモデルGPT-6-Cyberの提供を発表しました。公式が挙げた用途は、脆弱性の調査、許可されたテスト環境での脆弱性の再現、修正の検証です。また、最初のリクエストを送信する前にDaybreakのセットアップを完了する必要があると案内しています。
これは噂話ではありません。情報源はOpenAIの開発者ドキュメントにある公式changelogです。ただし、公式の記述は短く、現時点で確認できる内容は限られています。価格やベンチマークスコア、利用可能な範囲については、すでにネット上でさまざまな情報が出回っていますが、公式資料にはその根拠が見当たりません。
この記事のポイント:公式原文だけをもとに、GPT-6-Cyberでできること、利用上の境界、今後の公式発表を待つ必要がある情報を整理します。今すぐ評価に取り組むべきか判断する際にお役立てください。
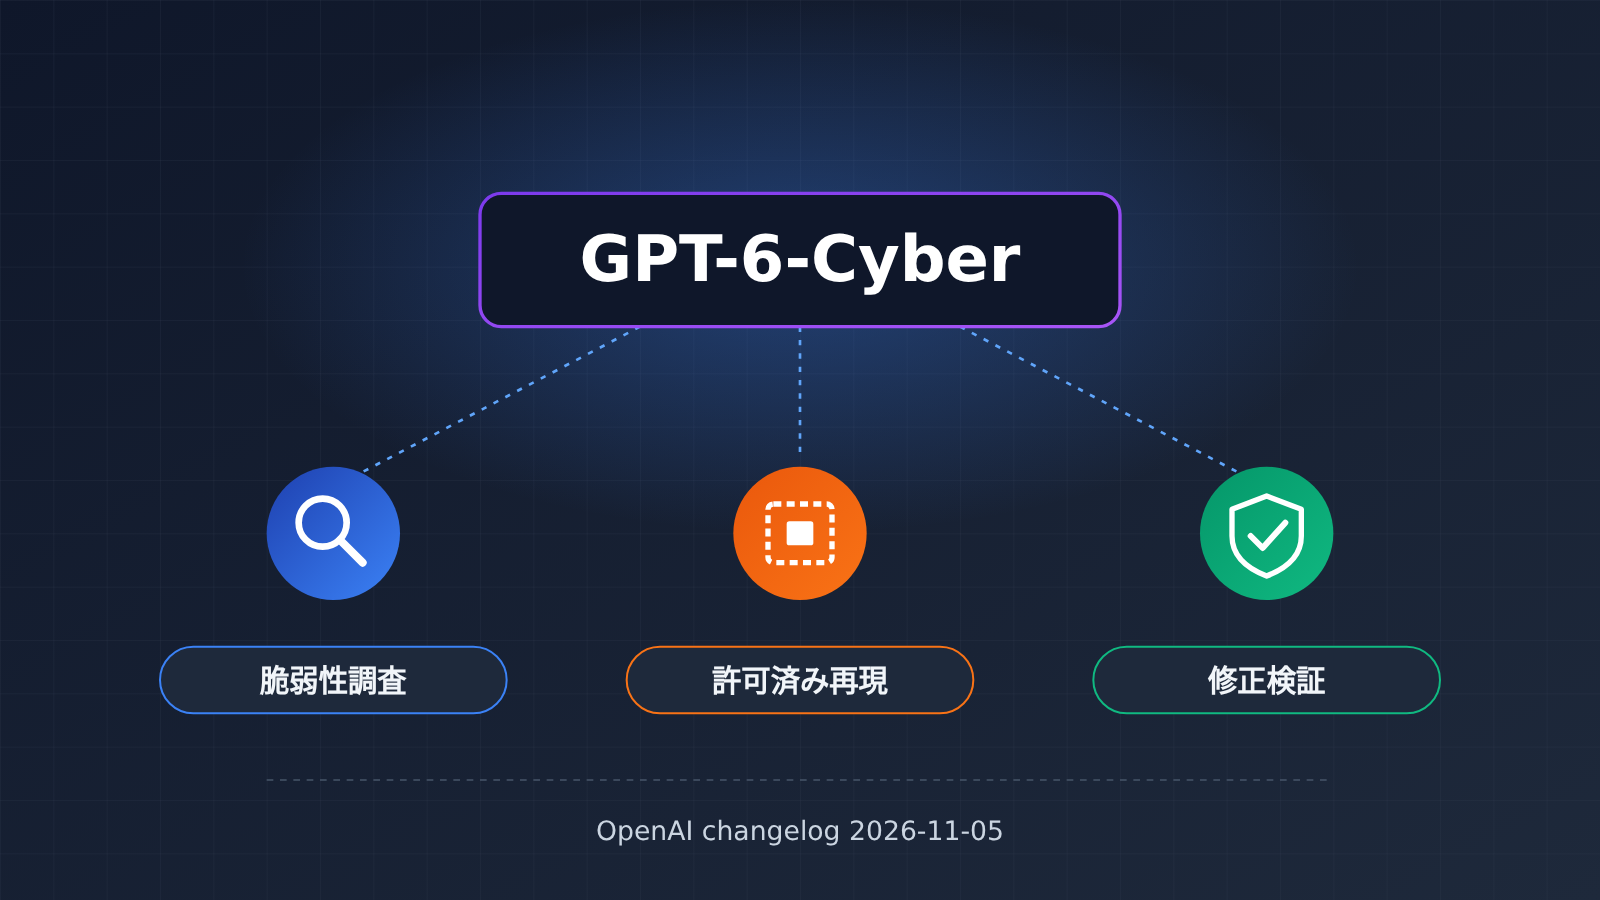
GPT-6-Cyber の主要情報
まず、公式の原文から確認できる情報を整理します。下表には changelog に明記された内容だけを掲載し、それ以外の項目はすべて「非公開」としています。
| 項目 | 詳細 | 出典の確認状況 |
|---|---|---|
| 公開日 | 2026-11-05(changelog の記録日) | ✅ 公式確認済み |
| 提供元 | OpenAI。開発者向けドキュメントの changelog で公開 | ✅ 公式確認済み |
| モデル名 | GPT-6-Cyber | ✅ 公式確認済み |
| 公式の用途 | 脆弱性の調査、許可されたテスト環境での再現、修正の検証 | ✅ 公式確認済み |
| 利用前の準備 | 最初のリクエストを送る前に Daybreak setup を確認し、完了する必要がある | ✅ 公式確認済み |
| 料金 / アクセス条件 / インターフェースのパラメータ | changelog には記載なし | ❓ 非公開 |
この記録から、OpenAI による GPT-6-Cyber の位置付けは明確です。セキュリティエンジニアリングのワークフローを支援する専用モデルであり、汎用の対話モデルではありません。公式は用途を「脆弱性」に関する作業に絞り、最初の文で「authorized test environment」(許可されたテスト環境)と明記しています。つまり、利用範囲の制限は追加条項ではなく、製品の位置付けそのものに含まれています。
GPT-6-Cyber の Daybreak setup とは
changelog の原文には「See Daybreak setup before sending your first request」とあり、最初のリクエストを送る前に Daybreak setup を確認するよう求めています。この一文からは、2つのことが読み取れます。1つ目は、GPT-6-Cyber は APIキーを取得すればすぐに呼び出せるモデルではない可能性が高いこと。2つ目は、OpenAI が専用の接続手順を用意していることです。
ただし、Daybreak setup の具体的な内容は、現在の資料では明らかになっていません。利用資格の申請、組織の審査、本人確認が必要なのか、単なる技術的な設定なのかも不明です。公式ドキュメントで詳細が示されるまでは、二次情報を正確な手順として受け取らないほうがよいでしょう。
GPT-6-Cyber の3つの主な用途を理解する
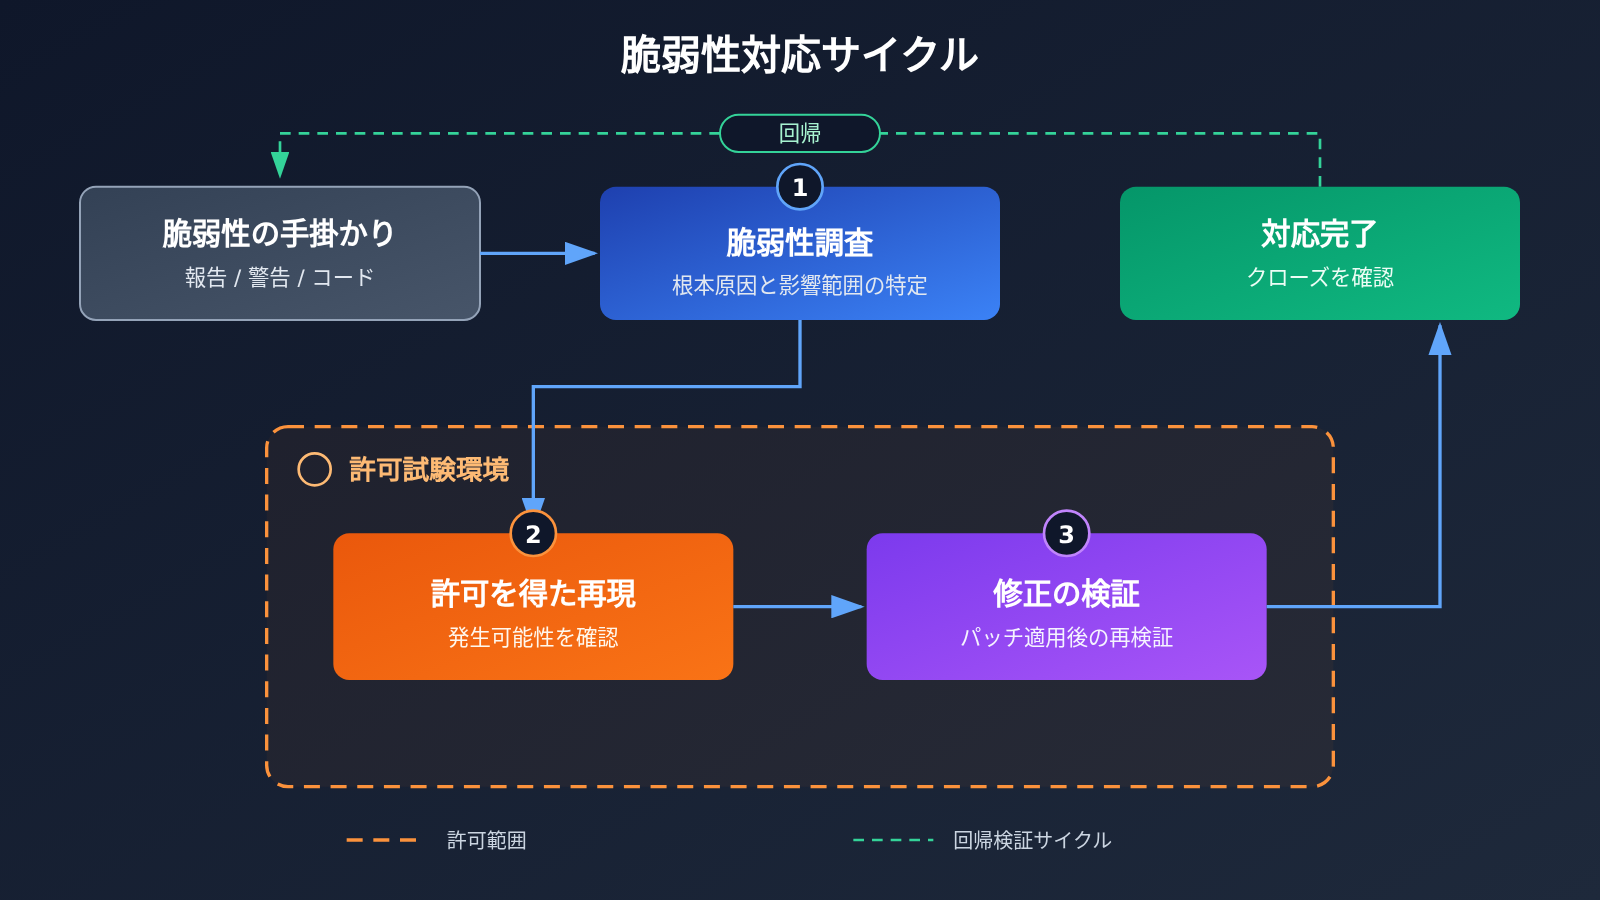
公式の原文では、investigate、reproduce、verify という3つの動作が挙げられています。これらをつなげると、セキュリティチームが脆弱性を処理する一連の流れになります。ここでは一般的なセキュリティエンジニアリングの実践に照らして、それぞれの段階を説明します。この説明は業界の一般的な知識に基づくものであり、OpenAI によるモデルの能力に関する公式な説明ではありません。
| 段階 | 公式の表現 | セキュリティワークフローにおける意味 | 主な成果物 |
|---|---|---|---|
| 脆弱性の調査 | investigate vulnerabilities | 脆弱性の手がかりを分析し、根本原因、発生条件、影響範囲を特定する | 根本原因の分析、影響評価 |
| 許可された環境での再現 | reproduce them in an authorized test environment | 許可されたテスト環境で、脆弱性が実在し、発生することを確認する | 再現手順、検証記録 |
| 修正の検証 | verify fixes | パッチの適用前後に再テストし、脆弱性が解消され、新たな問題が生じていないことを確認する | 回帰テストの結果、修正の確認 |
GPT-6-Cyber による脆弱性の調査
脆弱性の調査は通常、一つの手がかりから始まります。外部から提出された脆弱性報告やスキャンツールのアラート、コード監査で見つかった不審なロジックなどがその例です。調査の目的は、問題がどこにあり、どのような条件で発生し、どのシステムやデータに影響するかを明らかにすることです。この段階ではコードやシステムの背景を理解することが欠かせず、セキュリティチームが最も時間を費やす作業の一つでもあります。
GPT-6-Cyber による許可された環境での再現
再現は、脆弱性が「本当に存在するのか」を判断するための重要なステップです。脆弱性報告の多くは理論上の推測にとどまっており、実際の環境で発生を確認して初めて、チームは優先順位を決め、修正に必要なリソースを割り当てられます。公式では、再現は必ず「authorized test environment(許可されたテスト環境)」で行う必要があると強調しています。この点は次の節で詳しく説明します。
GPT-6-Cyber による修正の検証
修正の検証は、しばしば過小評価されます。パッチを書き終えたからといって、問題が解決したとは限りません。実際には、パッチが発生経路の一部しかカバーしていなかったり、修正によって新たな回帰の問題が生じたりすることもあります。検証では、再現時と同じ方法で再テストし、元の攻撃経路が使えなくなったことを確認する必要があります。公式がこの段階を用途の一つとして明記していることから、GPT-6-Cyber は単に「脆弱性を見つける」だけでなく、発見から対応完了までの一連の流れを対象としていることがわかります。
GPT-6-Cyber の「認可されたテスト環境」が持つコンプライアンス上の意味
今回の changelog で最も注目すべき表現が「authorized test environment(認可されたテスト環境)」です。脆弱性の再現は、使い方によって安全にも危険にもなります。同じ再現手順でも、自社のテスト環境で実施すればセキュリティ業務ですが、許可のない本番システムで実施すれば攻撃行為になりかねません。OpenAI がモデルを紹介する一文にこの限定を明記したことは、製品レベルで利用の境界を設けたことを示しています。
OpenAI は現時点で、「認可されたテスト環境」の具体的な定義や関連ポリシーの詳細を公開していません。業界の一般的な慣行に照らすと、企業が同様のツールを導入する際は、通常、以下の点に注意します。社内での準備の参考にしてください。
- 認可範囲の明確化:テスト対象が自組織に属しているか、資産所有者から書面による許可を得ており、範囲と実施時間帯が記録されている
- 環境の分離:再現は独立したテスト環境またはプレリリース環境で行い、本番データや実際のユーザーから分離する
- プロセスの監査可能性:誰が、いつ、どの対象に対して、どのようなテストを行ったかをログに残す
- データの最小化:モデルに送るコード、ログ、設定は可能な限り機密情報を除き、キーやユーザーデータの漏えいを防ぐ
企業の技術チームにとって、GPT-6-Cyber の評価は単なる技術選定にとどまらず、セキュリティ、法務、コンプライアンスの各チームも参加する必要があるということです。公式ポリシーが公開されたら、社内のペネトレーションテストの認可手続きと照らし合わせ、両者を整合させられるか確認することをおすすめします。
GPT-6-Cyberの確認済み情報と未公開情報
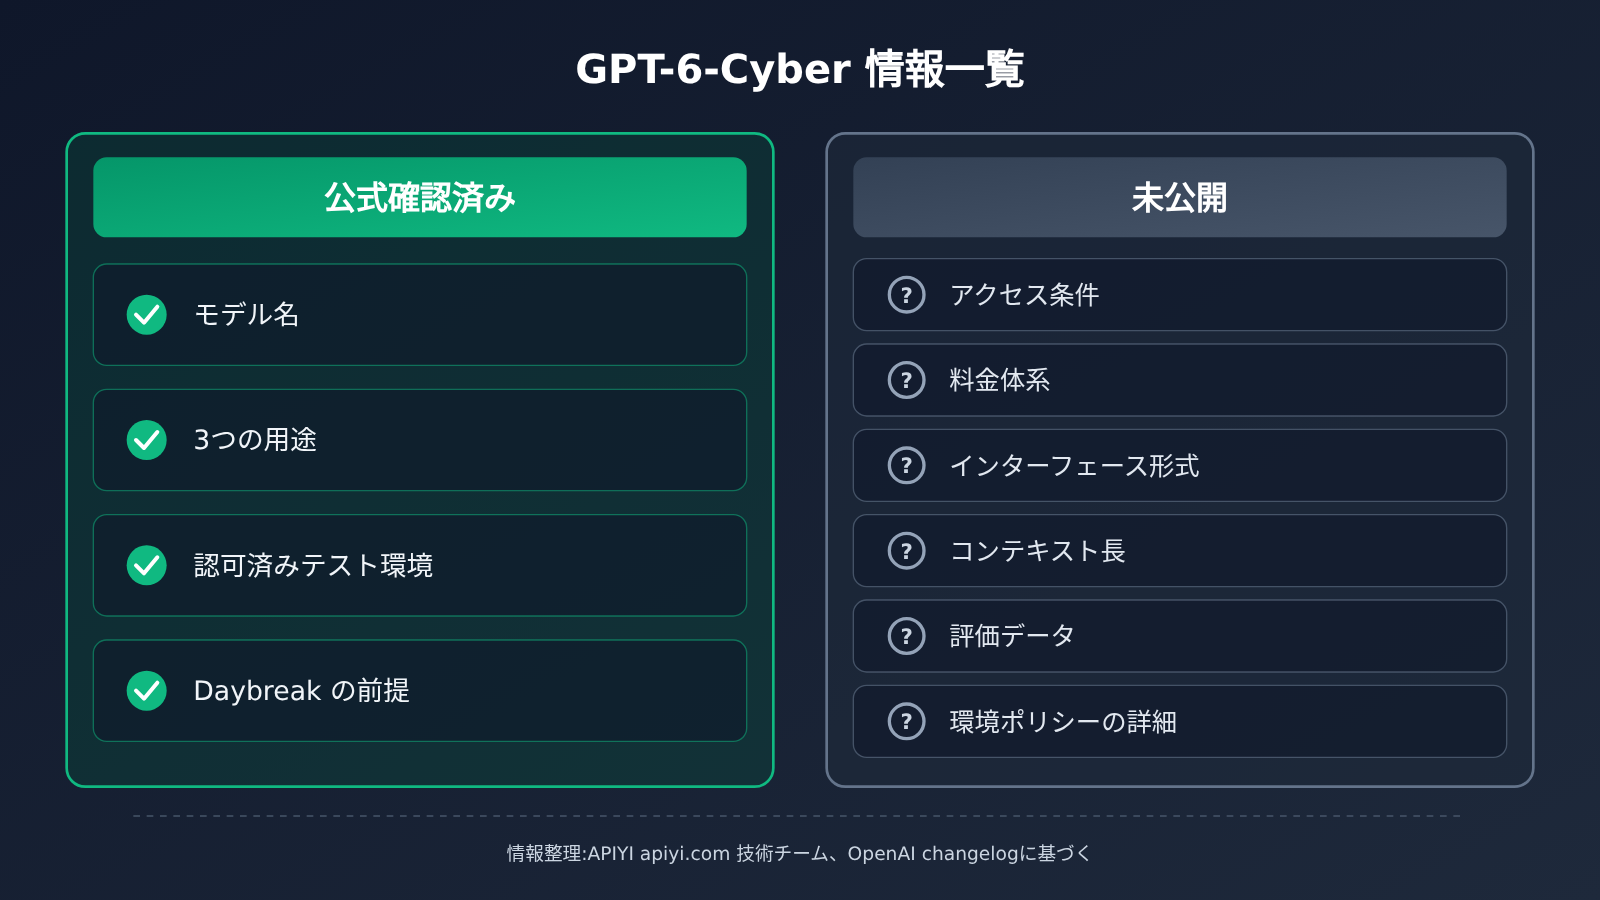
現在、さまざまな情報が出回っています。以下では、情報を「公式に確認済み」と「未公開」の2つに分けて整理します。評価を始める前に一項目ずつ確認し、未確認の内容は社内の計画に盛り込まないようにしましょう。
| 確認項目 | なぜ重要か | 現在の状況 |
|---|---|---|
| アクセス条件 | 一般公開されるか、組織や利用者が限定されるか、審査が必要か | 未公開 |
| Daybreak setupの手順 | 申請から初回のモデル呼び出しまでにかかる時間を左右する | 事前確認が必要とされているのみで、詳細は未公開 |
| 価格と課金方式 | 大規模なコード監査や回帰テストのコストに影響する | 未公開 |
| インターフェースの形式 | Chat CompletionsやResponsesなどへの対応状況によって、統合時の改修コストが変わる | 未公開 |
| コンテキスト長などの技術仕様 | 大規模なコードベースや長いログを一度に処理できるかに影響する | 未公開 |
| 能力評価データ | 汎用モデルとの実際の性能差を把握するために必要 | 未公開 |
| 許可されたテスト環境に関するポリシー | 規約に沿って利用できる範囲を確認するために必要 | 未公開 |
特に注意したいのは、現時点でGPT-6-Cyberのベンチマークスコア、汎用モデルとの比較データ、価格情報を示した公式資料は存在しないことです。具体的な数字を含む情報を見かけた場合は、まずOpenAIの公式ドキュメントに基づくものか確認しましょう。
📌 比較のポイント:公式にアクセスが開放されたら、同じ社内の脆弱性サンプルを使い、GPT-6-Cyberと現在使用している汎用モデルをそれぞれテストすることをおすすめします。汎用モデルのベースラインは、APIYI apiyi.comの統一インターフェースを通じて事前に準備しておけば、すぐに比較できます。
GPT-6-Cyber の評価に向けた準備
利用条件が明らかになる前に、新モデルに依存しない準備を進めておくことができます。現実的な方法としては、まず既存の汎用モデルで「脆弱性レポートを整理する」小さなワークフローを構築し、サンプルと評価基準を蓄積しておくことです。GPT-6-Cyber が公開されたら、モデル名を切り替えて比較テストを行えます。
以下の例では、OpenAI 互換インターフェースで汎用モデルを呼び出し、脆弱性レポートを構造化して整理します。なお、GPT-6-Cyber の API モデル識別子と接続方法は、現時点で公式には発表されていません。例中のモデル名は、実際に利用可能なモデルに置き換えてください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

response = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # 実際に利用可能な汎用モデルに置き換える
    messages=[{"role": "user", "content": "请把以下漏洞报告整理为:根因、触发条件、影响范围、修复建议四部分。\n<报告内容>"}]
)
print(response.choices[0].message.content)
完全な実装コードを見る(機密情報のマスキングと構造化出力を含む)
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース。後でモデルを切り替えて比較しやすい
)

SYSTEM_PROMPT = (
    "你是企业内部的安全工程助手,只处理已获授权的内部资产。"
    "请将漏洞报告整理为:根因、触发条件、影响范围、复现前提、修复建议、验证要点。"
    "不要输出针对第三方系统的攻击步骤。"
)

def redact(text: str) -> str:
    """送信前に基本的な機密情報をマスキングする: キーと思われる文字列、メールアドレス、社内 IP を除去"""
    text = re.sub(r"(?i)(api[_-]?key|secret|token)\s*[:=]\s*\S+", r"\1=<REDACTED>", text)
    text = re.sub(r"[\w.+-]+@[\w-]+\.[\w.]+", "<EMAIL>", text)
    text = re.sub(r"\b10\.\d+\.\d+\.\d+\b", "<INTERNAL_IP>", text)
    return text

def triage_report(report: str, model: str, extra_context: Optional[str] = None) -> str:
    content = redact(report)
    if extra_context:
        content += "\n\n补充上下文:\n" + redact(extra_context)
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content},
            ],
            temperature=0.2,
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

if __name__ == "__main__":
    sample = "登录接口在 token=abc123 时未校验过期时间,联系人 [email protected],服务器 10.0.3.15"
    # モデル名を実際に利用可能なモデルに置き換える。GPT-6-Cyber 公開後はここで比較テストができる
    print(triage_report(sample, model="YOUR_MODEL_NAME"))
🚀 クイックスタート:まず上記のワークフローを試してみたい場合は、APIYI apiyi.com に登録すると無料のテスト枠を取得できます。1つの APIキーで OpenAI、Claude、Gemini などの主要な汎用モデルを呼び出せるため、評価のベースラインを事前に構築するのに便利です。なお、APIYI が GPT-6-Cyber に対応するかどうかは現時点で確認されていません。プラットフォームのお知らせをご確認ください。
後の比較テストで条件をそろえられるよう、次の表に評価時に注目したい項目をまとめています。準備段階では、汎用モデルを使って最初の3項目のサンプルと評価基準を作成しておけます。
| 評価項目 | 準備期間にできること | 新モデル公開後の確認ポイント |
|---|---|---|
| 根本原因の特定精度 | 対応が完了した社内の脆弱性を正解データとして収集する | 汎用モデルの結論との違い |
| 再現手順の実用性 | 隔離環境で手動の再現手順を記録する | 生成された手順を許可済みの環境でそのまま実行できるか |
| 修正検証の網羅性 | 過去のパッチと回帰テストケースを整理する | パッチが見落とした脆弱性の発生経路を発見できるか |
| コンプライアンスとデータセキュリティ | データの匿名化ルールと権限リストを策定する | 公式ポリシーと社内プロセスが合致しているか |
GPT-6-Cyber の影響分析
開発者と企業の技術チームへの影響
- セキュリティワークフローに専用モデルという選択肢が加わる可能性:これまで汎用モデルで脆弱性を分析するには、プロンプトで多くの制約を指定する必要がありました。専用モデルの登場により、脆弱性対応に適したツールを選べるようになりますが、実際の効果は実機での検証が必要です。
- 導入のハードルが通常のモデルより高くなる可能性:Daybreak setup の前提条件から、呼び出し前に追加の手順が必要であることがわかります。チームは時間に余裕を持ち、セキュリティとコンプライアンスの責任者に早い段階から参加してもらう必要があります。
- 「許可」がチームの自主的な取り組みから製品の要件に:公式の用途説明には許可済みのテスト環境が明記されており、企業内の許可記録や監査プロセスがより重要になります。
セキュリティ業界への影響
- モデル提供企業が用途別にセキュリティ機能を分け始めた:OpenAI がセキュリティ用途を独立したモデルとして切り分け、専用の導入プロセスを設けたことは、大規模言語モデルの提供企業による高リスクな用途への対応が、よりきめ細かくなっていることを示しています。
- 修正の検証がより重視される:公式が「修正の検証」を「調査」と並べて挙げていることは、発見件数だけでなく、脆弱性の発見から修正・検証までの一連の対応に業界の関心を向ける後押しとなります。
よくある質問 FAQ
Q1: GPT-6-Cyber とは何ですか?
GPT-6-Cyber は、OpenAI が 2026-11-05 に開発者向け changelog で発表したセキュリティ専用モデルです。公式発表によると、脆弱性の調査、許可されたテスト環境での脆弱性の再現、修正の検証に使用されます。
Q2: GPT-6-Cyber と汎用 GPT モデルの違いは何ですか?
公式の説明によると、汎用モデルが幅広いタスクを対象とするのに対し、GPT-6-Cyber は脆弱性への対応を一通り行うことに特化しています。また、事前に Daybreak setup を完了し、許可されたテスト環境で使用する必要があります。両者の能力差については、現時点で公式の評価データがないため、数値による比較はできません。
Q3: GPT-6-Cyber は今すぐ呼び出せますか?
公式には、初回リクエストの前に Daybreak setup を確認する必要があると説明されていますが、一般公開されているか、申請や審査が必要かは明らかになっていません。二次情報に頼らず、OpenAI の開発者ドキュメントで今後の案内を確認することをおすすめします。
Q4: GPT-6-Cyber の料金はいくらですか?
公式 changelog には料金や課金方式が記載されていません。公式に発表されるまでは、具体的な料金を確認することはできません。セキュリティ分析タスクの呼び出しコストを先に見積もりたい場合は、APIYI apiyi.com で汎用モデルを使って複数のサンプルを実行し、トークン消費量の参考データを得ることができます。
Q5: 利用開始を待つ間に、どのような準備ができますか?
まずは、社内で対応が完了した脆弱性のサンプルを整理し、機密情報の除去や利用許可に関するルールを定めることをおすすめします。また、汎用モデルでレポートを整理するフローを構築すれば、評価の基準として活用できます。APIYI apiyi.com の OpenAI 互換インターフェースを使えば、同じコードで複数の汎用モデルを切り替えて比較でき、後から新しいモデルを導入する際の変更も比較的少なく済みます。
Q6: 「許可されたテスト環境」とは具体的に何ですか?
OpenAI はまだ公式な定義を公開していません。業界の慣例では、一般に、対象資産が自組織に属するか書面による許可を得ており、本番環境から分離され、操作を監査できるテスト環境を指します。具体的な範囲については、公式ポリシーの発表をご確認ください。
GPT-6-Cyber のポイント Key Takeaways
- 公式の位置づけは明確:GPT-6-Cyber は脆弱性の調査、許可された環境での再現、修正の検証という3つの工程を対象としています
- 利用には事前準備が必要:初回リクエスト前に Daybreak setup を確認する必要がありますが、具体的な手順は公開されていません
- 許可は厳守すべき境界:再現は authorized test environment に限定されるため、企業には適切なコンプライアンス手続きが必要です
- 重要な情報は未公開:アクセス条件、価格、インターフェースの形式、技術仕様、評価データはいずれも公表されていません
- 比較の基準を事前に準備:APIYI apiyi.com の汎用モデルで先に評価フローを構築し、公式に利用可能になってから比較できます
まとめ
現時点で確認できる GPT-6-Cyber のポイントは次のとおりです。
- 用途:脆弱性の調査、許可されたテスト環境での再現、修正の検証まで一連の流れをカバーします
- 前提条件:初回呼び出し前に Daybreak setup を完了する必要がありますが、手順の詳細は公式からの追加情報待ちです
- 利用の境界:公式の短い紹介文にも「許可されたテスト環境」と明記されており、コンプライアンス面の準備は技術評価と同じくらい重要です
多くのチームにとって、今は未確認の情報をもとに急いで判断するよりも、公式ドキュメントの更新に注目しながら、サンプル、評価基準、許可を得るための手続きを準備するのがよいでしょう。まずは APIYI apiyi.com の汎用モデルで評価フローを一通り試しておくと、GPT-6-Cyber のアクセス条件が明らかになった後、速やかに比較テストを実施できます。
📚 参考資料
- OpenAI API Changelog:GPT-6-Cyber のリリース記録(2026-11-05)
- リンク:
developers.openai.com/api/docs/changelog - 説明:本記事に記載された公式情報の出典です。モデルの用途説明と Daybreak setup の事前案内が含まれます。
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイトトップページからお気軽にお問い合わせください。接続に関する詳しい資料は、docs.apiyi.com のドキュメントセンターでご覧いただけます。


