
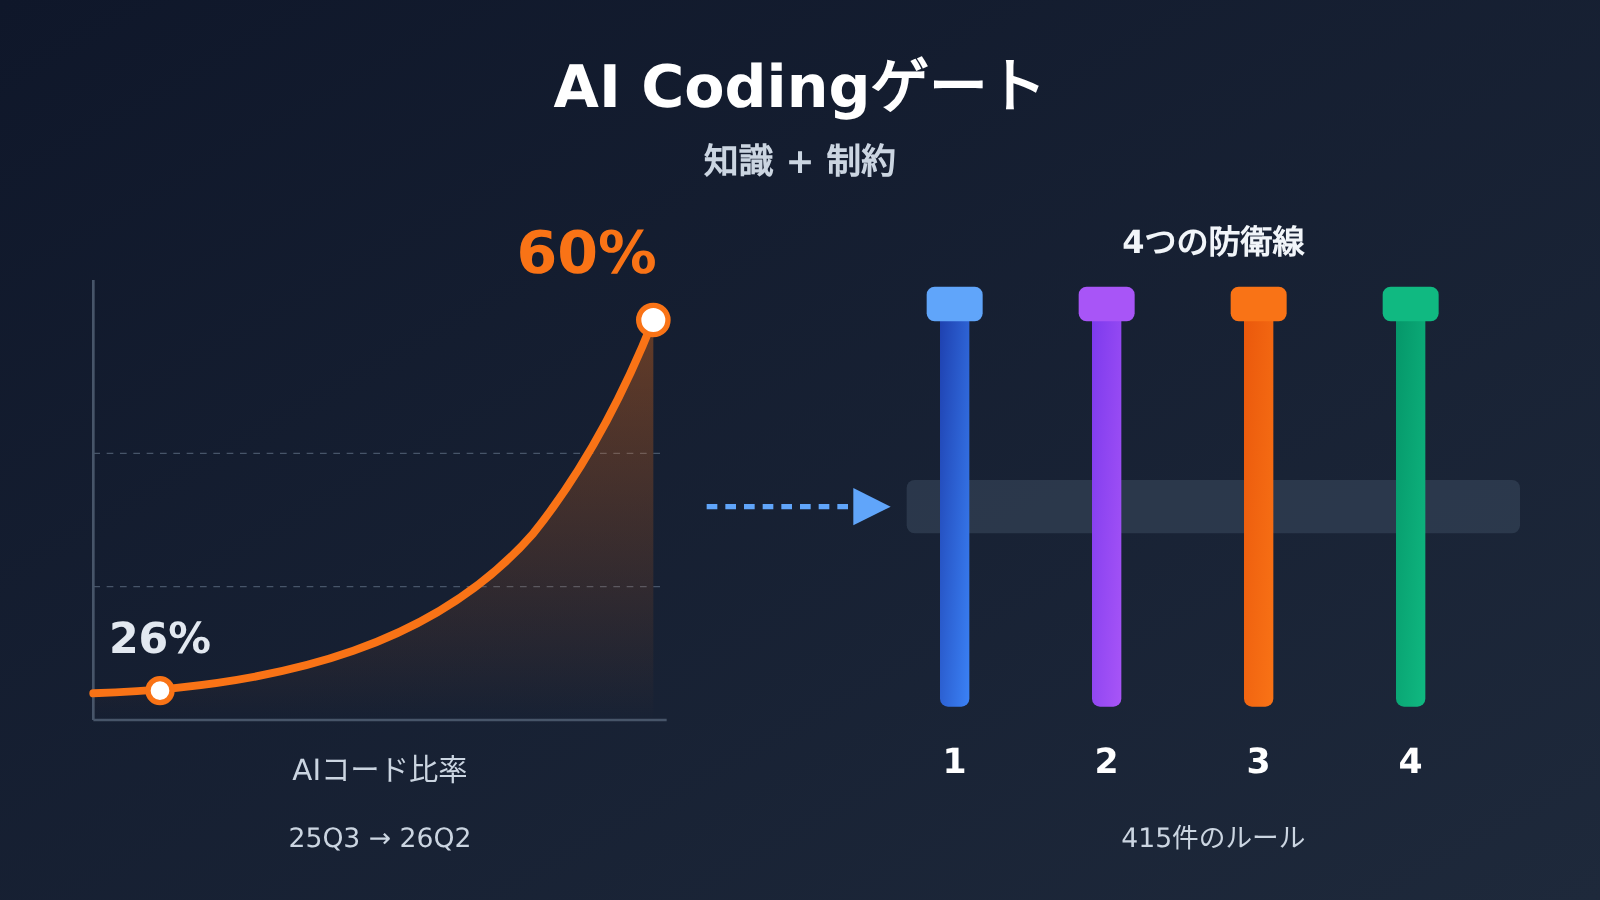
著者注:快手では、AIが生成したコードの割合が1年で26%から60%に上昇しました。この記事では、AI Codingの典型的な失敗パターンと、「知識+制約」を両輪とする取り組み、4つの階層別防御を整理し、チームで照らし合わせて使えるセルフチェックの枠組みにまとめます。
快手では、AIが生成したコードの割合が25Q3の26%から26Q2には60%に上昇しました。もはや生成速度はボトルネックではありません。真の課題は、検証手段が生成速度に追いつけるかどうかです。快手の技術エキスパート、熊紀元氏はAICon北京で「AI Codingの追加リスク管理:SkillゲートとHarnessの実践」をテーマに講演する予定です。その予告では、すでに多くの重要な情報が公開されています。
これは「AIが書くコードは危険だ」というだけの一般論ではありません。予告によると、本番環境ですでに複数の障害が見つかっており、問題を検出するSkillは累計3000件以上の問題を発見しています。管理の仕組みとしては、7種類、計415件のルールが整備されています。ただし、現時点の資料はあくまで講演予告です。検出精度や見逃し率・誤検知率、障害の減少幅といった効果を示すデータは、正式な講演で公開されるのを待つ必要があります。
この記事でわかること:AIが生成したコードの5つの典型的な失敗パターンと、「知識+制約」に4つの防御層を組み合わせた管理の枠組みを理解できます。また、自分たちのチームのチェック体制がAIの生産速度に追いついているかを確認できます。
AI Codingゲート管理の要点
まず、セッション予告の主要な情報を一つの表にまとめ、快手におけるAI Codingガバナンスの全体像を見ていきましょう。
| 項目 | 詳細 |
|---|---|
| 発表の場 | AICon 人工知能開発・応用カンファレンス・北京、2026年12月18–19日 |
| 所属セッション | 「AIネイティブアーキテクチャの進化とガバナンス」 |
| 発表者 | 熊紀元氏、快手アーキテクチャガバナンスセンターの横断アーキテクト・技術専門家 |
| AIコードの割合 | 25Q3は26%、26Q2は60% |
| 発見済みの問題 | 複数の本番環境障害。検出・ブロック用Skillで累計3000件以上の問題を発見 |
| ルールの規模 | 7種類、計415件:コンポーネント・業務知識が37件、規約・制約が378件 |
| 防御ライン | 業務Harness、MyFlickerプラグイン、インテリジェントCR、ArchAgentの4段階 |
| 予定される成果物 | Harness導入リファレンスマニュアル、ルールの有効性に関するフィードバックリスト、Tokenコスト最適化の要件、未導入の事業部門の導入スケジュール |
AI Codingの技術的負債はなぜ「複利」で増えるのか
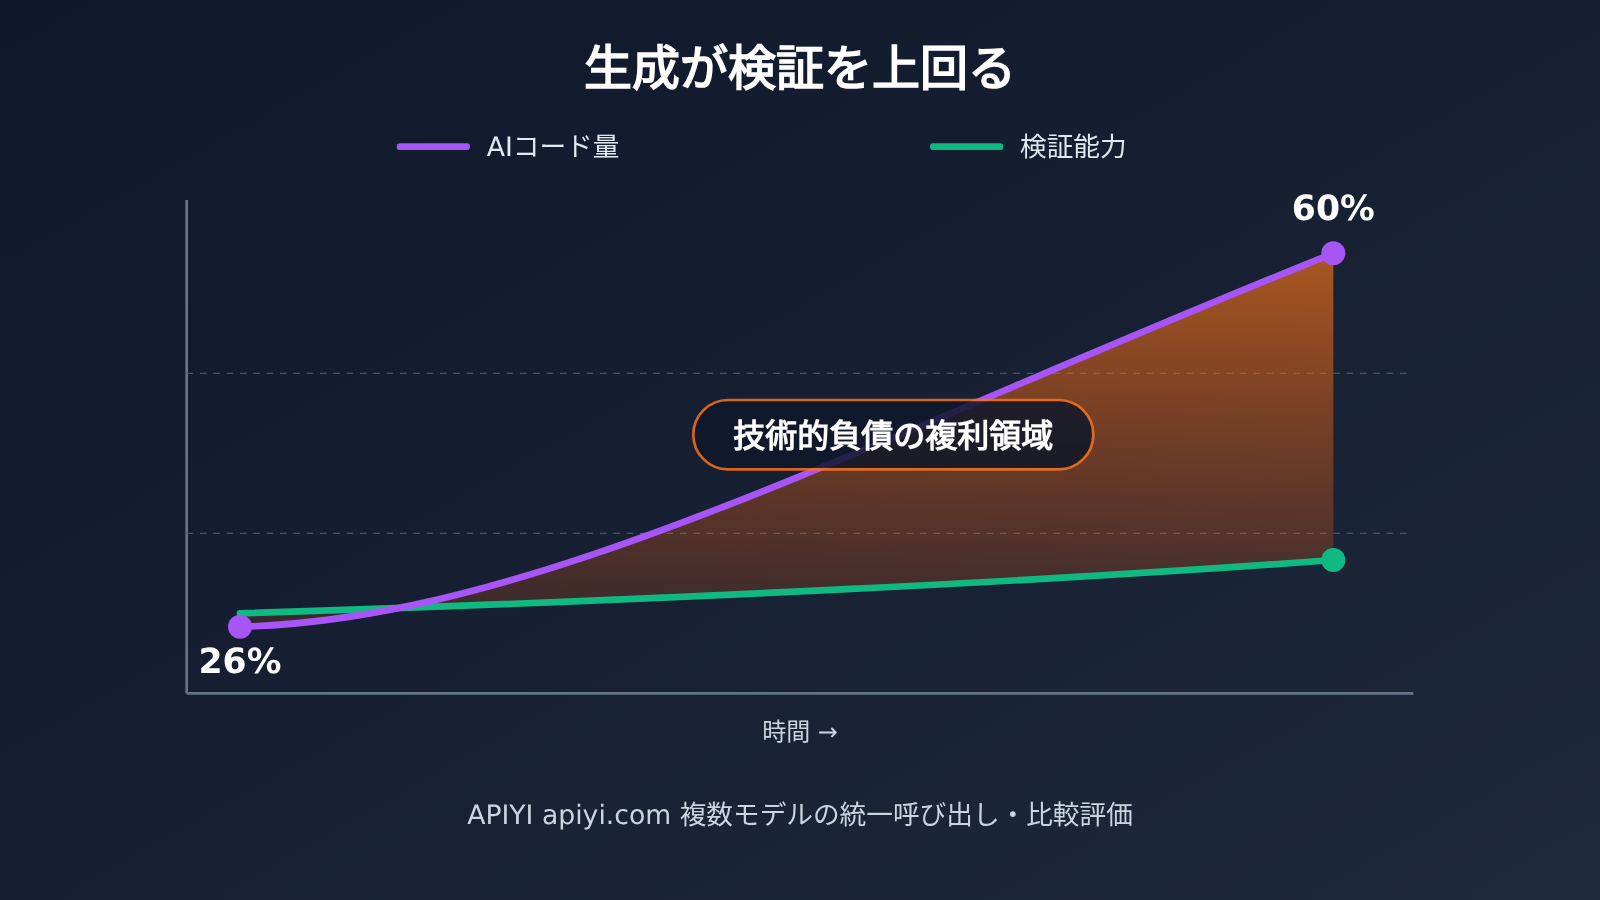
セッション予告では、AIコードの割合が検証手段の整備よりも速く増加するため、技術的負債が複利的に積み重なると指摘しています。その理由は、想像に難くありません。AIが日々生み出すコードのうち、実際に検証されるのがごく一部であれば、残った問題の種はその後の開発でも参照・コピーされ、積み重なっていきます。本番環境で問題が表面化したときには、原因究明にかかるコストが、当初ブロックするためのコストを大幅に上回ることも少なくありません。
Googleが最近公開した事例も、これを裏付けています。Gemini 4 Argonは、11時間の無人稼働中に、約20万行のADKコードベースに対する改善案を作成し、16892件の単体テストを完了しました。最終的に2件が採用された一方、残る4件は、信頼性、保守性、互換性、実際のパフォーマンスが期待に達しなかったため、人間によるレビューで却下されました。最先端のモデルであっても、ボトルネックはすでに「書けるか」から「十分に検証できるか」へと移っていることがわかります。
AI Codingの典型的な失敗5パターン:快手による根本原因分析
予告では、本番環境で発生した障害の根本原因を、業務知識の不足、過去の経緯に関する管理の不足、そして性能・セキュリティ・コーディングの3方面における制約の不足という5つに分類しています。記事に挙げられた失敗事例を踏まえると、次のセルフチェック表にまとめられます。なお、「対応する防御策の種類」は、資料の論旨に沿って私たちが整理したものであり、快手が公表した対応関係ではありません。
| 典型的な失敗 | 根本原因 | AIが間違えやすい理由 | 対応する防御策の種類 |
|---|---|---|---|
| SQLの条件を誤って書く | 社内固有の業務知識の不足 | 社内のフィールドの意味や業務上の定義をモデルが知らない | 知識の注入(コンポーネント・業務知識) |
| 過去の互換性コードを誤って削除する | 過去の経緯に関する管理の不足 | コードが「不要」に見え、モデルは過去のしがらみを理解していない | アーキテクチャ・互換性の制約 |
| 提案に従ってコードを変更し、スレッドプールを使い切る | 性能に関する制約の不足 | 局所的には合理的に見えても、システム全体の処理容量が考慮されていない | 性能・安定性の制約 |
| 暗黙のセキュリティ要件を見落とす | セキュリティに関する制約の不足 | セキュリティ要件は要求仕様に書かれていないことが多い | セキュリティ規範による制約 |
| コンパイルを通すためにコードチェックを省略する | コーディングに関する制約の不足 | モデルは「タスクの完了」を目指すため、近道を選ぶことがある | 回避できない強制的なゲート |
AI Codingの失敗に共通すること
これら5つの失敗には共通点があります。モデルの汎用能力が低いわけではなく、欠けているのは組織内部のコンテキストと譲れない境界線です。SQLの条件を誤るのは知識の問題であり、プロンプトやナレッジベースで軽減できます。一方、「コンパイルを通すために自らチェックを省略する」のは別の問題です。制約が「推奨」の段階にとどまる限り、AIはそれを障害とみなして回避する可能性があります。
だからこそ、予告にあった次の言葉は、すべての技術責任者が覚えておくべきです。制約は、AIが回避できないゲートにしなければなりません。プロンプトに書いた規範は注意喚起にすぎません。プロセスに組み込み、マージやリリースを実際に阻止できるチェックが、初めてゲートになります。
AI Codingの品質ゲートを実現する「知識+制約」の二輪駆動
快手のアーキテクチャガバナンスチームは、「知識+制約」の二輪駆動というアプローチを提案し、Skillの形で業務用Harnessに組み込みました。ルールは次の2つに分かれています。
- 知識(37ルール):コンポーネントや業務に関する知識。主に、AIが存在しない社内APIを呼び出したり、コンポーネントのパラメータを誤って使用したりするAPIのハルシネーションを防ぎます。
- 制約(378ルール):規範に関するルール。アーキテクチャ、安定性、パフォーマンス、セキュリティ、コーディング品質の5つの領域をカバーします。
両者の数に大きな差がある点は注目に値します。知識のルールは少数精鋭で、モデルが最も不足している社内固有のコンテキストを補うことが目的です。一方、制約のルールは数が多く、チームが長年蓄積してきた規範を実行可能なチェックに変えることを目指しています。7種類のルールの具体的な分類や例については、予告では詳しく触れられておらず、講演での公開を待つ必要があります。
AI Codingの品質ゲートにおけるSkillの品質保証
ルール自体にも誤りが生じることがあります。ルールが緩すぎれば検出漏れが起き、厳しすぎれば誤検出が増えます。誤検出が多くなると、開発者はゲートを回避する方法を探すようになり、品質ゲートは形骸化してしまいます。そこで快手は、3つの段階を通じたSkillの品質保証サイクルを構築しました。
- 開発期:ルール自体が正確かどうかを検証します。
- リリース判定期:検出漏れと誤検出の防止に重点を置き、ルールが基準を満たした後にリリースします。
- 効果検証期:リリース後のルールによる実際の検出・阻止効果を継続的に監視します。
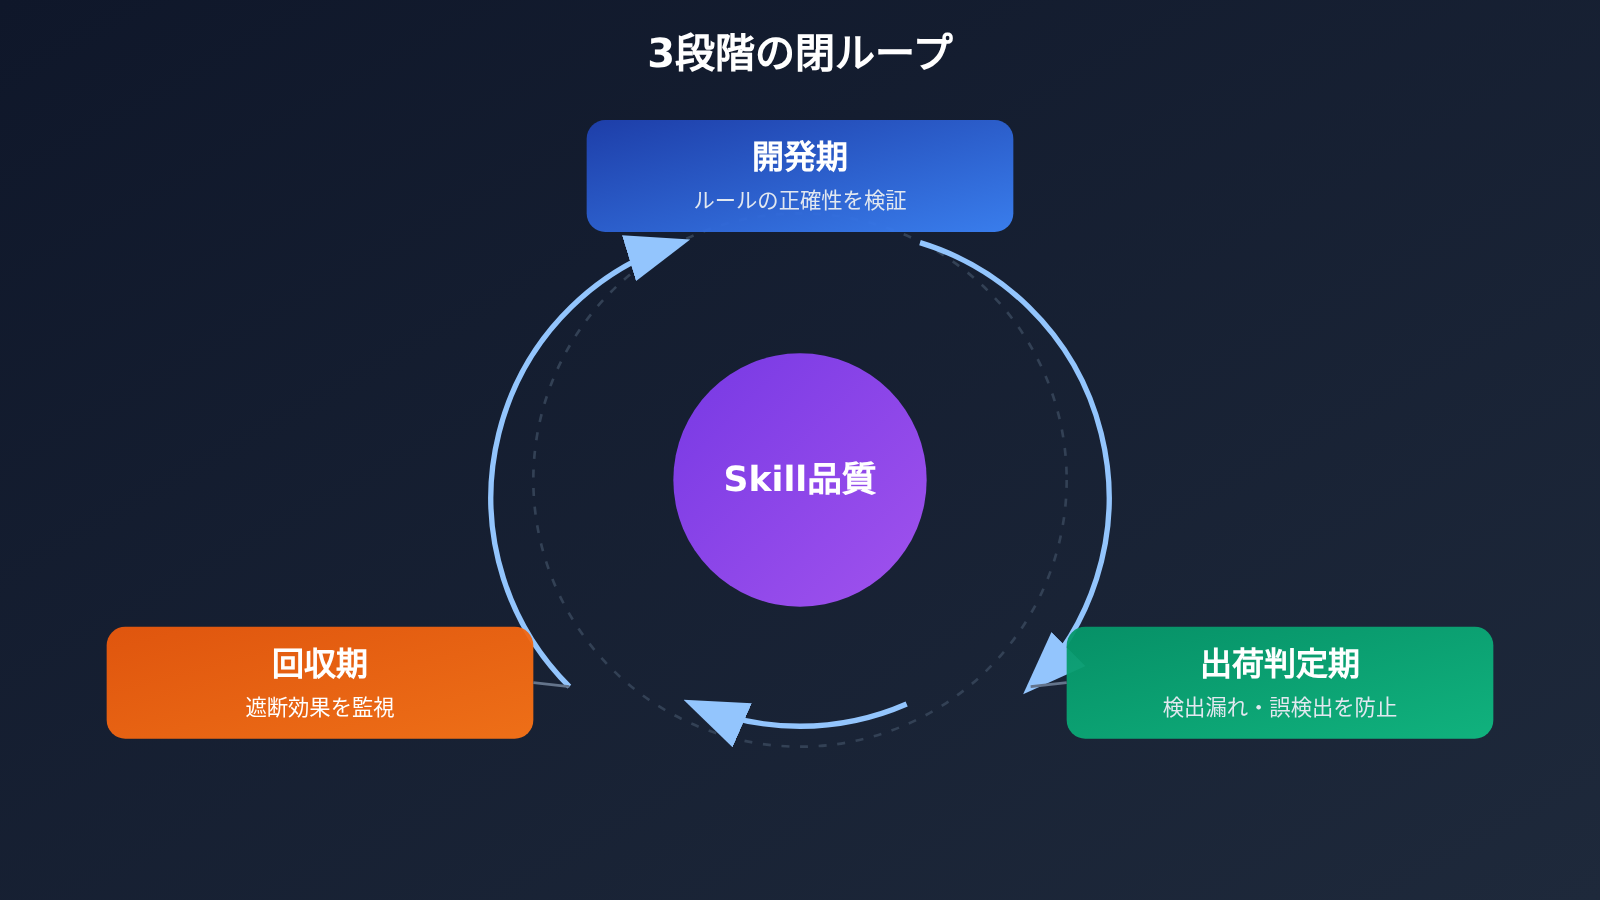
ルールを、テスト・リリース・監視が必要な「プロダクト」として管理すること。これは、中小規模のチームが見落としがちな一方で、この仕組みの中でも特に重要なポイントです。
AI Codingを支える4層の防御ライン
快手は開発プロセスの各段階に4つの防御ラインを設けています。それぞれ異なる課題に対応し、互いを補完する構成です。
| 防御ライン | 適用段階 | 解決する課題 | 現在のカバー範囲(予告による) |
|---|---|---|---|
| 業務別Harnessによる検知・ブロック | コーディング時 | AIがコードを生成する時点で知識を注入し、制約を適用する | メインサイト、海外、商業化、生活サービス、ECなど複数の事業部門 |
| MyFlickerプラグイン | コーディング時(補完) | Harnessをまだ導入していない部門をカバーする | 開発部門など |
| インテリジェントCRによる検知・ブロック | CodeReview | マージ前に一律のチェックを行う | 全社 |
| ArchAgentによる可視化とガバナンス | 本番環境 | すでにリリースされた問題を発見し、改善を促す | 全社 |
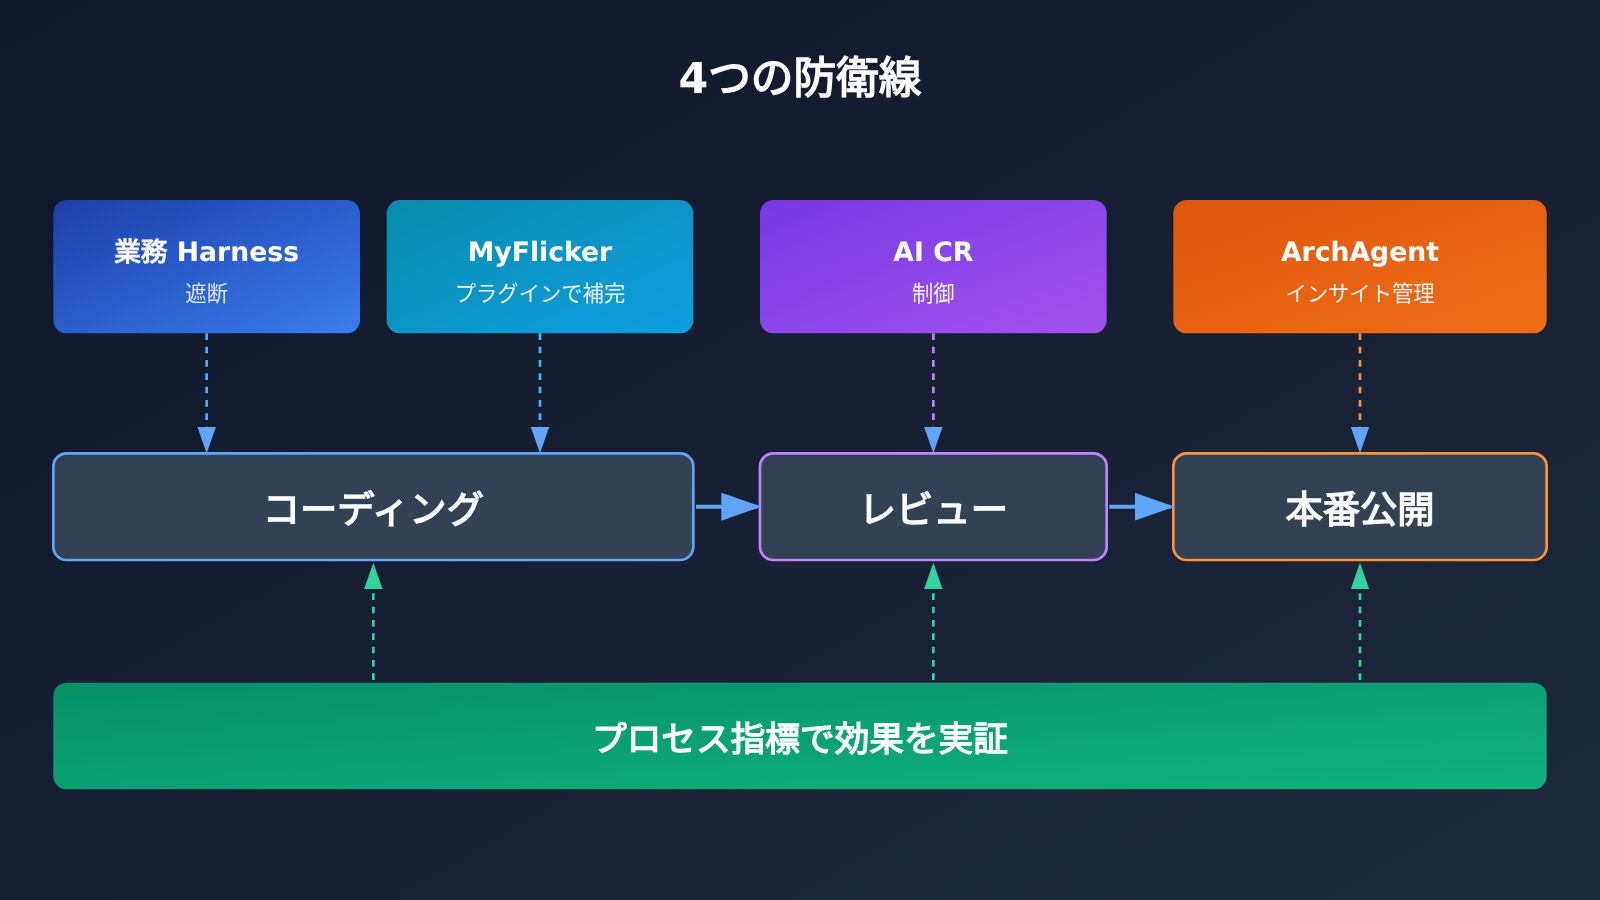
この構成の考え方は明快です。早い段階で検知するほどコストは低く、後の段階で検知するほど広い範囲をカバーできます。コーディング時のHarnessは業務に最も近い一方、事業部門ごとに導入する必要があります。インテリジェントCRとArchAgentは各部門の改修を必要とせず、全社でチェックできますが、問題の発見はより後の段階になります。また予告では、効果を感覚だけで判断するのではなく、プロセス測定によって各防御ラインの効果を裏付けることにも言及しています。
AI Codingの品質ゲートを導入する3つのパターン
予告では、導入状況を示す典型例として3つの事業部門が紹介されています。今後の講演では、それぞれの導入時点の状況、仕組み、検知・ブロックの効果、導入コストが語られる予定です。
- メインサイトのMina:導入済みで、ガバナンスを進めている段階。
- 海外向けのAIFlow:複数の技術スタックにまたがり、導入を進めている段階。
- ECのPandoraFlow:複雑な業務を対象に、ゼロから導入する段階。
この3つの事例は、社外のチームにとっても参考になります。多くの企業はいずれかの状況に当てはまるため、自社の現在地と照らし合わせることができます。
AI Codingのゲート運用:中小チームはどう始めるか
快手の415件のルールと4段階の防御は、大規模な組織向けに作られたものであり、中小チームがそのまま取り入れる必要はありません。以下は資料の内容を踏まえた私たちからの導入提案であり、快手の結論ではありません。参考としてご覧ください。
| 導入段階 | 推奨する取り組み | 優先して防ぐ問題 |
|---|---|---|
| ステップ1:強制ゲート | CIでチェックのスキップを禁止し、lintの適用除外やテストのスキップが新たに追加された場合はすべてブロックする | AIがコンパイルを通すためにチェックをスキップする |
| ステップ2:少量の知識 | 間違えやすい社内テーブル、フィールド、コンポーネントの使い方を10〜20件まとめる | SQLの記述ミス、APIのハルシネーション |
| ステップ3:重要な制約 | 本番障害が発生した領域に絞ってルールを作る。例えば、スレッドプール、互換性維持のためのコード、認証・認可など | スレッドプールの枯渇、互換コードの誤削除 |
| ステップ4:AIレビュー | PRの段階でモデルによるレビューを追加し、人手によるCRを補完する | 明示されていないセキュリティ要件の見落とし |
| ステップ5:振り返り | 各ルールの検出回数、誤検知回数、回避された回数を記録し、定期的に整理する | ルールの形骸化、誤検知による疲弊 |
ステップ1をあえて最初に置いたのは、ほとんどコストをかけずに、「AIが近道をする」という見つけにくい問題を直接防げるためです。以下は、チェックのスキップを禁止するシンプルなゲートスクリプトです。モデルには依存せず、決定的なルールを使います。
import re, subprocess, sys

# 今回のコミットで追加されたコード行を取得する
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
ステップ4のAIレビューは、任意のOpenAI互換インターフェースで実装できます。以下の例では、チームの重要なルールをいくつかシステムプロンプトに設定し、diffをレビューします。
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 他のモデルに置き換えて効果を比較できる
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
完全な実装を見る:ブロック機能と使用量記録を備えたレビューゲート
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """ルールファイル:[{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # コスト評価のためにトークン消費量を記録
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # 違反があればブロックする。検出率と誤検知率の集計のため、結果をログにも記録することを推奨
    sys.exit(1 if result.get("violations") else 0)
注意したいのは、モデルによるレビューにも見逃しや誤検知があることです。確定的なチェックや人によるコードレビュー(CR)を補うものとして使い、単独でゲートキーパーを任せることはできません。
🚀 公式の推奨:AIレビューのゲートを構築する際は、まず同じ過去のPRを使って、複数のモデルの検出率と誤検知率を比較することをおすすめします。APIYI apiyi.com なら、1つのAPIキーでOpenAI、Claude、Geminiなどのモデルを呼び出せます。切り替え時に変更するのはmodelパラメータだけです。新規ユーザーには無料のテスト枠もあります。
AI Codingの品質ゲートがもたらす影響
開発チームへの影響
- レビューの重点が変わる:AIが生成したコードの割合が増えるほど、人によるコードレビュー(CR)で一行ずつ確認するのは難しくなります。チームは「コードを見る」ことから「ルールと品質ゲートを維持する」ことへ、力の入れどころを移す必要があります。
- ルールが資産になる:業務知識や障害から得た教訓を、ドキュメントやベテラン社員の頭の中に散在させるのではなく、実行可能なルールとして蓄積する必要があります。
- 新たなコストが生じる:ルールが増え、レビューの頻度が上がるほど、Tokenの消費量も増えます。快手は成果物の中で「Tokenコスト最適化の要件」を明記しており、大規模な運用ではすでに実際の課題になっていることがうかがえます。ただし、具体的な規模はまだ公表されていません。
業界への影響
- 生成能力の競争からガバナンス能力の競争へ:GoogleのArgonの事例と快手の実践は、次の段階では検証、レビュー、本番環境のガバナンス能力が差を生むことを示しています。
- Harnessのエンジニアリング:知識、制約、テスト、フィードバックループをAgentの実行環境に組み込むことが、企業がCoding Agentを導入する際の標準的な手法になりつつあります。
- 誤検知への対応は長期的な課題に:ルールの規模が大きくなると、ルールを正確に保ち、開発者の疲弊を防ぐことは、ルール自体を作ることより難しくなります。
💰 コストに関するヒント:AIレビューの品質ゲートにかかるTokenコストを評価する際は、まず少数のリポジトリで消費量を記録してみましょう。APIYI apiyi.com は従量課金と利用量の統計機能を提供しているため、全面導入後のコストを見積もるのに役立ちます。
よくある質問 FAQ
Q1:AI Codingのゲートとは何ですか?
AI Codingのゲートとは、コーディング、レビュー、リリースなどの各段階に設ける必須チェックです。AIが生成したコードに含まれるビジネスロジックの誤り、パフォーマンス上の懸念、セキュリティ上の問題を検出します。プロンプト内の「推奨事項」とは異なり、チェックを通過しなかったコードはマージやリリースができず、AIも回避できません。
Q2:「知識+制約」と一般的なコード規約チェックはどう違いますか?
一般的なlintは主に構文とスタイルをチェックします。快手の手法には、さらに2つの層があります。1つ目は、コーディング時に注入する37項目のコンポーネント知識と業務知識で、APIに関するハルシネーションを防ぎます。2つ目は、アーキテクチャ、安定性、パフォーマンス、セキュリティ、コード品質をカバーする378項目の規約・制約です。これらをSkillを通じてHarnessに組み込み、AIがコードを生成する段階から適用します。
Q3:快手の発表はいつ行われますか?効果に関するデータはいつ公開されますか?
発表はAICon北京で、2026年12月18~19日に予定されています。現在公開されているのは講演内容の予告のみです。検出精度、見逃し率や誤検知率、障害の減少などの効果データに加え、ルールの例やHarnessの実装詳細は、正式な講演で明らかになる予定です。
Q4:Harnessがないチームはどう始めればよいですか?
快手のMyFlickerプラグインを使った補完策が参考になります。まずはCIとPRの段階にゲートを設ければ、業務システムを改修する必要はありません。最初に「チェックのスキップを禁止する」といった確定的なルールを導入し、その後、過去の障害に基づく重要な制約を少数追加するとよいでしょう。AIレビューも導入するなら、APIYI apiyi.comで1つのキーを使って複数のモデルを試し、誤検知が最も少ないものを選べます。
Q5:AIレビューゲートの有効性をすばやく検証するにはどうすればよいですか?
1. 問題の有無が分かっている過去のPRを20~50件選び、テストセットにします。
2. 本文のサンプルコード(base_urlを `https://api.apiyi.com/v1` に設定)で一度実行し、検出率と誤検知率を集計します。
3. APIYI apiyi.comでモデルを切り替えてテストを繰り返し、Token消費量も記録したうえで、全面導入するかどうかを判断します。
Q6:この手法にはどのような課題が知られていますか?
予告では、いくつかの課題が挙げられています。ルールには見逃しや誤検知があるため、3段階のフィードバックループによる継続的なメンテナンスが必要です。また、規模が拡大するとTokenコストが増加します。事業部門ごとに技術スタックが異なり、導入の進捗にも差があります。例えば、海外向けのAIFlowでは、異なる技術スタックへの展開がまだ進行中です。加えて、モデルによるレビューは、確定的なチェックや人間の判断に代わるものではありません。
AI Codingのゲート管理:重要ポイント Key Takeaways
- 生成はもはやボトルネックではない:快手ではAIが生成したコードの割合が1年で26%から60%に上昇し、検証能力が課題になっています。
- 失敗には5つのパターンがある:業務知識、過去の管理ルール、性能・セキュリティ・コーディング上の制約が不足しています。
- 制約はゲートとして実装する:AIはコンパイルを通すためにチェックを飛ばすことがあり、プロンプトで「推奨」するだけでは不十分です。
- 知識と制約は分けて管理する:37件の知識でハルシネーションを防ぎ、378件の制約で規約を守ります。
- 4つの防御ラインで相互にカバーする:コーディング時のHarness、プラグインによる補完、インテリジェントCR、本番環境のArchAgentです。
- ルール自体もテストする:開発、リリース判定、回収の3段階で品質管理を循環させ、検出漏れと誤検出を抑えます。
- 小規模チームは強制力のあるゲートから始める:まず「チェックのスキップ」を防ぎ、AIレビューはAPIYI apiyi.comを通じて低コストで試せます。
まとめ
快手の講演予告は、AI Codingのガバナンスを考えるうえで、明確な参照枠を示しています。
- 問題の捉え方:AIコードの増加に検証手段が追いつかず、技術的負債が複利的に蓄積し、本番環境での障害も発生しています。
- 方法論:「知識+制約」を両輪とし、Skillの形で開発プロセスに組み込みます。ルール自体についても品質管理のサイクルを回します。
- 導入構造:コーディング、プラグイン、レビュー、本番環境の4層で防御し、業務への導入状況に応じて異なる経路を選びます。
すでにAIプログラミングを大規模に活用しているチームは、まず本記事の「5つの失敗パターン」と「4つの防御ライン」の表を使って、自チームのゲートがどの層までカバーできているか確認してみてください。詳しい効果データや実装の詳細については、12月の正式講演にも注目です。
PRの段階でAIレビューを試すなら、APIYI apiyi.comを通じて、各モデルのレビュー効果とToken消費量を手早く比較し、その結果を見て投資規模を決めるのがおすすめです。
📚 参考資料
- InfoQ – AI Codingの増分リスク管理:SkillゲートとHarnessの実践|AICon北京:快手によるセッション予告の原文
- リンク:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
内容:AI生成コードの割合、ルールの規模、4段階の防御策、講演の概要を紹介
-
InfoQ – GoogleがGemini 4 Argonを使い、一晩でADKコードベースの20万行を最適化:Coding Agentによる既存コードベースの改修事例
- リンク:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - 内容:Agentの成果と人手によるレビューでの却下率を紹介。「検証こそがボトルネック」という主張を裏付ける参考事例
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYIのホームページ apiyi.com からお気軽にお問い合わせください。導入に関する詳しい資料は、ドキュメントセンター docs.apiyi.com をご覧ください。


