
Catatan penulis: Artikel ini mengacu pada postingan riset resmi tentang Claude Fable 5.2 yang menyelesaikan dua soal fisika lubang hitam dengan multi-agen, lalu merangkum praktik yang bisa langsung diterapkan untuk tugas Agent intensif dalam hal memilih model, memisahkan peran, dan menetapkan batas berhenti.
Pada 17 November 2026, Anthropic menerbitkan postingan riset: Beberapa salinan Claude Fable 5.2 berjalan di latar belakang selama sekitar enam minggu dan menyelesaikan dua soal fisika lubang hitam. Bagi pengembang yang menjalankan tugas panjang dan multi-agen, hal yang layak diperhatikan bukanlah fisikanya sendiri, melainkan cara kerja yang ditunjukkan: berlangsung lama, paralel di banyak jalur, dan saling memeriksa.
Ini bukan artikel sains populer tentang fisika, dan juga tidak akan memutuskan untuk Anda penyedia API mana yang lebih stabil. Artikel ini hanya melakukan satu hal: menerjemahkan sinyal rekayasa yang bisa dipelajari dari postingan riset menjadi langkah-langkah yang bisa Anda ikuti saat menjalankan tugas Agent intensif sendiri.
Nilai inti: Setelah membaca artikel ini, Anda akan tahu cara memisahkan inferensi utama dan peninjauan ulang ke dalam peran berbeda, menuliskan batas berhenti yang jelas untuk setiap jalur agen, dan hanya memilih di antara model yang harga resminya tercantum dalam tabel model, sehingga biaya tugas panjang dapat diperkirakan dan dibatasi.
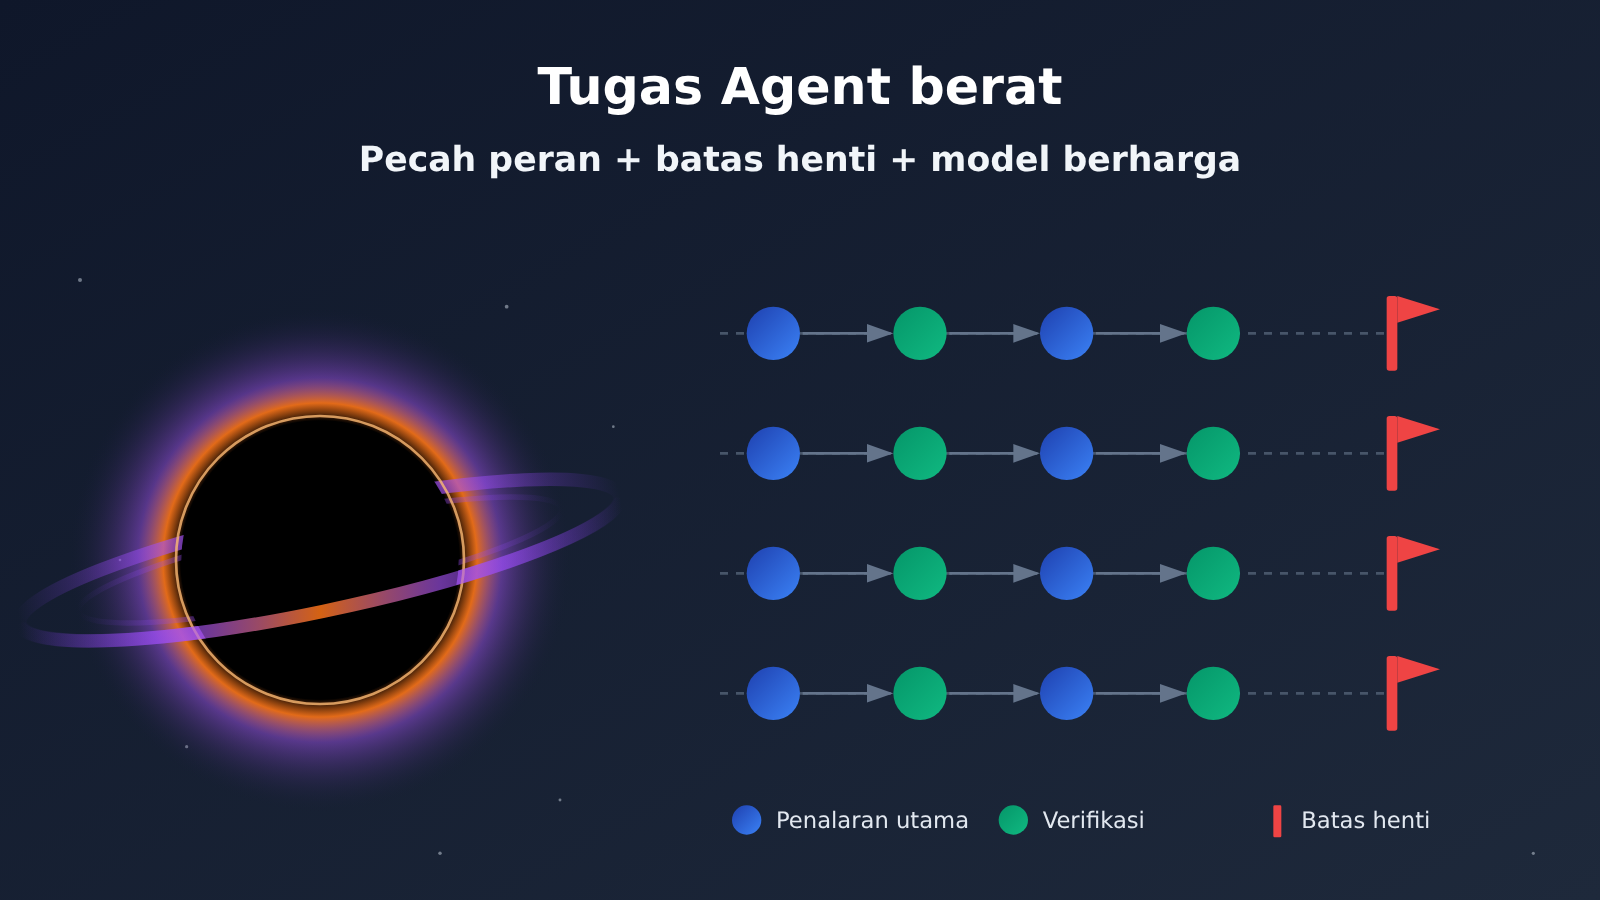
Poin inti tugas Agent berat menurut posting penelitian Claude Fable 5.2
Pertama, mari kita jelaskan latar belakangnya dalam satu-dua paragraf. Posting penelitian ini adalah keterangan resmi dari Anthropic, dan dua makalah yang disebutkan masih berstatus preprint, belum melalui peer review. Kedua soal berasal dari fisika teoretis, tidak menggambarkan alam semesta tempat kita hidup, dan tidak memiliki kegunaan praktis, jadi maknanya terutama terletak pada “metode”, bukan pada “seberapa penting kesimpulannya”.
Menurut posting tersebut, pada Agustus 2026 peneliti Hongbin Chen meminta Claude mendaftar soal-soal terbuka di bidang black hole dan bootstrap, dan dalam beberapa jam mendapat 22 soal. Ia menugaskan satu agen untuk setiap soal, agen-agen itu bisa membaca progres satu sama lain, lalu menjalankannya di latar belakang selama sekitar enam minggu. Kalimat asli di posting adalah “tanpa konfigurasi khusus”, tetapi itu adalah deskripsi resmi tentang cara penyiapannya, bukan berarti tanpa biaya; posting juga tidak memberikan rincian biaya.
| Fakta dalam posting penelitian | Implikasi untuk tugas Agent berat | Yang bisa Anda lakukan |
|---|---|---|
| Satu soal satu agen, agen bisa membaca progres satu sama lain | Granularitas pemecahan tugas harus jelas, status bersama harus bisa dibaca | Setiap subtugas punya agen independen, progres ditulis ke penyimpanan bersama |
| Hampir setiap langkah dikerjakan dua agen secara independen lalu dicocokkan dengan literatur | Langkah kunci perlu verifikasi independen | Pisahkan inferensi utama dan verifikasi menjadi dua peran |
| Agen awal mencoba paralel 61 kali dan gagal | Kegagalan adalah hal biasa, kegagalan harus punya batas | Tuliskan dengan jelas jumlah kegagalan maksimum dan anggaran untuk setiap jalur |
| Hasil diverifikasi secara formal dengan Lean dan diperiksa fisikawan | Hasil mesin pada akhirnya harus divalidasi eksternal | Sisakan tahap verifikasi oleh manusia atau alat |
| Berjalan di latar belakang sekitar enam minggu | Biaya tugas panjang akan menumpuk | Perkirakan berdasarkan harga di tabel model, dan tetapkan batas biaya |
Apa yang dijelaskan oleh dua soal dalam tugas Agent berskala berat
Soal pertama adalah perhitungan transisi fase Hawking-Page yang sudah diajukan sejak 2003 dan sampai sekarang belum pernah tuntas dihitung. Postingan tersebut menyebutkan bahwa hampir setiap langkah dikerjakan dua kali secara independen oleh dua agen, lalu dibandingkan dengan literatur; kesimpulannya, pada kopling lemah transisi tersebut tetap berlangsung mendadak. Fisikawan lain memperoleh jawaban yang sama secara independen dengan metode berbeda, sehingga terbentuk verifikasi silang. Bagi praktik rekayasa, soal ini menunjukkan pola pemeriksaan ulang berupa “repetisi independen + pembandingan eksternal”.
Soal kedua adalah masalah batas atas untuk versi paling sederhana dari bootstrap modular. Sekelompok agen Claude sebelumnya telah mencoba secara paralel sebanyak 61 kali dan semuanya gagal. Agen berikutnya mengenali pola dari hasil numerik, meminjam metode dari soal pengisian bola (sphere packing) yang lain, lalu membuktikan bahwa batas atas massa lubang hitam teringan adalah sekitar c/9.1266, sekaligus menunjukkan bahwa metode tersebut tidak dapat menekan batas atas itu lebih rendah lagi. Pada September 2026, hasil ini diverifikasi secara formal menggunakan Lean, makalahnya ditulis oleh Claude, dan fisikawan memeriksa hasil utamanya. Pelajaran bagi rekayasa dari soal ini adalah: banyaknya percobaan gagal merupakan bagian dari proses, sehingga setiap jalur harus memiliki anggaran dan kondisi berhenti.
Perlu ditekankan secara khusus bahwa pendekatan dalam postingan tersebut adalah “beberapa salinan dari model yang sama saling memeriksa”, bukan “perencanaan memakai model mahal, pemeriksaan memakai model murah”. Skema pembagian peran untuk menghemat biaya yang dibahas di bawah ini adalah praktik rekayasa yang bisa dicoba oleh pembaca, bukan kesimpulan yang sudah divalidasi oleh penelitian ini.
Cara Memisahkan Peran pada Tugas Agent Berat: Pisahkan Penalaran Utama dan Pemeriksaan Ulang
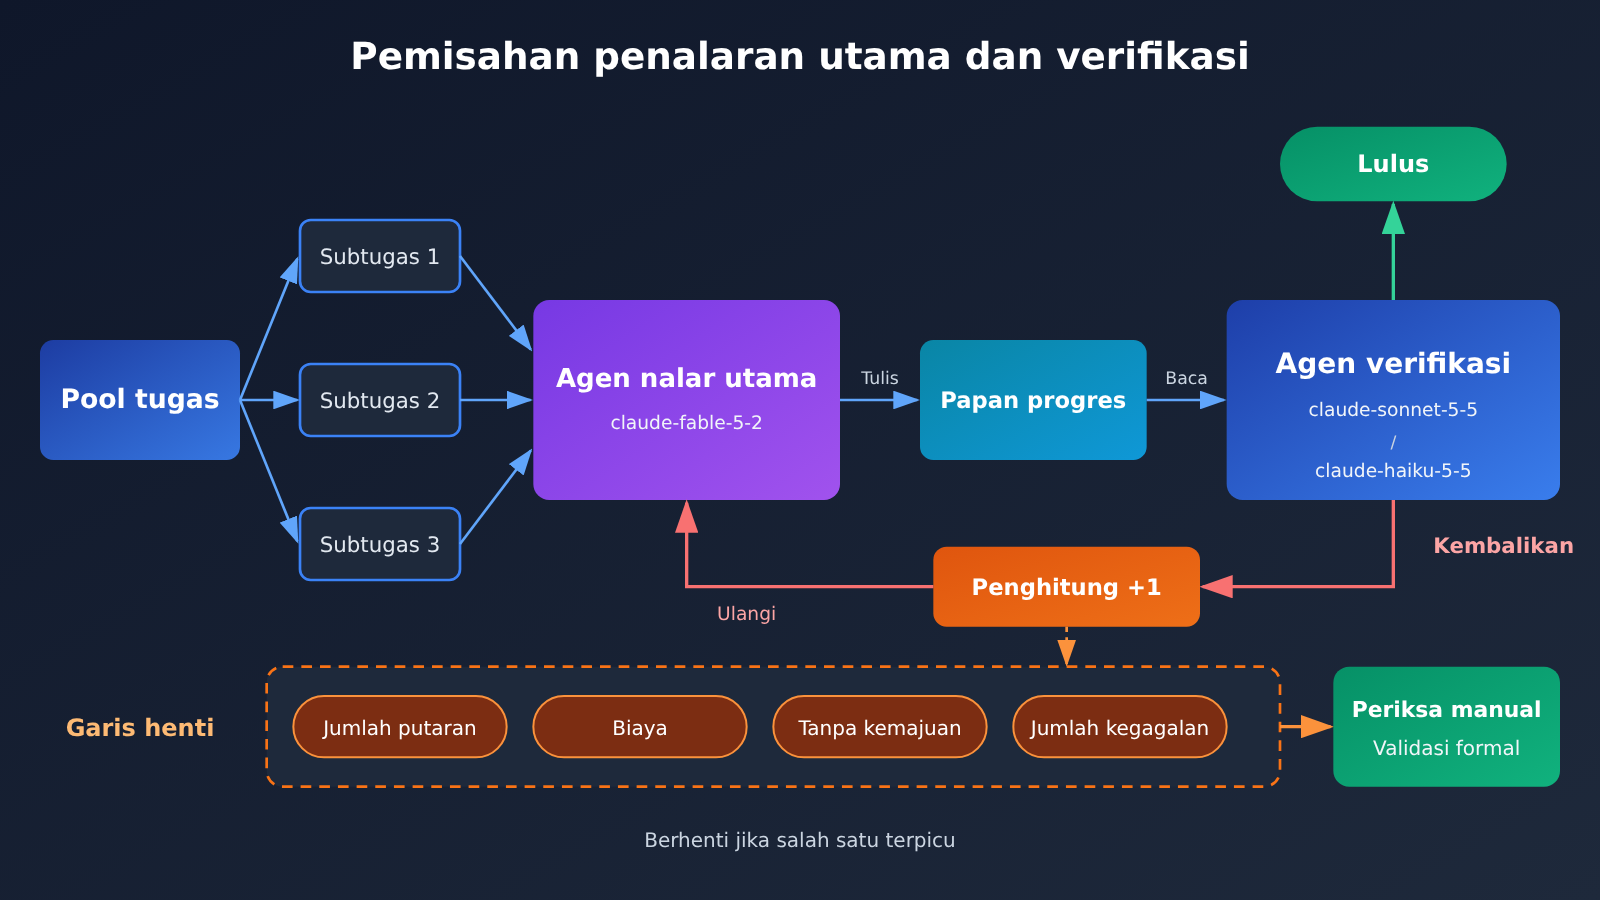
Dalam tugas Agent berat, bagian yang paling mahal biasanya adalah jalur yang butuh penalaran mendalam, sedangkan yang paling sering adalah aksi pemeriksaan ulang seperti pengecekan, pembandingan, dan validasi format. Kalau semua pemanggilan menggunakan model termahal yang sama, biaya akan tumbuh linear bahkan superlinear seiring jumlah putaran. Memisahkan “menghasilkan pemikiran” dan “memeriksa sekali” menjadi dua peran adalah cara paling langsung untuk mengendalikan biaya.
Prinsip pemisahannya bisa dirangkum begini: langkah yang butuh penalaran terbuka dan perencanaan rantai panjang diserahkan ke peran penalaran utama; pengecekan yang punya standar jelas—seperti menilai “apakah langkah ini konsisten dengan langkah sebelumnya”, “apakah format output sesuai aturan”, “apakah kesimpulan bertentangan dengan literatur yang sudah diketahui”—diserahkan ke peran pemeriksaan ulang. Peran pemeriksaan ulang seharusnya memberi penilaian terstruktur, bukan mengulang penalaran dari awal.
| Peran | Cakupan tugas | Kandidat ID model | Persyaratan output |
|---|---|---|---|
| Penalaran utama | Derivasi terbuka, pembuatan rencana, langkah kunci | claude-fable-5-2, claude-fable-5-2-thinking |
Proses penalaran lengkap dan kesimpulan antara |
| Pemeriksaan ulang tingkat satu | Konsistensi logika, pembandingan langkah, verifikasi sitasi | claude-sonnet-5-5 |
PASS / FAIL beserta alasannya |
| Validasi ringan | Pengecekan format, kelengkapan field, pembandingan sederhana | claude-haiku-5-5 |
Hasil JSON terstruktur |
| Validasi eksternal | Pembuktian formal, verifikasi numerik, tinjauan manusia | Alat atau manusia | Konfirmasi akhir |
Setelah dipisahkan seperti ini, semua peran bisa lewat satu pintu pemanggilan yang sama. Melalui APIYI apiyi.com, satu kunci API saja sudah cukup untuk berpindah di antara model-model pada tabel di atas. Antarmukanya kompatibel dengan OpenAI, jadi penalaran utama dan pemeriksaan ulang hanya perlu mengubah parameter model, tanpa harus memelihara beberapa SDK dan beberapa kunci. Untuk tugas panjang yang butuh banyak jalur paralel, pintu masuk yang terpadu juga membuat statistik penggunaan terkumpul di satu tempat, sehingga memudahkan rekonsiliasi.
Namun perlu diingat, model pemeriksaan ulang yang lebih murah bukan berarti lebih andal. Apakah peran pemeriksaan ulang mampu menjalankan tugasnya bergantung pada seberapa jelas standar penilaian yang kamu berikan. Sebaiknya jalankan dulu dengan sekumpulan kecil sampel yang jawabannya sudah diketahui, pastikan keputusan lulus dan penolakan dari model pemeriksaan ulang基本上 sesuai harapan, baru kemudian masukkan ke dalam tugas panjang.
Cara Memilih API untuk Tugas Agent Berat: Harga dan ID Model
Kontrol anggaran untuk tugas panjang bertumpu pada satu syarat: harga satuan setiap panggilan harus sudah pasti. Sebaiknya pegang satu prinsip: hanya memanggil model yang harganya tercantum jelas di tabel model, lalu menetapkan ID model dan harga satuannya secara hard-code di dalam kode, bukan menggantinya secara mendadak saat runtime.
Menurut halaman model resmi Anthropic, Claude Fable 5.2 dirilis pada 9 November 2026, ID modelnya adalah claude-fable-5-2, jendela konteks 1 juta token, output maksimum 128 ribu token, dan thinking aktif secara default. Tabel berikut memuat harga model yang relevan dengan artikel ini dari tabel model APIYI di apiyi.com pada tanggal verifikasi (2026-11-19), dalam dolar AS per juta token.
| ID Model | Input | Baca cache | Output | Peran yang disarankan dalam artikel ini |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | Inferensi utama |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | Inferensi utama (versi thinking) |
claude-fable-5-1 |
10 | 0.25 | 50 | Versi berdekatan, untuk pembanding |
claude-sonnet-5-5 |
2 | 0.1 | 10 | Tinjauan ulang tingkat pertama |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | Verifikasi ringan |
Ada beberapa informasi penting untuk tugas panjang yang bisa dibaca dari tabel. Pertama, harga claude-fable-5-2 lebih rendah daripada claude-fable-5-1 yang berdekatan; jika inferensi utama Anda sebelumnya memakai versi lama, ada baiknya mempertimbangkan migrasi. Kedua, harga baca cache hanya 2,5% dari harga input. Dalam tugas panjang, agent berulang kali membaca progres bersama, system prompt, dan dokumen latar belakang; jika bagian ini bisa memanfaatkan cache, perbedaan biaya akan sangat terasa. Apakah terjadi cache hit bergantung pada cara pemanggilan dan aturan platform; ikuti penjelasan dokumentasi. Ketiga, perbedaan harga satuan antara model tinjauan dan inferensi utama mencapai beberapa orde besaran.
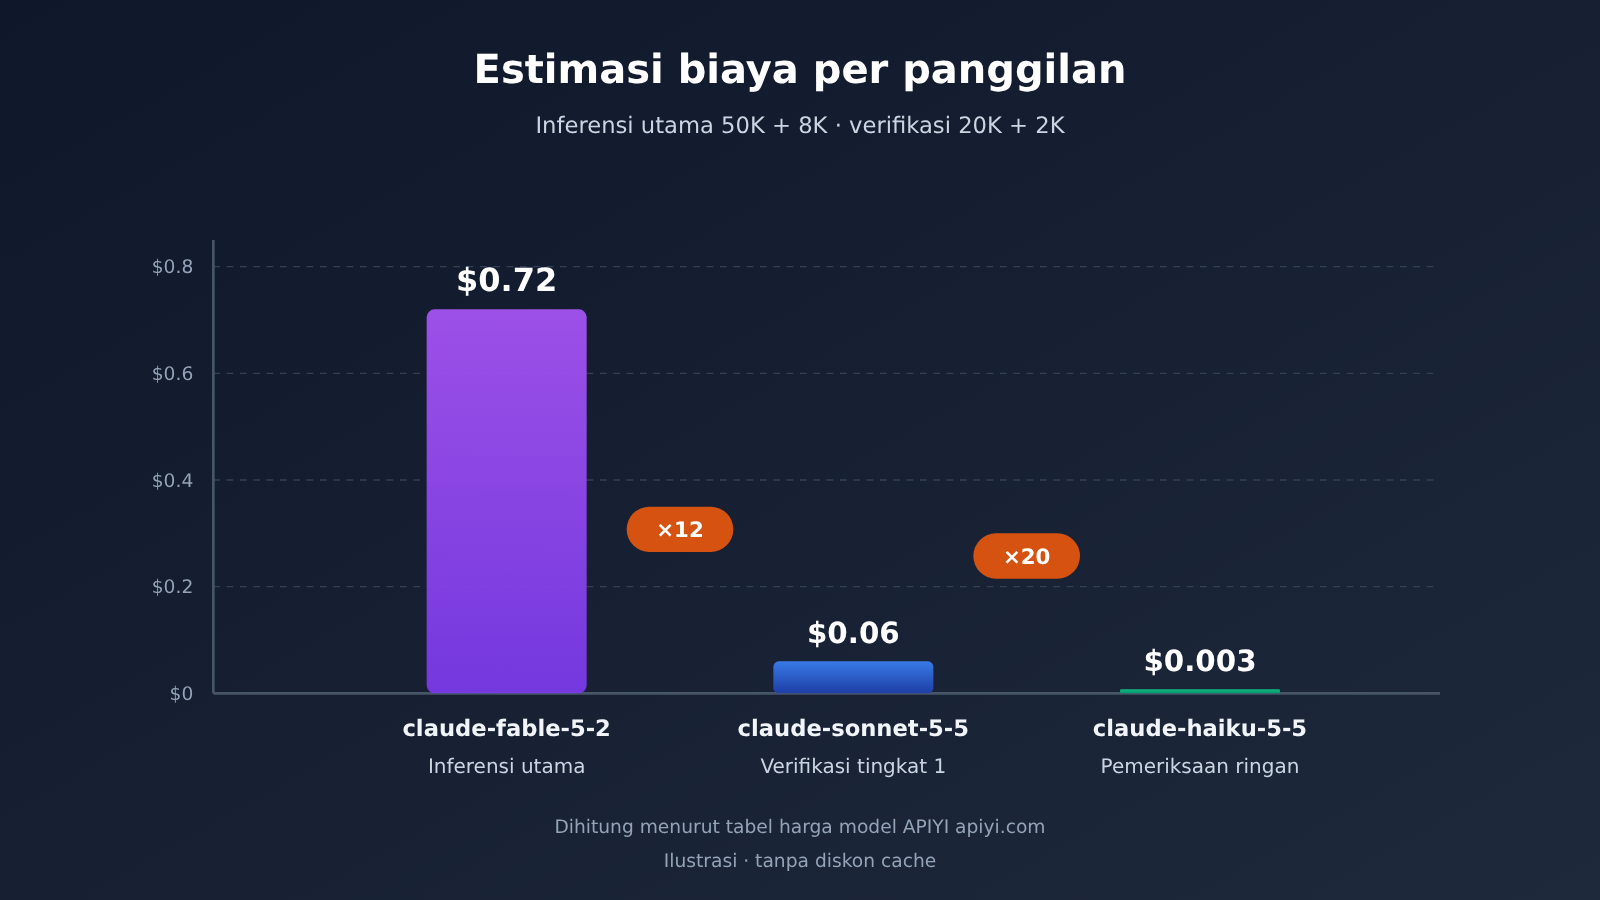
Mari rasakan dengan beberapa angka hipotetis: satu panggilan inferensi utama dengan input 50 ribu token dan output 8 ribu token pada claude-fable-5-2 sekitar 0.4 + 0.32 = 0.72 dolar AS; satu tinjauan dengan input 20 ribu dan output 2 ribu token pada claude-sonnet-5-5 sekitar 0.04 + 0.02 = 0.06 dolar AS, sedangkan pada claude-haiku-5-5 sekitar 0.003 dolar AS. Jika tinjauan juga memakai model inferensi utama, panggilan tinjauan yang sama sekitar 0.16 + 0.08 = 0.24 dolar AS. Ini hanya ilustrasi aritmetika; jumlah token sebenarnya bergantung pada tugas Anda.
Selain itu, di halaman model resmi, harga Opus 5.5 adalah input 4 dan output 20, Sonnet 5.5 adalah 2 dan 10, sedangkan Haiku 5.5 mulai dari 0.10 dan 0.50. Angka-angka ini bisa menjadi referensi untuk memahami gradasi harga resmi. Saat melakukan panggilan sebenarnya, model dan harga mengacu pada daftar model platform. Seri claude-fable-5-2 dari APIYI mendukung dua endpoint, chat dan messages, dengan pintu masuk seragam di https://api.apiyi.com/v1.
Panduan Cepat Tugas Agent Berat: Kode Penjadwalan dengan Batas Penghentian
Contoh Minimal
Pertama, pastikan model inferensi utama dapat dipanggil dengan normal dan field usage bisa didapatkan — ini menjadi dasar untuk penghitungan biaya nanti:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Antarmuka kompatibel OpenAI dari APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Digunakan untuk menghitung token dan memperkirakan biaya
Tuliskan batas henti untuk setiap jalur agen
Dalam catatan riset, agen-agen awal mencoba secara paralel sebanyak 61 kali dan tidak berhasil, hal ini mengingatkan kita: tugas Agent yang berat pasti akan melibatkan banyak percobaan gagal, dan kegagalan itu sendiri juga menghabiskan biaya. Fungsi batas henti adalah membuat setiap jalur agen berhenti secara otomatis sebelum lepas kendali, lalu menyerahkannya kepada manusia atau alat untuk menilai.
| Batas henti | Arti | Nilai awal yang disarankan (sesuaikan dengan tugas) |
|---|---|---|
| Jumlah putaran maksimum | Batas atas bolak-balik antara penalaran utama dan peninjauan ulang | 10-30 putaran |
| Batas biaya | Batas atas estimasi biaya kumulatif per jalur | Ditetapkan sesuai anggaran per soal |
| Tanpa kemajuan berturut-turut | Peninjauan ulang terus menolak dan tidak ada kesimpulan baru | 3-5 kali |
| Jumlah kegagalan maksimum | Jumlah kumulatif penolakan oleh peninjauan ulang | Sekitar setengah dari jumlah putaran |
| Panjang output | Batas atas token per output | Jauh di bawah output maksimum 128 ribu |
Lihat kode implementasi lengkap
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Pintu masuk terpadu APIYI, dipakai bersama oleh inferensi utama dan tinjauan
)

# Harga satuan: USD / juta token, ditulis tetap sesuai tabel model platform, perbarui manual saat berubah
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Estimasi berdasarkan harga tercantum, tanpa memperhitungkan diskon cache, hasilnya cenderung konservatif."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
Kode ini memiliki tiga desain yang disengaja. Pertama, tabel harga satuan ditulis tetap di dalam kode; siapa pun yang mengganti model harus sekaligus mengganti harga satuannya, agar tidak terjadi distorsi anggaran akibat “mengganti ke model yang belum ada harganya”. Kedua, peran peninjau diminta hanya mengeluarkan PASS atau FAIL beserta alasannya, tidak diizinkan menurunkan ulang, sehingga panjang keluaran tinjauan terkendali. Ketiga, setelah berhenti, kode mengembalikan kemajuan saat ini dan biaya kumulatif, memudahkan pengalihan ke manusia, bukan membiarkan agen mencoba ulang tanpa batas.
🚀 Mulai cepat: Sebaiknya gunakan dulu kuota uji gratis untuk pengguna baru di APIYI apiyi.com, jalankan alur di atas dengan satu soal kecil yang jawabannya sudah Anda ketahui, pastikan penilaian verifikasi dan estimasi biaya sesuai ekspektasi, lalu secara bertahap tingkatkan jumlah jalur paralel dan jumlah putaran.
FAQ Umum: Memilih API untuk Tugas Agent Berat
Q1: Apakah klaim bahwa Claude Fable 5.2 memecahkan masalah fisika lubang hitam bisa dipercaya?
Ini adalah pernyataan resmi Anthropic dalam postingan riset mereka tanggal 17 November 2026. Dua makalah terkait masih berupa preprint dan belum melalui peer review. Hasil untuk soal kedua sudah diverifikasi secara formal dengan Lean pada September 2026, sementara soal pertama memperoleh jawaban yang sama dari fisikawan lain yang memakai metode berbeda. Saat membacanya, posisikan informasi ini pada level “pernyataan resmi + preprint”.
Q2: Postingan riset menyebut “tanpa konfigurasi khusus”. Apakah itu berarti murah?
Tidak. “Tanpa konfigurasi khusus” menggambarkan cara penyiapannya, dan postingan tersebut tidak menyertakan rincian biaya. Ada 22 soal, satu agen per soal, dijalankan di latar belakang selama sekitar enam minggu — volume pemanggilannya sendiri sudah tidak kecil. Jika Anda menjalankan tugas dengan skala serupa, hitung sendiri perkiraan biayanya berdasarkan harga di tabel model, dan pasang batas maksimum biaya.
Q3: Apakah memakai model murah untuk peninjauan ulang adalah praktik yang sudah divalidasi dalam postingan riset?
Bukan. Pendekatan dalam postingan tersebut adalah beberapa salinan model yang sama mengerjakan ulang secara independen lalu saling memeriksa. “Penalaran utama pakai model mahal, peninjauan pakai model murah” adalah saran engineering dari artikel ini yang bisa Anda coba; efektivitasnya perlu Anda verifikasi pada tugas Anda sendiri. Untuk langkah-langkah yang menuntut akurasi sangat tinggi, Anda juga bisa tetap memakai cara “dua salinan penalaran utama mengerjakan ulang secara independen”.
Q4: Bagaimana memilih antara `claude-fable-5-2` dan `claude-fable-5-2-thinking`?
Keduanya punya harga yang sama di tabel model APIYI, yaitu input 8, cache read 0.2, dan output 40 dolar per juta token. Halaman model resmi menyatakan bahwa thinking pada Fable 5.2 aktif secara default. Perbedaan konkret perilaku pemanggilan antara kedua ID ini mengacu pada keterangan model di platform; sebaiknya jalankan beberapa kali tugas yang sama pada masing-masing ID, bandingkan panjang output dan `usage`, lalu putuskan mana yang dipakai untuk penalaran utama.
Q5: Bagaimana cara memanggil model penalaran utama dan model peninjauan lewat satu antarmuka?
Setelah mendaftar di APIYI apiyi.com dan mendapatkan API Key, atur `base_url` SDK ke `https://api.apiyi.com/v1`. Untuk penalaran utama dan peninjauan, Anda cukup mengganti parameter `model`, misalnya `claude-fable-5-2` dan `claude-sonnet-5-5`. Pengguna baru mendapat kuota uji gratis, cocok untuk memverifikasi batas henti dan logika peninjauan terlebih dahulu.
Q6: Apa gunanya harga cache read dalam tugas panjang?
Harga cache read Fable 5.2 adalah 2,5% dari harga input, yakni 0,2 dolar per juta token. Tugas panjang multi-agen akan berulang kali membaca system prompt, materi latar belakang, dan progres bersama. Jika bagian ini dijaga stabil dan diletakkan di depan prompt, peluang cache hit lebih besar. Apakah terjadi cache hit dan bagaimana penagihannya mengacu pada dokumentasi platform.
Q7: Berapa nilai batas henti yang tepat?
Tidak ada angka universal. Sebaiknya mulai dari nilai konservatif: 10-30 putaran, 3-5 kali berturut-turut tanpa kemajuan, dan batas biaya per jalur yang disesuaikan dengan nilai soal. Setelah menyelesaikan satu batch, lihat distribusi alasan berhenti. Jika sebagian besar berhenti karena “batas biaya” padahal sudah hampir selesai, longgarkan sedikit. Jika sebagian besar karena “berturut-turut tanpa kemajuan”, berarti pemecahan tugasnya belum cukup rinci.
Q8: Apa saja keterbatasan pendekatan ini?
Pertama, model pemeriksa bisa saja melewatkan atau salah menilai, jadi perlu dikalibrasi dengan sampel yang sudah diketahui jawabannya. Kedua, estimasi biaya didasarkan pada harga resmi, belum memperhitungkan diskon cache dan fluktuasi dari percobaan ulang yang gagal. Ketiga, seperti pada postingan riset, kesimpulan akhir tetap memerlukan verifikasi eksternal, misalnya bukti formal atau tinjauan ahli di bidangnya; agen-agen yang saling meloloskan satu sama lain tidak berarti hasilnya sudah benar.
Poin-Poin Utama Memilih API untuk Tugas Agent Berat
- Sifat sumbernya: Riset lubang hitam Fable 5.2 adalah klaim resmi dari pihak pengembang, makalahnya masih preprint — lihat metodenya, bukan kesimpulannya
- Pisahkan peran: penalaran terbuka diserahkan ke model penalaran utama, pemeriksaan dengan standar jelas diserahkan ke model pemeriksa
- Pemeriksaan harus independen: model pemeriksa hanya menilai tanpa menalar ulang, dan mengeluarkan PASS / FAIL beserta alasannya
- Batas penghentian wajib dituliskan: empat batas — jumlah putaran, biaya, tanpa kemajuan beruntun, jumlah kegagalan — tidak boleh ada satu pun yang terlewat
- Hanya pakai model yang ada harga resminya: ID model dan harga satuan ditulis mati di dalam kode, mengganti model wajib dibarengi mengubah harganya
- Manfaatkan pembacaan cache: latar belakang dan progres yang stabil diletakkan di bagian awal, biaya baca cache hanya 2.5% dari harga input
- Mulai dari satu pintu masuk yang seragam: lewat APIYI, satu Key untuk beralih antara model penalaran utama dan model pemeriksa; mulai dulu dengan kuota gratis untuk soal kecil
Ringkasan
Dari kasus Claude Fable 5.2 yang memecahkan soal fisika lubang hitam, ada tiga hal yang paling layak dijadikan acuan untuk tugas Agent yang intensif:
- Pisahkan penalaran utama dan peninjauan ulang: Postingan riset menggunakan beberapa salinan model yang sama untuk saling memeriksa. Anda bisa mengembangkan pendekatan ini dengan memilih model berharga berbeda sesuai peran, lalu memverifikasi kualitas peninjauan ulang menggunakan sampel.
- Tuliskan batas penghentian dengan jelas untuk setiap jalur: 61 percobaan gagal menunjukkan bahwa kegagalan adalah hal biasa. Jumlah putaran, biaya, tidak adanya kemajuan, dan jumlah kegagalan semuanya harus memiliki batas.
- Hanya panggil model yang harga satuannya tercantum di tabel model: Tulis ID model dan harga satuan seperti
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5, dan sebagainya ke dalam kode. Dengan begitu, biaya dapat diperkirakan dan dibatasi hingga batas maksimum.
Keberhasilan tugas panjang sering kali tidak bergantung pada seberapa cerdas satu kali pemanggilan, tetapi pada apakah alur keseluruhan dapat terus berjalan dalam anggaran yang terkendali dan menghasilkan luaran yang dapat diverifikasi. Disarankan untuk menggunakan APIYI apiyi.com dengan kuota uji gratis untuk menjalankan satu soal kecil dari awal hingga berhasil terlebih dahulu, lalu menyesuaikan parameter secara bertahap dan memperluas skala berdasarkan alasan penghentian.
📚 Referensi
-
Postingan riset Anthropic: Keterangan resmi tentang Claude Fable 5.2 yang menyelesaikan dua soal fisika lubang hitam secara multi-agen
- Tautan:
anthropic.com/research/claude-black-hole-physics - Keterangan: Deskripsi langsung untuk memahami pembagian tugas agen, durasi, dan cara peninjauan ulang
- Tautan:
-
Makalah preprint pertama: Preprint yang terkait dengan postingan riset, belum melalui tinjauan sejawat
- Tautan:
hexagonmath.org/2611.00175v1 - Keterangan: Cocok bagi pembaca yang ingin melihat teks asli hasilnya
- Tautan:
-
Makalah preprint kedua: Preprint lain yang terkait dengan postingan riset, belum melalui tinjauan sejawat
- Tautan:
hexagonmath.org/2611.00174v1 - Keterangan: Bacalah dengan membandingkannya dengan makalah sebelumnya
- Tautan:
-
Halaman model resmi Claude Fable 5.2: ID model, konteks, output maksimum, dan harga resmi
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Memeriksa spesifikasi model dan tingkatan harga resmi
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI; penjelasan model dan harga dapat dilihat di pusat dokumentasi docs.apiyi.com


