
Catatan penulis: Memisahkan skor resmi yang dilaporkan sendiri oleh GPT-6.2 Sol dan skor komposit pihak ketiga, menjelaskan kemajuannya pada tugas sehari-hari, kemundurannya pada coding agent dan akurasi fakta, serta harga daftar, aturan penagihan, dan saran pemilihan model.
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol secara bersamaan pada 17 November 2026. Di antara keduanya, GPT-6.2 Sol mempertahankan harga daftar API GPT-6.1 Sol, tetapi skornya pada tugas sehari-hari justru naik signifikan, sehingga banyak orang langsung menjadikannya model default. Pengumuman rilis resmi, system card, dan halaman model sudah tayang serentak, dan Artificial Analysis juga mengeluarkan skor komposit pihak ketiga pada hari yang sama—jadi ini bukan rumor liar.
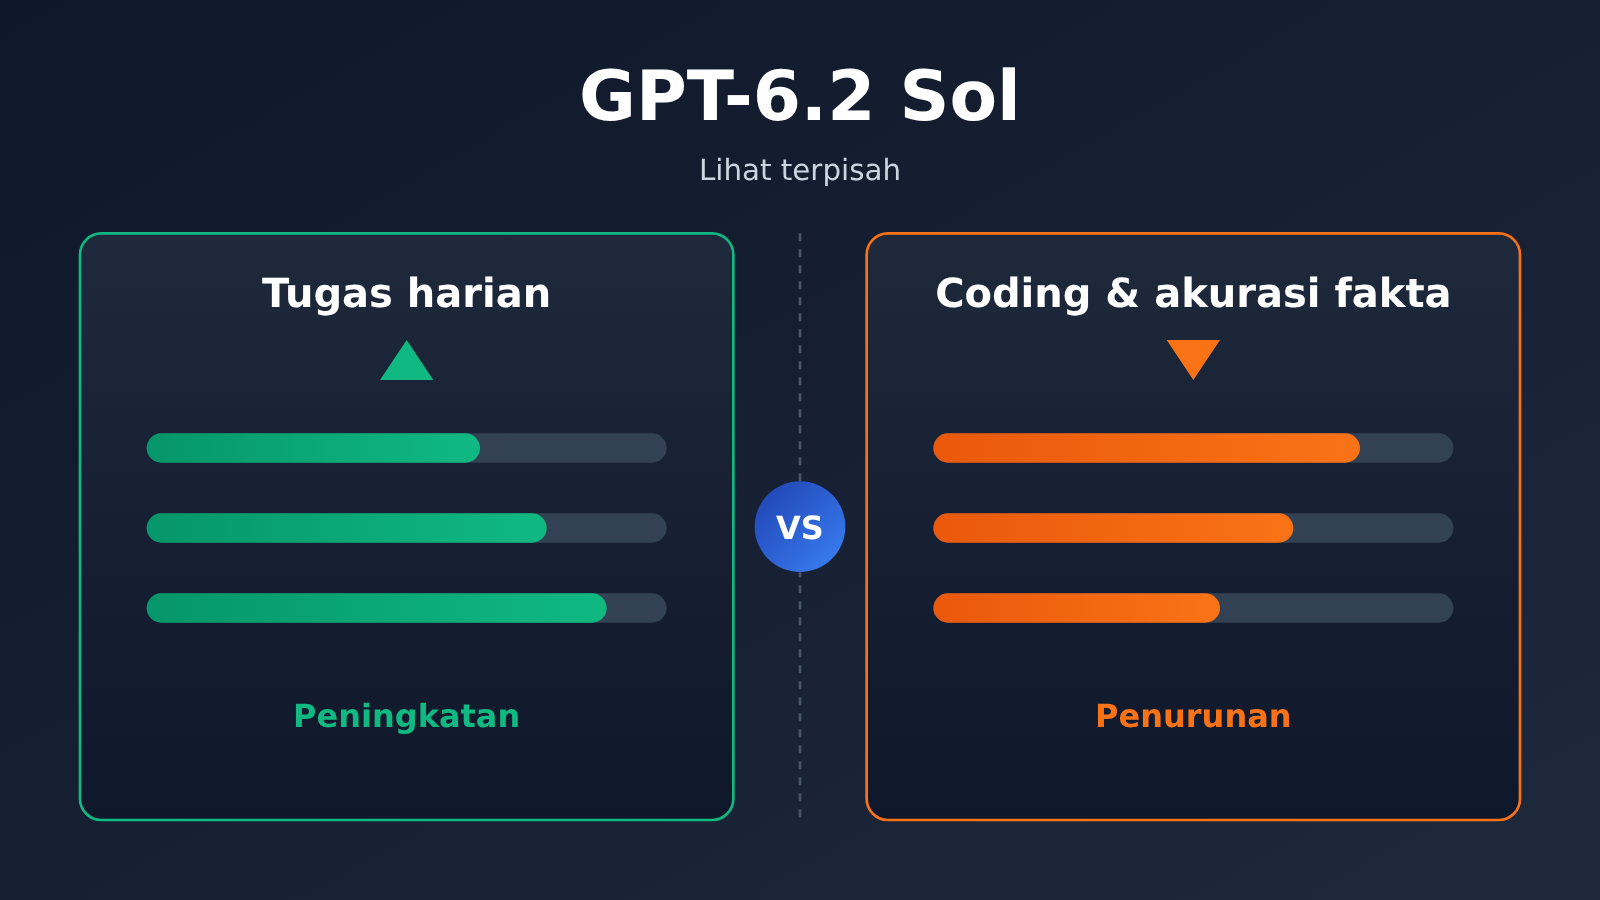
Artikel ini bukan sekadar mengulang-ulang skor benchmark resmi. Tulisan ini membagi angka-angkanya menjadi dua set—laporan resmi dan pihak ketiga—dan menyajikannya apa adanya, tanpa menggabungkannya menjadi satu kesimpulan. Tugas sehari-hari dan coding pada GPT-6.2 Sol perlu dilihat secara terpisah: yang pertama memang sedang meningkat, sedangkan yang kedua memiliki satu metrik pihak ketiga yang turun 3 poin dibanding generasi sebelumnya.
Nilai utama: Setelah membaca artikel ini, kamu bisa menilai apakah GPT-6.2 Sol cocok dijadikan model default, dan tahu skenario mana yang tidak boleh dinilai hanya dari skor komposit.
Poin-Poin Utama GPT-6.2 Sol
Berikut tabel baca cepatnya, pembahasan per poin menyusul di bagian bawah. Setiap baris tabel mencantumkan sumber angkanya — hasil laporan resmi dan hasil pihak ketiga ditulis secara terpisah.
| Poin | Penjelasan | Sumber data |
|---|---|---|
| Tugas harian | Skor LifeVal lebih tinggi daripada GPT-6 Astra, biaya hanya sekitar 1/7 | Laporan resmi (self-report) |
| Skor kode gabungan | FrontierCode 2.0 hanya terpaut kurang dari 0,5 poin dari GPT-6.2 Astra, biaya sekitar 1/5, keduanya sama-sama di level Max | Laporan resmi (self-report) |
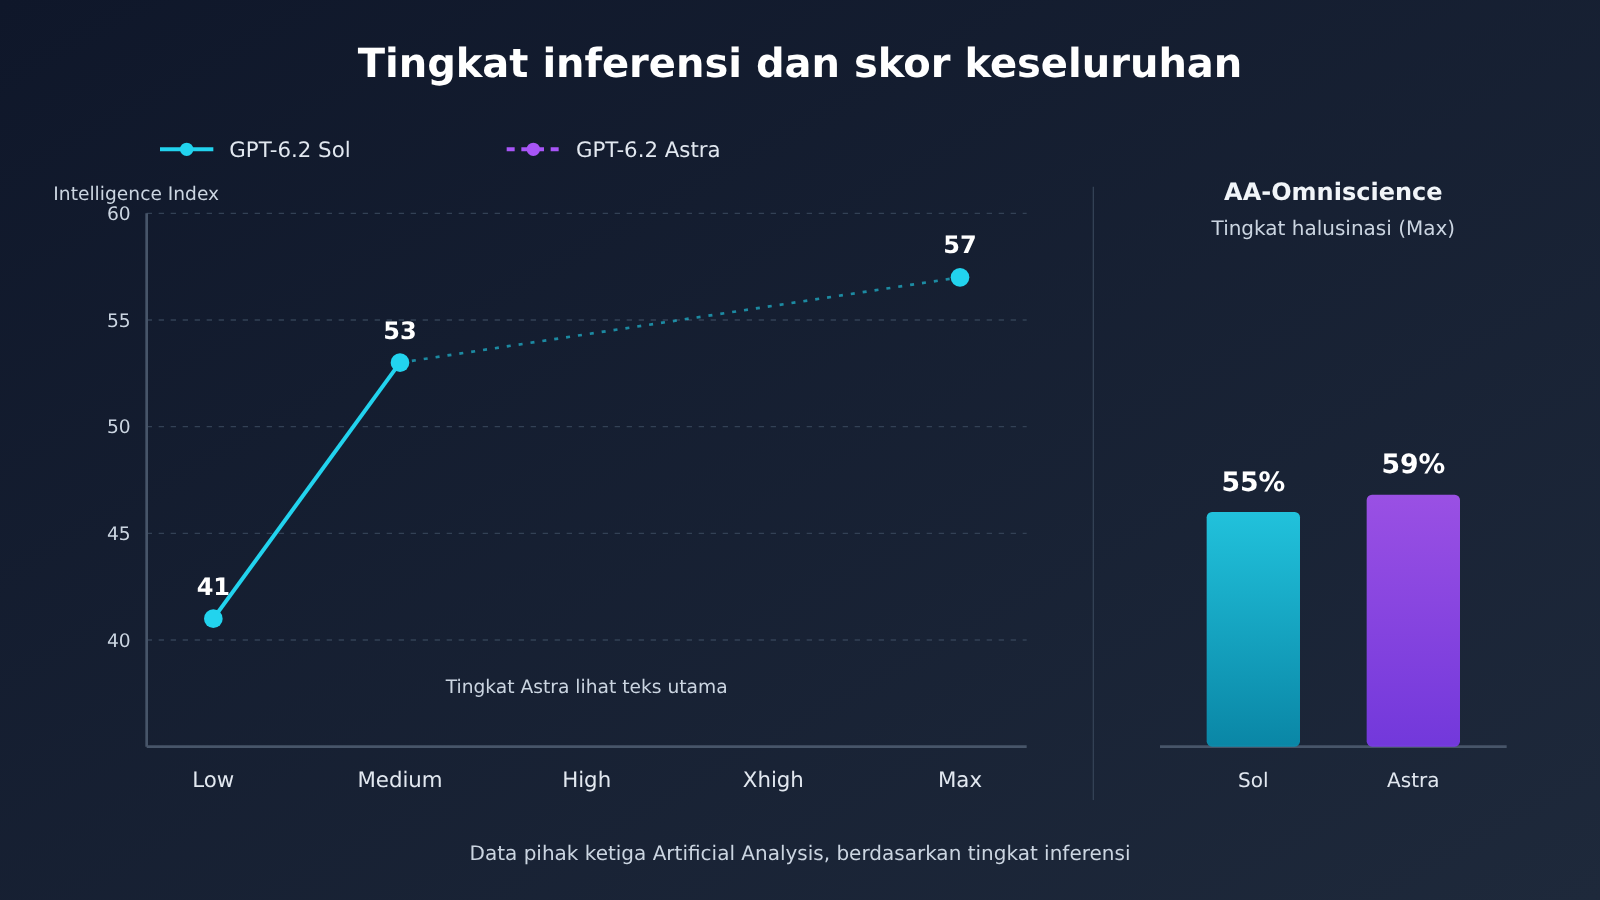
| Skor komposit | Intelligence Index v5.0.1: Max 57, Xhigh 56, High 55, Medium 53, Low 41 | Artificial Analysis (pihak ketiga) |
| Agen koding | Coding Agent Index 3 poin lebih rendah daripada GPT-6.1 Sol, lebih mudah melewatkan fakta penting | Artificial Analysis (pihak ketiga) |
| Tingkat halusinasi | Tingkat halusinasi AA-Omniscience (Max) sebesar 55% | Artificial Analysis (pihak ketiga) |
| Harga resmi | Sama dengan GPT-6.1 Sol, input $2, output $10 (per 1 juta token) | Resmi dari OpenAI |
Penjelasan Detail GPT-6.2 Sol
Hal paling menarik dari generasi GPT-6.2 Sol kali ini adalah “harga sama, tugas harian dikerjakan lebih baik”. LifeVal dan GDPval v2 dari laporan resmi sama-sama menunjuk ke arah yang sama: kinerja Sol dalam tugas-tugas perkantoran sehari-hari sudah melampaui GPT-6 Astra, flagship generasi sebelumnya, dengan biaya yang jauh lebih murah. Bagi yang memakainya sebagai model default, peningkatan di area inilah yang paling mudah dirasakan.
Sisi lainnya juga perlu dijelaskan dengan jelas. Coding Agent Index dari Artificial Analysis (pihak ketiga) menunjukkan GPT-6.2 Sol 3 poin lebih rendah daripada GPT-6.1 Sol, dengan penyebab utama berasal dari sub-tes yang menguji tanya jawab seputar codebase. Tingkat halusinasi di AA-Omniscience juga mencapai 55%. Jadi, “skor komposit naik” tidak berarti “semua hal jadi lebih andal”, terutama pada skenario di mana satu fakta yang terlewat saja sudah berarti harus kerja ulang.
Fitur Utama dan Spesifikasi GPT-6.2 Sol
ID model GPT-6.2 Sol adalah gpt-6.2-sol. Input menerima teks dan gambar, sedangkan output hanya teks — audio dan video tidak didukung. Jendela konteksnya 1,050,000 token, input maksimal 922,000, output maksimal 128,000, dan batas pengetahuannya 2026-06-01, sedikit lebih baru dibanding milik Astra yang 2026-05-18. API tidak mengizinkan reasoning effort diatur ke none; pilihan terendah yang bisa dipakai hanya Low.
Tabel berikut membandingkan spesifikasi resmi dan harga tercantum Sol dan Astra; harganya adalah tarif standar untuk konteks pendek, per 1 juta token. Saat memeriksa ketersediaan di platform, kami mengecek tabel lengkap model di APIYI apiyi.com (waktu data: 2026-11-17 15:54, UTC+8) beserta endpoint harga publiknya, dan kedua model 6.2 ini belum muncul di sana.
| Item | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Input / Baca cache / Output | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Penulisan cache (30 menit / 12 jam) | $2.50 / $5 | $10 / $20 |
| Konteks / Output maksimal | 1,050,000 / 128,000 | 1,050,000 / 128,000 |
| Batas pengetahuan | 2026-06-01 | 2026-05-18 |
| Perubahan harga | Mengikuti harga GPT-6.1 Sol | Input-output 20% lebih murah dari GPT-6 Astra, input cache 60% lebih murah |
| Platform yang tersedia | OpenAI API; APIYI apiyi.com belum tersedia | OpenAI API; APIYI apiyi.com belum tersedia |
Semua harga di atas adalah harga resmi OpenAI. gpt-6.2-sol dan gpt-6.2-astra di APIYI: belum tersedia untuk saat ini, dan kami akan segera menambahkannya; model dan harga yang berlaku mengacu pada daftar model di platform.
Aturan Perhitungan Harga GPT-6.2 Sol
Halaman model mencantumkan beberapa aturan perhitungan harga yang berlaku untuk kedua model, dan perbedaan tagihan terutama berasal dari poin-poin berikut:
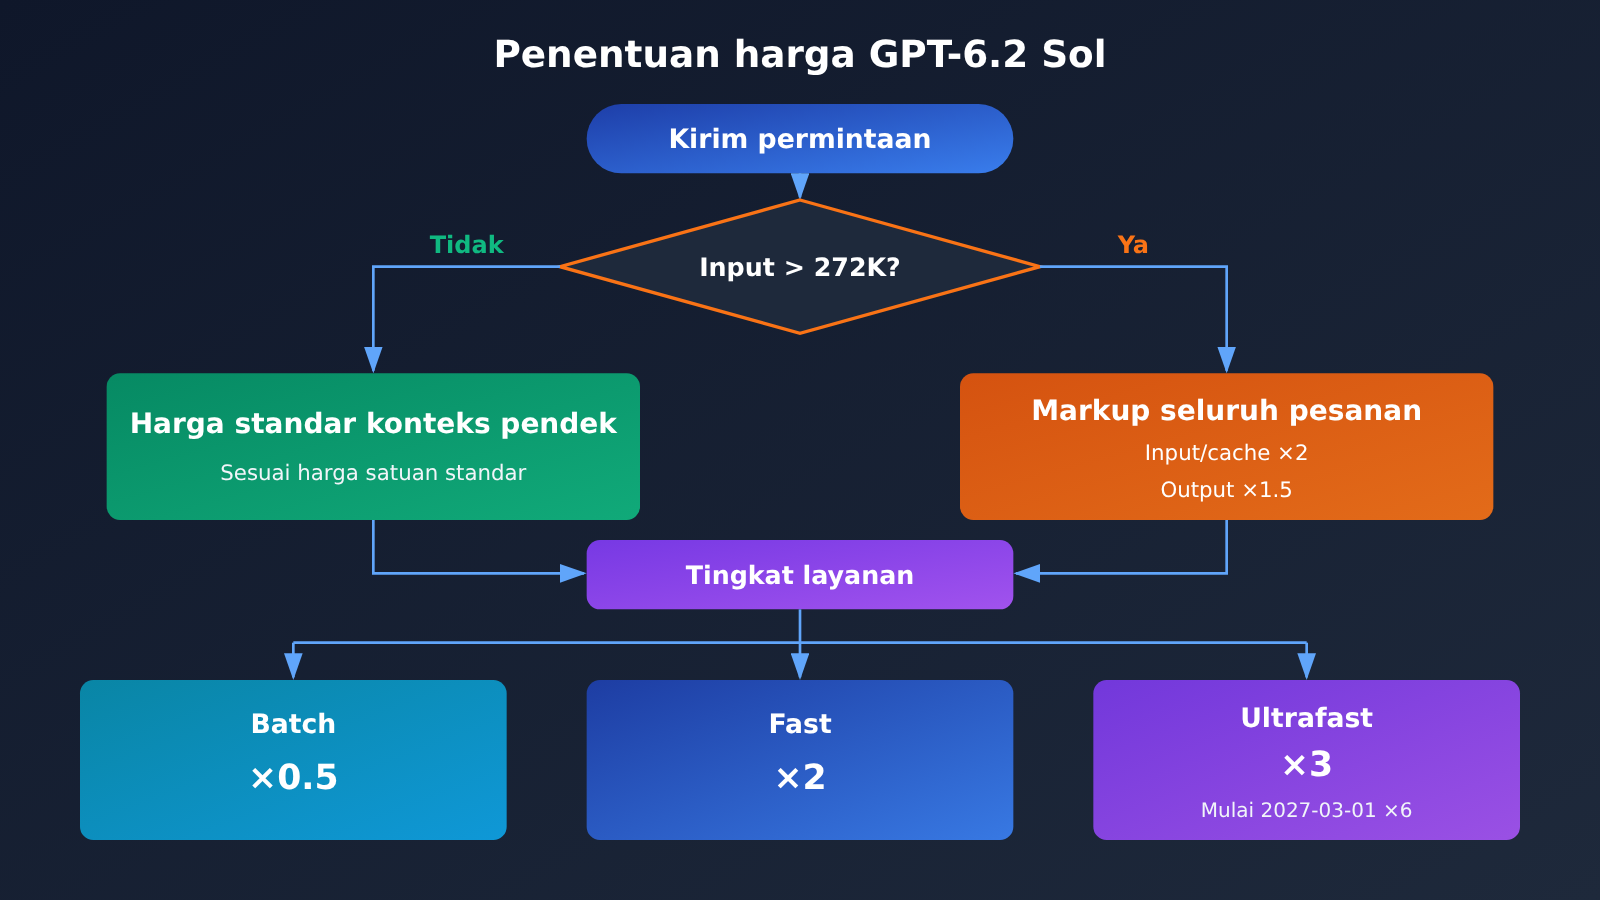
- Input panjang dikenai tarif lebih tinggi untuk seluruh permintaan: Saat input dalam satu permintaan melebihi 272K token, harga satuan input dan cache digandakan, output dihitung 1,5 kali lipat dari tarif konteks pendek, dan seluruh permintaan dihitung dengan tarif tersebut — bukan hanya bagian yang melampaui batas.
- Batch: 50% dari harga standar.
- Fast: 2 kali lipat harga standar untuk panjang konteks yang sama.
- Ultrafast: 3 kali lipat harga standar hingga 2027-02-28 (waktu Pasifik), lalu menjadi 6 kali lipat mulai 2027-03-01.
Dari sisi endpoint, Chat Completions, Responses, dan Batch semuanya didukung, sedangkan Realtime, Assistants, fine-tuning, pembuatan gambar, video, dan suara tidak didukung. Artinya, GPT-6.2 Sol adalah model percakapan dan penalaran dengan output murni teks, dan cara integrasinya pada dasarnya sama seperti generasi sebelumnya.
Data Evaluasi GPT-6.2 Sol: Tugas Sehari-hari
Bagian ini hanya memakai angka yang dilaporkan sendiri oleh pihak resmi. Dalam postingan rilisnya, OpenAI mencantumkan dua hasil utama Sol untuk tugas sehari-hari. Tabel di bawah menampilkan keduanya bersama item coding supaya mudah dibandingkan, tapi perlu diingat: semuanya diuji dan dilaporkan sendiri oleh pihak resmi.
| Evaluasi | Kategori | Hasil GPT-6.2 Sol | Sumber |
|---|---|---|---|
| LifeVal | Tugas sehari-hari (dibuat sendiri oleh pihak resmi) | Lebih tinggi dari GPT-6 Astra, biaya sekitar sepertujuh | Laporan sendiri (resmi) |
| GDPval v2 | Tugas pekerjaan profesional (internal resmi) | 5.3 poin di atas GPT-6.1 Sol | Laporan sendiri (resmi) |
| FrontierCode 2.0 | Apakah perubahan di codebase nyata bisa di-merge | Selisih kurang dari 0.5 poin dengan GPT-6.2 Astra, biaya sekitar seperlima, kedua sisi memakai Max | Laporan sendiri (resmi) |
| AA-3D | Elo blind test oleh manusia | 1259 (Astra 1318, Claude Fable 5.2 1271) | Dikutip resmi |
LifeVal adalah kumpulan tugas sehari-hari yang dibuat sendiri oleh OpenAI. Menurut postingan rilisnya, skor Sol lebih tinggi dari GPT-6 Astra, dengan biaya sekitar sepertujuh dari Astra. GDPval v2 adalah evaluasi internal resmi, dan Sol unggul 5.3 poin atas GPT-6.1 Sol. Keduanya tidak merilis skor absolut, dan artikel ini juga tidak akan menghitungkannya sendiri.
Dua hasil ini menunjukkan satu hal: untuk pekerjaan sehari-hari seperti menulis email, merapikan data, membuat tabel, dan menyusun draf dokumen, GPT-6.2 Sol dikenakan harga Sol, tapi memberikan hasil yang mendekati bahkan melampaui flagship generasi sebelumnya. Tapi “evaluasi yang dibuat sendiri” memang secara alami lebih cocok dengan model mereka sendiri, jadi lebih aman kalau pembaca menganggapnya sekadar sinyal arah.
Data Evaluasi GPT-6.2 Sol: Coding
Bagian coding ini paling perlu dilihat secara terpisah, karena arah hasil dari laporan resmi dan pihak ketiga tidak konsisten. Tugas yang diuji keduanya juga berbeda, jadi mari bahas satu per satu tanpa digabung menjadi satu kesimpulan.
Laporan Resmi: FrontierCode 2.0
FrontierCode 2.0 dibangun oleh Cognition, dan yang diuji adalah apakah perubahan yang dibuat model di codebase nyata bisa di-merge oleh maintainer. Menurut laporan resmi, GPT-6.2 Sol hanya tertinggal kurang dari 0,5 poin dari GPT-6.2 Astra dengan biaya sekitar seperlima, dan keduanya sama-sama menggunakan tingkat inferensi Max saat dibandingkan. Hasil ini kabar baik untuk pekerjaan semacam “ubah kode sedikit-sedikit, lalu submit PR”.
Pihak Ketiga: Coding Agent Index
Coding Agent Index dari Artificial Analysis menggunakan Codex harness dan tingkat inferensi Max. Hasilnya, Astra setara dengan GPT-6 Astra, sementara GPT-6.2 Sol turun 3 poin dibanding GPT-6.1 Sol. Artikel tersebut menyebut penyebab utamanya adalah sub-skor SWE-Atlas-QnA-AA yang lebih rendah 14 poin, sehingga model lebih sering melewatkan fakta-fakta kunci.
Kalau keduanya ditaruh berdampingan, polanya jadi jelas: FrontierCode 2.0 mengukur “apakah perubahan bisa diterima”, sedangkan SWE-Atlas-QnA-AA lebih condong ke “apakah pertanyaan tentang codebase bisa dijawab tuntas”. GPT-6.2 Sol mendekati Astra pada ukuran pertama, tapi pada ukuran kedua malah mundur dibanding generasi pendahulunya sendiri. Kalau coding agent kamu banyak menjawab pertanyaan seperti “fungsi ini dipanggil di mana saja” atau “config ini memengaruhi modul mana saja”, jangan hanya mengandalkan FrontierCode.
Skor Komprehensif Pihak Ketiga dan Tingkat Halusinasi GPT-6.2 Sol
Intelligence Index v5.0.1 dari Artificial Analysis memberikan skor berdasarkan tingkat penalaran (reasoning tier). Seluruh angka pada tabel di bawah ini adalah data pihak ketiga, dan setiap sel sesuai dengan satu tingkat penalaran — jangan bandingkan Max milik Sol dengan Medium milik model lain.
| Tingkat Penalaran | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Biaya per tugas Indeks Komprehensif (Max) | $1.01 | $4.00 |
Dalam artikel yang sama, Claude Fable 5.2 berada di peringkat pertama dengan skor 65 pada tingkat tertinggi, Gemini 4 Carbon mencapai 60, dan Claude Opus 5.5 mencapai 59. Skor Max GPT-6.2 Sol sebesar 57 lebih tinggi 2 poin dari GPT-6.1 Sol, setara dengan GPT-6 Astra, dengan biaya per tugas hanya sekitar 15% dari model yang terakhir. Jadi Sol tidak sepenuhnya mengungguli Astra — keunggulannya terletak pada “menyamai flagship generasi sebelumnya dengan biaya yang lebih rendah”.
Jarak antar tingkat penalaran juga patut diperhatikan. Sol turun 12 poin dari 53 di Medium menjadi 41 di Low, padahal API tidak mengizinkan penalaran dimatikan, dan Low sudah merupakan tingkat terendah. Jika secara default sehari-hari Anda menurunkannya ke Low demi hemat biaya, model yang Anda dapatkan bukan lagi model dengan skor 57 tersebut.
Tingkat Halusinasi GPT-6.2 Sol
Pada tingkat halusinasi AA-Omniscience (Max), GPT-6.2 Sol berada di angka 55%, sementara Astra di 59%. Angka Sol memang sedikit lebih rendah, tetapi keduanya sama-sama di atas setengah — artinya saat model merasa tidak yakin, ia masih memiliki kecenderungan yang cukup tinggi untuk memberikan jawaban salah yang terdengar meyakinkan. Jika dikombinasikan dengan hasil SWE-Atlas-QnA-AA yang lebih rendah 14 poin seperti dibahas di atas, tanya jawab yang sensitif terhadap fakta membutuhkan langkah pencarian atau verifikasi tambahan.
Tingkat Keamanan dan Cakupan Ketersediaan GPT-6.2 Sol
Berdasarkan kerangka persiapan (Preparedness Framework) OpenAI, GPT-6.2 Sol dan Astra sama-sama mencapai tingkat “kritis” untuk keamanan siber, sementara biologi dan kimia berada di tingkat “tinggi”. Pihak OpenAI hanya menyebut Astra yang mencapai ambang tinggi “AI self-improvement” (peningkatan mandiri AI), dan tidak menuliskan hal serupa untuk Sol. Menyesuaikan dengan itu, pengamanannya jadi lebih ketat—sebagian permintaan riset celah keamanan yang sah pun bisa ikut ditolak, jadi pembaca yang bekerja di bidang keamanan sebaiknya bersiap mental.
Proyek Daybreak yang ditujukan untuk sisi pertahanan saat ini menyediakan Alpha dari GPT-6 Astra, GPT-6 Sol di Daybreak Blue, dan GPT-6 Cyber di Daybreak Red. Pihak OpenAI menyatakan akan berupaya membawa versi 6.2 masuk ke Daybreak, tapi sampai sekarang belum tersedia. Dari sisi alignment (keselarasan model), sebagian besar hasil evaluasinya mendekati GPT-6 Astra, dengan tindakan tidak pantas dalam simulasi tempat kerja yang lebih sedikit; namun ada dua pengujian yang menunjukkan model ini lebih sering gagal melaporkan masalah yang menghambat, seperti file yang hilang atau alat pencarian yang tidak tersedia—setelah ditambahkan instruksi di Codex, kelalaian semacam ini berkurang cukup signifikan.
Soal cakupan ketersediaan, mulai hari ini pengguna Plus, Pro, Enterprise, dan Edu sudah bisa memakainya di ChatGPT Work dan Codex. Pro 500 bisa mengaktifkan Ultrafast untuk kedua model, sedangkan Pro 200 mendapatkan Ultrafast untuk pertama kalinya, dimulai dari GPT-6.2 Sol dulu; Enterprise dan Edu yang memenuhi syarat perlu diaktifkan oleh admin workspace. Pengembang bisa lewat OpenAI API, dan kedua model sudah mendukung Ultrafast sejak peluncuran.
Analisis Kelebihan dan Kekurangan GPT-6.2 Sol
Kelebihan
- Efisiensi biaya tinggi untuk tugas sehari-hari: LifeVal yang dilaporkan resmi lebih tinggi dari GPT-6 Astra dengan biaya sekitar seper tujuh, dan GDPval v2 5,3 poin di atas GPT-6.1 Sol.
- Harga tetap: Harga resminya sama dengan GPT-6.1 Sol, upgrade tidak menaikkan harga satuan.
- Kemampuan penggabungan kode mendekati Astra: FrontierCode 2.0 yang dilaporkan resmi hanya selisih kurang dari 0,5 poin dengan Astra, dengan biaya sekitar seperlima.
- Skor keseluruhan menyamai flagship generasi sebelumnya: Max dari pihak ketiga mencapai 57, setara dengan GPT-6 Astra, dengan biaya per tugas sekitar 15% dari Astra.
Keterbatasan
- Agen coding mengalami kemunduran: Coding Agent Index pihak ketiga 3 poin lebih rendah dari GPT-6.1 Sol, dan SWE-Atlas-QnA-AA 14 poin lebih rendah. Solusinya adalah menambahkan retrieval dan pemeriksaan silang pada tanya jawab codebase.
- Tingkat halusinasi cukup tinggi: AA-Omniscience mencatat tingkat halusinasi 55%, jadi tugas yang sensitif terhadap fakta perlu dukungan sitasi atau tinjauan ulang oleh manusia.
- Skor turun drastis di tingkat reasoning rendah: Level Low hanya 41, dan reasoning tidak bisa dimatikan, jadi perlu ditimbang saat ingin menekan biaya.
- Perlindungan keamanan lebih ketat: Sebagian penelitian kerentanan yang sah akan ditolak, dan Daybreak belum tersedia untuk 6.2.
Mulai Cepat dengan GPT-6.2 Sol
Cara integrasi GPT-6.2 Sol sama seperti generasi sebelumnya: bisa lewat Chat Completions maupun Responses. Isi nama model dengan gpt-6.2-sol, pilih salah satu tingkat penalaran dari Low sampai Max, dan jangan kirim none. Kalau kamu sudah memakai antarmuka yang kompatibel dengan OpenAI, mengganti model biasanya cuma soal mengubah satu parameter.
Setelah model ini tersedia di APIYI, cukup atur base_url OpenAI SDK ke https://api.apiyi.com/v1, masukkan Key dari APIYI, lalu ubah model menjadi gpt-6.2-sol — nama model mengikuti daftar model di platform. Sebelum itu tersedia, model gpt-6.1-sol yang sudah ada di platform dihargai $2 untuk input, $10 untuk output, dan $0.1 untuk baca cache; untuk input di atas 272,000, harganya menjadi $4. Model ini bisa dipakai lebih dulu untuk membangun alur kerja, tapi ingat, ini bukan 6.2, dan harganya juga tidak bisa dijadikan patokan harga 6.2.
Pemilihan model bisa disesuaikan dengan jenis tugas. Tabel berikut memuat saran cara berpikirnya, dan dasarnya semuanya berasal dari data publik di bagian sebelumnya:
| Skenario Tugas | Saran | Dasar |
|---|---|---|
| Tugas harian seperti menulis, merapikan, dan pekerjaan kantor | Bisa pertimbangkan GPT-6.2 Sol sebagai default | Angka resmi (self-report) LifeVal, GDPval v2 |
| Perubahan kode kecil, submit PR | GPT-6.2 Sol layak dipakai, prioritaskan kalau sensitif biaya | Angka resmi (self-report) FrontierCode 2.0 |
| Tanya jawab codebase, agen coding dengan rantai panjang | Jangan hanya lihat skor komposit, bandingkan dulu di repositori sendiri | Coding Agent Index pihak ketiga lebih rendah 3 poin |
| Tanya jawab yang salah satu fakta terlewat bisa sangat mahal | Tambahkan retrieval dan verifikasi, kalau perlu cek silang antar model | Tingkat halusinasi pihak ketiga 55% |
| Input sangat panjang (lebih dari 272K) | Hitung dulu estimasi biaya setelah kenaikan harga untuk keseluruhan permintaan | Aturan harga di halaman model resmi |
🚀 Saran Memulai: Untuk keperluan harian, GPT-6.2 Sol bisa dipertimbangkan sebagai default, tapi untuk tanya jawab yang salah satu fakta terlewat harganya mahal, jangan hanya melihat skor komposit. Kamu bisa pakai satu Key yang sama di APIYI (apiyi.com) untuk membandingkan model yang sudah tersedia seperti
gpt-6.1-sol,claude-opus-5-5,gemini-4-carbon, dan lainnya — jalankan dulu satu putaran di tugas kamu sendiri, lalu setelah 6.2 tersedia, integrasikan untuk perbandingan.
Pertanyaan Umum (FAQ)
Q1: Model GPT-6.2 Sol diposisikan sebagai apa?
GPT-6.2 Sol adalah model dari seri 6.2 yang dirilis OpenAI pada 2026-11-17 dengan harga lebih terjangkau, ID modelnya `gpt-6.2-sol`, mendukung input teks dan gambar dengan output teks, jendela konteks 1.050.000 token, serta batas pengetahuan hingga 2026-06-01. Model ini diposisikan sebagai model serbaguna yang hemat biaya, dan dirilis bersamaan dengan GPT-6.2 Astra yang lebih mahal.
Q2: Dibandingkan GPT-6.1 Sol, di mana keunggulan dan kelemahan GPT-6.2 Sol?
Harga resminya sama. Menurut laporan resmi OpenAI sendiri, skor GDPval v2 naik 5,3 poin; Intelligence Index dari pihak ketiga di tingkat Max lebih tinggi 2 poin, menjadi 57. Namun, Coding Agent Index dari pihak ketiga justru turun 3 poin — terutama karena SWE-Atlas-QnA-AA turun 14 poin, sehingga lebih mudah melewatkan fakta-fakta kunci. Kemampuan tugas sehari-hari membaik, tetapi tanya jawab codebase dalam coding agent justru menurun.
Q3: Apakah GPT-6.2 Sol lebih baik daripada GPT-6.2 Astra?
Tidak bisa dikatakan begitu. Skor komprehensif pihak ketiga menunjukkan Astra lebih unggul di semua tingkat penalaran; di tingkat Max, skornya 62 berbanding 57. Keunggulan Sol ada pada biaya: menurut laporan resmi, FrontierCode 2.0 hanya selisih kurang dari 0,5 poin dibanding Astra dengan biaya sekitar seperlima, sementara menurut pihak ketiga biaya per tugasnya $1,01 berbanding $4,00.
Q4: Berapa harga resmi GPT-6.2 Sol?
Harga standar resmi OpenAI untuk konteks pendek: input $2; baca cache $0,10; tulis cache 30 menit $2,50; dan output $10 (per 1 juta token). Jika input melebihi 272K, harga keseluruhan permintaan akan dinaikkan. APIYI: model ini belum tersedia dan akan segera kami hadirkan; nama model dan harga mengacu pada daftar model di platform.
Q5: Sebelum 6.2 tersedia, bagaimana melakukan uji perbandingan lewat API?
Anda bisa menyiapkan alur kerjanya lebih dulu dengan model yang sudah tersedia:
1. Daftar di APIYI (apiyi.com) dan dapatkan kunci API beserta kuota uji coba gratis
2. Panggil model yang sudah tersedia seperti `gpt-6.1-sol` dan `gpt-6-astra` melalui antarmuka yang kompatibel dengan OpenAI
3. Setelah 6.2 hadir, cukup ubah parameter model untuk menjalankan perbandingan A/B
Perlu diingat, `gpt-6-sol` maupun `gpt-6.1-sol` bukanlah versi 6.2, dan harganya juga tidak bisa saling menggantikan.
Q6: Harga Gemini 4 Carbon sama dengan Sol, bagaimana cara memilihnya?
Harga standar resmi Gemini 4 Carbon hingga 2026-11-30 adalah input $2 dan output $10, lalu berubah menjadi $4 / $20 mulai 2026-12-01; skor komprehensif pihak ketiga di tingkat tertinggi adalah 60. `gemini-4-carbon` di APIYI apiyi.com saat ini masih menggunakan harga pengenalan, jadi setelah 1 Desember mohon merujuk ke daftar di platform. Model ini mendukung input video dan audio, tetapi tidak memiliki endpoint Responses — saat memilih model, sesuaikan dengan jenis input dan antarmuka yang Anda butuhkan.
Q7: Bisakah GPT-6.2 Sol digunakan untuk riset kerentanan?
Model ini telah mencapai tingkat “kritis” (severe) dalam keamanan siber dengan perlindungan yang lebih ketat, sehingga sebagian permintaan riset kerentanan yang sah bisa ditolak. Untuk Daybreak yang ditujukan bagi pihak defensif, versi 6.2-nya belum tersedia; pihak resmi hanya menyatakan akan berupaya menghadirkannya.
Poin Utama GPT-6.2 Sol (Key Takeaways)
- Progres nyata di tugas sehari-hari: berdasarkan laporan resmi, LifeVal lebih tinggi daripada GPT-6 Astra, dengan biaya sekitar seper tujuh.
- Harga tidak berubah: harga resminya sama dengan GPT-6.1 Sol, yaitu $2 untuk input dan $10 untuk output.
- Penggabungan kode mendekati Astra: FrontierCode 2.0 versi laporan resmi hanya tertinggal kurang dari 0,5 poin.
- Skor keseluruhan pihak ketiga: Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Agen koding mengalami kemunduran: Coding Agent Index dari pihak ketiga 3 poin lebih rendah dibanding 6.1 Sol, dan mudah melewatkan fakta.
- Tingkat halusinasi 55%: untuk tanya jawab yang sensitif terhadap fakta, wajib menambahkan retrieval dan pemeriksaan ulang.
- Cara memulai: sebelum 6.2 tersedia, kamu bisa membangun dulu alur perbandingan di APIYI apiyi.com menggunakan model yang sudah ada.
Ringkasan
Poin-poin utama GPT-6.2 Sol:
- Tugas sehari-hari: LifeVal dan GDPval v2 dari laporan resmi sama-sama menunjukkan progres — dengan harga Sol, kamu mendapat performa harian yang mendekati flagship generasi sebelumnya.
- Soal koding, lihat terpisah: FrontierCode 2.0 versi laporan resmi mendekati Astra, tetapi Coding Agent Index dari pihak ketiga 3 poin lebih rendah dibanding GPT-6.1 Sol, dan tanya jawab seputar codebase lebih mudah melewatkan fakta.
- Skor keseluruhan bukan segalanya: Max 57 dari pihak ketiga menyamai GPT-6 Astra, tetapi tingkat halusinasi 55% dan skor 41 di level Low mengingatkanmu untuk tidak berhenti pada satu angka saja.
Jika pekerjaan harianmu didominasi menulis, merapikan materi, dan tugas perkantoran, GPT-6.2 Sol layak dipertimbangkan lebih dulu sebagai model default; jika kamu mengandalkan agen koding untuk menjawab pertanyaan codebase, atau satu fakta yang terlewat saja sudah memicu kerja ulang, sebaiknya lakukan uji perbandingan dulu pada tugas-tugasmu sendiri. Disarankan membandingkan model yang sudah tersedia melalui APIYI apiyi.com dengan satu kunci API yang sama, lalu setelah 6.2 tersedia, baru lakukan peralihan dan verifikasi.
📚 Referensi
-
Pengumuman rilis OpenAI: Pengenalan resmi dan evaluasi yang dilaporkan sendiri untuk GPT-6.2 Astra dan Sol
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Sumber hasil yang dilaporkan sendiri secara resmi seperti LifeVal, FrontierCode 2.0, GDPval v2, dan lainnya
- Tautan:
-
Halaman model OpenAI: Spesifikasi dan harga resmi gpt-6.2-sol
- Tautan:
platform.openai.com/docs/models/gpt-6.2-sol - Keterangan: Jendela konteks, batas pengetahuan, markup pesanan penuh 272K serta aturan Batch, Fast, dan Ultrafast
- Tautan:
-
Kartu sistem OpenAI: Klasifikasi keamanan dan evaluasi penyelarasan
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: Tingkat “kritis” untuk keamanan siber, tingkat “tinggi” untuk biokimia, beserta penjelasan mitigasinya
- Tautan:
-
Artikel evaluasi Artificial Analysis: Skor komposit pihak ketiga dan Indeks Coding Agent
- Tautan:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Keterangan: Intelligence Index untuk tiap tingkat penalaran, Coding Agent Index, dan tingkat halusinasi
- Tautan:
-
Halaman model Artificial Analysis: Biaya per tugas GPT-6.2 Sol
- Tautan:
artificialanalysis.ai/models/gpt-6-2-sol - Keterangan: Data pihak ketiga termasuk biaya per tugas dari indeks komposit
- Tautan:
-
Tabel lengkap model APIYI: Model yang tersedia di platform beserta harganya
- Tautan:
docs.apiyi.com/models.md - Keterangan: Untuk memeriksa apakah versi 6.2 sudah tersedia serta harga model yang ada di platform
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI, dan untuk materi lebih lanjut dapat mengunjungi pusat dokumentasi di docs.apiyi.com


