
Catatan penulis: membedah Qwen4-Max, peringkat ke-6 di papan Code Arena WebDev: komposisi enam besar, jarak antar model Tiongkok, selisih dengan model teratas, serta cara membaca jumlah suara dan biaya per tugas yang benar.
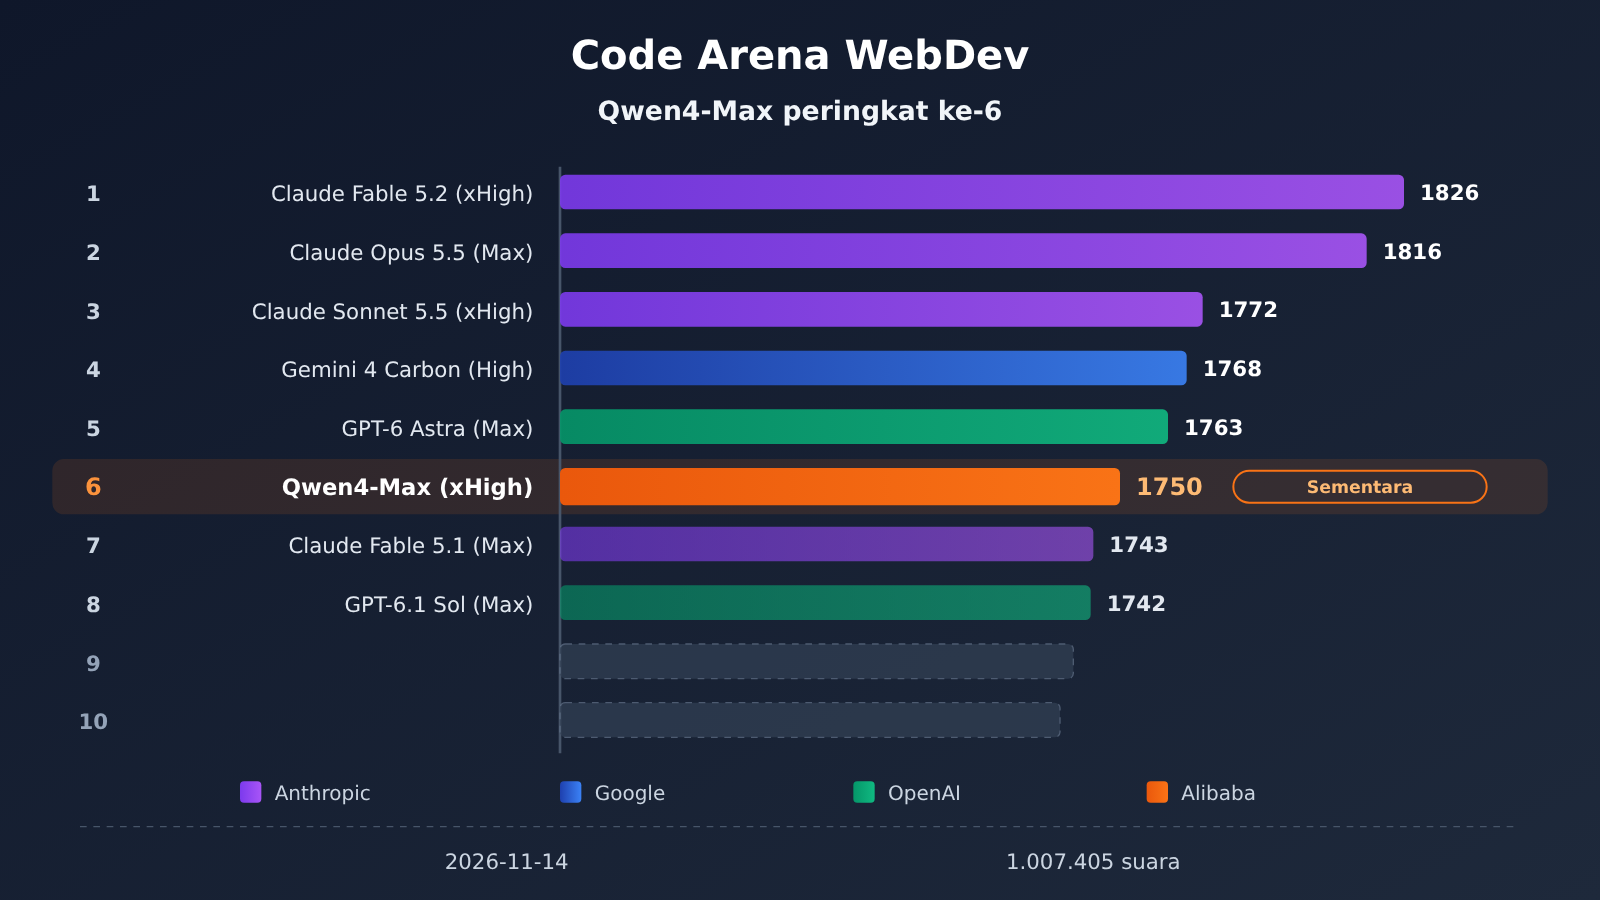
Langsung ke kesimpulan: di papan Code Arena WebDev milik arena.ai (kategori Overall, halaman bertanda 2026-11-14), Qwen4-Max (xHigh) berada di peringkat ke-6 dengan 1750 poin. Ini adalah pertama kalinya model Tiongkok masuk ke enam besar papan ini, sekaligus satu-satunya model dari laboratorium non-AS di enam besar.
Ini bukan artikel promosi yang mengemas peringkat ke-6 menjadi peringkat ke-1. Qwen4-Max di papan masih membawa label Preliminary, hanya memiliki 1,814 suara, dan peringkatnya masih bisa bergerak. Dalam gambar resmi Alibaba yang sama, model ini masih tertinggal jelas dari Opus 5.5 dan GPT-6 Astra di Terminal-Bench dan ProgramBench.
Nilai inti: setelah membaca artikel ini, Anda akan mendapatkan metadata papan peringkat yang bisa Anda buka dan verifikasi sendiri, serta memahami bagaimana peringkat ke-6 Qwen4-Max sebaiknya digunakan dan tidak digunakan.
Poin Inti Peringkat 6 Qwen4-Max Code Arena WebDev
Sebelum membahas peringkat, mari tampilkan dulu metadata daftar peringkat. Setiap pernyataan tentang “peringkat ke berapa” sebaiknya dicek lebih dulu tanggal, jumlah suara, dan jumlah model yang ikut dinilai. Kalau tidak, sulit menilai apakah peringkatnya benar-benar bisa dipertanggungjawabkan.
| Poin | Data (data publik dari daftar yang sama) | Cara membaca |
|---|---|---|
| Daftar dan kategori | arena.ai Code Arena WebDev, Overall | Hanya mewakili preferensi blind test untuk kategori pengembangan web |
| Tanggal halaman | 2026-11-14 | Peringkat terus berubah seiring berjalannya voting |
| Total suara / jumlah model | 1,007,405 suara / 159 model | Sampelnya besar, tetapi jumlah suara tiap model sangat berbeda |
| Peringkat dan skor Qwen4-Max | Peringkat 6, 1750 poin | Satu-satunya model dari laboratorium non-AS di enam besar |
| Jumlah suara dan label Qwen4-Max | 1,814 suara, Preliminary | Masih dalam tahap evaluasi awal |
| Biaya per tugas P50 | $4.18 | Median statistik di daftar, bukan harga satuan model |
Penjelasan Rinci Kriteria Peringkat Qwen4-Max
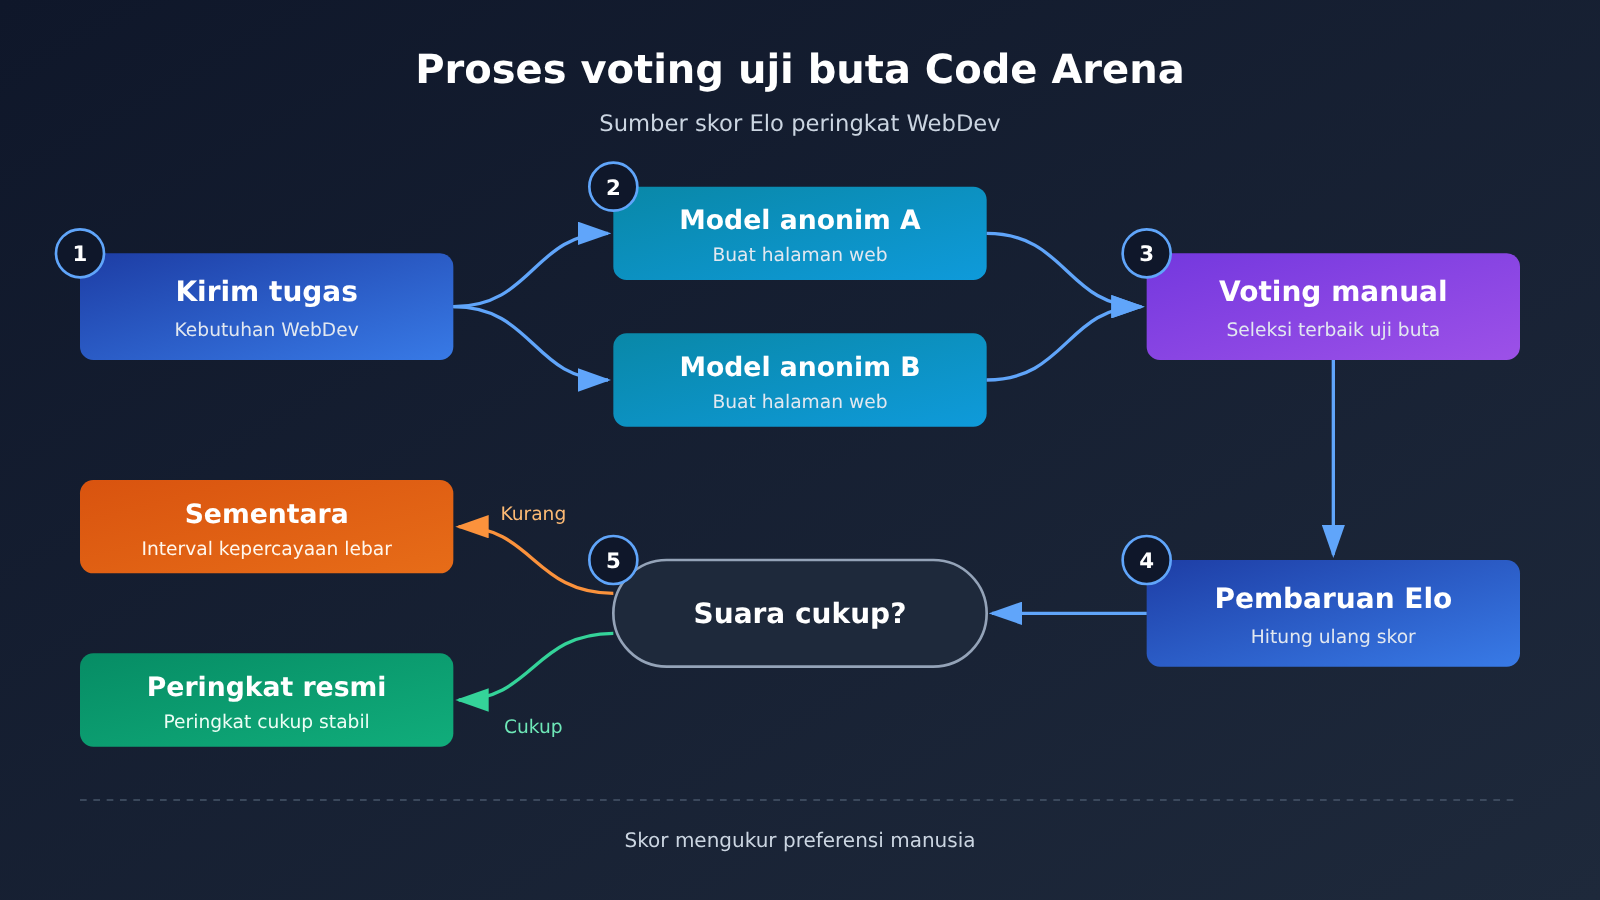
Skor Elo Code Arena berasal dari voting manual lewat blind test: pengguna memberikan tugas pengembangan web yang sama, melihat hasil dari dua model anonim, lalu memilih mana yang lebih baik. Skor ini mencerminkan “menurut penilai manusia, siapa yang membuat halaman web lebih baik”; yang diukur adalah preferensi, bukan skor produktivitas menyeluruh.
Arti label Preliminary juga perlu dipahami. Label ini menunjukkan bahwa model tersebut belum cukup banyak ikut pertandingan, sehingga interval kepercayaannya cenderung lebar. Gemini 4 Carbon (High), yang ada di peringkat 4 daftar yang sama, juga menyandang label ini. Jadi wajar saja kalau posisi di rentang peringkat 4 sampai 6 bisa bertukar dalam beberapa minggu ke depan.
Siapa Enam Besar Code Arena WebDev: Lanskap Pesaing Qwen4-Max
Menyajikan sepuluh besar secara lengkap membuat posisi Qwen4-Max lebih mudah terlihat. Lima posisi teratas ditempati oleh tiga laboratorium AS, dan Anthropic sendiri mengambil tiga kursi.
| Peringkat | Model | Skor | Lab asal | Catatan |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | Peringkat pertama |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 per tugas $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminary | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 per tugas $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Preliminary, 1,814 suara |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
Apa Arti Komposisi Lima Besar bagi Qwen4-Max
Di enam besar, Anthropic menempati 3 kursi (Fable 5.2, Opus 5.5, Sonnet 5.5), Google dan OpenAI masing-masing 1 kursi, dan Alibaba 1 kursi. Dengan kata lain, Qwen4-Max “menyelipkan” satu posisi di antara model flagship tiga laboratorium terkemuka, bukan sekadar memungut peringkat di papan peringkat yang longgar.
Detail lain yang perlu dicatat adalah peringkat 6 sampai 8 sangat rapat: 1750, 1743, 1742, selisih ketiganya kurang dari 10 poin. Keunggulan Qwen4-Max atas Claude Fable 5.1 dan GPT-6.1 Sol lebih kecil daripada jarak 13 poin di belakang GPT-6 Astra. Stabilitas peringkatnya baru bisa dinilai setelah jumlah suara bertambah.
Posisi Qwen4-Max di antara model domestik
Kalau hanya melihat kubu domestik, keunggulan Qwen4-Max cukup jelas. Ia satu-satunya model domestik yang masuk sepuluh besar, sementara peringkat kedua baru muncul di posisi ke-13.
| Peringkat domestik | Model | Skor | Peringkat daftar | Selisih dengan Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | ke-6 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | ke-13 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | ke-16 | −74 |
| 4 | Qwen3.8-Max | 1670 | ke-18 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | ke-18 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | ke-19 | −89 |
| 7 | Kimi K3 (Max) | 1658 | ke-20 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | ke-26 | −111 |
| 9 | Hy4 preview | 1632 | ke-27 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | ke-31 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | ke-33 | −129 |
Dua makna di balik selisih internal domestik
Lapisan pertama adalah lompatan antargenerasi. Qwen4-Max lebih tinggi 74 poin dibanding generasi sebelumnya dari keluarga yang sama, Qwen3.8-Max (0902), dengan peringkat melonjak dari ke-16 ke ke-6. Di daftar yang sama dan mekanisme voting yang sama, kenaikan sebesar ini terbilang signifikan.
Lapisan kedua adalah jaraknya dengan runner-up domestik. Qwen4-Max unggul 64 poin atas Kimi K3.1 Pro, selisih yang mendekati 66 poin keterbelakangannya dari Opus 5.5. Artinya, Qwen4-Max saat ini berada di posisi tengah antara kubu domestik dan papan atas global: di bawah ia sudah menjauh dari pesaing domestik, tetapi ke puncak masih ada jarak yang harus ditempuh.
Perlu diingat, peringkat 2 sampai 7 domestik berdesakan di rentang 1686 hingga 1658 dengan selisih poin yang sangat tipis. Menggunakan daftar ini untuk menentukan urutan antar-kesembilan model tersebut kurang bermakna.
Seberapa jauh Qwen4-Max dari model teratas global?
Selisih skor di Code Arena WebDev
Mencantumkan selisih skor Qwen4-Max dengan model-model teratas, lalu memperkirakan “peluang menang dalam pertandingan langsung” secara kasar memakai rumus Elo umum (skala 400 poin), bisa membantu memahami makna nyata dari selisih tersebut. Metode statistik spesifik arena mungkin berbeda dari Elo standar, jadi persentase kemenangan berikut hanya sebagai gambaran intuitif:
- Melawan peringkat 5, GPT-6 Astra: 1750 vs 1763, selisih 13 poin, perkiraan kasar peluang menang sekitar 48%, praktis imbang.
- Melawan peringkat 2, Opus 5.5: selisih 66 poin, perkiraan kasar peluang menang sekitar 41%.
- Melawan peringkat 1, Fable 5.2: selisih 76 poin, perkiraan kasar peluang menang sekitar 39%.
- Melawan Kimi K3.1 Pro, peringkat kedua asal Tiongkok: unggul 64 poin, perkiraan kasar peluang menang sekitar 59%.
Rentang skor seluruh papan adalah 1071 hingga 1826. Pada skala ini, selisih 76 poin Qwen4-Max dari peringkat teratas terbilang tidak besar, tetapi juga menunjukkan bahwa dalam preferensi pengembangan web, model teratas dari Anthropic masih lebih disukai para juri.
Benchmark lain di gambar yang sama: Elo tinggi bukan berarti kuat di tugas terminal
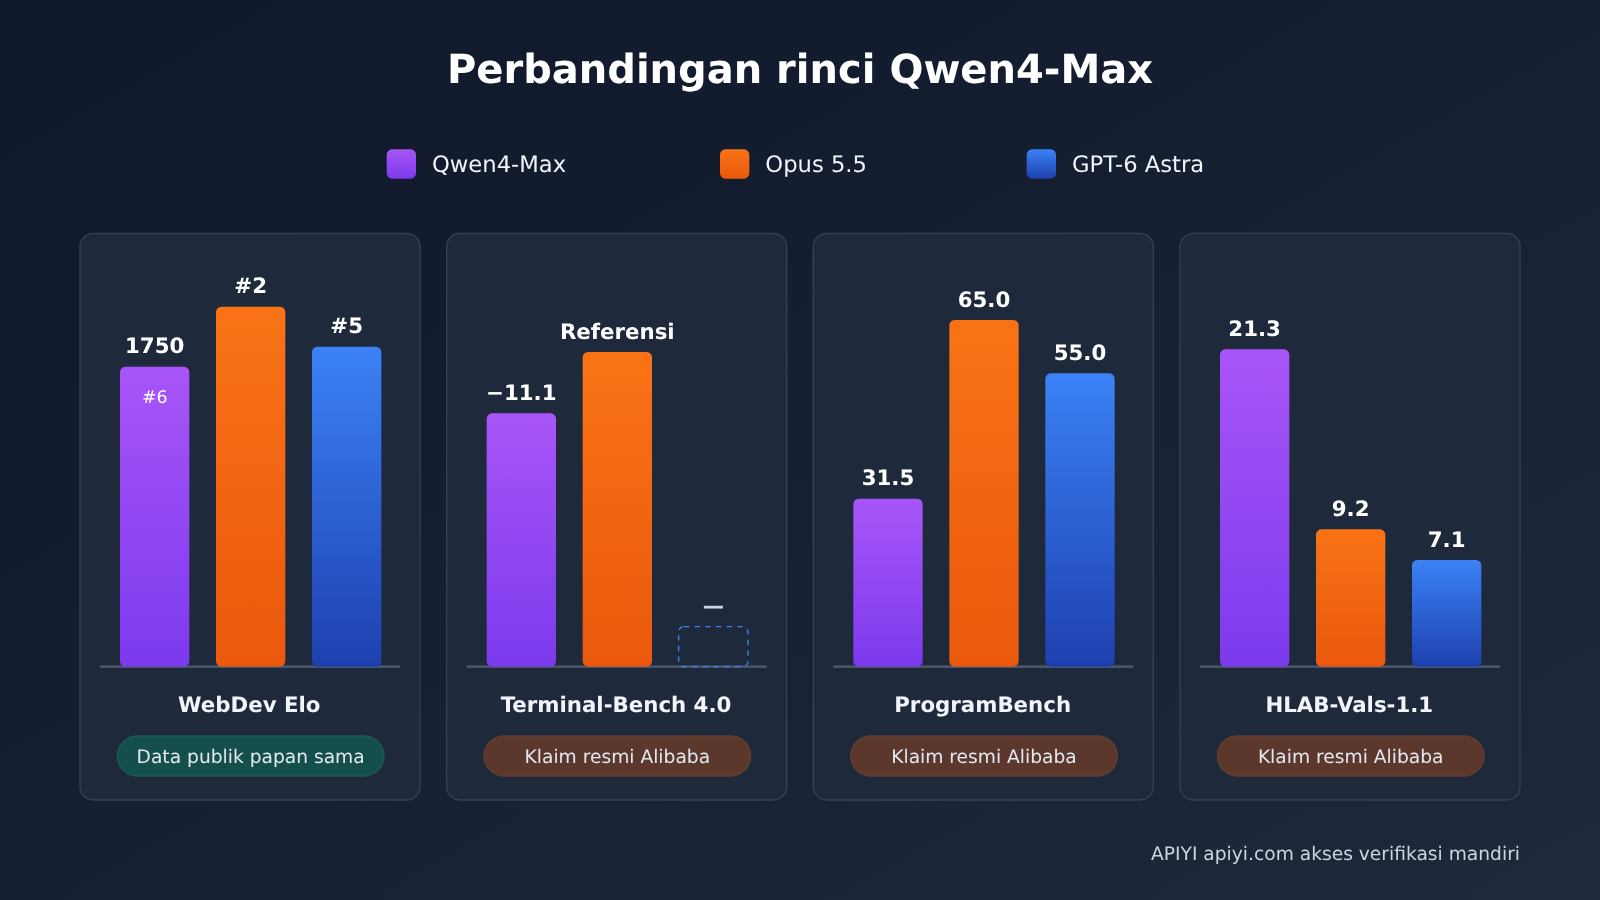
Saat merilis Qwen4-Max, Alibaba memakai satu gambar yang memuat beberapa benchmark. Data berikut semuanya dilaporkan sendiri oleh pihak resmi Alibaba, bukan data peringkat arena, dan bukan hasil replikasi pihak ketiga.
| Benchmark (laporan resmi) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Lainnya |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Tabel ini menunjukkan satu hal penting: Qwen4-Max mendapat skor tinggi dalam uji buta pengembangan web, tetapi selisihnya pada benchmark operasi terminal dan pemrograman rekayasa masih jelas. Di Terminal-Bench 4.0, skornya 11.1 poin lebih rendah dari Opus 5.5, bahkan model Kimi di gambar tersebut mendapat 67.2 yang lebih tinggi; di ProgramBench, skor 31.5-nya belum sampai setengah Opus 5.5.
Ia juga unggul jelas di beberapa item. Pada HLAB-Vals-1.1, Qwen4-Max memperoleh 21.3, jauh di atas Opus 5.5 yang 9.2 dan GPT-6 Astra yang 7.1; pada AA-Briefcase ia juga lebih tinggi dari GPT-6 Astra. Jadi deskripsi yang lebih akurat adalah: distribusi kemampuan Qwen4-Max berbeda dari model-model teratas, bukan “mendekati secara menyeluruh”.
Cara membaca jumlah suara dan biaya Qwen4-Max
Jumlah suara: apa arti 1,814 suara
Apakah sebuah posisi peringkat bisa bertahan, sebagian besar bergantung pada jumlah suara. 1,814 suara Qwen4-Max hanya kurang dari 0,2% dari total sekitar 1 juta suara, dan juga jauh lebih sedikit dibandingkan beberapa model dalam negeri di papan peringkat yang sama.
| Model | Peringkat | Jumlah suara | Biaya per tugas P50 | Status |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | ke-6 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | ke-13 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | ke-16 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | ke-2 | Data publik papan peringkat yang sama | $8.99 | — |
| GPT-6 Astra (Max) | ke-5 | Data publik papan peringkat yang sama | $9.43 | — |
Jumlah suara Qwen3.8-Max sekitar 12,7 kali lipat Qwen4-Max, sehingga skornya lebih mendekati “nilai stabil”. Skor 1750 Qwen4-Max saat ini lebih mirip pembacaan awal, yang nantinya bisa naik maupun turun. Saat mengutip peringkat ini, sebaiknya sertakan ketiga pembatas berikut: “Preliminary, 1,814 suara, 2026-11-14”.
Biaya P50 per tugas: bukan harga satuan model
Di papan peringkat ini, biaya P50 per tugas adalah median biaya satu kali pengerjaan tugas pada tugas yang tercantum. Angka ini sangat dipengaruhi oleh panjang output model dan tingkat intensitas penalaran (misalnya xHigh, Max), sehingga tidak dapat dipakai sebagai harga per juta token model untuk perbandingan.
Dengan ukuran ini, biaya $4.18 Qwen4-Max sekitar 46% dari Opus 5.5 ($8.99) dan 44% dari GPT-6 Astra ($9.43), tetapi sekitar 4.7 kali Kimi K3.1 Pro ($0.89) dan 2.2 kali Qwen3.8-Max generasi sebelumnya ($1.91). Jika skenario Anda sensitif terhadap biaya per tugas, Kimi K3.1 Pro meraih skor 1686 dengan biaya sekitar seperlima; ini juga layak dimasukkan ke dalam evaluasi.
Harga resmi Qwen4-Max dan harga APIYI saat ini
Berikut adalah harga per 1 juta token, dengan tanggal pengambilan data 2026-11-16:
- Harga resmi Qwen4-Max: input $1.5, output $4.5, baca cache $0.075.
- Model unggulan Qwen yang dijual APIYI
qwen3.8-max: input $1.65, output $4.95, baca cache $0.20625.
Perlu dicatat, APIYI saat ini belum menyediakan qwen4-max; kami akan segera menghadirkan model ini. Keduanya adalah model yang berbeda, jadi harga di atas tidak dapat dibandingkan secara langsung. Untuk ketersediaan model dan harga, silakan mengacu pada daftar model di platform APIYI apiyi.com.
Tiga langkah untuk memverifikasi ulang papan peringkat, mencocokkan harga, dan mengganti endpoint
Setelah membaca sebuah papan peringkat, developer biasanya melakukan tiga hal: memeriksa peringkat, memeriksa harga, dan mencoba memasukkan model ke proyek mereka sendiri. Sebaiknya ikuti urutan berikut:
- Verifikasi ulang papan peringkat: Buka halaman Code Arena WebDev di arena.ai, lalu pastikan apakah tanggal, jumlah suara, dan penanda Preliminary berubah.
- Cek harga: Di daftar model APIYI apiyi.com, lihat model Qwen yang sedang dijual beserta harga real-time, dan pastikan
qwen4-maxsudah tersedia. - Ganti endpoint: Di SDK yang sudah kompatibel dengan OpenAI, ubah base_url menjadi
https://api.apiyi.com/v1; isi ID model denganqwen3.8-maxuntuk sementara, lalu setelah model baru tersedia ganti keqwen4-maxuntuk membandingkan.
🚀 Saran cepat untuk memulai: Jika Anda ingin memverifikasi selisih antara seri Qwen dan Claude, GPT, Gemini pada tugas WebDev Anda sendiri, Anda bisa menggunakan APIYI apiyi.com untuk memanggil beberapa model sekaligus dengan satu kunci API. Pengguna baru mendapat kuota uji gratis, cocok untuk menjalankan sekumpulan sampel kecil terlebih dahulu sebelum menentukan pilihan model.
Analisis kelebihan dan kekurangan Qwen4-Max
Keunggulan Qwen4-Max
- Skor preferensi pengembangan web memimpin kubu model domestik Tiongkok: 1750 poin, 64 poin lebih tinggi dari model domestik peringkat kedua, dan 74 poin lebih tinggi dari generasi sebelumnya.
- Sebagian selisih dengan kelompok teratas sudah sangat kecil: hanya 13 poin dari peringkat ke-5 GPT-6 Astra, dan hampir setara dengan peringkat ke-7 serta ke-8.
- Biaya per tugas lebih rendah daripada model unggulan papan atas: P50 $4.18, kurang dari setengah Opus 5.5 dan GPT-6 Astra.
- Beberapa benchmark punya keunggulan unik: skor yang dilaporkan sendiri secara resmi oleh HLAB-Vals-1.1 jelas memimpin Opus 5.5 dan GPT-6 Astra.
Keterbatasan Qwen4-Max
- Peringkat belum stabil: penanda Preliminary ditambah 1,814 suara; saat mengutip, perlu mencantumkan syarat pembatas.
- Tertinggal pada benchmark terminal dan rekayasa pemrograman: pada Terminal-Bench 4.0 dan ProgramBench, jelas lebih rendah daripada Opus 5.5 dan GPT-6 Astra; saat membuat Agent atau otomasi command line, perlu evaluasi terpisah.
- Biaya per tugas lebih tinggi daripada sebagian model domestik: jauh lebih mahal daripada Kimi K3.1 Pro dan Qwen3.8-Max; untuk skenario yang sensitif biaya, belum tentu hemat.
Kapan sebaiknya tidak hanya melihat papan peringkat Code Arena WebDev
Jika skenario utama Anda adalah operasi terminal, perubahan kode dalam rantai panjang, atau tugas Agent multi-langkah, melihat WebDev Elo saja akan membuat Anda melebih-lebihkan performa aktual Qwen4-Max; pada titik ini, benchmark seperti Terminal-Bench lebih sesuai dengan kebutuhan. Demikian pula, jika anggaran menjadi batasan keras, biaya per tugas sebaiknya dilihat bersama skor, bukan hanya mengejar peringkat. Papan peringkat ini paling cocok untuk menjawab pertanyaan: “Di mata reviewer manusia, siapa yang menghasilkan halaman web lebih baik?”
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apakah peringkat ke-6 Qwen4-Max di papan Code Arena WebDev itu peringkat asli?
Ya, itu peringkat asli yang ditampilkan di halaman papan peringkat (2026-11-14, kategori Overall, 1750 poin). Namun ada tanda Preliminary, dengan hanya 1.814 suara, jadi peringkat berikutnya masih bisa berubah. Saat mengutip, sebaiknya cantumkan kondisi-kondisi ini.
Q2: Berapa selisih Qwen4-Max dengan GPT-6 Astra dan Opus 5.5?
Di Code Arena WebDev, Qwen4-Max berada 13 poin di bawah GPT-6 Astra, 66 poin di bawah Opus 5.5, dan 76 poin di bawah pemuncak klasemen Fable 5.2. Namun pada Terminal-Bench 4.0 dan ProgramBench yang dilaporkan sendiri oleh Alibaba, jaraknya dengan kedua model tersebut jelas lebih besar.
Q3: Seberapa jauh Qwen4-Max unggul di antara model domestik?
Ini satu-satunya model domestik yang masuk sepuluh besar, unggul 64 poin dari model domestik peringkat kedua Kimi K3.1 Pro (peringkat 13, 1686 poin), dan unggul 74 poin dari generasi sebelumnya milik mereka sendiri, Qwen3.8-Max (0902).
Q4: Skenario apa yang paling cocok untuk Qwen4-Max?
Dilihat dari cakupan papan peringkat ini, model tersebut lebih cocok untuk tugas WebDev seperti pembuatan front-end halaman web, landing page, dan prototipe interaktif. Untuk skenario seperti otomatisasi terminal dan modifikasi kode berskala besar tingkat engineering, sebaiknya merujuk pada benchmark khusus terminal dan menjalankan verifikasi sampel sendiri.
Q5: Bagaimana cara memanggil model seri Qwen lewat API untuk uji perbandingan?
Anda bisa mendaftar dan mendapatkan API Key di APIYI apiyi.com, lalu di SDK yang kompatibel dengan OpenAI setel base_url menjadi `https://api.apiyi.com/v1` dan isi model ID dengan `qwen3.8-max`. `qwen4-max` saat ini belum tersedia di platform, kami akan segera menghadirkannya; setelah tersedia, cukup ganti model ID untuk beralih pembanding.
Q6: Apakah biaya $4.18 per tugas itu harga Qwen4-Max?
Bukan. $4.18 adalah median biaya per tugas (P50) yang dihitung oleh papan peringkat, dan dipengaruhi oleh panjang output serta tingkat reasoning. Harga satuan model sebaiknya dilihat dari harga input, output, dan cache read per 1M token; harga terbaru bisa dicek di daftar model APIYI apiyi.com.
Poin-Poin Utama Qwen4-Max Code Arena WebDev
- Peringkat: peringkat ke-6 pada papan peringkat 2026-11-14 dengan 1750 poin; model Tiongkok pertama kali masuk enam besar.
- Komposisi: lima posisi teratas dikuasai tiga wakil Anthropic, satu Google, dan satu OpenAI.
- Stabilitas: bertanda Preliminary dengan 1,814 suara; peringkat masih bisa berubah.
- Posisi model Tiongkok: unggul 64 poin atas Kimi K3.1 Pro dan 74 poin atas generasi sebelumnya.
- Batas kemampuan: pada Terminal-Bench dan ProgramBench yang dilaporkan resmi sendiri, masih tertinggal dari model teratas.
- Dasar perhitungan biaya: P50 $4.18 adalah median per tugas, bukan harga satuan model.
- Cara memulai: Anda bisa lebih dulu menyiapkan alur perbandingan di APIYI menggunakan
qwen3.8-max, lalu beralih setelah model baru tersedia.
Ringkasan
Performa Qwen4-Max di papan Code Arena WebDev dapat diringkas menjadi tiga poin:
- Pertama kali masuk enam besar: 1750 poin, satu-satunya model dari laboratorium non-AS di enam besar, hanya terpaut 13 poin dari peringkat ke-5.
- Peringkat masih bacaan awal: status Preliminary, 1,814 suara; saat mengutip, tuliskan tanggal dan jumlah suara secara jelas.
- Elo tidak berarti unggul secara menyeluruh: pada benchmark terminal dan pemrograman rekayasa yang dilaporkan resmi sendiri, model ini masih tertinggal dari Opus 5.5 dan GPT-6 Astra.
Jika Anda sedang memilih model, sebaiknya gunakan papan peringkat ini sebagai salah satu dimensi referensi untuk “preferensi pengembangan web”, lalu padukan dengan sampel tugas dan anggaran biaya Anda sendiri untuk mengambil keputusan. Disarankan melalui APIYI apiyi.com memakai antarmuka terpadu untuk membandingkan model kandidat pada kumpulan tugas yang sama, dan menarik kesimpulan berdasarkan data Anda sendiri.
📚 Referensi
- Papan Code Arena WebDev arena.ai: sumber peringkat, skor, jumlah suara, dan biaya per tugas dalam artikel ini
- Tautan:
arena.ai -
Keterangan: Halaman bertanda 2026-11-14, kategori Overall, Anda dapat memeriksa sendiri peringkat terbaru dan tanda Preliminary
-
Gambar rilis resmi Alibaba Qwen4-Max: sumber skor benchmark Terminal-Bench 4.0, ProgramBench, dan lainnya
- Tautan: mengacu pada saluran rilis resmi Qwen
- Keterangan: Data terkait dalam artikel ini semuanya dilaporkan sendiri oleh pihak resmi, bukan hasil reproduksi pihak ketiga
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Untuk informasi penawaran model dan panduan integrasi, Anda dapat mengunjungi pusat dokumentasi docs.apiyi.com


