
Catatan penulis: Sebagai sesama model unggulan kelas 2.4T, Qwen4-Max mencatat harga daftar turun 25%, batas output naik sekitar tiga kali lipat, dan token untuk tugas yang sama 20–30% lebih sedikit. Artikel ini membedah arsitektur, skor benchmark yang dilaporkan sendiri oleh pihak resmi, serta harga daftar kedua generasi, dan memberikan daftar periksa untuk migrasi dari qwen3.8-max.
Pada 2026-11-16, Alibaba merilis Qwen4-Max. Langsung saja ke kesimpulan: dibandingkan Qwen3.8-Max, generasi baru ini memangkas harga daftar input dan output masing-masing sebesar 25%, menaikkan output maksimum dari 128K menjadi 393K, sekitar tiga kali lipat, dan dalam evaluasi Work360 resmi penggunaan token untuk tugas yang sama 20–30% lebih sedikit. Bagi tim yang sudah menjalankan qwen3.8-max di produksi, peningkatan ini layak dievaluasi dengan saksama, tetapi tidak perlu membangun ulang dari nol.
Ini bukan artikel promosi yang menyatakan “generasi baru unggul mutlak”. Skor benchmark di bawah ini semuanya ditandai sebagai laporan sendiri pihak resmi, sedangkan peringkat pihak ketiga ditandai sebagai snapshot papan peringkat publik (2026-11-14). Dua angka yang mudah dibesar-besarkan, yaitu penurunan biaya per tugas sebesar 62% dan peringkat ke-6 Arena, akan dibahas secara terpisah.
Nilai utama: Setelah membaca, Anda dapat menilai tiga hal: berapa persen dari penghematan biaya yang benar-benar nyata, benchmark mana yang naik signifikan dan mana yang hampir tidak berubah, serta apa lagi yang perlu diubah saat migrasi selain mengganti ID model. Selain itu, jika Anda memanggil melalui APIYI apiyi.com, hingga 2026-11-16 11:00 platform belum menyediakan qwen4-max; untuk saat ini tetap gunakan qwen3.8-max, dan kami akan segera menghadirkan model ini.
Ringkasan Cepat Perbedaan Inti Qwen4-Max vs Qwen3.8-Max
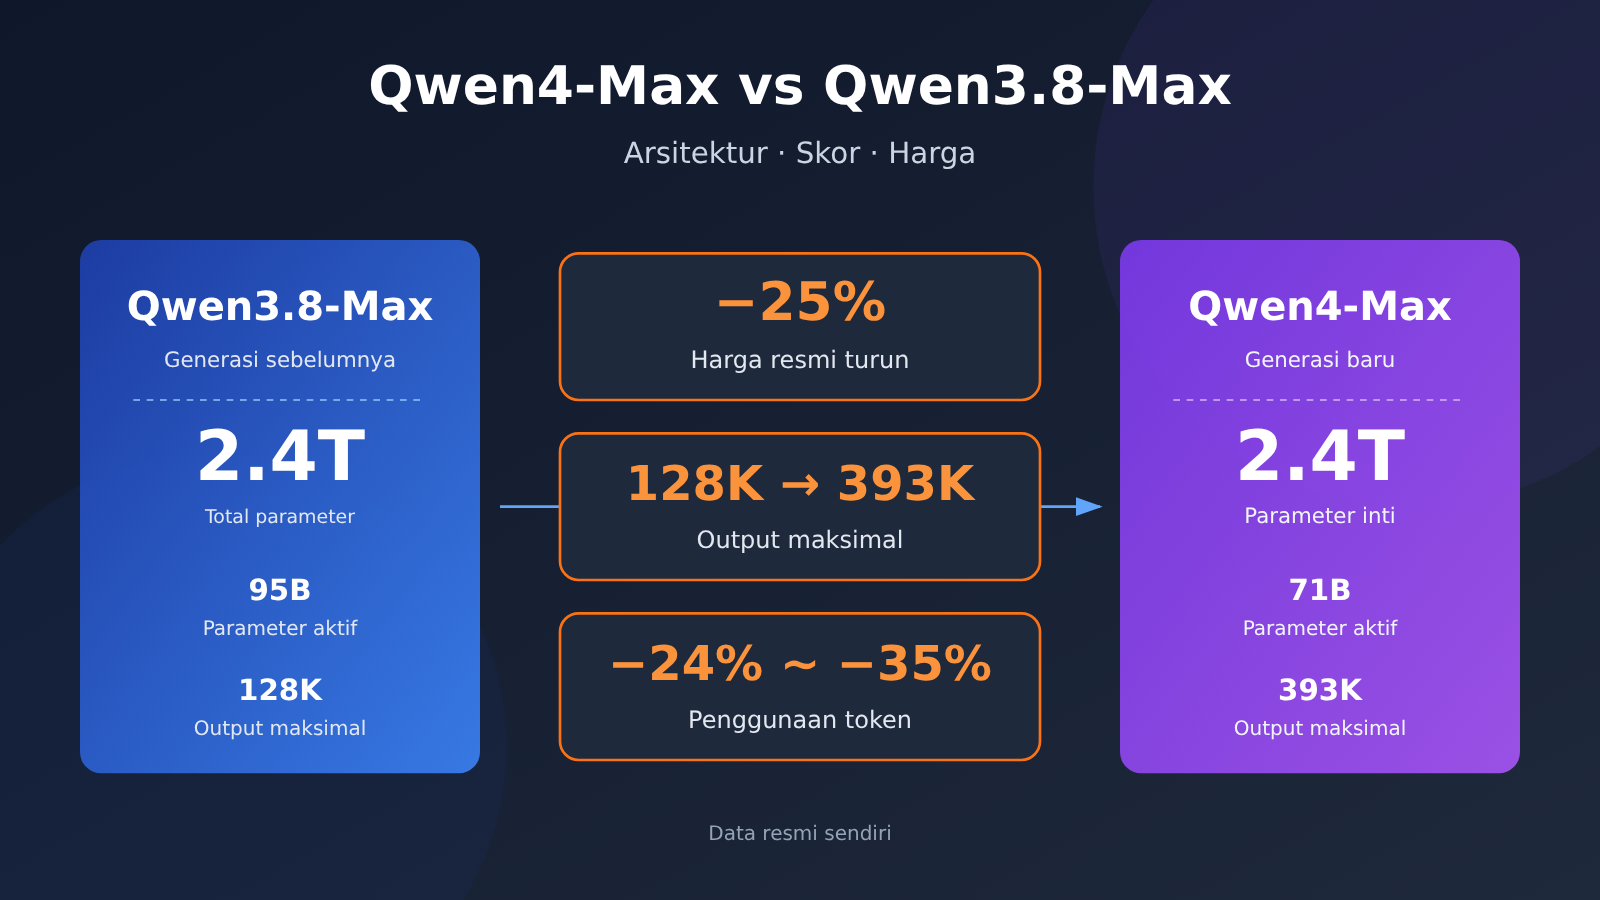
Total skala kedua generasi model berada di tingkat yang sama, tetapi Qwen4-Max melakukan penyesuaian pada parameter aktif, batas output, dan tingkat penalaran bawaan. Tabel berikut menyandingkan perbedaan di tingkat spesifikasi terlebih dahulu, sedangkan harga dibahas terpisah di bab biaya nanti.
| Dimensi Perbandingan | Qwen3.8-Max | Qwen4-Max | Perubahan |
|---|---|---|---|
| Skala parameter | 2.4T total parameter | 2.4T backbone + 328B N-gram Embedding | Backbone setara, ada tabel embedding baru |
| Aktivasi per inferensi | 95B | 71B | Berkurang sekitar 25% |
| Konteks | 1M | 1M (input maksimum 991K, mode berpikir 983K) | Batas input sedikit diperketat |
| Output maksimum | 128K | 393K | Sekitar 3 kali lipat |
| Rantai berpikir maksimum | Tidak dirinci resmi | 262K | Ada batas atas yang jelas (baru) |
| reasoning_effort bawaan | xhigh | high | Tingkat bawaan turun satu level |
| Kemampuan visual | Mendukung input gambar | Visual native | Visual menjadi kemampuan native |
| Bobot terbuka | Qwen3.8-2.4T-A95B | Tidak disebutkan dalam materi | — |
Dari tabel ini terlihat arah peningkatan kali ini: skala total tidak berubah, komputasi per inferensi lebih hemat, ruang output diperbesar. Parameter aktif turun dari 95B ke 71B, ini menjadi prasyarat dasar agar harga resmi bisa diturunkan; output maksimum yang dinaikkan ke 393K langsung mengubah kelayakan tugas seperti laporan panjang dan pembuatan blok kode besar.
Perlu diingat, reasoning_effort bawaan berubah dari xhigh menjadi high. Jika kode Anda tidak menetapkan parameter ini secara eksplisit, setelah mengganti ID model tingkat penalaran yang benar-benar dijalankan akan berubah. Hal ini akan ditekankan lagi dalam daftar migrasi.
Perubahan arsitektur Qwen4-Max: dampak tiga perubahan terhadap penggunaan
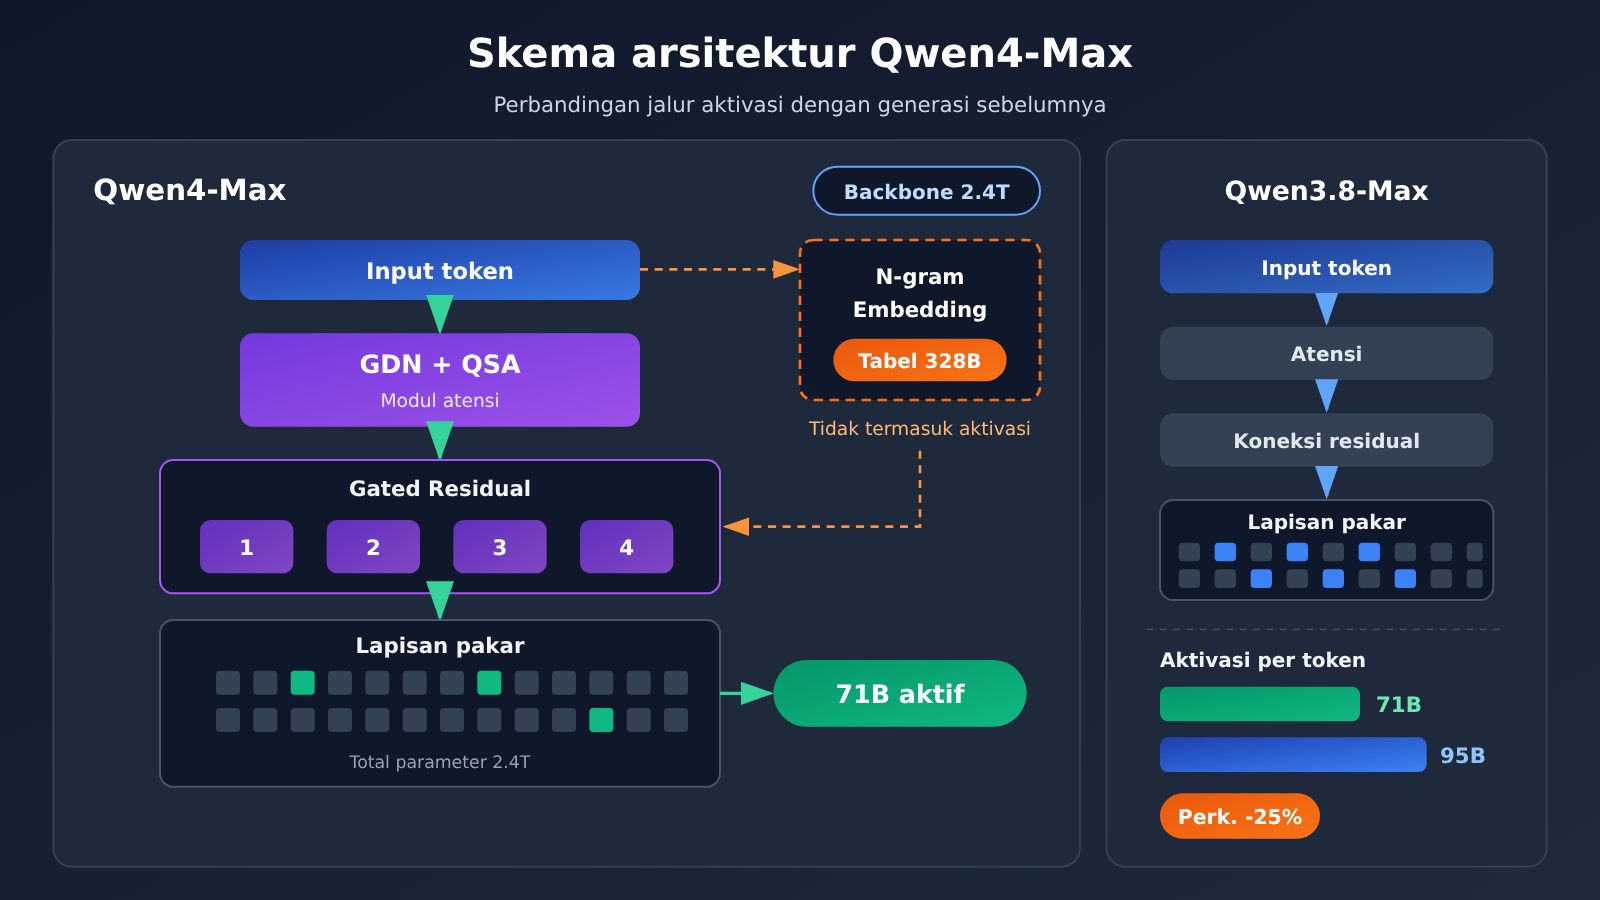
Blog resmi merangkum perubahan arsitektur Qwen4-Max menjadi tiga hal: GDN + QSA, Gated Residual empat cabang, dan N-gram Embedding. Bagi pengguna API, tidak perlu memahami detail implementasi lapis demi lapis, tetapi perlu tahu apa dampak masing-masing dari ketiga perubahan ini.
GDN + QSA: perubahan pada lapisan attention
Ini adalah penyesuaian pada struktur attention. Dokumentasi resmi memperkenalkannya bersama konteks 1M dan output maksimum 393K; pemahaman kami, ini terutama melayani efisiensi komputasi pada skenario sekuens panjang. Bagi pemanggil, hasil yang bisa langsung dirasakan adalah: dengan jendela konteks 1M yang sama, Qwen4-Max dapat menghasilkan output yang lebih panjang, sementara harga per unit justru lebih rendah.
Gated Residual empat cabang
Koneksi residual diperluas menjadi empat cabang dengan gating. Perubahan semacam ini biasanya memengaruhi stabilitas pelatihan dan aliran informasi antar kemampuan, yang akhirnya tercermin pada perilaku model. Dampak praktisnya, bahkan jika petunjuknya sama persis, gaya output dan panjang langkah penalaran Qwen4-Max bisa berbeda dari generasi sebelumnya, jadi petunjuk yang telah disetel khusus untuk Qwen3.8-Max perlu diuji regresi.
N-gram Embedding: parameter 328B tidak sama dengan beban komputasi
Penulisan parameter Qwen4-Max adalah “2.4T backbone / 71B aktivasi + 328B N-gram Embedding”. Menurut desain umum, embedding semacam ini termasuk parameter berbasis lookup table dan tidak dihitung dalam komputasi aktivasi backbone per token, jadi angka 328B tidak bisa langsung ditambahkan ke jumlah aktivasi untuk perbandingan. Yang benar-benar terkait biaya inferensi adalah 71B versus 95B, yaitu sekitar 25% lebih sedikit aktivasi setiap kali.
Pada tingkat pre-training, pihak resmi menyatakan Qwen4-Max-Base memiliki BPB (bit per byte, semakin rendah semakin baik) terendah di empat kategori evaluasi internal—pengetahuan, kode, tanya jawab, dan STEM—sekitar 5–13% lebih rendah daripada Qwen3.8-Max-Base. Ini adalah evaluasi internal resmi, tetapi setidaknya menunjukkan bahwa basis model itu sendiri telah meningkat; peningkatan skor benchmark berikutnya bukan hanya berasal dari post-training.
Perbandingan skor benchmark Qwen4-Max: mana yang naik banyak, mana yang hampir tidak bergerak
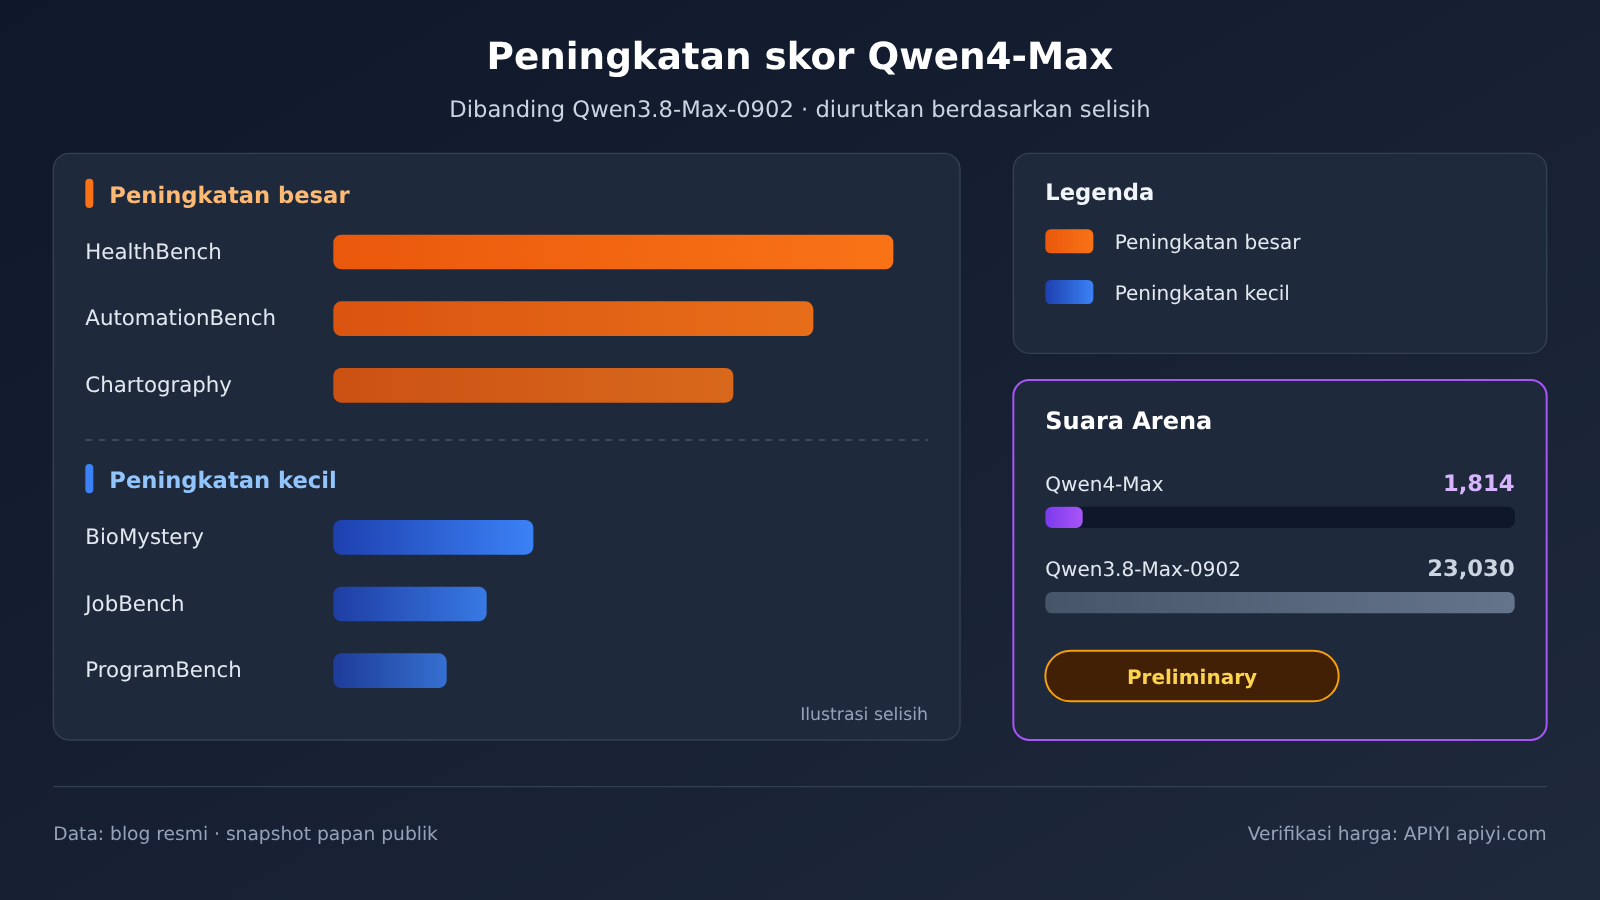
Semua data di bawah ini berasal dari satu tabel perbandingan yang sama dari Alibaba, bersifat laporan resmi sendiri, dengan objek pembanding Qwen3.8-Max-0902 (versi penyegaran September). Kami mengurutkannya berdasarkan besarnya peningkatan dari yang terbesar ke terkecil, agar Anda bisa langsung melihat di mana keuntungan upgrade terkonsentrasi.
| Benchmark (laporan resmi sendiri) | Qwen3.8-Max-0902 | Qwen4-Max | Selisih | Penilaian besaran peningkatan |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | Signifikan |
| CodeArena | 1676 | 1750 | +74 | Signifikan |
| HealthBench | 39.6 | 60.0 | +20.4 | Sangat signifikan |
| AutomationBench | 56.2 | 72.5 | +16.3 | Sangat signifikan |
| Chartography | 42.0 | 54.2 | +12.2 | Signifikan |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | Signifikan |
| APEX-Agents | 63.3 | 72.1 | +8.8 | Signifikan |
| HLE | 43.9 | 51.7 | +7.8 | Signifikan |
| DeepSWE | 69.3 | 75.7 | +6.4 | Sedang |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | Sedang |
| Video-Index | 63.2 | 68.1 | +4.9 | Sedang |
| ProgramBench | 28.0 | 31.5 | +3.5 | Kecil |
| JobBench | 65.3 | 68.5 | +3.2 | Kecil |
| BioMystery | 84.1 | 85.0 | +0.9 | Hampir tidak bergerak |
Peningkatan paling terkonsentrasi ada pada tugas sejenis agen dan pemanggilan alat: AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Jika bisnis Anda melibatkan pemanggilan alat multi-putaran, operasi terminal, atau alur otomatisasi, di sinilah keuntungan upgrade paling besar. HealthBench naik dari 39.6 ke 60.0, Chartography naik 12.2, menunjukkan bahwa tanya jawab medis dan pemahaman grafik juga menjadi fokus generasi ini.
Di sisi lain, BioMystery hanya naik 0.9, JobBench dan ProgramBench naik sedikit di atas 3 poin. Untuk beberapa jenis tugas ini, keuntungan marginal dari upgrade terbatas; jika skenario utama Anda kebetulan mirip dengan ini, skor benchmark saja tidak cukup untuk mendukung keputusan upgrade — Anda sebaiknya lebih melihat biaya. Work360 yang juga diberikan secara resmi adalah 52.69 berbanding 47.74, lebih tinggi 4.95, yang juga termasuk peningkatan sedang.
Dari sisi keamanan, laporan resmi menunjukkan tingkat kelulusan ganda di tingkat fungsi pada Last Secure Code Bench naik dari 22.0% ke 31.8%, dan keamanan simultan pada tiga granularitas naik dari 8% ke 14.7%. Nilai absolutnya masih belum tinggi, kode yang dihasilkan tetap perlu melalui tinjauan keamanan, tetapi peningkatan relatifnya jelas.
Papan Pihak Ketiga Arena: Peringkat Preliminary dengan 1.814 Suara
Skor CodeArena resmi 1750 juga terlihat di papan Code Arena WebDev pihak ketiga arena.ai. Berikut adalah snapshot papan publik, 2026-11-14:
- Qwen4-Max (xHigh): 1750 poin, peringkat ke-6, ditandai Preliminary, 1.814 suara, $4,18/tugas
- Qwen3.8-Max (0902): 1676 poin, peringkat ke-16, 23.030 suara, $1,91/tugas
- Qwen3.8-Max: 1670 poin, peringkat ke-18
Titik kedua yang mudah dibesar-besarkan di sini adalah: Qwen4-Max hanya memiliki 1.814 suara, sedangkan versi 0902 generasi sebelumnya memiliki 23.030 suara—selisih sekitar 12 kali. Penanda Preliminary berarti peringkatnya masih dalam proses konvergensi; peringkat ke-6 masih bisa berubah. Saat mengutipnya sekarang, sebaiknya tulis “peringkat sementara ke-6”.
Ada satu detail lain di snapshot yang perlu diperhatikan: Qwen4-Max berkompetisi di tingkat xHigh, dengan biaya per tugas $4,18—lebih tinggi daripada $1,91 untuk Qwen3.8-Max 0902. Ini tidak bertentangan dengan klaim resmi “biaya per tugas menurun”, karena tingkat pengujian dan jenis tugasnya berbeda. Namun, ini mengingatkan kita: pada tingkat penalaran tertinggi, Qwen4-Max belum tentu lebih hemat biaya.
Harga dan Biaya Qwen4-Max: Berapa Persen Penghematan yang Benar-Benar Nyata
Pada akhirnya, upgrade berarti mengganti model, dan sebelum memutuskan, kita harus membandingkan harga terlebih dahulu. Tabel di bawah ini mencantumkan harga resmi kedua generasi serta harga qwen3.8-max yang saat ini dijual di APIYI. Semua satuan adalah per 1M tokens, dengan tanggal pengambilan data 16 November 2026.
| Item penagihan (per 1M tokens) | Qwen3.8-Max Resmi (Wilayah Singapura) | Qwen4-Max Resmi | Qwen4-Max Resmi (RMB) | Harga APIYI qwen3.8-max Saat Ini |
|---|---|---|---|---|
| Input | $2 | $1,5 | ¥10 | $1,65 |
| Output | $6 | $4,5 | ¥30 | $4,95 |
| Baca cache | $0,25 | $0,075 | ¥0,5 | $0,20625 |
| Tulis cache (5 menit) | Tidak tercantum di blog resmi | $1,875 | ¥12,5 | Tidak dicantumkan terpisah di dokumentasi |
| Tulis cache (1 jam) | Tidak tercantum di blog resmi | $3 | ¥20 | Tidak dicantumkan terpisah di dokumentasi |
Input dan output masing-masing turun 25%, baca cache turun dari $0,25 menjadi $0,075 dengan penurunan sekitar 70%—ini merupakan item terbesar dalam penyesuaian harga kali ini. Di sisi lain, Qwen4-Max secara eksplisit mencantumkan dua tingkat harga tulis cache, yaitu 5 menit dan 1 jam. Aplikasi yang sering menggunakan ulang prefix panjang perlu memasukkan biaya tulis ini ke dalam anggaran.
Penghematan token: 20–30% terlihat dari Work360, 40–50% dari Terminal-Bench
Data resmi penghematan token terdiri dari dua kelompok angka. Pada Work360, tier Xhigh menghemat 24%, tier High menghemat 35%—dari sinilah angka “20–30%” berasal. Di Terminal-Bench 4.0 bahkan lebih ekstrem, masing-masing menghemat 48% dan 49%.
Penghematan pada tugas berbasis terminal jelas lebih besar, kemungkinan terkait dengan berkurangnya jumlah putaran tool pada tugas seperti ini. Saat menyusun anggaran, estimasi 20–30% untuk tugas kantor umum lebih aman; 40–50% hanya berlaku untuk skenario operasi terminal yang mirip Terminal-Bench.
11 poin yang membuat 62% dan 51% tidak cocok
Ini titik pertama yang mudah dibesar-besarkan. Data resmi menunjukkan biaya per tugas turun dari $4.43 ke $1.67, sekitar 62% dalam dolar; versi berbahasa Mandarin menulis ¥26.58 turun ke ¥11.16, sekitar 58%; kedua basis angka ini sendiri sudah tidak sama.
Dengan menghitung memakai data resmi mereka sendiri: token 35% lebih sedikit dan harga satuan turun 25%, mengalikan keduanya hanya menghasilkan penurunan biaya sekitar 51%, yaitu 0.65 × 0.75 ≈ 0.49. Sekitar 11 poin sisanya tidak dijelaskan secara resmi. Kami menduga ini mungkin berasal dari manfaat cache hit akibat penurunan besar harga baca cache (sekitar −70%), serta berkurangnya jumlah putaran pemanggilan tool, tetapi ini hanya dugaan, bukan penjelasan resmi.
Pendekatan yang lebih aman: anggap 51% sebagai batas atas referensi “pada rasio cache hit yang sama”; 62% hanya mungkin mendekati pada skenario dengan cache hit tinggi dan putaran tool yang banyak. Untuk bisnis Anda secara spesifik, dasar paling andal adalah menjalankan perbandingan biaya per tugas sekali menggunakan trafik nyata.
Harga Saat Ini dan Status Ketersediaan APIYI
APIYI saat ini menyediakan qwen3.8-max dengan harga input $1.65, output $4.95, dan pembacaan cache $0.20625. Menurut dokumentasi, harga ini 17.5% lebih rendah daripada $2 / $6 milik Alibaba Cloud. Ada juga qwen3.8-max-0902 dengan harga yang sama, sedangkan versi bobot terbuka qwen3.8-2.4t-a95b dibanderol $1.72 / $5.16 / $0.215.
Saat peninjauan ulang pada 2026-11-16 pukul 11.00, qwen4-max belum muncul di dokumentasi model maupun daftar harga APIYI (total 284 model), jadi belum tersedia. Kami akan segera mencantumkan model ini; nama model dan harga mengikuti daftar model platform APIYI di apiyi.com. Sejujurnya, harga satuan resmi Qwen4-Max sudah lebih rendah daripada harga platform qwen3.8-max saat ini, jadi setelah tersedia, ada baiknya kita memeriksa ulang perhitungannya.
Bermigrasi dari Qwen3.8-Max ke Qwen4-Max: daftar periksa
Banyak orang mengira upgrade hanya soal mengganti satu ID model, padahal parameter default, batas jendela konteks, dan penagihan cache semuanya ikut berubah. Daftar periksa berikut disusun berdasarkan prioritas “kalau tidak diubah, bisa bermasalah”.
| Item pemeriksaan | Kondisi Qwen3.8-Max saat ini | Setelah migrasi ke Qwen4-Max | Tindakan yang disarankan |
|---|---|---|---|
| ID model | qwen3.8-max / qwen3.8-max-0902 |
Mengacu pada daftar model di platform | Tunggu tersedia di platform, lalu beralih; mulai dengan canary |
| Nilai default reasoning_effort | xhigh | high | Tulis levelnya secara eksplisit agar perilaku tidak berubah diam-diam |
| Batas atas max_tokens | 128K | 393K | Periksa pemotongan di hilir, penyimpanan, dan pengaturan timeout |
| Input maksimum | 1M | 991K (mode berpikir 983K) | Input super panjang yang mendekati 1M perlu dipangkas |
| Penagihan cache | Baca cache $0.25 | Baca cache $0.075, plus harga tulis 5 menit / 1 jam | Evaluasi ulang strategi prefiks cache dan TTL |
| Input visual | Input gambar | Visual native | Uji regresi ulang untuk kasus penggunaan terkait gambar |
| Petunjuk dan format output | Sudah dioptimalkan untuk generasi sebelumnya | Arsitektur berubah, perilaku bisa berbeda | Lakukan regresi dengan set evaluasi tetap |
| Pemantauan biaya | Dihitung per token | Token dan harga satuan sama-sama turun | Beralih memantau biaya per tugas, bukan harga satuan |
Yang paling mudah terlewat dalam daftar ini adalah reasoning_effort. Qwen3.8-Max default-nya xhigh, sedangkan Qwen4-Max default-nya high. Kalau di kode tidak diatur secara eksplisit, setelah beralih bisa jadi lebih hemat token, tapi bisa juga hasilnya kurang memuaskan pada tugas penalaran kompleks. Data penghematan token resmi mencakup dua level sekaligus, Xhigh dan High, jadi sebaiknya Anda juga menguji kedua level itu sebelum memutuskan mana yang dipakai di produksi.
Kedua, panjang output. Batas 393K berarti satu respons bisa jauh lebih panjang daripada sebelumnya. Kalau sistem log, kolom database, atau timeout gateway dirancang untuk output 128K, semuanya perlu dilonggarkan lebih dulu. Input maksimum menyempit dari 1M ke 991K (983K untuk mode berpikir). Bisnis yang biasanya tidak sampai mentok tidak terlalu terpengaruh, tapi skenario yang menjejalkan dokumen hingga mendekati batas akan langsung error.
Pendekatan saat ini untuk memanggil lewat APIYI
Jika sekarang Anda mengakses lewat APIYI, dengan base_url https://api.apiyi.com/v1 dan protokol yang kompatibel dengan OpenAI, cukup isi kolom model dengan qwen3.8-max untuk tetap berjalan di produksi. Kalau perlu mengunci perilaku versi rilis September, bisa ganti ke qwen3.8-max-0902, harganya sama.
Setelah qwen4-max tersedia di platform, karena protokolnya tidak berubah, migrasi di level kode hanya perlu mengganti kolom model, lalu melengkapi reasoning_effort dan max_tokens sesuai daftar di atas. Sebaiknya alihkan 5%–10% trafik lebih dulu sebagai canary, bandingkan biaya per tugas dan metrik bisnis, baru kemudian ganti sepenuhnya.
🚀 Saran migrasi: Proyek yang saat ini berjalan lewat APIYI apiyi.com sebaiknya tetap memakai
qwen3.8-max, sambil menyiapkan set evaluasi dan sakelar canary; ganti ID setelahqwen4-maxtersedia. Dengan begitu, tidak akan ada kekosongan layanan gara-gara “menunggu model baru”.
Rekomendasi Skenario untuk Qwen4-Max dan Qwen3.8-Max
Skenario yang Memprioritaskan Evaluasi Upgrade ke Qwen4-Max
- Pemanggilan tool multi-putaran dan otomasi: AutomationBench, Terminal-Bench, dan APEX-Agents semuanya menunjukkan peningkatan signifikan; penghematan token juga paling besar pada tugas bertipe terminal.
- Tugas output sangat panjang: Perlu menghasilkan laporan, kode, atau dokumen lebih dari 128K dalam sekali jalan; hanya 393K milik Qwen4-Max yang dapat memenuhi.
- Tanya jawab medis dan pemahaman grafik: HealthBench +20.4, Chartography +12.2, merupakan area dengan peningkatan paling signifikan di generasi ini.
- Ada persyaratan keamanan kode: Tingkat lolos ganda keamanan naik dari 22.0% menjadi 31.8%, tetapi tetap perlu disertai proses tinjauan.
- Aplikasi dengan tingkat penggunaan ulang cache tinggi: Harga baca cache turun sekitar 70%; skenario dengan petunjuk sistem panjang dan prefiks basis pengetahuan tetap paling diuntungkan.
Skenario untuk Tetap Menggunakan Qwen3.8-Max
- Lini produksi sudah stabil, petunjuk telah dioptimalkan secara mendalam: Qwen3.8-Max tetap menjadi model produksi yang andal; tidak perlu upgrade hanya demi upgrade.
- Tugas utama serupa dengan BioMystery dan JobBench: Peningkatan di area ini terbatas; biaya migrasi bisa lebih tinggi daripada manfaatnya.
- Butuh bobot terbuka untuk deploy mandiri: Qwen3.8-2.4T-A95B memiliki bobot terbuka; materi tidak menyebutkan versi bobot terbuka untuk Qwen4-Max.
- Memanggil lewat APIYI dan perlu langsung tersedia: Selama
qwen4-maxbelum tersedia,qwen3.8-maxadalah pilihan yang siap pakai.
| Situasi Anda | Saran |
|---|---|
| Terutama agen dan pemanggilan tool, fokus pada pengurangan biaya | Prioritaskan evaluasi Qwen4-Max, uji biaya aktual pada tingkat High |
| Butuh satu kali output lebih dari 128K | Hanya Qwen4-Max yang bisa |
| Lini produksi stabil, terutama untuk tanya jawab umum | Tetap pakai Qwen3.8-Max, lakukan evaluasi regresi saat waktu luang |
| Butuh bobot terbuka untuk deploy mandiri | Lanjutkan dengan Qwen3.8-2.4T-A95B |
| Saat ini mengakses lewat APIYI | Lanjutkan dengan qwen3.8-max, lakukan peralihan canary setelah tersedia |
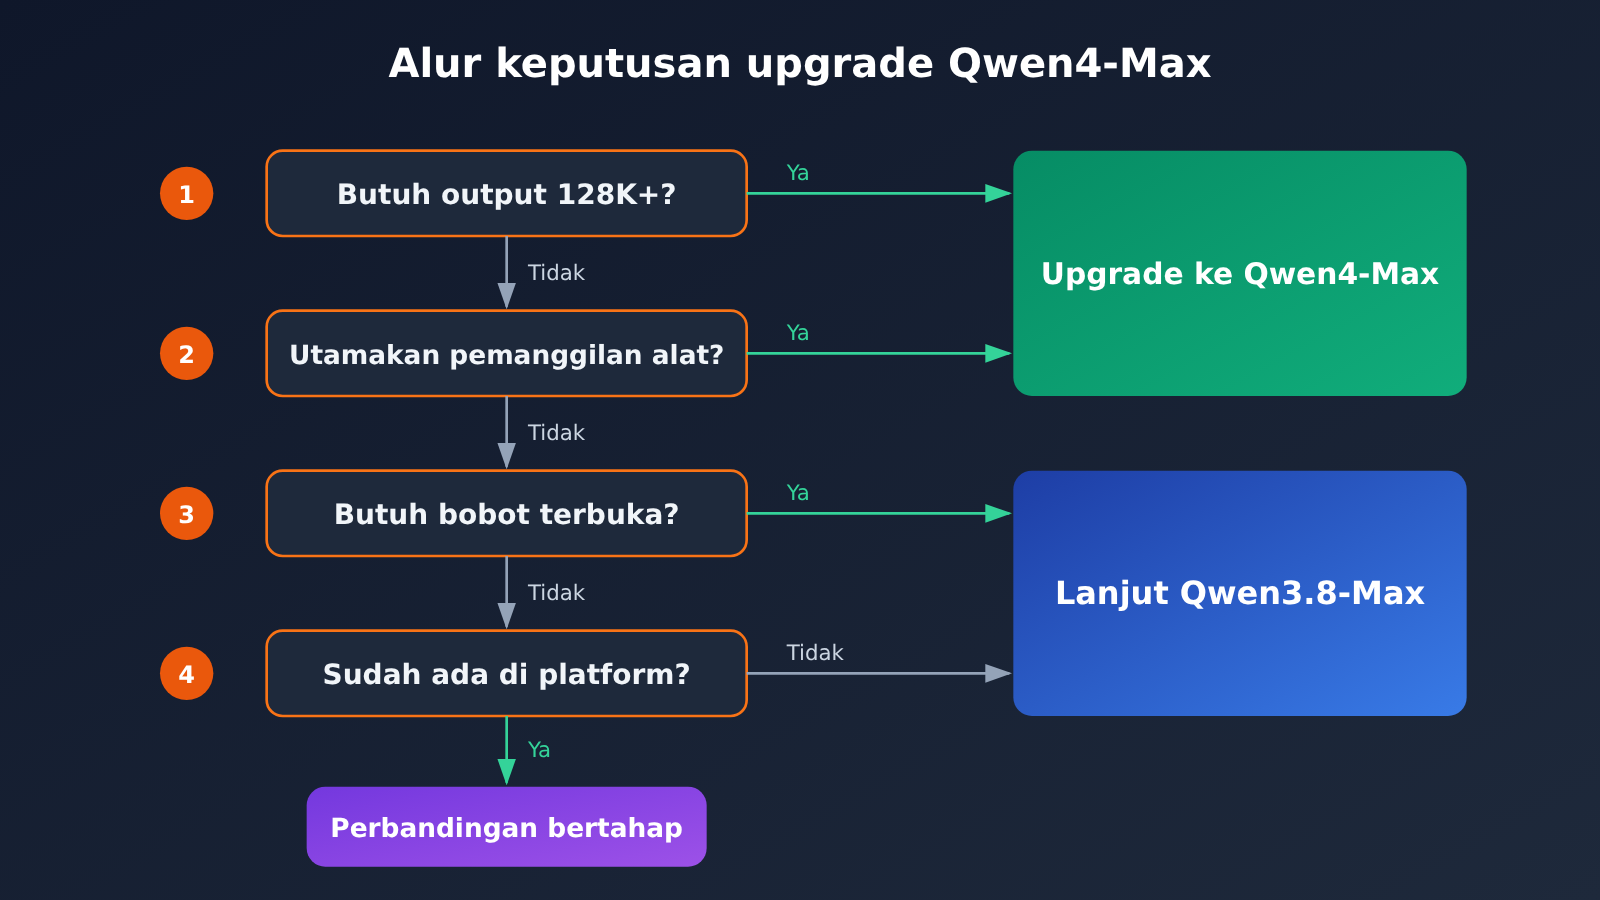
Rekomendasi Keputusan: Qwen4-Max vs Qwen3.8-Max
Jika hanya melihat satu kalimat: bisnis yang menggunakan agen, output panjang, dan intensif cache layak untuk upgrade; bisnis umum yang sudah stabil bisa menunggu. Dari tiga manfaat upgrade, penurunan harga satuan sebesar 25% sudah pasti, penghematan token sebesar dua sampai tiga puluh persen adalah data resmi pada evaluasi tertentu, sedangkan penurunan 62% per tugas baru bisa mendekati angka itu jika kondisi cache dan jumlah putaran tool Anda sendiri mendukung.
💡 Saran pemilihan: Sebelum memutuskan, sebaiknya jalankan satu set pengujian dengan tugas nyata Anda masing-masing, lalu bandingkan biaya per tugas dan kualitas hasil, bukan hanya melihat tabel skor. Melalui APIYI apiyi.com Anda bisa memakai kunci API yang sama untuk menjalankan baseline
qwen3.8-maxlebih dulu; setelahqwen4-maxtersedia, bandingkan langsung dalam kode yang sama.
Pertanyaan Umum (FAQ)
Q1: Apa hubungan antara Qwen4-Max dan Qwen3.8-Max?
Keduanya adalah model unggulan kelas 2.4T dari Tongyi Qianwen. Qwen3.8-Max dirilis pada 2026-08-03, dan 0902 adalah versi pembaruan September; Qwen4-Max dirilis pada 2026-11-16 dengan arsitektur baru, parameter aktif per inferensi turun dari 95B menjadi 71B, batas output dinaikkan menjadi 393K, dan harga resmi diturunkan 25%.
Q2: Jika token dihemat dua sampai tiga puluh persen, apakah tagihan juga turun dua sampai tiga puluh persen?
Tidak hanya itu, dan juga belum tentu. Harga satuan sendiri turun 25%, lalu ditambah pengurangan token, secara teori biaya untuk tugas yang sama bisa turun sekitar 51%. Namun data penghematan token berasal dari evaluasi resmi Work360; berapa besar penghematan di bisnis Anda perlu diukur langsung. Jika menggunakan level xhigh, sebagaimana ditunjukkan snapshot Arena, biaya per tugas justru bisa lebih tinggi.
Q3: Qwen4-Max berada di peringkat ke-6 Arena, apakah peringkat ini reliabel?
Ini baru bisa dianggap hasil awal. Dalam snapshot papan peringkat publik (2026-11-14), Qwen4-Max hanya memiliki 1,814 suara dan ditandai Preliminary, sedangkan generasi sebelumnya 0902 memiliki 23,030 suara, selisih sekitar 12 kali. Skor 1750 sesuai dengan klaim resmi, tetapi peringkat masih bisa berubah setelah suara terkumpul.
Q4: Apakah sekarang qwen4-max bisa dipanggil melalui APIYI?
Per 2026-11-16 11:00 belum bisa; `qwen4-max` belum tersedia, dan kami akan menyediakannya secepat mungkin. Saat ini yang tersedia adalah `qwen3.8-max`, `qwen3.8-max-0902`, dan versi bobot terbuka `qwen3.8-2.4t-a95b`. Model serta harga terbaru mengikuti daftar model platform APIYI apiyi.com; pengguna baru bisa memakai kuota uji gratis untuk menjalankan baseline terlebih dahulu.
Q5: Apakah saat migrasi cukup hanya mengubah ID model?
Tidak cukup. Setidaknya Anda juga perlu mengatur reasoning_effort secara eksplisit (nilai default berubah dari xhigh menjadi high), melonggarkan max_tokens dan batas penyimpanan downstream sesuai kebutuhan, memeriksa input sangat panjang yang mendekati 1M, dan mengevaluasi ulang biaya penulisan cache. Dari sisi protokol, jika memakai antarmuka kompatibel OpenAI `https://api.apiyi.com/v1`, kode hanya perlu mengubah field model.
Q6: Apakah Qwen3.8-Max masih layak terus digunakan?
Masih layak. Model ini tetap merupakan flagship kelas 2.4T dengan konteks 1M, output 128K, serta mode berpikir dan non-berpikir yang lengkap, plus versi bobot terbuka. Peningkatan Qwen4-Max pada benchmark seperti BioMystery dan JobBench sangat kecil; untuk bisnis seperti ini, Qwen3.8-Max yang sudah stabil sepenuhnya bisa terus menangani trafik produksi.
Qwen4-Max vs Qwen3.8-Max: Poin-Poin Utama
- Skala setara, aktivasi lebih sedikit: Tulang punggung 2.4T tidak berubah, setiap aktivasi turun dari 95B ke 71B, sekitar 25% lebih sedikit.
- Harga satuan turun 25%: Input $2→$1.5, output $6→$4.5, pembacaan cache turun sekitar 70%, ditambah biaya penulisan cache yang baru.
- Output kira-kira tiga kali lipat: Output maksimum 128K→393K, input maksimum diperketat menjadi 991K.
- Kenaikan terkonsentrasi pada agen: AutomationBench, Terminal-Bench, HealthBench meningkat jelas, BioMystery hampir tidak berubah.
- Dua hal jangan dilebih-lebihkan: Penurunan biaya 62% hanya bisa menjelaskan sekitar 51%, peringkat ke-6 Arena hanya 1,814 suara dan bersifat Preliminary.
- Migrasi bukan sekadar ganti ID: Perhatikan nilai default
reasoning_effort, batas atasmax_tokens, dan strategi cache. - Status APIYI:
qwen4-maxbelum tersedia untuk sementara, terus gunakanqwen3.8-max, setelah tersedia lakukan peralihan bertahap.
Ringkasan
Kesimpulan inti Qwen4-Max dibandingkan Qwen3.8-Max:
- Biaya: Penurunan harga satuan 25% adalah keuntungan pasti; penghematan token sebesar dua hingga tiga puluh persen harus diverifikasi dengan pengukuran bisnis Anda sendiri; penurunan 62% memiliki sekitar 11 poin yang sumbernya belum jelas.
- Kemampuan: Peningkatan jelas pada agen, pemanggilan tool, arah medis dan grafik; sebagian benchmark hampir setara; semua skor merupakan laporan sendiri dari pihak resmi.
- Migrasi: Protokol tidak berubah, tetapi tingkat penalaran default, batas output, dan penagihan cache semuanya berubah, sehingga perlu diperiksa satu per satu sesuai daftar.
Qwen3.8-Max tetap menjadi model produksi yang andal; peningkatan versi seharusnya menjadi keputusan peralihan bertahap yang didukung data, bukan peralihan penuh begitu melihat versi baru. Disarankan untuk terlebih dahulu membangun baseline biaya dan kualitas dengan qwen3.8-max melalui APIYI apiyi.com, lalu setelah qwen4-max tersedia, bandingkan langsung di bawah antarmuka yang sama.
📚 Referensi
- Blog resmi Qwen3.8: Catatan rilis Qwen3.8-Max, berisi parameter, konteks, dan harga resmi
- Tautan:
qwen.ai/blog?id=qwen3.8 -
Keterangan: sumber spesifikasi generasi sebelumnya dan harga wilayah Singapura
-
Hugging Face – Qwen3.8-2.4T-A95B: Versi bobot terbuka Qwen3.8
- Tautan:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Keterangan: kartu model dan unduhan bobot saat perlu deployment mandiri
-
Blog resmi Qwen: Posting rilis Qwen4-Max serta perbandingan skor benchmark dalam gambar yang sama
- Tautan:
qwen.ai/blog -
Keterangan: sumber perubahan arsitektur, skor benchmark yang dilaporkan resmi, serta data token dan biaya per tugas
-
arena.ai Code Arena WebDev: Papan peringkat adu model pihak ketiga
- Tautan:
arena.ai - Keterangan: Artikel ini mengutip snapshot 2026-11-14; peringkat dapat berubah seiring jumlah suara
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Model dan harga dapat dicek di pusat dokumentasi docs.apiyi.com


