
Catatan penulis: Artikel ini membandingkan skor benchmark, spesifikasi jendela konteks, serta harga input dan output Qwen4-Max dan GPT-6 Astra, lalu menjelaskan sisi mana yang lebih hemat berdasarkan jenis tugas.
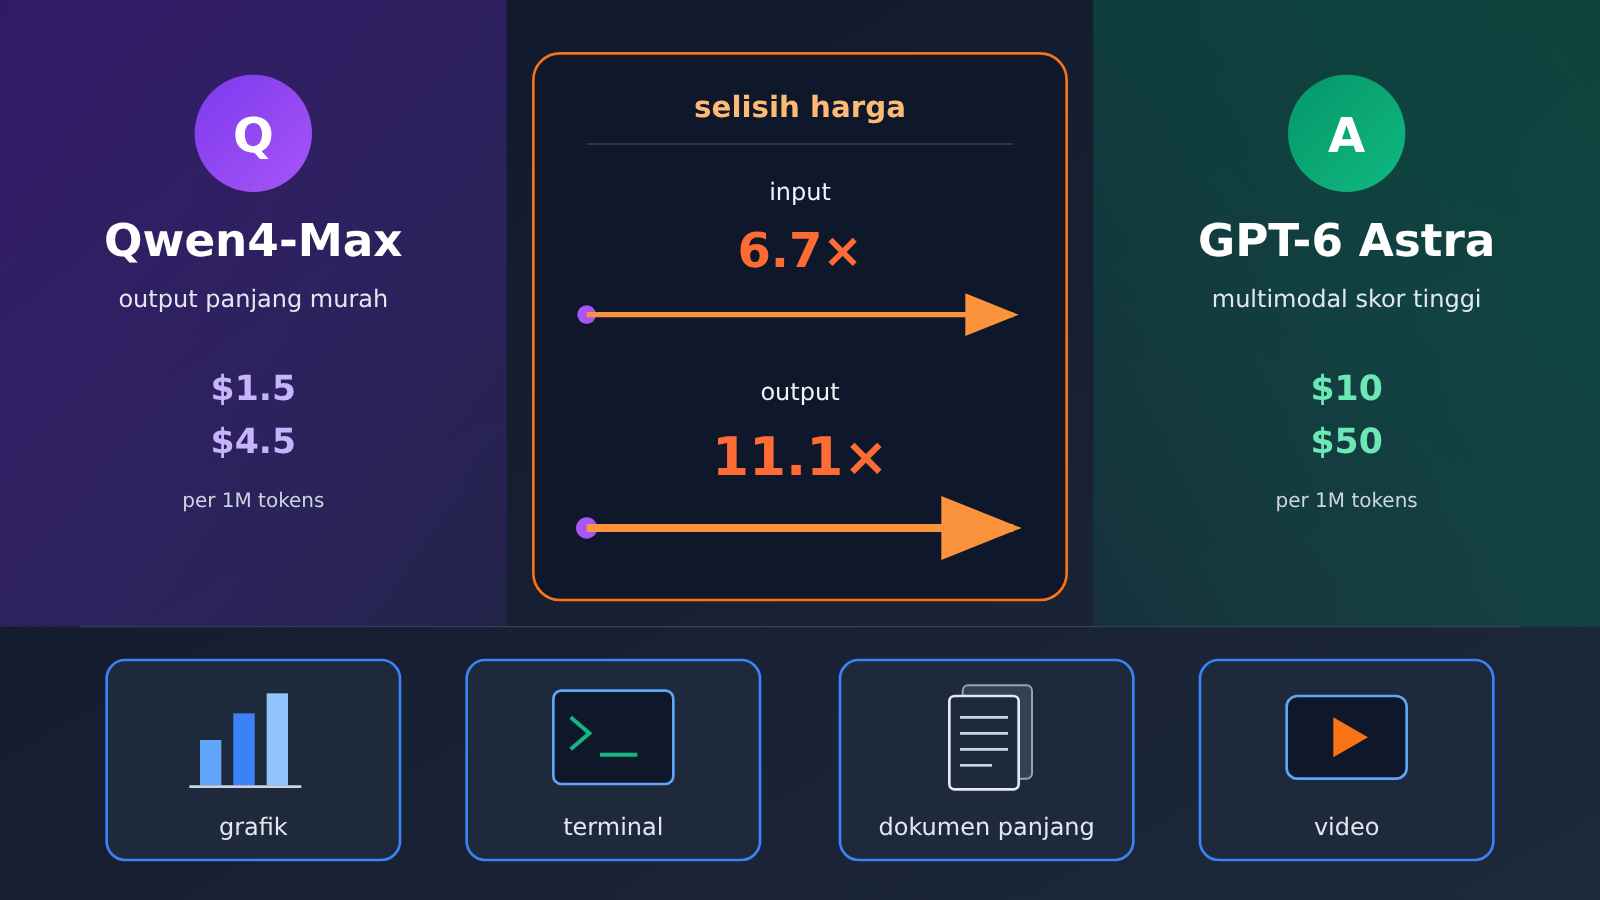
Kesimpulan di awal: Harga input GPT-6 Astra sekitar 6.7 kali harga Qwen4-Max, sedangkan harga output sekitar 11.1 kali. Premi harga ini menukar sesuatu yang sangat konkret, terutama skor lebih tinggi pada tiga jenis tugas: pemahaman grafik, operasi terminal dan repositori kode, serta pemahaman video. Pada Agent perkantoran dan sebagian evaluasi profesional, Qwen4-Max justru unggul.
Ini bukan artikel tentang “siapa yang menang telak atas siapa”. Kedua model punya keunggulan yang jelas, sekaligus kelemahan yang jelas. Artikel ini hanya membandingkan kedua model ini, dengan empat sumber fakta: perbandingan gambar yang sama yang dilaporkan sendiri oleh Qwen, teks asli dokumentasi OpenAI, snapshot papan peringkat publik arena (2026-11-14), serta daftar harga platform APIYI.
Nilai inti: Setelah membaca artikel ini, Anda akan mendapatkan tabel pemilihan model berdasarkan tugas dan anggaran, tahu ke mana uang ekstra yang dibayarkan untuk Astra pergi, dan juga tahu bagaimana aturan kenaikan harga seluruh pesanan dihitung ketika input Astra melebihi 272K.
Perbedaan Inti Qwen4-Max vs GPT-6 Astra
Mari kita mulai dengan menempatkan spesifikasi dan harga dalam satu tabel. Data spesifikasi dan harga masing-masing berasal dari daftar harga QwenCloud dan dokumen asli OpenAI, dengan tanggal pengambilan data 2026-11-16, dan satuan harga semuanya per 1 juta token.
| Dimensi Perbandingan | Qwen4-Max | GPT-6 Astra | Unggul di |
|---|---|---|---|
| Arsitektur / Posisi | Backbone 2.4T / aktivasi 71B + Embedding N-gram 328B, visi native | Model general-purpose terkuat OpenAI saat ini | Masing-masing punya posisi |
| Jendela konteks | 1M | 1.050.000 | Relatif setara |
| Input maksimum | 991K (mode berpikir 983K) | 922K | Qwen4-Max |
| Output maksimum | 393K (rantai pemikiran maksimum 262K) | 128K | Qwen4-Max |
| Tingkat penalaran | Mode berpikir | reasoning.effort: low / medium / high / xhigh / max |
Astra lebih terperinci |
| Harga input | $1,5 | $10 (jadi 2 kali lipat jika input melebihi 272K) | Qwen4-Max |
| Harga output | $4,5 | $50 (jadi 1,5 kali lipat jika input melebihi 272K) | Qwen4-Max |
| Batas pengetahuan | Tidak dicantumkan dalam referensi | 2026-04-30 | — |
Perbedaan jendela konteks antara Qwen4-Max dan GPT-6 Astra
Jendela konteks nominal keduanya berada di kisaran 1M, perbedaannya terletak pada pembagian input dan output. Qwen4-Max mampu menghasilkan hingga 393K token dalam sekali jalan, batas atas ini sangat berguna untuk pembuatan laporan panjang, penulisan ulang kode dalam jumlah besar, dan ekstraksi terstruktur secara batch. Batas output Astra adalah 128K, cukup untuk tugas sehari-hari, tetapi untuk generasi yang sangat panjang perlu dilakukan pemecahan.
Untuk item input maksimum, Qwen4-Max dengan 991K juga sedikit lebih banyak dibandingkan Astra dengan 922K. Dalam pemilihan aktual, yang lebih perlu diperhatikan adalah ambang batas penagihan Astra: begitu input melebihi 272K, harga satuan untuk seluruh transaksi akan naik. Bagian biaya di bawah ini akan menghitung masalah ini secara terpisah.
Membandingkan Skor Qwen4-Max dan GPT-6 Astra per Item
Skor berikut semuanya adalah perbandingan dalam grafik yang sama yang dilaporkan sendiri oleh pihak resmi Qwen. Perbandingan semacam ini diterbitkan oleh salah satu pihak, jadi saat membacanya perlu menyisakan ruang. Namun, beberapa keunggulan jelas Astra dalam tabel juga dicantumkan sendiri oleh pihak resmi Qwen, sehingga kredibilitasnya relatif lebih tinggi.
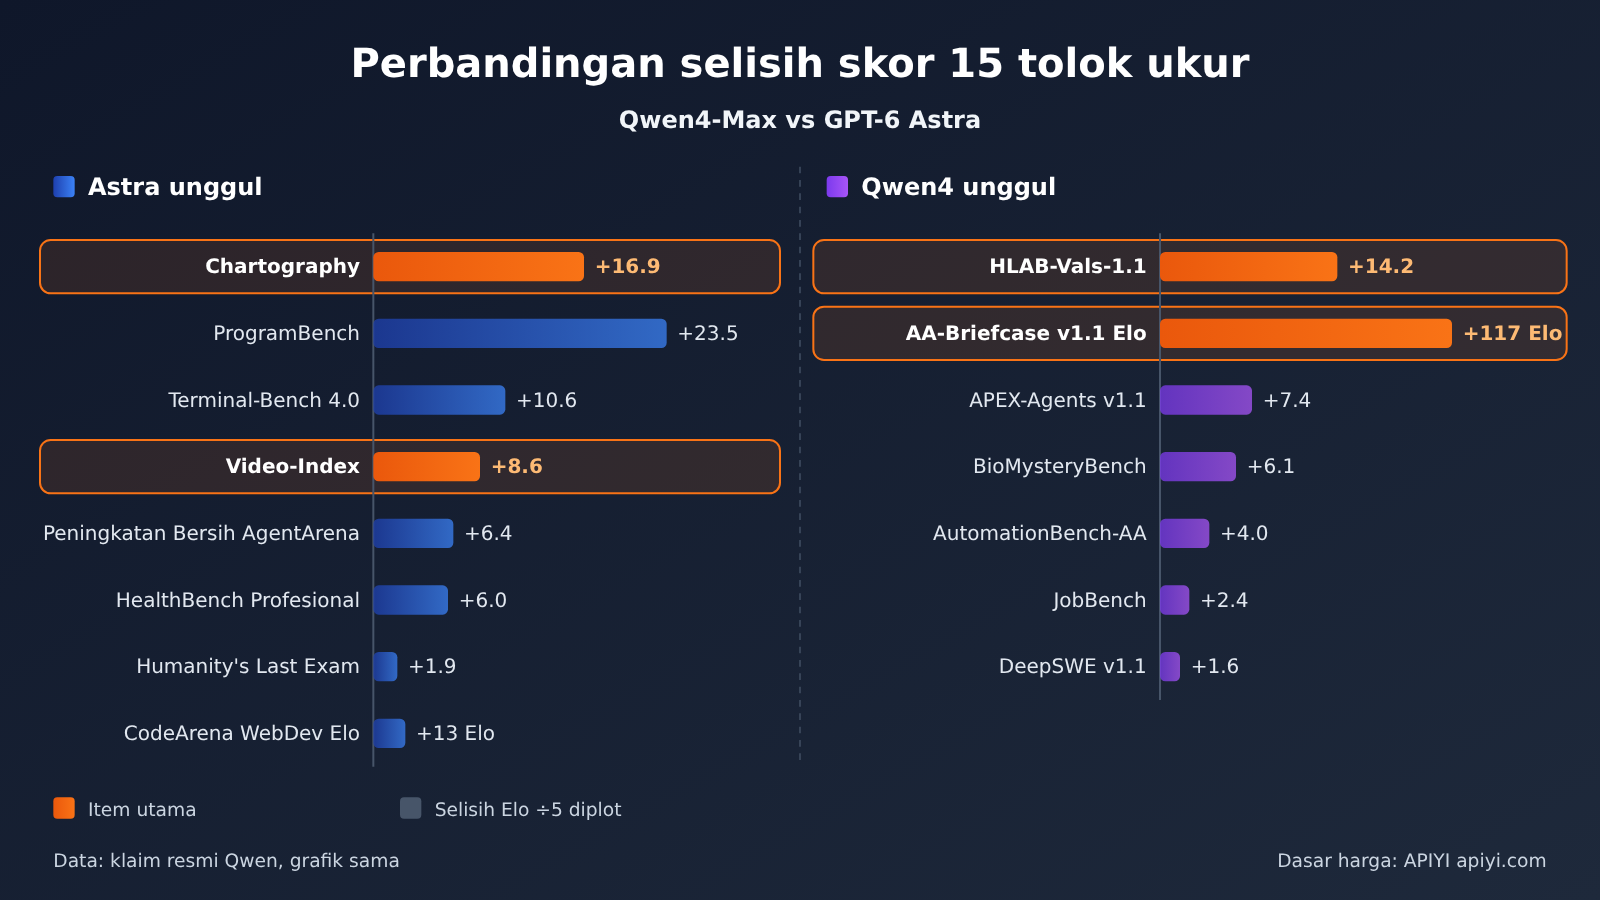
| Benchmark | Qwen4-Max | GPT-6 Astra | Selisih | Pihak Unggul |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
Keunggulan Sesungguhnya GPT-6 Astra: Grafik, Terminal, Video
Kesenjangan pemahaman grafik paling besar. Di Chartography, Astra mencetak 71,1 sementara Qwen4-Max 54,2, selisih 16,9 poin. Jika bisnis Anda perlu membaca grafik laporan keuangan, tangkapan layar dasbor pemantauan, atau grafik ilmiah, kesenjangan ini akan langsung terlihat pada akurasi ekstraksi, dan sangat sulit ditutup hanya dengan mengandalkan petunjuk.
Terminal dan repositori kode adalah area kedua. Terminal-Bench 4.0 selisih 10,6 poin, sedangkan ProgramBench selisih 23,5 poin. Kedua pengujian ini mengukur kemampuan eksekusi perintah bertahap dan pembangunan program lengkap, yang justru menjadi bagian paling krusial bagi Agent pengkodean. Di DeepSWE, Qwen4-Max unggul tipis 1,6 poin, menunjukkan kemampuannya memperbaiki satu issue tidak lemah. Namun begitu tugas berubah menjadi “menyiapkan proyek lewat rantai panjang di terminal”, Astra lebih stabil.
Pemahaman video tidak boleh dilewatkan. Di Video-Index, Astra 76,7 versus 68,1, unggul 8,6 poin. Meskipun Qwen4-Max mendukung visi secara native, ia masih tertinggal cukup jauh dalam pemahaman video. Tim yang perlu melakukan moderasi konten video, pengambilan klip, atau ringkasan video pembelajaran sebaiknya menempatkan aspek ini di depan daftar pilihan.
Keunggulan Sesungguhnya Qwen4-Max: Agent Perkantoran dan Evaluasi Profesional
HLAB-Vals-1.1 adalah salah satu aspek yang paling jelas menunjukkan keunggulan Qwen4-Max, 21,3 versus 7,1, selisih skor absolut 14,2, secara proporsional hampir 3 kali lipat. AA-Briefcase v1.1 Elo unggul 117 poin (1686 versus 1569). Evaluasi semacam ini cenderung berfokus pada dokumen bisnis dan tugas Agent terkait alur kerja kantor, dan dalam sistem Elo, selisih 117 poin tergolong sangat jelas.
APEX-Agents (+7,4), AutomationBench-AA (+4,0), dan JobBench (+2,4) juga menunjukkan Qwen4-Max unggul. Melihat semua ini secara bersamaan, kesimpulannya: dalam skenario otomatisasi alur kerja dan Agent perkantoran, Qwen4-Max bukan hanya lebih murah, tetapi skornya juga lebih tinggi.
Snapshot Peringkat Publik Code Arena (2026-11-14)
Peringkat pihak ketiga dapat dijadikan referensi silang. Snapshot peringkat publik arena.ai Code Arena WebDev menunjukkan bahwa GPT-6 Astra (Max) berada di peringkat ke-5 dengan 1763 poin, 8.685 suara, dan biaya per tugas $9.43. Qwen4-Max (xHigh) berada di peringkat ke-6 dengan 1750 poin, ditandai Preliminary, 1.814 suara, dan biaya per tugas $4.18.
Selisih 13 poin Elo dalam skenario WebDev masih termasuk level yang sama, tetapi biaya per tugasnya berbeda lebih dari dua kali lipat. Perlu dicatat bahwa jumlah suara Qwen4-Max masih sedikit, sehingga peringkatnya dapat terus berubah dan cocok untuk diamati secara berkelanjutan.
Perbandingan Harga Input dan Output Qwen4-Max vs GPT-6 Astra
Tabel harga dibagi menjadi dua bagian: harga resmi dan harga terkini di APIYI. Harga resmi diambil dari dokumentasi QwenCloud dan teks asli dokumen OpenAI, tanggal pengambilan data 2026-11-16, dalam satuan per 1M token.
| Item penagihan | Qwen4-Max (QwenCloud) | GPT-6 Astra (dokumen resmi OpenAI) | Rasio |
|---|---|---|---|
| Input | $1.5 | $10 | 6.7× |
| Output | $4.5 | $50 | 11.1× |
| Baca cache | $0.075 | $1 | 13.3× |
| Tulis cache | 5 menit $1.875 / 1 jam $3 | $12.5 | 4.2–6.7× |
| Input di atas 272K | Materi referensi tidak mencantumkan tingkatan | Input dan cache seluruh permintaan ×2, output ×1.5 | — |
Jebakan penagihan berganda GPT-6 Astra saat input melebihi 272K
Aturan dalam dokumen OpenAI adalah: ketika input satu permintaan melebihi 272K, input dan cache seluruh permintaan ditagih 2 kali, sedangkan output 1.5 kali. Yang naik harganya bukan hanya bagian yang melewati 272K — seluruh permintaan dihitung dengan harga tinggi. Banyak tim yang memperkirakan biaya RAG dokumen panjang atau konteks penuh seluruh repositori kode sering kali melewatkan poin ini.
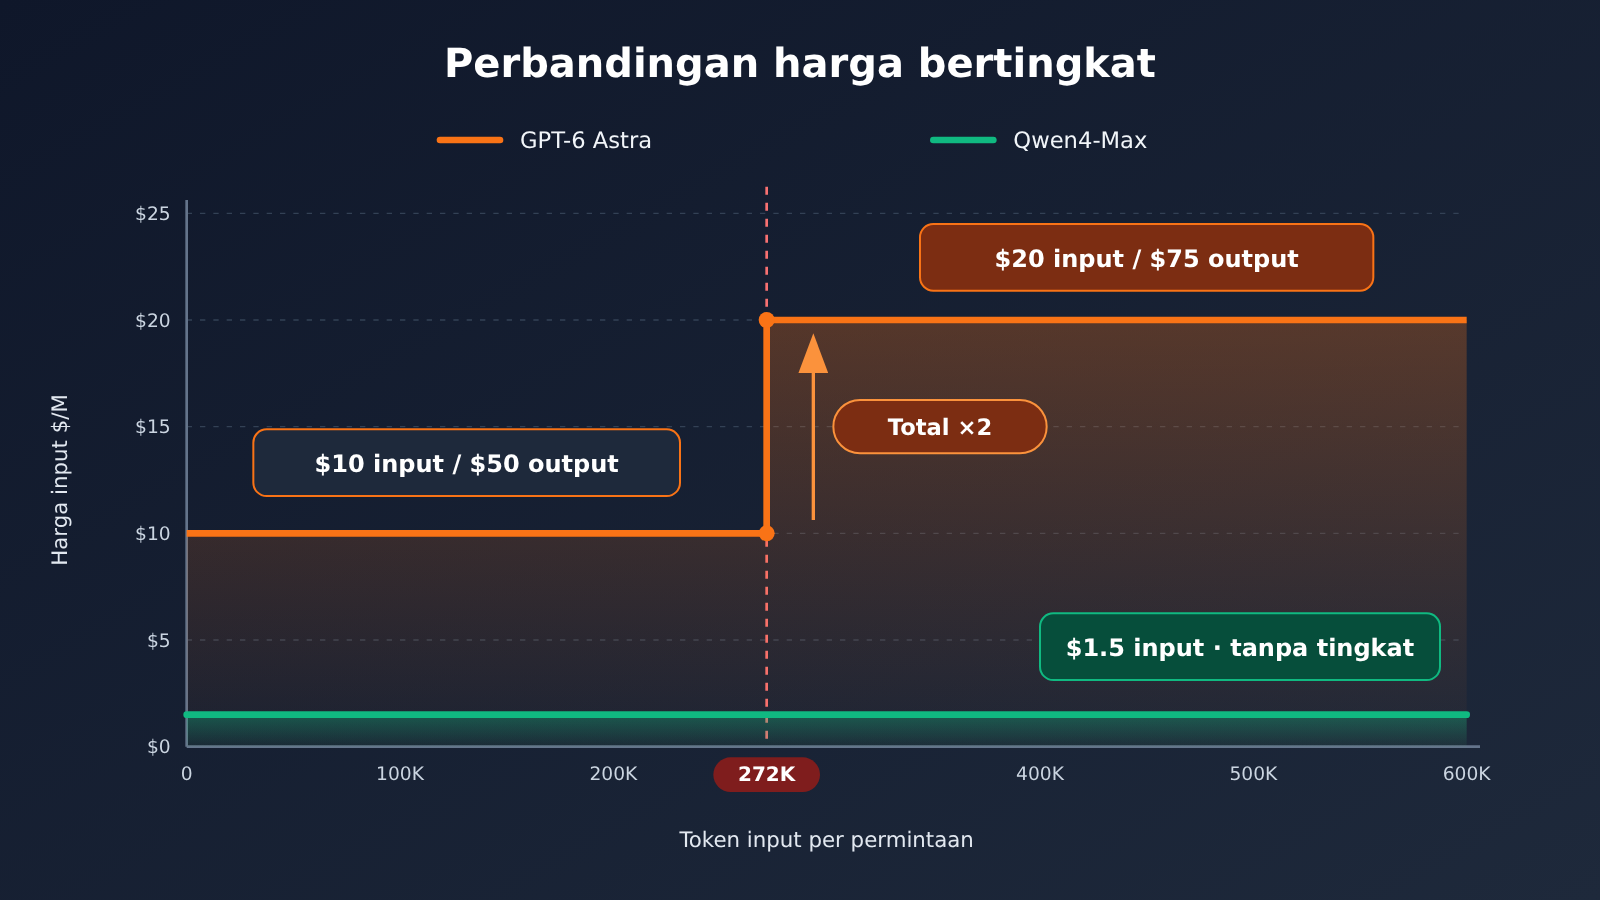
Mari kita hitung dengan beberapa jenis permintaan tipikal berikut. Harga memakai tarif resmi standar, belum menghitung cache.
| Skenario | Qwen4-Max | GPT-6 Astra | Selisih |
|---|---|---|---|
| Sekali permintaan 270K input + 20K output | sekitar $0.50 | sekitar $3.70 | sekitar 7.4× |
| Sekali permintaan 400K input + 20K output | sekitar $0.69 | sekitar $9.50 (aturan 272K sudah terpicu) | sekitar 13.8× |
| Bulanan 100 juta input + 10 juta output (semua permintaan di bawah 272K) | sekitar $195 | sekitar $1,500 | sekitar 7.7× |
| Sama seperti di atas, tetapi semuanya permintaan konteks panjang di atas 272K | sekitar $195 (perkiraan dengan tarif standar) | sekitar $2,750 | sekitar 14× |
Baris kedua paling menjelaskan masalahnya. Input naik dari 270K ke 400K, tokennya hanya bertambah kurang dari setengah, tetapi biaya per permintaan Astra meloncat dari $3.70 ke $9.50. Jadi saat merancang alur konteks panjang untuk Astra, sebaiknya jaga input per permintaan tetap di bawah 272K. Kita bisa dulu melakukan pemangkasan hasil retrieval atau ringkasan per chunk, lalu menyerahkan hasilnya ke Astra untuk inferensi akhir.
Harga terkini APIYI dan status ketersediaan model
Daftar harga APIYI saat ini (2026-11-16) adalah sebagai berikut. Pada akhirnya, daftar model di platform yang menjadi acuan.
gpt-6-astra: input $10, output $50, baca cache $1; input pada rentang 272,001–1,050,000 token adalah $20, sesuai dengan tingkatan resmi.qwen3.8-max: input $1.65, output $4.95, baca cache $0.20625.qwen4-max: belum tersedia, kami akan segera menghadirkan model ini. ID model dan harga setelah tersedia mengacu pada daftar model di apiyi.com.
💰 Saran biaya: sebelum
qwen4-maxtersedia, Anda bisa lebih dulu memakaiqwen3.8-maxuntuk menjalankan dan menguji petunjuk serta alur tool calling keluarga Qwen, lalu langsung mengganti parametermodelbegitu model baru diluncurkan. Kedua seri menggunakan Key yang sama di APIYI apiyi.com, dan tagihannya juga dilihat di tempat yang sama, sehingga memudahkan perbandingan langsung biaya nyata di kedua sisi.
Memilih Qwen4-Max atau GPT-6 Astra Berdasarkan Tugas
Menyandingkan skor benchmark dan harga memungkinkan kita memberikan rekomendasi berdasarkan jenis tugas.
| Jenis Tugas | Rekomendasi | Dasar | Platform yang Tersedia |
|---|---|---|---|
| Pemahaman grafik / tangkapan layar | GPT-6 Astra | Unggul 16,9 poin di Chartography | APIYI apiyi.com, OpenAI resmi |
| Operasi terminal dan pembangunan repositori kode lengkap | GPT-6 Astra | Terminal-Bench +10,6, ProgramBench +23,5 | APIYI, OpenAI resmi |
| Pemahaman video | GPT-6 Astra | Unggul 8,6 poin di Video-Index | APIYI, OpenAI resmi |
| Perbaikan satu issue / WebDev | Qwen4-Max (rasio harga-kinerja) | Sedikit unggul di DeepSWE, selisih hanya 13 Elo di WebDev, biaya per tugas sekitar setengah | QwenCloud; APIYI belum tersedia |
| Agent otomasi kantor dan alur kerja | Qwen4-Max | AA-Briefcase +117, APEX +7,4, HLAB-Vals +14,2 | QwenCloud; APIYI belum tersedia |
| Pemrosesan batch konteks panjang (>272K) | Qwen4-Max | Tanpa kenaikan harga seluruh pesanan ala Astra, output maksimum 393K | QwenCloud; APIYI belum tersedia |
| Tanya jawab profesional medis | GPT-6 Astra | Unggul 6,0 di HealthBench Professional | APIYI, OpenAI resmi |
Skenario yang Cocok untuk GPT-6 Astra
- Kontrol kualitas multimodal: Grafik, tangkapan layar dasbor, dan potongan video perlu diinterpretasikan dengan akurasi tinggi, di mana biaya kesalahan jauh lebih besar daripada biaya token.
- Agent pengodingan otonom: Harus mengeksekusi perintah dalam rantai panjang di terminal sandbox dan membangun program lengkap, sehingga selisih pada ProgramBench akan langsung memengaruhi tingkat keberhasilan tugas.
- Permintaan bernilai tinggi dengan frekuensi rendah: Volume panggilan tidak besar, tetapi setiap hasil memengaruhi keputusan; dalam kondisi ini, harga output 11 kali lipat hanya menempati porsi terbatas dari total anggaran.
Skenario yang Cocok untuk Qwen4-Max
- Tugas teks dengan throughput tinggi: Pemrosesan dokumen, ringkasan, dan ekstraksi dalam jumlah besar setiap hari, di mana selisih harga output 11,1 kali lipat akan langsung menentukan tagihan bulanan.
- Agent untuk pekerjaan kantor: Alur formulir, pemrosesan dokumen bisnis, dan alur kerja otomatis, di mana skor Qwen4-Max sendiri sudah lebih tinggi.
- Input sangat panjang dan output sangat panjang: Kontrak berukuran ratusan K, peninjauan menyeluruh repositori kode, serta laporan yang perlu dibuat hingga ratusan ribu token sekaligus.
Rekomendasi keputusan untuk Qwen4-Max dan GPT-6 Astra
Bagi tim yang sudah menggunakan Astra dan anggarannya ketat, pendekatan yang lebih aman adalah perutean campuran, bukan beralih seluruhnya. Tiga jenis permintaan—grafik, terminal, dan video—tetap ditangani Astra; permintaan teks dan agen perkantoran lainnya dipindahkan ke keluarga Qwen; lalu permintaan konteks panjang Astra ditekan hingga di bawah 272K. Dengan begitu, kemampuan yang benar-benar unggul dari Astra tetap terjaga, sekaligus memangkas biaya terbesar dari selisih harga.
Sebelum mengganti model, sebaiknya periksa tiga hal berikut:
- Periksa model: Di daftar model APIYI apiyi.com, pastikan
gpt-6-astradanqwen3.8-maxtersedia, serta perhatikan status peluncuranqwen4-max; jangan mengisi ID model berdasarkan ingatan. - Periksa harga: Periksa harga satuan untuk input, output, dan baca cache, serta tier input Astra sebesar $20 untuk di atas 272,001 token. Hitung ulang tagihan bulanan berdasarkan distribusi token aktual di log Anda.
- Periksa protokol: Kedua model dapat dipanggil melalui antarmuka kompatibel OpenAI di
https://api.apiyi.com/v1; cukup setelbase_urlke alamat tersebut saat inisialisasi SDK. Astra juga mendukung dua endpoint,/v1/responsesdan/v1/chat/completions. Jika perlu menyesuaikan tingkat penalaran denganreasoning.effort, sebaiknya verifikasi perilaku parameter terlebih dahulu di endpoint Responses.
💡 Saran pemilihan: Kirim sampel bisnis yang sama ke
gpt-6-astradan model keluarga Qwen secara terpisah, lalu catat akurasi dan biaya per permintaan; ini lebih andal daripada melihat papan peringkat. Dengan APIYI apiyi.com, cukup mengganti parametermodelmenggunakan satu kunci API untuk melakukan perbandingan; pengguna baru juga memiliki kuota uji gratis untuk menjalankan sampel kecil lebih dulu.
FAQ (Pertanyaan yang Sering Diajukan)
Q1: Apa posisi Qwen4-Max dan GPT-6 Astra masing-masing?
Qwen4-Max dirilis pada 2026-11-16, menggunakan struktur backbone 2.4T / 71B aktif, mendukung visi native dan jendela konteks 1M. GPT-6 Astra adalah model general-purpose terkuat OpenAI saat ini, dengan jendela konteks 1.050.000 token, dan tingkat penalaran dibagi menjadi lima level dari low hingga max.
Q2: Astra jauh lebih mahal, apakah tambahan skornya sepadan?
Tergantung tugasnya. Pada pemahaman grafik (+16.9), ProgramBench (+23.5), Terminal-Bench (+10.6), dan pemahaman video (+8.6), keunggulan Astra memang nyata, jadi untuk tugas-tugas ini premiumnya layak dibayar. Pada Agent perkantoran, HLAB-Vals, dan AA-Briefcase, Qwen4-Max punya skor lebih tinggi dengan harga lebih murah, jadi membayar lebih untuk Astra justru tidak masuk akal.
Q3: Apakah hasil benchmark ini bisa dipercaya?
Ke-15 benchmark tersebut adalah perbandingan pada grafik yang sama yang dilaporkan sendiri oleh pihak Qwen, jadi termasuk data pihak pertama dan perlu dibaca dengan menyisakan margin. Snapshot papan peringkat publik arena (2026-11-14) bisa dijadikan referensi silang pihak ketiga, dan selisih keduanya di WebDev juga hanya 13 Elo. Namun Qwen4-Max di papan peringkat masih ditandai sebagai Preliminary, dan jumlah suaranya juga lebih sedikit.
Q4: Bagaimana aturan Astra untuk input di atas 272K?
Setelah input satu kali permintaan melewati 272K, seluruh input dan cache dalam permintaan itu dihitung 2x, dan output dihitung 1.5x. Kenaikan harga berlaku untuk keseluruhan permintaan, bukan hanya bagian yang melewati batas. Contohnya, 400K input ditambah 20K output biayanya sekitar $9.50, sekitar 2.5x lipat dibandingkan 270K input dengan output yang sama.
Q5: Apakah sekarang Qwen4-Max sudah bisa dipanggil lewat APIYI?
Saat ini `qwen4-max` belum tersedia di daftar, kami akan segera menambahkannya. Sementara itu Anda bisa memakai `qwen3.8-max` ($1.65 / $4.95 / baca cache $0.20625) untuk memvalidasi alur kerja keluarga Qwen. `gpt-6-astra` sudah tersedia, dengan alamat akses seragam `https://api.apiyi.com/v1`, dan model spesifiknya mengikuti daftar model di apiyi.com.
Q6: Apa saja kekurangan Qwen4-Max yang jelas?
Pemahaman grafik, pemahaman video, operasi rantai panjang di terminal, dan ProgramBench semuanya tertinggal cukup jelas dari Astra, dan HealthBench Professional juga lebih rendah 6 poin. Jika inti bisnis Anda berada di skenario-skenario tersebut, beralih ke Qwen4-Max hanya demi menghemat biaya bisa jadi menukar penghematan itu dengan tingkat keberhasilan yang lebih rendah.
Qwen4-Max vs GPT-6 Astra: Poin-Poin Utama
- Selisih harga: harga input Astra 6.7 kali lipat Qwen4-Max, harga output 11.1 kali, dan cache read 13.3 kali.
- Keunggulan nyata Astra: Chartography 71.1 vs 54.2, Video-Index 76.7 vs 68.1, serta unggul pada terminal dan pembangunan repositori kode.
- Keunggulan nyata Qwen4: HLAB-Vals 21.3 vs 7.1, AA-Briefcase 1686 vs 1569, dan secara keseluruhan lebih kuat pada Agent perkantoran.
- Jebakan konteks panjang: ketika input Astra melewati 272K, seluruh transaksi dikenai biaya tambahan — input ×2, output ×1.5.
- Batas output: output maksimum Qwen4-Max 393K, sedangkan Astra 128K.
- Cara memulai: di APIYI, gunakan Key yang sama untuk membandingkan
gpt-6-astradengan model seri Qwen;qwen4-maxsedang dalam proses penayangan.
Ringkasan
Membandingkan Qwen4-Max dengan GPT-6 Astra, ada tiga kesimpulan inti:
- Harga premium Astra sepadan dengan tiga kemampuan nyata: pemahaman grafik, terminal dan pembangunan repositori kode, serta pemahaman video — tugas-tugas inilah yang layak dibayar lebih.
- Qwen4-Max bukan sekadar lebih murah: pada Agent perkantoran dan sejumlah evaluasi profesional skornya justru lebih tinggi, dan batas outputnya juga lebih besar.
- Konteks panjang harus dihitung terpisah: ambang 272K milik Astra membuat biaya satu kali pemanggilan melonjak; memangkas input ke bawah ambang tersebut lewat retrieval trimming adalah cara paling langsung untuk menghemat.
Bagi sebagian besar tim, routing campuran berdasarkan jenis tugas lebih hemat daripada beralih seluruhnya. Sebaiknya lakukan uji A/B dengan sampel bisnis nyata di APIYI apiyi.com, lalu tentukan proporsi alokasi untuk tiap jenis permintaan.
📚 Referensi
- Dokumentasi Model OpenAI – GPT-6 Astra:spesifikasi, konteks, dan tingkat penalaran
- Tautan:
developers.openai.com/api/docs/models/gpt-6-astra -
Keterangan: sumber asli untuk panjang konteks, input/output maksimum, dan tingkat
reasoning.effort -
Halaman Harga OpenAI:harga standar dan aturan harga di atas 272K
- Tautan:
developers.openai.com/api/docs/pricing -
Keterangan: harga satuan input, output, serta baca/tulis cache, dan aturan kenaikan harga untuk seluruh pesanan pada konteks panjang
-
Papan Peringkat arena.ai Code Arena WebDev:papan publik pihak ketiga (tanggal snapshot 2026-11-14)
- Tautan:
arena.ai - Keterangan: referensi silang peringkat Elo, jumlah suara, dan biaya per tugas
Penulis:Tim Teknis APIYI
Diskusi Teknis:Silakan hubungi kami di halaman beranda situs APIYI, materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com


