
Catatan penulis: Durasi tugas Codex ditentukan bersama oleh model, intensitas penalaran, jalur layanan, siklus alat, cache, dan jaringan. Dengan perbandingan tugas yang sama dilengkapi pengukuran waktu per segmen, Anda bisa menemukan titik hambatannya.
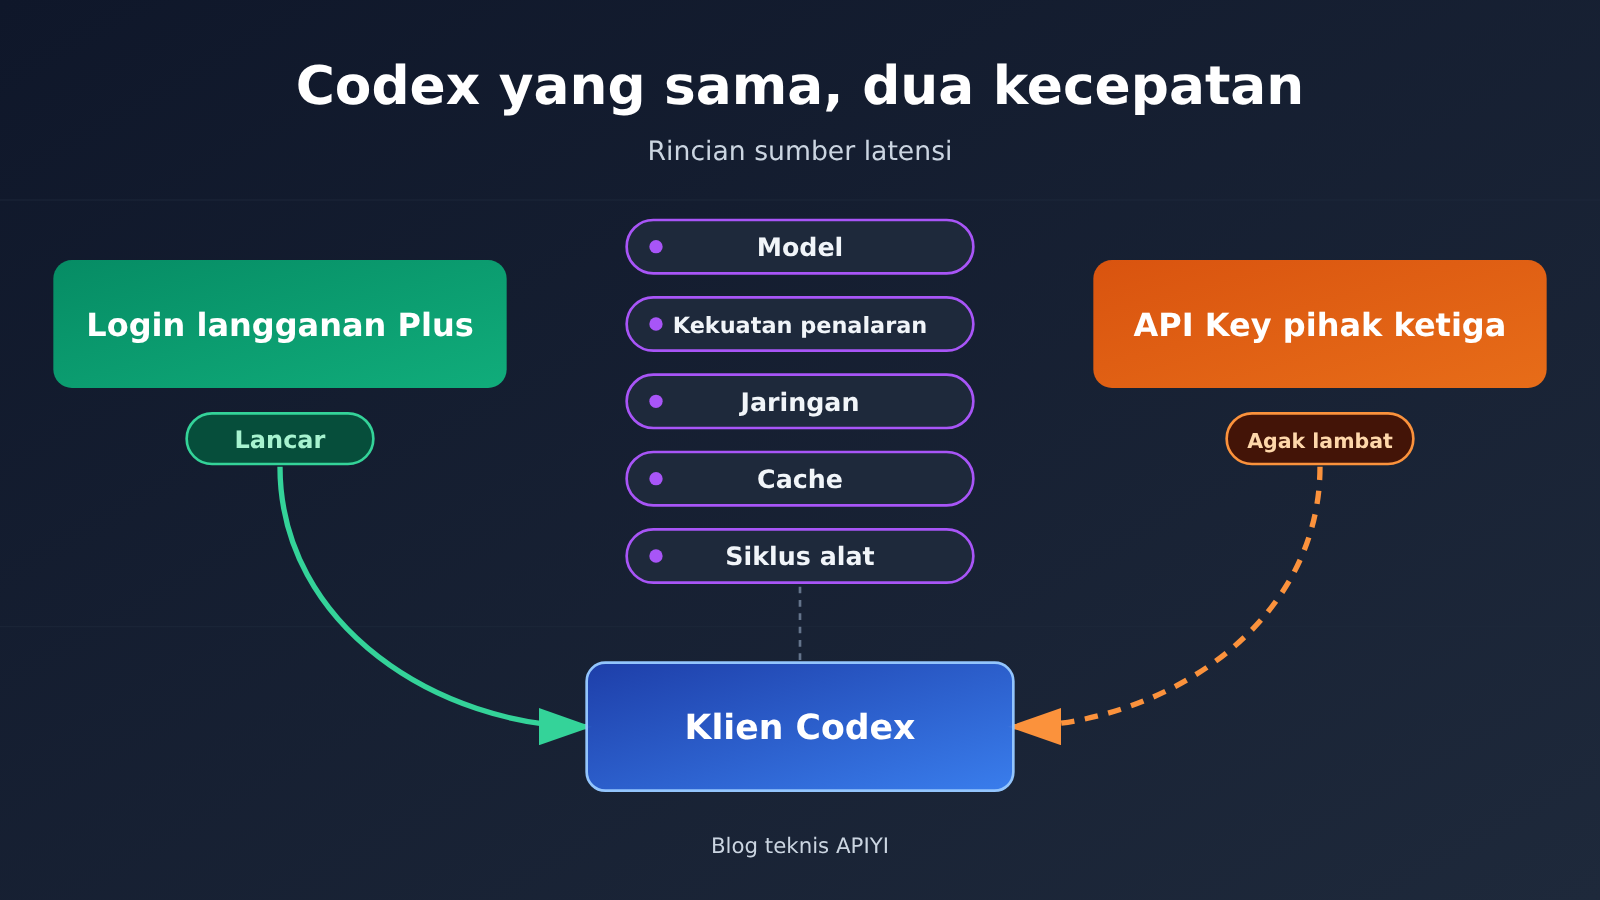
Codex yang sama, saat login dengan ChatGPT Plus terasa lancar, tetapi begitu diganti dengan kunci API pihak ketiga menjadi lambat — penyebabnya biasanya karena keduanya melewati jalur layanan yang berbeda, dan siklus Agent Codex akan mengakumulasi latensi tambahan di setiap putaran permintaan secara berlipat. Antarmuka klien memang sama, tetapi deployment model, tingkat penalaran, protokol transmisi, cache hit, dan tingkat kompatibilitas event alat semuanya bisa berbeda. Satu permintaan hanya menunggu 3 detik lebih lama, tetapi tugas pemrograman yang membutuhkan 20 putaran panggilan serial bisa menambah sekitar 1 menit.
Uraian berikut pertama-tama membedah cara kerja Codex dan dua jalur aksesnya, lalu menjelaskan satu per satu sumber latensi pada API pihak ketiga, dan menggunakan dua GitHub Issue publik sebagai bukti kasus. Setelah itu disajikan empat metrik inti, tiga kelompok pengujian pembanding, serta rencana optimasi yang diklasifikasikan berdasarkan gejala — untuk membantu Anda menentukan apakah Codex Anda lambat di model, jaringan, cache, atau siklus alat. Terakhir, dibahas saat memilih API pihak ketiga, metrik mana yang lebih mencerminkan biaya sebenarnya daripada harga satuan.
To Know: Terminologi untuk Memahami Perbedaan Kecepatan Codex
| Terminologi | Penjelasan |
|---|---|
| Codex Harness | Kerangka eksekusi Codex, bertanggung jawab mengatur model, alat, konteks, dan siklus tugas multi-putaran. |
| Responses API | Antarmuka yang disediakan OpenAI, mendukung output model, pemanggilan alat, dan manajemen status multi-putaran; Codex bergantung padanya untuk beroperasi. |
| TTFT | Time To First Token, waktu tunggu dari saat permintaan dikirim hingga token output pertama diterima. |
| TPS | Tokens Per Second, jumlah token yang dihasilkan per detik, mencerminkan kecepatan output berkelanjutan. |
| Waktu end-to-end | Total waktu dari pengiriman tugas hingga tugas akhirnya selesai, mencakup seluruh pemanggilan model dan eksekusi alat. |
| Tingkat penalaran | Tingkat kedalaman pemikiran model, seperti low, medium, high; tingkat yang lebih tinggi biasanya menghasilkan output lebih banyak dan waktu lebih lama. |
| Pemanggilan alat (Tool Calling) | Proses di mana model meminta program eksternal untuk membaca file, menjalankan perintah, dan sebagainya, lalu menggunakan hasilnya untuk melanjutkan penalaran. |
| Caching petunjuk (Prompt Caching) | Ketika prefiks input berulang dan memenuhi syarat, hasil perhitungan yang sudah ada digunakan kembali untuk mengurangi waktu pemrosesan. |
| SSE | Server-Sent Events, server terus-menerus mengirimkan event melalui koneksi HTTP satu arah. |
| WebSocket | Koneksi dua arah yang persisten, sehingga permintaan multi-putaran dapat menggunakan kembali koneksi yang sama. |
| previous_response_id | Parameter dalam Responses API yang mereferensikan respons putaran sebelumnya; dipadukan dengan input inkremental dapat mengurangi transmisi berulang. |
| Tingkat layanan | Opsi pemrosesan berbeda untuk model yang sama, seperti Standard, Fast, dengan kecepatan dan harga yang berbeda-beda. |
1 Mengapa Codex yang sama bisa memiliki dua kecepatan?
1.1 Login langganan Codex dan API Key melewati jalur layanan yang berbeda
Menurut dokumentasi autentikasi OpenAI, Codex CLI, ekstensi IDE, dan aplikasi desktop sama-sama mendukung dua cara login: login akun ChatGPT, atau mengisi kunci API. Login ChatGPT mengonsumsi hak penggunaan Codex yang disertakan dalam langganan beserta kuota terkait; kunci API mengikuti aturan penagihan berbasis metering dan pembatasan laju (rate limit) dari akun API. Langganan Plus sendiri juga tidak mencakup hak untuk memanggil API OpenAI mana pun secara gratis.
Ketika memakai kunci API pihak ketiga, klien Codex hanya bertugas menyusun tugas, sedangkan inferensi sebenarnya terjadi pada layanan di balik antarmuka tersebut. Model yang benar-benar dipanggil, cara penagihan, protokol streaming, dan kualitas layanan semuanya ditentukan oleh implementasi antarmuka pihak ketiga dan backend-nya. Jadi, nama model yang tampil sama di klien hanya berarti Anda memilih nama yang sama; itu tidak bisa memastikan bahwa dua permintaan melewati deployment model, antrean layanan, dan jalur transmisi yang sama.
1.2 Loop Agent Codex membuatnya perlu meminta model berulang kali
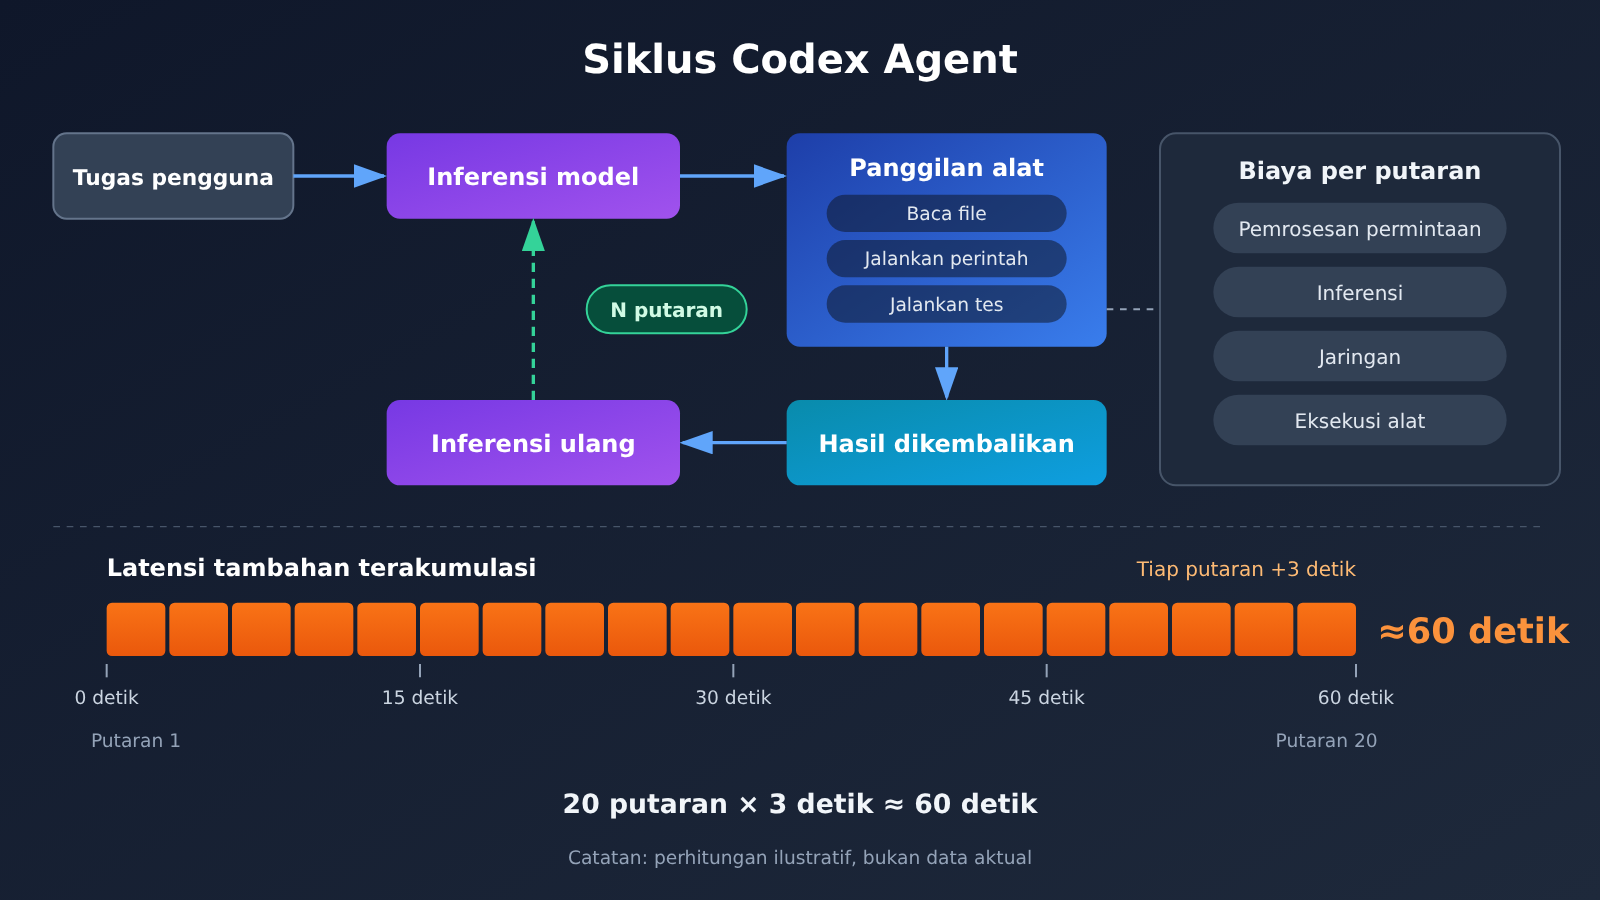
Dalam “Codex as a platform” yang diterbitkan OpenAI pada 19 Agustus 2026 dijelaskan bahwa Agent Harness open-source milik Codex bertanggung jawab memahami tugas, memelihara konteks, menelusuri basis kode, memanggil Shell, mengedit file, menjalankan pengujian, serta menangani pemulihan kegagalan, persetujuan pengguna, dan batas eksekusi. Hakikatnya adalah sistem loop “inferensi model → eksekusi alat → inferensi lagi”.
Dalam artikel engineering OpenAI tanggal 22 April 2026 diuraikan alur tipikalnya: pengguna mengajukan tugas perubahan, model menilai apa yang harus dilakukan, Codex membaca file atau menjalankan perintah, setelah alat mengembalikan hasil model menganalisis ulang, lalu melanjutkan memanggil alat, mengubah kode, menjalankan pengujian, dan memeriksa hasil. Tugas kompleks bisa mencakup puluhan putaran bolak-balik antara model dan alat, dan setiap putaran merupakan satu permintaan API penuh.
2 Dari mana perbedaan kecepatan Codex saat terhubung ke API pihak ketiga?
Mari kita rangkum dulu lima sumber latensi dalam satu tabel, lalu bahas satu per satu.
| Sumber latensi | Metrik yang paling terpengaruh | Gejala tipikal | Prioritas pemeriksaan |
|---|---|---|---|
| Model dan intensitas reasoning | TPS, waktu inferensi per putaran | Output terus-menerus lambat, waktu berpikir panjang | Tinggi |
| Tingkat layanan dan routing | TTFT, besaran fluktuasi | Respons pertama lambat atau kadang cepat kadang lambat | Tinggi |
| Gateway dan jalur jaringan | Waktu tambahan tetap di setiap putaran | Setiap panggilan selalu lebih lambat beberapa detik secara konsisten | Sedang |
| Protokol transport (SSE / WebSocket) | Akumulasi biaya pada banyak putaran, stabilitas koneksi | Tugas panjang lambat, koneksi terputus di tengah jalan | Sedang |
| Cache dan loop tool | Waktu pemrosesan input, jumlah putaran panggilan | Percakapan panjang jelas melambat, putaran terlalu banyak | Tinggi |
2.1 Pengaruh kecepatan inferensi model dan intensitas reasoning terhadap waktu Codex
Sebelum membandingkan dua cara akses, kita harus memastikan ID model aktual, intensitas reasoning, versi model, dan tingkat layanan memang sama. Intensitas reasoning berkisar dari low hingga xhigh, max; semakin tinggi tingkatnya, semakin banyak konten berpikir yang dihasilkan model, dan semakin lama waktu per putaran.
Panduan optimasi latensi OpenAI menempatkan jumlah token output sebagai variabel kunci yang memengaruhi waktu inferensi: pada sebagian skenario, mengurangi token output sekitar 50% bisa menurunkan latensi generasi mendekati 50% pula; sementara dampak dari mengurangi teks input biasa biasanya jauh lebih kecil. Tingkat layanan juga sama pentingnya — mode Fast dari OpenAI dapat mencapai kecepatan hingga 2,5 kali lipat untuk model dan beban kerja yang sesuai, tetapi ini adalah pilihan tingkat berbayar dan hanya berlaku untuk sebagian model.
Artinya, meskipun sisi langganan dan sisi pihak ketiga sama-sama menampilkan model yang ident, begitu tingkat reasoning atau tingkat layanannya berbeda, perbedaan kecepatannya akan langsung terlihat jelas.
2.2 Dampak layanan proksi API, jalur jaringan, dan WebSocket terhadap tugas multi-putaran
Rantai permintaan pada antarmuka pihak ketiga biasanya lebih panjang: klien → gateway penyedia layanan → node proksi → kemungkinan jalur lintas negara → layanan inferensi akhir. Setiap tambahan hop dapat menambah latensi tetap dan fluktuasi jaringan, dan latensi ini akan terakumulasi dari putaran ke putaran dalam siklus Agent.
Protokol transport adalah variabel lain. Responses API tradisional umumnya ditransmisikan melalui HTTP/SSE, dan setiap putaran harus membangun ulang permintaan serta membawa konteks. Mode WebSocket mempertahankan koneksi persisten dan, dengan bantuan previous_response_id serta input inkremental, mengurangi transmisi dan pemrosesan berulang. Data resmi yang dipublikasikan OpenAI adalah sebagai berikut:
- Optimasi API pada akhir 2025 membuat latensi token pertama membaik hampir 45%.
- Dalam alur kerja tertentu dengan lebih dari 20 pemanggilan alat, mode WebSocket memberikan percepatan end-to-end hingga sekitar 40%.
- Integrasi terkait Vercel melaporkan perbaikan latensi hingga sekitar 40%, alur kerja multi-file Cline melaporkan percepatan sekitar 39%, dan model OpenAI di Cursor melaporkan perbaikan hingga sekitar 30%.
Data ini berasal dari berbagai produk dan skenario pengujian, dan merupakan nilai batas atas dalam alur kerja tertentu. Sebagian gateway kompatibel hanya mengimplementasikan HTTP/SSE, atau tidak sepenuhnya mendukung WebSocket dan manajemen status inkremental yang digunakan Codex; integrasi semacam ini tidak akan memperoleh manfaat tersebut.
2.3 Cache konteks dan jumlah pemanggilan tool di Codex
Dalam tugas panjang, pesan historis, definisi tool, dan konteks berulang dapat menghabiskan banyak token input. Saat cache petunjuk berhasil digunakan (cache hit), waktu pemrosesan prefiks ini bisa berkurang. Dokumentasi OpenAI menunjukkan bahwa GPT-5.6 dan seri setelahnya mendukung penulisan cache, pembacaan, dan kontrol TTL yang baru.
Masalahnya, cache bergantung pada stabilitas prefiks permintaan. Jika lapisan proksi menulis ulang prefiks permintaan, mengubah urutan definisi tool, atau mengubah batas cache, maka pemakaian ulang cache bisa terpengaruh, sehingga setiap putaran memproses ulang sebagian besar konteks. Jumlah pemanggilan tool secara langsung menentukan jumlah putaran permintaan: semakin banyak putaran, semakin tinggi pula faktor pengali untuk semua biaya per putaran.
2.4 Mengapa respons pertama Codex normal, tetapi setelahnya masih lambat?
Ini adalah bentuk paling umum dari masalah yang disebut di judul. TTFT hanya mengukur seberapa cepat token pertama datang, sedangkan total waktu tugas Codex adalah akumulasi dari semua putaran. Total waktu dapat ditulis sebagai:
T_total = Σ (waktu pemrosesan permintaan API + waktu inferensi model + waktu transmisi jaringan + waktu eksekusi tool lokal + waktu tunggu dan percobaan ulang)
Respons pertama normal tetapi keseluruhan lambat biasanya berasal dari beberapa kondisi berikut: kecepatan output berkelanjutan (TPS) rendah, balasan panjang memperlambat setiap putaran; setelah eksekusi tool selesai, model melakukan inferensi ulang, dan setiap inferensi ulang harus memproses konteks sekali lagi; koneksi streaming terputus di tengah atau timeout, klien memicu percobaan ulang, dan yang dilihat pengguna adalah “model berhenti”. Berdasarkan perhitungan mekanisme, tugas yang membutuhkan 20 pemanggilan model serial, jika setiap kali menunggu 3 detik lebih lama, total waktu akan bertambah sekitar 60 detik; angka ini digunakan untuk menggambarkan efek akumulatif, bukan hasil pengukuran aktual.
Bukti apa yang diberikan kasus publik terhadap masalah kelambatan Codex?
Dua kasus berikut berasal dari laporan pengguna di repositori openai/codex. Keduanya merupakan log kasus individual dari satu pengguna, digunakan untuk menjelaskan mekanisme, dan tidak mewakili tingkat umum di industri.
3.1 Issue #60831: Fluktuasi waktu respons sekitar tujuh kali dalam sesi yang sama
Dalam Issue #60831 yang diajukan pada November 2026, pelapor mengamati dua permintaan dalam sesi yang sama, proses klien yang sama, dan pengaturan inferensi yang sama: badan permintaan setelah kompresi keduanya sekitar 13.09 MB, tidak terjadi kompresi konteks di antaranya, dan riwayat gambar juga tidak berubah. Permintaan yang lambat membutuhkan 109.317 detik dari selesainya kompresi permintaan hingga menerima header respons HTTP, sedangkan yang cepat 15.637 detik, dengan rasio sekitar 6.99 kali.
Perlu diperhatikan cakupan pengukurannya: kedua angka ini mengukur waktu “sampai menerima header respons”, yang termasuk tahap pemrosesan layanan, bukan durasi penyelesaian keseluruhan tugas; kedua permintaan juga berasal dari jalur yang sama, tidak terkait dengan perbandingan langganan maupun pihak ketiga. Ini menunjukkan bahwa ketika ukuran konteks tidak berubah, waktu pemrosesan sisi server itu sendiri bisa sangat berfluktuasi. Laporan itu sendiri tidak dapat menentukan secara pasti tahap layanan mana yang menyebabkan kemacetan.
3.2 Issue #44305: Perulangan alat membuat satu tugas hanya-baca meledak durasinya
Dalam Issue #44305 pada September 2026, pelapor membandingkan tugas hanya-baca sejenis: Agent lain menggunakan 3 pembacaan paralel dan selesai sekitar 10.6 detik; Codex berjalan 91.5 detik lalu timeout, tanpa memberikan jawaban lengkap. Selama itu Codex melakukan sekitar 11 inferensi model dan 11 pemanggilan alat, dengan total input sekitar 295,042 token, di antaranya input cache sekitar 260,608 token.
Berdasarkan angka-angka ini, proporsi input cache sekitar 88.3%, kondisi cache hit cukup baik, tetapi 11 putaran berurutan tetap membuat durasi jauh lebih lama daripada solusi pembacaan paralel. Strategi kerja kedua Agent itu sendiri berbeda, selisih waktu tidak bisa sepenuhnya diatribusikan ke Codex atau model, tetapi ini dengan jelas menunjukkan efek penggandaan dari jumlah putaran pemanggilan dan eksekusi berurutan terhadap total durasi.
Selain itu, ada dua jenis masalah lagi yang berkaitan langsung dengan integrasi pihak ketiga: Issue #33029 melaporkan bahwa saat Codex Desktop menggunakan antarmuka kompatibel pihak ketiga, endpoint model bekerja normal, tetapi aplikasi desktop tetap meminta sebagian layanan tambahan ChatGPT, dan permintaan yang timeout ini memperlambat respons aplikasi; Issue #41340 dan #42471 masing-masing melaporkan munculnya “stream disconnected before completion” pada endpoint Responses pihak ketiga, serta peristiwa pemanggilan alat yang diterima tetapi tidak masuk ke alur eksekusi. Chat sederhana bisa berjalan, dan siklus alat Codex yang lengkap bisa berjalan, adalah dua tingkat persyaratan kompatibilitas yang berbeda.
4 Bagaimana menemukan di mana Codex Anda lambat?
4.1 Gunakan empat metrik inti untuk menemukan bottleneck Codex
| Metrik | Cara pencatatan | Masalah yang tercermin |
|---|---|---|
| TTFT | Waktu tunggu output valid pertama pada setiap permintaan | Antrean, startup model, paket pertama jaringan |
| Durasi end-to-end | Total waktu tugas dari pengiriman hingga selesai | Pengalaman keseluruhan, menjadi dasar penilaian akhir |
| Jumlah pemanggilan model / tool | Hitung putaran inferensi, jumlah tool, dan waktu eksekusi tool | Strategi Agent dan amplifikasi serial |
| Cache hit | Total input, pembacaan cache, penulisan cache, token output | Biaya pemrosesan ulang konteks |
Selain keempat metrik ini, sebaiknya catat juga TPS, token input/output per permintaan, protokol yang digunakan (WebSocket atau SSE), serta jumlah 429, 5xx, timeout, dan retry. Data tambahan ini membantu Anda membedakan “lambat” dengan “lambat akibat retry setelah error”.
4.2 Langkah Eksekusi Uji Pembanding Tiga Kelompok Codex
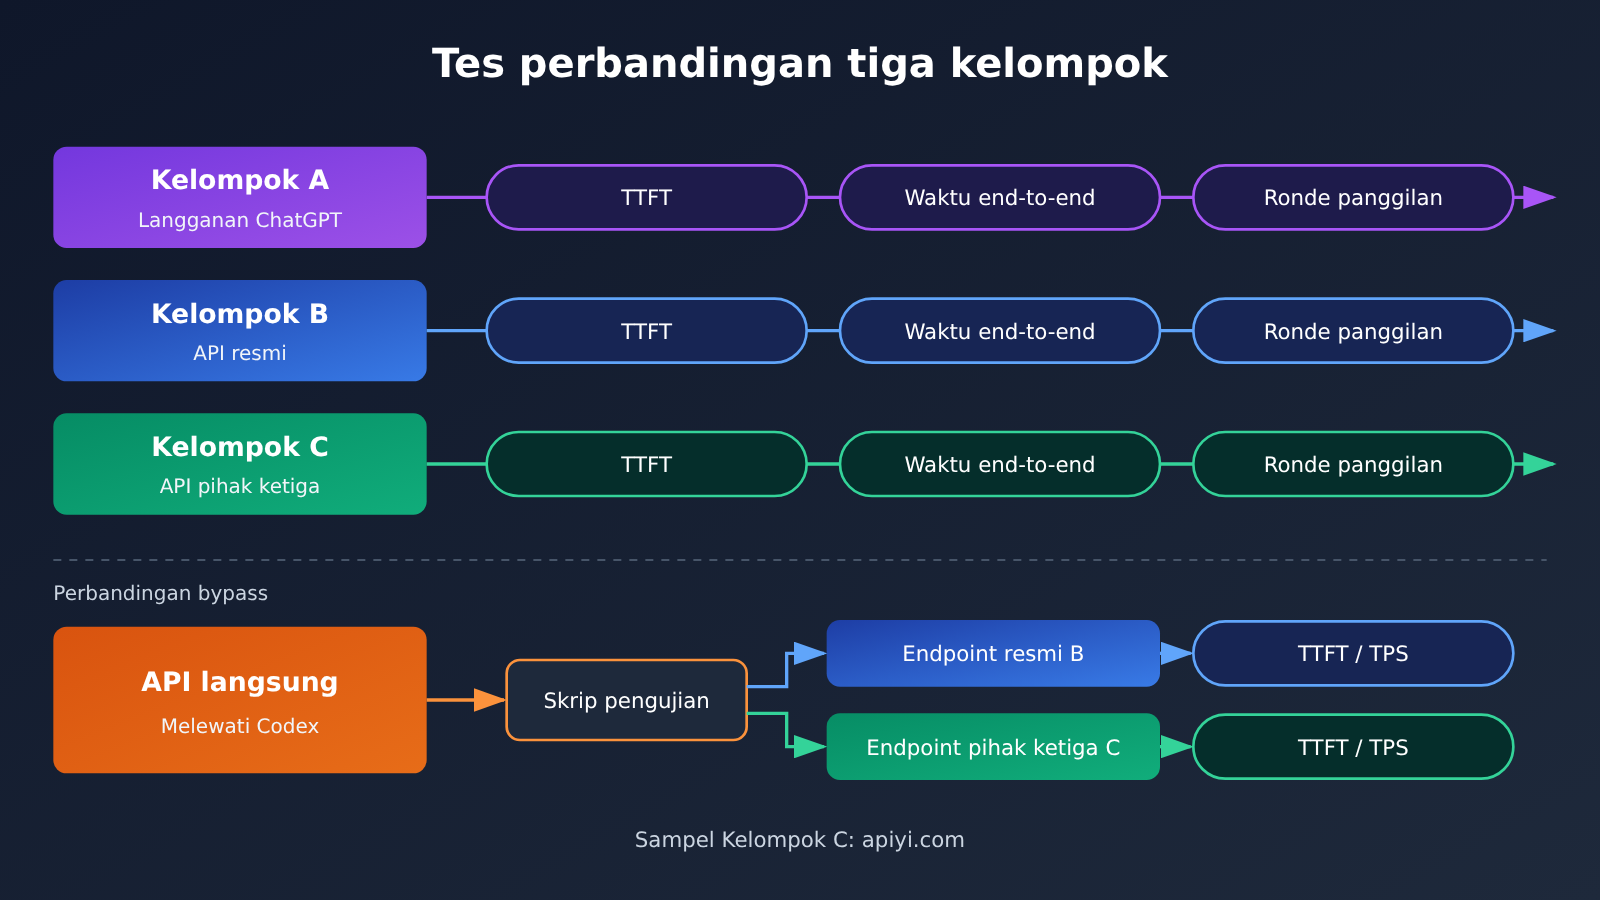
Prasyarat uji pembanding adalah mengontrol variabel: ID model, tingkat penalaran, versi Codex, file proyek, dan deskripsi tugas harus tetap sama, lalu masing-masing dijalankan sekali dalam dua skenario—sesi baru dan sesi panjang—untuk mengidentifikasi pengaruh panjang konteks.
- Grup A: Masuk ke Codex menggunakan langganan ChatGPT, jalankan tugas standar, catat durasi end-to-end dan jumlah putaran pemanggilan.
- Grup B: Hubungkan Codex menggunakan kunci API resmi dari model yang sama, jalankan tugas yang sama.
- Grup C: Hubungkan Codex menggunakan API kompatibel pihak ketiga, jalankan tugas yang sama.
- Kelompok koneksi langsung: Untuk jalur B dan C, lewati Codex, kirim permintaan tunggal yang sama dengan skrip, ukur TTFT dan TPS.
Perbedaan A dan B terutama mencerminkan perbedaan layanan antara jalur langganan dan jalur API; perbedaan B dan C mencerminkan perbedaan gateway, routing, dan layanan inferensi; sedangkan selisih antara hasil koneksi langsung dan hasil di dalam Codex mencerminkan overhead tambahan dari loop Agent, kompatibilitas protokol, dan klien. Untuk setiap kelompok, disarankan mengulang pengujian beberapa kali dan mengambil median agar satu fluktuasi sesaat tidak dianggap sebagai kesimpulan.
Skrip berikut dipakai untuk pengujian “kelompok koneksi langsung”: mengirim permintaan Responses secara streaming untuk mengukur TTFT, durasi total, token output, dan TPS:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI; ganti ke alamat resmi untuk kontrol Grup B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Samakan dengan ID model yang digunakan di Codex
    reasoning={"effort": "medium"},   # Samakan dengan tingkat penalaran di Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Lihat skrip lengkap untuk pengujian berulang multi-putaran dan statistik cache
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # antarmuka APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Gunakan prefiks tetap yang cukup panjang untuk mensimulasikan system prompt dan definisi tool Codex, agar cache hit lebih mudah diamati
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Saat menjalankan pengujian Grup C di dalam Codex, Anda perlu mengonfigurasi endpoint pihak ketiga sebagai penyedia model. Berikut adalah bentuk penulisan ~/.codex/config.toml yang umum dipakai; untuk nama field yang spesifik, silakan mengacu pada dokumentasi resmi versi Codex yang Anda gunakan:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Mulai cepat: saat melakukan perbandingan Grup C, Anda dapat mengajukan kuota uji coba gratis untuk pengguna baru di APIYI apiyi.com, lalu memakai Key yang sama untuk berganti beberapa model dan menjalankan skrip di atas satu per satu, sehingga cepat memperoleh data TTFT dan total waktu yang bisa dibandingkan.
4.3 Solusi optimasi Codex berdasarkan gejala
| Gejala | Prioritas pemeriksaan | Cara penanganan |
|---|---|---|
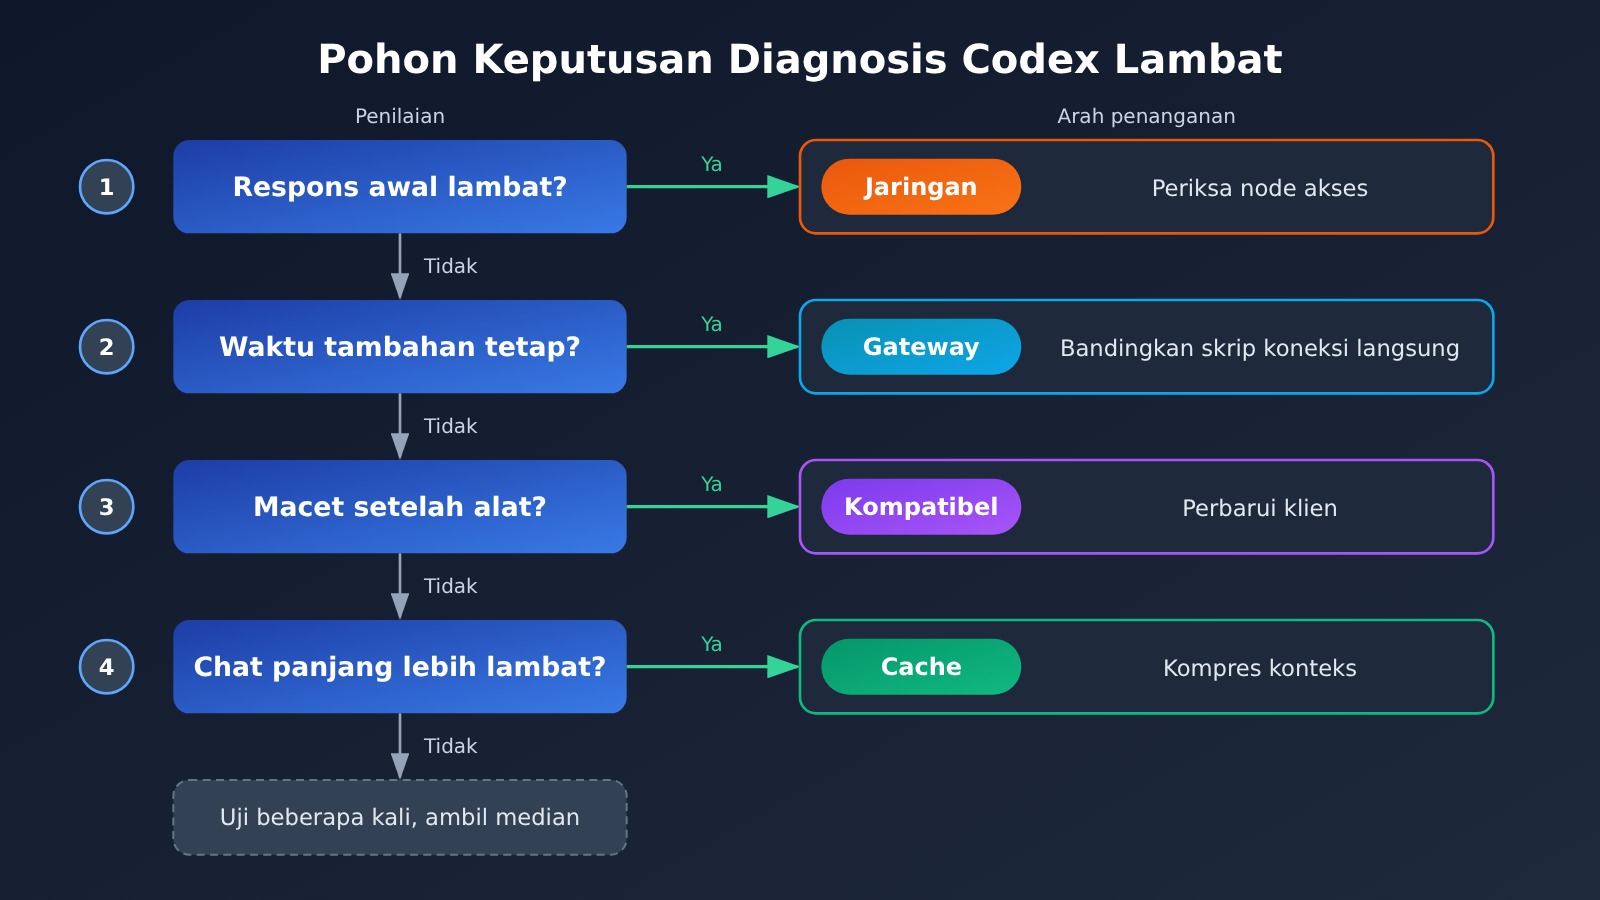
| Respons pertama lambat | Antrean, startup model, paket pertama jaringan | Gunakan node akses yang lebih dekat, konfirmasi tingkat layanan, hindari jam sibuk saat membandingkan |
| Respons pertama cepat, berikutnya lambat | TPS, putaran tool, cache | Turunkan intensitas penalaran, batasi panjang output, periksa rasio cache hit |
| Setiap panggilan ada tambahan waktu yang stabil | Rantai proksi, permintaan tambahan | Bandingkan grup B dan C dengan skrip koneksi langsung, cari sumber overhead gateway |
| Macet setelah pemanggilan tool | Event Responses, callback tool | Periksa apakah ada aliran yang terputus atau event tool yang hilang, perbarui versi klien |
| Percakapan panjang jelas lebih lambat daripada percakapan baru | Token historis, kompresi, cache | Buka sesi baru pada waktu yang tepat atau picu kompresi konteks, amati perubahan pembacaan cache |
| Kecepatan kadang cepat kadang lambat | Beban layanan, retry, fluktuasi jaringan | Hitung jumlah 429/5xx dan timeout, lakukan beberapa pengujian lalu ambil median |
| Desktop keseluruhan lag, API normal | Permintaan layanan pendukung ChatGPT | Lihat Issue #33029, periksa apakah permintaan pendukung timeout, gunakan CLI jika perlu |
Optimasi di tingkat model mengikuti panduan latensi OpenAI: kurangi token output, kurangi konteks input, kurangi jumlah panggilan, proses langkah independen secara paralel, dan hal-hal yang bisa diselesaikan dengan program biasa jangan diserahkan ke model. Untuk Codex, cara paling langsung adalah memberikan cakupan yang lebih jelas dalam deskripsi tugas, agar Agent mengurangi putaran pembacaan yang bersifat eksploratif.
5 Saat memilih API pihak ketiga untuk Codex, metrik apa yang lebih penting daripada harga per unit?
5.1 Dari harga per token ke biaya penyelesaian tugas
Dalam skenario Codex, biaya sebenarnya ditentukan oleh “menyelesaikan satu tugas”. API dengan harga per unit rendah, jika cache hit-nya buruk, jumlah putaran pemanggilan banyak, serta sering terputus dan mencoba ulang, token dan waktu yang akhirnya dikonsumsi justru akan lebih tinggi. Saat mengevaluasi, sebaiknya lihat beberapa hal berikut secara bersamaan: tingkat keberhasilan tugas, waktu end-to-end, total token yang dikonsumsi per tugas (termasuk pembacaan cache), serta biaya tambahan akibat kegagalan dan percobaan ulang.
| Dimensi evaluasi | Fokus | Metode pengujian | Platform yang tersedia |
|---|---|---|---|
| Identitas dan versi model | Apakah ID dan versi model jelas, stabil, serta tersedia | Cocokkan field model yang dikembalikan dengan dokumentasi | APIYI apiyi.com, API resmi |
| Kecepatan token pertama dan berkelanjutan | Median dan fluktuasi TTFT serta TPS | Pengujian multi-putaran dengan skrip koneksi langsung | APIYI apiyi.com, API resmi |
| Waktu penyelesaian Agent multi-putaran | Total waktu tugas nyata di dalam Codex | Pengujian pembanding tiga kelompok | APIYI apiyi.com, API resmi |
| Kompatibilitas protokol | Dukungan Responses, WebSocket, dan event alat | Jalankan satu tugas lengkap: membaca file + mengubah kode + pengujian | Tergantung dokumentasi penyedia layanan |
| Dukungan cache | Apakah token pembacaan cache dikembalikan dengan normal | Lihat statistik field cache dalam usage | Tergantung dokumentasi penyedia layanan |
| Stabilitas dan penagihan | Tingkat kegagalan, konkrensi, dan transparansi penagihan | Catat 429/5xx dan rincian tagihan | Tergantung dokumentasi penyedia layanan |
5.2 Menilai APIYI dan antarmuka pihak ketiga lainnya dengan tugas nyata
APIYI apiyi.com adalah platform agregasi API Model Bahasa Besar AI; satu kunci API dapat memanggil model-model populer seperti OpenAI, Claude, dan Gemini, antarmukanya kompatibel dengan protokol OpenAI, serta penagihannya berdasarkan penggunaan. Nilainya dalam skenario Codex terutama terletak pada kemudahan perbandingan horizontal: dengan konfigurasi yang sama, Anda dapat beralih antar model dan tingkatannya, lalu menghasilkan data yang dapat dibandingkan pada proyek Anda sendiri.
Jalur layanan, dukungan protokol, dan stabilitas tiap penyedia pihak ketiga berbeda-beda; dalam evaluasi, gunakan data pengujian spesifik dan perjanjian layanan sebagai acuan. Disarankan memilih 2~3 tugas representatif (misalnya satu refaktor multi-file, satu perbaikan bug yang disertai pengujian), jalankan masing-masing pada setiap metode integrasi sesuai metode di Bagian 4, lalu putuskan berdasarkan tingkat keberhasilan dan total token.
💡 Saran pemilihan: Pertama, gunakan skrip koneksi langsung untuk menyaring opsi yang TTFT dan TPS-nya jelas menyimpang, lalu masukkan kandidat yang tersisa ke Codex untuk menjalankan tugas lengkap. Melalui antarmuka terpadu APIYI apiyi.com, Anda dapat menyelesaikan perbandingan beberapa model tanpa mengubah struktur kode.
FAQ Pertanyaan Umum
Q1: Dari mana terutama perbedaan kecepatan antara langganan Codex dan API pihak ketiga?
Perbedaan ini berasal dari keseluruhan jalur layanan: deployment model aktual, intensitas inferensi, tingkat layanan, rantai gateway, protokol transmisi, cache hit, dan tingkat kompatibilitas event tool. Loop Agent multi-putaran Codex akan mengakumulasi perbedaan per-putaran ini putaran demi putaran, sehingga selisih total waktu seringkali jauh lebih besar dibandingkan selisih satu permintaan.
Q2: TTFT normal, tapi kenapa tugas Codex tetap lambat?
TTFT hanya mengukur waktu tunggu token pertama. Satu tugas Codex mencakup beberapa putaran inferensi dan pemanggilan tool; kecepatan output berkelanjutan, inferensi ulang setelah eksekusi tool, cache miss, dan retry di tengah jalan semuanya memperpanjang total waktu. Untuk menilai pengalaman, lihat waktu end-to-end dan jumlah putaran pemanggilan.
Q3: Berapa banyak mode WebSocket bisa mempercepat Codex?
Data yang diumumkan OpenAI: dalam alur kerja tertentu dengan lebih dari 20 pemanggilan tool, kecepatan end-to-end meningkat hingga sekitar 40%. Ini adalah batas atas untuk skenario tertentu; manfaat aktual bergantung pada jumlah putaran tugas serta apakah antarmuka sepenuhnya mendukung WebSocket dan manajemen status inkremental.
Q4: Codex makin lambat dalam percakapan panjang, bagaimana menanganinya?
Pertama catat total token input per putaran dan token pembacaan cache, pastikan cache hit berjalan normal. Jika konteks historis terlalu panjang, bisa membuka sesi baru atau memicu kompresi konteks; sekaligus persempit cakupan tugas dan kurangi putaran pembacaan file yang bersifat eksploratif.
Q5: Bagaimana cara cepat mengukur performa sebenarnya API pihak ketiga di Codex?
1. Daftar di APIYI apiyi.com dan dapatkan kunci API serta kuota uji gratis;
2. Gunakan skrip koneksi langsung dalam artikel ini untuk mengukur TTFT, TPS, dan cache hit;
3. Konfigurasi Codex sesuai bagian 4.2, jalankan tugas yang sama dengan sisi langganan, lalu bandingkan waktu end-to-end dan jumlah putaran pemanggilan.
Dengan cara ini, perbedaan layanan inferensi dan perbedaan akibat loop Agent bisa dilihat secara terpisah.
Q6: Apakah data di Issue publik bisa mewakili performa umum Codex?
Tidak bisa langsung mewakili. Issue #60831 dan #44305 keduanya merupakan log dari satu pengguna; yang pertama mengukur waktu hingga header respons HTTP, sedangkan yang kedua adalah tugas read-only yang mengalami timeout. Nilai keduanya terletak pada menunjukkan bagaimana fluktuasi sisi server dan loop tool serial memengaruhi waktu; kesimpulan spesifik perlu diverifikasi dengan pengujian tugas Anda sendiri.
Poin Penting Perbedaan Kecepatan Codex
- Jalur berbeda: Login langganan dan kunci API melewati jalur penagihan serta layanan yang berbeda; nama model yang sama bukan berarti deployment-nya juga sama.
- Efek penggandaan loop: Loop Agent pada Codex mengakumulasikan latensi kecil di setiap putaran menjadi selisih total waktu yang signifikan.
- Metrik berlapis: TTFT mengukur respons pertama, sedangkan waktu end-to-end dan jumlah putaran panggilanlah yang mencerminkan pengalaman sebenarnya.
- Protokol berpengaruh: WebSocket dapat memberikan percepatan hingga sekitar 40% pada skenario pemanggilan alat multi-putaran, tetapi memerlukan dukungan antarmuka yang lengkap.
- Cache perlu diverifikasi: Lapisan proksi dapat mengubah prefiks permintaan yang berpotensi memengaruhi cache, jadi token pembacaan cache perlu dihitung.
- Pengujian pembanding: Bandingkan tiga kelompok—langganan, API resmi, dan API pihak ketiga—pada tugas yang sama, lalu tambahkan pengujian koneksi langsung untuk menemukan hambatan.
- Pilih berdasarkan tugas: Uji secara horizontal memakai tugas nyata di platform seperti APIYI apiyi.com, dan lihat biaya penyelesaian tugas, bukan harga satuan.
Ringkasan
Codex yang sama menunjukkan dua kecepatan berbeda; akar masalahnya terletak pada efek gabungan antara jalur layanan dan loop Agent:
- Tingkat mekanisme: Model, intensitas penalaran, tingkat layanan, gateway, protokol, cache, dan loop alat bersama-sama menentukan total waktu. Perbedaan apa pun dalam satu putaran akan diperbesar oleh panggilan multi-putaran.
- Tingkat bukti: Data resmi menunjukkan bahwa optimasi protokol dan tingkat layanan dapat menghadirkan percepatan yang cukup besar, sementara log pengguna menunjukkan bahwa fluktuasi sisi server dan loop serial dapat memperpanjang durasi tugas secara signifikan.
- Tingkat metode: Catat empat metrik inti, lakukan tiga kelompok pembanding plus pengujian koneksi langsung, lalu optimalkan satu per satu sesuai gejala.
Saat melakukan troubleshooting, pertama-tama tetapkan model dan intensitas penalaran, lalu gunakan data sebagai dasar. Jika Anda perlu membandingkan beberapa model dan cara akses, Anda dapat memanfaatkan antarmuka terpadu APIYI untuk menekan biaya pengujian seminimal mungkin.
📚 Referensi
- Codex as a platform: build on the open agent harness: OpenAI memperkenalkan tanggung jawab Codex Agent Harness
- Tautan:
developers.openai.com/blog/codex-as-a-platform -
Penjelasan: Dasar resmi untuk memahami model multi-putaran dan loop alat Codex
-
Dokumentasi autentikasi Codex: Dua metode akses, login ChatGPT dan kunci API
- Tautan:
learn.chatgpt.com/docs/auth?surface=cli -
Penjelasan: Membedakan hak langganan dengan penagihan API serta aturan pembatasan laju
-
Speeding up agentic workflows with WebSockets in the Responses API: Artikel engineering OpenAI
- Tautan:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Penjelasan: Alur loop Agent dan data percepatan WebSocket
-
Dokumentasi mode WebSocket: Mode WebSocket pada Responses API
- Tautan:
developers.openai.com/api/docs/guides/websocket-mode -
Penjelasan: Koneksi persisten, input inkremental, dan skenario penggunaan yang sesuai
-
Panduan latency optimization: Prinsip optimasi latensi OpenAI
- Tautan:
developers.openai.com/api/docs/guides/latency-optimization -
Penjelasan: Ide optimasi seperti token output, jumlah panggilan, dan paralelisasi
-
Dokumentasi fast mode: Tingkat layanan dan cakupan akselerasi
- Tautan:
developers.openai.com/api/docs/guides/fast-mode -
Penjelasan: Variabel tingkat layanan yang perlu dikendalikan saat membandingkan kecepatan
-
Dokumentasi prompt caching: Penulisan cache, pembacaan, dan TTL
- Tautan:
developers.openai.com/api/docs/guides/prompt-caching -
Penjelasan: Statistik dan optimasi cache hit untuk percakapan panjang
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: Masalah latensi dan kompatibilitas yang dilaporkan pengguna
- Tautan:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Penjelasan: Log kasus individual untuk fluktuasi sisi server, amplifikasi loop alat, permintaan tambahan desktop, dan kompatibilitas protokol pihak ketiga
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI di apiyi.com untuk berdiskusi tentang pengalaman integrasi Codex dan pengujian performa. Materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com.


