
Menghubungkan API Model Bahasa Besar pihak ketiga ke lingkungan produksi — titik tersulitnya tidak pernah ada di momen baris kode pertama berhasil dijalankan. Yang benar-benar menentukan apakah proyek bisa dikirim dengan stabil adalah masalah-masalah yang tidak bisa terlihat lebih awal di bulan pertama setelah rilis: respons kembali tetapi formatnya salah, klien kehabisan waktu sementara platform sudah memotong biaya, jalur utama mati dan fallback diam-diam berpindah ke model yang lebih mahal, lalu tiga bulan kemudian saat ingin melakukan evaluasi ternyata log-nya sudah dihapus.
Ini bukan artikel rekomendasi “platform API mana yang lebih enak dipakai” — tulisan ini tidak mengulang kata sifat dari halaman promosi vendor, dan tidak memberikan peringkat platform apa pun. Kami hanya membahas satu hal yang bisa dikerjakan: sebelum rilis, bukti apa saja yang bisa Anda periksa sendiri untuk menilai apakah sebuah layanan proksi API dan gateway Model Bahasa Besar bisa diandalkan.
Nilai inti: setelah membaca artikel ini, Anda akan mendapatkan satu metode pemeriksaan berisi 7 item checklist penerimaan dan 1 tabel kesimpulan, yang mengubah “sepertinya oke” menjadi “ada buktinya”.
Mulai dari istilah: pahami 6 kata ini sebelum bicara rilis
Sebelum membahas metode penerimaan, mari samakan dulu beberapa istilah yang akan sering muncul. Istilah-istilah ini kerap dipakai dengan arti berbeda di dokumentasi vendor dan artikel teknis, dan perbedaan definisi itu sendiri sudah merupakan risiko saat rilis.
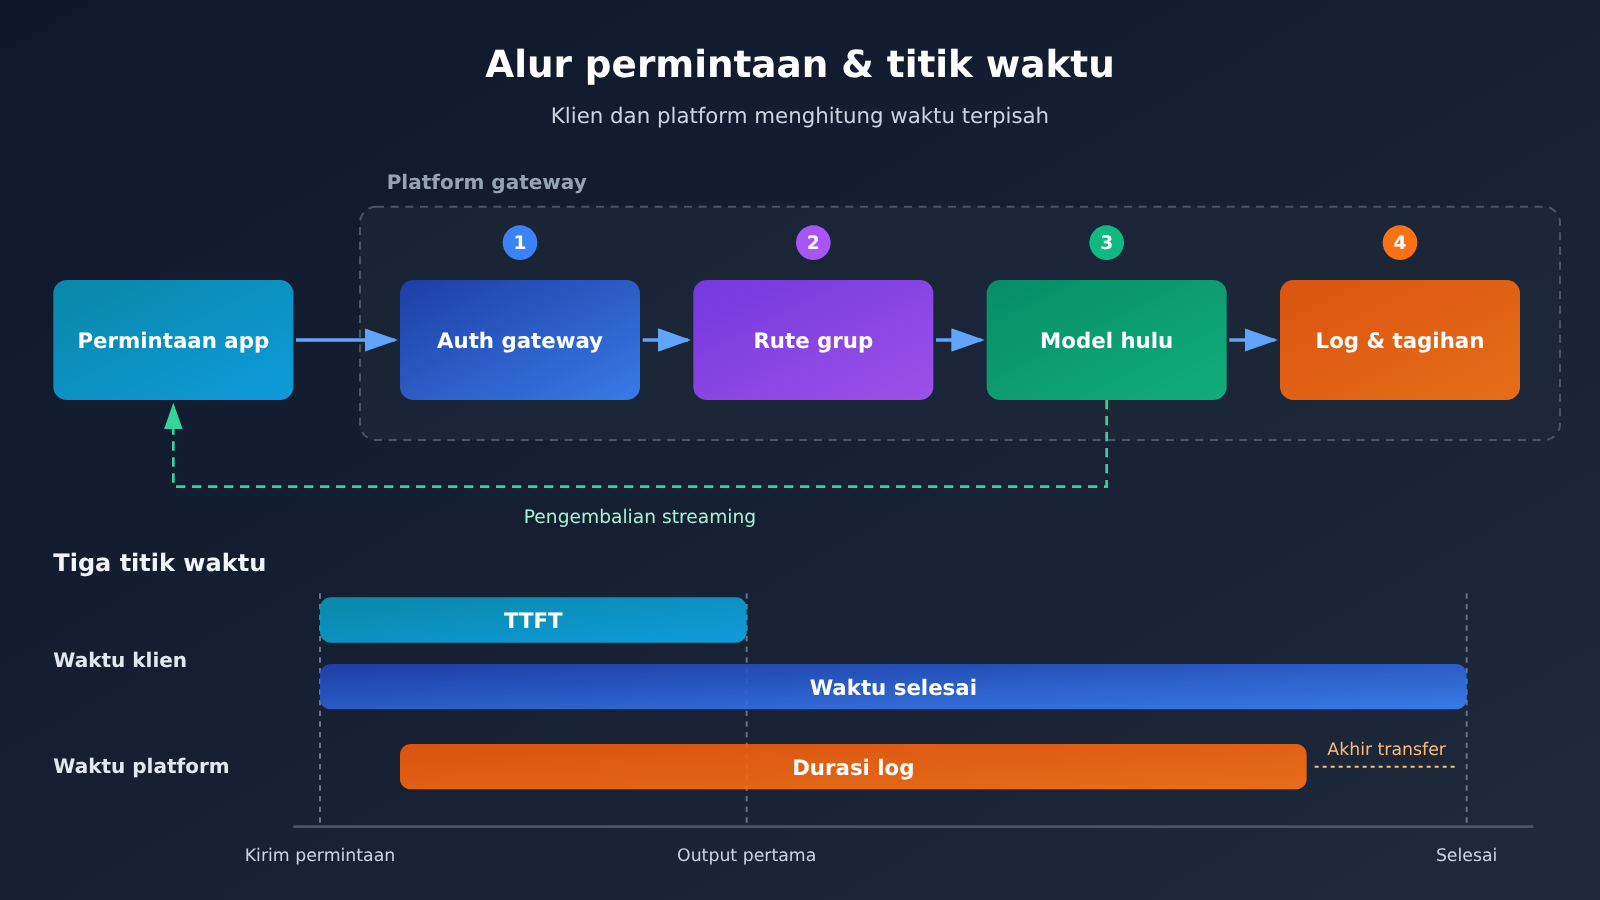
- Gateway API: pintu masuk yang menerima permintaan aplikasi lalu meneruskannya ke layanan model upstream. Biasanya ia sekaligus menangani empat hal — autentikasi, penagihan, routing, dan log — sehingga satu pemanggilan yang gagal bisa terjadi di lapisan mana pun dalam rantai tersebut, dan pembagian tanggung jawabnya harus dipastikan lebih dulu.
- TTFT (waktu output valid pertama): waktu dari permintaan dikirim sampai token output valid pertama tiba. Dalam interaksi streaming, inilah nilai yang dirasakan pengguna, bukan total durasi seluruh balasan.
- p95: nilai metrik yang tidak dilampaui oleh sekitar 95% sampel. Rata-rata menyembunyikan permintaan yang lambat; hanya p95 yang bisa menyingkap sekelompok kecil pemanggilan yang “kadang macet belasan detik”.
- RPM dan konkurensi: RPM adalah jumlah permintaan yang dikirim per menit, konkurensi adalah jumlah permintaan yang masih dieksekusi pada saat yang sama. Semakin lama sebuah permintaan dieksekusi, RPM rendah pun bisa menumpuk konkurensi in-flight yang tinggi — jadi keduanya harus dicatat secara terpisah.
- Fallback (cadangan): mekanisme untuk mencoba jalur atau model alternatif ketika layanan utama tidak dapat memenuhi permintaan. Saat penerimaan, yang perlu diperiksa sekaligus adalah model akhir yang dipakai, fitur inti, batas biaya, dan kebijakan data — bukan hanya apakah permintaannya berhasil atau tidak.
- SLA: service level agreement, yang menetapkan definisi metrik, cakupan statistik, tanggung jawab atas gangguan, dan syarat kompensasi. Ini adalah kesepakatan yang bisa dieksekusi, bukan sekadar persentase yang bisa dikutip sendirian.
Informasi Utama: Keandalan Gateway Perlu Diurai ke dalam 5 Aspek Pemeriksaan
Nilai dari layanan proksi API dan gateway untuk Model Bahasa Besar ada pada antarmuka yang seragam. Tapi justru kemudahan itu bisa menutupi perbedaan di lapisan bawah. Di balik satu base_url yang kompatibel dengan OpenAI, bisa saja ada pemasok upstream yang sama sekali berbeda, kebijakan pembatasan laju yang berbeda, aturan retensi log yang berbeda, dan prosedur penanganan gangguan yang berbeda pula.
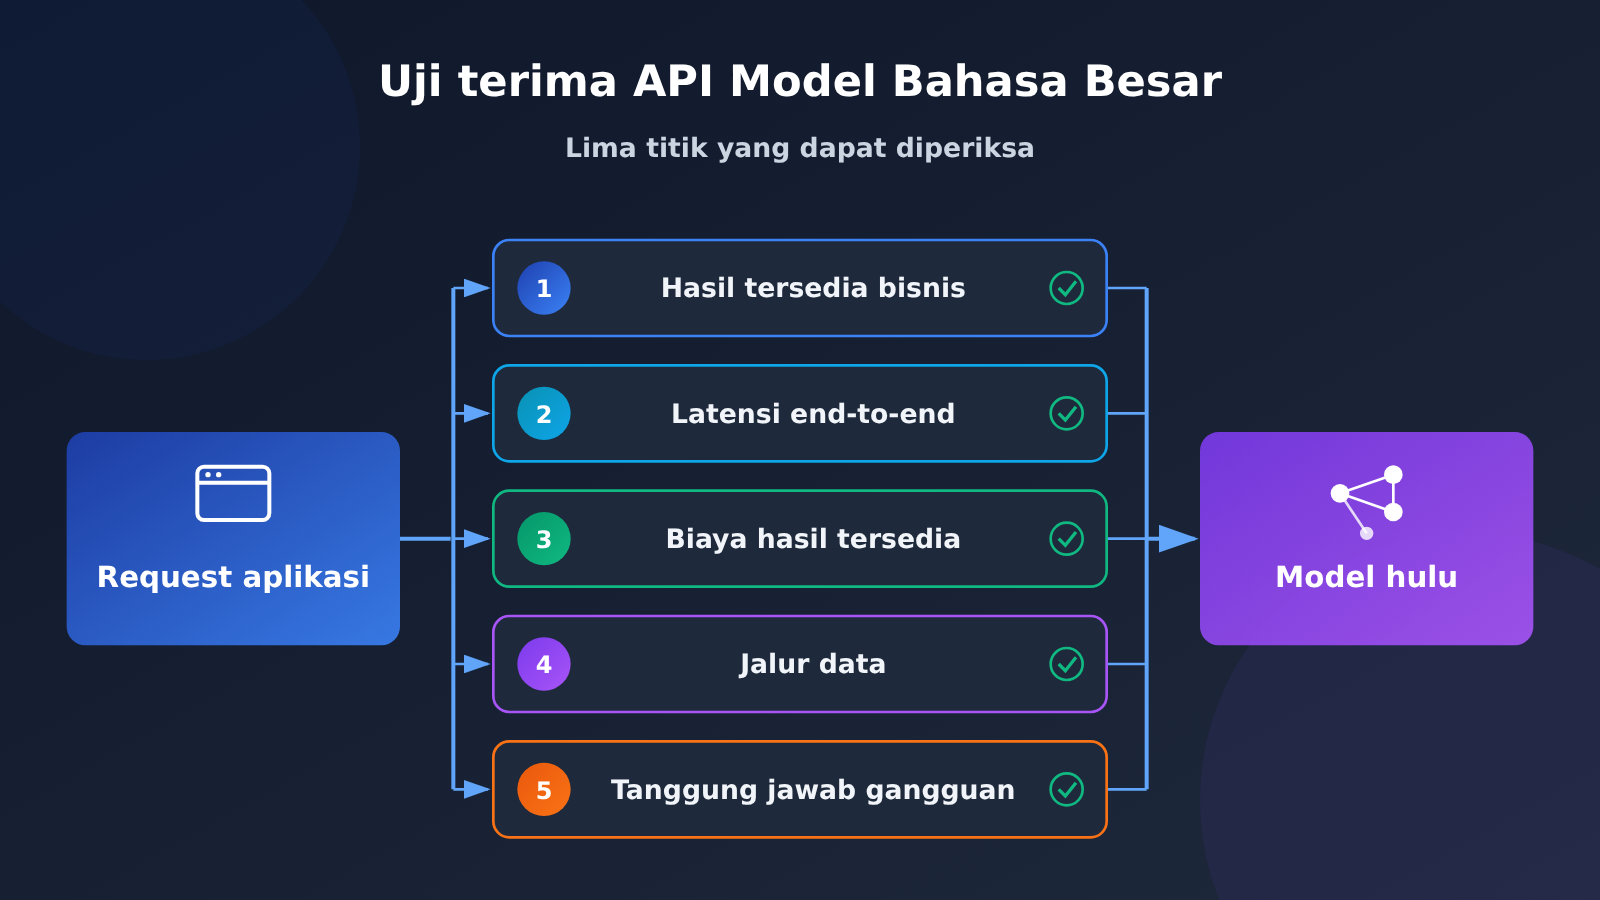
Karena itu, keputusan untuk go-live tidak boleh berhenti di pertanyaan “bisa dipanggil atau tidak”. Ada tiga hal yang perlu diamati sekaligus: apakah hasilnya bisa dipakai, apakah waktu tunggunya bisa diterima, dan apakah anomali bisa ditelusuri. Tabel di bawah menjabarkan ketiga hal itu menjadi 5 aspek pemeriksaan, sekaligus menjadi kerangka lima bagian berikutnya dalam artikel ini.
| Aspek pemeriksaan | Pertanyaan yang harus dijawab | Dasar penilaian | Salah tafsir yang umum |
|---|---|---|---|
| Hasil yang dapat dipakai bisnis | Apakah konten yang dikembalikan bisa langsung masuk ke alur bisnis | Jumlah respons lengkap, jumlah yang formatnya valid, jumlah yang lolos penilaian bisnis | Menganggap HTTP 200 sebagai sukses |
| Latensi ujung ke ujung | Berapa lama pengguna menunggu sebelum melihat keluaran valid pertama | p50 dan p95 dari TTFT dan waktu selesai, dengan pencatatan waktu terpisah di sisi klien dan platform | Hanya melihat rata-rata durasi |
| Biaya per hasil yang dapat dipakai | Berapa biaya riil untuk setiap hasil yang benar-benar bisa dipakai | Total seluruh pengeluaran yang sudah ditagih dibagi jumlah hasil yang dapat dipakai bisnis | Hanya membandingkan harga satuan, tanpa memperhitungkan retry dan fallback |
| Jalur data | Siapa saja yang dilalui input dan output, berapa lama disimpan, siapa yang bisa melihat | Kebijakan berlapis untuk gateway, upstream, log, dan artefak asinkron | Menganggap enkripsi transmisi berarti konten tidak bisa dibaca |
| Tanggung jawab saat gangguan | Setelah insiden, standar apa yang dipakai untuk menetapkan kesalahan dan bagaimana kompensasinya | Periode statistik SLA, pengecualian, proses pengajuan, dan bentuk kompensasi | Menganggap penjelasan publik sebagai komitmen kontrak |
🎯 Saran teknis: Salin tabel ini menjadi tabel akseptansi tim Anda sendiri, dan setiap barisnya wajib diisi dengan sumber bukti. Kalau Anda perlu menjalankan alur pemanggilan lebih dulu, Anda bisa mendapatkan kuota uji lewat APIYI (apiyi.com), lalu memakai satu skrip yang sama untuk mencatat dan membandingkan beberapa model secara berdampingan.
Mengapa Keandalan Harus Didefinisikan sebagai Syarat Penerimaan Bisnis
Antarmuka terpadu memang menurunkan biaya integrasi, tetapi sekaligus melemparkan sejumlah keputusan yang tadinya urusan infrastruktur ke tim aplikasi. Dulu Anda harus memelihara logika retry dan beberapa SDK sendiri. Sekarang cukup mengganti satu base_url untuk memanggil banyak model. Imbalannya, visibilitas Anda terhadap jalur request jadi berkurang.
Karena itu, langkah pertama dalam pengujian penerimaan bukanlah mengukur performa, melainkan mendefinisikan dengan jelas apa arti “tersedia”. Untuk satu request yang sama, ada tiga hal yang berbeda: platform mencatat penagihan berhasil, klien menerima status 200, dan sisi bisnis berhasil mem-parse hasilnya. Ketiganya harus dihitung sendiri-sendiri. JSON dengan struktur tidak valid tetap tidak menghasilkan apa-apa bagi bisnis, meskipun platform menyelesaikan request-nya dengan normal, dan biayanya tetap muncul.
Langkah kedua adalah memecah set pengujian berdasarkan bentuk bisnisnya. Untuk tanya jawab interaktif, yang dilihat adalah waktu sampai keluaran valid pertama dan batas waktu sampai balasan lengkap. Untuk pemanggilan tool, yang dilihat adalah apakah struktur parameternya valid dan field-nya lengkap. Untuk batch processing, yang dilihat adalah berapa banyak hasil yang bisa dipakai sebelum tenggat pengiriman. Kalau ketiganya dicampur menjadi satu angka “rata-rata waktu”, kesimpulannya pasti menyesatkan.
Langkah ketiga adalah menyamakan cara pengukuran waktu. Waktu tunggu di klien dan durasi yang dicatat di log platform mencakup tahapan yang berbeda. Dokumentasi resmi pun sudah menyebutkan kasus ketika platform mencatat request berhasil dan menagihkannya, tetapi klien mengalami timeout karena transmisi respons atau penutupan koneksi. Selain itu, ketika sistem di belakang layar otomatis mencoba jalur lain, total waktu tunggu juga ikut memanjang. Jadi, setiap kali terjadi anomali, cocokkan dulu tiga hal dengan nomor bisnis dan request_id, yaitu catatan klien, log platform, dan perubahan saldo. Baru setelah itu putuskan perlu retry atau tidak.
Cara menguji kemampuan gateway dan beban puncak dengan tugas tetap
Agar pengujian bisa direproduksi, variabelnya harus dipatok lebih dulu: versi model target, kanal atau grup, antarmuka pemanggilan, parameter inti, titik masuk jaringan, skala input-output, dan apakah memakai streaming. Begitu salah satunya berubah, data sebelum dan sesudahnya tidak lagi bisa dibandingkan dalam satu tabel. Sampelnya juga harus berasal dari data bisnis nyata yang sudah dianonimkan, bukan input mainan semacam “halo”.
Tabel berikut adalah template catatan acceptance yang bisa langsung dipakai; isinya saran metodologi dan tidak memuat kesimpulan pengukuran platform mana pun. Ambang batasnya Anda tentukan sendiri sesuai kebutuhan bisnis — misalnya tugas interaktif menuntut output valid pertama muncul dalam sekian detik, sementara tugas offline menuntut sejumlah hasil terpakai terkirim dalam beberapa jam.
| Dimensi | Catatan yang disarankan | Cara menilai |
|---|---|---|
| Keberhasilan pengiriman bisnis | Total permintaan, jumlah respons lengkap, jumlah format yang bisa dipakai, jumlah yang lolos penilaian bisnis | Tulis penyebutnya secara lengkap, lalu lihat proporsi hasil yang benar-benar terpakai bisnis |
| Latensi | Waktu mulai, waktu output valid pertama, waktu selesai, durasi di log platform | Catat waktu di sisi klien dan sisi platform secara terpisah, lalu hitung p50 dan p95 |
| Kemampuan inti | Penutupan streaming, legalitas parameter tool, parsing output terstruktur, penanganan input panjang | Luluskan satu per satu sesuai kemampuan yang benar-benar diandalkan produk ini |
| Beban puncak | Jumlah permintaan in-flight bersamaan, permintaan per menit, proporsi 429, antrean dan retry | Jaga skala permintaan tetap sama, naikkan beban bertahap dan sisakan jendela observasi |
| Biaya | Pemotongan biaya per panggilan, refund, biaya fallback, jumlah hasil yang terpakai bisnis | Hitung total biaya yang ditanggung tiap hasil terpakai |
| Kemampuan penelusuran | Nomor bisnis, request_id, model dan grup, kode error, jawaban tiket | Mampu memetakan pesanan yang anomali kembali ke catatan platform |
Skrip di bawah ini hanya melakukan satu hal: mencatat waktu output valid pertama sekaligus total durasi pada panggilan streaming, supaya Anda bisa menaruh pengukuran waktu dari klien dan log platform pada satu garis waktu yang sama untuk dibandingkan.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Lihat kode uji beban batch dan statistik persentil
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
Kesalahan paling umum saat uji beban adalah menyamakan RPM dengan konkurensi. Jumlah permintaan per menit, jumlah token per menit, dan jumlah permintaan yang sedang berjalan bersamaan adalah tiga batasan yang berbeda, dan satu sama lain tidak bisa saling menggantikan. Setelah latensi naik, retry juga akan memperbesar tekanan pada sistem. Karena itu skrip uji harus punya antrean lokal, batas waktu tunggu maksimum, dan retry dengan backoff yang ada batas atasnya.
Ada satu detail lagi yang gampang terlewat: halaman “Konkurensi” dan halaman “Token dan Grup” di dokumentasi APIYI tidak sepenuhnya sama dalam menjelaskan cakupan pembatasan laju. Halaman pertama menyebut kuota beberapa token bersifat independen, sedangkan halaman kedua menyatakan pembatasan laju mengikuti akun. Cara verifikasi yang benar adalah mengukur sendiri kuota aktual pada akun dan saluran yang Anda tuju, dengan mencatat konkurensi dan RPM secara terpisah. Jangan memakai angka tetap dari tangkapan layar orang lain, dan jangan mencoba menyiasati batas dengan membuat banyak Key.
Cara memeriksa biaya per hasil yang layak pakai dan perilaku fallback
Yang lebih layak dibandingkan daripada harga satuan adalah “biaya aktual per hasil yang layak pakai secara bisnis”. Rumusnya sederhana: pembilang diisi seluruh pengeluaran yang sudah diselesaikan (termasuk retry dan fallback), penyebut diisi jumlah hasil yang layak pakai secara bisnis, dan refund yang sudah dikonfirmasi dikurangkan dari pembilang.
Berikut contoh hitungan yang murni hipotetis, hanya untuk menunjukkan cara menghitung, dan tidak mewakili harga penyedia mana pun.
| Skema | Pengeluaran bersih yang sudah diselesaikan | Hasil layak pakai | Biaya per hasil layak pakai |
|---|---|---|---|
| Skema A | 3,0 dolar AS | 90 | sekitar 0,0333 dolar AS |
| Skema B | 3,2 dolar AS | 98 | sekitar 0,0327 dolar AS |
Kalau hanya melihat pengeluaran, Skema A lebih murah. Tetapi dihitung per hasil yang layak pakai, Skema B justru lebih hemat. Karena itulah pertanyaan “siapa yang lebih murah” tidak ada artinya tanpa penyebut bisnis. Ada dua hal lain yang perlu diperhatikan. Pertama, kuota yang sudah ditahan di muka untuk tugas asinkron tetapi belum diselesaikan harus dicantumkan terpisah. Kedua, kalau hanya menjumlahkan catatan konsumsi, pengeluaran bersih bisa terlihat lebih tinggi dari sebenarnya, karena refund tugas asinkron muncul sebagai angka negatif di tagihan.
Fallback perlu dipisahkan menjadi dua jenis perubahan yang sama sekali berbeda. Pergantian saluran berarti pindah ke jalur lain untuk model yang sama, sehingga secara teori kemampuan dan harga model tidak berubah. Pergantian model berarti mencoba model lain dari sebuah daftar ketika model utama tidak tersedia. Ini mekanisme yang umum di industri. Misalnya, model fallbacks di OpenRouter secara jelas menyatakan bahwa penagihan mengikuti harga model yang benar-benar dipakai, dan model akhirnya dicantumkan di field model pada respons. Contoh ini hanya untuk menjelaskan mekanismenya, dan arti field tersebut tidak bisa dipindahkan begitu saja ke platform lain.
Jadi item verifikasi setidaknya mencakup empat hal: model apa yang akhirnya dipakai setelah fallback, apakah fungsi inti masih berjalan, apakah biaya per permintaan punya batas atas, dan berapa waktu tunggu terlama. Kalau ada jenis bisnis yang tidak boleh berganti model, Anda juga perlu memastikan fallback bisa dimatikan. Skenario streaming harus diuji tersendiri: ketika kegagalan terjadi setelah sebagian output sudah dikirim, apakah kelanjutannya bisa tersambung mulus. Hal ini tidak bisa disimpulkan dari fallback yang berhasil pada mode non-streaming.
💡 Saran memilih: Bandingkan harga langsung dan jalur fallback dalam satu tabel yang sama, baru terlihat biaya yang sebenarnya. Kalau ingin cepat mendapatkan catatan penagihan nyata dari beberapa model untuk dibandingkan, jalankan sampel kecil lewat APIYI (apiyi.com), lalu hitung ulang di tabel verifikasi Anda sendiri.
Bagaimana memverifikasi jalur data dan tanggung jawab kegagalan
Dua hal ini paling sering dilewati dengan kalimat seperti “kami sangat aman” atau “kami sangat stabil”, padahal justru inilah satu-satunya yang bisa menyelamatkan Anda setelah masalah terjadi. Cara verifikasinya adalah menempatkan gateway, penyedia model upstream, log troubleshooting terperinci, dan artefak asinkron pada satu jalur data yang sama, lalu menanyakan kebijakannya lapis demi lapis.
| Tahap jalur | Kebijakan yang perlu diperiksa | Cara pemeriksaan |
|---|---|---|
| Gateway itu sendiri | Apakah input dan output disimpan secara default, siapa yang boleh mengaktifkan log troubleshooting, berapa lama disimpan | Baca dokumentasi resmi tentang keamanan data dan log |
| Penyedia model upstream | Penggunaan untuk pelatihan, masa retensi, apakah perlu otorisasi aktif | Baca kebijakan tiap upstream secara berlapis, jangan digabung menjadi satu |
| Log troubleshooting terperinci | Cakupan pencatatan, pihak yang bisa melihat, periode retensi default, kapan catatan dihapus setelah fitur dimatikan | Pastikan mematikan sakelar tidak sama dengan penghapusan langsung catatan yang sudah ada |
| Artefak tugas asinkron | Lokasi penyimpanan artefak, masa berlaku tautan unduhan | Simpan segera di sisi bisnis, jangan bergantung pada tautan sementara |
Menurut dokumentasi publik, kebijakan umum APIYI adalah tidak menyimpan input dan output pelanggan secara default; log troubleshooting terperinci dapat diaktifkan sementara oleh administrator untuk merekam input, konteks, dan output secara lengkap, isinya hanya terlihat oleh administrator, dan periode retensi default yang tercantum di halaman tersebut adalah 7–30 hari. Halaman yang sama juga menjelaskan bahwa tindakan mematikan sakelar pencatatan tidak bisa ditafsirkan sebagai catatan yang sudah ada telah langsung dihapus. Pernyataan semacam ini harus tetap disertai atribusi “sebagaimana dijelaskan dokumentasi resmi” — itu bukan sertifikasi kepatuhan, dan bukan pula kesimpulan hukum.
Ada satu fakta operasional lain yang sering terlewat: log itu sendiri punya siklus hidup. Penjelasan khusus tentang retensi log di APIYI menyebutkan bahwa log pemanggilan disimpan bergulir untuk sekitar dua bulan terakhir, dengan penghapusan record yang lebih lama dari dua bulan dilakukan pada tanggal 5, 15, dan 25 setiap bulan; pembersihan ini tidak dapat dipulihkan, sehingga rincian yang dibutuhkan untuk rekonsiliasi dan audit jangka panjang harus Anda ekspor dan simpan sendiri. Masa penyimpanan hasil sinkron dan artefak asinkron juga berbeda; halaman tersebut menyebutkan tautan unduhan artefak berlaku sekitar satu hari. Jika Anda baru melakukan telaah ulang setelah jendela waktu ini lewat, bukti di tangan Anda sudah tidak ada.
Tanggung jawab kegagalan harus berpijak pada klausul yang bisa dieksekusi. Halaman khusus SLA di APIYI menjelaskan pemberian kembali kredit layanan ketika terjadi kerugian akibat masalah di pihak platform, serta kemungkinan perusahaan mengatur dalam kontrak cakupan jaminan, indikator ketersediaan, waktu respons, dan batas atas kompensasi; halaman itu tidak memberikan satu angka ketersediaan tetap yang seragam untuk semua pelanggan. Saat membandingkan vendor, catatlah periode statistik indikator, definisi penyebut, pengecualian gangguan, alur pengajuan, dan bentuk kompensasinya, serta bedakan dengan jelas antara kompensasi kredit layanan dan ganti rugi tunai dalam hal nilai pengadaan.
Putuskan Cakupan Peluncuran dengan Satu Tabel Akseptansi
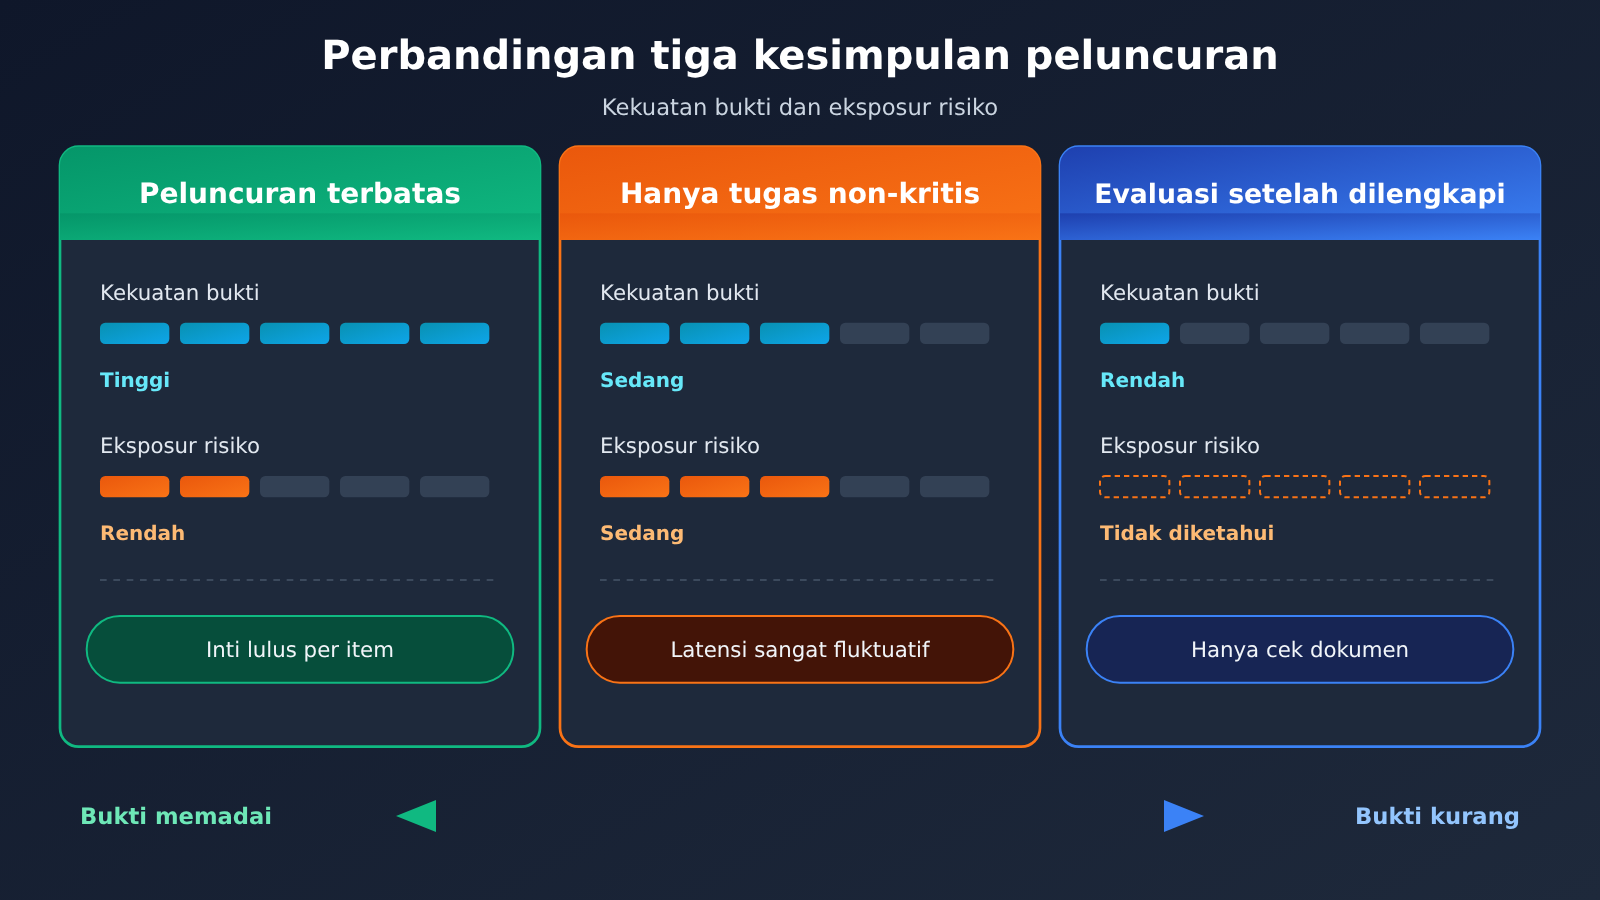
Saat merangkum semua catatan menjadi kesimpulan, jangan membuat “peringkat keandalan”. Yang dibutuhkan adalah penilaian cakupan. Satu penyedia yang sama bisa jadi hanya cukup untuk “tugas non-kritis” pada bisnis interaktif Anda, tetapi sepenuhnya memadai untuk pemrosesan batch offline.
| Kesimpulan | Bukti yang perlu ditunjukkan | Pemicu untuk beralih atau berhenti |
|---|---|---|
| Boleh diluncurkan dalam skala kecil | Kemampuan inti lolos satu per satu, p95 masih dalam batas bisnis, biaya per hasil yang dapat dipakai bisa diterima, jalur data dan SLA sudah diperiksa | Tingkat keberhasilan yang dapat dipakai secara bisnis turun di bawah ambang batas secara berturut-turut, atau anomali penagihan tidak bisa direkonsiliasi |
| Hanya untuk tugas non-kritis | Kemampuan lolos tetapi latensi berfluktuasi besar, atau mekanisme cadangan (fallback) mengubah model dan biaya | Jalur kritis dikembalikan ke layanan sendiri atau koneksi langsung, strategi fallback dimatikan secara eksplisit |
| Dievaluasi ulang setelah syarat dilengkapi | Baru sebatas pemeriksaan dokumen, belum ada uji nyata dengan akun Anda, atau klausul SLA belum masuk ke kontrak | Setelah data uji nyata dan klausul kontrak dilengkapi, buat kesimpulan ulang |
Kalau untuk sementara hanya bisa melakukan pemeriksaan dokumen, tulis kesimpulannya apa adanya: “kemampuan publik dan syarat pengadaan sudah diperiksa”, lalu sisakan akseptansi sesungguhnya untuk putaran berikutnya. Saat perlu memverifikasi perilaku penanganan gangguan, gunakan konfigurasi uji yang diizinkan penyedia atau lingkungan terisolasi, dan jangan sengaja mengganggu layanan produksi bersama. Kalau terjadi timeout dan hasilnya tidak jelas, periksa dulu status eksekusi dan penagihannya, supaya satu aksi bisnis yang sama tidak dijalankan dua kali.
🚀 Mulai cepat: Kalau tidak mau menyusun skrip uji dari nol, Anda bisa memakai kuota uji gratis dari APIYI (apiyi.com) untuk menjalankan kolom “kemampuan” dan “latensi” dari daftar 7 butir di atas. Setelah itu baru putuskan apakah perlu masuk ke tahap uji beban yang lebih berat.
FAQ — Pertanyaan yang Sering Diajukan
Q1: Sebenarnya apa itu proksi API Model Bahasa Besar dan gateway?
Itu adalah lapisan gerbang antara aplikasi dan layanan model di hulu: begitu permintaan diterima, lapisan ini menjalankan autentikasi, penagihan, perutean penerusan, dan pencatatan log. Istilah “proksi” sendiri menekankan bahwa lapisan tersebut menyatukan banyak penyedia model ke dalam satu antarmuka yang kompatibel. Jadi yang Anda dapatkan adalah kemudahan integrasi, sementara yang Anda bayar adalah berkurangnya visibilitas terhadap jalur di lapisan bawah.
Q2: Kalau soal keandalan, di mana bedanya koneksi langsung ke API resmi dibanding memakai gateway proksi?
Bedanya ada pada jumlah lapisan jalur dan batas tanggung jawab. Kalau koneksi langsung, Anda hanya perlu menilai satu pihak di hulu; kalau lewat gateway, gateway itu sendiri, saluran grup, dan penyedia di hulu bisa sama-sama menjadi titik kegagalan — tapi di sisi lain Anda juga mendapat satu lapisan cadangan dan kemungkinan log yang terpusat. Cara menilainya bukan membandingkan siapa yang lebih cepat, melainkan mengumpulkan bukti secara terpisah pada 5 lapisan yang dibahas di artikel ini.
Q3: Kenapa tidak boleh hanya melihat latensi rata-rata?
Karena nilai rata-rata menutupi sedikit permintaan yang sangat lambat, dan justru permintaan seperti itulah yang biasanya menjadi sumber keluhan pengguna. Untuk interaksi streaming, TTFT dan waktu penyelesaian penuh juga harus dihitung terpisah, disertai jumlah sampel, rentang waktu, serta keterangan apakah angka tersebut mencakup kegagalan, antrean, dan percobaan ulang. Tanpa itu, p95 pun tidak bisa dibandingkan secara adil.
Q4: Permintaan berhasil tapi isinya tidak bisa dipakai — apakah itu dihitung sebagai masalah platform?
Biasanya tidak, tetapi biayanya tetap harus dihitung. Platform akan menagih selama permintaan selesai secara normal; keluaran dengan struktur tidak valid adalah bagian yang perlu dicoba ulang di sisi bisnis, dan pengeluaran berulang itu semestinya masuk ke pembilang “biaya per hasil yang bisa dipakai”. Karena itu, di tabel penerimaan, keberhasilan eksekusi platform dan lolosnya penilaian bisnis wajib dipisahkan menjadi dua kolom.
Q5: Bagaimana cara cepat memverifikasi apakah sebuah gateway mampu menopang bisnis saya?
Gunakan sampel Anda sendiri yang sudah didesensitisasi, dengan model, saluran, parameter, dan skala input yang tetap, lalu jalankan satu putaran sampel kecil. Catat TTFT, p95, proporsi hasil yang layak dipakai secara bisnis, dan rincian pemotongan biaya. Anda bisa mengambil kuota uji lewat APIYI apiyi.com untuk menyelesaikan putaran ini, lalu mengisi datanya kembali ke tabel penerimaan — bukan menarik kesimpulan hanya dari satu tes konektivitas.
Q6: Apa saja keterbatasan yang sudah diketahui dari metode ini?
p95 dari sampel kecil sangat fluktuatif dan tidak bisa dijadikan janji layanan jangka panjang; perbedaan beban di hulu pada waktu yang berbeda juga memengaruhi kesimpulan, sehingga pengujian perlu diulang pada beberapa rentang waktu. Selain itu, semua dasar perhitungan di artikel ini hanyalah saran metodologis, tanpa data performa terukur maupun tagihan aktual dari platform mana pun. Keputusan akhir tetap harus memadukan ambang batas bisnis Anda sendiri dengan ketentuan kontrak.
Poin Penting Gateway Proksi API Model Bahasa Besar
- Keandalan harus didefinisikan menurut penerimaan bisnis: tagihan platform berhasil, klien menerima 200, dan parsing bisnis lolos — tiga hal yang perlu dihitung secara terpisah.
- Latensi harus dipisah menjadi dua titik waktu: TTFT menentukan pengalaman interaktif, waktu penyelesaian penuh menentukan kemampuan pengiriman; keduanya perlu dilihat pada p95.
- RPM dan konkurensi wajib dicatat terpisah: RPM rendah pun bisa menumpuk konkurensi in-flight yang tinggi, jadi acuan pembatasan laju mengikuti hasil pengukuran aktual pada akun target.
- Biaya dihitung per hasil yang terpakai: total pengeluaran yang sudah diselesaikan dibagi jumlah hasil bisnis yang valid — percobaan ulang dan fallback keduanya masuk ke pembilang.
- Fallback harus dibedakan antara perpindahan kanal dan perpindahan model: model akhir, fungsi inti, batas biaya, dan waktu tunggu maksimum diverifikasi satu per satu.
- Data dan tanggung jawab dilihat dari klausul yang bisa dijalankan: log punya jendela retensi, SLA harus punya acuan statistik, pengecualian, dan bentuk kompensasi.
- Jalur memulai: lebih dulu jalankan sampel kecil di APIYI apiyi.com untuk menguji dua kolom — kemampuan dan latensi — baru masuk ke uji beban dan pemeriksaan kontrak.
Ringkasan
Menilai apakah sebuah layanan proksi dan gateway API Model Bahasa Besar bisa diandalkan pada dasarnya adalah soal pembuktian, bukan soal kesan. Kalau Anda memecah “bisa dipakai atau tidak” menjadi lima lapis — hasil bisnis yang valid, latensi end-to-end, biaya per hasil valid, rantai data, dan tanggung jawab saat gangguan — lalu meninggalkan catatan yang bisa diperiksa di tiap lapis, sebagian besar kejutan bisa Anda ubah menjadi hal yang sudah diketahui sebelum go-live.
Saat implementasi, ingat tiga hal: kesimpulan hanya ditulis sebagai rentang, bukan peringkat; acuan pengukuran hanya yang Anda ukur sendiri, bukan yang ada di tangkapan layar orang lain; bukti hanya ditulis sejauh masih bisa diperiksa ulang, karena log akan kedaluwarsa. Dengan ketiganya, diskusi pemilihan vendor tidak lagi bergantung pada siapa yang paling lantang bersuara.
Disarankan menyelesaikan satu putaran penerimaan dengan sampel kecil lewat APIYI apiyi.com lebih dulu. Platform ini menyediakan antarmuka terpadu dan kuota uji gratis, sehingga beberapa model bisa dibandingkan dalam satu tabel yang sama.
Referensi
- Token dan Grup di APIYI: Penjelasan multi-Key, kuota, grup sumber daya, dan grup cadangan
- Tautan:
docs.apiyi.com/faq/token-and-groups -
Keterangan: Untuk memeriksa alokasi Key, grup sumber daya, serta mekanisme jalur utama dan cadangan
-
Kebijakan Retensi dan Pembersihan Log APIYI: Penjelasan penyimpanan bergulir dan ekspor log
- Tautan:
docs.apiyi.com/faq/log-retention-policy -
Keterangan: Untuk memastikan jangka waktu penyimpanan mandiri atas rincian yang dibutuhkan untuk rekonsiliasi dan audit
-
Penjelasan Log Terperinci APIYI: Cakupan pengaktifan dan masa simpan log untuk pemecahan masalah
- Tautan:
docs.apiyi.com/faq/user-logs-control -
Keterangan: Untuk memeriksa tingkatan log pada alur data
-
Penjelasan Keamanan Data APIYI: Penjelasan kebijakan default yang tidak menyimpan input dan output
- Tautan:
docs.apiyi.com/faq/data-security -
Keterangan: Dibaca berdampingan dengan kebijakan upstream sebagai pembanding antarlapisan
-
Jaminan SLA APIYI: Penggantian kuota dan cakupan yang disepakati dalam kontrak
- Tautan:
docs.apiyi.com/faq/sla-guarantee -
Keterangan: Untuk memahami bentuk kompensasi atas tanggung jawab gangguan beserta batasannya
-
Cara Membaca Nominal Tagihan di Log: Kolom tagihan dan acuan pengali
- Tautan:
docs.apiyi.com/faq/log-billing-explained -
Keterangan: Untuk menghitung biaya aktual setiap hasil yang berhasil digunakan
-
Log Selesai dan Biaya Terpotong, tetapi Klien Tidak Menerima Respons: Perbedaan antara timeout klien dan penagihan platform
- Tautan:
docs.apiyi.com/faq/log-duration-vs-client-wait -
Keterangan: Bacaan wajib untuk menelusuri pesanan yang bermasalah
-
Tautan:
openrouter.ai/docs/guides/routing/provider-selection -
Keterangan: Untuk memahami perbedaan antara pergantian jalur dan pergantian model
-
OpenRouter Model Fallbacks: Model cadangan dan acuan penagihan aktualnya
- Tautan:
openrouter.ai/docs/guides/routing/model-fallbacks - Keterangan: Menjelaskan praktik umum di industri soal model akhir dan pihak yang menanggung biaya
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com. Dokumentasi lainnya tersedia di pusat dokumentasi docs.apiyi.com


