
Catatan penulis: artikel ini mengulas mekanisme Claude Dreaming yang diungkap lewat blog teknik Anthropic. Isinya mencakup struktur memori 4 lapis, data eksperimen CL-Bench dan Wiki, contoh koreksi kesalahan, serta risiko teknisnya. Di bagian akhir, saya jelaskan bagaimana developer bisa meminjam ide “merapikan memori di antara sesi” untuk membangun sistem memori Agent sendiri.
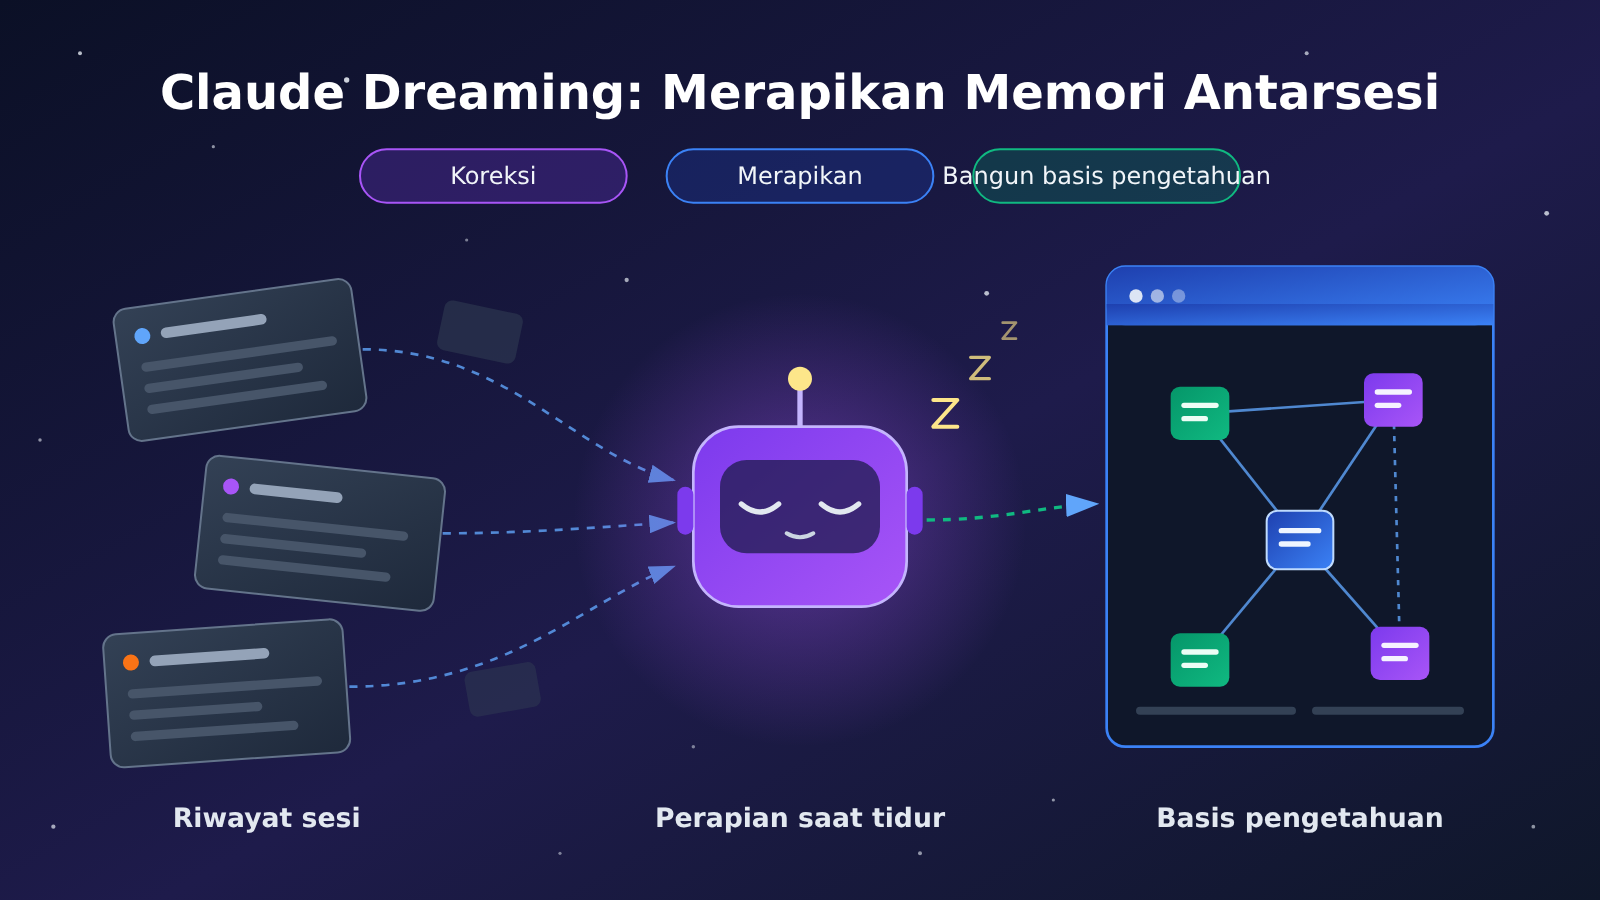
Pada 6 November 2026, Anthropic menerbitkan artikel The components of agent memory di blog teknik mereka. Untuk pertama kalinya, artikel ini menjelaskan secara sistematis bagaimana Claude Dreaming mengoreksi kesalahan, merapikan memori, dan membangun basis pengetahuan di antara sesi. Akun X resmi Anthropic ikut membagikan artikel tersebut, dan antarmuka research preview untuk Dreams juga sudah muncul di dokumentasi Claude Managed Agents.
Ini bukan sekadar konsep “tambahkan vector store ke Agent”. Lewat sejumlah eksperimen, Anthropic menunjukkan bahwa untuk Agent yang berjalan lama, menyimpan riwayat saja tidak cukup. Memori harus terus diverifikasi, dikoreksi, diintegrasikan, dan ditata, baru informasi lama benar-benar membantu tugas berikutnya.
Manfaat utama: setelah membaca artikel ini, kamu akan memahami struktur memori 4 lapis Claude Dreaming beserta data eksperimen pentingnya. Kamu juga akan tahu kapan pendekatan ini efektif, kapan justru merugikan, dan bagaimana cara meminjam idenya untuk Agent buatanmu sendiri.
Ringkasan Inti Claude Dreaming
| Item | Detail |
|---|---|
| Tanggal rilis | 2026-11-06, blog Anthropic Engineering |
| Konsep inti | Dreaming: proses latar belakang yang memanfaatkan riwayat untuk menata ulang dan memelihara memori di antara sesi |
| Lapisan memori | 4 lapisan: Transcripts, Memory notes, Memory representations, Injected context |
| Bentuk produk | Dreams di Claude Managed Agents, saat ini masih Research Preview dan aksesnya harus diajukan lebih dulu |
| Materi pendukung | Cookbook resmi “Dreaming with a dynamic workflow”, dirilis 2026-11-02 |
| Cakupan dampak | Agent yang berjalan lama, tugas lintas sesi, pembangunan basis pengetahuan internal perusahaan |
Sebelum membahas Dreaming, kita samakan dulu beberapa istilahnya. Transcript adalah catatan lengkap sebuah sesi, mencakup input pengguna, output Agent, pemanggilan tool, dan hasilnya. Memory Note adalah fakta, aturan, dan pengalaman permanen yang disarikan dari riwayat. Memory Store adalah ruang penyimpanan persisten untuk file memori lintas sesi. Dreaming mirip dengan Sleep-time Compute, yaitu memanfaatkan daya komputasi yang menganggur di luar interaksi utama untuk memproses konteks yang sudah ada.
Kenapa Memori Agent Tidak Cukup dengan Menyimpan Riwayat Percakapan
Banyak tim yang membangun memori Agent langsung berpikir untuk menyimpan semua percakapan, lalu mencarinya kembali saat dibutuhkan. Masalahnya, log riwayat, ringkasan sesi, dan pengetahuan yang bisa dicari adalah tiga hal yang berbeda. Log hanyalah tumpukan peristiwa mentah, ringkasan bisa membuang detail penting, dan hanya pengetahuan yang sudah diverifikasi dan ditata yang bisa membantu tugas berikutnya secara stabil.
Menyimpan seluruh percakapan begitu saja menimbulkan tiga risiko: informasi duplikat, status lama yang kedaluwarsa, dan kesalahan yang terus menumpuk. Satu catatan yang salah akan dibaca berulang kali oleh sesi-sesi berikutnya, sehingga kesalahan itu diperlakukan sebagai fakta dan terus dijalankan. Kesimpulan Anthropic cukup lugas: memori tidak selalu lebih baik kalau lebih banyak, tetapi perlu dipilih, diverifikasi, dan ditata.
Eksperimen Pokémon Red menunjukkan perbedaannya dengan jelas. Pada sekitar 10.000 langkah, Sonnet 3.7 membuat 413 file dan 225 folder, tetapi hanya mendapat 1 lencana. Fable 5 hanya membuat 9 file memori biasa, 2 folder, dan satu global.md, tetapi berhasil meraih 4 lencana.
Selisihnya ada pada “apa yang dicatat”. Sonnet 3.7 banyak menyimpan status game yang terus berubah, dan catatan itu cepat kedaluwarsa. Fable 5 lebih fokus pada strategi, aturan yang sudah terverifikasi, dan rencana aksi. Dari sini muncul satu prinsip desain: memori jangka panjang sebaiknya memprioritaskan pengetahuan yang sulit didapatkan lagi dari lingkungan saat ini, sedangkan status real-time yang bisa langsung dibaca setiap saat tidak perlu dicatat.
Empat Lapisan Sistem Memori Claude
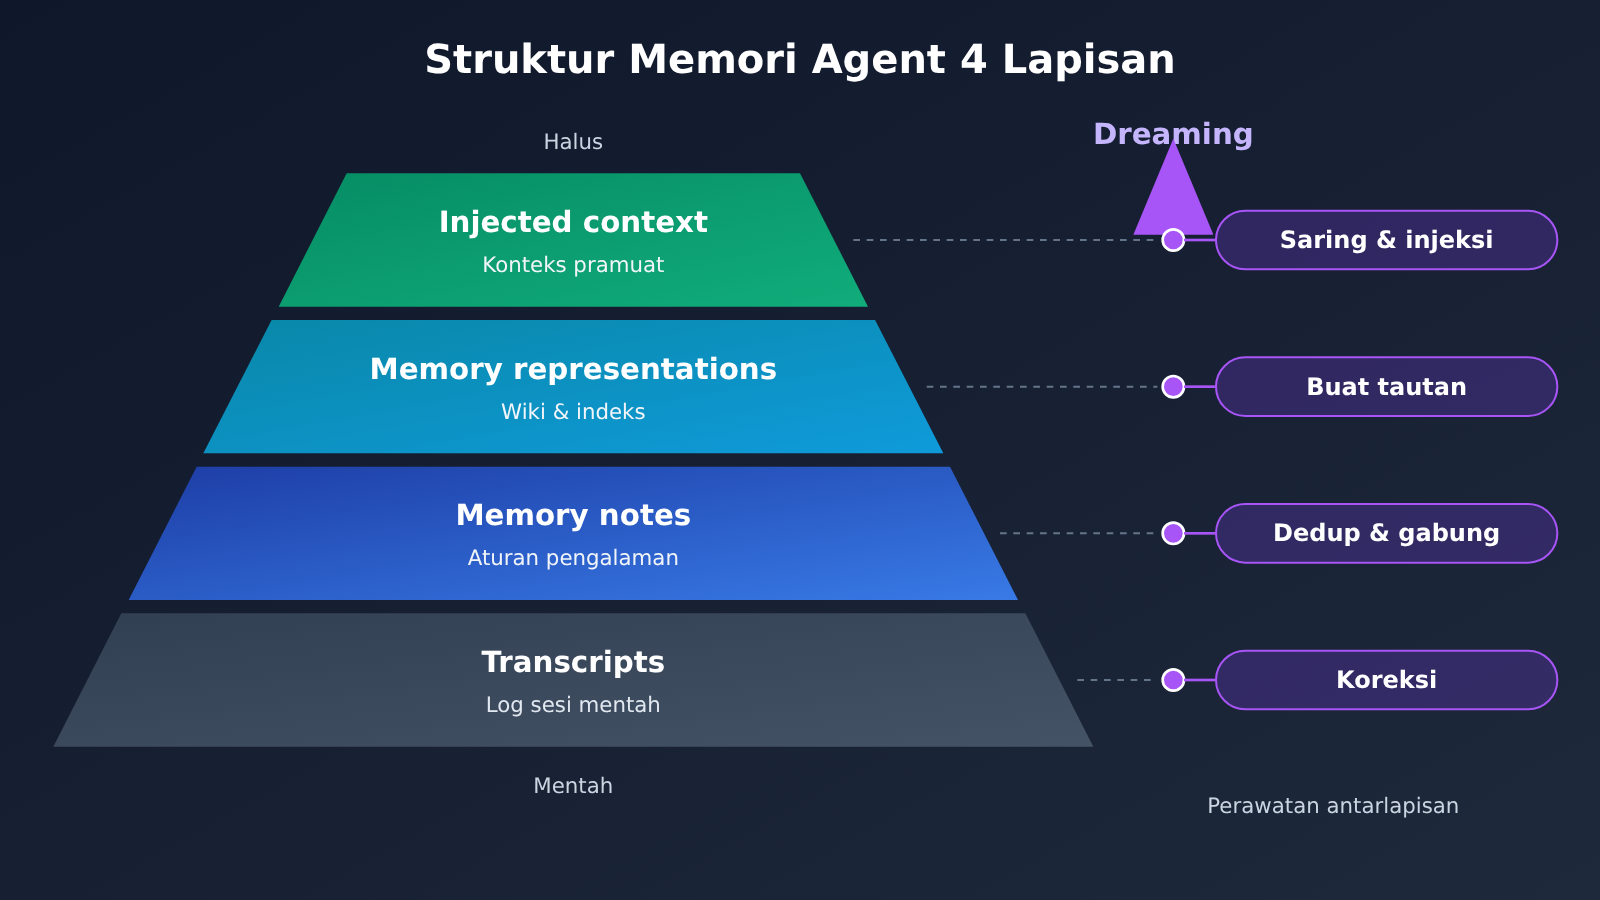
Anthropic membagi memori Agent menjadi 4 lapisan. Tiap lapisan punya tugas, frekuensi penulisan, dan biaya pembacaan yang berbeda.
| Lapisan | Isi | Fungsi | Cara Membaca |
|---|---|---|---|
| Transcripts | Catatan lengkap sesi | Log kejadian yang bisa dicari, menjadi bukti mentah untuk menelusuri fakta | Dicari sesuai kebutuhan |
| Memory notes | Fakta penting, pengalaman, dan aturan yang dicatat selama mengerjakan tugas | Mengendapkan pengalaman yang bisa dipakai ulang | Dibaca sesuai kebutuhan |
| Memory representations | Representasi terstruktur seperti Wiki, indeks, dan tautan | Mengatur hubungan antarpengetahuan dan mendukung pencarian lintas dokumen | Navigasi dan pencarian |
| Injected context | Sedikit memori bernilai tinggi | Dimuat lebih dulu saat sesi baru dimulai | Disuntikkan otomatis |
Keempat lapisan ini adalah proses bertahap dari “mentah” menuju “murni”. Transcript memuat informasi paling lengkap, tetapi ukurannya besar dan banyak noise. Injected context paling ringkas, tetapi setiap entrinya memakan jendela konteks sesi baru, sehingga ruangnya hanya diberikan untuk informasi dengan tingkat salience (Salience) tertinggi.
Posisi Dreaming adalah pemeliharaan lintas lapisan. Ia kembali ke Transcript untuk mengoreksi catatan lama, menggabungkan informasi duplikat di Memory notes, membangun Wiki dan indeks, lalu menentukan konten mana yang layak disuntikkan lebih dulu di awal sesi baru (Context Injection).
Bagaimana Claude Dreaming Mengoreksi Kesalahan, Merapikan, dan Membangun Basis Pengetahuan
Koreksi lewat Dreaming: Kasus Navigasi Mt. Moon
Anthropic pernah mencatat sebuah kesalahan navigasi. Agent salah mengingat posisi Pokémon Center di dekat Mt. Moon, sehingga di sesi-sesi berikutnya ia terus mencoba rute yang keliru berulang kali.
Setelah Dreaming memeriksa ulang Transcript riwayat, ia menemukan catatan salah yang pertama kali muncul, lalu memperbaiki file memori. Agent yang memakai memori hasil perbaikan itu tiba di Cerulean City pada operasi ke-1.935. Versi tanpa koreksi gagal berulang kali dan akhirnya tidak berhasil mencapai tujuan.
Kasus ini menunjukkan bahwa Dreaming tidak sekadar membuat ringkasan. Ia bisa kembali ke pengalaman aslinya dan memeriksa apakah sebuah memori masih benar. Transcript yang disimpan pun jadi punya fungsi baru: menjadi gudang bukti yang bisa dicek ulang kapan saja.
Efek Memori Claude: Data Eksperimen CL-Bench
Anthropic menguji efek memori dengan tugas basis data dari CL-Bench 1.0. Tabel berikut berisi mean reward yang dilaporkan secara resmi.
| Model | Tanpa memori | Dengan memori | Peningkatan |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Perlu diingat, data ini hanya berlaku untuk tugas tersebut dan bukan skor umum untuk kemampuan memori Agent. Yang lebih menarik adalah satu pola: semakin kuat modelnya, semakin ia cenderung mencatat aturan yang sudah terverifikasi, penyebab kesalahan, dan jebakan yang mungkin dihadapi nanti, alih-alih menyalin percakapan lama apa adanya. Peningkatan Sonnet 4.6 sangat terbatas, yang menunjukkan bahwa efektivitas sistem memori sangat bergantung pada “kualitas pencatatan” model itu sendiri.
Hasil Dreaming dalam Membangun Basis Pengetahuan Wiki
Eksperimen terbesar memakai sekitar 350.000 dokumen internal, dengan total sekitar 420M Token. Anthropic membangun Wiki pengetahuan secara bertahap lewat 128 sesi Dreaming, lalu mengevaluasi hasilnya dengan tugas tanya jawab.
| Metode pencarian | Skor | Catatan |
|---|---|---|
| Wiki saja (sebelum → sesudah dibangun) | 13% → 48% | Efeknya jelas terlihat setelah Wiki makin matang |
| Search saja | 53% | Baseline |
| Search + Wiki (sebelum → sesudah dibangun) | 54% → 61% | Rata-rata hemat sekitar 20.000 Token per pertanyaan |
| Tugas sintesis lintas file untuk merger dan akuisisi | Wiki 87% vs Search saja 73% | Keunggulan sintesis lintas dokumen paling terasa |
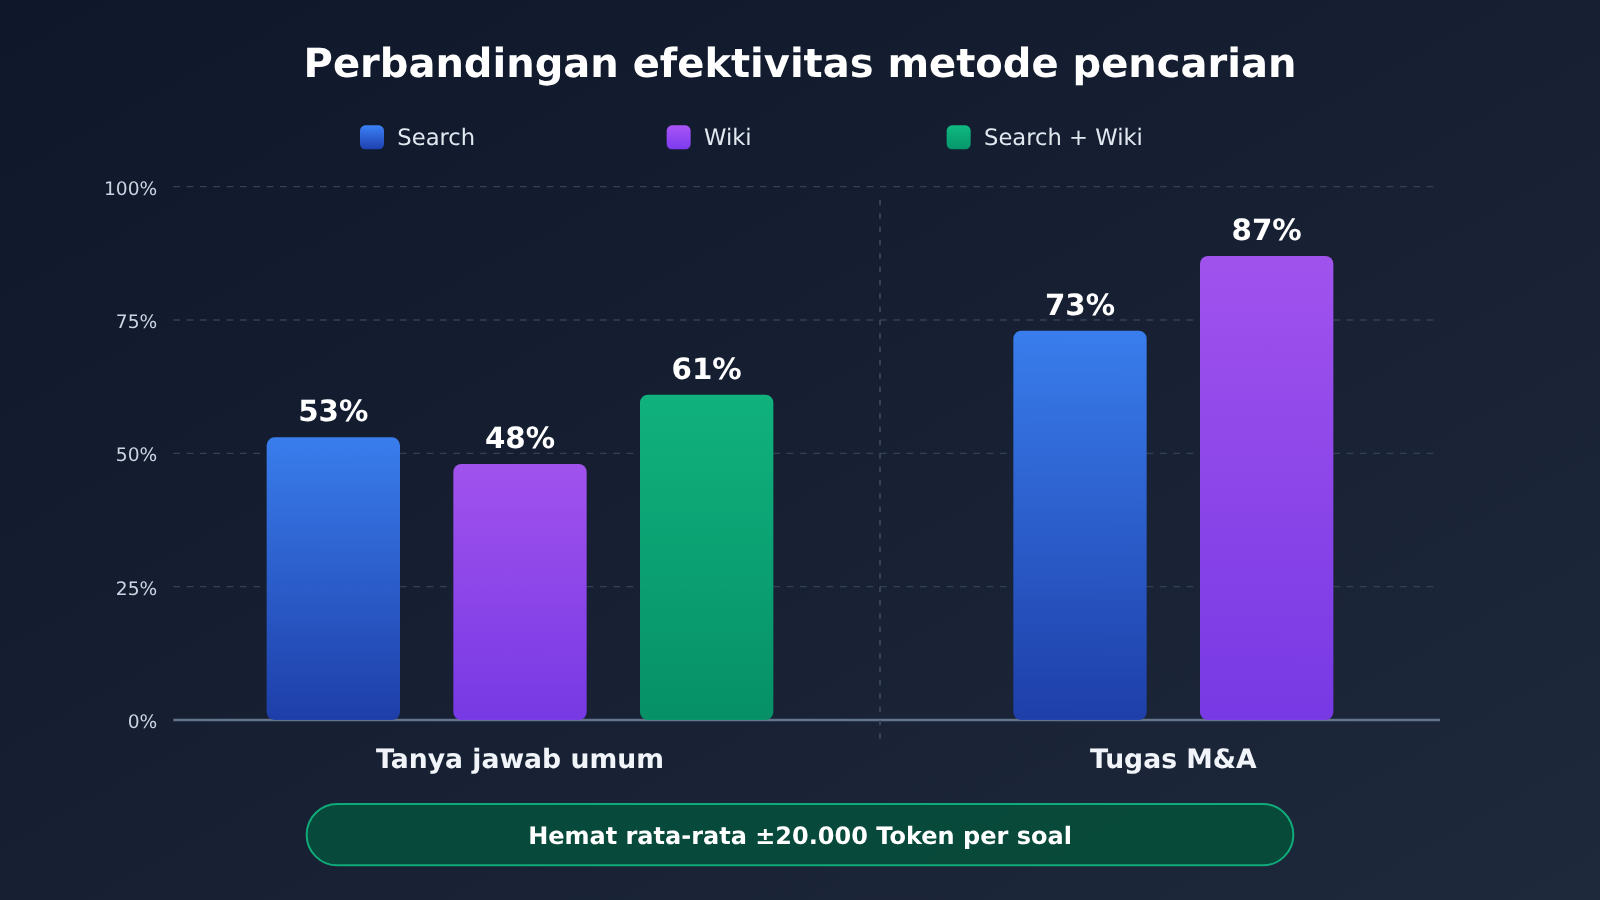
📊 Keterangan grafik: Semua data di atas berasal dari eksperimen yang dipublikasikan di blog teknik Anthropic. Kalau ingin mencoba validasi skala kecil pada korpus sendiri, kamu bisa memanggil model Claude lewat APIYI (apiyi.com), lalu membandingkan dua pendekatan: “pencarian murni” dan “pencarian + Wiki yang sudah dirapikan”, baik dari sisi hasil maupun konsumsi Token.
Nilai memori terstruktur terutama terlihat di dua hal. Pertama, tautan dan indeks memungkinkan informasi dari banyak file disintesis jadi satu. Kedua, jumlah teks asli yang perlu dibaca ulang di setiap pencarian berkurang, sehingga biaya Token ikut turun.
Analisis Dampak: Mengapa Perapian Memori Claude Dreaming Kadang Efektif dan Kadang Merugikan
Anthropic tidak menyebut Dreaming sebagai solusi serba bisa. Di artikelnya ada beberapa contoh kegagalan. Bagi praktik rekayasa, bagian ini mungkin lebih berguna daripada data positifnya.
5 Jenis Risiko Rekayasa dalam Perapian Memori
- Pencatatan berlebihan: Seperti Sonnet 3.7, model menyimpan banyak status yang mudah berubah. Akibatnya memori cepat membengkak dan cepat pula kedaluwarsa.
- Informasi kedaluwarsa: Lingkungan sudah berubah, tetapi memori masih tertinggal di versi lama. Tanpa pengecekan sumber, memori seperti ini akan terus menyesatkan Agent.
- Penimpaan akibat penulisan bersama: Dalam eksperimen perapian kontrak, beberapa Agent menulis ke satu tabel ringkasan yang sama. Dari 57 fakta kunci, hanya 41 yang tersisa, sekitar 72%. Setelah diubah menjadi satu halaman terpisah per kontrak, ditulis oleh satu Agent, dengan klausul aslinya tetap disimpan, seluruh 57 fakta berhasil dipertahankan.
- Ukuran Wiki membengkak: Pada satu pengujian, berkas aslinya hanya 115 KB, tetapi Wiki yang dihasilkan membengkak menjadi 203 KB. Perapian malah membuat informasinya bertambah banyak.
- Tidak ada manfaat pada tugas sederhana: Untuk pertanyaan yang jawabannya bisa langsung dicari dari satu berkas, Wiki tidak memberi peningkatan yang berarti dan hanya menambah biaya pemeliharaan.
Dampak bagi Developer
- Memori perlu dibuat berlapis: Log mentah, aturan pengalaman, pengetahuan terstruktur, dan konteks yang diinjeksi di awal sebaiknya disimpan terpisah, masing-masing dengan strategi tulis dan baca sendiri.
- Sumber harus bisa dilacak: Setiap memori harus bisa ditelusuri kembali ke Transcript asalnya. Ini syarat utama agar kesalahan bisa dikoreksi.
- Penulisan harus diserialisasi atau dipartisi: Hindari beberapa Agent menulis ke berkas yang sama secara bersamaan. Sebaiknya gunakan struktur “satu entitas, satu halaman”.
- Bersihkan secara berkala: Wiki dan Memory notes juga perlu dideduplikasi, digabung, dan dibuang bagian yang sudah tidak relevan. Kalau tidak, ukurannya hanya akan terus bertambah.
Dampak bagi Industri
- Fokus riset memori Agent mulai bergeser dari “pencarian yang akurat” ke pertanyaan apakah memori itu sendiri benar dan apakah sedang dirawat dengan baik.
- Sleep-time Compute berpeluang menjadi arsitektur standar. Biaya perapian dipindahkan ke waktu senggang sehingga beban konteks saat interaksi utama berkurang.
- Memori terstruktur lebih cocok untuk tugas yang melibatkan banyak berkas, banyak putaran, dan akumulasi jangka panjang. Untuk tanya jawab sekali pakai yang sederhana, pencarian biasa tetap pilihan yang lebih hemat.
Cara developer menerapkan konsep Claude Dreaming di Agent sendiri
Syarat penggunaan Dreams versi Research Preview
Berdasarkan dokumentasi Anthropic saat ini, Dreams adalah fitur dari Claude Managed Agents dengan status Research Preview, jadi Anda perlu mengajukan akses terlebih dahulu. Saat memanggilnya, Anda harus menyertakan dua Beta Header: managed-agents-2026-04-01 dan dreaming-2026-04-21.
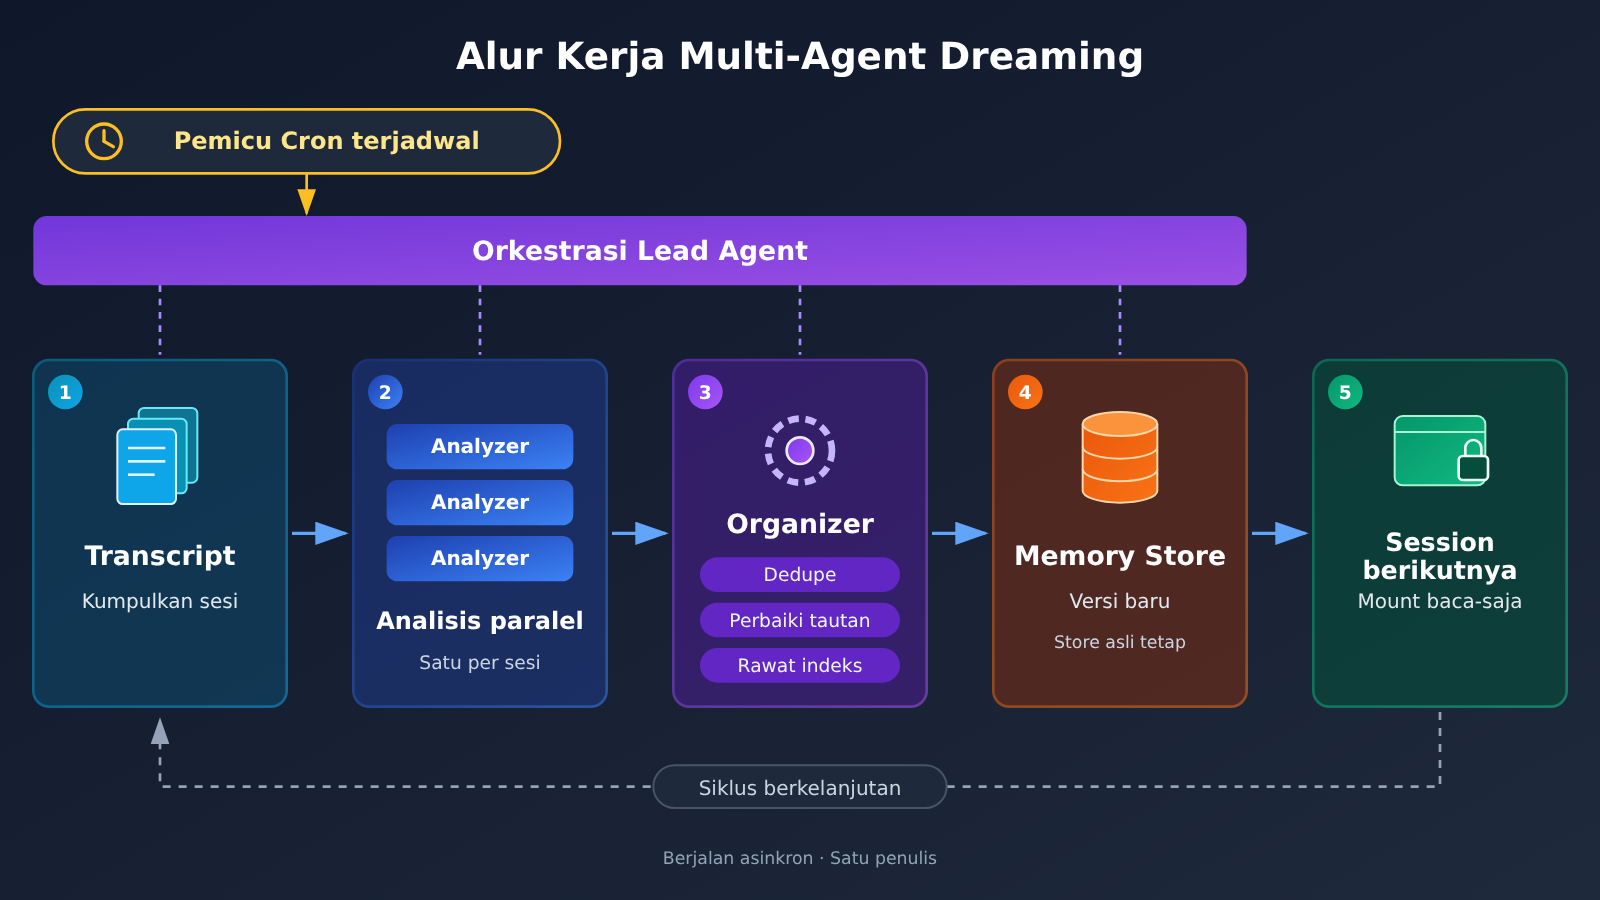
Inputnya berupa Memory Store yang sudah ada ditambah 1 sampai 100 Session historis. Outputnya adalah Memory Store baru, sedangkan Store aslinya tidak diubah. Tugasnya berjalan secara asinkron dan biasanya memakan waktu beberapa menit hingga beberapa jam. Biayanya dihitung berdasarkan harga Token standar dari model yang dipilih. Model yang didukung terutama Opus 5.5 dan Sonnet 5.5. Selain itu, fitur ini saat ini belum memenuhi syarat Zero Data Retention maupun HIPAA, jadi evaluasi dulu sebelum memproses data sensitif.
Desain Alur Kerja Dinamis di Cookbook
Cookbook resmi menyediakan alur kerja multi-Agent yang bisa Anda bangun sendiri. Secara default, Lead Agent yang mengatur alurnya, setiap Analyzer Agent menangani satu Transcript, dan Organizer Agent bertugas menghapus duplikat, memperbaiki tautan, serta memelihara indeks. Memory Store yang sudah dirapikan dipasang (mount) ke Session berikutnya, biasanya dalam mode hanya-baca. Prosesnya juga bisa dijadwalkan dengan Cron, misalnya merapikan Session satu hari terakhir setiap malam.
Cookbook juga memberikan contoh biayanya. Untuk 11 contoh Transcript dengan total 283 KB, proses berjalan sekitar 2,5 menit dengan biaya sekitar $0,36. Untuk 50 Transcript panjang dengan total sekitar 12 MB, biayanya kira-kira $8 dengan pengaturan optimasi biaya, dan waktunya sekitar 10 menit. Angka-angka ini hanyalah hasil dari eksperimen tertentu, bukan tarif tetap.
Membangun Alur Konsolidasi Memori Antar-Sesi dengan Model Claude
Perlu diluruskan dulu: APIYI menyediakan antarmuka pemanggilan model untuk seri Claude, bukan berarti menyediakan Managed Agents, Memory Stores, atau Dreams API. Meski begitu, ide inti Dreaming, yaitu “membaca Transcript di latar belakang, menyaring aturan yang sudah terverifikasi, lalu menyerahkannya ke satu penulis tunggal untuk dirapikan”, bisa kamu implementasikan sendiri dengan pemanggilan model biasa. Berikut contoh minimal untuk meminta Claude menganalisis satu catatan sesi dan menghasilkan kandidat memori.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # Ganti dengan model Claude yang tersedia di daftar model
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Lihat kode implementasi lengkap (Analyzer + Organizer penulis tunggal)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Satu topik satu halaman, ditulis berurutan oleh satu alur saja agar tidak saling menimpa
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Bisa dipicu Cron setiap malam; sesi berikutnya cukup memuat halaman indeks di memory_store secara read-only
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Saran untuk memulai: Saat membangun prototipe, kamu bisa memakai satu kunci API yang sama lewat APIYI (apiyi.com) untuk menguji berbagai model Claude sebagai Analyzer dan Organizer. Bandingkan kombinasi mana yang menghasilkan aturan paling akurat dengan konsumsi Token paling hemat, baru tentukan konfigurasi untuk produksi.
Perbedaan kedua jalur tersebut bisa diringkas dalam tabel berikut:
| Perbandingan | Anthropic Managed Agents Dreams | Membangun sendiri perapian memori berbasis API model |
|---|---|---|
| Cara akses | Pratinjau riset, perlu mengajukan akses dan memakai Beta Header | Langsung memanggil antarmuka model Claude |
| Penyimpanan memori | Memory Store resmi, menghasilkan Store baru | Implementasi sendiri: file, basis data, atau Wiki |
| Penjadwalan dan konkurensi | Tugas asinkron resmi | Implementasi sendiri: Cron, antrean, dan kontrol penulis tunggal |
| Koreksi dan izin akses | Sudah tersedia dalam alur resmi | Perlu merancang sendiri pengecekan sumber dan izin akses |
| Platform yang tersedia | Anthropic resmi | APIYI apiyi.com (pemanggilan model), API resmi |
FAQ Seputar Claude Dreaming
Q1: Apa itu Claude Dreaming?
Dreaming adalah proses pemeliharaan memori di latar belakang di antara sesi yang diperkenalkan oleh Anthropic. Proses ini memanfaatkan Transcript riwayat untuk mengoreksi catatan lama, menggabungkan informasi yang duplikat, membangun Wiki dan indeks, lalu menyaring konteks bernilai tinggi yang perlu disuntikkan lebih dulu ke sesi baru.
Q2: Apa bedanya Dreaming dengan ringkasan sesi biasa atau pencarian vektor?
Ringkasan hanya memadatkan informasi, sedangkan pencarian hanya bertugas menemukan informasi. Dreaming kembali ke Transcript asli untuk memverifikasi apakah sebuah memori masih benar. Contohnya pada kasus Mt. Moon, arah yang keliru berhasil dikoreksi. Dreaming juga membangun tautan antardokumen: pada tugas sintesis lintas file, Wiki mendapat skor 87%, sementara pencarian murni 73%.
Q3: Apakah Claude Dreaming sudah bisa dipakai sekarang?
Blog teknik terkait terbit pada 6 November 2026. Saat ini Dreams hadir sebagai Research Preview di Claude Managed Agents. Anda perlu mengajukan akses, dan pemanggilannya harus menyertakan dua Beta Header.
Q4: Kalau tidak punya akses ke Managed Agents, apakah masih bisa meniru ide Dreaming?
Bisa. Ikuti alurnya: “pengumpulan Transcript, analisis di latar belakang, perapian dengan penulis tunggal, mount hanya-baca, dan pemeliharaan berkala”. Dengan pemanggilan model biasa, Anda sudah bisa membuat versi sederhananya. Lewat APIYI apiyi.com, Anda bisa memanggil model Claude dengan antarmuka yang kompatibel dengan OpenAI untuk analisis dan perapian. Penyimpanan, penjadwalan, dan izin akses tetap perlu Anda implementasikan sendiri.
Q5: Apakah APIYI menyediakan fitur Claude Dreaming secara langsung?
Tidak. APIYI apiyi.com menyediakan antarmuka pemanggilan model seperti Claude, dan tidak mencakup Managed Agents, Memory Stores, maupun Dreams API milik Anthropic. Layanan ini cocok untuk memanggil model dan membangun alur perapian memori sendiri. Pengguna baru bisa memakai kuota uji coba gratis untuk memvalidasi rancangannya terlebih dulu.
Q6: Apa saja batasan Dreaming yang sudah diketahui?
Untuk pertanyaan sederhana yang bisa dijawab dari satu file, Wiki tidak memberi keuntungan yang berarti. Proses perapian juga bisa membuat ukuran data membengkak, misalnya teks asli 115 KB menghasilkan Wiki 203 KB. Penulisan bersama oleh banyak Agent bisa menyebabkan fakta hilang. Dreams resmi juga belum memenuhi syarat ZDR dan HIPAA, dan durasi tugasnya bervariasi dari beberapa menit hingga beberapa jam.
Poin Utama Claude Dreaming (Key Takeaways)
- Memori bukan sekadar penyimpanan: menyimpan seluruh percakapan akan menumpuk informasi yang duplikat, usang, bahkan keliru, sehingga perlu diverifikasi dan diorganisasi.
- Struktur memori 4 lapis: Transcripts, Memory notes, Memory representations, dan Injected context masing-masing punya peran sendiri.
- Koreksi bergantung pada catatan asli: Dreaming kembali memeriksa Transcript dan berhasil memperbaiki informasi arah yang salah, yang sebelumnya menyebabkan kegagalan berulang.
- Wiki unggul di tugas lintas dokumen: pada tugas merger dan akuisisi, Wiki meraih skor 87%, sedangkan pencarian murni hanya 73%, dengan penghematan sekitar 20 ribu Token per soal.
- Perapihan juga punya efek samping: penulisan bersamaan (konkuren) bisa menghilangkan fakta, Wiki bisa membengkak, dan untuk tugas sederhana fitur ini tidak diperlukan.
- Bisa dibangun sendiri: dengan memanggil model Claude lewat APIYI apiyi.com, kamu bisa membuat versi sederhana dari perapihan memori antarsesi.
Kesimpulan
Ada tiga hal utama yang bisa kita pelajari dari Claude Dreaming:
- Inti memori jangka panjang adalah perawatan: hanya memori yang sudah diverifikasi, dihilangkan duplikasinya, dan diorganisasi yang bisa membantu tugas berikutnya secara stabil.
- Apa yang dicatat lebih penting daripada seberapa banyak: utamakan mencatat aturan, penyebab kesalahan, dan jebakan yang sulit didapatkan kembali dari lingkungan, dan jangan mencatat status yang mudah berubah.
- Memori terstruktur harus disesuaikan dengan skenario: tugas lintas file, banyak putaran, dan akumulasi jangka panjang layak memakai Wiki, sedangkan tugas pencarian sederhana tidak perlu menanggung biaya perawatan tambahan.
Kalau Agent kamu sudah berjalan lintas banyak sesi, mulailah dari siklus minimal ini: “simpan Transcript, rapikan secara serial sekali tiap malam, dan pasang halaman indeks dalam mode hanya-baca”. Untuk memvalidasi alurnya dengan cepat, kamu bisa memanggil model Claude lewat APIYI apiyi.com. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI dan kuota uji coba gratis untuk pengguna baru.
📚 Referensi
- The components of agent memory: Artikel asli dari blog teknik Anthropic yang memperkenalkan struktur memori 4 lapisan dan eksperimen Dreaming
- Tautan:
anthropic.com/research/components-of-agent-memory -
Keterangan: Sumber asli data eksperimen seperti CL-Bench, Pokémon, Wiki, dan perapian kontrak
-
Dreaming with a dynamic workflow: Cookbook resmi Claude
- Tautan:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Keterangan: Contoh alur kerja multi-Agent Lead, Analyzer, dan Organizer, beserta acuan biayanya
-
Unggahan resmi Anthropic di X: Catatan rilis blog teknik Dreaming
- Tautan:
x.com/AnthropicAI/status/2118814753154064501 - Keterangan: Untuk memastikan waktu rilis dan posisi resmi fitur ini
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda resmi APIYI. Materi lengkap lainnya tersedia di pusat dokumentasi docs.apiyi.com


