
Bisa menghemat, tapi ada syaratnya. Menurut dua contoh hitungan hipotetis di dokumentasi resmi Google, pada skenario 200 alat dengan konteks dasar 2,000 Token, Token input Gemini Tool Retrieval turun dari 164,000 menjadi 23,650, sekitar 85.6% lebih sedikit. Pada skenario 10 alat dengan konteks dasar 30,000 Token, Token input naik dari 68,000 menjadi 92,830, sekitar 36.5% lebih banyak. Apakah ini masuk akal secara biaya? Jawabannya bergantung pada satu hal: apakah Schema alat lengkap yang dihemat cukup untuk menutup biaya konteks tambahan yang muncul dari pencarian di sisi server.
Apa saja yang akan Anda dapatkan dari artikel ini?
- Bagian Token mana yang dihemat Tool Retrieval, dan bagian Token mana yang baru ditambahkan.
- Prasyarat lengkap dan rincian per item dari contoh hitungan resmi 200 alat dan 10 alat.
- Rumus titik impas yang diturunkan dari parameter resmi, plus cara menilai “berapa jumlah alat minimal supaya layak diaktifkan”.
- Cara menghitung biaya sebenarnya satu tugas Agent memakai field
interaction.usagedan aturan cache.
Indeks: Mulai dari tabel konsep dan ringkasan dampak untuk menyeragamkan istilah dan membantu Anda menentukan termasuk pembaca jenis mana. Bagian “Fakta Objektif” membahas mekanisme yang diumumkan Google, aturan penagihan, dan dasar perhitungan asli dua contoh hitungan. Bagian “Analisis dan Penilaian” menyajikan titik impas yang diturunkan dari parameter resmi, perbedaan tiga jenis “penghematan”, rumus tagihan per tugas, dan tabel keputusan aktivasi.
Analisis Biaya Gemini Tool Retrieval: Yang Perlu Diketahui — Penjelasan Konsep
| Konsep | Penjelasan singkat |
|---|---|
| Token input | Satuan pengukuran untuk teks, konteks historis, dan deklarasi tool yang dikirim ke model untuk diproses |
| Skema tool | Definisi parameter lengkap yang menjadi dasar saat model menghasilkan pemanggilan fungsi; dalam contoh perhitungan, tiap skema sekitar 400 token |
| Daftar tool dengan pemuatan tertunda | Setelah defer_loading: true diatur, model pada awalnya hanya melihat nama dan deskripsi singkat tool; dalam pengujian awal resmi, tiap item sekitar 26 token |
| Konteks dasar B | Dalam contoh perhitungan, informasi historis dan tugas yang memang harus diproses model pada setiap pemanggilan |
| Inferensi setelah pencarian | Pemanggilan model tambahan yang dijalankan setelah server menemukan tool, dengan konteks yang ada ditambah Skema baru |
total_tool_use_tokens |
Dalam satu permintaan, jumlah input tambahan untuk pemanggilan model yang dipicu oleh tool sisi server dan pencarian |
total_cached_tokens |
Bagian dari penggunaan input yang diproses oleh cache dan ditagih dengan tarif cache |
| Titik impas | Batas saat biaya input pemuatan statis dan pemuatan sesuai kebutuhan sama, dengan asumsi yang sama |
| Biaya per tugas sukses | Jumlah biaya berbagai putaran pemanggilan model dan tool yang dikeluarkan untuk menyelesaikan satu tujuan bisnis |
Ringkasan Dampak Gemini Tool Retrieval
- Pengembang Agent dengan pustaka tool besar: saat tool-nya banyak tetapi hanya sedikit yang dipakai per tugas, ada peluang menurunkan secara signifikan biaya input Skema yang berulang. Inilah skenario yang sesuai dengan contoh perhitungan resmi dengan 200 tool.
- Pengembang aplikasi dengan kumpulan tool kecil dan konteks panjang: setiap pencarian sisi server memerlukan inferensi model tambahan dan memproses ulang konteks panjang, sehingga setelah diaktifkan bisa jadi lebih mahal. Contoh perhitungan resmi dengan 10 tool justru menjadi kontracontoh.
- Staf engineering atau FinOps yang bertanggung jawab atas perhitungan biaya: hanya melihat
total_input_tokenspada permintaan pertama akan meremehkan biaya;total_tool_use_tokens, cache hit, dan token output harus dihitung sekaligus. - Tim platform yang memelihara registri tool perusahaan: mode pencarian sisi klien dapat memadukan filter izin internal dan tool dinamis, tetapi setiap pencarian menambah satu round-trip API; dasar perhitungan biayanya perlu dievaluasi secara terpisah.
Fakta Objektif: Peluncuran dan Mekanisme Penagihan Gemini Tool Retrieval
Apa itu Gemini Tool Retrieval dan kapan dirilis
Pada 19 November 2026, Google mengumumkan di blog resminya bahwa fitur preview Tool Retrieval telah dibuka di Gemini Interactions API. Fitur ini masih dalam tahap Preview dan memerlukan versi API v1beta; metode generateContent yang lama tidak mendukungnya. Cara mengaktifkan mode sisi server adalah dengan menambahkan {"type": "tool_search"} ke dalam tools, lalu menetapkan defer_loading: true pada function atau mcp_server yang ingin ditunda pemuatannya.
Hingga 20 November 2026, dokumentasi pengembang secara eksplisit mencantumkan empat ID model yang kompatibel: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, dan gemini-3.6-flash. Pernyataan dalam pengumuman bahwa “Gemini 3.6 dan model yang lebih baru” memang lebih luas, tetapi model yang tidak tercantum dalam dokumentasi perlu diverifikasi sendiri; menetapkan defer_loading pada model yang tidak mendukung akan mengembalikan HTTP 400.
Ada satu hal yang mudah disalahpahami dan perlu ditekankan: dalam mode sisi server, pengembang tetap harus mengirimkan array tools secara lengkap pada setiap permintaan, termasuk parameter lengkap dari tool yang ditunda, bahkan saat menggunakan previous_interaction_id. Yang berubah oleh Tool Retrieval adalah kapan skema lengkap masuk ke dalam konteks model, bukan berarti definisi-definisi tersebut tidak lagi dikirim dalam body permintaan.
Dari Mana Biaya Pemuatan Statis dan Gemini Tool Retrieval Muncul?
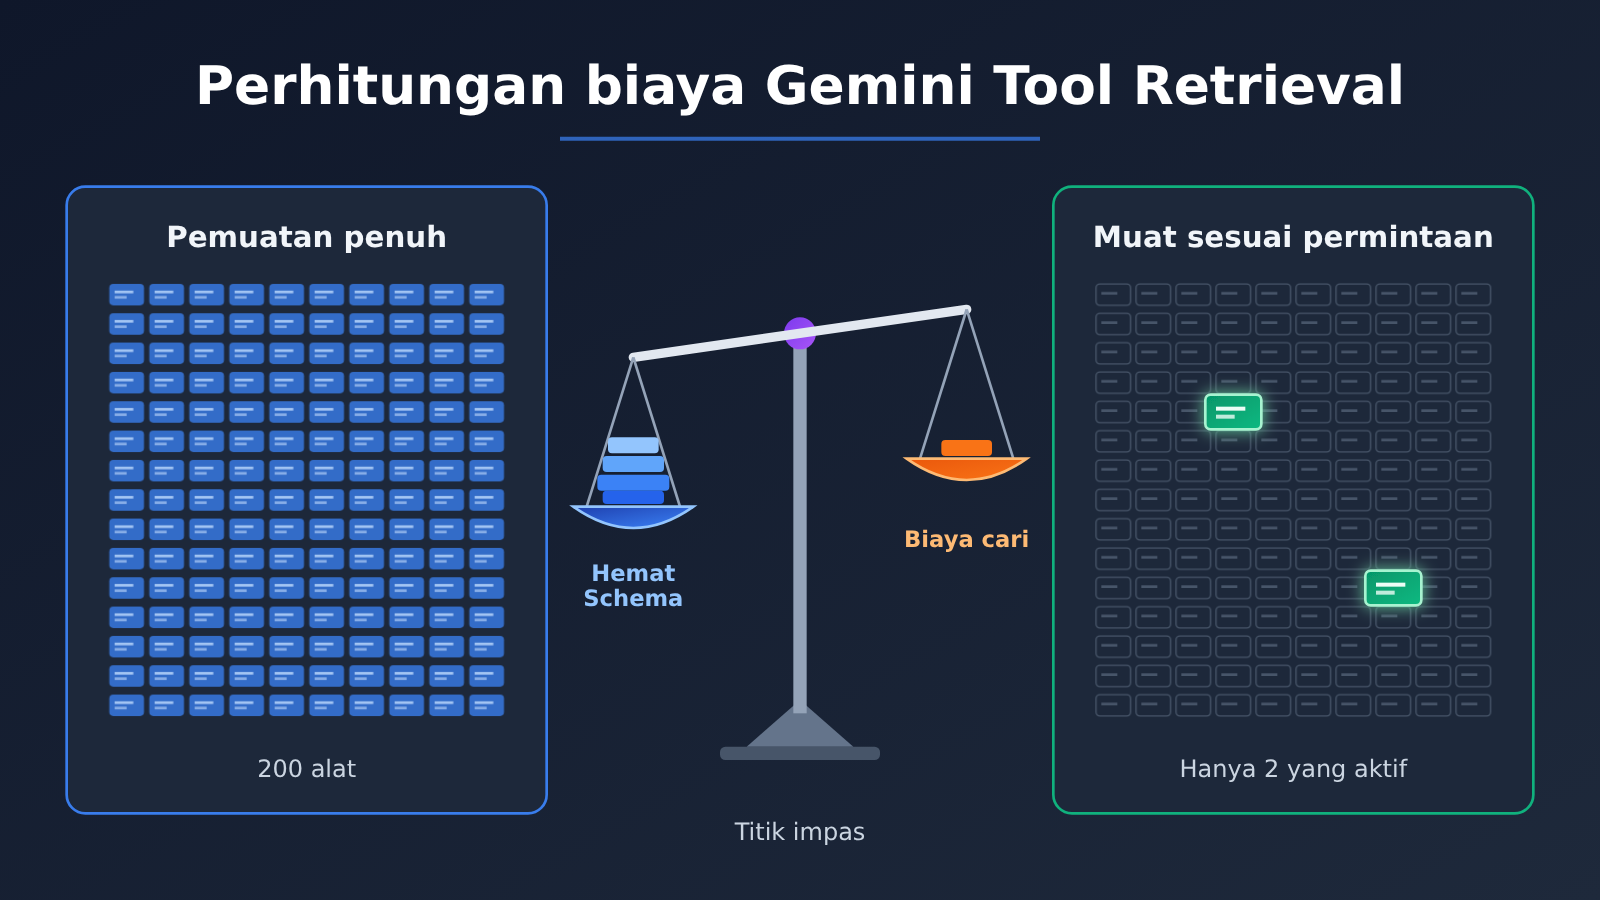
Saat memuat secara statis, setiap pemanggilan model harus membaca Schema lengkap dari semua tool, bahkan jika pada putaran itu hanya satu fungsi refund yang dipakai. Tool Retrieval menggantinya dengan daftar tool yang singkat; ketika model membutuhkannya, model mengirim tool_search_call, server mengembalikan tool_search_result yang berisi Schema lengkap, lalu model membuat function_call berdasarkan hasil tersebut.
Google secara eksplisit menyatakan bahwa Tool Retrieval tidak memiliki biaya fitur tersendiri, tetapi hal-hal berikut tetap ditagih sesuai tarif model yang dipilih:
- Item daftar singkat untuk semua tool yang dimuat secara tertunda.
- Instruksi pencarian tetap tambahan yang muncul setelah
tool_searchdiaktifkan. - Inferensi model tambahan yang dipicu oleh setiap retrieval di sisi server; inferensi ini memproses ulang konteks lengkap dan Schema yang baru dimuat.
- Schema lengkap tool yang dimuat, serta biaya berkelanjutan untuk tool tersebut pada putaran-putaran berikutnya (dokumentasi saat ini belum menyediakan mekanisme unloading).
- Token normal untuk output, Thinking, dan hasil eksekusi tool.
Contoh Perhitungan Resmi Gemini Tool Retrieval: 200 Alat dan 10 Alat
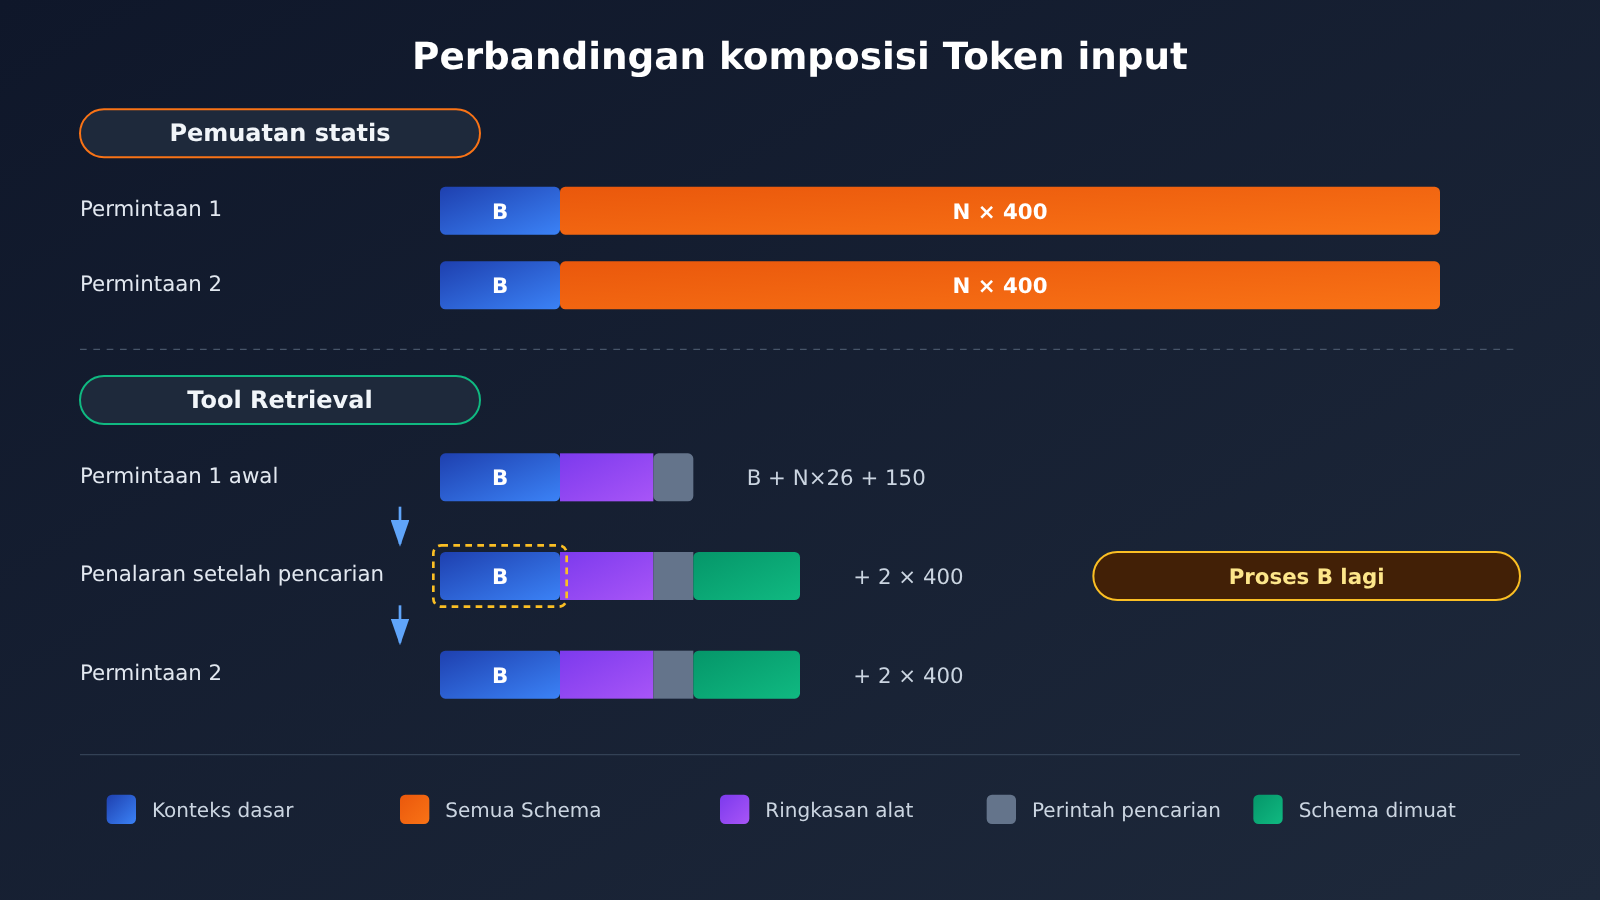
Kedua contoh perhitungan ini berasal dari dokumentasi Google Tool Retrieval. Keduanya merupakan perhitungan hipotetis yang ditandai resmi, bukan benchmark lingkungan produksi, dan sama-sama mengabaikan Token output serta keuntungan cache. Asumsi yang diseragamkan adalah: setiap Skema lengkap 400 Token, setiap ringkasan singkat alat yang ditangguhkan sekitar 26 Token, instruksi pencarian 150 Token, satu tugas mencakup 2 permintaan eksternal, 1 pencarian sisi server diselesaikan pada permintaan pertama, dan total 2 alat dimuat.
| Item perhitungan | 200 alat, B=2,000 | 10 alat, B=30,000 |
|---|---|---|
| Pemuatan statis: 2 × (B + N × 400) | 164,000 | 68,000 |
| Input awal permintaan 1 (B + N × 26 + 150) | 7,350 | 30,410 |
| Inferensi setelah pencarian pada permintaan 1 (ditambah 2 Skema) | 8,150 | 31,210 |
| Input permintaan 2 | 8,150 | 31,210 |
| Total Tool Retrieval | 23,650 | 92,830 |
| Perubahan | -140,350 | +24,830 |
| Besaran perubahan (dihitung ulang dari angka resmi) | sekitar -85.6% | sekitar +36.5% |
Skenario 200 alat terlihat jauh lebih hemat karena skema statis harus membawa 80,000 Token definisi alat setiap kali, sementara konteks dasarnya hanya 2,000; biaya tambahan untuk satu kali inferensi pencarian pun kecil. Skenario 10 alat justru sebaliknya: total definisi alat hanya 4,000 Token sehingga ruang penghematan terbatas, sedangkan inferensi setelah pencarian harus memproses ulang konteks panjang 30,000 Token; biaya tambahan itu langsung melebihi penghematannya.
Field Usage, Harga, dan Aturan Cache pada Gemini Tool Retrieval
Google menyediakan field di interaction.usage yang dibutuhkan untuk menganalisis biaya Tool Retrieval:
| Field | Arti | Peran dalam analisis biaya |
|---|---|---|
total_input_tokens |
Input pada pemanggilan model pertama dalam permintaan | Hanya mencerminkan “seberapa banyak konteks awal memendek” |
total_tool_use_tokens |
Input pemanggilan model tambahan yang dipicu oleh tool sisi server dan pencarian | Sumber utama biaya pencarian, paling mudah terlewatkan |
total_cached_tokens |
Bagian yang sudah termasuk dalam input dan ditangani oleh cache | Dihitung dengan tarif cache, tidak boleh dijumlahkan lagi |
total_output_tokens |
Output yang dihasilkan model | Dihitung dengan tarif output |
total_thought_tokens |
Token yang dihasilkan proses penalaran | Dihitung dengan tarif output model yang dipilih |
Dari sisi harga, pada tarif standar Standard di halaman penetapan harga Google, Gemini 4 Hydrogen menetapkan input sebesar $1.50 per juta Token, output (termasuk Thinking) $7.50, dan input cache $0.075. Jika hanya memakai harga satuan input ini untuk konversi aritmetika pada contoh perhitungan resmi, skenario 200 tool berada di sekitar $0.246 vs $0.0355, sedangkan skenario 10 tool sekitar $0.102 vs $0.139. Ini hanyalah perkalian jumlah Token hipotetis dengan tarif resmi, bukan tagihan nyata dalam bentuk apa pun.
Aturan cache memiliki dua ambang batas yang perlu dipahami secara terpisah. Pertama, Interactions API hanya mendukung implicit caching; per 20 November 2026, skala input minimum untuk implicit caching pada seri Gemini 4, Gemini 3.8 Flash, dan Gemini 3.6 Flash semuanya adalah 4.096 Token. Kedua, dalam percakapan multi-putaran dan Agent Loop Gemini 4, permintaan baru harus menambahkan setidaknya 2.050 Token agar sistem meng-cache permintaan sebelumnya secara penuh; jika kurang, 2.050 Token di akhir permintaan sebelumnya akan ditagih ulang dengan harga input standar, dan output model, Thinking, serta hasil fungsi semuanya ikut dihitung dalam tambahan ini.
Hingga tanggal verifikasi materi, Google belum mempublikasikan proporsi penghematan Token pada kumpulan tugas nyata, besaran perbaikan latensi, atau peningkatan akurasi pemilihan tool untuk Tool Retrieval, dan juga belum terlihat pengujian produksi dari developer independen yang dapat diverifikasi secara memadai.
Analisis: Kapan Gemini Tool Retrieval Benar-benar Menghemat Token
Titik impas Gemini Tool Retrieval: berapa jumlah tool yang layak untuk diaktifkan
Berikut adalah contoh perluasan yang diturunkan dari parameter contoh perhitungan resmi, bukan ambang universal yang diterbitkan Google. Misalkan N adalah jumlah total tool, B adalah konteks dasar, dengan asumsi yang sama S=400, D=26, H=150, K=2, dan skenario “dua permintaan, satu pencarian”:
- Pemuatan statis: T_static = 2 × (B + 400N)
- Pemuatan sesuai kebutuhan: T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
Rumus ini dapat mereproduksi kedua hasil resmi secara lengkap. Dengan menetapkan T_retrieval < T_static, setelah disederhanakan diperoleh 722N > B + 2050, yaitu N > (B + 2050) / 722. Angka 2050 di sini berasal dari 3 × 150 + 1600, murni hasil aljabar, dan sama sekali tidak terkait dengan kondisi penambahan 2,050 Token pada cache multi-putaran Gemini 4 dalam dokumentasi caching; jangan dicampur-adukkan.
| Konteks dasar B | Jumlah tool N | Pemuatan statis | Tool Retrieval | Perubahan | Besar perubahan | Atribut data |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | Contoh resmi |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | Contoh resmi |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | Derivasi perluasan |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | Derivasi perluasan |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | Derivasi perluasan |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | Derivasi perluasan |
Pada B=30,000, nilai ambangnya adalah N > 44.39, artinya pemuatan sesuai kebutuhan baru sedikit lebih unggul mulai dari tool ke-45, dan di sekitar titik impas penghematannya hampir dapat diabaikan. Dengan rumus yang sama, jika B=2,000, nilai ambangnya sekitar 5.6, yaitu 6 tool sudah cukup untuk membalikkan keadaan. Dari sini terlihat bahwa semakin panjang konteks dasar, semakin besar pustaka tool yang diperlukan untuk mengamortisasi biaya pemrosesan ulang konteks saat pencarian.
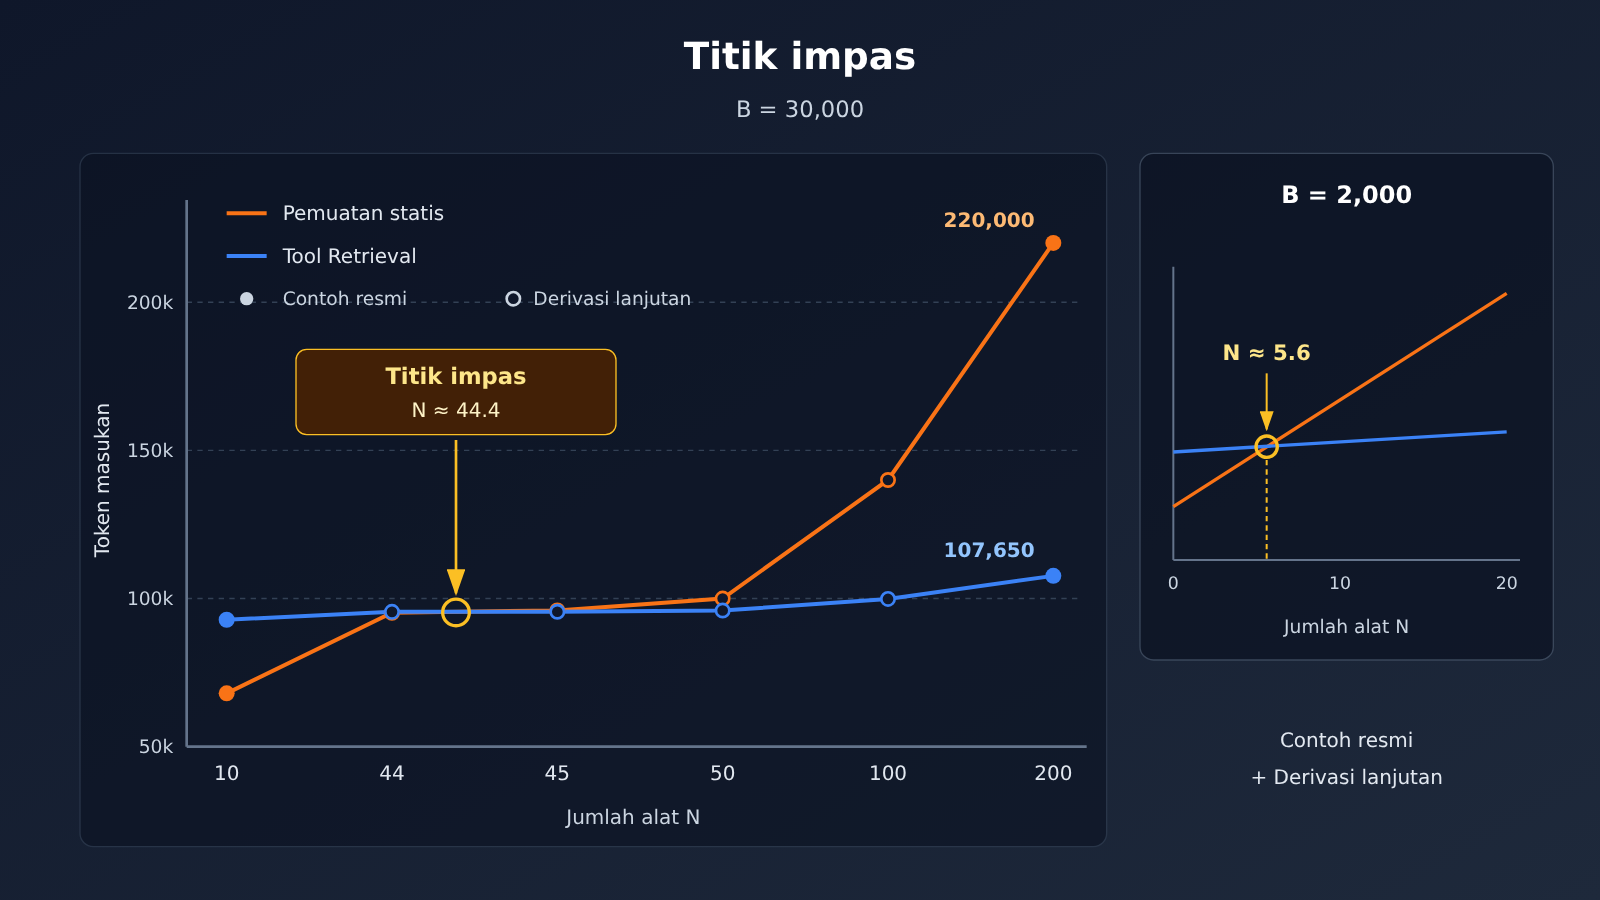
Keterangan gambar: dua baris data pertama adalah contoh perhitungan resmi Google, sisanya adalah derivasi dengan asumsi yang sama. Jumlah pencarian dan jumlah pemuatan dalam tugas nyata akan mengubah kurva; disarankan menguji ulang dengan permintaan bisnis Anda sendiri, dan Anda dapat menggunakan antarmuka terpadu APIYI apiyi.com untuk dengan cepat menyiapkan baseline pemuatan statis beberapa model sebagai pembanding.
Tugas di dunia nyata jarang benar-benar sesuai dengan rangkaian asumsi ini; variabel berikut akan menggeser titik impas:
- Jumlah pencarian: setiap kali ada satu pencarian sisi server tambahan, ada satu input model tambahan yang mendekati skala “B + daftar tool + Schema yang sudah dimuat”; dalam skenario konteks panjang, ini setara dengan membayar B lagi setiap kali.
- Jumlah pemuatan aktual K: semakin banyak tool yang dimuat, semakin kecil penghematannya; Schema yang sudah dimuat tidak dapat dilepas dan akan terus terakumulasi dalam sesi panjang.
- Ukuran Schema individual S: untuk tool dengan parameter rumit dan deskripsi panjang, manfaat pemuatan sesuai kebutuhan lebih besar; jika Schema sangat pendek, manfaatnya akan termakan oleh item daftar dan instruksi pencarian.
- Jumlah putaran sesi: pendekatan statis harus mengulang seluruh Schema pada setiap putaran; semakin banyak putaran dan tidak lagi memicu pencarian baru, semakin jelas keunggulan pemuatan sesuai kebutuhan.
Pengurangan Token Input, Penurunan Total Biaya, Respons Lebih Cepat: Tiga Jenis “Penghematan” pada Gemini Tool Retrieval
Ketiga hal ini sering dianggap sama, padahal tidak setara. Pengurangan token input paling mudah dilihat, tetapi jika hanya melihat total_input_tokens, Anda akan melewatkan penalaran pasca-pencarian yang tercatat di total_tool_use_tokens, sehingga besaran penghematan bisa ditaksir terlalu tinggi.
Penurunan total biaya juga bergantung pada cache dan harga satuan. Pemuatan sesuai kebutuhan membuat prompt awal lebih pendek; jika awalnya justru melewati ambang cache implisit 4.096 token karena banyak Schema, maka setelah diaktifkan bisa jadi cache-nya justru hilang. Jika loop pendek pemanggilan fungsi dan pengembalian hasil menambahkan kurang dari 2.050 token, Gemini 4 juga tidak mendapatkan cache permintaan sebelumnya secara penuh. Artinya, token memang berkurang, tetapi struktur harga satuan bisa jadi memburuk.
Respons lebih cepat saat ini belum didukung oleh data resmi maupun independen mana pun. Pencarian sisi server tidak menambah round-trip di klien, tetapi di dalam permintaan memang ada inferensi model tambahan yang dijalankan; sementara pencarian sisi klien menambah satu round-trip API setiap kali mencari. Apakah latensi benar-benar lebih cepat atau justru lebih lambat, hanya bisa dijawab lewat pengujian end-to-end Anda sendiri.
Cara menghitung tagihan sebenarnya untuk satu tugas Gemini Tool Retrieval Agent
Berdasarkan semantik Usage resmi, dengan asumsi penagihan standar, token cache sudah termasuk dalam input, dan tidak ada alat lain yang dikenakan biaya per panggilan, satu permintaan dapat diestimasi sebagai:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
Di sini I, U, C, O, T secara berurutan merujuk pada lima field pada tabel di atas. Sebuah tugas Agent sering kali mencakup beberapa permintaan, jadi Usage dari setiap permintaan perlu dijumlahkan terlebih dahulu sebelum dihitung, lalu gunakan “total biaya ÷ jumlah tugas yang berhasil diselesaikan” untuk mendapatkan biaya per tugas yang berhasil.
Sebelum mengaktifkan Tool Retrieval, cara paling aman adalah mengukur baseline pemuatan statis terlebih dahulu. Berikut contoh menjalankan Function Calling statis sekali melalui antarmuka kompatibel OpenAI, lalu mencatat Usage baseline:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, untuk menjalankan baseline pemuatan statis
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # Nama model mengacu pada daftar model platform
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # Catat token input dan output saat pemuatan statis penuh
Perlu dijelaskan bahwa Tool Retrieval sendiri bergantung pada versi v1beta dari Google Interactions API. Contoh di atas hanya digunakan untuk memperoleh data pembanding pemuatan statis; untuk sisi pemuatan sesuai kebutuhan, gunakan cara pemanggilan yang mendukung Interactions API, lalu masukkan Usage dari kedua sisi ke dalam rumus biaya yang sama untuk dibandingkan.
Lihat kode implementasi lengkap: perhitungan titik impas + estimasi tagihan Usage
import openai

# ---------- 1. Perhitungan teoretis mengikuti acuan contoh resmi (contoh tambahan, bukan ambang resmi) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # hanya berlaku saat S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 临界工具数:", round(breakeven_tools(30000), 2))

# ---------- 2. Estimasi biaya per permintaan berdasarkan field Usage (dolar) ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T masing-masing merujuk pada total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Contoh: harga standar Gemini 4 Hydrogen 1.50 / 0.075 / 7.50 (per juta Token)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Baseline pemuatan statis (antarmuka kompatibel OpenAI) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # saat mengumpulkan tugas multi-putaran, akumulasikan per permintaan
🚀 Mulai cepat: sebaiknya jalankan dulu baseline pemuatan statis di APIYI apiyi.com dengan satu Key, catat Token dan tingkat penyelesaian dari kumpulan tugas bisnis nyata, baru kemudian putuskan apakah Agent perlu dimigrasikan ke pemuatan sesuai permintaan — supaya tidak langsung mengubah arsitektur hanya berdasarkan angka ilustrasi resmi.
Keputusan Mengaktifkan Gemini Tool Retrieval: Apakah Pustaka Alat Anda Memenuhi Syarat
Dengan menggabungkan rekomendasi teknis resmi dan penalaran di atas, Anda dapat membuat penilaian awal berdasarkan tabel berikut; pada akhirnya tetap berpegang pada biaya per tugas sukses dan tingkat penyelesaian untuk tugas nyata:
| Karakteristik beban kerja | Strategi yang disarankan | Alasan |
|---|---|---|
| Kurang dari sekitar 20 alat stabil, sebagian besar digunakan setiap putaran | Lanjutkan pemuatan statis | Rekomendasi resmi; Schema yang dapat dihemat sedikit, sementara overhead pencarian menjadi porsi yang tinggi |
| Alat sedikit tetapi konteks dasar sangat panjang | Pemuatan statis, atau hanya menunda beberapa alat dengan Schema besar | Setiap pencarian akan memproses ulang konteks panjang; contoh perhitungan 10 alat justru menjadi contoh berlawanan |
| Puluhan hingga ratusan alat, hanya beberapa yang digunakan per permintaan | Prioritaskan evaluasi retrieval sisi server | Pustaka alat long-tail berskala besar adalah skenario yang sesuai dengan contoh perhitungan resmi 200 alat |
| Campuran alat frekuensi tinggi + banyak alat khusus frekuensi rendah | Muat langsung alat frekuensi tinggi, gunakan defer_loading untuk alat frekuensi rendah |
Pola campuran yang direkomendasikan resmi, agar tugas sederhana tidak perlu mencari terlebih dahulu |
| Multi-tenant, alat dinamis, perlu penyaringan berdasarkan izin pengguna | Evaluasi retrieval sisi klien | Dapat terhubung ke registri yang dibangun sendiri, tetapi setiap pencarian menambah satu perjalanan bolak-balik |
| Alat yang sering disebutkan dalam instruksi sistem | Tetap dimuat langsung | Rekomendasi resmi mengingatkan bahwa alat tertunda yang disebutkan dapat dipanggil langsung dengan melewati pencarian dan menyebabkan kesalahan |
💡 Saran pemilihan: jalankan kumpulan tugas yang sama dengan dua pendekatan—statis dan sesuai kebutuhan—secara terpisah, sambil menjaga model, pustaka alat, panjang konteks, dan kondisi cache tetap konsisten. Melalui APIYI apiyi.com, Anda dapat beralih antara berbagai model Gemini dan model arus utama lainnya dalam antarmuka terpadu untuk membuat perbandingan baseline, sehingga perbedaan biaya dapat dikaitkan dengan strategi pemuatan alat itu sendiri.
Ada beberapa detail teknis yang secara langsung memengaruhi tagihan: saat mengelola riwayat sendiri dengan store=false, Anda harus mempertahankan tool_search_call, tool_search_result, dan signature-nya apa adanya, jika tidak, permintaan berikutnya dapat mengembalikan HTTP 400; jangan menghilangkan parameters dari alat yang ditunda hanya untuk memperkecil isi permintaan; saat men-debug, periksa function_call di interaction.steps, jangan hanya melihat interaction.status. Jika masalah ini memicu percobaan ulang, token dari permintaan berulang juga akan dihitung dalam biaya.
Pada dasarnya, Tool Retrieval adalah alat penghematan biaya yang berasumsi bahwa “sedikit alat sering digunakan, sementara sebagian besar alat lama menganggur”. Dua contoh perhitungan resmi dengan arah berlawanan telah menjelaskan batasannya: semakin besar pustaka alat, semakin pendek konteks, dan semakin sedikit pencarian, semakin mungkin menghemat; sebaliknya, biaya bisa lebih tinggi. Yang benar-benar perlu dioptimalkan bukanlah jumlah token pada permintaan pertama, melainkan total biaya per tugas sukses.
Seperti yang ditulis oleh Chen Danran dari Dinasti Qing dalam Wuyan · Qian Du Jian Fan Yi: “Mereka yang tidak merencanakan gambaran keseluruhan tidak akan mampu merencanakan satu wilayah pun.”
Referensi
- Pengumuman resmi Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Tautan:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Tautan:
- Dokumentasi teknis Google Tool Retrieval: konfigurasi, penagihan, contoh perhitungan resmi, dan batasan
- Tautan:
aistudio.google.com/docs/tool-retrieval
- Tautan:
- Dokumentasi Google Context caching: ambang cache implisit dan aturan cache multi-putaran Gemini 4
- Tautan:
aistudio.google.com/docs/caching
- Tautan:
- Harga Google Gemini Developer API: tarif input, output, dan cache model
- Tautan:
aistudio.google.com/docs/pricing
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika Anda ingin membandingkan biaya Token berbagai model seperti Gemini dalam skenario Agent, silakan kunjungi APIYI apiyi.com untuk mendapatkan kuota uji coba. Penjelasan integrasi lebih lanjut dapat dilihat di pusat dokumentasi docs.apiyi.com


