
Note de l’auteur : à partir d’un constat formulé lors du Sommet mondial de l’écosystème numérique de Tencent — « améliorer l’efficacité individuelle ne rend pas automatiquement l’organisation plus forte » —, nous examinons les cinq mécanismes de gestion à mettre en place au niveau de l’invocation des modèles lorsque les équipes utilisent l’IA.
Début novembre 2026, le Sommet mondial de l’écosystème numérique de Tencent a consacré une scène aux lancements de produits IA, avec plus de 40 présentations en deux jours. Un constat mérite qu’on s’y arrête : améliorer l’efficacité individuelle ne rend pas automatiquement l’organisation plus forte : entre les deux, il faut construire tout un ensemble de capacités organisationnelles. Cette phrase est de Zhang Xiyao, directeur général adjoint de Tencent Cloud et responsable du produit WorkBuddy pour les entreprises.
Cet article ne se contente pas de résumer une nouvelle série de lancements de produits Agent. Il aborde une question plus fondamentale : quand on passe d’un usage individuel de l’IA à un usage en équipe, tout le monde partage les mêmes capacités offertes par les modèles. Qui peut les invoquer, combien chacun les utilise et à quel projet attribuer les dépenses : tout cela doit d’abord être maîtrisé au niveau de la couche d’invocation des modèles.
Ce que vous allez en retirer : une grille de vérification avant de déployer l’IA dans votre équipe. Elle couvre l’accès aux modèles, les clés et les autorisations, l’attribution des coûts, le suivi des appels et le partage des bonnes pratiques. Elle précise aussi ce qu’une passerelle unifiée peut résoudre, et ce qu’elle ne peut pas résoudre.
L’essentiel sur l’utilisation de l’IA en équipe
Commençons par les faits. Les informations du tableau proviennent toutes du reportage de GeekPark sur la conférence.
| Élément | Détails |
|---|---|
| Événement | Présentations de produits IA à la Tencent Global Digital Ecosystem Conference : deux jours, sept thèmes et plus de 40 lancements de produits |
| Constat central | Améliorer la productivité individuelle ne suffit pas à renforcer une organisation : il faut aussi développer tout un ensemble de capacités organisationnelles |
| Priorités de la mise à niveau entreprise | Une plateforme ouverte pour connecter les systèmes métier ; une solution de sécurité d’entreprise et un centre d’observabilité pour gérer les autorisations, les processus d’exécution et les coûts d’utilisation ; des agents hébergés capables de fonctionner 24 h/24 et 7 j/7 |
| Suite complémentaire | Buddy One propose un compte unifié, un pool de Credit partagé et une gestion centralisée, pour simplifier la configuration et le déploiement de l’IA en entreprise |
| Exemple de déploiement | Suning a créé une plateforme d’agents à l’échelle de l’organisation, couvrant 14 services et 48 scénarios de collaboration, avec 36 agents réutilisables |
| Défi du passage à l’échelle | Si chaque Agent nécessite son propre environnement d’exécution, faire fonctionner 100 000 employés numériques pourrait demander 100 000 environnements isolés |
Trois questions concrètes pour les équipes qui utilisent l’IA
Selon le reportage, les entreprises qui déploient des Agents doivent répondre à trois questions : les Agents peuvent-ils se connecter aux systèmes existants et accéder aux données nécessaires ? Comment gérer les autorisations des différents employés et Agents ? Et comment permettre aux autres de réutiliser directement une bonne méthode découverte par une personne ? Ces questions concernent toutes les équipes qui prévoient de déployer l’IA, quels que soient les produits utilisés.
Un détail mérite l’attention : dans la mise à niveau entreprise, les autorisations, les processus d’exécution et les coûts d’utilisation sont regroupés dans un même module. Le pool de Credit partagé est lui aussi présenté comme un moyen de simplifier le déploiement. Cela montre que lorsque l’IA passe du statut d’outil individuel à celui de ressource d’équipe, le contrôle des accès et le suivi des coûts deviennent des questions d’infrastructure, et non des correctifs à ajouter après coup.
Pourquoi la couche d’invocation des modèles est le premier point de contrôle pour une équipe qui utilise l’IA
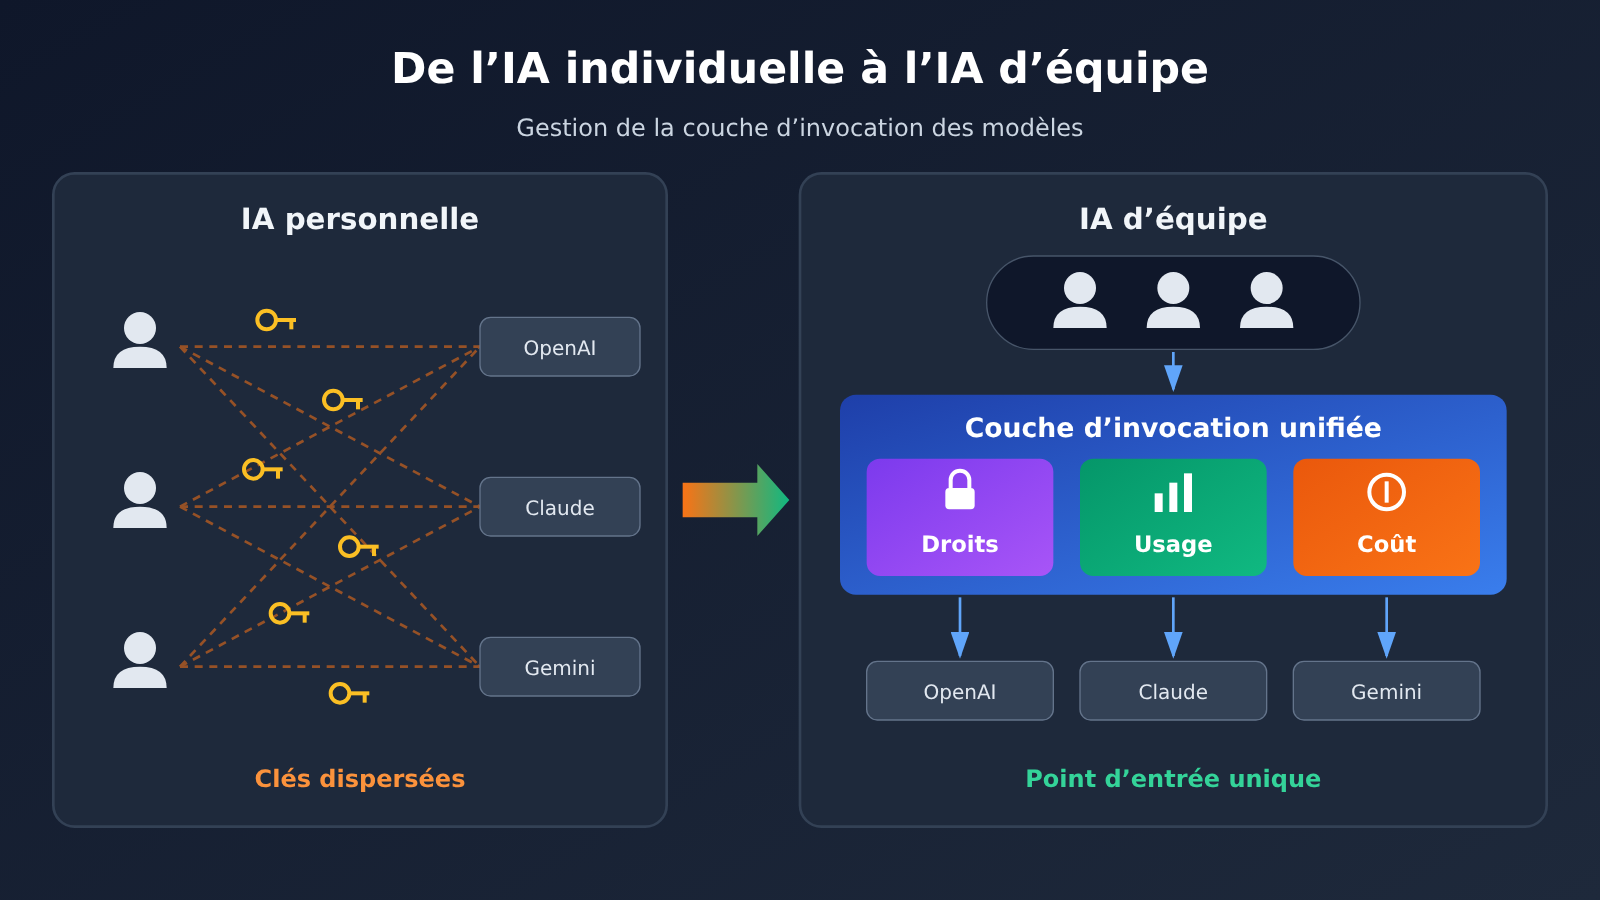
Quand on utilise l’IA à titre individuel, on s’inscrit généralement à plusieurs services de modèles, on renseigne sa propre carte bancaire, on conserve ses propres clés API et on inscrit les adresses d’appel en dur dans ses scripts ou ses outils. Cette approche est efficace pendant la phase d’exploration, mais dès que l’équipe grandit, les problèmes s’accumulent.
Les situations courantes ne manquent pas : les clés sont dispersées entre ordinateurs personnels et historiques de conversation, et lors d’un départ, personne ne sait exactement combien sont encore utilisées ; en fin de mois, la facture ne donne qu’un montant global, sans préciser quel projet ou quelle personne l’a généré ; si un modèle se met soudainement à renvoyer des erreurs ou augmente ses tarifs, il faut modifier un par un tous les endroits où son appel est inscrit en dur. Ces problèmes n’ont rien à voir avec les capacités des agents : ils viennent avant tout de l’absence de gestion centralisée de la couche d’invocation des modèles.
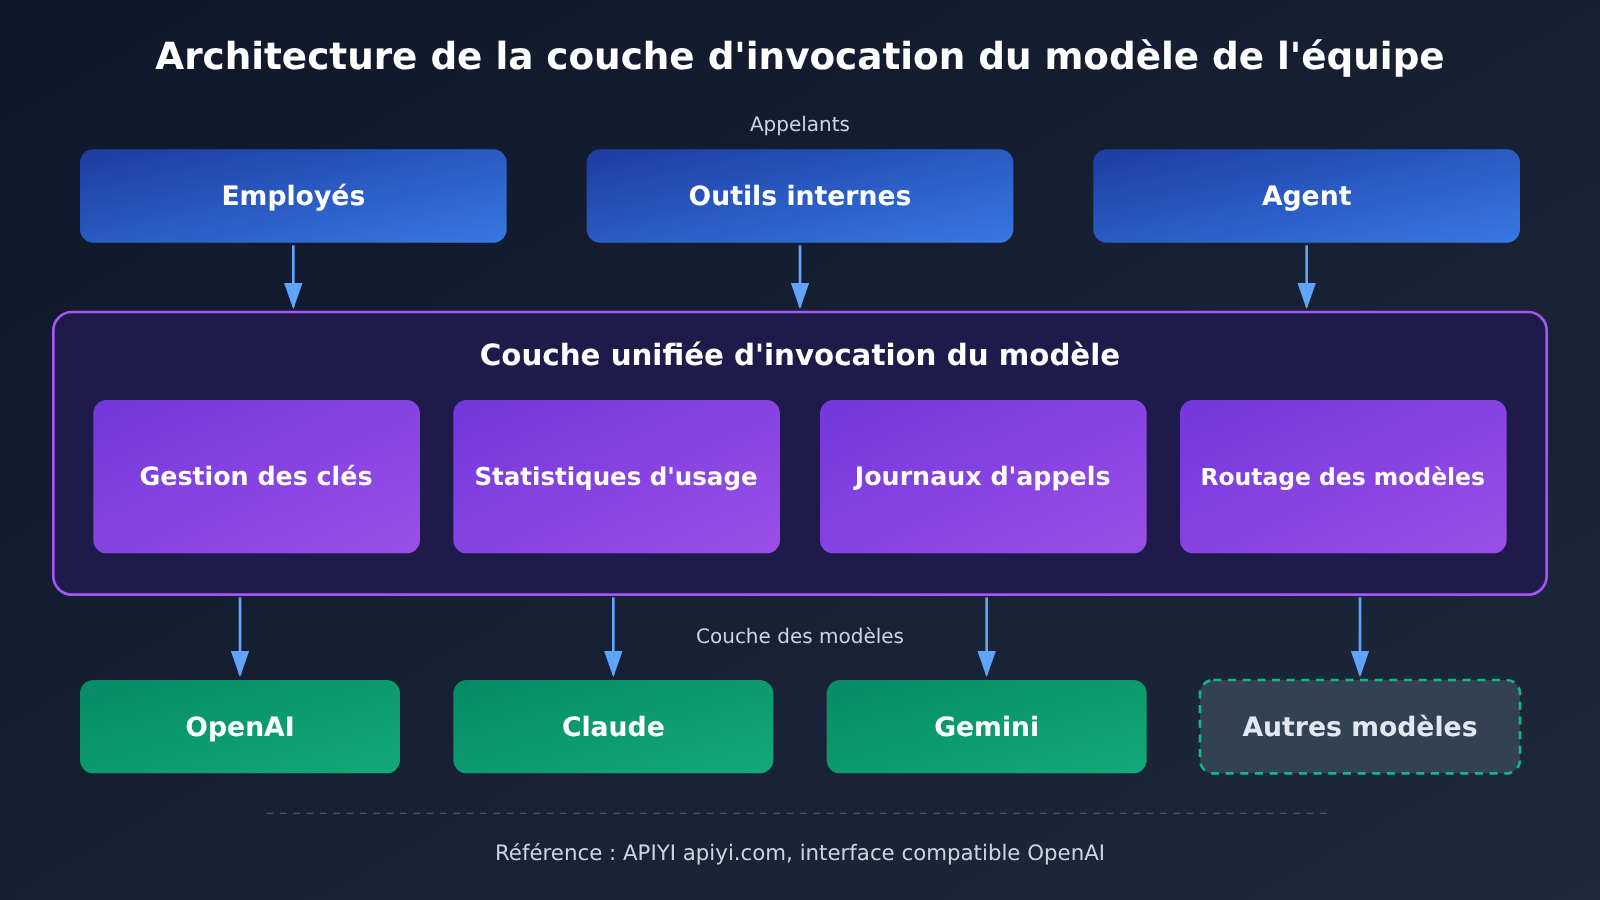
En regroupant les appels dans une seule couche, l’équipe dispose enfin d’un point central où appliquer des règles communes. « Reprendre le contrôle » ne signifie pas mettre en place d’emblée des procédures d’approbation complexes : il s’agit d’abord de faire passer tous les appels par le même point d’entrée. La gestion des autorisations, de l’utilisation et des coûts pourra ensuite s’appuyer sur cette base.
Les 5 points à vérifier sur la couche d’invocation des modèles avant d’utiliser l’IA en équipe
Cette liste ne dépend d’aucun fournisseur. Vous pouvez l’utiliser pour évaluer une passerelle maison, une solution cloud ou une plateforme d’agrégation tierce.
| Point à vérifier | Questions à se poser | Mise en place minimale |
|---|---|---|
| 1. Accès aux modèles | De quels modèles l’équipe a-t-elle besoin ? Combien de code faut-il modifier pour changer de modèle ? | Utiliser une interface compatible avec OpenAI et rendre le nom du modèle configurable |
| 2. Clés et permissions | Qui détient les clés ? Peut-on les révoquer rapidement en cas de départ ou de fuite ? | Distribuer les clés par projet ou par service et interdire les clés personnelles dans le code de production |
| 3. Répartition des coûts | Combien dépense chaque projet ou chaque équipe ? | Distinguer au minimum l’utilisation par clé ou par projet et produire un relevé mensuel détaillé |
| 4. Traçage des invocations | En cas de problème, peut-on identifier l’invocation et le modèle concernés ? | Enregistrer l’heure de la requête, le modèle, le nombre de tokens et l’identifiant de l’appelant |
| 5. Réutilisation des pratiques | Les autres peuvent-ils réutiliser directement les bonnes invites et les bons processus ? | Enregistrer les invites et les paramètres validés sous forme de modèles partagés ou de services internes |
Points 1 et 2 : accès aux modèles, clés et permissions
Pour l’accès aux modèles, le maître mot est l’« interchangeabilité ». Les modèles excellent dans des tâches différentes, et leurs prix comme leur stabilité peuvent évoluer. Si le code métier dépend uniquement d’une interface compatible et que le nom du modèle figure dans la configuration, passer d’un modèle à l’autre revient à modifier la configuration, sans nouveau développement.
Pour les clés et les permissions, le maître mot est la « révocabilité ». Le principe recommandé : une clé par service et un quota par projet, plutôt qu’une seule super-clé partagée par toute l’équipe. Ainsi, si une clé fuite, seul le service concerné est exposé et sa révocation n’affecte pas les autres activités.
Points 3 à 5 : répartition des coûts, traçage des invocations et réutilisation des pratiques
La répartition des coûts permet aux équipes métier de reconnaître la valeur de l’investissement dans l’IA. Avec une facture globale pour seul indicateur, impossible de savoir quels usages créent réellement de la valeur ; il devient aussi difficile de demander un budget à la direction. Le traçage des invocations est quant à lui indispensable pour résoudre les problèmes : lorsqu’un utilisateur signale une erreur dans une réponse de l’IA, vous devez pouvoir retrouver le modèle utilisé et les données fournies lors de l’invocation.
La réutilisation des pratiques reprend l’idée du cas de Suning : transformer le processus de lancement d’un nouveau produit en modèle et intégrer les documents de travail à une base de connaissances. Le temps de préparation est ainsi passé de 3 jours ouvrables à 4 heures, et la méthode a été conservée pour être réutilisée. Dans la couche d’invocation des modèles, cela signifie regrouper les invites validées, le choix du modèle et les combinaisons de paramètres, plutôt que de laisser ce savoir dans la tête d’une seule personne.
Exemple d’invocation unifiée de l’IA en équipe
Voici un exemple minimal qui appelle un modèle via une interface compatible avec OpenAI. Le nom du modèle est lu depuis une variable d’environnement, ce qui permet à toute l’équipe de changer facilement de modèle.
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # Clé distribuée par projet
    base_url="https://api.apiyi.com/v1"          # Interface unifiée APIYI
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
Voir la version adaptée à l’équipe avec journalisation des appels
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # Une clé pour appeler les modèles de plusieurs fournisseurs
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """Point d’entrée unifié de l’équipe : enregistre le projet, l’appelant, le modèle et l’utilisation des tokens"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # Écrit dans un journal local, à importer ensuite dans des rapports pour regrouper les coûts par projet
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
Cette fonction ajoute deux informations côté application : le projet et l’appelant. Même si la plateforme fournit déjà des statistiques d’utilisation, il reste utile de conserver vos propres journaux d’appels : seul votre système sait à quel cas d’usage chaque appel correspond.
🚀 Pour démarrer rapidement : si chaque membre de votre équipe utilise encore ses propres clés, vous pouvez commencer par accéder aux principaux modèles, comme OpenAI, Claude et Gemini, avec une seule clé API via APIYI apiyi.com. La plateforme propose une interface compatible avec OpenAI et une facturation à l’usage. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit, pratique pour mettre en place un premier point d’entrée unifié.
Ce qu’une couche unifiée d’invocation des modèles peut résoudre, et ce qu’elle ne peut pas résoudre
Beaucoup d’équipes voient la passerelle unifiée comme « la réponse à toute la gouvernance de l’IA ». En réalité, elle ne couvre que l’invocation des modèles. Le tableau ci-dessous précise ses limites.
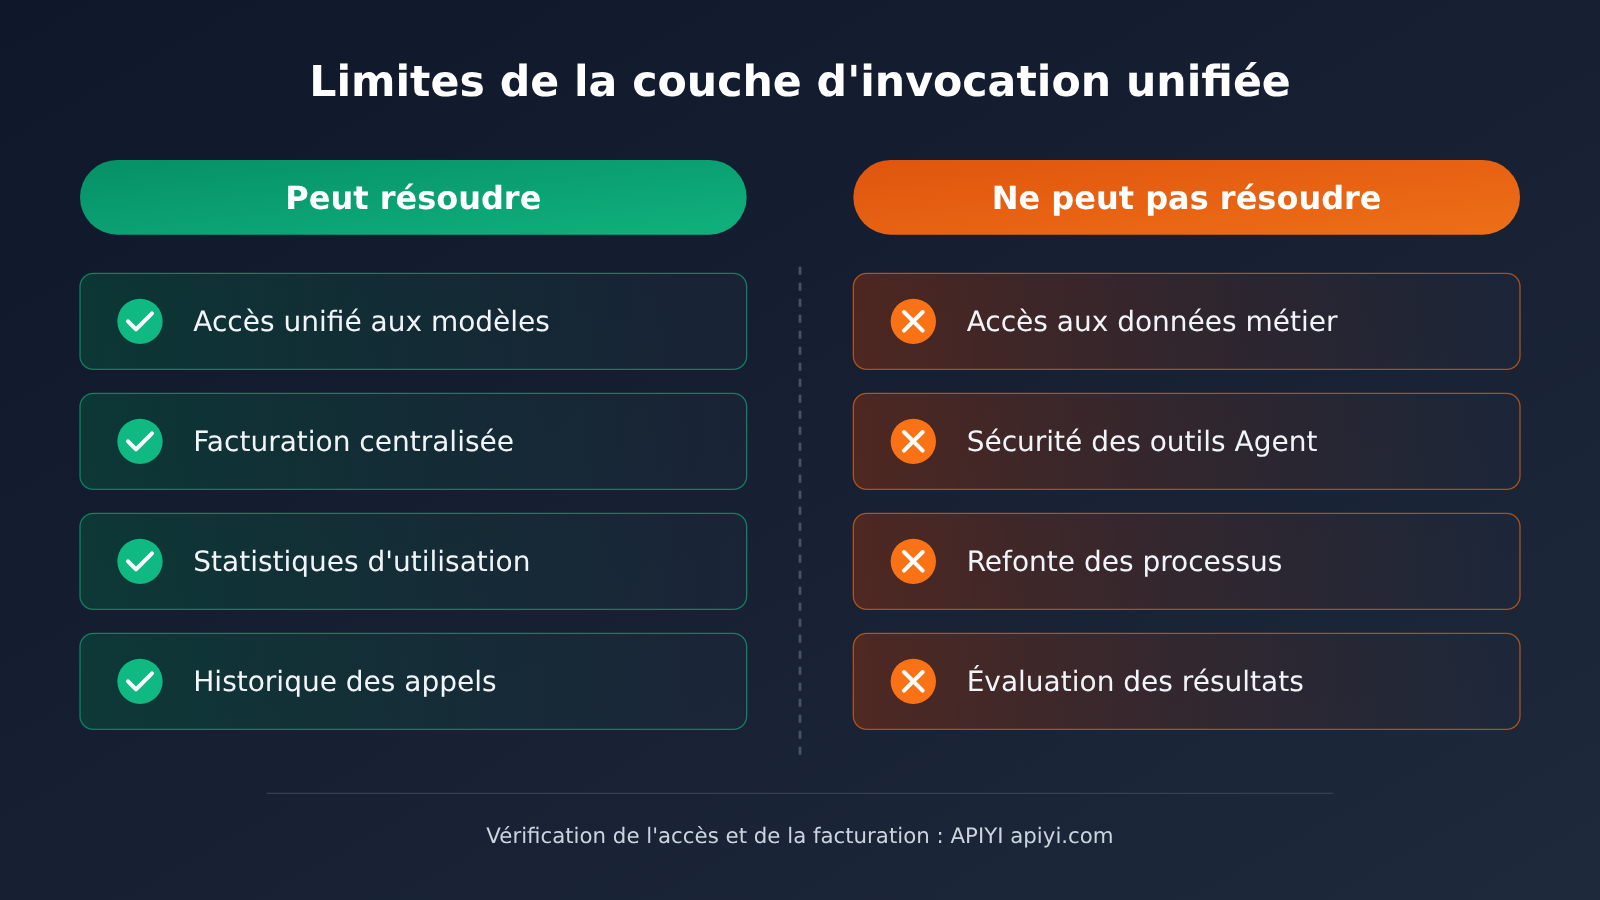
| Dimension | Ce que la couche unifiée peut faire | Ce qui relève encore d’autres composants |
|---|---|---|
| Accès aux modèles | Appeler les modèles de plusieurs fournisseurs via une seule interface, avec un faible coût de changement | Déterminer quel modèle convient à chaque usage métier |
| Coûts | Centraliser le solde et la facturation à l’usage pour faciliter la consolidation | Relier les coûts aux résultats métier et évaluer le ROI |
| Autorisations | Contrôler « qui peut appeler les modèles » | Contrôler « les données qu’un agent peut lire et les actions qu’il peut exécuter » |
| Traçabilité | Enregistrer le modèle, les tokens et l’heure de chaque appel | Suivre toute la chaîne d’exécution d’un agent et la qualité des résultats |
| Réutilisation | Fournir un point d’accès stable pour les appels | Constituer un ensemble réutilisable d’invites, de modèles de processus et de bases de connaissances |
Cela explique aussi pourquoi Tencent a présenté lors de la conférence une solution de sécurité, un centre d’observabilité, Agent Runtime et des produits de gestion des connaissances. Comme le souligne l’article, un agent peut appeler des outils de manière autonome, accéder à des données et même exécuter du code. Il est donc essentiel de limiter ses actions, de protéger les informations sensibles et de pouvoir retrouver la cause d’un problème. Ces questions relèvent de l’environnement d’exécution des agents et de la couche de données : la passerelle de modèles ne les couvre pas.
L’ordre logique est donc le suivant : unifier d’abord la couche d’invocation des modèles pour rendre les accès et les dépenses visibles, puis ajouter les droits d’accès aux données, la sécurité des agents et la refonte des processus. Sans visibilité sur la couche de base, impossible de gouverner efficacement les couches supérieures.
Analyse de l’impact de l’IA sur les équipes
Pour les responsables techniques
- Prévoir un point d’entrée unique dans l’architecture : lors de l’intégration d’un grand modèle de langage dans un nouveau projet, évitez de coder en dur l’adresse officielle d’un fournisseur. Passez systématiquement par l’interface compatible choisie par l’équipe.
- Intégrer la gestion des clés aux opérations : les clés API doivent suivre le même processus de gestion que les mots de passe de base de données, avec un historique de leur attribution, de leur rotation et de leur révocation.
- Définir les champs des journaux dès le départ : il faut au minimum pouvoir relier le projet, l’appelant, le modèle et la consommation de tokens. Sans cela, le rapprochement des coûts en fin de mois sera difficile à reconstituer.
Pour les décideurs métier et les achats
Lorsqu’une équipe achète des services d’IA, la question n’est plus seulement « quel modèle est le plus performant ? », mais aussi « peut-on en garder le contrôle ? ». Le tableau ci-dessous présente les priorités selon le stade de déploiement de l’équipe, pour aider à planifier son adoption.
| Stade de l’équipe | Situation typique | Priorités pour l’invocation des modèles |
|---|---|---|
| Exploration individuelle | Quelques personnes testent les services à leurs frais, chacune avec ses propres clés | Choisir une interface commune et centraliser les comptes dispersés |
| Projet pilote en groupe | Un ou deux projets commencent à dépendre de l’IA | Distribuer les clés par projet et mettre en place des statistiques d’utilisation de base |
| Déploiement au sein d’un service | Plusieurs lignes métier invoquent des modèles simultanément | Affecter les coûts par projet et rendre les journaux d’appels consultables |
| Utilisation à l’échelle de l’organisation | Les agents entrent dans les processus métier critiques | Ajouter la gestion des accès aux données, la sécurité des agents et l’évaluation des résultats |
Pour les achats, il faut aussi vérifier que les procédures de paiement et de facturation répondent aux exigences financières de l’entreprise, ainsi que la granularité des permissions, les champs des journaux, leur durée de conservation et leurs modalités d’export. Ces éléments varient beaucoup d’une plateforme à l’autre : mieux vaut les confirmer un par un auprès du fournisseur avant de signer et se référer à sa documentation officielle.
Pour le secteur
Lors de la conférence, Buddy One a proposé un pool de crédits partagé et une gestion centralisée. Cela montre que l’allocation centralisée des quotas des modèles comme ressource commune à l’équipe devient une approche standard dans les produits d’IA destinés aux entreprises. On peut s’attendre à ce que la visibilité sur l’utilisation et l’affectation des coûts deviennent des exigences de base des clients professionnels, et non plus de simples atouts, qu’il s’agisse de suites proposées par de grands acteurs ou de plateformes indépendantes d’agrégation de modèles.
💡 Conseil : avant un déploiement à grande échelle, réalisez un projet pilote limité avec des données métier réelles. Avec APIYI apiyi.com, vous pouvez invoquer des modèles de plusieurs fournisseurs, comparer leurs résultats et leur consommation de tokens pour une même tâche, puis choisir le modèle par défaut de l’équipe.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que la « gouvernance de la couche d’invocation des modèles » pour une équipe qui utilise l’IA ?
C’est la gestion centralisée de l’accès de l’équipe aux grands modèles de langage : quels modèles utiliser, qui détient les clés, quelle est la consommation de chaque projet et si chaque invocation peut être retracée. Elle ne prend pas en charge la logique métier des agents, mais garantit que toutes les invocations passent par un point d’accès contrôlable.
Q2 : Quelle est la différence entre une couche d’invocation unifiée et une plateforme d’agents d’entreprise ?
Une plateforme d’agents d’entreprise s’intéresse à la façon dont les agents se connectent aux systèmes métier, accèdent aux données, collaborent et fonctionnent sur de longues périodes. La couche d’invocation des modèles ne concerne que l’étape d’appel au modèle. La première couvre donc un périmètre plus large, mais dépend elle aussi d’un accès stable et contrôlé aux modèles sous-jacents. Les deux occupent des niveaux différents et ne se remplacent pas.
Q3 : Une petite équipe doit-elle s’en préoccuper dès maintenant ?
Oui, mais elle peut commencer par une version légère. Les deux mesures les plus utiles sont d’unifier l’interface d’invocation et d’éviter d’intégrer des clés personnelles dans le code de production. Elles coûtent peu à mettre en place, alors qu’il sera bien plus compliqué de corriger la situation une fois l’équipe agrandie.
Q4 : Comment mettre rapidement en place un point d’accès commun aux modèles pour l’équipe ?
Une solution simple consiste à choisir une plateforme d’agrégation compatible avec OpenAI. Par exemple, après vous être inscrit sur APIYI apiyi.com et avoir obtenu une clé API, remplacez le `base_url` dans votre code par `https://api.apiyi.com/v1`. Vous pourrez alors invoquer les modèles OpenAI, Claude, Gemini et d’autres avec le même code, puis utiliser la fonction d’encapsulation présentée dans cet article pour enregistrer la consommation par projet.
Q5 : Une plateforme d’agrégation peut-elle remplacer directement le système d’autorisations de l’équipe ?
Pas complètement. La plateforme peut contrôler l’accès aux modèles et la facturation, mais la granularité des autorisations par membre et par projet, les plafonds d’utilisation et les politiques de conservation des journaux varient selon la plateforme. Il faut donc consulter sa documentation. Les autorisations d’accès aux données métier et d’action des agents doivent, quant à elles, être gérées par les systèmes propres à l’entreprise. Avant de planifier votre mise en place, vous pouvez vérifier les fonctionnalités disponibles dans le centre de documentation d’APIYI apiyi.com.
Points clés pour la couche d’invocation des modèles en équipe
- La productivité individuelle ne suffit pas à renforcer l’organisation : quand une équipe partage les capacités des modèles, les problèmes de gestion apparaissent souvent avant les limites des modèles eux-mêmes.
- Unifier d’abord le point d’entrée : les appels doivent passer par une même couche pour pouvoir appliquer des règles d’accès et de coûts.
- Distribuer les clés par projet : une clé par service permet de la révoquer rapidement en cas de fuite ou de départ.
- Attribuer les coûts aux projets : l’application doit renseigner le projet et l’appelant pour faciliter le rapprochement des coûts en fin de mois.
- La passerelle a ses limites : les autorisations d’accès aux données, la sécurité des agents et l’évolution des processus doivent être prises en charge ailleurs.
- Démarrer à moindre coût : APIYI apiyi.com permet d’accéder à plusieurs modèles avec une seule clé et de lancer un premier projet pilote.
Conclusion
Lors de la discussion sur les agents en entreprise sur Tencent Meeting, l’essentiel n’était pas de savoir à quel point un agent est performant, mais comment l’organisation peut intégrer ces capacités. Pour les responsables qui souhaitent déployer l’IA dans leur équipe, la couche d’invocation des modèles est l’une des premières à pouvoir être mise en place, et pourtant l’une des plus faciles à négliger :
- L’accès aux modèles doit rester interchangeable : utilisez une interface compatible commune et rendez le nom du modèle configurable.
- Les accès et les coûts doivent être visibles : distribuez les clés et regroupez les usages par projet pour éviter les comptes difficiles à démêler.
- L’expérience doit être réutilisable : faites des invites et des processus validés des ressources partagées par l’équipe.
L’engouement passera, mais cette liste de vérification restera utile pour déployer l’IA dans une équipe, quelle que soit sa taille. Commencez par un ou deux cas d’usage métier, vérifiez que le point d’entrée et le suivi des usages fonctionnent, puis élargissez progressivement le périmètre. APIYI apiyi.com permet de tester rapidement l’accès unifié à plusieurs modèles, avec un crédit de test gratuit et une facturation à l’usage.
📚 Références
- GeekPark – Pourquoi une personne peut-elle bien utiliser l’IA, alors qu’une entreprise n’y parvient pas ? : article sur les annonces relatives aux agents d’entreprise lors de la conférence mondiale Tencent sur l’écosystème numérique
- Lien :
geekpark.net/news/373541 -
Description : informations sur la mise à niveau de WorkBuddy Enterprise, Buddy One, le cas Suning et Agent Runtime
-
Documentation de l’API OpenAI : description de l’interface Chat Completions et du champ usage
- Lien :
platform.openai.com/docs - Description : pour comprendre la structure des requêtes des interfaces compatibles et le calcul des tokens
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI, apiyi.com. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.


