
Nota do autor: a partir da ideia de que “a produtividade individual não significa necessariamente uma organização mais forte”, apresentada na Conferência Global de Ecossistemas Digitais da Tencent, vamos analisar cinco mecanismos de gestão que as equipes precisam estabelecer na camada de invocação do modelo ao usar IA.
No início de novembro de 2026, a Conferência Global de Ecossistemas Digitais da Tencent teve um palco dedicado ao lançamento de produtos de IA, com mais de 40 apresentações em dois dias. Uma observação merece atenção: a produtividade individual não significa necessariamente uma organização mais forte; entre as duas, existe todo um conjunto de capacidades organizacionais. A frase é de Zhang Xiyao, vice-gerente geral da Tencent Cloud e responsável pelo produto empresarial WorkBuddy.
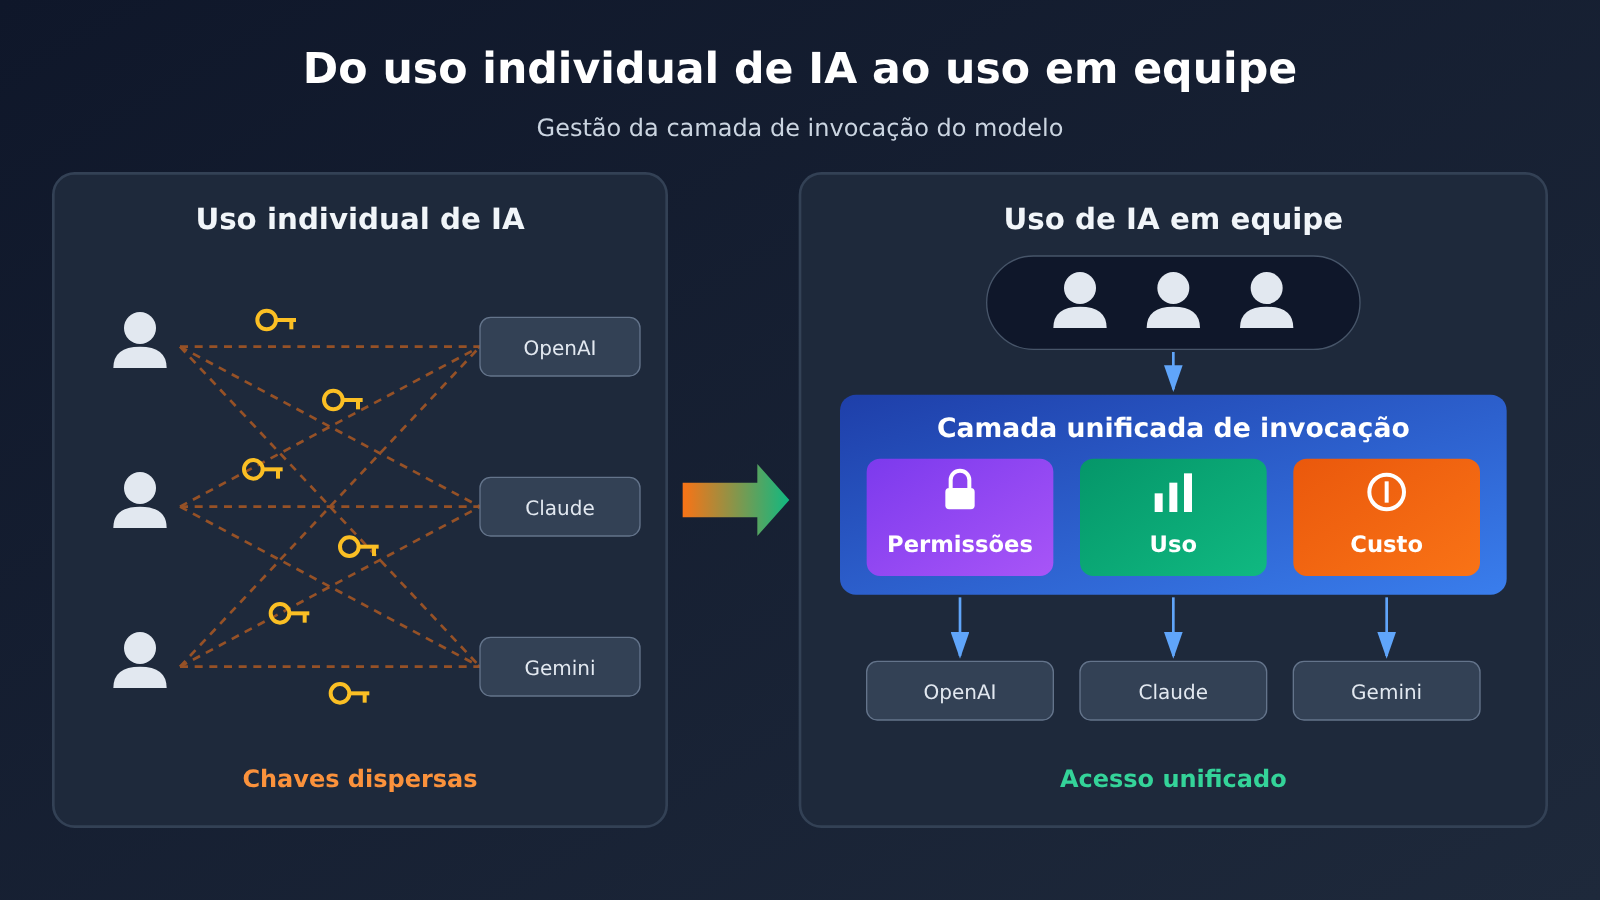
Este não é mais um resumo de lançamentos de produtos de agentes de IA. A ideia aqui é discutir uma questão mais fundamental: quando o uso de IA passa do indivíduo para a equipe, todos compartilham o mesmo conjunto de recursos de modelos. Quem pode invocar os modelos, quanto cada pessoa usou e em qual projeto o dinheiro foi gasto: tudo isso precisa ser gerenciado desde a camada de invocação do modelo.
O que você vai levar: ao terminar a leitura, você terá um roteiro de verificação para antes de ampliar o uso de IA na equipe. Ele cobre acesso aos modelos, chaves e permissões, atribuição de custos, rastreamento de invocações e compartilhamento de aprendizados. Também deixa claro quais problemas um gateway unificado pode resolver e quais ficam fora do seu alcance.
Resumo: o essencial sobre o uso de IA em equipe
Vamos começar pelo contexto da discussão. As informações da tabela vêm da cobertura do evento pelo GeekPark.
| Item | Detalhes |
|---|---|
| Evento | Palco de lançamentos de produtos de IA na Conferência Global de Ecossistemas Digitais da Tencent: dois dias, sete temas e mais de 40 lançamentos de produtos |
| Conclusão central | Aumentar a produtividade individual não significa fortalecer a organização; entre uma coisa e outra, é preciso desenvolver toda uma capacidade organizacional |
| Principais melhorias da versão empresarial | Plataforma aberta para conectar sistemas de negócios; solução de segurança empresarial e centro de observabilidade para gerenciar permissões, processos de execução e custos de uso; agentes hospedados com suporte a operação 24 horas por dia, 7 dias por semana |
| Pacote complementar | Buddy One oferece conta unificada, pool compartilhado de Credits e gestão centralizada, com o objetivo de simplificar a configuração e a adoção de IA nas empresas |
| Caso de implementação | A Suning criou uma plataforma de agentes para toda a organização, abrangendo 14 departamentos e 48 cenários de colaboração, com 36 agentes reutilizáveis |
| Desafio de escala | Se cada Agent precisar de um ambiente de execução independente, operar 100 mil funcionários digitais pode significar 100 mil sandboxes |
Três questões práticas para equipes que usam IA
Segundo a reportagem, as empresas precisam responder a três perguntas ao adotar Agents: eles conseguem se conectar aos sistemas existentes e acessar os dados necessários? Como gerenciar as permissões de diferentes funcionários e Agents? Como fazer com que um bom método descoberto por uma pessoa possa ser usado diretamente pelas outras? Essas questões se aplicam a qualquer equipe que queira adotar IA, independentemente do fornecedor escolhido.
Vale notar que, nas melhorias da versão empresarial, “permissões, processos de execução e custos de uso” são tratados no mesmo módulo. O pool compartilhado de Credits também é apresentado como uma forma de simplificar a adoção. Isso mostra que, quando a IA deixa de ser uma ferramenta individual e passa a ser um recurso da equipe, o controle de acesso e a apuração de custos já são questões de infraestrutura, não correções para depois.
Por que a camada de invocação do modelo é o primeiro ponto de controle para equipes que usam IA
Quando cada pessoa usa IA por conta própria, o cenário costuma ser assim: cada uma cria contas em alguns serviços de modelos, cadastra seu próprio cartão, guarda suas próprias chaves API e fixa os endereços de chamada nos próprios scripts ou ferramentas. Isso funciona bem na fase de exploração, mas, à medida que a equipe cresce, os problemas começam a se acumular.
Entre os problemas mais comuns estão: chaves espalhadas por computadores pessoais e históricos de conversa, sem que ninguém saiba dizer quantas estão em uso quando alguém sai da equipe; faturas de fim de mês que mostram apenas o total, sem identificar qual projeto ou pessoa gerou o gasto; e modelos que, de repente, apresentam erros ou ficam mais caros, exigindo alterações em cada lugar onde a chamada foi fixada no código. Nada disso tem relação com a capacidade dos agentes: o problema é a falta de gestão centralizada na camada de invocação do modelo.
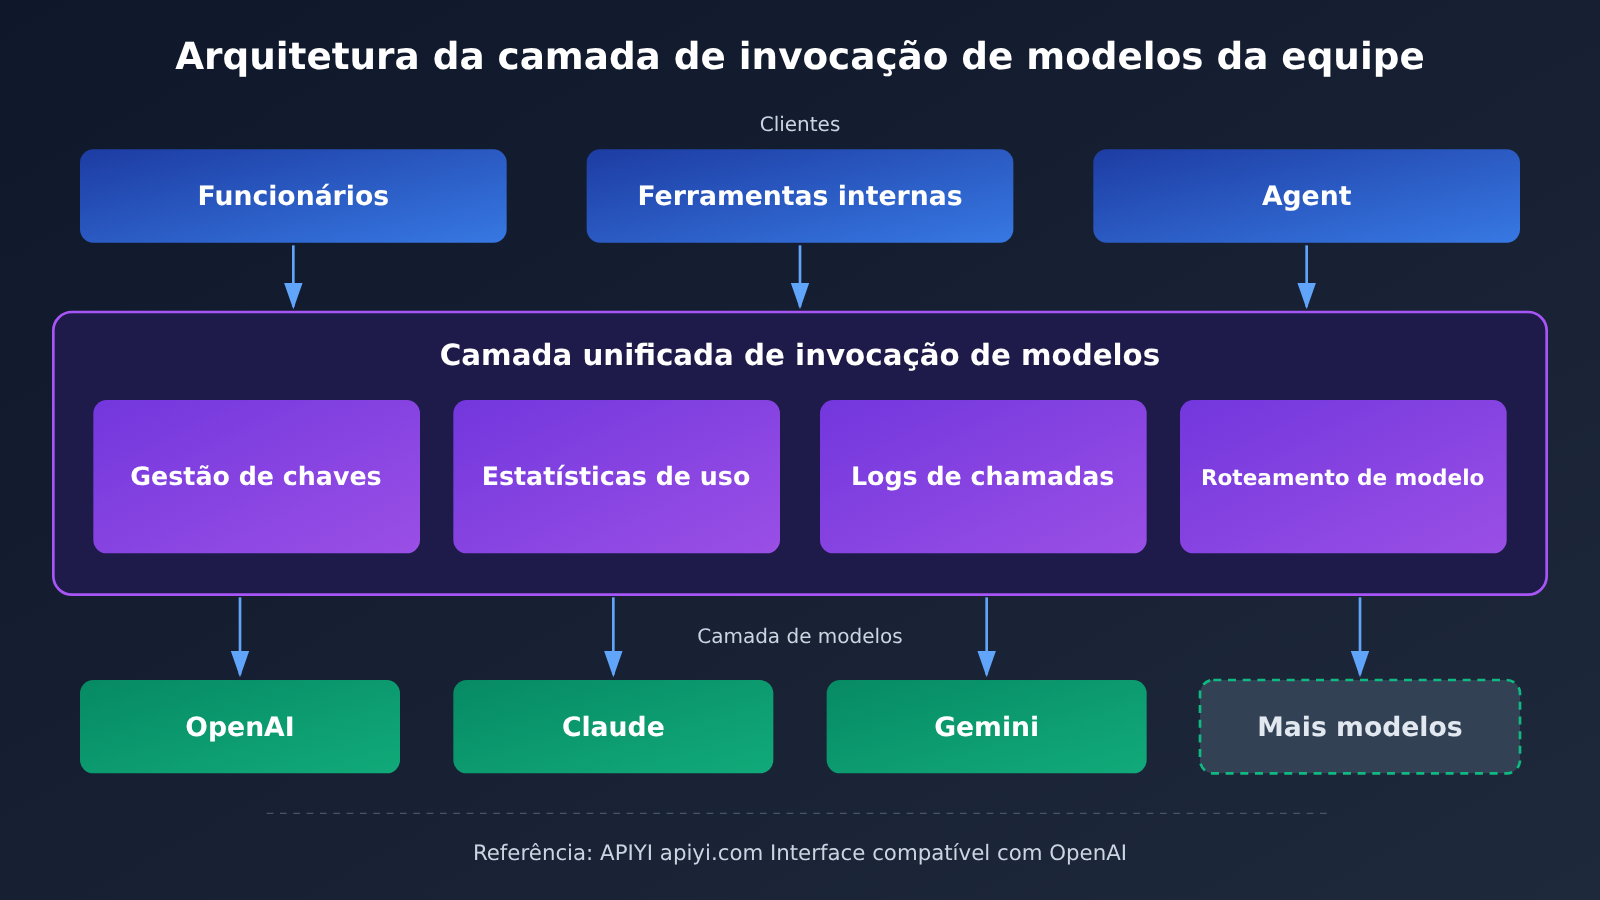
Ao concentrar as chamadas em uma única camada, a equipe passa a ter um ponto onde pode aplicar regras de forma centralizada. “Organizar primeiro” não significa criar processos complexos de aprovação logo de cara. O primeiro passo é garantir que todas as chamadas passem pelo mesmo ponto de entrada, criando uma base para gerenciar permissões, uso e custos.
Checklist de 5 itens para a camada de invocação de modelos antes de usar IA na equipe
Este checklist não está vinculado a nenhum fornecedor. Você pode usá-lo para avaliar um gateway próprio, uma solução de provedor de nuvem ou uma plataforma agregadora de terceiros.
| Item | Pergunta a responder | Prática mínima viável |
|---|---|---|
| 1. Acesso aos modelos | De quais modelos a equipe precisa? Quanto código é preciso alterar para trocar de modelo? | Usar uma interface compatível com a OpenAI e definir o nome do modelo como configuração |
| 2. Chaves e permissões | Quem tem acesso às chaves? É possível revogá-las rapidamente em caso de desligamento ou vazamento? | Distribuir chaves por projeto ou serviço e proibir o uso de chaves pessoais no código de produção |
| 3. Atribuição de custos | Quanto cada projeto e cada equipe gastou? | Diferenciar o consumo por chave ou projeto e gerar um detalhamento mensal da fatura |
| 4. Rastreamento de invocações | Em caso de problema, é possível identificar a invocação e o modelo usados? | Registrar o horário da solicitação, o modelo, o número de tokens e a identificação de quem fez a chamada |
| 5. Reaproveitamento de experiências | Outras pessoas conseguem usar diretamente bons comandos e fluxos de trabalho? | Transformar comandos e parâmetros validados em templates compartilhados ou serviços internos |
Itens 1 e 2: acesso aos modelos e permissões das chaves
O ponto-chave do acesso aos modelos é a possibilidade de substituí-los. Modelos diferentes se destacam em tarefas diferentes, e seus preços e sua estabilidade também mudam. Se o código da aplicação depende apenas de uma interface compatível e o nome do modelo fica na configuração, trocar de modelo exige apenas uma alteração na configuração, sem precisar desenvolver tudo de novo.
Já o ponto-chave das permissões é a possibilidade de revogá-las. A recomendação é usar uma chave por serviço e uma cota por projeto, em vez de compartilhar uma chave com acesso total entre toda a equipe. Assim, se uma chave vazar, o impacto fica limitado àquele serviço e, após a revogação, as demais aplicações continuam funcionando normalmente.
Itens 3 a 5: atribuição de custos, rastreamento de invocações e reaproveitamento de experiências
A atribuição de custos determina se o investimento em IA pode ser reconhecido pelas áreas de negócio. Se você só consegue ver a fatura total, não dá para saber quais aplicações realmente geraram valor, e fica difícil solicitar orçamento à gestão. Já o rastreamento de invocações é essencial para investigar problemas: quando um usuário relata que “a resposta da IA estava errada”, você precisa conseguir identificar qual modelo foi usado e o que foi enviado naquela chamada.
O reaproveitamento de experiências segue a ideia do caso da Suning: organizar o processo de lançamento de novos produtos em templates e incluir os arquivos do processo na base de conhecimento. Com isso, o tempo de preparação caiu de 3 dias úteis para 4 horas, e o método ficou registrado para ser usado novamente. Na camada de invocação de modelos, isso significa reunir comandos validados, escolhas de modelo e combinações de parâmetros, em vez de deixar esse conhecimento apenas na cabeça de uma pessoa.
Exemplo de invocação unificada de IA para equipes
A seguir, um exemplo mínimo: a invocação do modelo usa uma interface compatível com a OpenAI, e o nome do modelo é lido de uma variável de ambiente. Assim, a equipe pode trocar de modelo de forma unificada.
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # Chave distribuída por projeto
    base_url="https://api.apiyi.com/v1"          # Interface unificada da APIYI
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
Veja a versão para equipes com registro de chamadas
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # Uma chave para acessar modelos de vários provedores
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """Ponto de acesso unificado da equipe: registra projeto, solicitante, modelo e uso de tokens"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # Grava no log local, que pode ser importado depois para relatórios de custos por projeto
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
Essa versão acrescenta duas dimensões no lado da aplicação: “projeto” e “solicitante”. Mesmo que a plataforma já ofereça estatísticas de uso, manter seus próprios registros de chamadas é útil, pois só o seu sistema sabe a qual contexto de negócio cada chamada pertence.
🚀 Começo rápido: se a equipe ainda está na fase em que cada pessoa usa suas próprias chaves, é possível começar acessando modelos populares como OpenAI, Claude e Gemini com uma única chave API pela APIYI apiyi.com. A plataforma usa uma interface compatível com a OpenAI, cobra conforme o uso e oferece créditos gratuitos para testes a novos usuários. É uma opção para começar a testar um ponto de acesso unificado.
O que uma camada unificada de invocação de modelos resolve — e o que não resolve
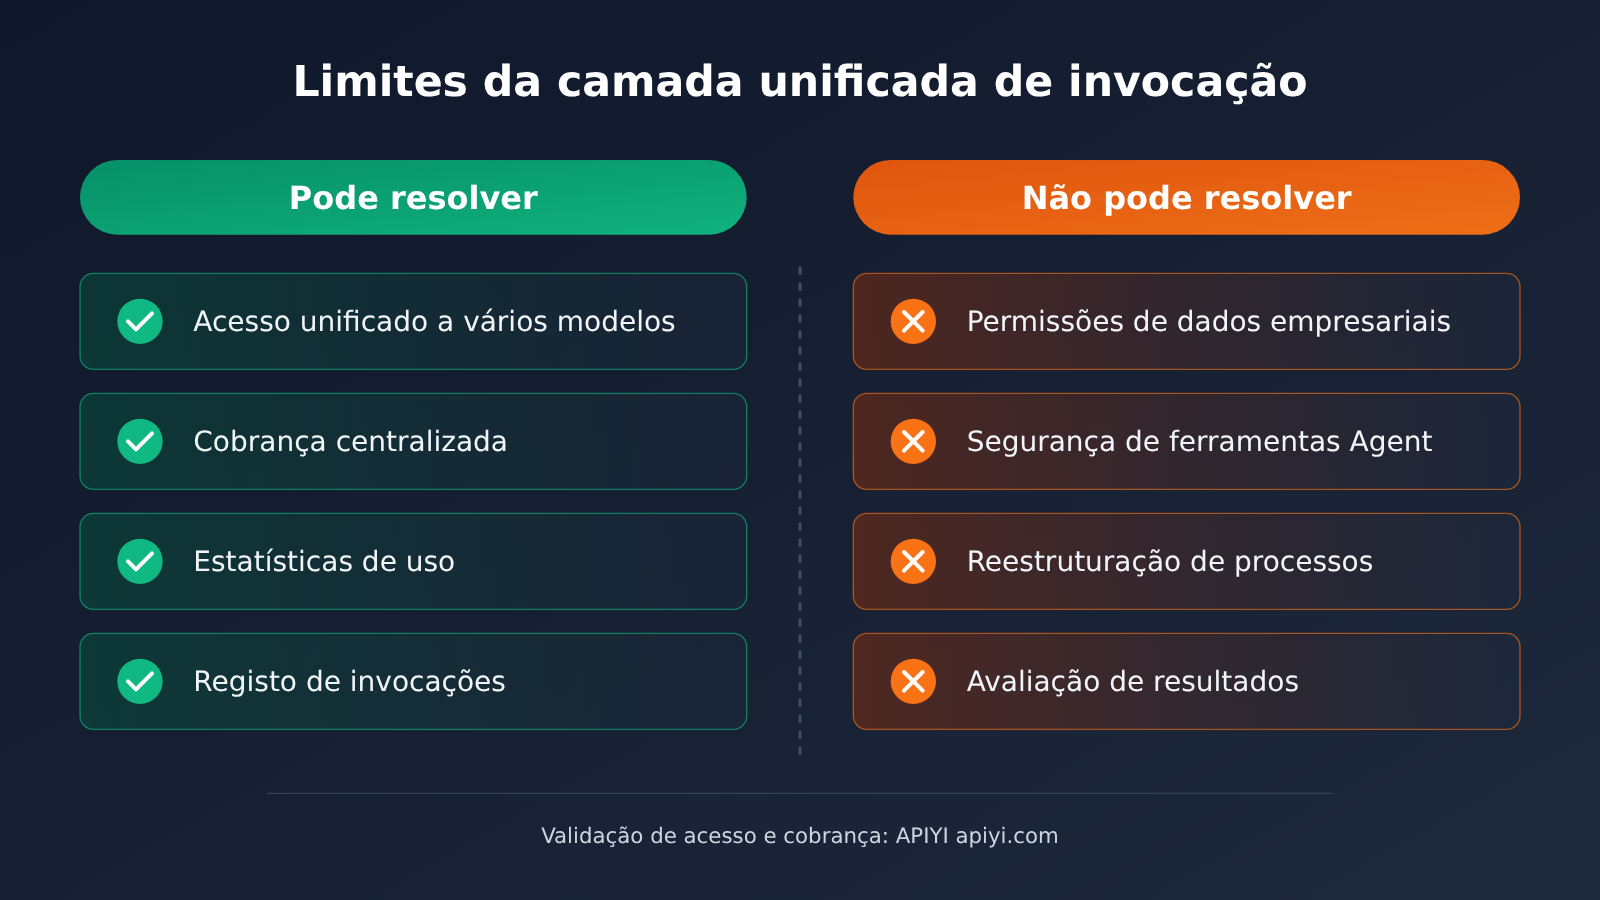
Muitas equipes acabam imaginando que um gateway unificado é “a resposta para toda a governança de IA”. Na prática, ele cuida apenas da camada de invocação do modelo. A tabela abaixo deixa esses limites mais claros.
| Dimensão | O que a camada unificada resolve | O que ainda depende de outras etapas |
|---|---|---|
| Acesso aos modelos | Uma interface para chamar modelos de vários provedores, com baixo custo de troca | Decidir qual modelo é mais adequado para cada caso de uso |
| Custos | Saldo centralizado e cobrança por uso, facilitando a consolidação | Relacionar custos aos resultados de negócio e avaliar o ROI |
| Permissões | Controlar “quem pode chamar o modelo” | Controlar “quais dados o agente pode ler e quais operações pode executar” |
| Rastreamento | Registrar modelo, tokens e tempo de cada chamada | Acompanhar toda a cadeia de execução do agente e a qualidade dos resultados |
| Reutilização | Oferecer um ponto de acesso estável para as chamadas | Consolidar comandos, modelos de processos e bases de conhecimento |
Isso também explica por que a Tencent lançou, no evento, uma solução de segurança, uma central de observabilidade, o Agent Runtime e produtos de conhecimento. Segundo a reportagem, agentes podem chamar ferramentas, acessar dados e até executar código por conta própria. Por isso, é importante limitar o escopo das operações, proteger informações sensíveis e rastrear as causas quando algo dá errado. Essas questões pertencem às camadas de execução dos agentes e de dados, fora do alcance do gateway de modelos.
A sequência mais razoável, portanto, é: primeiro, unificar a camada de invocação dos modelos para dar visibilidade ao acesso e aos gastos; depois, acrescentar permissões de dados, segurança dos agentes e mudanças nos processos. Sem visibilidade da camada de base, não há como governar as camadas superiores.
Análise do impacto do uso de IA pelas equipes
Impacto para líderes técnicos
- Reserve um ponto de entrada unificado na arquitetura: ao integrar um Modelo de Linguagem Grande a um novo projeto, evite fixar diretamente o endereço oficial de um fornecedor no código. Use sempre a interface compatível definida pela equipe.
- Inclua o gerenciamento de chaves nas operações: a chave API deve seguir o mesmo processo de gestão de segredos usado para senhas de banco de dados, com registros de emissão, rotação e revogação.
- Defina os campos de log com antecedência: no mínimo, projeto, solicitante, modelo e consumo de tokens precisam estar associados. Caso contrário, será difícil reconciliar os custos no fim do mês.
Impacto para decisores de negócios e equipes de compras
Na contratação de recursos de IA, o foco da avaliação passa de “qual é o modelo mais poderoso” para “conseguimos gerenciá-lo?”. A tabela abaixo mostra as prioridades em cada estágio da equipe, como referência para planejar a adoção.
| Estágio da equipe | Situação típica | Prioridades na camada de invocação do modelo |
|---|---|---|
| Exploração individual | Algumas pessoas testam por conta própria e têm suas próprias chaves | Escolher uma interface unificada e consolidar as contas dispersas |
| Projeto-piloto em grupo | Um ou dois projetos começam a depender de IA | Distribuir chaves por projeto e criar estatísticas básicas de uso |
| Adoção no departamento | Várias áreas de negócio fazem chamadas ao mesmo tempo | Consolidar custos por projeto e permitir a consulta dos registros de chamadas |
| Uso em toda a organização | Agentes entram nos principais processos de negócio | Acrescentar permissões de dados, segurança dos agentes e avaliação de resultados |
Para a equipe de compras, também é importante verificar se os processos de pagamento e documentação fiscal atendem às exigências financeiras da empresa, além de avaliar a granularidade das permissões, os campos de log, o período de retenção e as opções de exportação da plataforma. Esses detalhes variam bastante entre fornecedores. Por isso, vale confirmar cada item antes de assinar o contrato e tomar a documentação oficial do fornecedor como referência.
Impacto para o setor
Na conferência, o Buddy One apresentou um pool compartilhado de Credit e gerenciamento centralizado. Isso mostra que tratar a capacidade de uso dos modelos como um recurso compartilhado e distribuído de forma centralizada está se tornando uma abordagem padrão nos produtos de IA para empresas. Tudo indica que, tanto em suítes de grandes empresas quanto em plataformas independentes de agregação de modelos, a visibilidade do uso e a consolidação de custos serão requisitos básicos dos clientes corporativos, e não mais diferenciais.
💡 Sugestão para escolher: antes de ampliar a adoção, faça um piloto em pequena escala com dados reais do negócio. Com a APIYI apiyi.com, você pode invocar modelos de vários fornecedores, comparar os resultados e o consumo de tokens de cada um na mesma tarefa e, então, escolher o modelo padrão da equipe.
Perguntas frequentes (FAQ)
Q1: O que é a “governança da camada de invocação de modelos” no uso de IA por equipes?
É o gerenciamento centralizado de como a equipe acessa os Modelos de Linguagem Grande: quais modelos são usados, quem possui as chaves, quanto cada projeto consome e se é possível rastrear cada invocação. Essa camada não cuida da lógica de negócio dos Agents; ela garante que todas as invocações passem por um ponto de acesso gerenciável.
Q2: Qual é a diferença entre uma camada unificada de invocação de modelos e uma plataforma empresarial de Agents?
Uma plataforma empresarial de Agents cuida de como os Agents se conectam aos sistemas de negócio, acessam dados, colaboram e executam tarefas de longa duração. Já a camada de invocação de modelos se concentra apenas na etapa de invocar o modelo. A primeira tem um escopo mais amplo, mas também depende de um acesso estável e controlado aos modelos. Elas atuam em camadas diferentes e não se substituem.
Q3: Uma equipe pequena precisa fazer isso agora?
Sim, mas pode começar com uma versão simples. As duas medidas mais importantes são unificar a interface de invocação e impedir que chaves pessoais entrem no código de produção. Ambas têm baixo custo, e corrigir isso depois que a equipe crescer será bem mais trabalhoso.
Q4: Como criar rapidamente um ponto de acesso unificado para a invocação de modelos pela equipe?
Uma opção simples é usar uma plataforma de agregação compatível com OpenAI. Por exemplo, depois de se cadastrar na APIYI apiyi.com e obter uma chave API, substitua o base_url no código por `https://api.apiyi.com/v1`. Assim, você pode usar o mesmo código para invocar modelos como OpenAI, Claude e Gemini e, com a função de encapsulamento apresentada neste artigo, registrar o uso por projeto.
Q5: Uma plataforma de agregação pode substituir diretamente o sistema de permissões da equipe?
Não completamente. A plataforma pode controlar o acesso aos modelos e a cobrança, mas o nível de detalhamento das permissões por membro e por projeto, os limites de uso e as políticas de retenção de logs variam entre plataformas. Consulte a documentação de cada uma. Já as permissões de acesso aos dados de negócio e de operação dos Agents devem ficar sob responsabilidade dos sistemas da própria empresa. Antes de planejar a implementação, confira os recursos disponíveis na central de documentação da APIYI apiyi.com.
Principais pontos sobre a camada de invocação de modelos de IA para equipes
- Ganhos individuais de produtividade não tornam a organização mais forte automaticamente: quando uma equipe compartilha recursos de modelos, os problemas de gestão aparecem antes das limitações dos modelos.
- Unifique o ponto de acesso antes de pensar em governança: só quando todas as chamadas passam pela mesma camada é possível aplicar regras de permissão e custo.
- Distribua chaves por projeto: use uma chave para cada serviço, para poder revogá-la rapidamente em caso de vazamento ou desligamento.
- Atribua os custos aos projetos: inclua campos de projeto e de quem faz a chamada na aplicação para facilitar a conciliação no fim do mês.
- O gateway tem limites: permissões de dados, segurança de Agents e mudanças nos processos precisam ser tratadas em outras frentes.
- Comece com baixo custo: com a APIYI apiyi.com, é possível acessar vários modelos usando uma única chave e colocar um projeto-piloto em prática.
Resumo
Na conferência da Tencent, a discussão sobre Agents empresariais não se concentrou em quão poderoso é um Agent específico, mas em como as organizações podem incorporar esses recursos. Para quem pretende incentivar o uso de IA na equipe, a camada de invocação do modelo é uma das primeiras que podem ser implementadas — e também uma das mais fáceis de ignorar:
- O modelo deve ser substituível: use uma interface compatível e unificada e deixe o nome do modelo como configuração.
- Permissões e custos devem ser visíveis: distribua chaves por projeto e registre o uso para evitar contas confusas.
- A experiência deve ser reutilizável: transforme comandos e processos já validados em recursos compartilhados pela equipe.
O entusiasmo do momento vai passar, mas esta lista de verificação continua útil para equipes de qualquer tamanho que queiram adotar IA. Comece com um ou dois cenários de negócio como projeto-piloto, implemente o ponto de acesso e o registro de uso e, depois, amplie o escopo aos poucos. A APIYI apiyi.com é uma opção para validar rapidamente o acesso unificado a vários modelos: a plataforma oferece crédito gratuito para testes e cobrança conforme o uso.
📚 Referências
- GeekPark – Por que uma pessoa consegue usar bem a IA, mas uma empresa não?: reportagem sobre os anúncios relacionados a agentes empresariais na Conferência Global de Ecossistema Digital da Tencent
- Link:
geekpark.net/news/373541 -
Descrição: informações sobre a atualização da versão empresarial do WorkBuddy, o Buddy One, o caso da Suning e o Agent Runtime
-
Documentação da API da OpenAI: informações sobre a interface Chat Completions e o campo usage
- Link:
platform.openai.com/docs - Descrição: ajuda a entender a estrutura das requisições em interfaces compatíveis e a contagem de tokens
Autor: Equipe técnica da APIYI
Troca de ideias técnicas: entre em contato conosco pela página inicial do site oficial da APIYI, apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com


