
Nota del autor: a partir de una idea planteada en la Conferencia Global de Ecosistemas Digitales de Tencent —«mejorar la productividad individual no equivale a fortalecer la organización»—, analizamos cinco mecanismos de gestión que conviene establecer en la capa de invocación de modelos cuando un equipo usa IA.
A principios de noviembre de 2026, la Conferencia Global de Ecosistemas Digitales de Tencent contó con un escenario dedicado al lanzamiento de productos de IA, donde se presentaron más de 40 productos en dos días. Una de las ideas que se plantearon merece atención: mejorar la productividad individual no equivale a fortalecer la organización; entre ambas cosas hay todo un conjunto de capacidades organizativas. La frase es de Zhang Xiyao, vicepresidente de Tencent Cloud y responsable de WorkBuddy para empresas.
Este no es otro resumen del lanzamiento de un producto Agent. Aquí queremos abordar una cuestión más fundamental: al pasar del uso individual de la IA al trabajo en equipo, todos comparten las capacidades de un mismo conjunto de modelos. Quién puede invocarlos, cuánto usa cada persona y a qué proyecto se asigna el gasto son cuestiones que conviene gestionar desde la capa de invocación del modelo.
Qué te llevarás: una guía para revisar lo necesario antes de extender el uso de la IA en tu equipo. Cubre el acceso a modelos, las claves y los permisos, la asignación de costos, el seguimiento de invocaciones y la reutilización de la experiencia. También aclara qué problemas puede resolver una pasarela unificada y cuáles no.
Lo esencial sobre el uso de IA en equipos
Empecemos por los hechos de esta conversación. La información de la siguiente tabla procede de la cobertura del evento realizada por GeekPark.
| Información | Detalles |
|---|---|
| Evento | Escenario de lanzamiento de productos de IA de la Tencent Global Digital Ecosystem Conference: dos días, siete temas y más de 40 lanzamientos de productos |
| Idea central | Que las personas sean más productivas no significa que la organización sea más fuerte: entre ambas cosas hay todo un conjunto de capacidades organizativas |
| Prioridades de la actualización empresarial | Una plataforma abierta para conectar sistemas de negocio; una solución de seguridad empresarial y un centro de observabilidad para gestionar permisos, procesos de ejecución y costos de uso; agentes gestionados capaces de funcionar las 24 horas, los 7 días de la semana |
| Suite complementaria | Buddy One ofrece una cuenta unificada, un fondo compartido de Credit y administración centralizada, con el objetivo de reducir la complejidad de configurar y desplegar IA en las empresas |
| Caso de implementación | Suning creó una plataforma de agentes para toda la organización que abarca 14 departamentos y 48 escenarios de colaboración, y reúne 36 agentes reutilizables |
| Desafío de escala | Si cada Agent necesita un entorno de ejecución independiente, gestionar 100 000 empleados digitales podría requerir 100 000 entornos aislados |
Tres problemas reales al usar IA en equipo
El artículo señala que, al desplegar Agents, las empresas deben responder a tres preguntas: ¿puede el Agent conectarse a los sistemas existentes y acceder a los datos que necesita? ¿Cómo se gestionan los permisos de cada empleado y Agent? ¿Cómo pueden los demás usar directamente un buen método que una persona descubrió por su cuenta? Estas preguntas se aplican a todos los equipos que se preparan para desplegar IA, sin importar los productos que utilicen.
Cabe destacar que, en la actualización empresarial, los «permisos, procesos de ejecución y costos de uso» se tratan en un mismo módulo. También se presenta el fondo compartido de Credit como una forma de reducir la complejidad del despliegue. Esto indica que, cuando la IA pasa de ser una herramienta individual a un recurso de equipo, el control de acceso y la imputación de costos pasan a ser cuestiones de infraestructura, no parches posteriores.
Por qué la capa de invocación del modelo es el primer punto de control para un equipo que usa IA
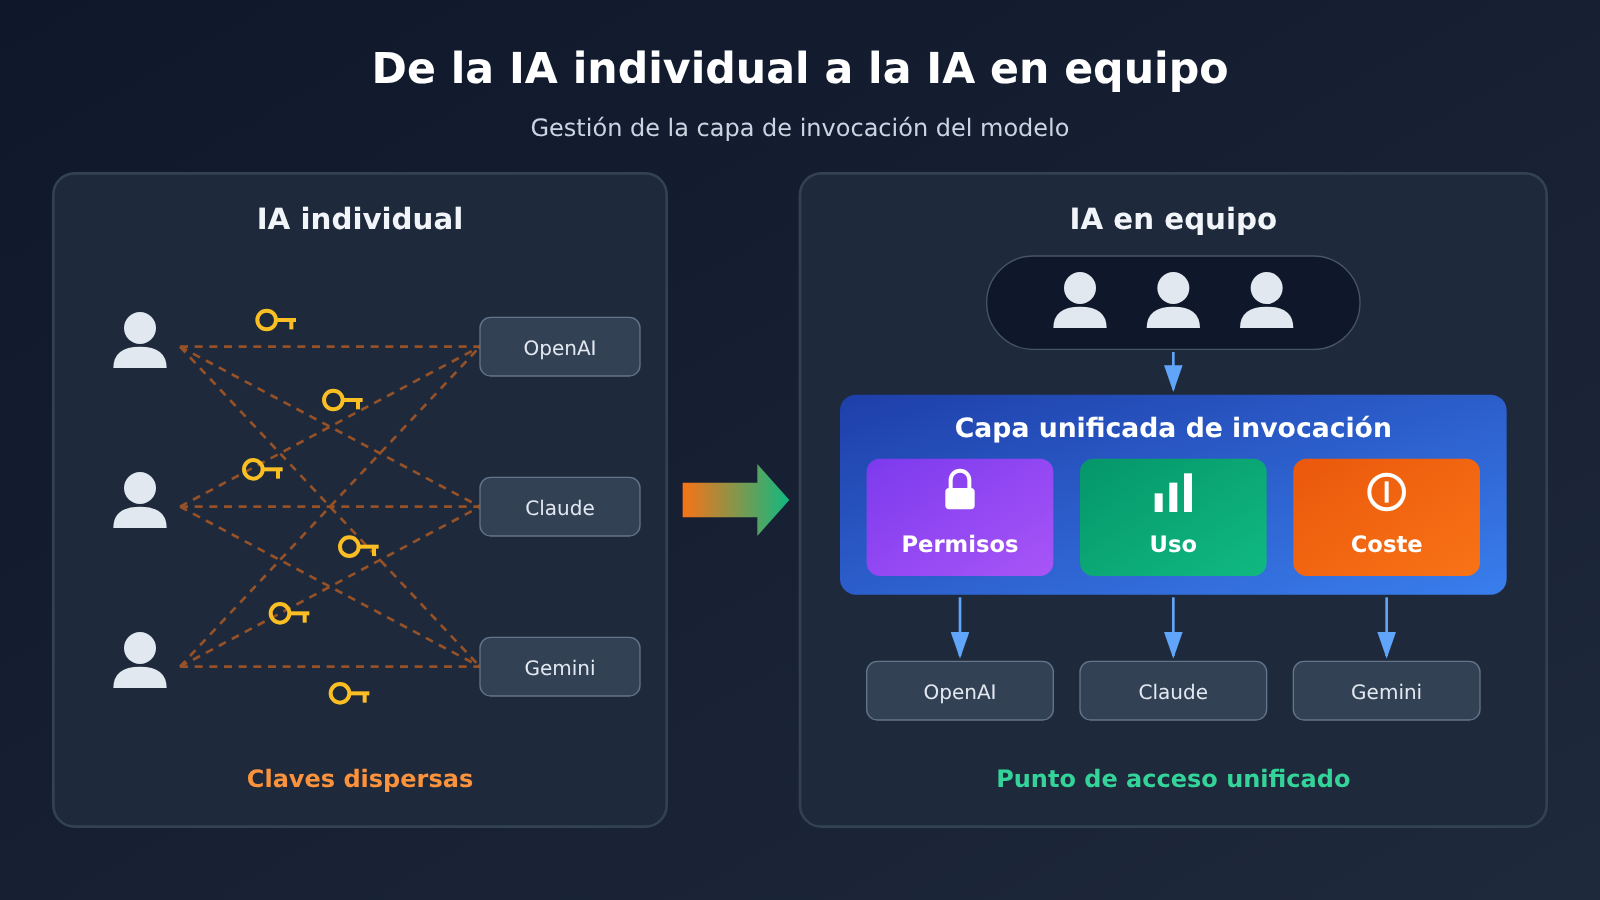
Cuando cada persona usa IA por su cuenta, lo habitual es que registre varios servicios de modelos, vincule sus propias tarjetas, guarde sus claves API y escriba directamente las direcciones de los servicios en sus scripts o herramientas. Esta forma de trabajar es muy eficiente durante la fase de exploración, pero, a medida que crece el equipo, empiezan a aparecer problemas.
Entre los más comunes están las claves dispersas en computadoras personales y conversaciones de chat, sin que nadie sepa cuántas siguen en uso cuando alguien deja el equipo; facturas mensuales que solo muestran el total, sin distinguir qué proyecto o persona generó el gasto; o errores y subidas de precio repentinas de un modelo que obligan a modificar, uno por uno, todos los lugares donde se escribió directamente la dirección del servicio. Estos problemas no dependen de las capacidades del Agent: en esencia, se deben a la falta de una gestión unificada de la capa de invocación del modelo.
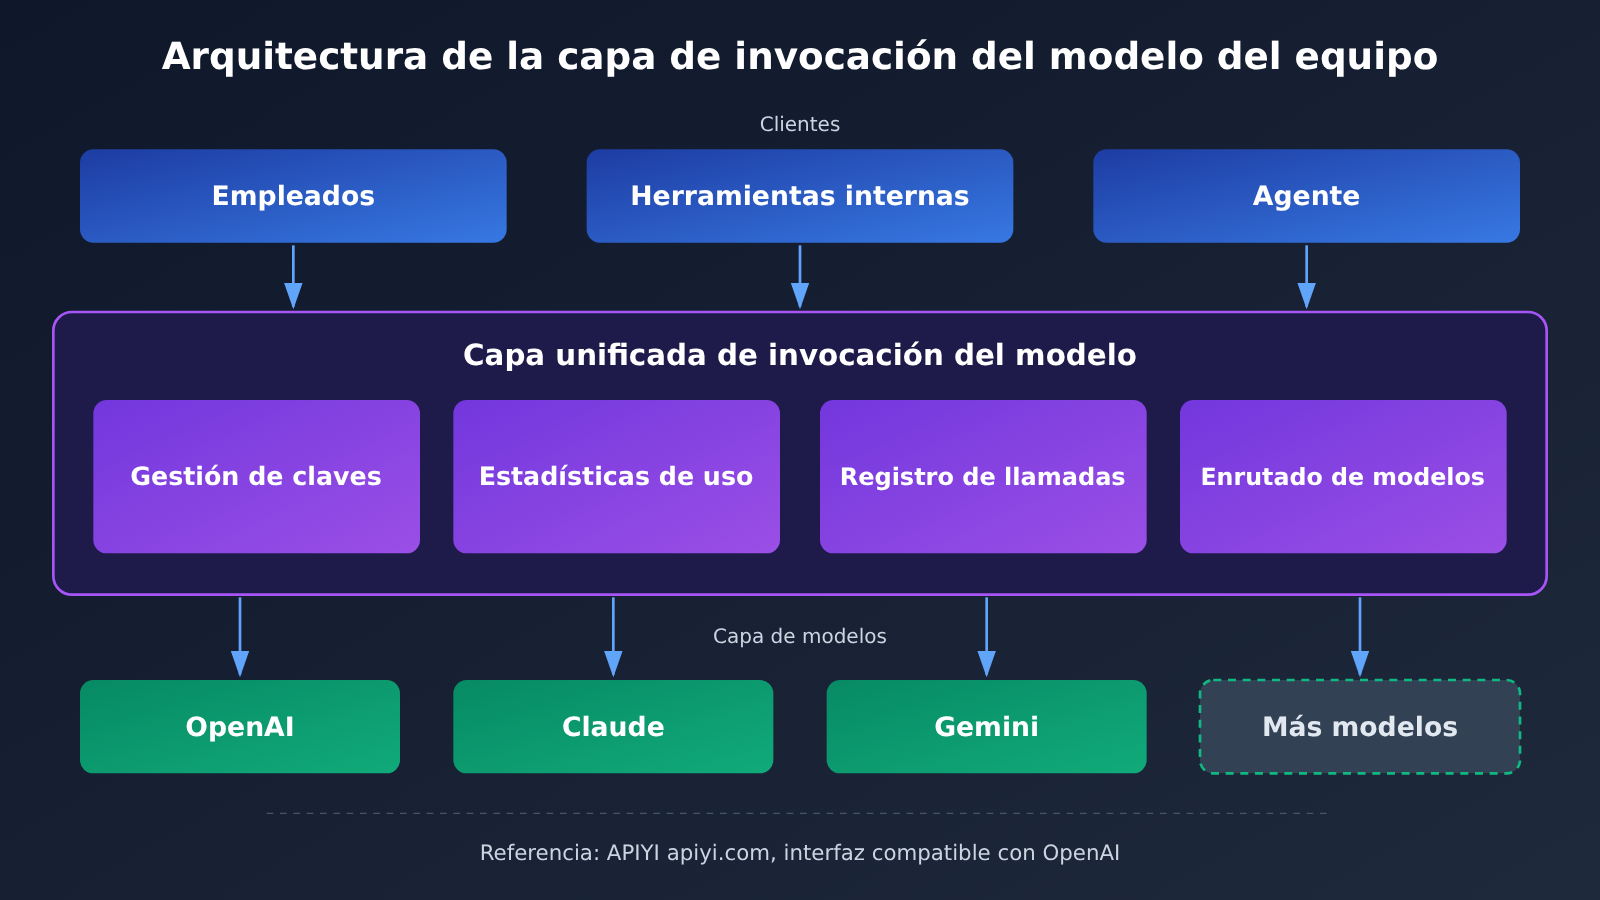
Al concentrar las invocaciones en una sola capa, el equipo dispone de un lugar donde aplicar reglas de forma unificada. «Poner orden primero» no significa crear desde el principio procesos de aprobación complejos, sino asegurar que todas las invocaciones pasen por un mismo punto de entrada. Así se sientan las bases para gestionar después los permisos, el uso y los costos.
Lista de comprobación de 5 puntos para la capa de invocación de modelos antes de usar IA en equipo
Esta lista no está ligada a ningún proveedor. Puedes usarla para evaluar una pasarela propia, una solución de un proveedor de nube o una plataforma de agregación de terceros.
| Punto de control | Preguntas que debes responder | Medida mínima viable |
|---|---|---|
| 1. Acceso a modelos | ¿Qué modelos necesita el equipo? ¿Cuánto código hay que modificar para cambiar de modelo? | Usar una interfaz compatible con OpenAI y definir el nombre del modelo como parámetro de configuración |
| 2. Claves y permisos | ¿Quién tiene las claves? ¿Se pueden revocar rápidamente si alguien deja la empresa o se produce una filtración? | Distribuir claves por proyecto o servicio y prohibir el uso de claves personales en código de producción |
| 3. Asignación de costos | ¿Cuánto ha gastado cada proyecto y cada equipo? | Como mínimo, diferenciar el consumo por clave o proyecto y generar un desglose mensual de facturación |
| 4. Trazabilidad de las invocaciones | Cuando surge un problema, ¿se puede identificar la invocación y el modelo utilizados? | Registrar la hora de la solicitud, el modelo, el número de tokens y el identificador de quien realiza la invocación |
| 5. Reutilización de conocimientos | ¿Pueden otras personas usar directamente las indicaciones y los flujos de trabajo que dan buenos resultados? | Convertir las indicaciones y los parámetros validados en plantillas compartidas o servicios internos |
Puntos 1 y 2: acceso a modelos y permisos de las claves
La clave del acceso a modelos es que sean «sustituibles». Cada modelo destaca en tareas distintas, y sus precios y estabilidad también pueden cambiar. Si el código de la aplicación depende únicamente de una interfaz compatible y el nombre del modelo está en la configuración, pasar de un modelo a otro se reduce a cambiar esa configuración, sin necesidad de volver a desarrollar.
En cuanto a los permisos, lo importante es que las claves se puedan revocar. La recomendación es asignar una clave a cada servicio y una cuota a cada proyecto, en lugar de que todo el equipo comparta una clave con permisos amplios. Así, si se filtra una clave, el impacto queda limitado a ese servicio y, al revocarla, los demás no se ven afectados.
Puntos 3 a 5: asignación de costos, trazabilidad y reutilización de conocimientos
La asignación de costos determina si las áreas de negocio pueden reconocer el valor de la inversión en IA. Si solo se ve la factura total, es imposible saber qué casos de uso generan valor y resulta difícil solicitar presupuesto a la dirección. La trazabilidad de las invocaciones, por su parte, es fundamental para investigar problemas: cuando un usuario informa de que «la IA respondió mal», necesitas poder identificar qué modelo se utilizó y qué entrada recibió.
La reutilización de conocimientos responde a la misma idea del caso de Suning: el proceso de lanzamiento de nuevos productos se convirtió en una plantilla y los archivos del proceso se incorporaron a una base de conocimiento. El tiempo de preparación pasó de 3 días laborables a 4 horas, y el método quedó documentado para poder utilizarlo directamente la próxima vez. En la capa de invocación del modelo, esto significa empaquetar las indicaciones, la selección de modelos y las combinaciones de parámetros que ya se han validado, en lugar de dejarlas solo en la cabeza de una persona.
Ejemplo de invocación unificada de IA para equipos
Este ejemplo mínimo invoca un modelo mediante una interfaz compatible con OpenAI. El nombre del modelo se lee desde una variable de entorno, lo que facilita que todo el equipo cambie de modelo de forma coordinada.
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # Clave distribuida por proyecto
    base_url="https://api.apiyi.com/v1"          # Interfaz unificada de APIYI
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
Ver la versión para equipos con registro de invocaciones
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # Una clave para invocar modelos de varios proveedores
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """Punto de invocación unificado del equipo: registra el proyecto, el llamador, el modelo y el uso de tokens"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # Escribe en un registro local para importar después los datos y agrupar los costos por proyecto
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
Esta función añade dos dimensiones en la aplicación: «proyecto» y «llamador». Aunque la plataforma ya ofrezca estadísticas de uso, mantener un registro propio de las invocaciones sigue siendo útil, porque solo tu sistema sabe a qué caso de uso pertenece cada llamada.
🚀 Inicio rápido: si tu equipo todavía usa una clave distinta por persona, puede empezar con APIYI apiyi.com para acceder a modelos como OpenAI, Claude y Gemini con una sola clave API. La plataforma ofrece una interfaz compatible con OpenAI, cobra según el uso y da crédito gratuito de prueba a los nuevos usuarios. Es una buena forma de poner en marcha un punto de invocación unificado.
Qué puede resolver una capa unificada de invocación de modelos y qué no
Muchos equipos tienden a imaginar que una puerta de enlace unificada es «la respuesta a todos los problemas de gobernanza de la IA». En realidad, solo se ocupa de la capa de invocación de modelos. Esta tabla aclara sus límites.
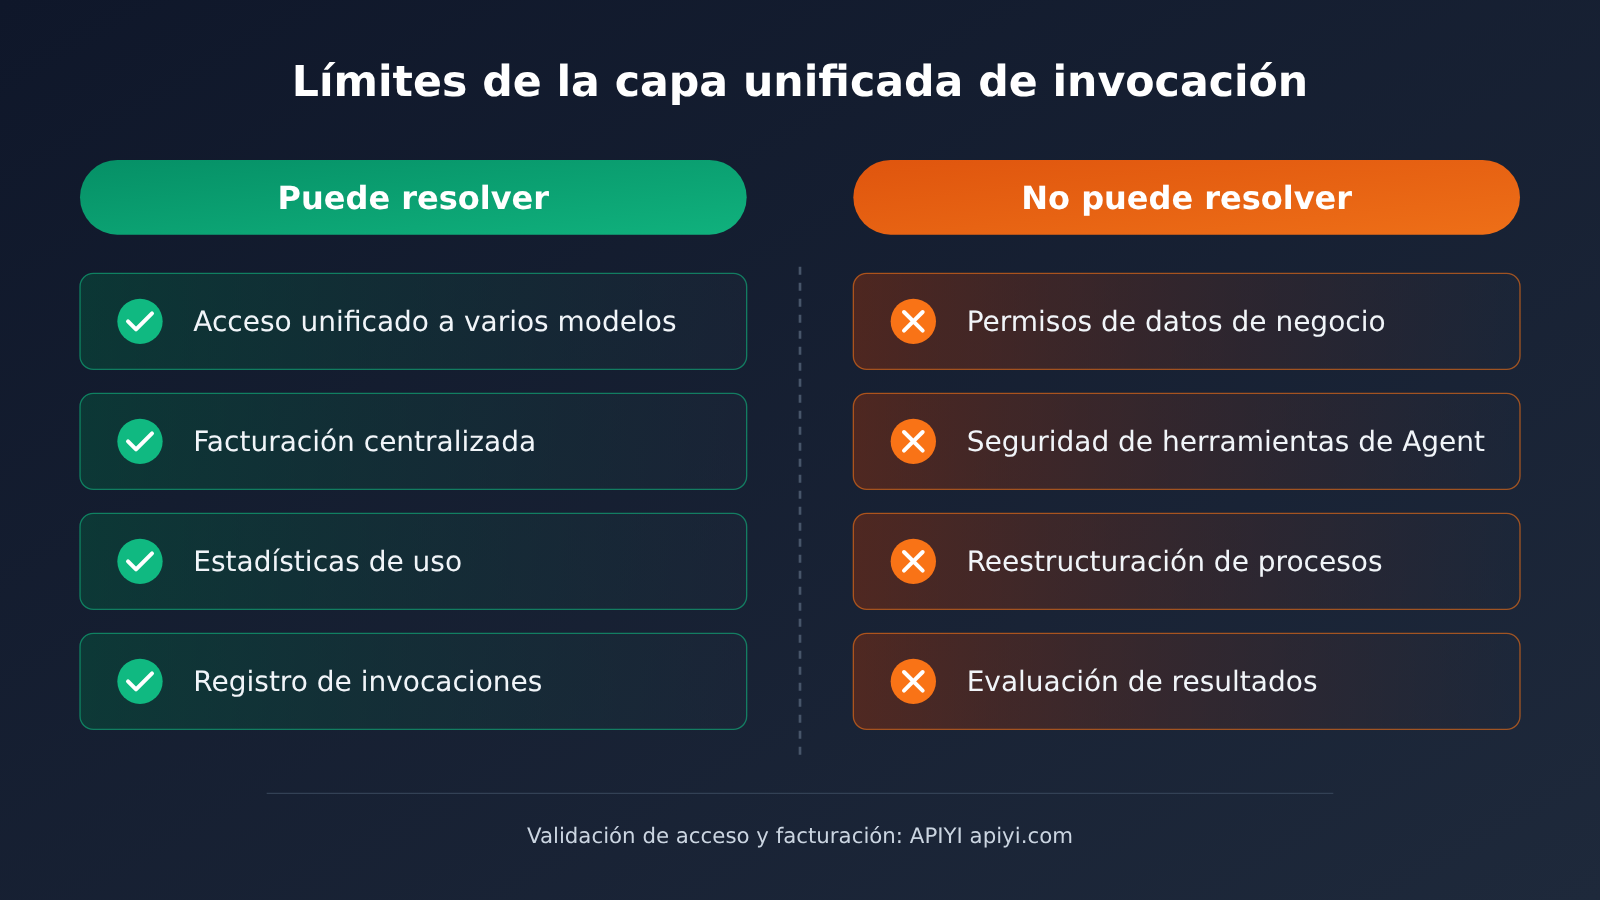
| Dimensión | Lo que puede hacer la capa unificada | Lo que aún requiere otros componentes |
|---|---|---|
| Acceso a modelos | Invocar modelos de distintos proveedores desde una sola interfaz, con un bajo costo de cambio | Decidir qué modelo conviene a cada caso de negocio |
| Costos | Centralizar el saldo y la facturación por consumo para facilitar la consolidación | Vincular los costos con los resultados del negocio y evaluar el ROI |
| Permisos | Controlar «quién puede invocar modelos» | Controlar «qué datos puede leer un agente y qué acciones puede ejecutar» |
| Trazabilidad | Registrar el modelo, los tokens y el tiempo de cada invocación | Rastrear la cadena completa de ejecución del agente y la calidad de sus resultados |
| Reutilización | Ofrecer un punto de acceso estable para las invocaciones | Consolidar indicaciones, plantillas de procesos y bases de conocimiento |
Esto también explica por qué Tencent presentó en el evento soluciones de seguridad, un centro de observabilidad, Agent Runtime y productos de conocimiento al mismo tiempo. Según la cobertura del evento, los agentes pueden llamar herramientas, acceder a datos e incluso ejecutar código de forma autónoma. Por eso es importante limitar el alcance de sus acciones, proteger la información sensible y poder rastrear la causa cuando algo sale mal. Estos son problemas de la capa de ejecución de agentes y de la capa de datos, fuera del alcance de una puerta de enlace de modelos.
Por eso, el orden lógico es: primero unificar la capa de invocación de modelos para tener visibilidad del acceso y el gasto; después, añadir permisos de datos, seguridad para agentes y mejoras en los procesos. Sin visibilidad de la capa inferior, es imposible gobernar las capas superiores.
Análisis del impacto del uso de IA en los equipos
Impacto para los responsables técnicos
- La arquitectura debe prever un punto de entrada común: al integrar un Modelo de Lenguaje Grande en un proyecto nuevo, evita fijar directamente la dirección oficial de un proveedor. Usa siempre la interfaz compatible acordada por el equipo.
- La gestión de claves pasa a formar parte de las operaciones: las claves API deben incluirse en los procesos de gestión de secretos, igual que las contraseñas de bases de datos, con registros de emisión, rotación y revocación.
- Los campos de registro deben diseñarse desde el principio: como mínimo, debe ser posible relacionar el proyecto, el cliente que realiza la llamada, el modelo y el consumo de tokens. De lo contrario, será difícil corregirlo al conciliar las cuentas a fin de mes.
Impacto para los responsables de negocio y compras
Cuando un equipo adquiere capacidades de IA, el criterio de evaluación pasa de «qué modelo es el más potente» a «si se puede gestionar y controlar». La siguiente tabla muestra las prioridades según la etapa del equipo y puede servir de referencia para planificar el despliegue.
| Etapa del equipo | Situación habitual | Prioridades en la capa de invocación del modelo |
|---|---|---|
| Exploración individual | Unas pocas personas prueban herramientas por su cuenta y cada una tiene sus propias claves | Elegir una interfaz común y centralizar las cuentas dispersas |
| Piloto de equipo | Uno o dos proyectos empiezan a depender de la IA | Distribuir claves por proyecto y establecer estadísticas básicas de uso |
| Despliegue departamental | Varias líneas de negocio realizan invocaciones al mismo tiempo | Agrupar los costos por proyecto y permitir búsquedas en los registros de llamadas |
| Aplicación en toda la organización | Los agentes entran en procesos de negocio esenciales | Añadir permisos de acceso a los datos, seguridad de los agentes y evaluación de resultados |
Para compras, también es importante comprobar si los procesos de pago y facturación cumplen los requisitos financieros de la empresa, así como el nivel de detalle de los permisos, los campos de registro, los plazos de conservación y las opciones de exportación de la plataforma. Estos detalles varían considerablemente entre proveedores, por lo que conviene confirmarlos uno por uno antes de firmar y tomar como referencia su documentación oficial.
Impacto en el sector
En el evento, Buddy One presentó un fondo compartido de créditos y una gestión centralizada. Esto indica que tratar las cuotas de los modelos como un recurso compartido y distribuirlas de forma centralizada se está convirtiendo en un enfoque habitual en los productos de IA para empresas. Es previsible que tanto las suites de los grandes proveedores como las plataformas independientes que agregan modelos deban ofrecer visibilidad del uso y agrupación de costos: para los clientes empresariales, serán requisitos básicos, no ventajas adicionales.
💡 Recomendación: antes del despliegue formal, realiza un piloto a pequeña escala con datos reales del negocio. A través de APIYI apiyi.com puedes invocar modelos de varios proveedores, comparar sus resultados y su consumo de tokens para una misma tarea y, después, elegir el modelo predeterminado del equipo.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la «gobernanza de la capa de invocación del modelo» cuando un equipo usa IA?
Consiste en gestionar de forma centralizada cómo accede el equipo a los Modelos de Lenguaje Grande: qué modelos se utilizan, quién tiene las claves, cuánto consume cada proyecto y si se puede rastrear cada invocación. No se encarga de la lógica de negocio de los agentes, sino de garantizar que todas las invocaciones pasen por un punto de acceso gestionable.
Q2: ¿En qué se diferencia una capa unificada de invocación del modelo de una plataforma empresarial de agentes?
Una plataforma empresarial de agentes se centra en cómo estos se conectan a los sistemas de negocio, acceden a los datos, colaboran y funcionan durante períodos prolongados; la capa de invocación del modelo solo se ocupa del paso de invocar el modelo. La primera abarca más funciones, pero también depende de un acceso estable y controlable a los modelos. Son capas complementarias, no alternativas.
Q3: ¿Es necesario que un equipo pequeño haga esto desde ahora?
Sí, pero puede empezar con una versión sencilla. Las dos medidas más útiles son unificar la interfaz de invocación y evitar que las claves personales entren en el código de producción. Ambas tienen un costo bajo, mientras que corregir estos problemas cuando el equipo crezca será mucho más complicado.
Q4: ¿Cómo se puede configurar rápidamente un punto de acceso unificado para que el equipo invoque modelos?
Una opción sencilla es elegir una plataforma de agregación compatible con OpenAI. Por ejemplo, después de registrarte en APIYI apiyi.com y obtener una clave API, puedes sustituir base_url en el código por `https://api.apiyi.com/v1`. Así podrás invocar modelos como OpenAI, Claude y Gemini con el mismo código y usar la función de encapsulación de este artículo para registrar el consumo por proyecto.
Q5: ¿Puede una plataforma de agregación sustituir directamente el sistema de permisos del equipo?
No por completo. La plataforma puede controlar el acceso a los modelos y la facturación, pero la granularidad de los permisos por miembro o proyecto, los límites de cuota y las políticas de retención de registros varían según la plataforma, por lo que conviene consultar su documentación. Los permisos sobre los datos de negocio y las operaciones de los agentes deben gestionarse desde los sistemas propios de la empresa. Antes de planificar, puedes comprobar las capacidades específicas en el centro de documentación de APIYI apiyi.com.
Puntos clave sobre la capa de invocación de modelos de IA para equipos
- La productividad individual no equivale a una organización más fuerte: cuando un equipo comparte capacidades de los modelos, los problemas de gestión aparecen antes que las limitaciones de los modelos.
- Primero unifica el acceso, luego ocúpate de la gobernanza: solo si todas las invocaciones pasan por la misma capa se pueden aplicar reglas de permisos y costos.
- Distribuye las claves por proyecto: una clave por servicio permite revocarla rápidamente en caso de filtración o cuando alguien deja la empresa.
- Asigna los costos a cada proyecto: añade los campos de proyecto y origen de la invocación en la aplicación para poder conciliar las cuentas al final del mes.
- La pasarela tiene sus límites: los permisos de datos, la seguridad de los agentes y la transformación de procesos requieren otras medidas.
- Empieza con poco presupuesto: con APIYI apiyi.com puedes acceder a varios modelos con una sola clave y poner en marcha un proyecto piloto.
Resumen
La conversación sobre agentes empresariales en la conferencia de Tencent no giró tanto en torno a lo potente que es un agente concreto, sino a cómo una organización puede incorporar esas capacidades. Para quienes quieren impulsar el uso de IA en sus equipos, la capa de invocación del modelo es una de las primeras que se pueden implementar y también una de las más fáciles de pasar por alto:
- El acceso a los modelos debe permitir sustituirlos: unifica la interfaz compatible y define el nombre del modelo como un parámetro de configuración.
- Los permisos y costos deben ser visibles: distribuye las claves y registra el consumo por proyecto para evitar cuentas confusas.
- La experiencia debe poder reutilizarse: convierte las indicaciones y los procesos validados en recursos del equipo.
La novedad pasará, pero esta lista de comprobación sirve para impulsar la IA en equipos de cualquier tamaño. Lo recomendable es empezar con uno o dos casos de negocio, comprobar que funcionan el acceso unificado y el registro de consumo, y ampliar el alcance poco a poco. Puedes usar APIYI apiyi.com para validar rápidamente el acceso unificado a varios modelos; la plataforma ofrece crédito gratuito para pruebas y pago por uso.
📚 Referencias
- GeekPark – ¿Por qué una persona puede usar bien la IA, pero una empresa no?: cobertura de los anuncios sobre agentes empresariales en la Conferencia Global del Ecosistema Digital de Tencent
- Enlace:
geekpark.net/news/373541 -
Descripción: incluye información sobre la actualización de WorkBuddy Enterprise, Buddy One, el caso de Suning y Agent Runtime
-
Documentación de la API de OpenAI: descripción de la interfaz Chat Completions y el campo usage
- Enlace:
platform.openai.com/docs - Descripción: ayuda a entender la estructura de las solicitudes a interfaces compatibles y cómo se contabilizan los tokens
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página principal de apiyi.com. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com


