
Résumé : Gemini Omni 1.2 Flash génère des vidéos de 3 à 15 secondes avec audio natif. Passer par Google en direct exige un palier payant et une région prise en charge. D’après les tarifs publics, comptez environ $0.07 par seconde en 720p, soit à peu près $0.70 pour une séquence de 10 secondes.
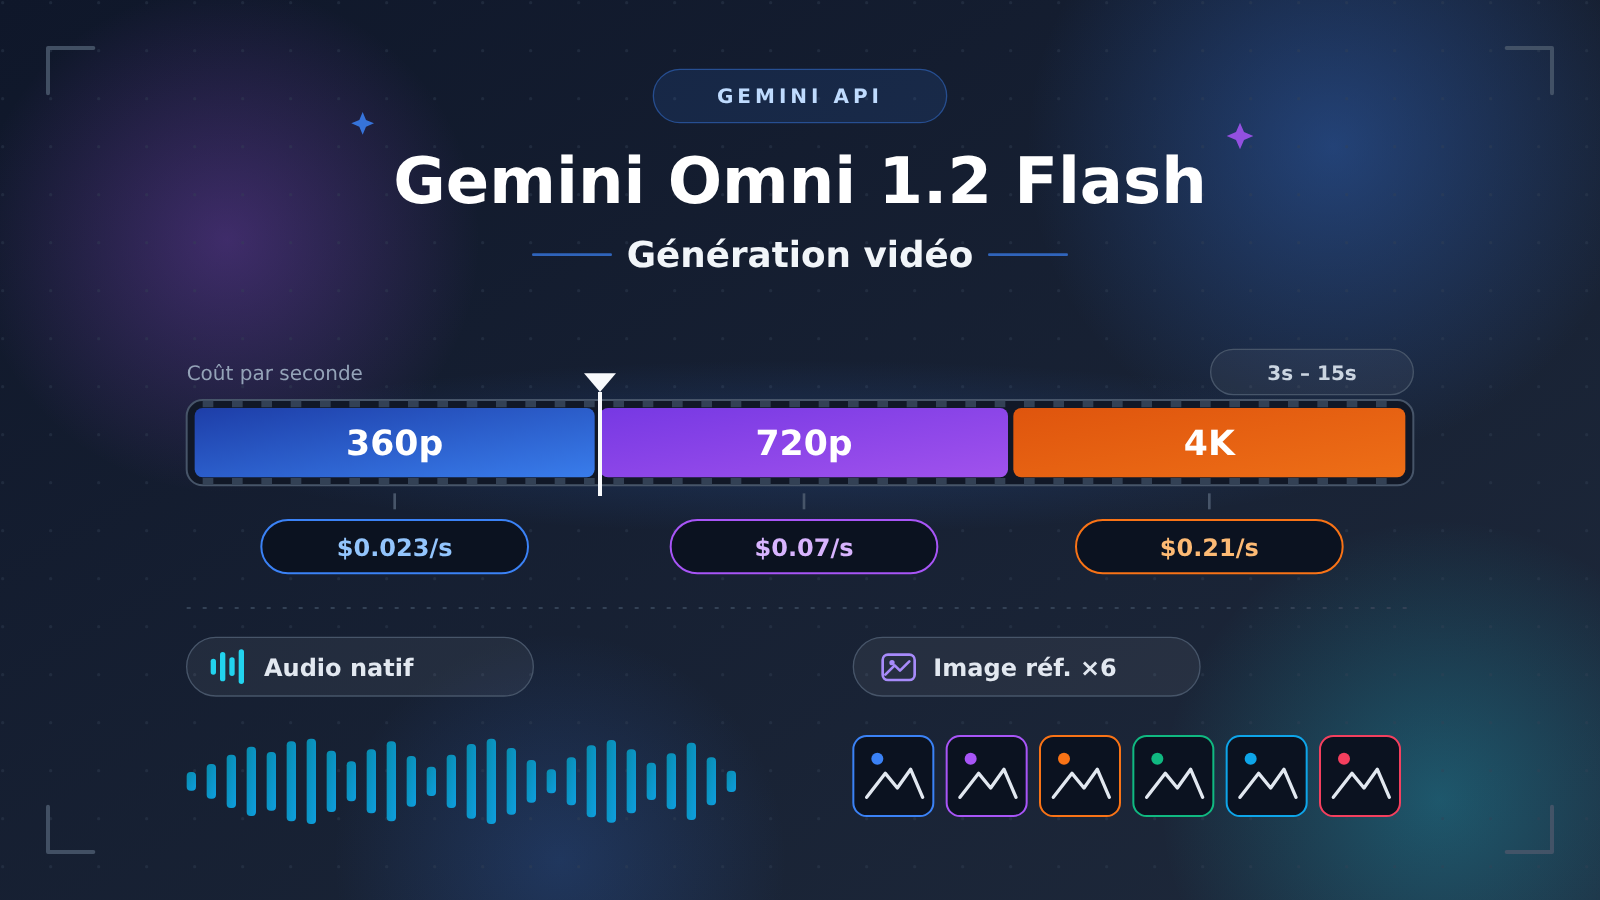
L’essentiel d’abord : Gemini Omni 1.2 Flash est un modèle vidéo publié par Google le 5 novembre 2026. Il prend en charge des durées de 3 à 15 secondes, des résolutions allant de 360p à 4K, jusqu’à 6 images de référence, et produit directement un audio natif. Sur l’API Gemini, il n’existe pas de palier gratuit : avant tout appel, il faut disposer d’un projet payant avec facturation activée, et se trouver dans une région figurant sur la liste de prise en charge de Google AI Studio et de l’API Gemini. Sur la base de $12.00 par million de tokens en sortie vidéo, on obtient environ $0.023 par seconde en 360p, $0.07 par seconde en 720p et $0.21 par seconde en suréchantillonnage 4K. Pour la plupart des essais, une vidéo de 8 secondes en 720p revient à environ $0.56 : le coût d’une tentative ratée reste faible, le vrai obstacle étant le compte, la facturation et la région.
La suite commence par un glossaire pour clarifier les notions de base, puis décortique les capacités du modèle et les conditions d’accès officielles. Vient ensuite un tableau comparatif des coûts selon les combinaisons de résolution et de durée, avec une méthode d’estimation, puis une explication de la forme d’appel asynchrone « créer, interroger en boucle, télécharger », et enfin la liste des points à vérifier un par un avant toute intégration. Après lecture, vous saurez si ce modèle mérite une place dans votre application ou dans votre chaîne de production de contenu.
À savoir : les termes liés à Gemini Omni 1.2 Flash
| Terme | Explication |
|---|---|
| API Gemini | Interface d’invocation de modèles de Google destinée aux développeurs, facturée au token |
| Google AI Studio | Console de débogage web de Google, qui permet de créer une clé API et de tester des modèles |
| Palier payant (Paid Tier) | Niveau de facturation accessible seulement après avoir lié un compte de facturation Cloud, par opposition au palier gratuit |
| Facturation Cloud | Compte de facturation Google Cloud, qui demande généralement l’association d’une carte bancaire |
| token | Unité de mesure du modèle ; la sortie vidéo est elle aussi convertie en tokens selon la résolution et la durée |
| Audio natif | Le modèle génère le son en même temps que l’image, sans étape de doublage supplémentaire |
| Image de référence | Image fournie au moment de la génération pour contraindre la cohérence d’un personnage, d’un objet ou d’un style |
| Texte vers vidéo / image vers vidéo | Générer une vidéo à partir d’une invite textuelle, ou d’une image accompagnée d’une invite |
| Suréchantillonnage 4K | Approche consistant à générer d’abord en basse résolution puis à agrandir en 4K ; la facturation suit le palier 4K |
| Tâche asynchrone | On soumet la requête, on récupère un ID de tâche, puis on attend que la génération en arrière-plan soit terminée |
| Interrogation répétée (polling) | Consulter l’état de la tâche à intervalles réguliers, jusqu’à la réussite ou l’échec |
| Interactions API | Interface propre à Google, qui offre l’édition conversationnelle de vidéo, la continuation, etc. |
| Interface compatible OpenAI | Interface exposée par des plateformes tierces au format des requêtes du SDK OpenAI, pratique pour réutiliser son code |
1 Les points clés de Gemini Omni 1.2 Flash : ce qu’il sait faire
1.1 Les limites de capacités de Gemini Omni 1.2 Flash
Le tableau ci-dessous récapitule les paramètres essentiels actuellement publics. Ces paramètres proviennent de la synthèse, par des plateformes tierces, des informations publiées par Google ; avant une intégration réelle, il faut les revérifier sur la page de publication officielle de Google.
| Dimension | Paramètre | Ce que cela implique pour les développeurs |
|---|---|---|
| Date de publication | 5 novembre 2026 | Modèle récent : le prix et la disponibilité peuvent encore évoluer |
| Durée vidéo | 3 à 15 secondes | Adapté aux courtes vidéos, aux plans publicitaires et aux démonstrations produit ; les vidéos longues doivent être assemblées |
| Résolution | 360p à 4K (4K par super-résolution) | Basse résolution pour la prévisualisation, haute résolution pour la version finale : les coûts restent maîtrisés |
| Images de référence | Jusqu’à 6 | Permet de verrouiller l’apparence d’un personnage, les détails d’un produit ou le style visuel |
| Audio | Audio natif | Sons d’ambiance et effets sonores générés en synchronisation avec l’image, ce qui réduit les étapes de post-production |
| Offre gratuite | Aucune | Il faut d’abord ouvrir un projet payant pour pouvoir appeler le modèle |
1.2 Répartition des capacités de Gemini Omni 1.2 Flash : ce qui n’est disponible que sur les API propres à Google
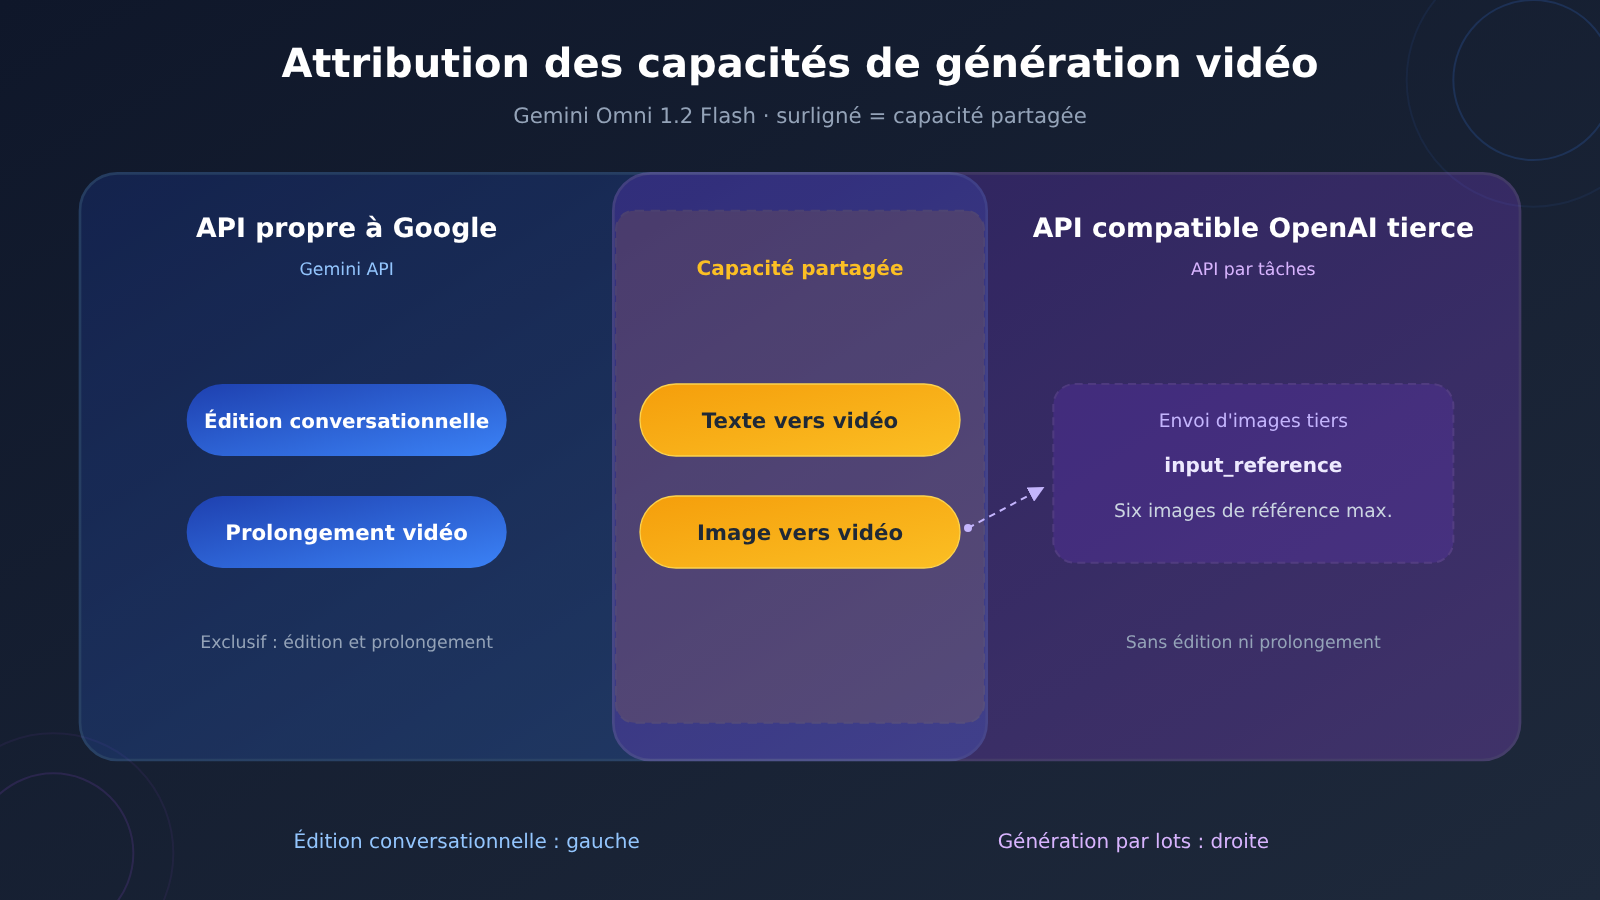
Le texte vers vidéo et l’image vers vidéo sont les deux modes les plus élémentaires ; les plateformes tierces compatibles OpenAI les prennent généralement aussi en charge. L’édition conversationnelle (modifier la vidéo précédente en langage naturel) et la continuation de vidéo font partie des fonctionnalités de Google Interactions API.
Cette distinction pèse lourd dans le choix. Si votre produit doit permettre à l’utilisateur de « modifier le plan en une phrase après génération », utilisez directement les API propres à Google ; s’il s’agit seulement de générer des segments indépendants en batch, une API de type tâche suffit.
2 Les prérequis officiels de Gemini Omni 1.2 Flash : ce qu’il faut remplir pour passer par Google
2.1 Offre payante et facturation Cloud
Sur la page tarifaire de Google, l’offre gratuite de Gemini Omni 1.2 Flash est indiquée comme « Not available ». Avant tout appel, il faut un projet Gemini API avec la facturation activée, autrement dit activer la facturation Google Cloud et associer une carte bancaire.
Pour les développeurs en Chine, la vraie difficulté à cette étape est généralement de disposer d’un moyen de paiement étranger utilisable et d’un compte Google. Lorsqu’une équipe l’utilise, il faut aussi prévoir à l’avance qui détient le compte de facturation et comment configurer des alertes budgétaires, pour éviter qu’un script de test appelé en boucle ne génère une facture inattendue.
2.2 Restrictions géographiques et identification des erreurs
Google AI Studio et l’API Gemini ne sont disponibles que dans les régions prises en charge. Dans une région absente de la liste, AI Studio ne s’ouvre pas et l’appel API renvoie « User location is not supported for the API use ».
Face à cette erreur, le problème vient de la région d’origine de la requête ; changer de clé API ou modifier les paramètres ne le résoudra pas. La liste des régions prises en charge par Google est mise à jour en continu : avant d’intégrer le modèle, fiez-vous à la dernière liste publiée dans la documentation officielle.
2.3 Distinguer les faits officiels sur Gemini Omni 1.2 Flash des déclarations des tiers
Des plateformes tierces ont déjà annoncé qu’elles intégreraient ce modèle, et leurs présentations mélangent des informations officielles de Google avec la description de leurs propres services. Le tableau ci-dessous sépare les deux types d’informations, pour vous aider à déterminer ce que vous pouvez citer directement et ce qu’il faut confirmer auprès de la plateforme elle-même.
| Information | Catégorie | Description |
|---|---|---|
| Date de publication, durée, résolution, nombre d’images de référence, audio natif | Information officielle Google (relayée par un tiers) | Se référer à la page de publication de Google |
| Pas de niveau gratuit, projet payant requis | Page tarifaire officielle de Google | Se référer à la page de tarification de l’API Gemini |
| Prix par million de tokens, conversion tokens par seconde | Page tarifaire officielle de Google | Se référer à la page de tarification de l’API Gemini |
| Édition conversationnelle, continuation attribuée à l’API Interactions | Capacité d’interface propre à Google | Se référer à la documentation Google |
ID du modèle gemini-omni-1.2-flash |
Déclaration propre à la plateforme tierce | Le nommage peut varier d’une plateforme à l’autre, à vérifier une par une |
Interface de tâche /v1/videos, paramètres seconds / size |
Déclaration propre à la plateforme tierce | Il s’agit d’un wrapper compatible OpenAI, pas du format natif de Google |
| Mode de recharge, montant minimum de recharge, retour 402 en cas de solde insuffisant | Déclaration propre à la plateforme tierce | Applicable uniquement à cette plateforme |
| « Déjà en ligne / Bientôt en ligne » | Déclaration propre à la plateforme tierce | Toujours pas en ligne au moment de la publication sur cette plateforme, à confirmer en temps réel |
3 Estimation des coûts de Gemini Omni 1.2 Flash : conversion par seconde et par segment
3.1 Structure de tarification officielle
L’API Gemini facture ce modèle au token, avec les prix par million de tokens suivants : entrée $1.50, sortie vidéo $12.00, sortie texte $9.00. Les tokens de sortie vidéo sont convertis selon la résolution et le nombre de secondes :
- 360p : 1,931 token par seconde, environ $0.023 par seconde
- 720p : 5,792 token par seconde, environ $0.07 par seconde
- Suréchantillonnage 4K : 17,376 token par seconde, environ $0.209 par seconde
La formule de conversion est toute simple : coût de sortie pour un segment vidéo = nombre de tokens par seconde × nombre de secondes × $12 ÷ 1,000,000. Prenons l’exemple du 720p sur 10 secondes : 5,792 × 10 × 12 ÷ 1,000,000 ≈ $0.695.
3.2 Tableau comparatif coût résolution × durée pour Gemini Omni 1.2 Flash
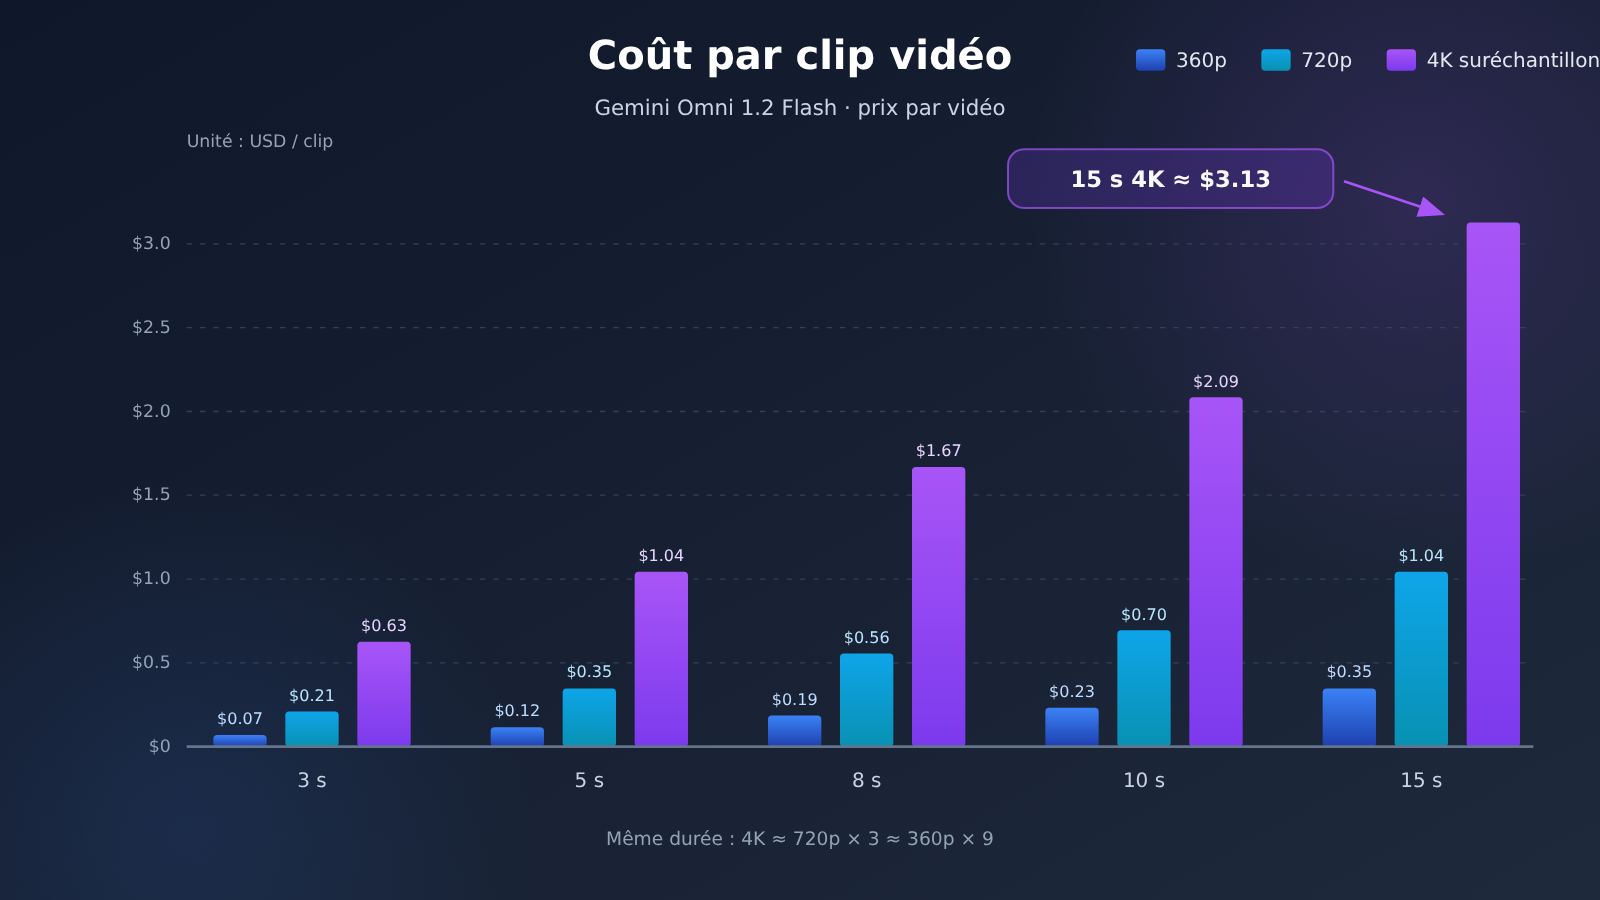
Le tableau ci-dessous est calculé selon le prix officiel de sortie vidéo, ne couvre que la partie sortie vidéo, et est arrondi à trois décimales.
| Durée | 360p (1,931 token/s) | 720p (5,792 token/s) | Suréchantillonnage 4K (17,376 token/s) |
|---|---|---|---|
| 3 secondes | $0.070 | $0.209 | $0.626 |
| 5 secondes | $0.116 | $0.348 | $1.043 |
| 8 secondes | $0.185 | $0.556 | $1.668 |
| 10 secondes | $0.232 | $0.695 | $2.085 |
| 15 secondes | $0.348 | $1.043 | $3.128 |
On peut voir qu’à durée égale, la 4K coûte environ 3 fois plus cher que la 720p et 9 fois plus cher que la 360p. Les sources publiques ne fournissent pas de valeur de conversion des tokens pour la 1080p ; si vous avez besoin de ce niveau, consultez la page tarifaire officielle.
3.3 Trois coûts facilement oubliés lors de l’estimation
Le tableau ci-dessus ne couvre que la sortie vidéo. Lorsqu’on établit la facture réelle, il faut aussi tenir compte des éléments suivants :
- Tokens d’entrée : les invites et les images de référence sont facturées 1,50 $ par million de tokens. Le nombre de tokens pour un maximum de 6 images de référence dépend de la règle officielle de conversion des images ; les sources publiques ne donnent pas de valeur précise.
- Coût des tentatives : si le résultat généré ne convient pas, il faut relancer, donc le budget doit être calculé comme « coût d’un segment × nombre moyen de tentatives ». Il n’existe actuellement aucune donnée publique sur les taux d’échec ou d’adoption, aussi il est conseillé de commencer par un test réel sur un petit lot de tâches.
- Stratégie de résolution : commencez par le 360p pour ajuster l’invite et le cadrage, puis passez au 720p ou à la 4K une fois le rendu fixé — cela réduit nettement les coûts d’essai-erreur. Un segment de 8 secondes testé 5 fois en 360p coûte environ 0,93 $, soit à peu près le coût de 2 exécutions en 720p.
4 Prise en main rapide de Gemini Omni 1.2 Flash : le processus d’appel des tâches vidéo asynchrones
4.1 Les trois phases d’une tâche asynchrone
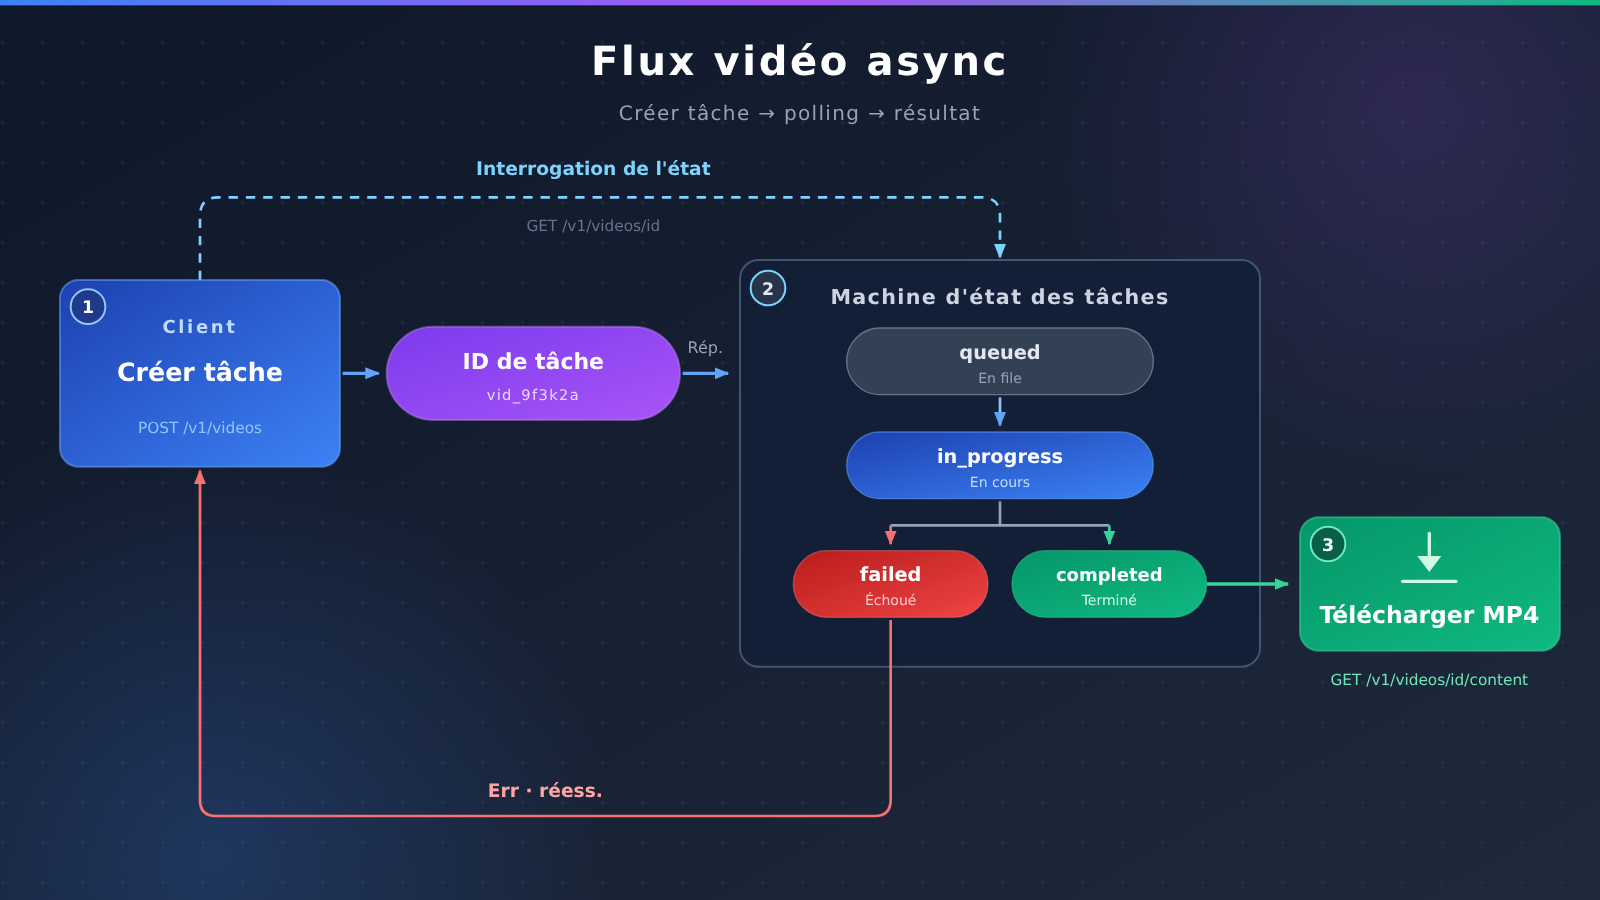
La génération de vidéos prend bien plus de temps que la complétion de texte, c’est pourquoi la forme de tâche asynchrone est généralement adoptée. Un appel complet se déroule en trois étapes :
- Créer la tâche : on soumet le modèle, l’invite, la durée, la résolution et d’autres paramètres ; l’interface renvoie immédiatement l’ID de la tâche et son état initial (par exemple
queued). - Interroger l’état : on vérifie la tâche à intervalle fixe ; l’état passe successivement par
queued,in_progress, puis finalementcompletedoufailed. - Télécharger le résultat : une fois l’état à
completed, on récupère le fichier vidéo via l’interface de contenu.
4.2 Exemple d’appel au format compatible OpenAI
Le code ci-dessous utilise l’interface videos du SDK OpenAI, les noms de paramètres provenant du format compatible OpenAI publié par des plateformes tierces. Remplacez base_url et l’ID du modèle par les valeurs fournies par le service que vous utilisez réellement, et vérifiez d’abord que ce service propose bien Gemini Omni 1.2 Flash.
import os, time
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIDEO_API_KEY"],
    base_url=os.environ["VIDEO_API_BASE_URL"],  # Remplacez par l'adresse réelle du service
)

video = client.videos.create(
    model="gemini-omni-1.2-flash",   # Se référer à l'ID de modèle publié par le fournisseur
    prompt="一只穿着迷你宇航服的猫在空间站里漂浮,背景有轻微的环境音",
    seconds="8",
    size="1280x720",
)

while video.status in ("queued", "in_progress"):
    time.sleep(5)
    video = client.videos.retrieve(video.id)

if video.status == "failed":
    raise RuntimeError(video.error)

client.videos.download_content(video.id).write_to_file("omni.mp4")
Si vous n’utilisez pas le SDK, le flux HTTP correspondant est le suivant : POST /v1/videos pour créer la tâche, GET /v1/videos/{id} pour interroger l’état, GET /v1/videos/{id}/content pour télécharger la vidéo. Pour l’image vers vidéo, on transmet l’image de référence via le champ input_reference. Certains services proposent également GET /v1/models?type=video, qui permet de lister les durées et tailles prises en charge par chaque modèle.
Voir l’implémentation complète avec gestion des délais d’attente, estimation du budget et traitement des erreurs
import os, time
from openai import OpenAI

# Conversion officielle de la sortie vidéo (tokens par seconde), pour estimer le coût avant soumission
TOKENS_PER_SECOND = {"640x360": 1931, "1280x720": 5792}
VIDEO_OUTPUT_PRICE_PER_M = 12.00  # dollars / million de tokens

def estimate_cost(size: str, seconds: int) -> float:
    tps = TOKENS_PER_SECOND.get(size)
    if tps is None:
        raise ValueError(f"未登记的分辨率: {size}")
    return tps * seconds * VIDEO_OUTPUT_PRICE_PER_M / 1_000_000

def generate_video(
    prompt: str,
    seconds: int = 8,
    size: str = "1280x720",
    out_path: str = "output.mp4",
    poll_interval: float = 5.0,
    timeout: float = 600.0,
    budget_usd: float = 1.0,
) -> str:
    cost = estimate_cost(size, seconds)
    if cost > budget_usd:
        raise ValueError(f"预估 ${cost:.3f} 超出单段预算 ${budget_usd}")
    print(f"预估视频输出成本: ${cost:.3f}")

    client = OpenAI(
        api_key=os.environ["VIDEO_API_KEY"],
        base_url=os.environ["VIDEO_API_BASE_URL"],
    )

    video = client.videos.create(
        model=os.environ.get("VIDEO_MODEL_ID", "gemini-omni-1.2-flash"),
        prompt=prompt,
        seconds=str(seconds),
        size=size,
    )
    print(f"任务已创建: {video.id}")

    start = time.time()
    while video.status in ("queued", "in_progress"):
        if time.time() - start > timeout:
            raise TimeoutError(f"任务 {video.id} 超时,可稍后用 ID 继续查询")
        time.sleep(poll_interval)
        video = client.videos.retrieve(video.id)
        print(f"状态: {video.status}")

    if video.status == "failed":
        raise RuntimeError(f"生成失败: {video.error}")

    client.videos.download_content(video.id).write_to_file(out_path)
    return out_path

if __name__ == "__main__":
    path = generate_video(
        prompt="清晨的咖啡店,蒸汽从杯口升起,背景有轻柔的人声与杯碟碰撞声",
        seconds=8,
        size="640x360",   # d'abord régler l'invite en 360p
        budget_usd=0.5,
    )
    print(f"已保存: {path}")
4.3 Conseils d’ingénierie pour le polling et le stockage
Un intervalle de polling d’environ 5 secondes suffit ; plus fréquent, cela ne fait qu’ajouter des requêtes inutiles. En production, je vous conseille d’écrire l’ID de la tâche dans la base de données et de laisser une tâche de fond faire le polling à votre place : ainsi, un rafraîchissement côté front ou un redémarrage du processus ne vous fera pas perdre une tâche déjà payée.
Une fois la vidéo téléchargée, transférez-la au plus vite vers votre propre stockage objet. Pour de la génération en lot, vous pouvez limiter la concurrence avec une file d’attente et, avant chaque soumission, valiser le budget avec une fonction du type estimate_cost : les tâches qui dépassent seront bloquées directement.
5.1 Liste de vérification avant l’intégration de Gemini Omni 1.2 Flash
| Point à vérifier | Via Google officiel | Via une plateforme compatible tierce |
|---|---|---|
| Compte et paiement | Compte Google, facturation Cloud, carte bancaire | Compte sur la plateforme et mode de recharge |
| Région | Votre région figure dans la liste prise en charge par Google | Couverture de service de la plateforme elle-même |
| Disponibilité du modèle | Déjà listé sur la page tarifs et dans la liste des modèles | Déjà disponible dans la liste des modèles de la plateforme, ID du modèle confirmé |
| Périmètre fonctionnel | Inclut l’édition conversationnelle et la continuation via Interactions API | Généralement des tâches texte vers vidéo et image vers vidéo |
| Prix | Prix unitaire officiel par token | Prix affiché par la plateforme, à comparer avec le tarif officiel |
5.2 Valider la qualité et le temps de traitement sur un petit échantillon
Actuellement, les données publiques ne contiennent pas de mesures réelles sur la qualité de génération, le temps de traitement et le taux d’échec. Nous vous conseillons de préparer 5 à 10 invites couvrant vos scénarios principaux, d’effectuer d’abord un premier passage en 360p sur 5 à 8 secondes, en notant pour chacune le temps de traitement, le succès ou l’échec et la disponibilité, avant de décider du budget pour la génération par lots en haute résolution. Le coût de sortie vidéo de ce premier passage de test se situe entre 1 $ et 2 $.
6 FAQ
Q1 : Qu’est-ce que le modèle Gemini Omni 1.2 Flash ?
Il s’agit d’un modèle de génération vidéo lancé par Google le 5 novembre 2026. Il peut générer des vidéos de 3 à 15 secondes avec un audio natif, avec des résolutions allant de 360p à 4K, et prend en charge jusqu’à 6 images de référence.
Q2 : Gemini Omni 1.2 Flash dispose-t-il d’un quota gratuit ?
Sur la page des tarifs de l’API Gemini, le niveau gratuit de ce modèle est indiqué comme « Not available » : il faut activer la facturation sur un projet payant pour pouvoir l’appeler.
Q3 : Combien coûte environ la génération d’une vidéo Gemini Omni 1.2 Flash ?
Selon le tarif officiel de sortie vidéo, le 720p coûte environ 0,07 $ par seconde : environ 0,56 $ pour 8 secondes, 0,70 $ pour 10 secondes, et 1,04 $ pour 15 secondes. Le 360p représente environ un tiers de ce prix, et l’upscaling 4K environ 3 fois plus. Les tokens d’entrée des invites et des images de référence sont facturés séparément.
Q4 : Que faire lorsque l’appel renvoie « User location is not supported for the API use » ?
Cela signifie que la région d’origine de la requête ne figure pas dans la liste des régions prises en charge par l’API Gemini, indépendamment de la clé et des paramètres. Il faut lancer l’appel depuis une région prise en charge, ou utiliser un service conforme qui a déjà déployé ce modèle.
Q5 : Peut-on modifier une vidéo Gemini Omni 1.2 Flash par conversation après sa génération ?
L’édition conversationnelle et la continuation font partie des fonctionnalités de l’API Google Interactions. L’interface tierce `/v1/videos` compatible OpenAI ne gère généralement que les tâches text-vers-vidéo et image-vers-vidéo ; pour une édition à plusieurs tours, il convient d’utiliser l’interface propre à Google.
Q6 : Pour quels scénarios Gemini Omni 1.2 Flash est-il adapté ?
Il est adapté aux courts segments nécessitant une synchronisation son/image : plans de présentation de produits e-commerce, contenus de courtes vidéos pour les réseaux sociaux, couvertures animées dans une App, prévisualisation de storyboards publicitaires. Les scénarios qui reposent sur des images de référence pour verrouiller l’apparence d’un personnage ou d’un produit sont également bien adaptés.
Q7 : Quelles sont les limites actuelles de Gemini Omni 1.2 Flash ?
Un segment unique est limité à 15 secondes maximum ; les contenus plus longs doivent être assemblés ; le 4K est une sortie upscalée, donc plus coûteuse ; il n’existe pas de niveau gratuit ; les canaux officiels de Google sont soumis à des restrictions géographiques. Aucune mesure réelle publique n’existe sur la qualité de génération, le temps de traitement et le taux d’échec : il faut les vérifier soi-même sur un petit échantillon.
7 Points clés à retenir de Gemini Omni 1.2 Flash
- Périmètre des capacités : 3 à 15 secondes, du 360p au 4K, jusqu’à 6 images de référence, audio natif
- Conditions officielles : pas d’offre gratuite, il faut un projet Gemini API payant et une région prise en charge
- Coût à la seconde : environ $0.023 en 360p, environ $0.07 en 720p, environ $0.209 pour l’upscale 4K
- Repères courants : environ $0.56 pour 8 secondes en 720p, environ $0.70 pour 10 secondes en 720p
- Mode d’appel : tâche asynchrone, en trois étapes — création, interrogation répétée (polling), téléchargement
- À qui appartiennent ces fonctions : l’édition conversationnelle et la prolongation relèvent de Google Interactions API
- Stratégie d’économie : commencez par régler l’invite en 360p, puis générez en haute résolution une fois le résultat validé
8 Conclusion : Gemini Omni 1.2 Flash vaut-il la peine d’être essayé ?
Le coût par segment de Gemini Omni 1.2 Flash reste dans une fourchette où l’on peut se permettre d’expérimenter sans stress : moins d’un dollar pour 10 secondes en 720p, et l’audio natif permet d’économiser une étape de postsynchronisation. Pour les développeurs en dehors des régions couvertes, les principaux freins sont les exigences de facturation du palier payant de Google et les restrictions géographiques, sans oublier le fait que l’édition conversationnelle n’est proposée que via les interfaces propres à Google.
La démarche que nous conseillons : vérifiez d’abord que vous remplissez les conditions officielles, ou trouvez un service qui propose déjà officiellement ce modèle ; utilisez ensuite le tableau comparatif des coûts de cet article pour établir votre budget ; enfin, testez la qualité et le temps de génération sur un petit échantillon en 360p, et ne passez à l’échelle de production qu’une fois les résultats conformes. Le modèle vient tout juste d’être publié, les prix et la disponibilité peuvent donc évoluer : vérifiez à nouveau la page tarifaire officielle de Google avant chaque intégration.
Références
- Blog TeamoRouter : mode d’emploi de Gemini Omni 1.2 Flash : récapitulatif par une plateforme tierce des informations de publication, des prix officiels et de ses propres interfaces
- Lien :
teamorouter.com/zh/blogs/use-gemini-omni-1-2-flash-without-google-account -
Précision : source des paramètres de capacités et des conversions en tokens utilisées dans cet article ; les éléments concernant les interfaces de la plateforme et la recharge relèvent de ses propres déclarations
-
Page tarifaire officielle de Gemini API : barème de facturation des modèles publié par Google
- Lien :
ai.google.dev/gemini-api/docs/pricing - Précision : sert à vérifier le statut de l’offre gratuite, le prix par million de tokens et la conversion selon la résolution


