
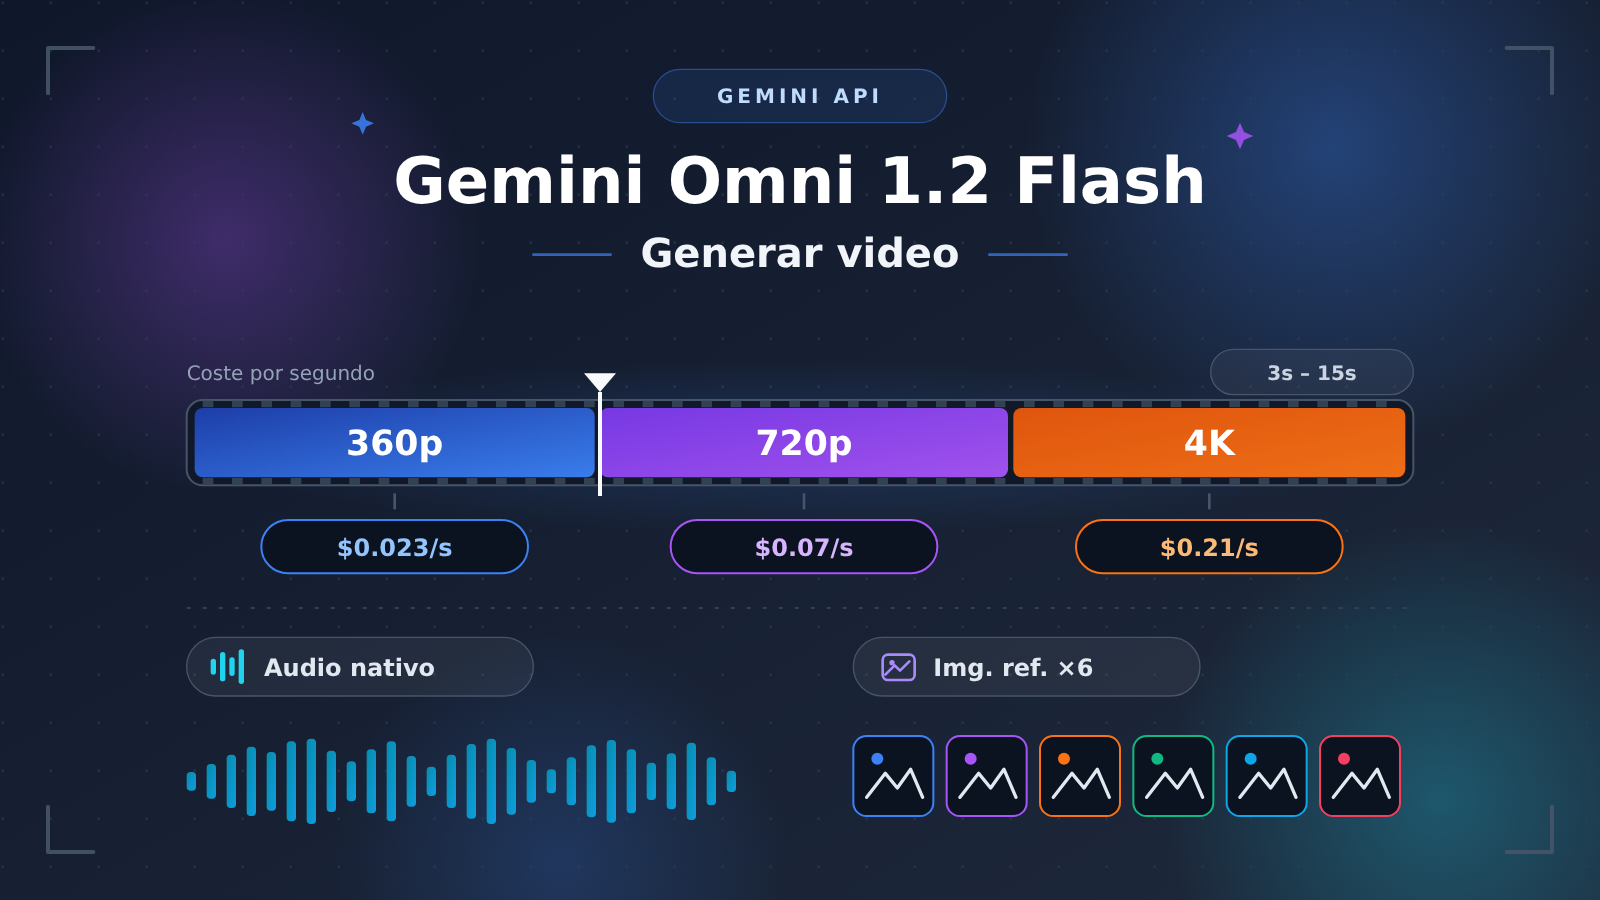
Resumen: Gemini Omni 1.2 Flash puede generar videos de 3 a 15 segundos con audio nativo. Usar la vía oficial de Google requiere el nivel de pago y estar en una región compatible. Según los precios públicos, 720p cuesta aproximadamente $0.07 por segundo, es decir, unos $0.70 por un clip de 10 segundos.
La conclusión, primero: Gemini Omni 1.2 Flash es un modelo de video que Google lanzó el 5 de noviembre de 2026. Admite duraciones de 3 a 15 segundos, resoluciones de 360p a 4K y hasta 6 imágenes de referencia, y entrega audio nativo directamente. No tiene nivel gratuito en Gemini API: antes de invocarlo hay que contar con un proyecto de pago con facturación activada, y la región debe estar dentro de la lista de países compatibles de Google AI Studio y Gemini API. Calculando a $12.00 por millón de tokens de salida de video, 360p sale aproximadamente $0.023 por segundo, 720p unos $0.07 por segundo y el escalado a 4K alrededor de $0.21 por segundo. Para la mayoría de los casos de prueba, un video de 8 segundos en 720p cuesta cerca de $0.56: el costo de cada intento fallido es bajo, y la verdadera barrera está en la cuenta, la facturación y la región.
A continuación, primero aclaramos los conceptos básicos con un glosario, luego desglosamos las capacidades del modelo y los requisitos oficiales, después presentamos una tabla comparativa de costos para distintas combinaciones de resolución y duración junto con el método de estimación, y luego explicamos la forma de invocación de las tareas de video asíncronas («crear, consultar por polling, descargar»). Por último, enumeramos los puntos que hay que verificar uno por uno antes de integrarse. Con todo esto podrás decidir si vale la pena incorporar este modelo en tu aplicación o en tu flujo de producción de contenido.
Para saber: términos relacionados con Gemini Omni 1.2 Flash
| Término | Explicación |
|---|---|
| Gemini API | Interfaz de invocación de modelos de Google para desarrolladores, con facturación por token |
| Google AI Studio | Consola de depuración web de Google, donde puedes crear una clave API y probar modelos |
| Nivel de pago (Paid Tier) | Nivel de facturación que requiere vincular una cuenta de facturación de Cloud; es el opuesto del nivel gratuito |
| Facturación de Cloud | Cuenta de facturación de Google Cloud, que normalmente requiere vincular una tarjeta de crédito |
| token | Unidad de medida del modelo; la salida de video también se convierte a tokens según resolución y duración |
| Audio nativo | El modelo genera el sonido al mismo tiempo que las imágenes, sin pasos adicionales de doblaje |
| Imagen de referencia | Imagen que se entrega al generar, para mantener la consistencia de personas, objetos o estilo |
| Texto a video / Imagen a video | Generar video a partir de una indicación de texto, o de una imagen más una indicación, respectivamente |
| Escalado a 4K | Enfoque que genera primero a menor resolución y luego amplía a 4K; la facturación se aplica según el nivel 4K |
| Tarea asíncrona | Tras enviar la solicitud, primero recibes un ID de tarea y luego recoges el resultado cuando la generación en segundo plano termina |
| Polling | Consultar el estado de la tarea a intervalos regulares hasta que termine o falle |
| Interactions API | Interfaz propia de Google que ofrece edición conversacional de video, continuación y otras capacidades |
| Interfaz compatible con OpenAI | Interfaz de plataformas de terceros que empaqueta el formato de solicitud del OpenAI SDK, para reutilizar el código fácilmente |
1 Puntos clave de Gemini Omni 1.2 Flash: qué puede hacer
1.1 Límites de capacidad de Gemini Omni 1.2 Flash
La siguiente tabla resume los parámetros clave de la información pública disponible. Estos datos provienen de la recopilación que plataformas de terceros hicieron de los anuncios de Google; antes de integrarse formalmente, conviene verificarlos de nuevo en la página oficial de Google.
| Dimensión | Parámetro | Qué significa para el desarrollador |
|---|---|---|
| Fecha de lanzamiento | 5 de noviembre de 2026 | Es un modelo nuevo, así que el precio y la disponibilidad todavía pueden cambiar |
| Duración del video | 3~15 segundos | Sirve para clips cortos, tomas publicitarias y demos de producto; los videos largos hay que empalmarlos |
| Resolución | De 360p a 4K (4K mediante superresolución) | Usa baja resolución para previsualizar y alta para el resultado final, así controlas el costo |
| Imagen de referencia | Hasta 6 | Permite fijar la apariencia del personaje, los detalles del producto o el estilo visual |
| Audio | Audio nativo | El audio ambiental, los efectos de sonido y la imagen se generan sincronizados, lo que reduce el trabajo de posproducción |
| Plan gratuito | No disponible | Primero hay que activar un proyecto de pago para poder invocar el modelo |
1.2 A qué capacidades pertenece Gemini Omni 1.2 Flash: cuáles están solo en la API propia de Google
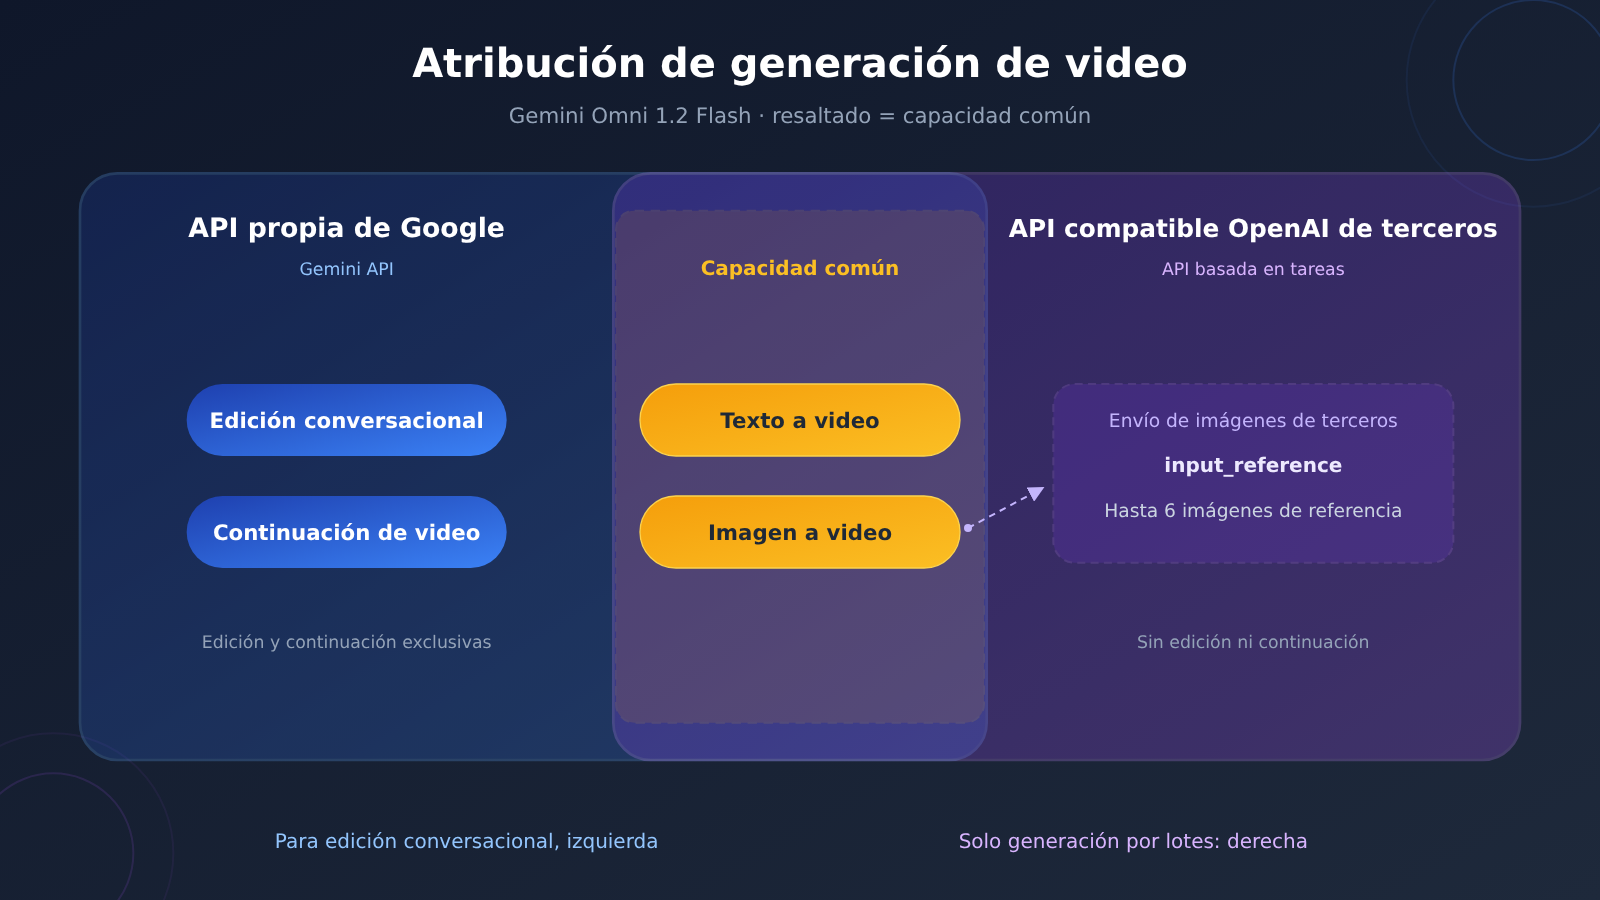
Texto a video e imagen a video son los dos modos más básicos, y las plataformas de terceros compatibles con OpenAI normalmente también los cubren. La edición conversacional (seguir modificando el video anterior con lenguaje natural) y la extensión de video son funciones de la API Interactions de Google.
Esta distinción influye mucho en la elección. Si tu producto necesita «generar y luego dejar que el usuario cambie la toma con una sola frase», tienes que usar directamente la API propia de Google; si solo generas fragmentos independientes por lotes, una API basada en tareas ya es suficiente.
2 Los requisitos oficiales de Gemini Omni 1.2 Flash: qué hay que cumplir para ir por Google
2.1 Plan de pago y facturación con Cloud
En la página de precios de Google, el plan gratuito de Gemini Omni 1.2 Flash figura como «Not available». Antes de invocar el modelo necesitas un proyecto de Gemini API con la facturación activada, es decir, habilitar la facturación de Google Cloud y vincular una tarjeta de crédito.
Para los desarrolladores en China, la dificultad real de este paso suele ser contar con un método de pago internacional disponible y una cuenta de Google. Cuando lo usa un equipo, conviene planificar de antemano quién es el titular de la cuenta de facturación y cómo configurar alertas de presupuesto, para evitar que un script de prueba que se ejecuta en bucle genere facturas inesperadas.
2.2 Restricciones regionales e identificación de errores
Google AI Studio y la API de Gemini solo están disponibles en las regiones admitidas. En las regiones que no están en la lista de soporte, AI Studio no abre y la llamada a la API devuelve «User location is not supported for the API use».
Cuando aparece este error, el problema está en la región de origen de la solicitud; cambiar la clave o modificar parámetros no lo resuelve. La lista de regiones admitidas de Google se actualiza dinámicamente, así que antes de integrarte guíate por la lista más reciente de la documentación oficial.
2.3 Cómo distinguir los datos oficiales de Gemini Omni 1.2 Flash de lo que declaran los terceros
Ya hay plataformas de terceros que han anunciado que integrarán este modelo, y en sus descripciones mezclan la información oficial de Google con las explicaciones de servicio de la propia plataforma. La siguiente tabla separa ambos tipos de información para que puedas juzgar qué se puede citar directamente y qué hay que confirmar con la plataforma misma.
| Información | Categoría | Descripción |
|---|---|---|
| Fecha de lanzamiento, duración, resolución, cantidad de imágenes de referencia, audio nativo | Información oficial de Google (reproducida por terceros) | Tomar como referencia la página de lanzamiento de Google |
| Sin nivel gratuito; requiere un proyecto de pago | Página oficial de precios de Google | Tomar como referencia la página de precios de Gemini API |
| Precio por millón de tokens, conversión de tokens por segundo | Página oficial de precios de Google | Tomar como referencia la página de precios de Gemini API |
| Edición conversacional y continuación atribuidas a Interactions API | Capacidad de API propia de Google | Tomar como referencia la documentación de Google |
ID del modelo gemini-omni-1.2-flash |
Declarado por la plataforma de terceros | La nomenclatura puede variar en cada plataforma; hay que confirmarla una por una |
Interfaz de tareas /v1/videos, parámetros seconds / size |
Declarado por la plataforma de terceros | Es un envoltorio compatible con OpenAI, no el formato nativo de Google |
| Método de recarga, monto mínimo de recarga, retorno 402 por saldo insuficiente | Declarado por la plataforma de terceros | Solo aplica a esa plataforma |
| «Ya disponible / Próximamente» | Declarado por la plataforma de terceros | En el momento de publicación de esa plataforma, aún no estaba disponible; hay que confirmarlo en tiempo real |
3 Estimación de costos de Gemini Omni 1.2 Flash: conversión por segundo y por segmento
3.1 Estructura de precios oficial
La API de Gemini factura este modelo por tokens. El precio por millón de tokens es el siguiente: entrada $1.50, salida de video $12.00, salida de texto $9.00. Los tokens de salida de video se convierten según la resolución y la cantidad de segundos:
- 360p: 1,931 tokens por segundo, aproximadamente $0.023 por segundo
- 720p: 5,792 tokens por segundo, aproximadamente $0.07 por segundo
- 4K con superresolución: 17,376 tokens por segundo, aproximadamente $0.209 por segundo
La fórmula de conversión es bastante directa: costo de salida de un segmento de video = tokens por segundo × segundos × $12 ÷ 1,000,000. Tomando 720p y 10 segundos como ejemplo, 5,792 × 10 × 12 ÷ 1,000,000 ≈ $0.695.
3.2 Tabla comparativa de costos por resolución × duración de Gemini Omni 1.2 Flash
La siguiente tabla se calcula según el precio oficial de salida de video; solo incluye la parte de salida de video y redondea a tres decimales.
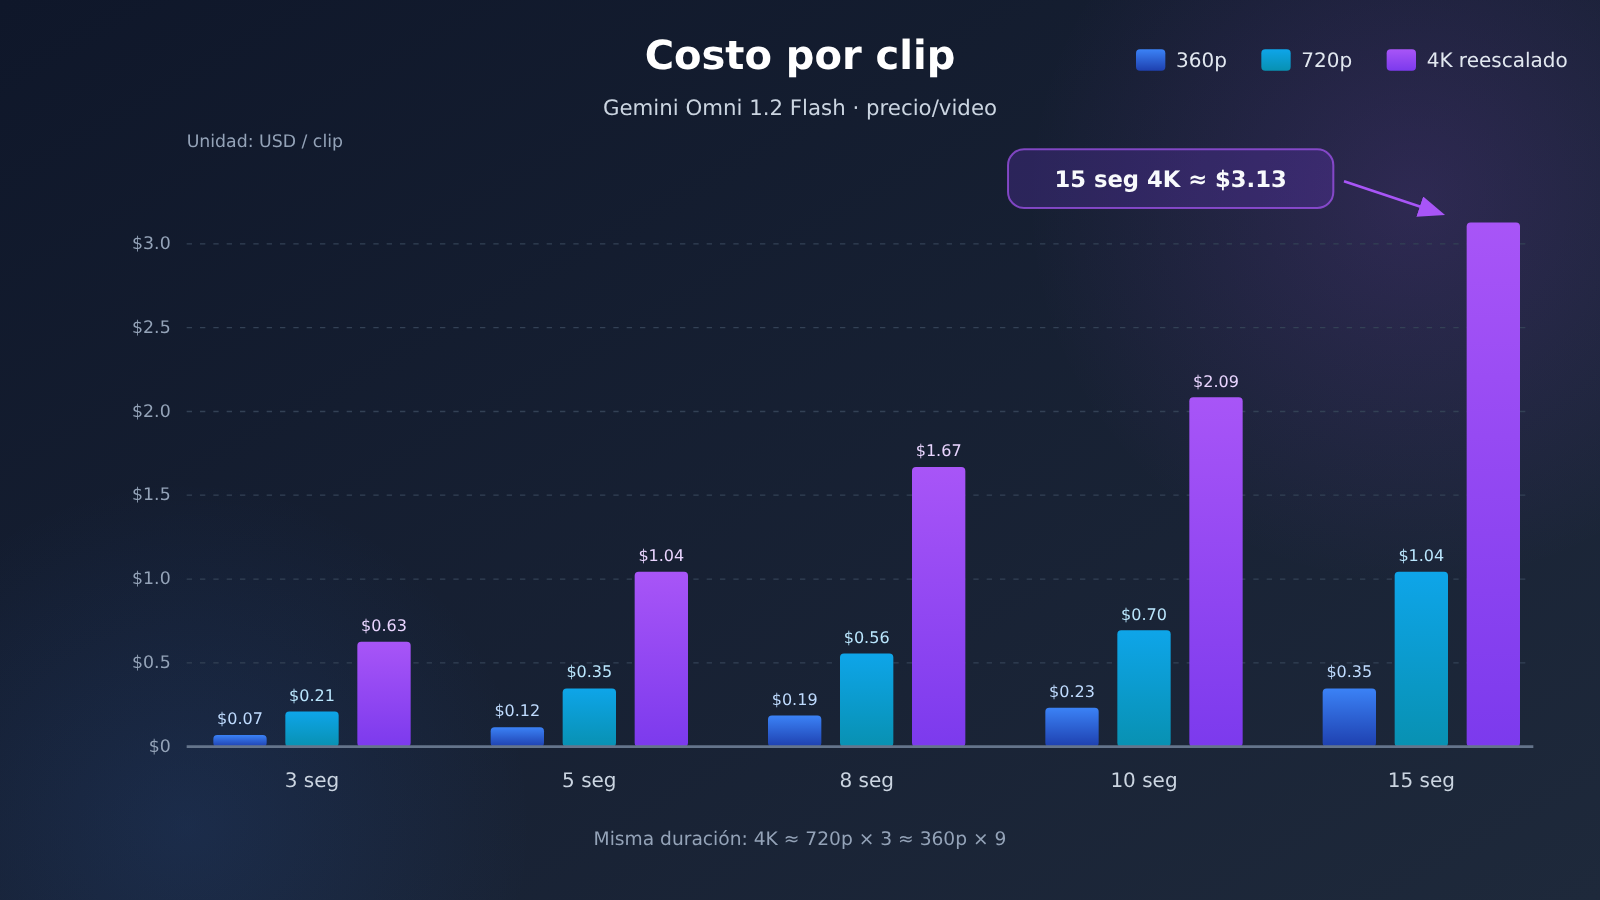
| Duración | 360p (1,931 tokens/s) | 720p (5,792 tokens/s) | 4K con superresolución (17,376 tokens/s) |
|---|---|---|---|
| 3 segundos | $0.070 | $0.209 | $0.626 |
| 5 segundos | $0.116 | $0.348 | $1.043 |
| 8 segundos | $0.185 | $0.556 | $1.668 |
| 10 segundos | $0.232 | $0.695 | $2.085 |
| 15 segundos | $0.348 | $1.043 | $3.128 |
Se puede ver que, para una misma duración, 4K cuesta aproximadamente 3 veces más que 720p y 9 veces más que 360p. Los materiales públicos no incluyen el valor de conversión de tokens para 1080p; si necesitas ese nivel, consulta la página oficial de precios.
3.3 Tres gastos que se suelen pasar por alto al estimar
La tabla anterior solo cubre la salida de video. La factura real también debe tener en cuenta las siguientes partes:
- Tokens de entrada: la indicación y las imágenes de referencia se cobran a $1.50 por millón de tokens. El número de tokens de hasta 6 imágenes de referencia depende de las reglas oficiales de conversión de imágenes; la documentación pública no ofrece un valor concreto.
- Costo de reintentos: si el resultado no te convence hay que volver a ejecutar, así que el presupuesto debería calcularse como «costo por clip × número medio de intentos». Por ahora no hay datos públicos sobre tasa de fallos o tasa de aceptación, así que conviene hacer primero pruebas con lotes pequeños.
- Estrategia de resolución: ajusta primero la indicación y los planos en 360p y, cuando lo tengas claro, genera en 720p o 4K; así recortas bastante los costos de prueba y error. Un clip de 8 segundos probado 5 veces en 360p cuesta unos $0.93, parecido a lo que cuesta ejecutarlo 2 veces en 720p.
4 Primeros pasos con Gemini Omni 1.2 Flash: flujo de invocación de tareas de video asíncronas
4.1 Las tres fases de una tarea asíncrona
La generación de video tarda mucho más que completar texto, por eso lo habitual es usar tareas asíncronas. Una invocación completa se divide en tres pasos:
- Crear la tarea: envías el modelo, la indicación, la duración, la resolución y demás parámetros, y la interfaz devuelve de inmediato el ID de la tarea y su estado inicial (por ejemplo
queued). - Consultar el estado: se pregunta por la tarea a intervalos fijos; el estado pasa por
queuedein_progresshasta terminar encompletedofailed. - Descargar el resultado: cuando el estado es
completed, se recupera el archivo de video mediante la interfaz de contenido.
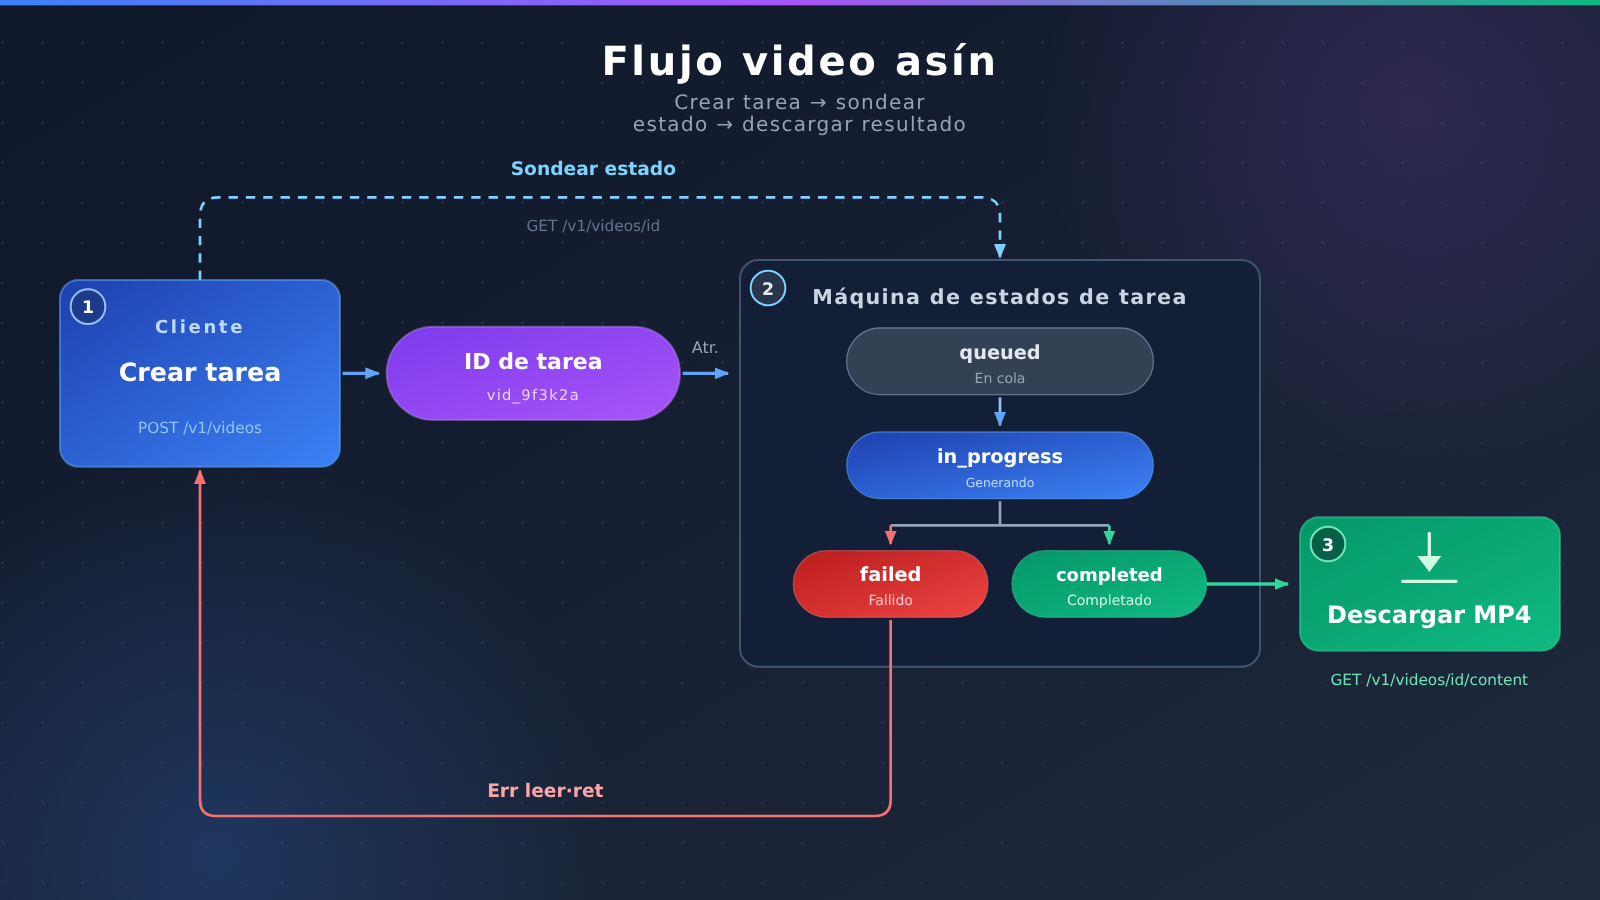
4.2 Ejemplo de invocación con formato compatible con OpenAI
El código siguiente usa la interfaz videos del SDK de OpenAI, y los nombres de parámetros provienen del formato compatible con OpenAI que publican las plataformas de terceros. Sustituye base_url y el ID del modelo por los valores que ofrece el servicio que realmente uses, y comprueba antes que ese servicio ya tiene disponible Gemini Omni 1.2 Flash.
import os, time
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIDEO_API_KEY"],
    base_url=os.environ["VIDEO_API_BASE_URL"],  # Sustituye por la dirección real del servicio
)

video = client.videos.create(
    model="gemini-omni-1.2-flash",   # Prevalece el ID de modelo publicado por el proveedor
    prompt="一只穿着迷你宇航服的猫在空间站里漂浮,背景有轻微的环境音",
    seconds="8",
    size="1280x720",
)

while video.status in ("queued", "in_progress"):
    time.sleep(5)
    video = client.videos.retrieve(video.id)

if video.status == "failed":
    raise RuntimeError(video.error)

client.videos.download_content(video.id).write_to_file("omni.mp4")
Si no usas el SDK, el flujo HTTP equivalente es: POST /v1/videos para crear la tarea, GET /v1/videos/{id} para consultar el estado y GET /v1/videos/{id}/content para descargar el video. En imagen a video, la imagen de referencia se pasa con el campo input_reference. Algunos servicios también ofrecen GET /v1/models?type=video, con el que puedes listar las duraciones y tamaños que admite cada modelo.
Ver la implementación completa con tiempos de espera, estimación de presupuesto y manejo de errores
import os, time
from openai import OpenAI

# Conversión oficial de salida de video (tokens por segundo), para estimar el costo antes de enviar
TOKENS_PER_SECOND = {"640x360": 1931, "1280x720": 5792}
VIDEO_OUTPUT_PRICE_PER_M = 12.00  # dólares / millón de tokens

def estimate_cost(size: str, seconds: int) -> float:
    tps = TOKENS_PER_SECOND.get(size)
    if tps is None:
        raise ValueError(f"未登记的分辨率: {size}")
    return tps * seconds * VIDEO_OUTPUT_PRICE_PER_M / 1_000_000

def generate_video(
    prompt: str,
    seconds: int = 8,
    size: str = "1280x720",
    out_path: str = "output.mp4",
    poll_interval: float = 5.0,
    timeout: float = 600.0,
    budget_usd: float = 1.0,
) -> str:
    cost = estimate_cost(size, seconds)
    if cost > budget_usd:
        raise ValueError(f"预估 ${cost:.3f} 超出单段预算 ${budget_usd}")
    print(f"预估视频输出成本: ${cost:.3f}")

    client = OpenAI(
        api_key=os.environ["VIDEO_API_KEY"],
        base_url=os.environ["VIDEO_API_BASE_URL"],
    )

    video = client.videos.create(
        model=os.environ.get("VIDEO_MODEL_ID", "gemini-omni-1.2-flash"),
        prompt=prompt,
        seconds=str(seconds),
        size=size,
    )
    print(f"任务已创建: {video.id}")

    start = time.time()
    while video.status in ("queued", "in_progress"):
        if time.time() - start > timeout:
            raise TimeoutError(f"任务 {video.id} 超时,可稍后用 ID 继续查询")
        time.sleep(poll_interval)
        video = client.videos.retrieve(video.id)
        print(f"状态: {video.status}")

    if video.status == "failed":
        raise RuntimeError(f"生成失败: {video.error}")

    client.videos.download_content(video.id).write_to_file(out_path)
    return out_path

if __name__ == "__main__":
    path = generate_video(
        prompt="清晨的咖啡店,蒸汽从杯口升起,背景有轻柔的人声与杯碟碰撞声",
        seconds=8,
        size="640x360",   # primero usar 360p para ajustar la indicación
        budget_usd=0.5,
    )
    print(f"已保存: {path}")
4.3 Recomendaciones de ingeniería para el sondeo y el almacenamiento
Con un intervalo de sondeo (polling) de unos 5 segundos vas sobrado; hacerlo demasiado rápido solo genera peticiones inútiles. En un entorno de producción, lo recomendable es guardar el ID de la tarea en la base de datos y dejar que una tarea en segundo plano se encargue del sondeo de forma centralizada: así, ni un refresco del frontend ni un reinicio del proceso te hará perder tareas por las que ya pagaste.
En cuanto descargues el video, conviene copiarlo lo antes posible a tu propio almacenamiento de objetos. Si necesitas generar en lote, puedes usar una cola para controlar la concurrencia y, antes de enviar cada tarea, hacer una validación de presupuesto con algo como estimate_cost; las tareas que se pasen del límite se bloquean directamente.
5 Aspectos que hay que confirmar antes de integrar Gemini Omni 1.2 Flash
5.1 Lista de verificación antes de integrar Gemini Omni 1.2 Flash
| Elemento a confirmar | Vía Google oficial | Vía plataforma compatible de terceros |
|---|---|---|
| Cuenta y pagos | Cuenta de Google, facturación de Cloud, tarjeta de crédito | Cuenta de la plataforma y método de recarga |
| Región | Tu región está dentro de la lista de países admitidos por Google | El alcance de servicio de la propia plataforma |
| Disponibilidad del modelo | Aparece en la página de precios y en la lista de modelos | Está publicado en la lista de modelos de la plataforma y el ID del modelo está confirmado |
| Alcance de funciones | Incluye edición conversacional y continuación mediante Interactions API | Normalmente, tareas de texto a video e imagen a video |
| Precio | Precio oficial por token | Precio publicado por la plataforma; compáralo con el oficial |
5.2 Validar la calidad y el tiempo de ejecución con una muestra pequeña
Actualmente no hay datos públicos de medición sobre la calidad de generación, el tiempo de ejecución ni la tasa de fallos. Te recomiendo preparar de 5 a 10 indicaciones que cubran tus escenarios principales, ejecutar primero una ronda a 360p y 5~8 segundos, registrar el tiempo, el éxito y la usabilidad de cada una, y luego decidir el presupuesto para la generación por lotes en alta resolución. El costo de salida de video de esta ronda de pruebas está entre $1 y $2.
6 Preguntas frecuentes (FAQ)
P1: ¿Qué tipo de modelo es Gemini Omni 1.2 Flash?
Es un modelo de generación de video lanzado por Google el 5 de noviembre de 2026. Puede generar videos de 3~15 segundos con audio nativo, con resoluciones que van de 360p a 4K, y admite hasta 6 imágenes de referencia.
P2: ¿Gemini Omni 1.2 Flash tiene nivel gratuito?
En la página de precios de la API de Gemini, el nivel gratuito de este modelo figura como «Not available», por lo que se necesita un proyecto de pago con facturación activada para poder invocarlo.
P3: ¿Cuánto cuesta aproximadamente generar un video con Gemini Omni 1.2 Flash?
Según el precio oficial de salida de video, 720p cuesta aproximadamente $0.07 por segundo: unos $0.56 por 8 segundos, $0.70 por 10 segundos y $1.04 por 15 segundos. El 360p cuesta aproximadamente un tercio de eso, y el 4K reescalado alrededor de 3 veces más. Los tokens de entrada de las indicaciones e imágenes de referencia se cobran aparte.
P4: ¿Qué hago si al invocar aparece «User location is not supported for the API use»?
Esto significa que la región de origen de la solicitud no está en la lista de regiones admitidas por la API de Gemini, y no tiene nada que ver con la clave ni con los parámetros. Es necesario realizar la invocación desde una región admitida o usar un servicio compatible que ya tenga este modelo disponible.
P5: ¿Se puede modificar un video de Gemini Omni 1.2 Flash mediante conversación después de generarlo?
La edición conversacional y la continuación son funciones de la API Interactions de Google. Las interfaces `/v1/videos` compatibles con OpenAI de terceros normalmente solo gestionan tareas de texto a video e imagen a video; si necesitas edición de varios turnos, conviene usar la interfaz propia de Google.
P6: ¿Para qué escenarios es adecuado Gemini Omni 1.2 Flash?
Es adecuado para clips cortos que necesiten sincronización entre audio e imagen: tomas de exhibición de productos de comercio electrónico, material para videos cortos en redes sociales, portadas animadas dentro de apps y previsualización de storyboards publicitarios. También funciona bien en escenarios que dependan de imágenes de referencia para mantener la apariencia de personajes o productos.
P7: ¿Cuáles son las limitaciones actuales de Gemini Omni 1.2 Flash?
Cada clip tiene una duración máxima de 15 segundos, así que los contenidos largos requieren concatenación; el 4K es una salida reescalada y tiene un costo mayor; no hay nivel gratuito; los canales oficiales de Google están sujetos a restricciones regionales. No hay datos públicos de medición sobre calidad de generación, tiempo de ejecución y tasa de fallos, por lo que conviene validarlo uno mismo con muestras pequeñas.
7 Puntos clave (Key Takeaways) de Gemini Omni 1.2 Flash
- Límites de capacidad: de 3 a 15 segundos, de 360p a 4K, hasta 6 imágenes de referencia, audio nativo
- Requisitos oficiales: sin nivel gratuito; se requiere un proyecto de pago de la API de Gemini y una región admitida
- Costo por segundo: 360p unos $0.023, 720p unos $0.07, 4K reescalado unos $0.209
- Referencias habituales: 8 segundos en 720p unos $0.56, 10 segundos en 720p unos $0.70
- Forma de invocación: tarea asíncrona; se completa en tres pasos: crear, sondear el estado (polling) y descargar
- A qué pertenecen estas funciones: la edición conversacional y la continuación son de la API Interactions de Google
- Estrategia para ahorrar: primero ajusta las indicaciones a 360p y, cuando estés conforme, genera en alta resolución
8 Conclusión: ¿vale la pena probar Gemini Omni 1.2 Flash?
El costo por segmento de Gemini Omni 1.2 Flash se sitúa en un rango que permite experimentar sin demasiado riesgo: un video de 10 segundos en 720p cuesta menos de 1 dólar, y el audio nativo además elimina un paso completo de doblaje. Para los desarrolladores en China, los principales obstáculos se concentran en los requisitos de facturación del plan de pago de Google y las restricciones regionales, además de que la edición conversacional solo está disponible en la interfaz propia de Google.
La ruta de decisión recomendada es: primero confirmar que se pueden cumplir los requisitos oficiales, o encontrar un servicio que ya haya lanzado oficialmente este modelo; luego usar la tabla comparativa de costos de este artículo para elaborar un presupuesto; finalmente, probar la calidad y el tiempo de ejecución con una muestra pequeña en 360p y, una vez que los datos cumplan con lo esperado, ampliar a escala de producción. El modelo se lanzó hace poco, por lo que los precios y la disponibilidad pueden cambiar; conviene revisar de nuevo la página oficial de precios de Google antes de cada integración.
Referencias
- Blog de TeamoRouter: instrucciones de uso de Gemini Omni 1.2 Flash: recopilación de información de lanzamiento, precios oficiales y descripción de su interfaz por parte de una plataforma de terceros
- Enlace:
teamorouter.com/zh/blogs/use-gemini-omni-1-2-flash-without-google-account -
Nota: fuente de los parámetros de capacidades y de los datos de conversión de tokens de este artículo; el contenido sobre la interfaz de la plataforma y las recargas es una descripción de la propia plataforma.
-
Página oficial de precios de Gemini API: estándares de facturación del modelo publicados por Google
- Enlace:
ai.google.dev/gemini-api/docs/pricing - Nota: se utiliza para verificar el estado del plan gratuito, el precio por millón de tokens y la conversión por resolución.


