
Zusammenfassung: Gemini Omni 1.2 Flash erzeugt Videos von 3 bis 15 Sekunden Länge mit nativem Audio. Wer den offiziellen Weg über Google geht, braucht einen kostenpflichtigen Tarif und eine unterstützte Region. Umgerechnet nach den öffentlichen Preisen kostet 720p etwa $0,07 pro Sekunde, ein 10-Sekunden-Segment also rund $0,70.
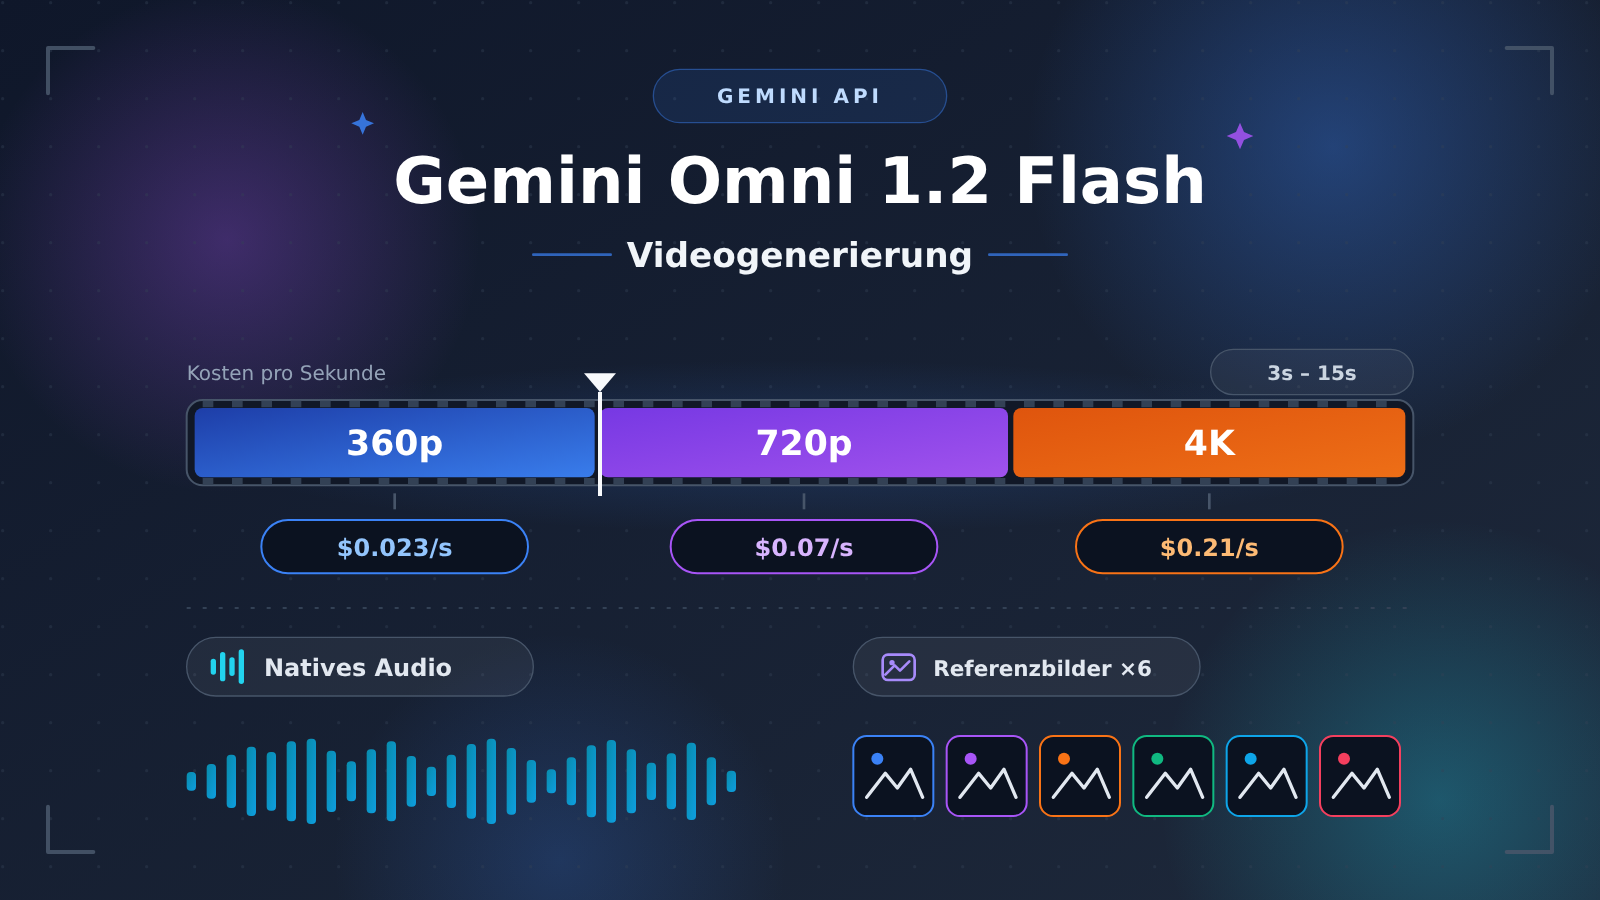
Fazit vorweg: Gemini Omni 1.2 Flash ist ein Videomodell, das Google am 5. November 2026 veröffentlicht hat. Es unterstützt Längen von 3 bis 15 Sekunden, Auflösungen von 360p bis 4K, bis zu 6 Referenzbilder und gibt natives Audio direkt mit aus. In der Gemini API gibt es dafür keinen kostenlosen Tarif: Vor dem Aufruf muss ein kostenpflichtiges Projekt mit aktivierter Abrechnung vorhanden sein, und die eigene Region muss in der Unterstützungsliste von Google AI Studio und der Gemini API stehen. Bei $12,00 pro Million Token für die Videoausgabe kostet 360p rund $0,023 pro Sekunde, 720p rund $0,07 pro Sekunde und 4K-Upscaling rund $0,21 pro Sekunde. Für die meisten Testszenarien liegt man mit einem 8-Sekunden-Video in 720p bei etwa $0,56 – ein einzelner Fehlversuch ist also günstig. Die eigentliche Hürde sind Konto, Abrechnung und Region.
Im Folgenden räumen wir zuerst mit einer Terminologie-Tabelle grundlegende Begriffe aus dem Weg, zerlegen dann die Fähigkeiten des Modells und die offiziellen Hürden, geben anschließend eine Kostenübersicht für verschiedene Auflösungs- und Längenkombinationen samt Schätzmethode, erklären danach die Aufrufform asynchroner Vide Aufträge – „erstellen, abfragen, herunterladen“ – und listen zum Schluss die Punkte auf, die man vor dem Anschluss einzeln prüfen sollte. Danach können Sie einschätzen, ob sich dieses Modell für Ihre Anwendung oder Ihren Content-Produktionsprozess lohnt.
To Know: Wichtige Begriffe zu Gemini Omni 1.2 Flash
| Begriff | Erklärung |
|---|---|
| Gemini API | Googles Schnittstelle für Modellaufrufe für Entwickler, Abrechnung nach Token |
| Google AI Studio | Googles Web-Konsole zum Debuggen, in der man API-Schlüssel erstellen und Modelle ausprobieren kann |
| Paid Tier (kostenpflichtiger Tarif) | Abrechnungsebene, die erst nach Verknüpfung eines Cloud-Abrechnungskontos nutzbar ist – das Gegenstück zum kostenlosen Tarif |
| Cloud-Abrechnung | Das Abrechnungskonto von Google Cloud, für das in der Regel eine Kreditkarte hinterlegt werden muss |
| token | Abrechnungseinheit des Modells; auch die Videoausgabe wird nach Auflösung und Dauer in Token umgerechnet |
| Natives Audio | Das Modell erzeugt den Ton gleichzeitig mit dem Bild, ein zusätzlicher Vertonungsschritt entfällt |
| Referenzbild | Beim Generieren mitgegebene Bilder, die die Konsistenz von Personen, Objekten oder Stil vorgeben |
| Text-zu-Video / Bild-zu-Video | Videoerzeugung mit einem Text-Prompt beziehungsweise mit einem Bild plus Prompt als Eingabe |
| 4K-Upscaling | Erst in niedrigerer Auflösung generieren und dann auf 4K hochskalieren; abgerechnet wird nach der 4K-Stufe |
| Asynchroner Auftrag | Nach dem Absenden erhält man zunächst eine Auftrags-ID und holt das Ergebnis ab, wenn die Generierung im Hintergrund fertig ist |
| Polling | In festen Abständen den Auftragsstatus abfragen, bis der Auftrag abgeschlossen ist oder fehlschlägt |
| Interactions API | Googles eigene Schnittstelle, die dialogbasierte Videobearbeitung, Fortsetzungen und Ähnliches bietet |
| OpenAI-kompatible Schnittstelle | Von Drittanbieterplattformen bereitgestellte Schnittstelle im Anfrageformat des OpenAI SDK, damit vorhandener Code weiterverwendet werden kann |
1 Die Kernpunkte von Gemini Omni 1.2 Flash: Was das Modell kann
1.1 Funktionsumfang und Grenzen von Gemini Omni 1.2 Flash
Die folgende Tabelle fasst die zentralen Parameter aus den derzeit öffentlich verfügbaren Unterlagen zusammen. Diese Angaben stammen aus der Aufbereitung der Google-Ankündigung durch Drittanbieterplattformen; vor dem produktiven Anschluss sollte man sie noch einmal auf der offiziellen Google-Release-Seite abgleichen.
| Dimension | Parameter | Bedeutung für Entwickler |
|---|---|---|
| Veröffentlichungsdatum | 5. November 2026 | Neues Modell; Preis und Verfügbarkeit können sich noch ändern |
| Videolänge | 3–15 Sekunden | Geeignet für kurze Videos, Werbespots und Produktdemos; längere Videos müssen zusammengesetzt werden |
| Auflösung | 360p bis 4K (4K per Hochskalierung) | Niedrige Auflösung für Vorschauen, hohe Auflösung für das finale Video – Kosten bleiben kontrollierbar |
| Referenzbilder | bis zu 6 | Ermöglicht das Festlegen von Charakteraussehen, Produktdetails oder Bildstil |
| Audio | natives Audio | Umgebungsgeräusche und Soundeffekte werden synchron zum Bild erzeugt, was die Nachbearbeitung reduziert |
| Kostenloser Tarif | keiner | Ein kostenpflichtiges Projekt muss zuerst aktiviert werden, bevor Aufrufe möglich sind |
1.2 Wohin die Funktionen von Gemini Omni 1.2 Flash gehören: Was nur über die eigenen Google-Schnittstellen verfügbar ist
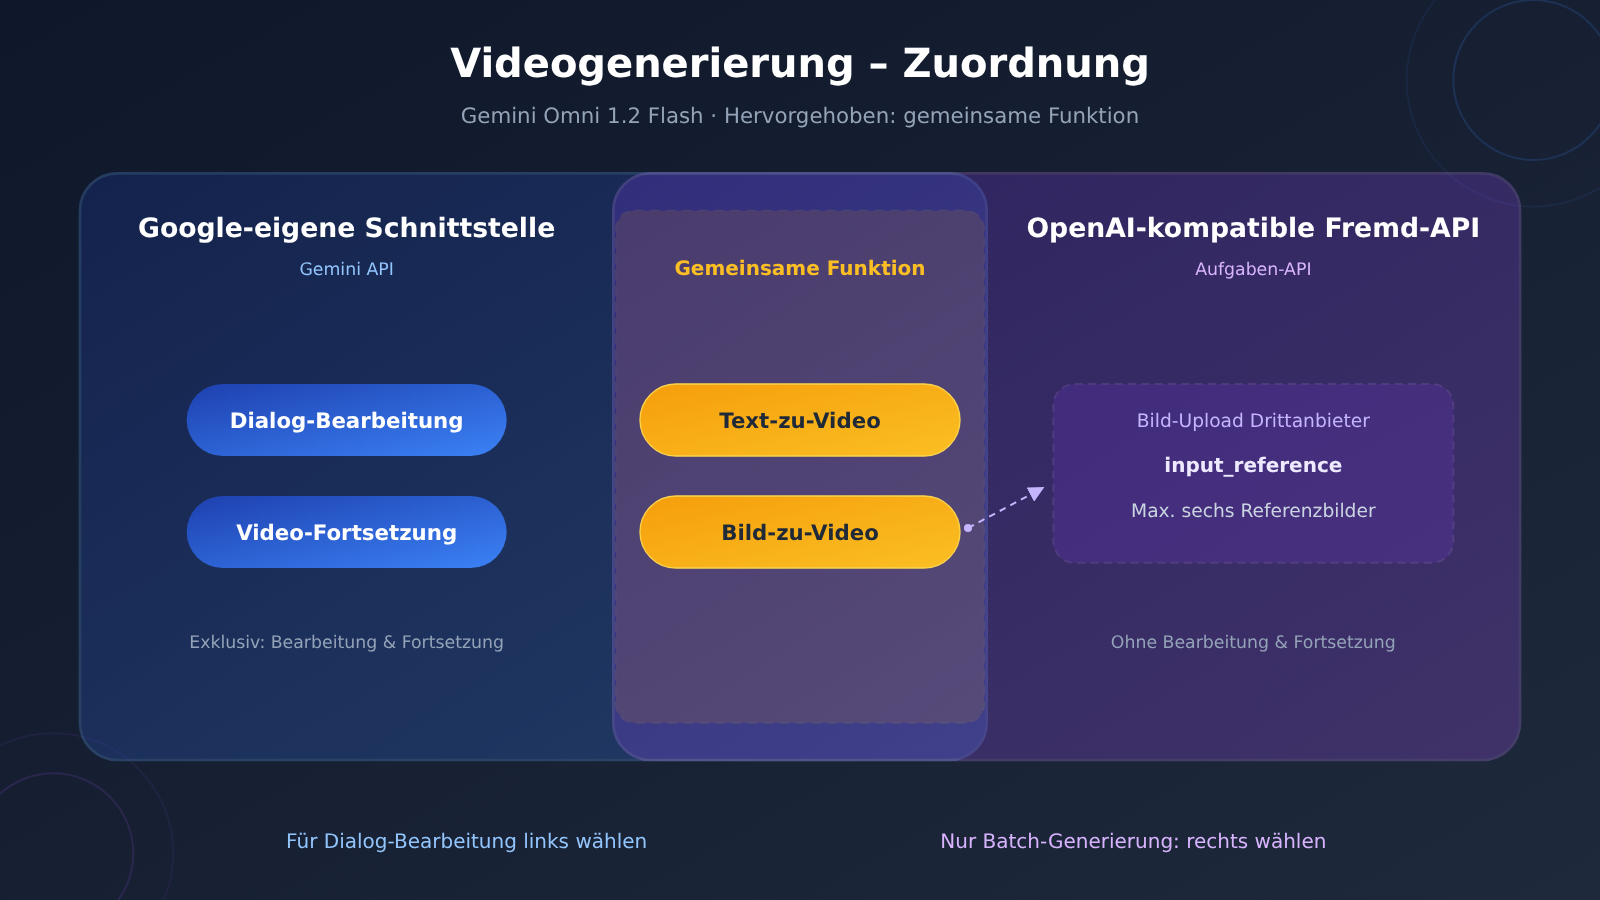
Text-zu-Video und Bild-zu-Video sind die beiden grundlegendsten Modi; Drittanbieterplattformen mit OpenAI-Kompatibilität decken sie in der Regel ebenfalls ab. Dialogbasierte Bearbeitung (ein vorheriges Video per natürlicher Sprache weiter ändern) und Video-Fortsetzung gehören zu den Funktionen der Google Interactions API.
Diese Unterscheidung ist für die Auswahl wichtig. Wenn Ihr Produkt nach der Generierung erlaubt, eine Einstellung mit einem Satz zu ändern, sollten Sie direkt die eigenen Google-Schnittstellen verwenden; wenn Sie nur unabhängige Segmente in Stapeln erzeugen, reicht eine aufgabenbasierte Schnittstelle aus.
2 Offizielle Voraussetzungen für Gemini Omni 1.2 Flash: Was Sie für den Weg über Google erfüllen müssen
2.1 Kostenpflichtiger Tarif und Cloud-Abrechnung
Auf der Google-Preisseite ist der kostenlose Tarif für Gemini Omni 1.2 Flash mit „Not available“ gekennzeichnet. Für den Aufruf benötigen Sie ein Gemini-API-Projekt mit aktivierter Abrechnung, also Google Cloud-Abrechnung und eine hinterlegte Kreditkarte.
Für Entwickler in China liegt die praktische Hürde bei diesem Schritt meist in einer nutzbaren ausländischen Zahlungsmethode und einem Google-Konto. Bei Teamnutzung sollten Sie vorab klären, wer das Abrechnungskonto hält und wie Budgetwarnungen eingerichtet werden, damit Testskripte durch wiederholte Aufrufe keine unerwarteten Rechnungen erzeugen.
2.2 Regionale Beschränkungen und Fehlererkennung
Google AI Studio und die Gemini API sind nur in unterstützten Regionen verfügbar. In Regionen, die nicht auf der Unterstützungsliste stehen, lässt sich AI Studio nicht öffnen, und API-Aufrufe geben „User location is not supported for the API use“ zurück.
Wenn dieser Fehler auftritt, liegt die Ursache in der Region, aus der die Anfrage stammt; ein anderer Key oder geänderte Parameter lösen das Problem nicht. Die Liste der unterstützten Regionen von Google wird laufend aktualisiert; prüfen Sie vor der Integration die aktuelle Liste in der offiziellen Dokumentation.
2.3 Offizielle Fakten zu Gemini Omni 1.2 Flash und Angaben von Drittanbietern auseinanderhalten
Auf dem Markt gibt es bereits Drittanbieterplattformen, die angekündigt haben, dieses Modell anzubinden. Ihre Darstellungen mischen offizielle Informationen von Google mit Beschreibungen der eigenen Dienste. Die folgende Tabelle trennt beide Arten von Informationen, damit Sie einschätzen können, welche Sie direkt zitieren können und welche Sie beim jeweiligen Anbieter selbst bestätigen sollten.
| Information | Kategorie | Erläuterung |
|---|---|---|
| Veröffentlichungsdatum, Dauer, Auflösung, Anzahl der Referenzbilder, natives Audio | Offizielle Google-Informationen (über Dritte wiedergegeben) | Maßgeblich ist die Google-Release-Seite |
| Kein kostenloses Kontingent, kostenpflichtiges Projekt erforderlich | Offizielle Google-Preisseite | Maßgeblich ist die Gemini-API-Preisseite |
| Preis pro Million Token, Token-Umrechnung pro Sekunde | Offizielle Google-Preisseite | Maßgeblich ist die Gemini-API-Preisseite |
| Dialogbasierte Bearbeitung, Fortschreibung gehören zur Interactions API | Eigene Schnittstellenfunktion von Google | Maßgeblich ist die Google-Dokumentation |
Modell-ID gemini-omni-1.2-flash |
Angaben der Drittanbieter-Plattform selbst | Die Benennung kann je Plattform abweichen, einzeln prüfen |
/v1/videos-Task-Schnittstelle, Parameter seconds / size |
Angaben der Drittanbieter-Plattform selbst | OpenAI-kompatible Kapselung, nicht Googles natives Format |
| Auflademöglichkeiten, Mindestaufladebetrag, Rückgabe 402 bei unzureichendem Guthaben | Angaben der Drittanbieter-Plattform selbst | Gilt nur für diese Plattform |
| „Bereits verfügbar / Demnächst verfügbar“ | Angaben der Drittanbieter-Plattform selbst | Zum Zeitpunkt der Veröffentlichung auf dieser Plattform noch nicht live, in Echtzeit prüfen |
3 Kostenkalkulation für Gemini Omni 1.2 Flash: Umrechnung nach Sekunden und Segmenten
3.1 Offizielle Preisstruktur
Die Gemini API rechnet dieses Modell nach Token ab, der Preis pro Million Token sieht so aus: Eingabe $1.50, Videoausgabe $12.00, Textausgabe $9.00. Die Videoausgabe-Token werden nach Auflösung und Sekundenzahl umgerechnet:
- 360p: 1.931 Token pro Sekunde, ca. $0.023 pro Sekunde
- 720p: 5.792 Token pro Sekunde, ca. $0.07 pro Sekunde
- Hochskaliertes 4K: 17.376 Token pro Sekunde, ca. $0.209 pro Sekunde
Die Formel ist denkbar einfach: Kosten für ein Videoausgabe-Segment = Token pro Sekunde × Sekunden × $12 ÷ 1.000.000. Ein Beispiel mit 720p und 10 Sekunden ergibt 5.792 × 10 × 12 ÷ 1.000.000 ≈ $0.695.
3.2 Kostentabelle Gemini Omni 1.2 Flash: Auflösung × Dauer
Die folgende Tabelle basiert auf dem offiziellen Stückpreis für die Videoausgabe, enthält nur den Teil der Videoausgabe und ist auf drei Nachkommastellen gerundet.
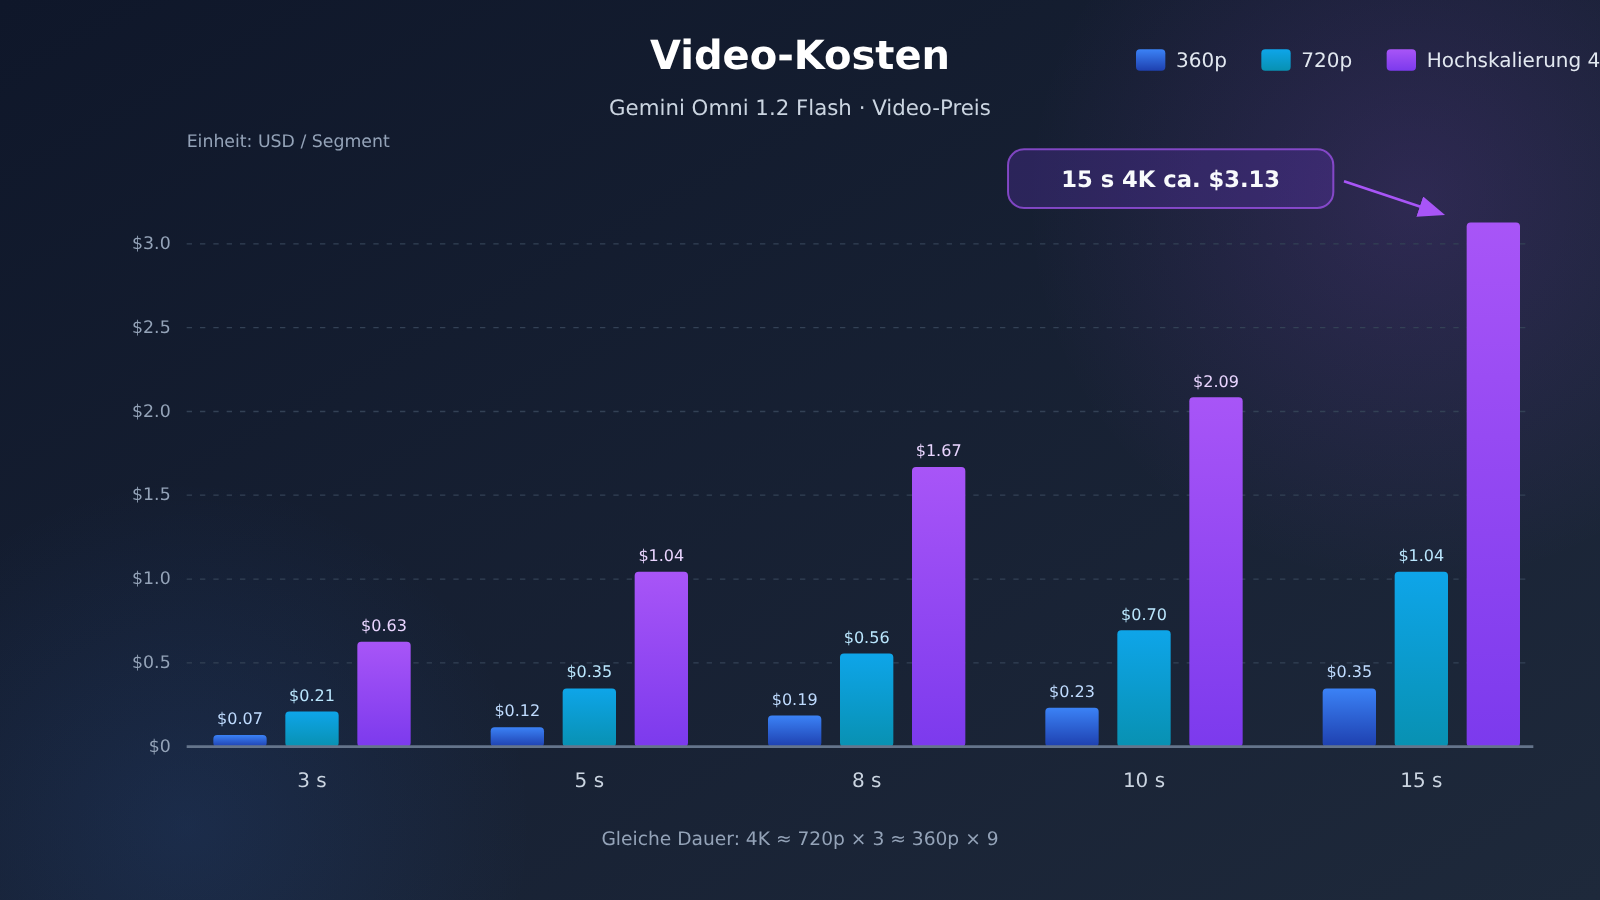
| Dauer | 360p (1.931 Token/Sek.) | 720p (5.792 Token/Sek.) | Hochskaliertes 4K (17.376 Token/Sek.) |
|---|---|---|---|
| 3 Sekunden | $0.070 | $0.209 | $0.626 |
| 5 Sekunden | $0.116 | $0.348 | $1.043 |
| 8 Sekunden | $0.185 | $0.556 | $1.668 |
| 10 Sekunden | $0.232 | $0.695 | $2.085 |
| 15 Sekunden | $0.348 | $1.043 | $3.128 |
Man sieht: Bei gleicher Dauer kostet 4K etwa das Dreifache von 720p und das Neunfache von 360p. In den öffentlich zugänglichen Unterlagen gibt es keinen Token-Umrechnungswert für 1080p – wenn Sie diese Stufe brauchen, schauen Sie bitte auf der offiziellen Preisseite nach.
3.3 Drei Kostenposten, die bei der Kalkulation leicht übersehen werden
Die obige Tabelle deckt nur die Videoausgabe ab. Bei der tatsächlichen Abrechnung kommen noch folgende Teile hinzu:
- Eingabe-Token: Eingabeaufforderungen und Referenzbilder werden mit $1.50 pro Million Token abgerechnet. Die Token-Anzahl von bis zu 6 Referenzbildern hängt von der offiziellen Umrechnungsregel für Bilder ab; öffentlich verfügbare Materialien geben keinen konkreten Wert an.
- Kosten für Wiederholungen: Wenn das Ergebnis nicht zufriedenstellt, muss neu generiert werden. Das Budget sollte als „Kosten pro Segment × durchschnittliche Anzahl der Versuche“ berechnet werden. Derzeit gibt es keine öffentlichen Daten zu Fehlerraten oder Übernahmequoten; es wird empfohlen, zunächst mit kleinen Stapelaufgaben zu testen.
- Auflösungsstrategie: Zuerst mit 360p die Eingabeaufforderung und die Kameraeinstellung abstimmen, danach 720p oder 4K ausgeben – das senkt die Trial-and-Error-Kosten deutlich. Ein 8-Sekunden-Clip kostet bei 360p für 5 Versuche etwa $0.93, ähnlich viel wie 2 Durchläufe bei 720p.
4 Gemini Omni 1.2 Flash Schnellstart: Aufrufablauf für asynchrone Videoaufgaben
4.1 Die drei Phasen einer asynchronen Aufgabe
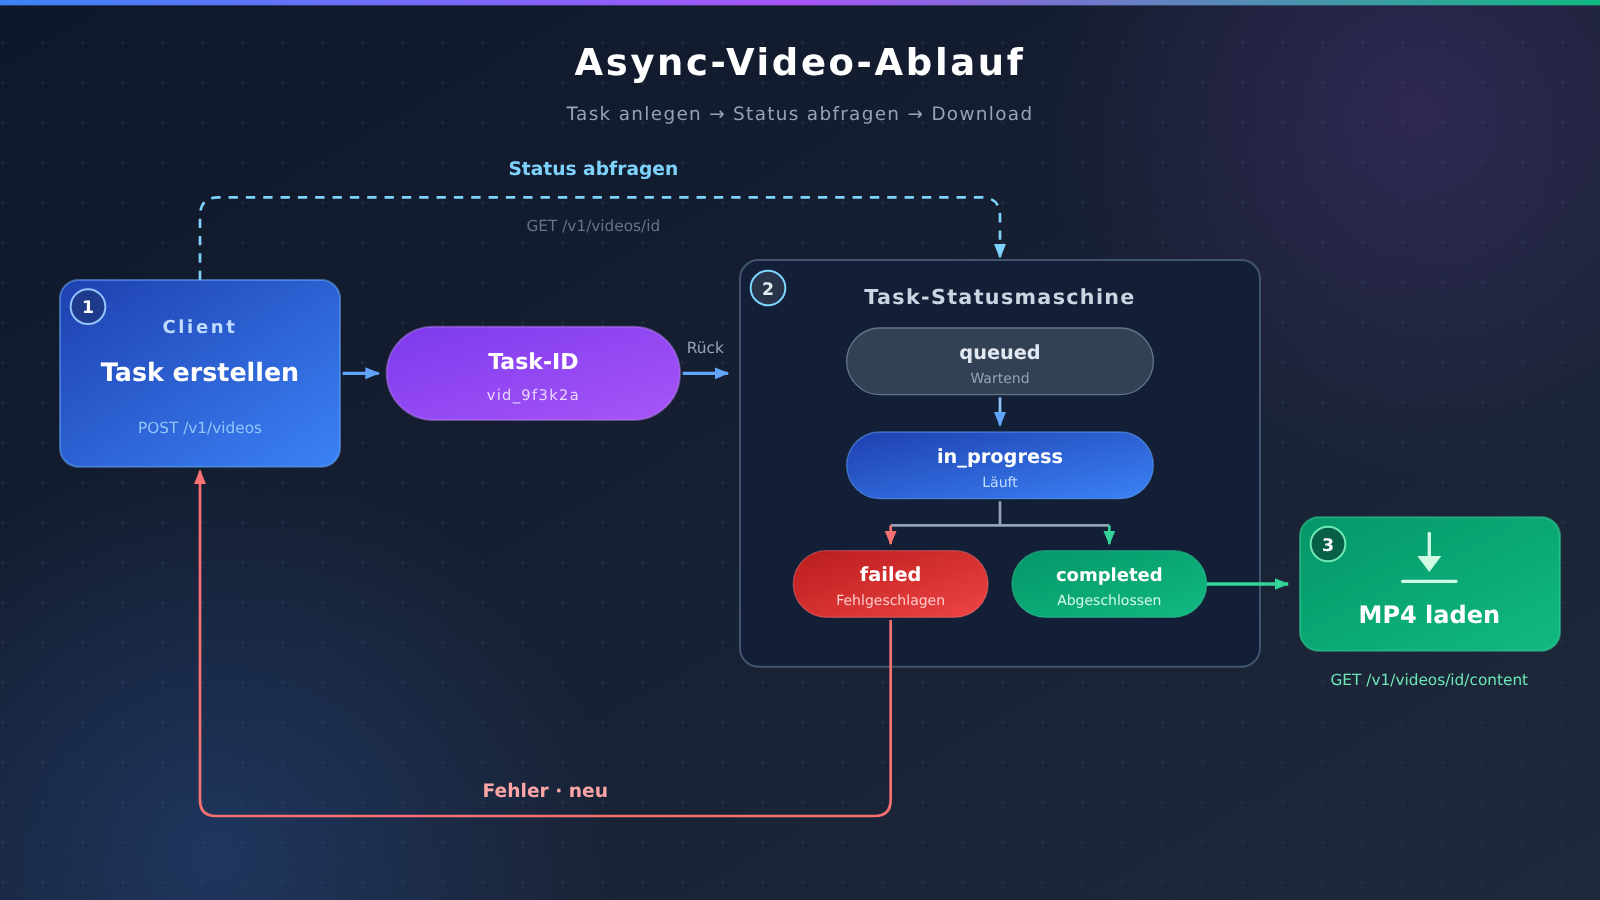
Die Videogenerierung dauert deutlich länger als die Textvervollständigung, daher wird üblicherweise die Form asynchroner Aufgaben verwendet. Ein vollständiger Aufruf erfolgt in drei Schritten:
- Aufgabe erstellen: Parameter wie Modell, Eingabeaufforderung, Dauer und Auflösung übermitteln; die Schnittstelle gibt sofort die Aufgaben-ID und den initialen Status zurück (z. B.
queued). - Status abfragen: Die Aufgabe in festen Intervallen abfragen; der Status durchläuft nacheinander
queued,in_progressund endet schließlich beicompletedoderfailed. - Ergebnis herunterladen: Nach Erreichen des Status
completeddie Videodatei über die Content-Schnittstelle abrufen.
4.2 Aufrufbeispiel im OpenAI-kompatiblen Format
Der folgende Code verwendet die videos-Schnittstelle des OpenAI SDK; die Parameternamen stammen aus dem öffentlich dokumentierten OpenAI-kompatiblen Format von Drittanbieterplattformen. Ersetzen Sie base_url und die Modell-ID durch die Werte des Dienstes, den Sie tatsächlich verwenden, und stellen Sie zunächst sicher, dass dieser Dienst Gemini Omni 1.2 Flash bereits anbietet.
import os, time
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["VIDEO_API_KEY"],
    base_url=os.environ["VIDEO_API_BASE_URL"],  # Durch tatsächliche Dienstadresse ersetzen
)

video = client.videos.create(
    model="gemini-omni-1.2-flash",   # Die vom Dienstleister veröffentlichte Modell-ID ist maßgeblich
    prompt="一只穿着迷你宇航服的猫在空间站里漂浮,背景有轻微的环境音",
    seconds="8",
    size="1280x720",
)

while video.status in ("queued", "in_progress"):
    time.sleep(5)
    video = client.videos.retrieve(video.id)

if video.status == "failed":
    raise RuntimeError(video.error)

client.videos.download_content(video.id).write_to_file("omni.mp4")
Wenn Sie das SDK nicht verwenden, lautet der entsprechende HTTP-Ablauf: POST /v1/videos zum Erstellen der Aufgabe, GET /v1/videos/{id} zum Abfragen des Status, GET /v1/videos/{id}/content zum Herunterladen des Videos. Beim Bild-zu-Video wird das Referenzbild über das Feld input_reference übergeben. Einige Dienste bieten außerdem GET /v1/models?type=video an, womit sich die von den jeweiligen Modellen unterstützten Dauern und Größen auflisten lassen.
Vollständige Implementierung mit Timeout, Budgetschätzung und Fehlerbehandlung anzeigen
import os, time
from openai import OpenAI

# Offizielle Umrechnung der Video-Ausgabe (Token pro Sekunde) für die Kostenschätzung vor der Einreichung
TOKENS_PER_SECOND = {"640x360": 1931, "1280x720": 5792}
VIDEO_OUTPUT_PRICE_PER_M = 12.00  # US-Dollar / Million Token

def estimate_cost(size: str, seconds: int) -> float:
    tps = TOKENS_PER_SECOND.get(size)
    if tps is None:
        raise ValueError(f"未登记的分辨率: {size}")
    return tps * seconds * VIDEO_OUTPUT_PRICE_PER_M / 1_000_000

def generate_video(
    prompt: str,
    seconds: int = 8,
    size: str = "1280x720",
    out_path: str = "output.mp4",
    poll_interval: float = 5.0,
    timeout: float = 600.0,
    budget_usd: float = 1.0,
) -> str:
    cost = estimate_cost(size, seconds)
    if cost > budget_usd:
        raise ValueError(f"预估 ${cost:.3f} 超出单段预算 ${budget_usd}")
    print(f"预估视频输出成本: ${cost:.3f}")

    client = OpenAI(
        api_key=os.environ["VIDEO_API_KEY"],
        base_url=os.environ["VIDEO_API_BASE_URL"],
    )

    video = client.videos.create(
        model=os.environ.get("VIDEO_MODEL_ID", "gemini-omni-1.2-flash"),
        prompt=prompt,
        seconds=str(seconds),
        size=size,
    )
    print(f"任务已创建: {video.id}")

    start = time.time()
    while video.status in ("queued", "in_progress"):
        if time.time() - start > timeout:
            raise TimeoutError(f"任务 {video.id} 超时,可稍后用 ID 继续查询")
        time.sleep(poll_interval)
        video = client.videos.retrieve(video.id)
        print(f"状态: {video.status}")

    if video.status == "failed":
        raise RuntimeError(f"生成失败: {video.error}")

    client.videos.download_content(video.id).write_to_file(out_path)
    return out_path

if __name__ == "__main__":
    path = generate_video(
        prompt="清晨的咖啡店,蒸汽从杯口升起,背景有轻柔的人声与杯碟碰撞声",
        seconds=8,
        size="640x360",   # Zuerst mit 360p die Eingabeaufforderung abstimmen
        budget_usd=0.5,
    )
    print(f"已保存: {path}")
4.3 Praktische Empfehlungen zu Polling und Speicherung
Ein Polling-Intervall von etwa 5 Sekunden reicht aus – häufigere Abfragen erzeugen nur unnötige Requests. Für den Produktivbetrieb empfiehlt es sich, die Aufgabe-ID in eine Datenbank zu schreiben und das Polling zentral von einem Hintergrundjob erledigen zu lassen. So gehen bereits bezahlte Aufgaben weder beim Neuladen der Oberfläche noch bei einem Neustart des Prozesses verloren.
Heruntergeladene Videos sollten zügig in den eigenen Objektspeicher übertragen werden. Bei Massengenerierung lässt sich die Parallelität über eine Warteschlange steuern; vor der Einreichung prüft eine Funktion wie estimate_cost das Budget, und Aufgaben, die es überschreiten, werden direkt blockiert.
5 Was vor der Anbindung von Gemini Omni 1.2 Flash geklärt sein sollte
5.1 Checkliste vor der Anbindung von Gemini Omni 1.2 Flash
| Prüfpunkt | Direkt über Google | Über eine kompatible Drittanbieter-Plattform |
|---|---|---|
| Konto und Zahlung | Google-Konto, Cloud-Abrechnung, Kreditkarte | Plattformkonto und Auflademethode |
| Region | Wohnregion innerhalb der Google-Supportliste | Eigener Servicebereich der Plattform |
| Modellverfügbarkeit | Auf der Preisseite und in der Modellliste aufgeführt | In der Modellliste der Plattform verfügbar, Modell-ID bestätigt |
| Funktionsumfang | Inklusive dialogbasierter Bearbeitung und Fortsetzung über die Interactions API | Meist Text-zu-Video- und Bild-zu-Video-Aufgaben |
| Preis | Offizieller Token-Preis | Plattformpreis, im Vergleich zum offiziellen Preis |
5.2 Qualität und Laufzeit mit einer kleinen Stichprobe prüfen
In den derzeit öffentlich verfügbaren Unterlagen gibt es keine Messdaten zu Generierungsqualität, Laufzeit und Fehlerrate. Es empfiehlt sich, 5 bis 10 Eingabeaufforderungen vorzubereiten, die deine Kernanwendungsfälle abdecken, zunächst eine Runde bei 360p und 5 bis 8 Sekunden laufen zu lassen und für jede Eingabeaufforderung Laufzeit, Erfolg und Verwendbarkeit zu protokollieren. Danach kannst du das Budget für die Batch-Generierung in hoher Auflösung festlegen. Die Kosten für die Videoausgabe dieser Testrunde liegen zwischen $1 und $2.
6 Häufig gestellte Fragen (FAQ)
Q1: Was für ein Modell ist Gemini Omni 1.2 Flash?
Es ist ein Modell für die Videogenerierung, das Google am 5. November 2026 veröffentlicht hat. Es erzeugt Videos mit 3 bis 15 Sekunden Länge und nativem Audio, die Auflösung reicht von 360p bis 4K, und es unterstützt bis zu 6 Referenzbilder.
Q2: Gibt es für Gemini Omni 1.2 Flash ein kostenloses Kontingent?
Auf der Preisseite der Gemini API ist der kostenlose Tarif für dieses Modell mit „Not available“ gekennzeichnet. Um es aufzurufen, ist ein kostenpflichtiges Projekt mit aktivierter Abrechnung erforderlich.
Q3: Wie viel kostet die Generierung eines Videos mit Gemini Omni 1.2 Flash ungefähr?
Nach dem offiziellen Preis für die Videoausgabe kostet 720p etwa $0.07 pro Sekunde: 8 Sekunden etwa $0.56, 10 Sekunden etwa $0.70, 15 Sekunden etwa $1.04. 360p kostet etwa ein Drittel davon, hochskaliertes 4K etwa das Dreifache. Die Eingabe-Token für Eingabeaufforderungen und Referenzbilder werden separat berechnet.
Q4: Was tun, wenn beim Aufruf „User location is not supported for the API use“ erscheint?
Das bedeutet, dass die Region, aus der die Anfrage stammt, nicht in der Liste der von der Gemini API unterstützten Regionen enthalten ist. Das hat nichts mit dem API-Schlüssel oder den Parametern zu tun. Du musst den Aufruf aus einer unterstützten Region heraus starten oder auf einen konformen Dienst ausweichen, der dieses Modell bereits anbietet.
Q5: Kann man ein mit Gemini Omni 1.2 Flash generiertes Video anschließend im Dialog ändern?
Dialogbasierte Bearbeitung und Fortsetzung sind Funktionen der Google Interactions API. Die OpenAI-kompatiblen `/v1/videos`-Schnittstellen von Drittanbietern übernehmen in der Regel nur Text-zu-Video- und Bild-zu-Video-Aufgaben. Wenn du mehrere Bearbeitungsrunden benötigst, solltest du die Google-eigenen Schnittstellen verwenden.
Q6: Für welche Anwendungsfälle eignet sich Gemini Omni 1.2 Flash?
Es eignet sich für kurze Clips, bei denen Ton und Bild synchron sein müssen: Produktaufnahmen für den E-Commerce, Kurzvideos für Social Media, animierte Cover in einer App und Storyboard-Previews für Werbung. Auch Szenarien, in denen Referenzbilder das Aussehen von Figuren oder Produkten festlegen sollen, passen gut.
Q7: Welche Einschränkungen gibt es bei Gemini Omni 1.2 Flash derzeit?
Ein einzelner Clip ist maximal 15 Sekunden lang, längere Inhalte müssen aneinandergesetzt werden; 4K ist eine hochskalierte Ausgabe und entsprechend teurer; es gibt keinen kostenlosen Tarif; die offiziellen Google-Kanäle unterliegen regionalen Beschränkungen. Zu Generierungsqualität, Laufzeit und Fehlerrate gibt es derzeit keine öffentlichen Messdaten, daher musst du selbst mit einer kleinen Stichprobe testen.
7 Gemini Omni 1.2 Flash: Wichtigste Erkenntnisse (Key Takeaways)
- Funktionsumfang: 3–15 Sekunden, 360p bis 4K, bis zu 6 Referenzbilder, nativer Ton
- Offizielle Hürde: kein kostenloses Kontingent, erforderlich sind ein bezahltes Gemini-API-Projekt und eine unterstützte Region
- Kosten pro Sekunde: 360p ca. $0.023, 720p ca. $0.07, Upscaling auf 4K ca. $0.209
- Gängige Referenzwerte: 8 Sekunden 720p ca. $0.56, 10 Sekunden 720p ca. $0.70
- Aufrufform: asynchrone Aufgabe, in drei Schritten erledigt – erstellen, abfragen, herunterladen
- Zuordnung der Funktionen: dialogbasierte Bearbeitung und Fortsetzung gehören zur Google Interactions API
- Strategie zum Sparen: zuerst in 360p die Eingabeaufforderung abstimmen, erst nach der Bestätigung in hoher Auflösung rendern
8 Fazit: Lohnt sich ein Test von Gemini Omni 1.2 Flash?
Die Kosten pro Segment bei Gemini Omni 1.2 Flash liegen in einem Bereich, in dem man bedenkenlos ausprobieren kann: Ein 10-Sekunden-Video in 720p kostet weniger als 1 US-Dollar, und der native Ton spart obendrein einen kompletten Vertonungsschritt. Für Entwickler in China liegen die Haupthindernisse bei den Abrechnungsanforderungen des kostenpflichtigen Google-Tarifs und bei den regionalen Einschränkungen – sowie bei der Tatsache, dass die dialogbasierte Bearbeitung nur über die Google-eigenen Schnittstellen verfügbar ist.
Der empfohlene Entscheidungsweg sieht so aus: Prüfen Sie zuerst, ob Sie die offiziellen Voraussetzungen erfüllen können oder einen Dienst finden, der das Modell bereits offiziell anbietet. Kalkulieren Sie dann mit der Kostentabelle aus diesem Artikel Ihr Budget. Testen Sie zum Schluss mit kleinen 360p-Beispielen Qualität und Laufzeit; erst wenn die Werte passen, skalieren Sie auf Produktionsniveau. Das Modell ist noch sehr neu, Preise und Verfügbarkeit können sich ändern – prüfen Sie daher vor jeder Integration erneut die offizielle Preisseite von Google.
Referenzen
- TeamoRouter-Blog: Anleitung zur Nutzung von Gemini Omni 1.2 Flash: Zusammenstellung der Veröffentlichungsinformationen und offiziellen Preise durch eine Drittplattform samt Beschreibung ihrer Schnittstellen
- Link:
teamorouter.com/zh/blogs/use-gemini-omni-1-2-flash-without-google-account -
Beschreibung: Quelle für die Funktionsparameter und die Token-Umrechnungsdaten in diesem Artikel; Angaben zu Plattform-Schnittstellen und zum Aufladen stammen aus der Selbstdarstellung der Plattform
-
Offizielle Preisseite der Gemini API: die von Google veröffentlichten Abrechnungsstandards für die Modelle
- Link:
ai.google.dev/gemini-api/docs/pricing - Beschreibung: dient zur Prüfung des Status des kostenlosen Kontingents, des Preises pro eine Million Token und der Umrechnung nach Auflösung


