
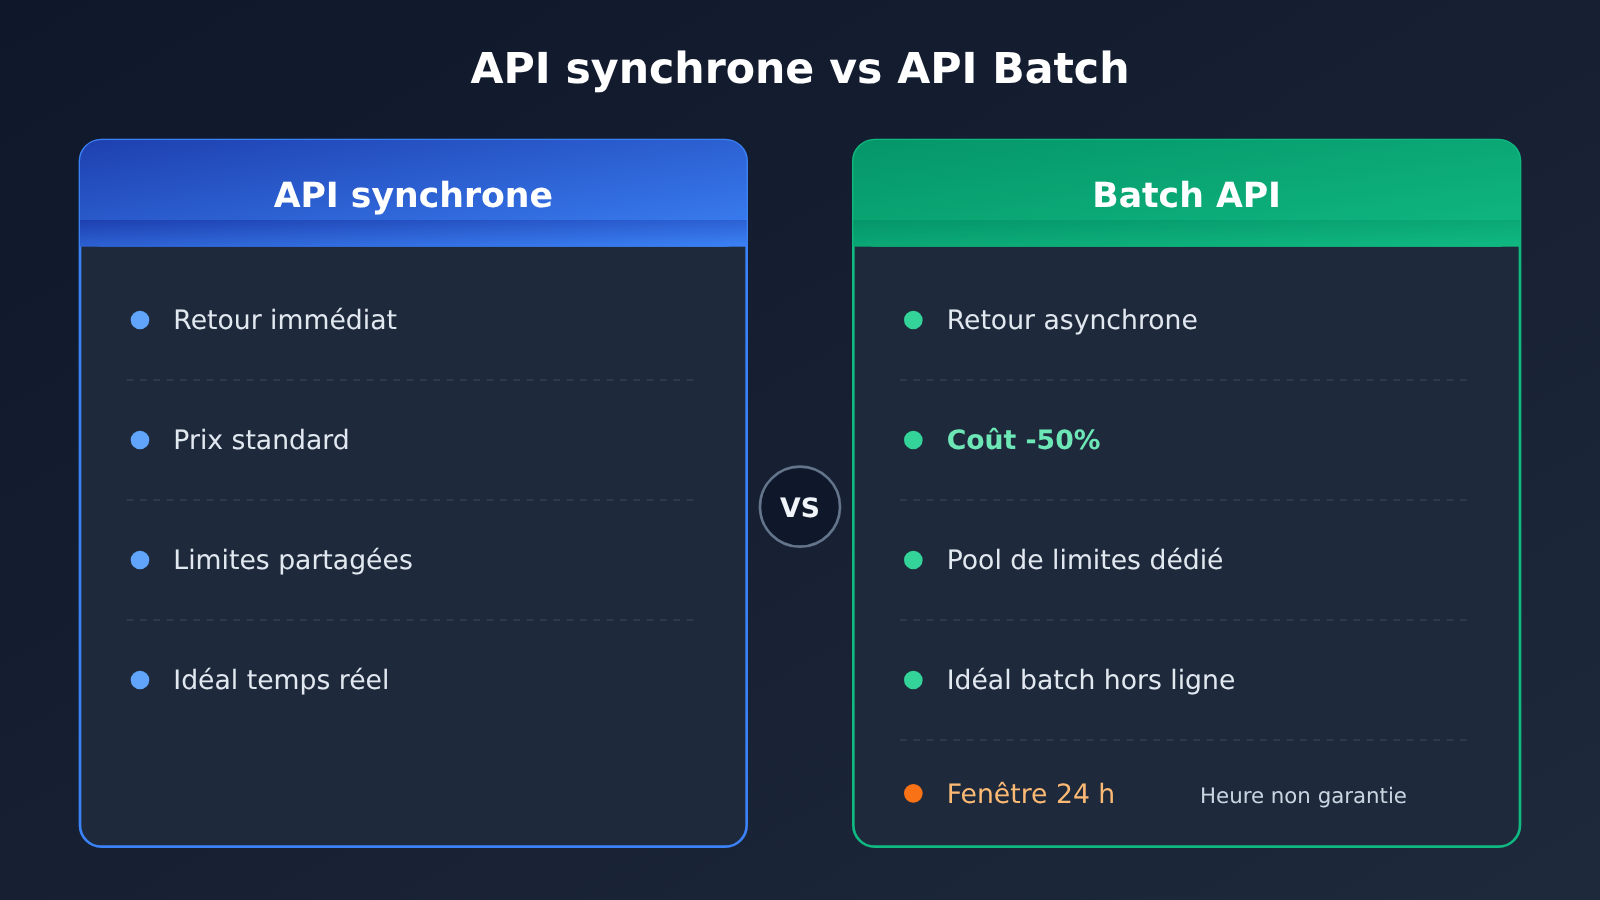
**Réponse directe : l’API Batch d’OpenAI convient aux tâches où « le résultat peut arriver un peu plus tard, où les requêtes sont indépendantes les unes des autres et où le volume est important ». Son tarif correspond à la moitié de celui de l’API synchrone, et elle dispose d’un pool de limites de débit séparé. Sa contrainte : une fenêtre de traitement de 24 heures, sans garantie de livraison à un moment précis. Les travaux hors ligne comme la classification selon des règles établies, l’enrichissement de bases de connaissances ou l’évaluation de modèles peuvent passer par Batch en priorité. En revanche, le support client en temps réel, les interactions exigeant une réponse immédiate et les chaînes de traitement où le résultat d’une étape conditionne l’étape suivante ne devraient pas être confiés à l’API Batch.
Que retiendrez-vous de cet article ?
- Les règles essentielles de l’API Batch d’OpenAI : remise, limites de débit, fenêtre de traitement, format de fichier et plafonds de volume.
- La différence entre trois choses : soumission réussie, génération réussie et livraison dans les délais.
- Comment facturer un lot expiré, et comment ne relancer que les requêtes en échec.
- Sur quoi porte exactement la remise de 50 %, et quels coûts ne sont pas divisés par deux.
- Une méthode pratique pour déterminer si une tâche se prête à Batch.
Sommaire : Avant d’entrer dans le vif, un tableau conceptuel et un aperçu des impacts vous aideront à poser les bases. La partie « Faits objectifs » passe en revue, point par point, les règles de la documentation officielle ; la partie « Analyse et interprétation » examine ce que ces règles impliquent pour le choix des tâches, l’estimation des coûts et la conception technique, avec les types de tâches adaptés et non adaptés.
Précision importante : cet article s’appuie sur le guide Batch maintenu en continu par OpenAI, vérifié le 2026-11-17. Ce document n’a pas de date de publication initiale explicite ; nous ne le présentons donc pas comme une nouveauté sortie ce jour-là, mais comme une lecture des règles d’une capacité existante.
À savoir : comprendre les concepts clés de l’API Batch d’OpenAI
| Concept | Explication brève |
|---|---|
| API synchrone | Mode d’appel classique où l’on attend immédiatement la réponse après l’envoi de la requête |
| API Batch | Interface qui permet de soumettre un grand nombre de requêtes en une fois, de les traiter de manière asynchrone et de récupérer les résultats plus tard |
| JSONL | Format texte où chaque ligne est un objet JSON indépendant ; dans Batch, chaque ligne correspond à une requête |
| custom_id | Identifiant unique que vous définissez pour chaque requête, afin de relier le résultat à la requête d’origine |
| Pool de limitation de débit indépendant | Les limites de débit des requêtes Batch sont calculées séparément de celles des requêtes synchrones, sans se concurrencer |
| Fenêtre de traitement de 24 heures | Délai de traitement d’un lot ; les requêtes non terminées à l’expiration sont annulées |
| Lot expiré | Lot qui n’est pas entièrement terminé après la fenêtre de traitement |
Aperçu des impacts de l’API Batch d’OpenAI
- Développeurs : pour les tâches batch hors ligne, on peut estimer le coût API à la moitié du tarif synchrone, sans consommer le quota de limitation de débit synchrone des services en ligne. Il faut toutefois implémenter soi-même la correspondance des custom_id, la resoumission des échecs et la vérification des résultats.
- Équipes contenu et données : les gros volumes de classification, de résumé et de nettoyage de base de connaissances sont plus rentables. En contrepartie, il faut renoncer au « résultat immédiat » et prévoir une marge dans les délais de livraison.
- Évaluation et recherche : Batch est très adapté à l’exécution de jeux de test à grande échelle. Attention toutefois : un fichier ne peut utiliser qu’un seul modèle ; les comparaisons multi-modèles doivent être réparties sur plusieurs fichiers.
- Responsables produit et opérations : il ne faut pas interpréter « 24 heures » comme « livraison garantie demain matin ». Pour les engagements de délai externes, Batch doit être considéré comme un canal best-effort.
Faits objectifs sur l’API Batch d’OpenAI
Règles de facturation et de limitation de débit de l’API Batch
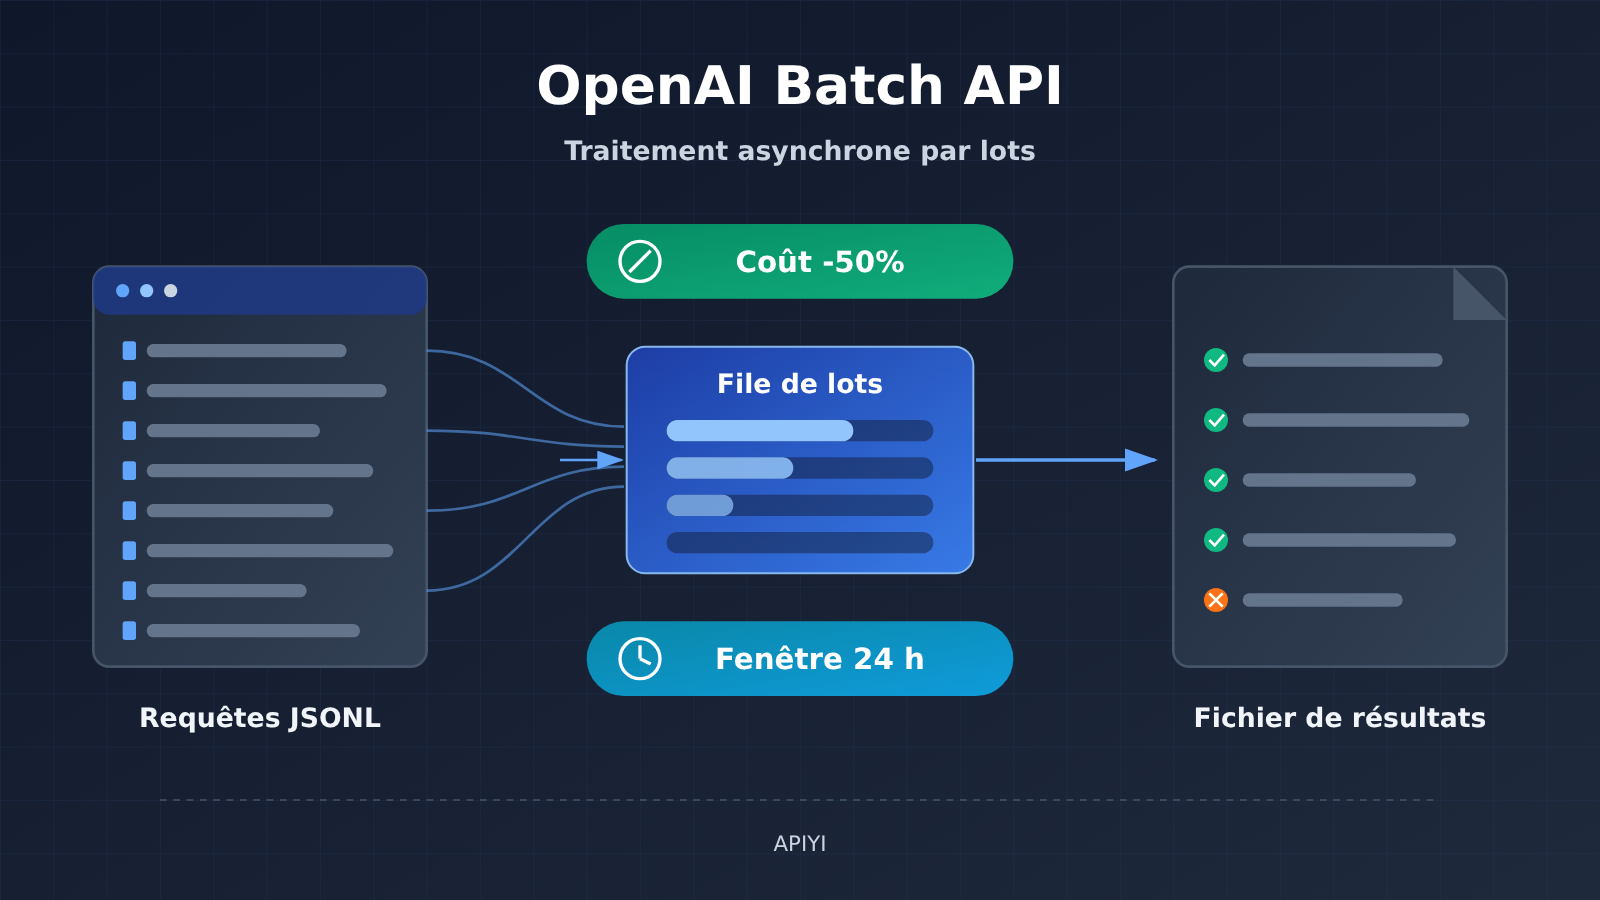
D’après le guide officiel Batch (documentation officielle OpenAI : developers.openai.com/api/docs/guides/batch), l’API Batch présente trois caractéristiques principales :
- Remise sur le coût : 50 % de réduction par rapport à l’API synchrone.
- Limitation de débit indépendante : elle utilise un pool de limites séparé, qui ne partage pas son quota avec les requêtes synchrones.
- Fenêtre de traitement : les lots sont traités dans une fenêtre de 24 heures.
Les modèles et points de terminaison pris en charge sont ceux listés dans la documentation officielle. On ne peut pas dire aujourd’hui de façon générale que « tous les modèles prennent en charge Batch ».
Format de fichier et limites de volume de l’API Batch
| Élément de règle | Exigence officielle | Signification concrète |
|---|---|---|
| Format de fichier | JSONL, une requête par ligne | Une ligne = une tâche indépendante |
| Identifiant de requête | Chaque requête possède un custom_id unique |
C’est lui qui permet de faire correspondre les résultats au moment de la récupération |
| Contrainte de modèle | Un seul modèle par fichier | Les tâches multi-modèles doivent être réparties sur plusieurs fichiers |
| Limite de quantité | 50 000 requêtes maximum par lot | Au-delà, il faut soumettre en plusieurs lots |
| Limite de taille | 200 MB maximum par fichier de lot | Les tâches à contexte long peuvent atteindre cette limite avant celle du nombre de requêtes |
| Ordre de sortie | Aucune garantie de correspondre à l’ordre d’entrée | Impossible d’associer les résultats par numéro de ligne |
Voici la structure indicative d’une ligne de requête, destinée à montrer où se place le custom_id. Les points de terminaison et paramètres précis sont à vérifier dans la liste de prise en charge de la documentation officielle :
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Règles d’expiration et de facturation de l’API Batch
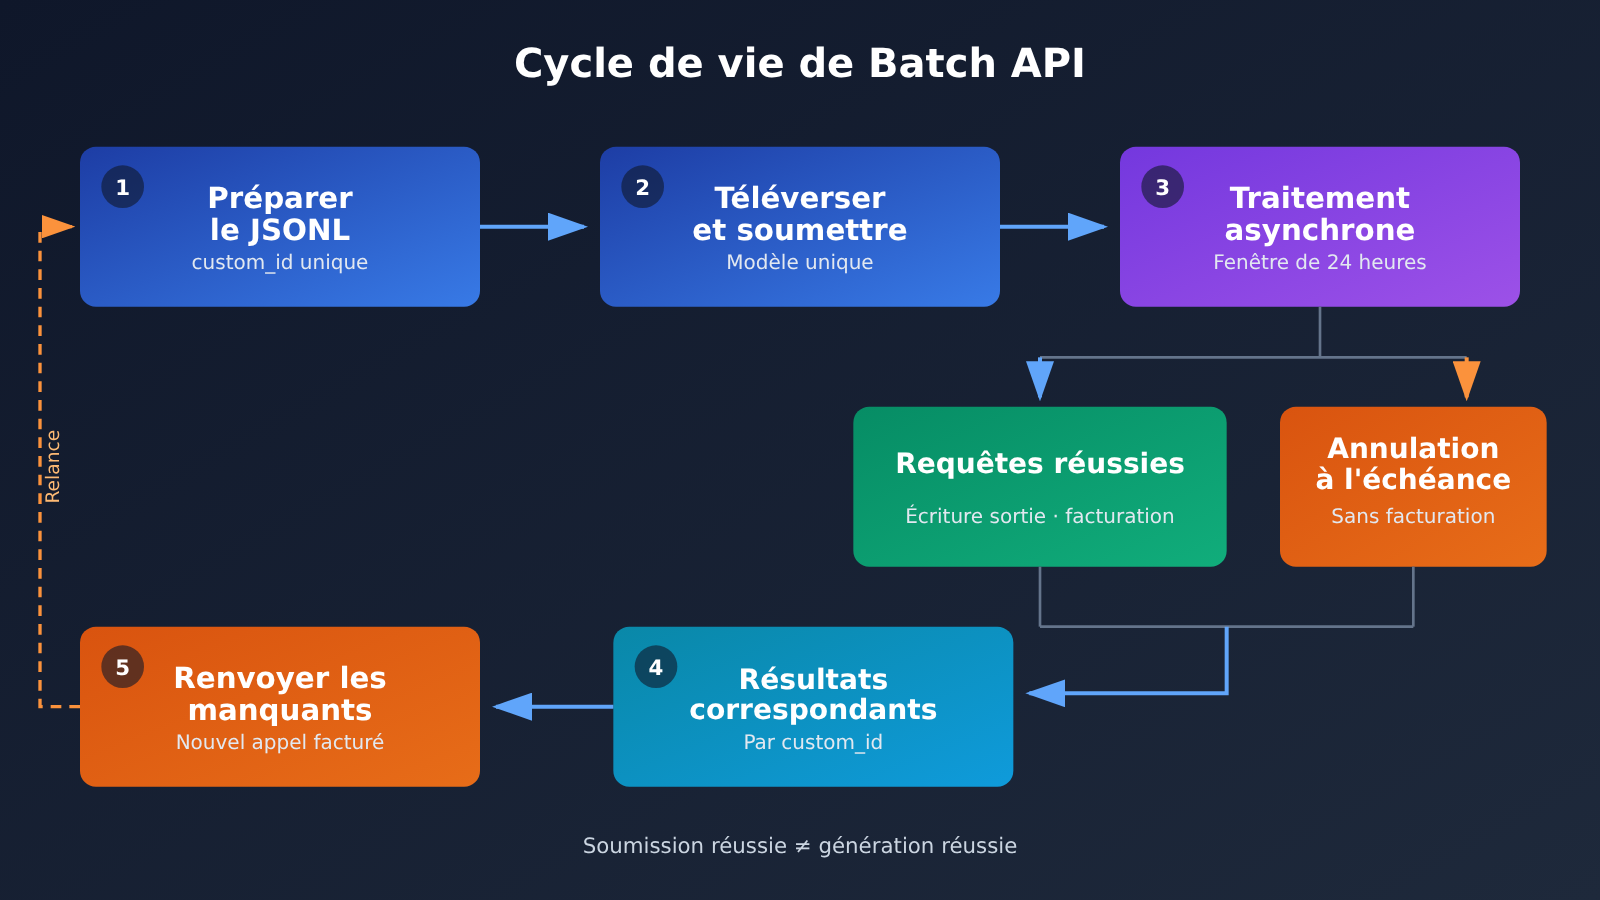
Si un lot dépasse la fenêtre de traitement, les requêtes encore inachevées sont annulées. Les résultats déjà obtenus avec succès restent téléchargeables, et la facturation ne concerne que les requêtes réussies.
La documentation rappelle également un point : une soumission réussie ne signifie pas une génération réussie. Le fait qu’un lot soit accepté indique simplement qu’il est entré dans le processus de traitement, pas que chaque ligne produira un résultat. La fenêtre de 24 heures n’est pas non plus la promesse d’une livraison « demain matin à telle heure ».
Analyse de l’API Batch d’OpenAI
Sur quelle part porte réellement la réduction de 50 %
La réduction de 50 % concerne les frais d’invocation du modèle pour le traitement Batch lui-même. L’exemple ci-dessous est un exemple conceptuel : les chiffres ne sont pas des données mesurées.
Imaginons qu’une tâche soit facturée 100 yuans en requête synchrone. La même requête passée par Batch coûterait, de manière indicative, 50 yuans. Le coût total du projet ne sera toutefois pas forcément divisé par deux, car plusieurs catégories de coûts ne bénéficient pas automatiquement de cette réduction :
| Poste de coût | Bénéficie du demi-tarif Batch ? | Explication |
|---|---|---|
| Frais d’invocation du modèle pour les requêtes par lots | Oui | Exemple indicatif : 100 yuans en synchrone correspondent à 50 yuans en Batch |
| Appels d’outils pour la recherche préalable | Non | Par exemple, effectuer des recherches, mener une étude, puis déterminer quoi écrire |
| Vérification humaine | Non | Le coût de la main-d’œuvre est indépendant du mode de facturation |
| Nouvelles tentatives supplémentaires | Non, à calculer séparément | Une nouvelle exécution après un échec ou une expiration génère de nouveaux appels |
| Développement et maintenance technique | Non | La génération de fichiers, la correspondance des résultats et la logique de resoumission demandent du travail |
Pour établir un budget, il faut donc appliquer la réduction de 50 % uniquement à « la part des appels qui peuvent être traités par lots », et non amputer directement le budget total du projet de moitié. Si la recherche et la vérification représentent une part importante d’un projet, l’économie globale apportée par Batch sera nettement inférieure à 50 %.
Comment comprendre la fenêtre de 24 heures
La fenêtre de 24 heures décrit un délai de traitement, pas une garantie de livraison. L’approche la plus sûre consiste à considérer les résultats Batch comme une production « que l’on obtiendra très probablement dans la fenêtre, mais qui peut être partiellement incomplète », et à prévoir du temps dans le planning pour des relances.
Si l’équipe métier exige « tous les résultats avant 9 h demain matin », alors s’appuyer sur une seule soumission Batch est risqué. Pour les tâches à contrainte temporelle stricte, on peut soumettre en amont, réserver une fenêtre de relance, ou basculer les parties critiques vers des requêtes synchrones.
custom_id est le cœur de la conception d’ingénierie Batch
Comme l’ordre des sorties n’est pas garanti, la récupération des résultats doit s’appuyer entièrement sur custom_id. Cela exige que custom_id ait un sens métier dès la phase de conception, et qu’il soit globalement unique, par exemple « type de tâche-numéro de lot-numéro de séquence ».
L’exemple de conception ci-dessous n’est pas non plus un test réel : pour générer 20 articles indépendants du même modèle, on peut écrire 20 lignes JSONL. Si au final 18 réussissent et que 2 sont annulées pour expiration, il suffit de retrouver les 2 manquantes via custom_id et de les resoumettre, sans avoir à relancer les 20. Les 18 réussies sont facturées comme requêtes réussies, les 2 annulées ne sont pas facturées.
Les points clés de ce processus peuvent se résumer ainsi :
- Vérifier avant soumission que le custom_id de chaque ligne est unique.
- Après récupération des résultats, soustraire l’ensemble des custom_id de sortie de l’ensemble des custom_id d’entrée pour obtenir la liste des manquants.
- Générer un nouveau JSONL uniquement pour la liste des manquants, puis le resoumettre.
- Les relances génèrent de nouveaux frais d’appel, à intégrer au budget.
Traiter séparément les modèles multiples et les dépendances
Un fichier ne peut utiliser qu’un seul modèle. Si un même projet veut confier la classification au modèle A et le résumé au modèle B, il faut préparer deux fichiers distincts, les soumettre chacun de leur côté et récupérer les résultats séparément.
Ce qui mérite encore plus l’attention, ce sont les dépendances. Si le processus consiste à « d’abord rechercher des informations, puis décider quoi écrire en fonction des conclusions de la recherche », la deuxième étape dépend de la sortie de la première. Dans ce cas, Batch n’orchestre pas automatiquement ces deux étapes. Il faut attendre la récupération des résultats du premier lot, puis laisser son propre programme générer les requêtes du second lot et les soumettre. Cela signifie aussi que la durée totale de la chaîne peut cumuler plusieurs fenêtres de traitement.
Quelles tâches conviennent à l’API OpenAI Batch
| Type de tâche | Adapté à Batch | Raison |
|---|---|---|
| Classification par lots selon des règles établies | Adapté | Règles fixes, éléments indépendants, pas de besoin de réponse en temps réel |
| Traitement de base de connaissances (résumé, nettoyage, structuration) | Adapté | Volume de données important, réalisable hors ligne |
| Évaluation de modèles, inférence par lots sur des jeux de test | Adapté | Naturellement en lot, insensible aux délais |
| Génération de contenu indépendant en lot avec un même modèle | Adapté | Chaque ligne est indépendante, les échecs peuvent être relancés via custom_id |
| Service client en temps réel, interaction conversationnelle | Non adapté | L’utilisateur a besoin d’une réponse immédiate, il faut utiliser des méthodes synchrones |
| Tâches avec une échéance de livraison stricte | À manier avec prudence | La fenêtre de 24 heures ne garantit pas un instant précis |
| Processus multi-étapes « d’abord rechercher, puis décider du contenu » | Orchestration à faire soi-même | Batch ne gère pas automatiquement les dépendances entre étapes |
Une méthode simple pour décider : posez trois questions à la suite. Le résultat peut-il être obtenu un peu plus tard ? Chaque requête est-elle indépendante des autres ? Le volume est-il suffisamment important pour justifier d’écrire la logique de fichiers et de récupération ? Si les trois réponses sont « oui », Batch est généralement l’option la plus économique. Si une seule réponse est « non », il faut d’abord découper la tâche, ou conserver un appel synchrone.
Évolutions à surveiller
Comme il s’agit d’une documentation officielle maintenue en continu, la gamme de modèles et de points de terminaison pris en charge, ainsi que les limites de quantité et de taille, peuvent évoluer. Les remarques suivantes sont des prédictions : à mesure que davantage de modèles et de points de terminaison seront intégrés à Batch, les flux de travail d’évaluation hors ligne et de traitement des données passeront plus souvent par le traitement par lots. Au moment de l’intégration, il faudra toutefois se fier aux règles indiquées dans la documentation à ce moment-là, et ne pas reprendre tel quel les chiffres relevés à la date de vérification de cet article.
L’intérêt de Batch API, c’est de faire réfléchir à ce qui peut attendre. Les tâches pour lesquelles on accepte d’attendre bénéficient d’un prix divisé par deux et d’un quota de débit sans perturbation ; celles qui exigent une réponse immédiate continuent de passer par des requêtes synchrones.
« Ne cherchez pas la rapidité, ne visez pas les petits profits. Qui veut aller trop vite n’atteint pas son but ; qui convoite de petits profits ne mène pas à bien de grandes choses. » — Entretiens de Confucius, « Zilu ».


