
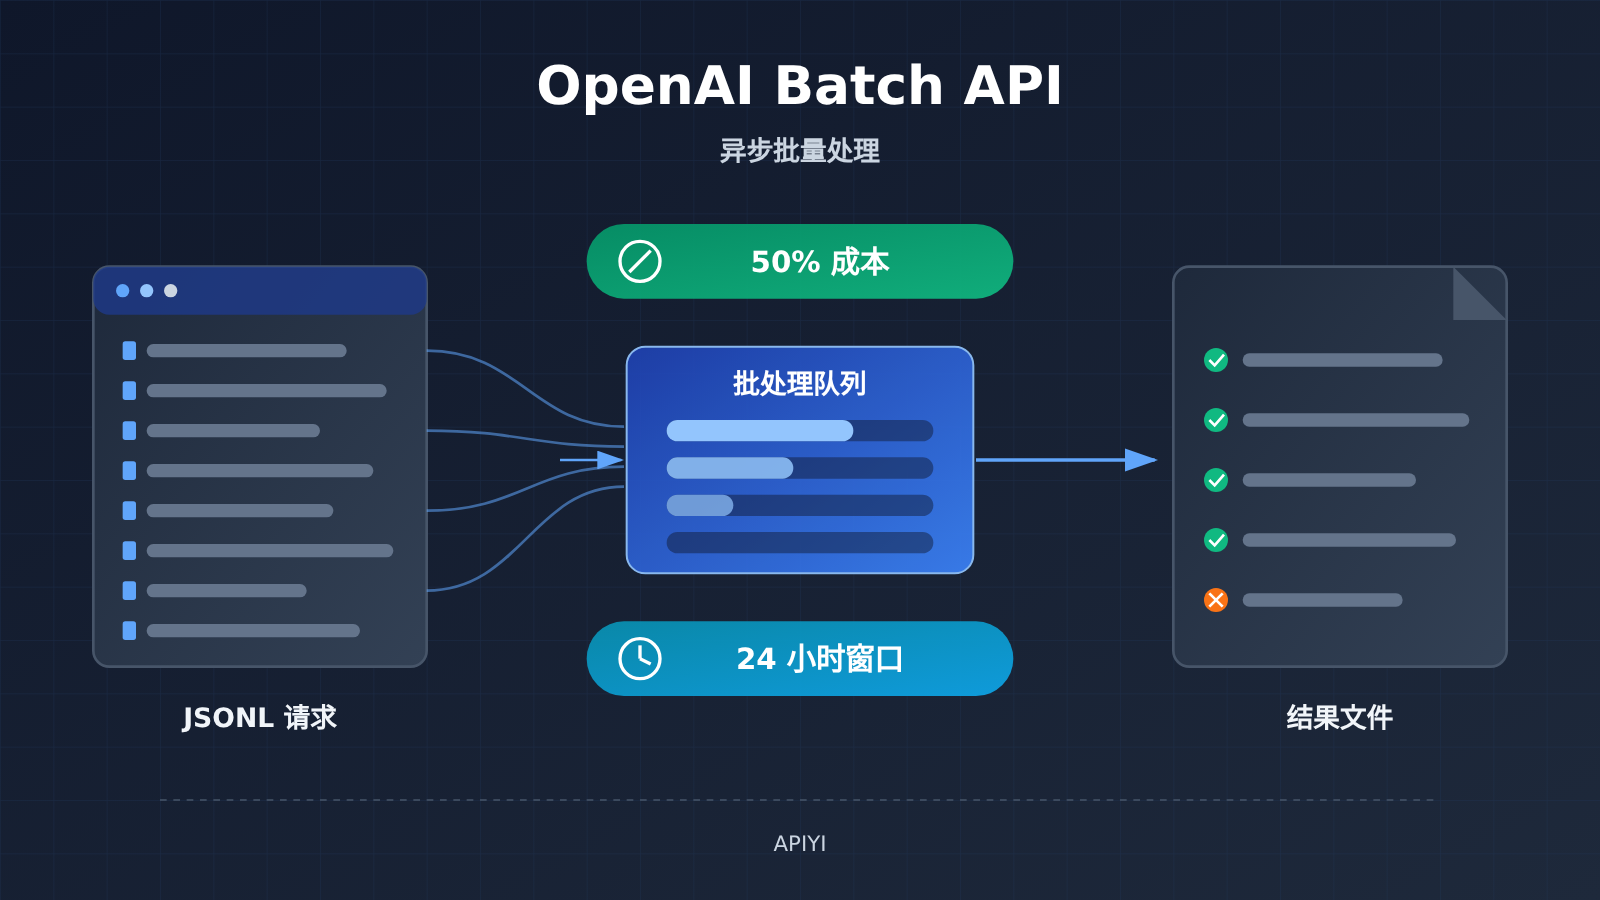
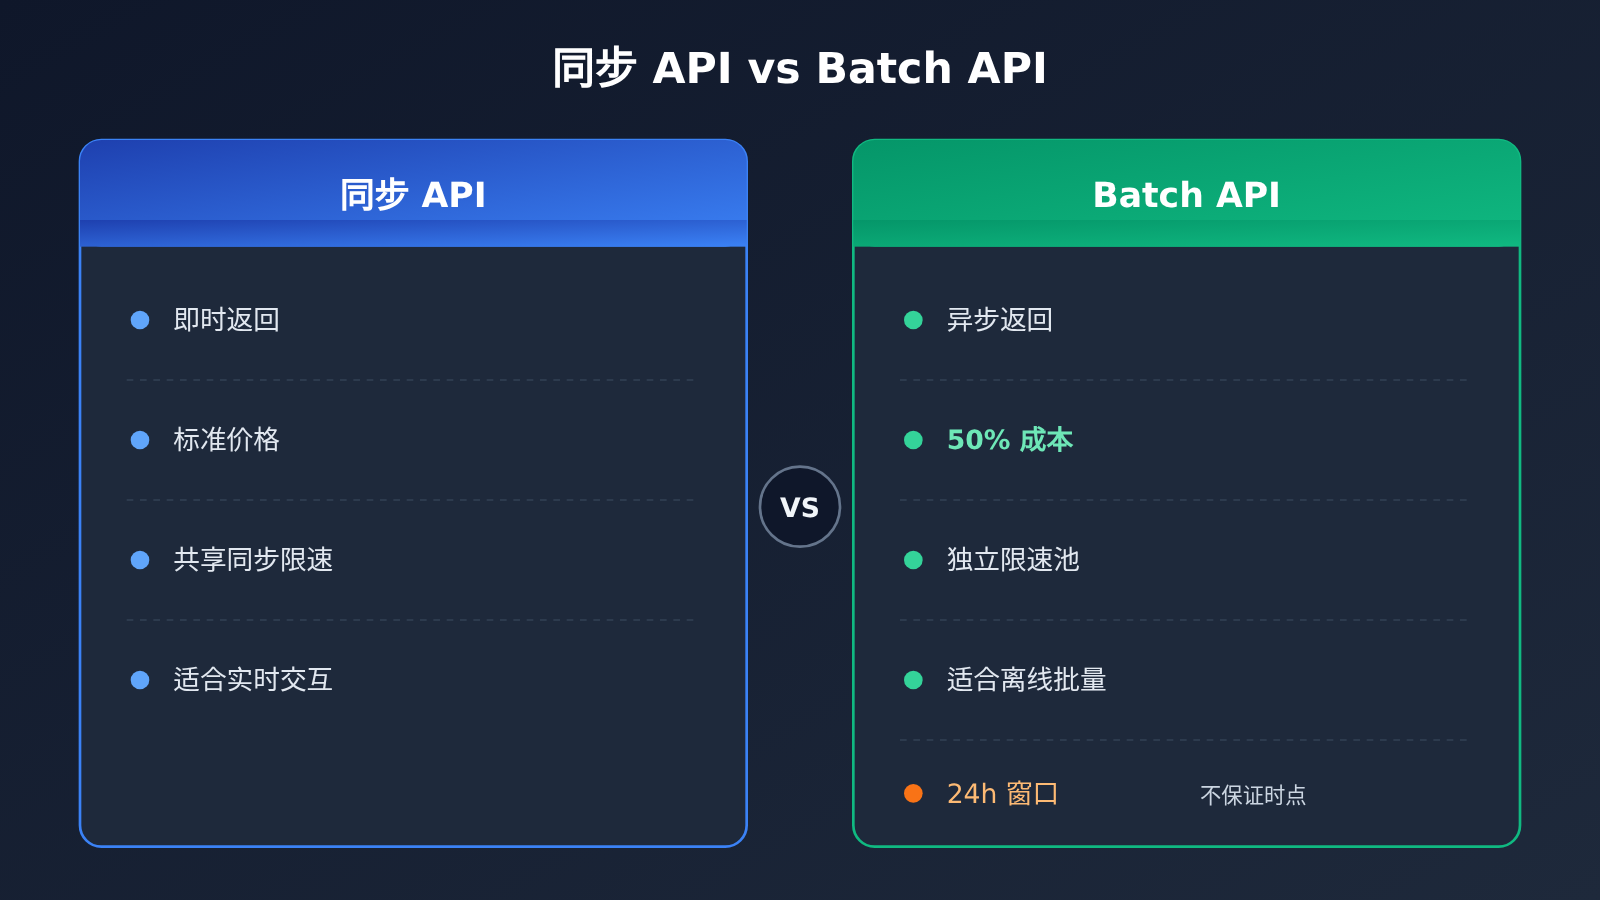
直接回答:OpenAI Batch API 适合“结果可以晚一点拿到、彼此独立、批量很大”的任务。 它的价格是同步 API 的一半,并且使用独立的限速池。它的约束是 24 小时处理窗口,而且这个窗口不保证在某个具体时点交付结果。既定规则的分类、知识库加工、模型评测这类离线工作,可以优先考虑 Batch。实时客服、需要即时回复的交互,以及前一步结果决定后一步内容的依赖流程,不应交给 Batch API。
您读完此文能了解到什么?
- OpenAI Batch API 的核心规则:折扣、限速、窗口、文件格式和数量上限。
- 提交成功、生成成功和按时交付这三件事之间的区别。
- 批次过期后如何计费,以及如何只补跑失败的请求。
- 五折具体省下哪部分成本,哪些成本不会跟着减半。
- 判断一项任务是否适合 Batch 的实用方法。
索引: 正文前先用一张概念表和一份影响速览帮你建立基础认知。「客观事实」部分逐条整理官方文档中的规则;「分析判断」部分讨论这些规则对任务选型、成本测算和工程设计意味着什么,并给出适合与不适合的任务类型。
需要说明的是,本文依据的是 OpenAI 官方持续维护的 Batch 指南,于 2026-11-17 核查。这份文档没有明确的首发日期,所以本文不把它当作当日发布的新功能,而是对一项现有能力的规则解读。
To Know:理解 OpenAI Batch API 的关键概念
| 概念 | 简要解释 |
|---|---|
| 同步 API | 发出请求后即时等待并返回结果的常规调用方式 |
| Batch API | 一次提交大量请求、异步处理、稍后统一取回结果的接口 |
| JSONL | 每一行是一个独立 JSON 对象的文本格式,Batch 中每行对应一个请求 |
| custom_id | 你为每条请求设定的唯一标识,用来把输出结果对应回原始请求 |
| 独立限速池 | Batch 请求的速率限制与同步请求分开计算,彼此不互相挤占 |
| 24 小时处理窗口 | 批次的处理时限;超时后未完成的请求会被取消 |
| 过期批次 | 超过处理窗口仍未全部完成的批次 |
OpenAI Batch API 影响速览
- 开发者: 离线批量任务的 API 费用可以按同步价格的一半来估算,同时不会占用线上服务的同步限速额度。但需要自己实现 custom_id 匹配、失败重提和结果校验。
- 内容与数据团队: 大批量的分类、摘要、知识库清洗等工作更划算。代价是放弃“当场出结果”,交付时间要留出余量。
- 评测与研究人员: 大规模跑测试集非常适合 Batch。不过需要注意,单个文件只能使用一个模型,多模型对比要拆成多个文件。
- 产品与运营负责人: 不能把“24 小时”理解为“明早一定交稿”。对外承诺时效时,应当把 Batch 视为尽力而为的通道。
OpenAI Batch API 客观事实
Batch API 的计费与限速规则
根据官方 Batch 指南(OpenAI 官方文档: developers.openai.com/api/docs/guides/batch),Batch API 有三项核心特性:
- 成本折扣: 相比同步 API 提供 50% 的成本折扣。
- 独立限速: 使用独立的限速池,不与同步请求共享额度。
- 处理窗口: 批次在 24 小时窗口内完成处理。
支持哪些模型和端点,以官方文档列出的范围为准。目前不能笼统地说“所有模型都支持 Batch”。
Batch API 的文件格式与数量上限
| 规则项 | 官方要求 | 实际含义 |
|---|---|---|
| 文件格式 | JSONL,每行一个请求 | 一行就是一个独立任务 |
| 请求标识 | 每条请求有唯一 custom_id | 结果回收全靠它来匹配 |
| 模型约束 | 单个文件只能用一个模型 | 多模型任务需要拆成多个文件 |
| 数量上限 | 单批最多 50,000 个请求 | 超过上限要分批提交 |
| 体积上限 | 单批文件最大 200MB | 长上下文任务可能先触及体积上限 |
| 输出顺序 | 不保证与输入顺序一致 | 不能按行号对应结果 |
下面是一条请求行的示意结构,用于说明 custom_id 的位置。具体端点和参数以官方文档的支持列表为准:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Batch API 的过期与计费规则
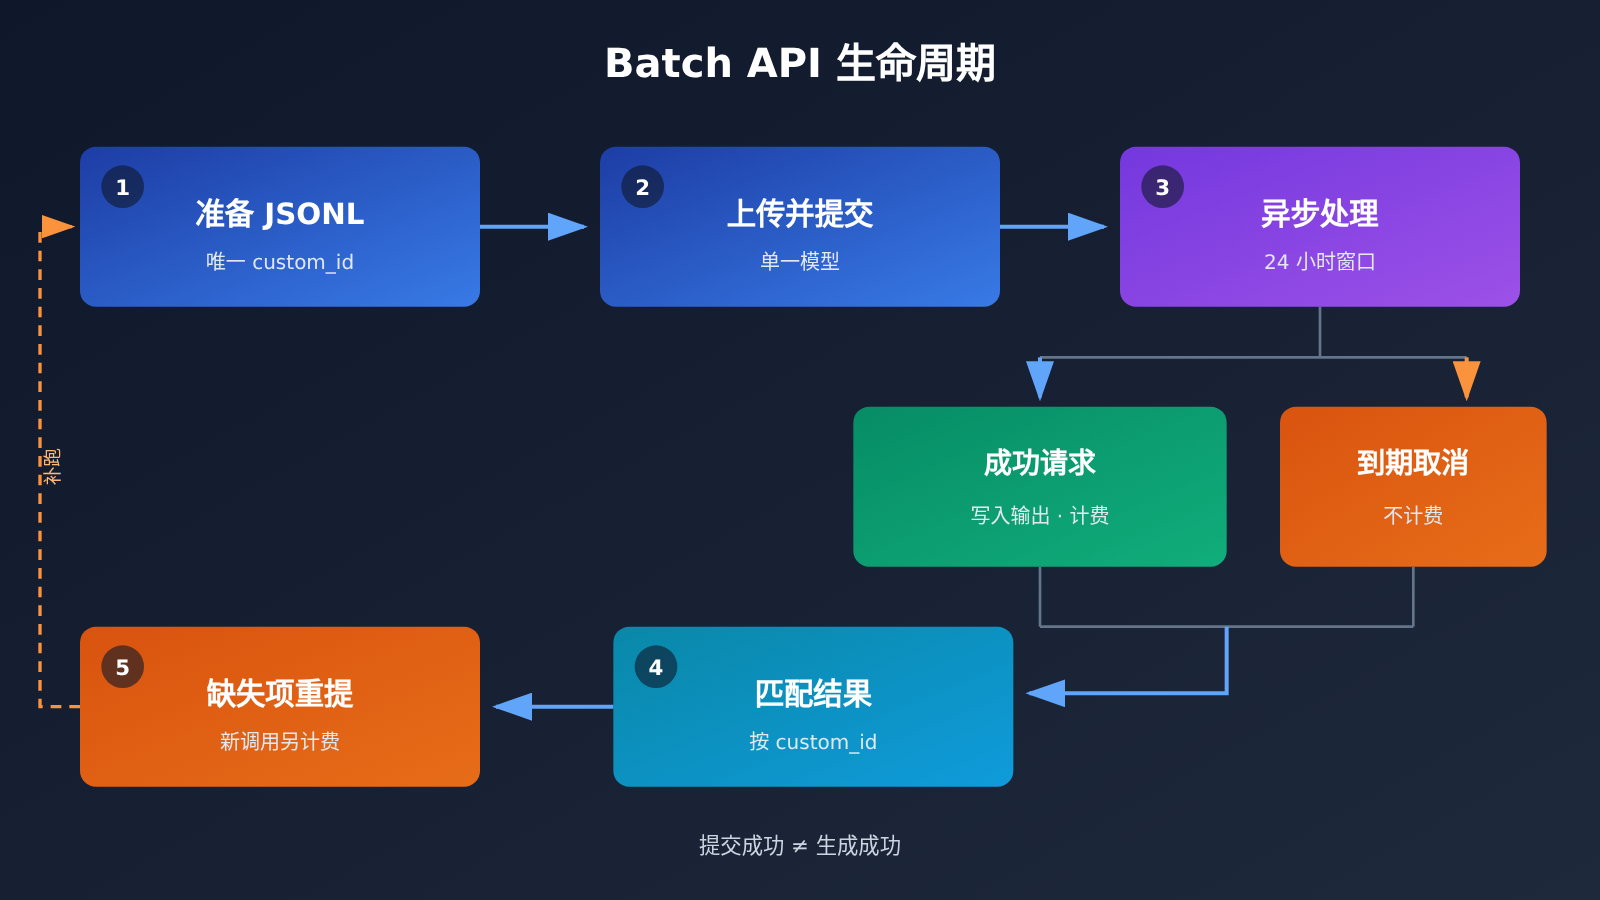
如果批次超过处理窗口,其中尚未完成的请求会被取消。已经成功的结果仍然可以下载,计费只针对成功的请求。
文档同时提醒了一点:提交成功不等于生成成功。 批次被接收,只代表进入了处理流程,不代表每一行都会产出结果。24 小时窗口也不是“明早某个时点交稿”的承诺。
OpenAI Batch API 分析判断
五折省的是哪部分钱
“五折”针对的是 Batch 处理本身的模型调用费用。下面用一个设计示例说明,数字不是实测数据。
假设某项任务按同步请求计费为 100 元,那么相同请求走 Batch 的示意费用是 50 元。整个项目的总成本却未必减半,因为有几类成本不会自动打折:
| 成本项 | 是否随 Batch 五折 | 说明 |
|---|---|---|
| 批处理请求的模型调用费 | 是 | 示意:同步 100 元对应 Batch 50 元 |
| 前置研究所用的工具调用 | 否 | 例如先检索、调研再确定写什么 |
| 人工审核 | 否 | 人力成本与计费方式无关 |
| 额外重试 | 否,需另行计算 | 失败或过期后补跑会产生新的调用 |
| 工程开发与维护 | 否 | 文件生成、结果匹配、重提逻辑需要投入 |
所以做预算时,应把五折只套在“可批处理的那部分调用”上,不要直接把项目总预算砍一半。如果一个项目里研究和审核占比很高,Batch 带来的整体节省会明显小于 50%。
24 小时窗口应该怎样理解
24 小时窗口描述的是处理时限,不是交付承诺。比较稳妥的做法是:把 Batch 结果当作“窗口期内大概率可得,但可能部分缺失”的产出,并在排期里为补跑留出时间。
如果业务方要求“明天上午 9 点前必须拿到全部结果”,那么只靠一次 Batch 提交是有风险的。对时效要求刚性的任务,可以提前提交、预留补跑窗口,或者把关键部分改走同步请求。
custom_id 是 Batch 工程设计的核心
由于输出不保证顺序,结果回收必须完全依赖 custom_id。这就要求 custom_id 在设计阶段就有业务含义,并且全局唯一,比如“任务类型-批次号-序号”。
下面这个设计示例同样不是实测:要生成 20 篇同一模型、彼此独立的文章,可以写成 20 行 JSONL。如果最终 18 篇成功、2 篇因过期被取消,只需通过 custom_id 找出缺失的 2 篇重新提交,不必把 20 篇全部重跑。已成功的 18 篇按成功请求计费,被取消的 2 篇不计费。
这个流程的关键点可以归纳为:
- 提交前校验每行 custom_id 是否唯一。
- 结果回收后,用输入 custom_id 集合减去输出 custom_id 集合,得到缺失清单。
- 只针对缺失清单生成新的 JSONL 再提交。
- 补跑产生的是新的调用费用,要计入预算。
多模型和依赖流程要拆开处理
单个文件只能使用一个模型。如果同一个项目想让 A 模型做分类、B 模型做摘要,就要分别准备两个文件,各自提交、各自回收。
更值得注意的是依赖关系。如果流程是“先研究资料,再根据研究结论决定写什么”,第二步依赖第一步的输出,那么 Batch 不会替你自动编排这两步。你需要在第一批结果回收后,由自己的程序生成第二批请求再提交。这也意味着整条链路的总耗时可能叠加多个处理窗口。
哪些任务适合 OpenAI Batch API
| 任务类型 | 是否适合 Batch | 理由 |
|---|---|---|
| 按既定规则的批量分类 | 适合 | 规则固定、条目独立、不急于实时返回 |
| 知识库加工(摘要、清洗、结构化) | 适合 | 数据量大,可离线完成 |
| 模型评测、测试集批量推理 | 适合 | 天然批量,对时效不敏感 |
| 同模型独立内容批量生成 | 适合 | 每行独立,失败可按 custom_id 补跑 |
| 实时客服、对话交互 | 不适合 | 用户需要即时回复,应使用同步等方式 |
| 有严格交付时点的任务 | 谨慎 | 24 小时窗口不保证具体时点 |
| 先研究再决定内容的多步流程 | 需自行编排 | Batch 不自动处理步骤间依赖 |
一个简单的判断方法是连问三个问题:结果能不能晚一点拿到?每条请求是否彼此独立?量是否大到值得写文件和回收逻辑?三个答案都是“是”,Batch 通常就是更划算的选择。只要有一个答案是“否”,就要先拆分任务,或者保留同步调用。
后续值得关注的变化
由于这是一份持续维护的官方文档,支持的模型与端点范围、数量和体积上限都可能调整。以下判断属于预测:随着更多模型和端点被纳入 Batch,离线评测和数据加工类工作流会更多地默认采用批处理。实际接入时,仍应以届时文档列出的规则为准,不要直接沿用本文核查日的数值。
Batch API 的价值,在于让人想清楚哪些事可以等。愿意等的任务换来一半的价格和不受打扰的限速额度;必须立刻得到回应的任务,则继续交给同步请求。
「无欲速,无见小利。欲速则不达,见小利则大事不成。」——《论语·子路》


