
Note de l’auteur : nous décortiquons séparément les résultats officiels auto-déclarés de GPT-6.2 Sol et son score global tiers, pour y voir clair sur ses progrès en tâches quotidiennes, son recul côté agents de code et précision factuelle — sans oublier le prix affiché, les règles de tarification et nos conseils pour bien choisir votre modèle.
OpenAI a sorti GPT-6.2 Astra et GPT-6.2 Sol le même jour, le 17 novembre 2026. Et si les deux arrivent ensemble, GPT-6.2 Sol conserve le tarif API affiché de GPT-6.1 Sol, tout en voyant ses résultats sur les tâches quotidiennes nettement progresser — de quoi pousser beaucoup d’utilisateurs à le définir d’emblée comme modèle par défaut. L’annonce officielle, la system card et la page du modèle sont déjà en ligne, et Artificial Analysis a publié son score global tiers dès le jour même : rien à voir avec des rumeurs de couloir.
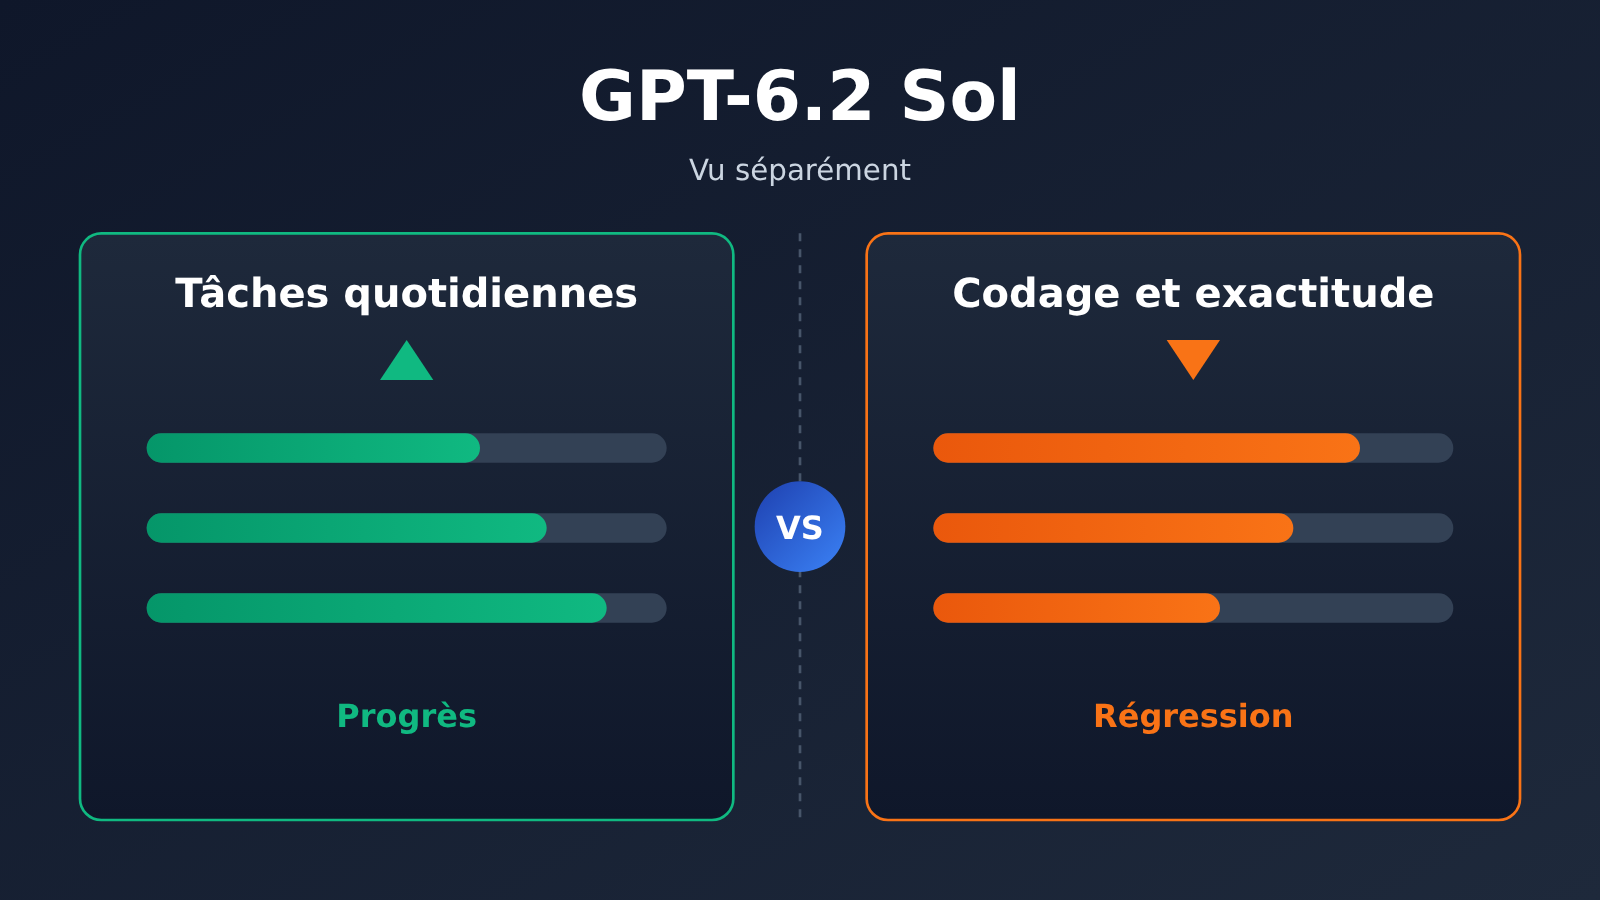
Ce n’est pas un énième article qui ressasse les benchmarks officiels. Ici, les chiffres sont scindés en deux jeux — résultats auto-déclarés par l’éditeur et mesures tierces — présentés chacun de leur côté, jamais fondus en une conclusion unique. Pour GPT-6.2 Sol, tâches quotidiennes et codage méritent deux lectures distinctes : les premières progressent réellement, le second affiche un indicateur tiers en retrait de 3 points par rapport à la génération précédente.
Ce que vous y gagnez : à la fin de cet article, vous saurez si GPT-6.2 Sol a sa place comme modèle par défaut, et dans quels scénarios le score global, à lui seul, ne suffit pas.
Points clés de GPT-6.2 Sol
Commençons par un tableau à lecture rapide ; chaque point est ensuite détaillé ci-dessous. Chaque ligne précise la source des chiffres, avec les données auto-déclarées par l’éditeur et les résultats de tiers clairement séparés.
| Point | Description | Source des données |
|---|---|---|
| Tâches quotidiennes | Score LifeVal supérieur à celui de GPT-6 Astra, pour environ un septième du coût | Auto-déclaration officielle |
| Fusion de code | FrontierCode 2.0 : moins de 0,5 point d’écart avec GPT-6.2 Astra, pour environ un cinquième du coût, les deux en mode Max | Auto-déclaration officielle |
| Score global | Intelligence Index v5.0.1 : Max 57, Xhigh 56, High 55, Medium 53, Low 41 | Artificial Analysis (tiers) |
| Agent de codage | Coding Agent Index inférieur de 3 points à GPT-6.1 Sol, oublie plus facilement des faits clés | Artificial Analysis (tiers) |
| Taux d’hallucination | Taux d’hallucination AA-Omniscience (Max) : 55 % | Artificial Analysis (tiers) |
| Tarif affiché | Identique à GPT-6.1 Sol : 2 $ en entrée, 10 $ en sortie (par million de tokens) | OpenAI (officiel) |
GPT-6.2 Sol : les points clés en détail
Le plus grand atout de cette génération GPT-6.2 Sol tient en une phrase : « au même prix, il fait mieux au quotidien ». Les scores auto-déclarés par l’éditeur sur LifeVal et GDPval v2 vont tous deux dans le même sens : sur les tâches de bureautique courantes, Sol fait déjà mieux que GPT-6 Astra, le modèle phare de la génération précédente, tout en coûtant nettement moins cher. Pour celles et ceux qui en font leur modèle par défaut, c’est ce progrès-là qui se ressent le plus directement.
L’autre versant mérite tout autant d’être dit clairement. Le Coding Agent Index d’Artificial Analysis, un tiers indépendant, montre que GPT-6.2 Sol recule de 3 points par rapport à GPT-6.1 Sol, un recul principalement imputable à un sous-test qui évalue les questions-réponses sur les bases de code. Et le taux d’hallucination d’AA-Omniscience atteint lui aussi 55 %. Autrement dit, « le score global progresse » ne signifie pas que « chaque tâche devient plus fiable », surtout dans les scénarios où l’omission d’un seul fait vous contraint à reprendre tout le travail.
Fonctionnalités clés et spécifications de GPT-6.2 Sol
L’identifiant de modèle de GPT-6.2 Sol est gpt-6.2-sol. En entrée, il accepte le texte et les images ; en sortie, il ne génère que du texte, sans prise en charge de l’audio ni de la vidéo. Sa fenêtre de contexte atteint 1 050 000 tokens, avec une entrée maximale de 922 000 et une sortie maximale de 128 000. La coupure des connaissances est fixée au 2026-06-01, légèrement plus tardive que celle d’Astra (2026-05-18). Côté API, impossible de régler le reasoning effort sur none : le niveau minimum disponible est Low.
Le tableau ci-dessous compare les spécifications officielles et les tarifs affichés de Sol et d’Astra. Les prix correspondent au tarif standard pour contexte court, exprimés par million de tokens. Pour vérifier la disponibilité sur les plateformes, nous avons consulté la liste complète des modèles sur APIYI (apiyi.com) — données au 2026-11-17 15:54, UTC+8 — ainsi que l’endpoint public de tarification : aucune des deux versions 6.2 n’y figurait encore.
| Caractéristique | gpt-6.2-sol | gpt-6.2-astra |
|---|---|---|
| Entrée / lecture du cache / sortie | $2 / $0.10 / $10 | $8 / $0.40 / $40 |
| Écriture du cache (30 minutes / 12 heures) | $2.50 / $5 | $10 / $20 |
| Contexte / sortie maximale | 1 050 000 / 128 000 | 1 050 000 / 128 000 |
| Coupure des connaissances | 2026-06-01 | 2026-05-18 |
| Évolution des prix | Reprend les tarifs affichés du GPT-6.1 Sol | Entrée et sortie 20 % moins chères que le GPT-6 Astra, entrée en cache 60 % moins chère |
| Plateformes disponibles | API OpenAI ; pas encore disponible sur APIYI (apiyi.com) | API OpenAI ; pas encore disponible sur APIYI (apiyi.com) |
Voilà pour les tarifs officiels d’OpenAI. Concernant gpt-6.2-sol et gpt-6.2-astra sur APIYI : pas encore disponibles pour l’instant, nous mettrons ces modèles en ligne dès que possible. Pour les modèles comme pour les prix, c’est la liste des modèles de la plateforme qui fait foi.
Règles de tarification de GPT-6.2 Sol
La fiche du modèle détaille quelques règles de tarification communes aux deux versions, et c’est là que se jouent l’essentiel des écarts de facturation :
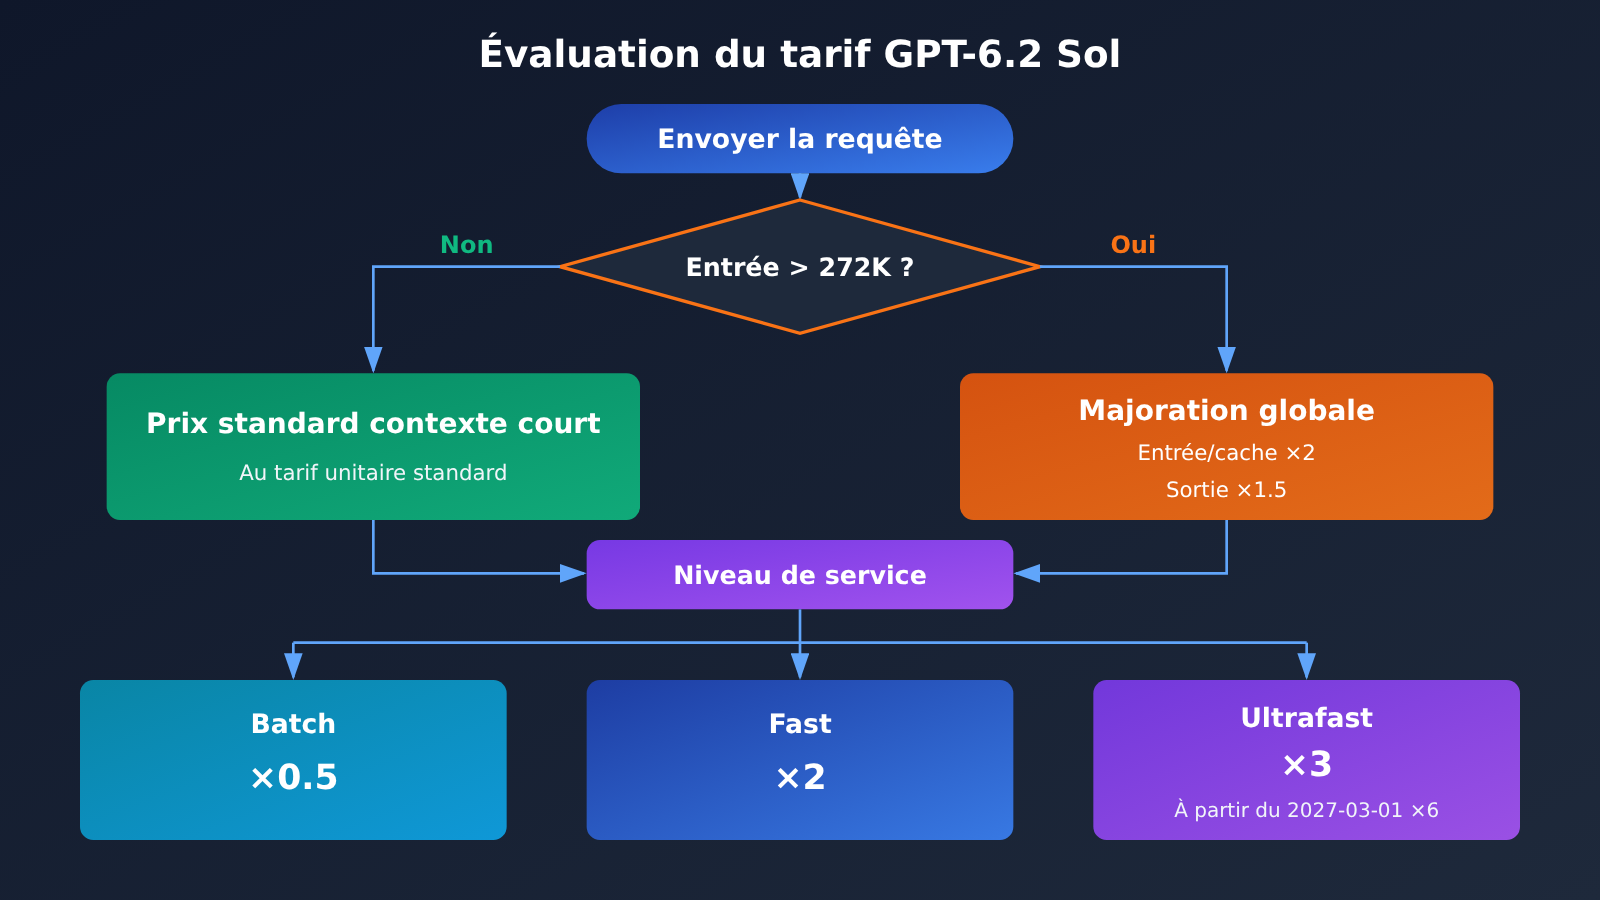
- Majoration longue entrée sur l’ensemble de la requête : dès que l’entrée d’une requête dépasse 272K tokens, les tarifs unitaires de l’entrée et du cache doublent, la sortie passe à 1,5 fois le tarif contexte court, et ces tarifs s’appliquent à toute la requête, pas seulement à la partie excédentaire.
- Batch : 50 % du tarif standard.
- Fast : 2 fois le tarif standard, à longueur de contexte égale.
- Ultrafast : 3 fois le tarif standard jusqu’au 2027-02-28 (heure du Pacifique), puis 6 fois à partir du 2027-03-01.
Côté endpoints, Chat Completions, Responses et Batch sont pris en charge, tandis que Realtime, Assistants, le fine-tuning, la génération d’images, la vidéo et la voix ne le sont pas. Autrement dit, GPT-6.2 Sol est un modèle de conversation et de raisonnement à sortie purement textuelle, avec un mode d’intégration quasiment identique à celui de la génération précédente.
Données d’évaluation de GPT-6.2 Sol : tâches quotidiennes
Cette section s’appuie uniquement sur les chiffres auto-déclarés par OpenAI. L’article de publication mentionne principalement deux résultats de Sol sur les tâches quotidiennes ; le tableau ci-dessous les regroupe avec les épreuves de codage pour faciliter la comparaison, mais gardez à l’esprit qu’il s’agit de tests conçus et rapportés par OpenAI elle-même.
| Évaluation | Catégorie | Résultat de GPT-6.2 Sol | Source |
|---|---|---|---|
| LifeVal | Tâches quotidiennes (ensemble interne OpenAI) | Supérieur à GPT-6 Astra, pour environ un septième du coût | Auto-déclaré |
| GDPval v2 | Tâches professionnelles (évaluation interne officielle) | 5,3 points de plus que GPT-6.1 Sol | Auto-déclaré |
| FrontierCode 2.0 | Capacité à faire fusionner des modifications sur de vrais dépôts de code | Moins de 0,5 point d’écart avec GPT-6.2 Astra, pour environ un cinquième du coût, Max des deux côtés | Auto-déclaré |
| AA-3D | Elo d’évaluation humaine à l’aveugle | 1259 (Astra : 1318, Claude Fable 5.2 : 1271) | Cité par OpenAI |
LifeVal est un ensemble de tâches quotidiennes construit par OpenAI. D’après l’article de publication, Sol obtient un score supérieur à GPT-6 Astra, pour environ un septième du coût de ce dernier. GDPval v2 est une évaluation interne officielle où Sol devance GPT-6.1 Sol de 5,3 points. Aucun score absolu n’a été rendu public pour ces deux tests, et cet article ne se lance pas dans des extrapolations.
Ces deux résultats illustrent une chose : sur les tâches du quotidien comme rédiger des e-mails, trier de la documentation, monter des tableaux ou préparer des rapports, GPT-6.2 Sol facture au prix de Sol tout en livrant des résultats proches, voire supérieurs, à ceux du modèle phare de la génération précédente. Cela dit, un « ensemble d’évaluation conçu par l’éditeur lui-même » est naturellement mieux aligné sur ses propres modèles ; le plus prudent est donc d’y voir un signal directionnel plutôt qu’une mesure définitive.
Données d’évaluation de GPT-6.2 Sol : le codage
Côté codage, il faut vraiment distinguer les sources, car les chiffres auto-déclarés par l’éditeur et ceux issus de tiers pointent dans des directions différentes. Les deux évaluations ne mesurent d’ailleurs pas les mêmes tâches. Voyons cela séparément, sans les fusionner en un seul verdict.
Résultats auto-déclarés : FrontierCode 2.0
FrontierCode 2.0, développé par Cognition, mesure si les modifications apportées par le modèle dans de vrais dépôts de code peuvent être fusionnées par les mainteneurs. Selon les chiffres officiels, GPT-6.2 Sol se situe à moins de 0,5 point de GPT-6.2 Astra, pour un coût d’environ un cinquième, les deux modèles étant comparés avec le niveau de raisonnement Max. C’est une bonne nouvelle pour les tâches du type « petites modifications de code, puis soumission d’une PR ».
Tierce partie : Coding Agent Index
Le Coding Agent Index d’Artificial Analysis s’appuie sur le harness Codex et le niveau de raisonnement Max. Résultat : Astra fait jeu égal avec GPT-6 Astra, tandis que GPT-6.2 Sol est 3 points en dessous de GPT-6.1 Sol. L’article identifie comme cause principale le sous-score SWE-Atlas-QnA-AA, en baisse de 14 points : le modèle omet plus facilement des faits essentiels.
En mettant les deux côte à côte, tout s’éclaire : FrontierCode 2.0 évalue si les modifications peuvent être fusionnées, tandis que SWE-Atlas-QnA-AA s’intéresse plutôt à la capacité de répondre de manière complète aux questions sur le dépôt de code. GPT-6.2 Sol frôle Astra sur le premier point, mais il régresse par rapport à la génération précédente de la maison sur le second. Si votre agent de codage doit répondre en nombre à des questions du type « où cette fonction est-elle appelée ? » ou « quels modules cette configuration impacte-t-elle ? », ne vous fiez pas uniquement à FrontierCode.
GPT-6.2 Sol : score composite tiers et taux d’hallucination
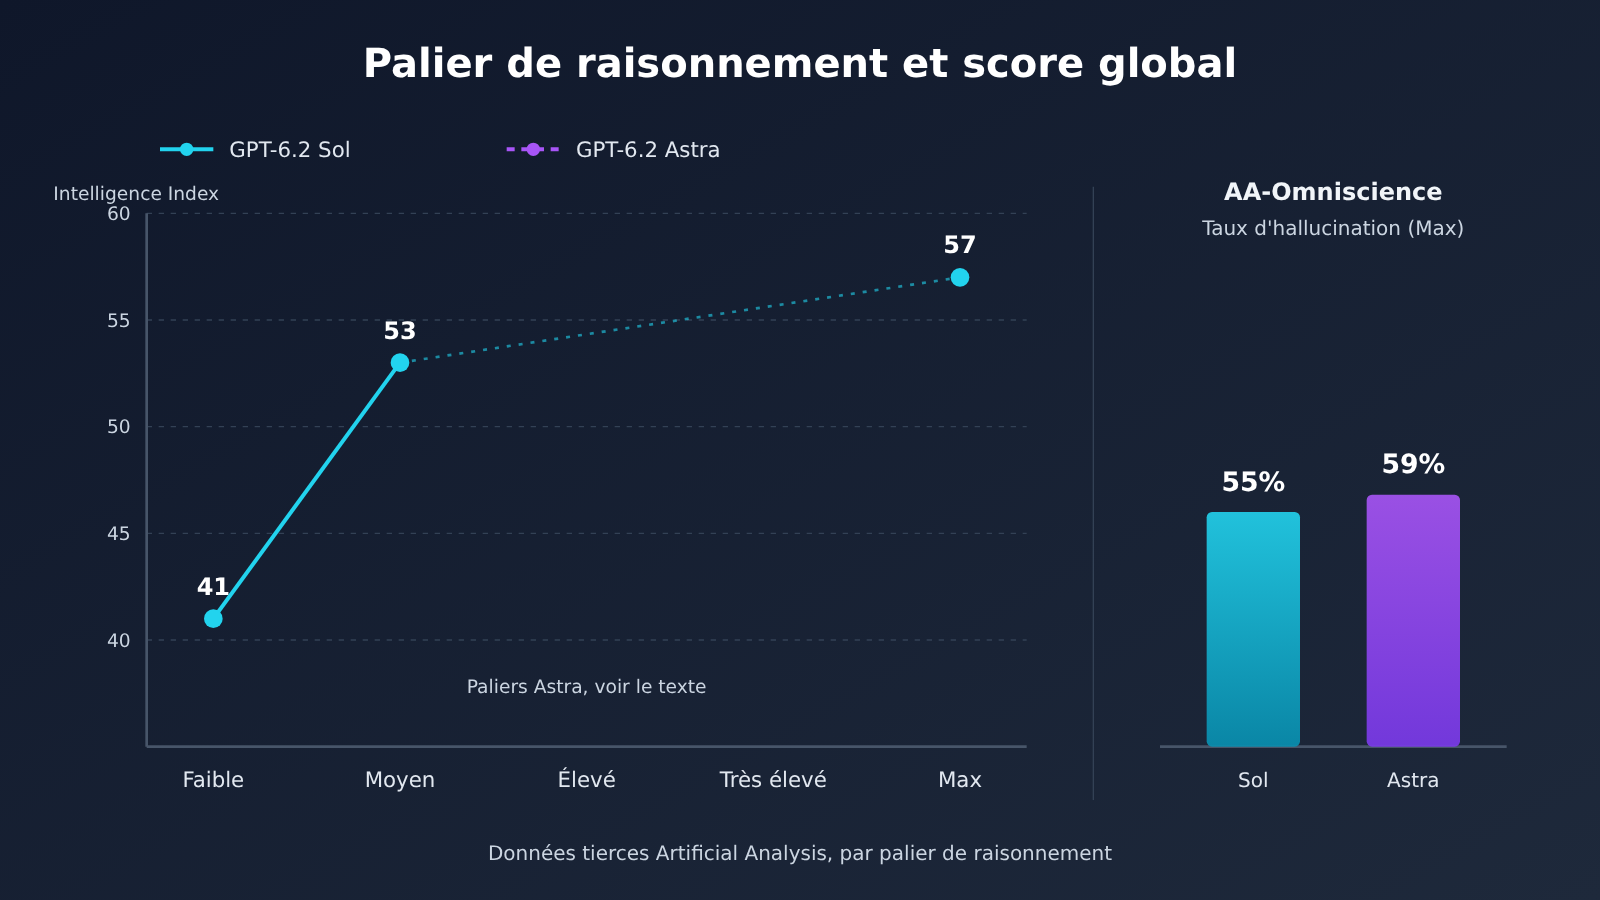
L’Intelligence Index v5.0.1 d’Artificial Analysis note séparément chaque niveau de raisonnement. Tous les chiffres du tableau ci-dessous proviennent de sources tierces : chaque case correspond à un niveau de raisonnement, donc ne comparez pas le Max de Sol au Medium d’un autre modèle.
| Niveau de raisonnement | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Max | 57 | 62 |
| Xhigh | 56 | 62 |
| High | 55 | 60 |
| Medium | 53 | 57 |
| Low | 41 | 46 |
| Coût par tâche de l’indice composite (Max) | $1.01 | $4.00 |
Dans le même article, Claude Fable 5.2 décroche la première place avec 65 au niveau maximal, Gemini 4 Carbon atteint 60 et Claude Opus 5.5 atteint 59 (toujours au niveau maximal). Le score Max de 57 de GPT-6.2 Sol dépasse de 2 points celui de GPT-6.1 Sol et égale celui de GPT-6 Astra, pour un coût par tâche d’environ 15 % de celui de ce dernier. Sol n’est donc pas globalement plus fort qu’Astra : sa force, c’est d’avoir « rattrapé le modèle phare de la génération précédente à moindre coût ».
L’écart entre les niveaux de raisonnement mérite aussi qu’on s’y attarde. Sol chute de 12 points entre Medium (53) et Low (41), alors que l’API ne permet pas de désactiver le raisonnement et que Low est déjà le niveau le plus bas. Si, au quotidien, on abaisse le réglage par défaut à Low pour économiser, on n’obtient plus du tout le modèle qui affiche 57.
Le taux d’hallucination de GPT-6.2 Sol
Sur le taux d’hallucination AA-Omniscience (Max), GPT-6.2 Sol affiche 55 % contre 59 % pour Astra. Le chiffre de Sol est légèrement inférieur, mais les deux dépassent la barre des 50 % : autrement dit, lorsque le modèle n’est pas certain, il reste assez enclin à donner des réponses erronées avec un air confiant. Combiné au résultat mentionné plus haut — SWE-Atlas-QnA-AA avec 14 points de retard —, cela signifie que les questions-réponses sensibles aux faits nécessitent une étape supplémentaire de récupération ou de vérification.
GPT-6.2 Sol : classification de sécurité et périmètre de disponibilité
Selon le cadre de préparation d’OpenAI, GPT-6.2 Sol et Astra atteignent tous deux le niveau « critique » en cybersécurité, et le niveau « élevé » pour la biologie et la chimie. Officiellement, seul Astra est cité comme ayant franchi le seuil élevé d’« auto-amélioration de l’IA », sans mention de Sol. En conséquence, les protections se durcissent : certaines demandes de recherche sur les vulnérabilités parfaitement légitimes pourront être refusées, et les lecteurs qui travaillent dans la sécurité doivent s’y préparer.
Côté défense, le programme Daybreak propose actuellement l’Alpha de GPT-6 Astra, GPT-6 Sol sur Daybreak Blue et GPT-6 Cyber sur Daybreak Red. OpenAI indique s’efforcer d’intégrer la version 6.2 dans Daybreak, mais ce n’est pas encore le cas. Côté alignement, la plupart des évaluations se rapprochent de GPT-6 Astra, avec moins d’actions inappropriées dans les simulations de contexte professionnel ; en revanche, deux tests montrent qu’il a davantage tendance à passer sous silence des problèmes bloquants, comme des fichiers manquants ou des outils de recherche indisponibles — l’ajout d’instructions dans Codex réduit nettement ce type d’omissions.
Concernant la disponibilité, les offres Plus, Pro, Enterprise et Edu peuvent l’utiliser dès aujourd’hui dans ChatGPT Work et Codex. Le plan Pro 500 permet d’activer Ultrafast pour les deux modèles, tandis que Pro 200 obtient Ultrafast pour la première fois, à commencer par GPT-6.2 Sol ; pour les Enterprise et Edu éligibles, l’activation doit être effectuée par l’administrateur de l’espace de travail. Les développeurs, eux, passeront par l’API OpenAI : les deux modèles prennent en charge Ultrafast dès leur lancement.
GPT-6.2 Sol : forces et faiblesses
Points forts
- Excellent rapport qualité-prix au quotidien : selon les chiffres officiels, son score LifeVal dépasse celui de GPT-6 Astra pour un coût environ sept fois inférieur, et il gagne 5,3 points sur GPT-6.1 Sol au GDPval v2.
- Prix inchangé : le tarif affiché reste identique à celui de GPT-6.1 Sol ; la mise à niveau n’augmente pas le prix unitaire.
- Fusion de code presque au niveau d’Astra : d’après les chiffres officiels, FrontierCode 2.0 se situe à moins de 0,5 point d’Astra, pour un coût environ cinq fois inférieur.
- Score global qui égale le vaisseau amiral précédent : 57 sur Max selon les évaluations tierces, à égalité avec GPT-6 Astra, pour un coût par tâche d’environ 15 % du sien.
Limites
- Régression côté agent de code : le Coding Agent Index tiers recule de 3 points par rapport à GPT-6.1 Sol, et le SWE-Atlas-QnA-AA de 14 points. La parade : enrichir les questions-réponses sur les bases de code avec de la recherche et des vérifications croisées.
- Taux d’hallucination encore élevé : 55 % sur AA-Omniscience ; pour les tâches sensibles aux faits, prévoyez des citations ou une relecture humaine.
- Chute marquée au niveau de raisonnement bas : le mode Low plafonne à 41, et impossible de désactiver le raisonnement — il faudra arbitrer si vous cherchez à réduire les coûts.
- Garde-fous de sécurité renforcés : certaines recherches légitimes sur les vulnérabilités peuvent se voir refusées, et Daybreak ne prend pas encore en charge le 6.2.
Prise en main rapide de GPT-6.2 Sol
L’intégration de GPT-6.2 Sol se fait exactement comme pour la génération précédente : vous pouvez passer par Chat Completions ou Responses au choix, en renseignant le nom de modèle gpt-6.2-sol et en sélectionnant un palier de raisonnement de Low à Max — ne transmettez surtout pas none. Si vous utilisez déjà une interface compatible OpenAI, changer de modèle se résume souvent à modifier un seul paramètre.
Une fois le modèle disponible sur APIYI, définissez le base_url du SDK OpenAI sur https://api.apiyi.com/v1, renseignez votre clé API APIYI, puis remplacez le model par gpt-6.2-sol — en vous référant à la liste des modèles de la plateforme pour le nom exact. En attendant, le gpt-6.1-sol déjà en ligne sur la plateforme est affiché à $2 en entrée, $10 en sortie et $0.1 en lecture de cache, avec un tarif d’entrée de $4 au-delà de 272 000 tokens en entrée. Vous pouvez l’utiliser dès maintenant pour monter votre flux de travail, mais ce n’est pas le 6.2, et ses tarifs ne doivent pas être pris pour ceux du 6.2.
Le choix du modèle peut se raisonner par type de tâche. Le tableau ci-dessous résume l’approche recommandée, qui s’appuie sur les données publiques présentées plus haut :
| Scénario de tâche | Recommandation | Justification |
|---|---|---|
| Rédaction, organisation, tâches bureautiques du quotidien | GPT-6.2 Sol peut être envisagé comme choix par défaut | Scores officiels auto-déclarés : LifeVal, GDPval v2 |
| Petites modifications de code, soumissions de PR | GPT-6.2 Sol convient, à privilégier quand le budget est serré | Scores officiels auto-déclarés : FrontierCode 2.0 |
| Questions-réponses sur base de code, agents de codage à longues chaînes d’actions | Ne vous fiez pas au seul score global, comparez d’abord sur votre propre dépôt | Coding Agent Index tiers : 3 points de moins |
| Questions où omettre un fait coûte cher | Ajoutez de la recherche et de la vérification, croisez plusieurs modèles si besoin | Taux d’hallucination tiers : 55 % |
| Entrées très longues (au-delà de 272K) | Estimez d’abord le coût total après application de la majoration | Règles de tarification de la page officielle du modèle |
🚀 Conseil de prise en main : au quotidien, GPT-6.2 Sol peut être votre choix par défaut, mais pour les questions-réponses où omettre un fait coûte cher, ne vous arrêtez pas au score global. Sur APIYI (apiyi.com), utilisez la même clé API pour comparer les modèles disponibles comme
gpt-6.1-sol,claude-opus-5-5ougemini-4-carbon, faites d’abord tourner vos propres tâches, puis basculez vers le 6.2 en comparaison dès sa mise en ligne.
FAQ – Questions fréquentes
Q1 : Quel est le positionnement du modèle GPT-6.2 Sol ?
GPT-6.2 Sol est le modèle le plus abordable de la série 6.2 publiée par OpenAI le 17 novembre 2026. Son identifiant de modèle est `gpt-6.2-sol` : il accepte du texte et des images en entrée, génère du texte en sortie, dispose d’une fenêtre de contexte de 1 050 000 tokens et ses connaissances s’arrêtent au 1er juin 2026. Il est positionné comme un modèle généraliste offrant un excellent rapport qualité-prix, publié en même temps que le plus cher GPT-6.2 Astra.
Q2 : Quels sont les points forts et les points faibles de GPT-6.2 Sol par rapport à GPT-6.1 Sol ?
Les tarifs affichés sont identiques. Selon les chiffres officiels auto-déclarés, GDPval v2 gagne 5,3 points ; selon l’Intelligence Index tiers, la catégorie Max gagne 2 points pour atteindre 57. En revanche, le Coding Agent Index tiers est inférieur de 3 points, principalement en raison de SWE-Atlas-QnA-AA qui perd 14 points : le modèle omet plus facilement des faits clés. Les tâches quotidiennes progressent, mais les questions-réponses sur les bases de code au sein des agents de codage régressent.
Q3 : GPT-6.2 Sol est-il meilleur que GPT-6.2 Astra ?
Pas vraiment. D’après les scores globaux des tiers, Astra devance Sol à tous les niveaux de raisonnement, avec 62 contre 57 dans la catégorie Max. L’avantage de Sol, c’est le coût : selon les données officielles auto-déclarées, FrontierCode 2.0 affiche moins d’un demi-point d’écart avec Astra pour environ un cinquième du coût ; côté tiers, le coût par tâche est de 1,01 $ contre 4,00 $.
Q4 : Quel est le prix officiel de GPT-6.2 Sol ?
Le tarif standard officiel d’OpenAI pour les courts contextes est de 2 $ en entrée, 0,10 $ en lecture de cache, 2,50 $ en écriture de cache 30 minutes et 10 $ en sortie (par million de tokens) ; au-delà de 272K tokens en entrée, l’ensemble de la facture est majoré. APIYI : le modèle n’est pas encore disponible, nous l’ajouterons dès que possible ; les identifiants de modèles et les tarifs font foi tels qu’affichés dans la liste des modèles de la plateforme.
Q5 : Avant que la 6.2 ne soit disponible, comment réaliser des tests comparatifs via l’API ?
Vous pouvez déjà mettre en place votre flux de travail avec les modèles actuellement disponibles :
1. Créez un compte sur APIYI (apiyi.com) et récupérez votre clé API ainsi que des crédits de test gratuits
2. Appelez les modèles disponibles comme `gpt-6.1-sol` ou `gpt-6-astra` via l’API compatible OpenAI
3. Une fois la 6.2 en ligne, changez simplement le paramètre `model` pour vos tests A/B
Attention : `gpt-6-sol` et `gpt-6.1-sol` ne sont pas des modèles 6.2, et leurs tarifs ne sont pas interchangeables.
Q6 : Gemini 4 Carbon a le même prix que Sol : lequel choisir ?
Le tarif standard officiel de Gemini 4 Carbon est de 2 $ en entrée et 10 $ en sortie jusqu’au 30 novembre 2026, puis passe à 4 $ / 20 $ à partir du 1er décembre 2026 ; le score global tiers atteint 60 dans la catégorie la plus élevée. Sur APIYI (apiyi.com), `gemini-4-carbon` affiche actuellement un tarif de lancement ; après le 1er décembre, référez-vous à la liste des modèles de la plateforme. Il prend en charge les entrées vidéo et audio, mais ne dispose pas du point de terminaison Responses : basez votre choix sur les types d’entrées et les interfaces dont vous avez besoin.
Q7 : Peut-on utiliser GPT-6.2 Sol pour la recherche de vulnérabilités ?
Il atteint le niveau « Critique » en cybersécurité, avec des protections renforcées : certaines demandes de recherche de vulnérabilités légitimes peuvent être refusées. Daybreak, destiné aux équipes défensives, n’existe pas encore en version 6.2 ; OpenAI indique seulement s’efforcer de l’introduire.
GPT-6.2 Sol : les points clés à retenir
- Progrès nets sur les tâches quotidiennes : selon les chiffres officiels, LifeVal dépasse GPT-6 Astra, pour un coût environ sept fois inférieur.
- Prix inchangé : même tarif officiel que GPT-6.1 Sol, soit 2 $ en entrée et 10 $ en sortie.
- Codage presque au niveau d’Astra : FrontierCode 2.0 officiel avec un écart de moins de 0,5 point.
- Scores globaux tiers : Max 57, Xhigh 56, High 55, Medium 53, Low 41.
- Recul des agents de codage : le Coding Agent Index tiers est 3 points sous GPT-6.1 Sol, avec un risque accru d’omettre des faits.
- Taux d’hallucination de 55 % : pour les questions/réponses sensibles aux faits, il faut impérativement ajouter de la recherche documentaire et une relecture.
- Pour bien démarrer : en attendant que le 6.2 soit disponible, vous pouvez déjà mettre en place votre processus de comparaison sur APIYI (apiyi.com) avec les modèles actuellement proposés.
En résumé
Les points essentiels de GPT-6.2 Sol :
- Tâches quotidiennes : LifeVal et GDPval v2 officiels affichent tous deux des progrès — vous obtenez des performances quotidiennes proches du fleuron de la génération précédente, au prix de Sol.
- Le codage mérite un regard nuancé : FrontierCode 2.0 officiel frôle Astra, mais le Coding Agent Index tiers est 3 points sous GPT-6.1 Sol, et les questions/réponses sur les bases de code omettent plus facilement des faits.
- Un score global ne fait pas tout : le score tiers Max de 57 égale GPT-6 Astra, mais le taux d’hallucination de 55 % et le 41 en niveau Low vous rappellent de ne pas vous arrêter à un seul chiffre.
Si votre quotidien professionnel repose surtout sur la rédaction, l’organisation et les tâches bureautiques, GPT-6.2 Sol mérite d’être envisagé en priorité comme modèle par défaut ; en revanche, si vous comptez sur des agents de codage pour interroger vos bases de code, ou si un seul fait manqué vous oblige à reprendre le travail, mieux vaut d’abord faire vos propres comparaisons sur vos tâches. Nous vous recommandons de passer par APIYI (apiyi.com) pour comparer les modèles disponibles avec une même clé API, puis de basculer sur le 6.2 dès sa mise en ligne pour valider le changement.
📚 Références
-
Annonce officielle d’OpenAI : présentation et évaluations auto-déclarées de GPT-6.2 Astra et Sol
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Note : source des résultats officiels auto-déclarés sur LifeVal, FrontierCode 2.0, GDPval v2, etc.
- Lien :
-
Page modèle OpenAI : spécifications et tarifs affichés de gpt-6.2-sol
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - Note : fenêtre de contexte, date de coupure des connaissances, majoration de 272 K sur commande complète et règles Batch, Fast, Ultrafast
- Lien :
-
Fiche système OpenAI : classification de sécurité et évaluations d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Note : niveau « critique » en cybersécurité, niveau « élevé » en biochimie et détails des mesures de protection
- Lien :
-
Article d’évaluation d’Artificial Analysis : score global tiers et indice d’agent de codage
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Note : Intelligence Index par palier de raisonnement, Coding Agent Index et taux d’hallucination
- Lien :
-
Page modèle d’Artificial Analysis : coût par tâche de GPT-6.2 Sol
- Lien :
artificialanalysis.ai/models/gpt-6-2-sol - Note : données tierces, dont le coût par tâche de l’indice global
- Lien :
-
Tableau complet des modèles APIYI : modèles disponibles et tarifs sur la plateforme
- Lien :
docs.apiyi.com/models.md - Note : pour vérifier si le 6.2 est en ligne et consulter les tarifs des modèles proposés
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI, et retrouvez plus de ressources dans le centre de documentation docs.apiyi.com


