
Note de l’auteur : cet article décortique les tests à l’aveugle, les benchmarks en annexe et les témoignages côté produit de la page de recherche de Tencent. Il compare Hy4 flash et GLM-5.3-Flash sur les tâches quotidiennes, le codage en terminal, le coût et les protocoles d’intégration, puis précise lequel des deux est aujourd’hui appelable sur APIYI.
Tencent Hunyuan a publié Hy4 flash le 16 novembre 2026, et la communication officielle le positionne comme « le modèle le moins cher pour la productivité quotidienne ». Beaucoup de personnes hésitent aujourd’hui entre GLM-5.3-Flash et lui pour en faire leur modèle principal du quotidien. La page de recherche de Tencent fournit trois types de matériaux : des tests à l’aveugle réalisés par des humains, des tableaux de référence en annexe et des témoignages côté produit. Les conclusions de ces trois sources ne vont pas exactement dans le même sens.
Ce n’est pas un article de compromis façon « chacun a ses points forts ». La suite présente séparément les données des trois sources, avec la source indiquée pour chaque chiffre. À la fin, je donne une recommandation claire selon le cas d’usage, et je précise quel modèle est aujourd’hui directement appelable sur APIYI.
L’essentiel à retenir : après lecture, vous saurez où Hy4 flash l’emporte dans les tests à l’aveugle, où GLM-5.3-Flash gagne dans les benchmarks en annexe, et quels protocoles et règles de prix surveiller au moment de l’intégration.
Différences clés entre Hy4 flash et GLM 5.3 Flash
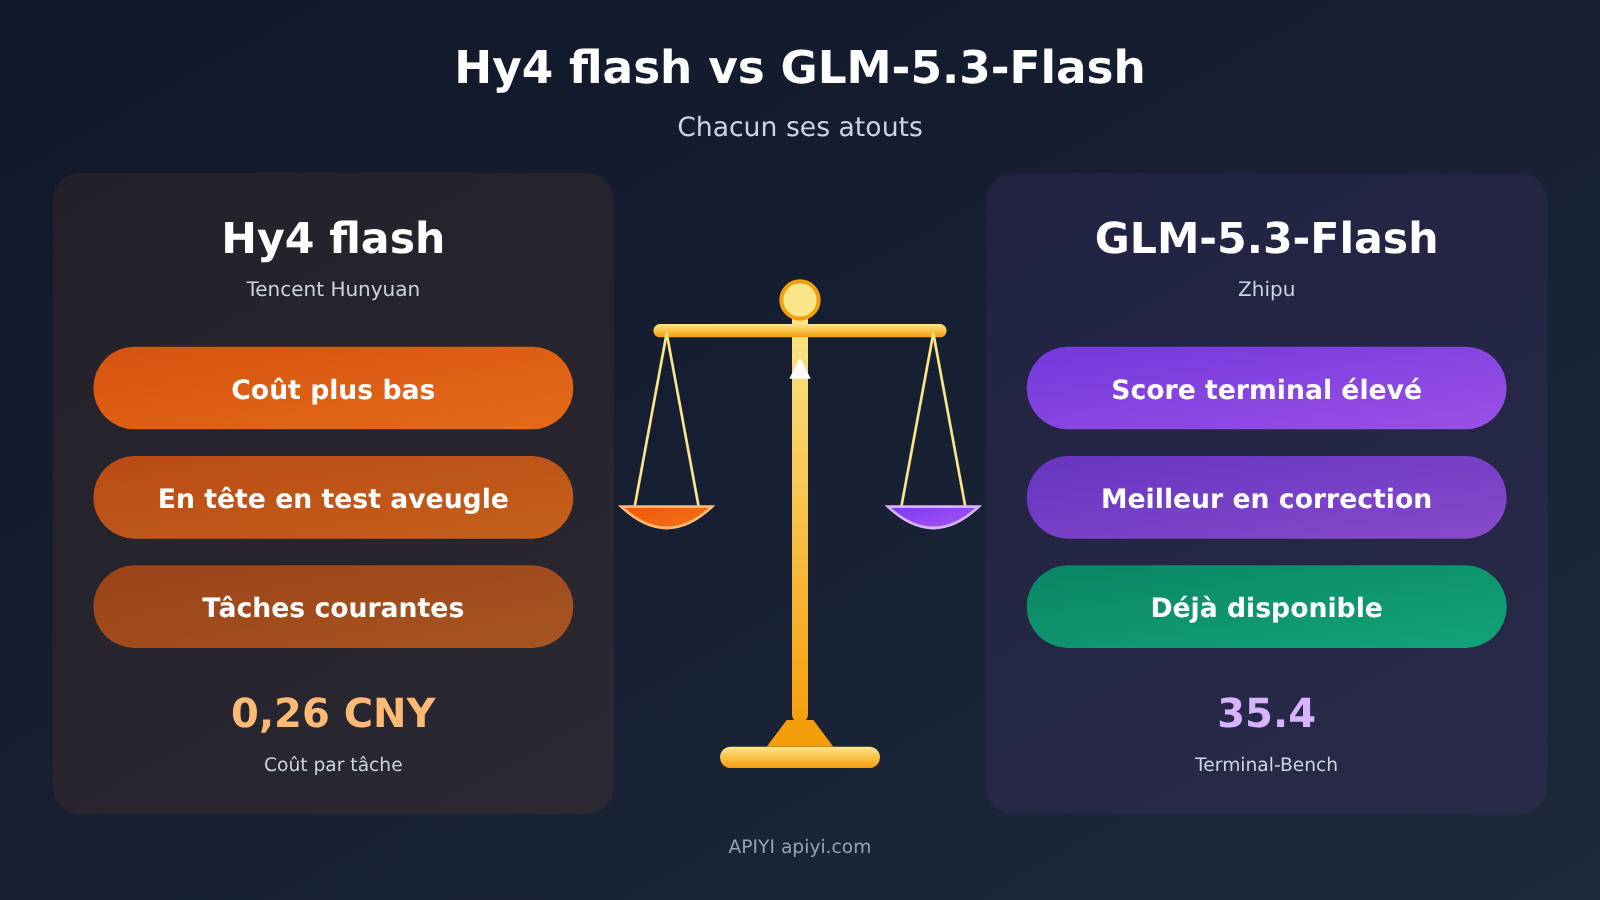
Commençons par la conclusion : aucun des deux ne l’emporte sur tous les fronts. Dans le test à l’aveugle de Tencent, Hy4 flash affiche une meilleure satisfaction, tout en étant plus rapide et moins cher. Dans les annexes, sur des évaluations comme Terminal-Bench 4.0 et PPTFixBench, davantage orientées « correction, opérations en terminal », GLM-5.3-Flash obtient de meilleurs scores.
| Critère de comparaison | Hy4 flash | GLM-5.3-Flash | Source des données |
|---|---|---|---|
| Satisfaction au test à l’aveugle (sur 4) | 2,79 | 2,53 | Tableau du test à l’aveugle de la page de recherche Tencent (déclaration officielle) |
| Temps médian de bout en bout | 6,7 minutes | 7,6 minutes | Idem |
| Coût par tâche au test à l’aveugle | 0,26 yuan | 0,81 yuan | Idem, en yuans |
| Terminal-Bench 4.0 | 19,2 | 35,4 | Annexe de la page de recherche Tencent |
| PPTFixBench | 23,7 | 28,6 | Annexe de la page de recherche Tencent |
| MdCoEditBench (co-écriture Markdown) | 56,9 | 32,3 | Annexe de la page de recherche Tencent |
| Spécifications | 224B de paramètres totaux (dont 64B Engram), 12B activés, fenêtre de contexte de 1M | 320B de paramètres totaux, 18B activés, fenêtre de contexte de 1M, sortie maximale de 128 000 | Page de recherche / page du modèle APIYI |
| Plateformes d’accès | Tencent Cloud TokenHub, WorkBuddy, etc. ; pas encore disponible sur APIYI | Disponible sur APIYI apiyi.com sous glm-5.3-flash |
Page de recherche / liste des modèles APIYI |
Tous les scores de ce tableau viennent du camp Tencent ; GLM n’a pas eu l’occasion de présenter sa défense. Il faut garder à l’esprit que le test à l’aveugle et les annexes sont des chiffres déclarés par Tencent, et que la plupart des jeux d’évaluation sont internes à Tencent, pas des positions dans un classement public final.
Les trois conventions de mesure dans la comparaison Hy4 flash / GLM 5.3 Flash
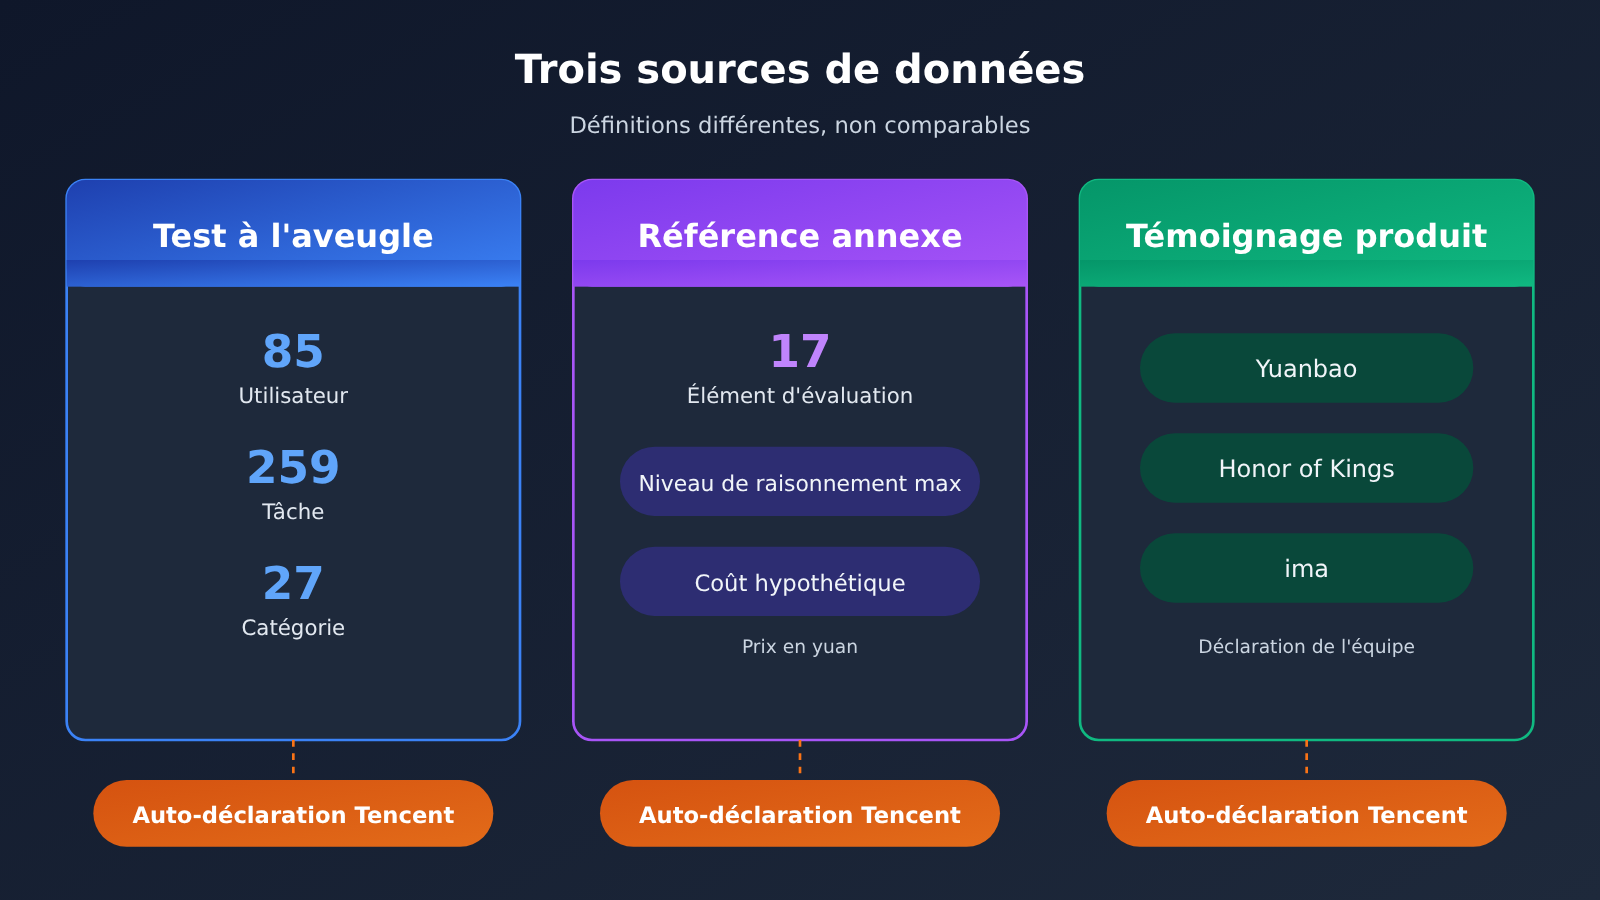
Les trois sources utilisent des conventions de mesure totalement différentes ; les mélanger prête facilement à confusion :
- Test à l’aveugle : 85 utilisateurs internes de WorkBuddy, 259 tâches, 27 catégories. Les modèles externes (dont GLM) sont en mode high, tandis que la ligne Hy4 flash n’indique aucun niveau.
- Tableau en annexe : 17 évaluations, chaque modèle étant pris à son plus haut niveau de raisonnement. Chaque cellule inclut un coût par tâche, calculé selon un prix fixe en yuans défini par Tencent.
- Témoignages des équipes produit : chiffres rapportés par les équipes Yuanbao, Honor of Kings, ima, etc., chacun dans son propre contexte et avec sa propre base de référence ; ils ne sont pas comparables entre eux.
Résultats du test à l’aveugle : Hy4 flash face à GLM 5.3 Flash
Le test à l’aveugle est l’argument le plus favorable dont dispose Hy4 flash. Le tableau complet du test à l’aveugle, sur la page de recherche, comporte quatre lignes ; les voici reproduites telles quelles (chiffres déclarés par Tencent elle-même) :
| Modèle | Satisfaction (note sur 4) | Temps médian de bout en bout | Coût par tâche (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3,09 | 10,3 minutes | 1,20 RMB |
| Hy4 flash (niveau non précisé) | 2,79 | 6,7 minutes | 0,26 RMB |
| Claude-Haiku-5.5 (high) | 2,81 | 6,8 minutes | 4,73 RMB |
| GLM-5.3-Flash (high) | 2,53 | 7,6 minutes | 0,81 RMB |
Si l’on ne regarde que les deux lignes Hy4 flash et GLM-5.3-Flash, Hy4 flash obtient une satisfaction supérieure de 0,26 point, un temps plus court d’environ 0,9 minute, et un coût par tâche d’environ un tiers de celui de GLM. C’est la base directe de l’affirmation « le test à l’aveugle du quotidien coûte moins cher ».
Trois points à bien lire. Premièrement, le meilleur score de satisfaction est celui de DeepSeek, à 3,09, et non celui de Hy4 flash. Deuxièmement, Hy4 flash est inférieur de 0,02 point à Haiku ; le mot utilisé sur la page de recherche est « proche de » (close to), pas « supérieur à ». Troisièmement, la « réduction du coût par tâche d’un facteur 18 » citée dans le post officiel provient de 4,73 RMB divisé par 0,26 RMB, et le point de comparaison est Haiku, pas GLM.
D’où vient le coût du test à l’aveugle de Hy4 flash face à GLM 5.3 Flash
Les coûts en RMB du tableau du test à l’aveugle sont calculés par Tencent selon sa propre grille tarifaire. Ils reflètent « qui dépense le moins sur un même lot de tâches », et ne correspondent pas à votre facture réelle sur une plateforme quelconque. Le coût bas de Hy4 flash vient en partie d’un prix catalogue bas, et en partie de ce que la page de recherche attribue à l’apprentissage par renforcement : une réduction de 50 % du nombre moyen de tokens de sortie de bout en bout.
La page de recherche contient aussi une série de conclusions WorkIndex : le coût moyen par tâche représente 1/13 de celui de Hy4 preview et 1/20 de celui de Hy4. Ces phrases ne valent que pour WorkIndex : ne les utilisez pas pour remplacer les chiffres en RMB du tableau du test à l’aveugle, et elles n’ont rien à voir avec GLM.
Benchmarks de l’annexe : Hy4 flash face à GLM 5.3 Flash
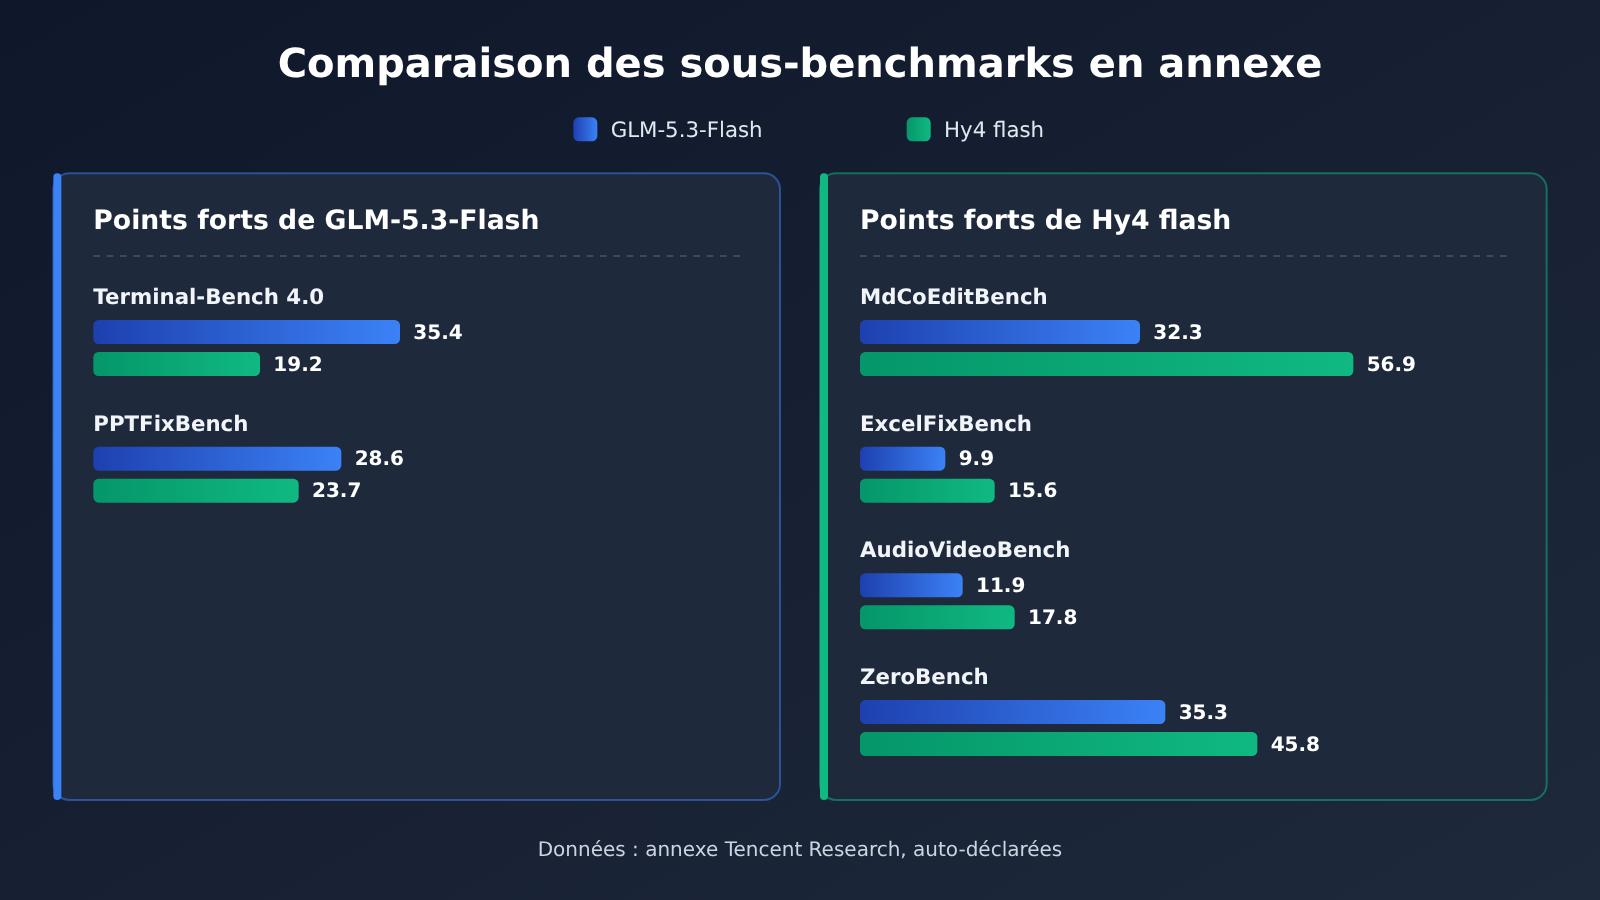
C’est sur l’annexe que GLM-5.3-Flash reprend des points. Le tableau ci-dessous reprend l’intégralité de l’image Appendix de la page de recherche de Tencent, en ne conservant que ces deux colonnes, au format « score / coût par tâche (RMB) » :
| Benchmark | Hy4 flash | GLM-5.3-Flash | Meilleur score |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (sans outils) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (avec outils) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (avec outils) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
L’écart le plus marqué concerne Terminal-Bench 4.0 : GLM à 35.4 contre 19.2 pour Hy4 flash, soit presque le double. Ce benchmark s’appuie sur le harness Claude Code, avec jusqu’à 500 tours et une durée maximale de 13 heures par exécution ; il évalue les opérations terminal sur la longue durée. Sur PPTFixBench, GLM mène aussi d’environ 5 points. GLM devance également d’une courte tête sur DeepSWE, WordEditBench, BuddyVQA et MMMU-Pro.
Hy4 flash creuse l’écart sur l’écriture collaborative de Markdown (56.9 contre 32.3), la réparation de tableaux, le traitement audio-vidéo et ZeroBench. Ces tâches sont plus proches du travail de bureau quotidien : rédiger des documents, corriger des tableaux, traiter des médias. Cela rejoint la recommandation de la page de recherche : pour l’ingénierie logicielle de longue haleine, continuez avec Hy4, pas avec Hy4 flash.
La colonne des coûts en annexe est une hypothèse de Tencent, pas une facture de la plateforme
L’annexe originale le précise : les coûts sont calculés sur la base du tarif API officiel de chaque modèle, avec 1 dollar converti à 7,2 yuans. Le prix fixe retenu pour GLM-5.3-Flash est de 0,8 yuan par million de tokens en entrée, 0,23 yuan pour les hits de cache et 2,8 yuan en sortie, mentionné comme « tarif API standard ». Il s’agit d’une hypothèse d’annexe posée par Tencent au moment de dresser le tableau, et non du tarif affiché par APIYI. Ne vous en servez pas non plus pour convertir votre facture sur APIYI.
Témoignages des équipes produit : Hy4 flash face à GLM 5.3 Flash
La page de recherche joint également les témoignages de plusieurs équipes produit de Tencent, dont trois citent directement GLM-5.3-Flash. Ce sont là des déclarations des équipes produit elles-mêmes, avec des contextes et des bases de comparaison qui varient :
- Yuanbao (déclaration de l’équipe produit) : en conversation générale, le score dépasse GLM-5.3-Flash de 2,52 %, l’écart étant le plus marqué en dialogue multi-tours. Il s’agit d’une évaluation interne de l’équipe Yuanbao, pas d’un classement public.
- Honor of Kings (déclaration de l’équipe produit) : par rapport à DeepSeek-V4.1-Flash-1017 et GLM-5.3-Flash, la localisation des causes racines est comparable. Les requêtes au modèle sont inférieures de 22,0 % à 39,1 %, les tokens de 40,5 % à 61,2 %, et les appels d’outils supérieurs de 51,2 % et 7,7 % respectivement.
- ima (déclaration de l’équipe produit) : par rapport aux deux modèles ci-dessus, l’attente moyenne est réduite de 18 % à 35 %, la note de réponse supérieure de 1,8 % et la qualité du contenu supérieure de 8,1 %.
Le point commun de ces trois retours : Hy4 flash l’emporte sur le terrain du « moins de tokens dépensés, moins d’attente », tandis que sur la qualité, c’est proche ou légèrement devant. Ils confirment les conclusions du test à l’aveugle, mais ne peuvent pas contredire l’écart observé sur Terminal-Bench dans l’annexe, car il ne s’agit pas du tout du même type de tâche.
Hy4 flash vs GLM 5.3 Flash : tarifs et intégration
Les prix sont la partie la plus facile à rater. On ne peut pas mélanger des chiffres venant de sources différentes : le tableau ci-dessous sépare l’origine de chaque tarif (unités en dollars par million de tokens) :
| Modèle / source | Entrée | Sortie | Lecture cache | Remarques |
|---|---|---|---|---|
| Hy4 flash (tarif catalogue, page de recherche Tencent) | 0.070 | 0.281 | 0.003 | Prix hors APIYI ; TokenHub applique -50 % jusqu’au 2026-11-30 |
glm-5.3-flash (page modèle APIYI apiyi.com) |
0.15 | 0.50 | 0.03 | Déjà disponible, groupes CodexResponses, Default, SVIP, multiplicateur 1x |
glm-5-3-flash-260828 (tableau récapitulatif APIYI) |
0.15 | 0.499995 | 0.03 | Autre canal, sans conflit avec la ligne précédente |
hy4 (tableau récapitulatif APIYI) |
0.85 | 2.55 | 0.045 | C’est Hy4, pas Hy4 flash |
| Hy4 (tarif catalogue, page de recherche Tencent) | 0.834 | 2.501 | 0.042 | Tarif catalogue de la page de recherche, à distinguer des prix APIYI |
Les -50 % sur Hy4 flash correspondent à une fenêtre promotionnelle limitée de TokenHub. La page de recherche ne publie pas de tableau de prix remisé à part : si vous divisez vous-même par 2 pour estimer, n’oubliez pas que le tarif catalogue revient après le 30 novembre.
Hy4 flash n’est pas encore référencé, nous allons le mettre en ligne dès que possible ; les identifiants de modèle et les prix font foi sur la liste des modèles de la plateforme. Aujourd’hui, APIYI ne propose que hy4, aucune version flash de Hunyuan. Si ce qu’il vous faut est la version Hunyuan à plafond élevé de Tencent, vous pouvez commencer avec hy4 ; si c’est bien Hy4 flash que vous voulez, il ne reste pour l’instant que les canaux officiels comme Tencent Cloud TokenHub ou WorkBuddy. La page de recherche ne donne pas non plus d’ID de modèle API : avant d’appeler, fiez-vous au nom affiché dans la console TokenHub.
Comment appeler GLM-5.3-Flash sur APIYI
glm-5.3-flash est disponible dès aujourd’hui. Sur APIYI, il ne prend en charge que les OpenAI Chat Completions, pas les Anthropic Messages, ni les Responses. C’est ce point qui détermine si vous pouvez le brancher directement dans certains clients :
- Créez une clé dans la console apiyi.com.
- Réglez le base_url du client sur
https://api.apiyi.com/v1, le chemin de requête étant/chat/completions. - Dans le corps de la requête, mettez
glm-5.3-flashdansmodelet passezmessagesau format OpenAI. - La réflexion est activée par défaut ; l’entrée peut être du texte, des images ou des vidéos, la sortie est du texte.
Si votre outil n’envoie que des requêtes au format Anthropic Messages, glm-5.3-flash ne fonctionnera pas directement. Dans ce cas, soit vous passez à un client qui gère Chat Completions, soit vous choisissez un modèle qui expose à la fois les endpoints chat et messages. Les paramètres comme la fenêtre de contexte, la sortie maximale ou les endpoints font foi sur la page modèle d’APIYI.
🚀 Conseil d’intégration : pour un modèle déjà référencé sur APIYI, utilisez votre clé apiyi.com et envoyez vos requêtes à
https://api.apiyi.com/v1; un client compatible OpenAI fonctionne après avoir modifié deux réglages. Les nouveaux utilisateurs disposent d’un quota de test gratuit : vous pouvez d’abord essayerglm-5.3-flashsur vos tâches quotidiennes.
Hy4 flash vs GLM 5.3 Flash : quels cas d’usage pour lequel
Quand choisir Hy4 flash
- Rédaction de documents et de Markdown : sur MdCoEditBench (annexe), 56,9 contre 32,3 — l’écart est net.
- Réparation de tableaux, traitement de contenus audio-vidéo : Hy4 flash est en tête sur ExcelFixBench et AudioVideoBench.
- Tâches quotidiennes fréquentes et sensibles au coût : en test à l’aveugle, 0,26 yuan par tâche contre 0,81 yuan (chiffres annoncés par Tencent).
- Produits à base de dialogues multi-tours : l’équipe produit de Yuanbao indique +2,52 % en conversation générale, l’écart étant le plus marqué sur le multi-tours.
Quand choisir GLM-5.3-Flash
- Opérations en terminal et tâches longues en ligne de commande : Terminal-Bench 4.0, 35,4 contre 19,2 — c’est l’écart le plus important.
- Tâches de réparation de diaporamas : PPTFixBench, 28,6 contre 23,7.
- Mise en production aujourd’hui même :
glm-5.3-flashest déjà disponible sur APIYI, Hy4 flash pas encore. - Chaîne d’outils basée sur Chat Completions : les clients au format OpenAI peuvent s’y connecter directement.
Hy4 flash vs GLM 5.3 Flash : notre recommandation
| Votre situation | Ce qu’on conseille |
|---|---|
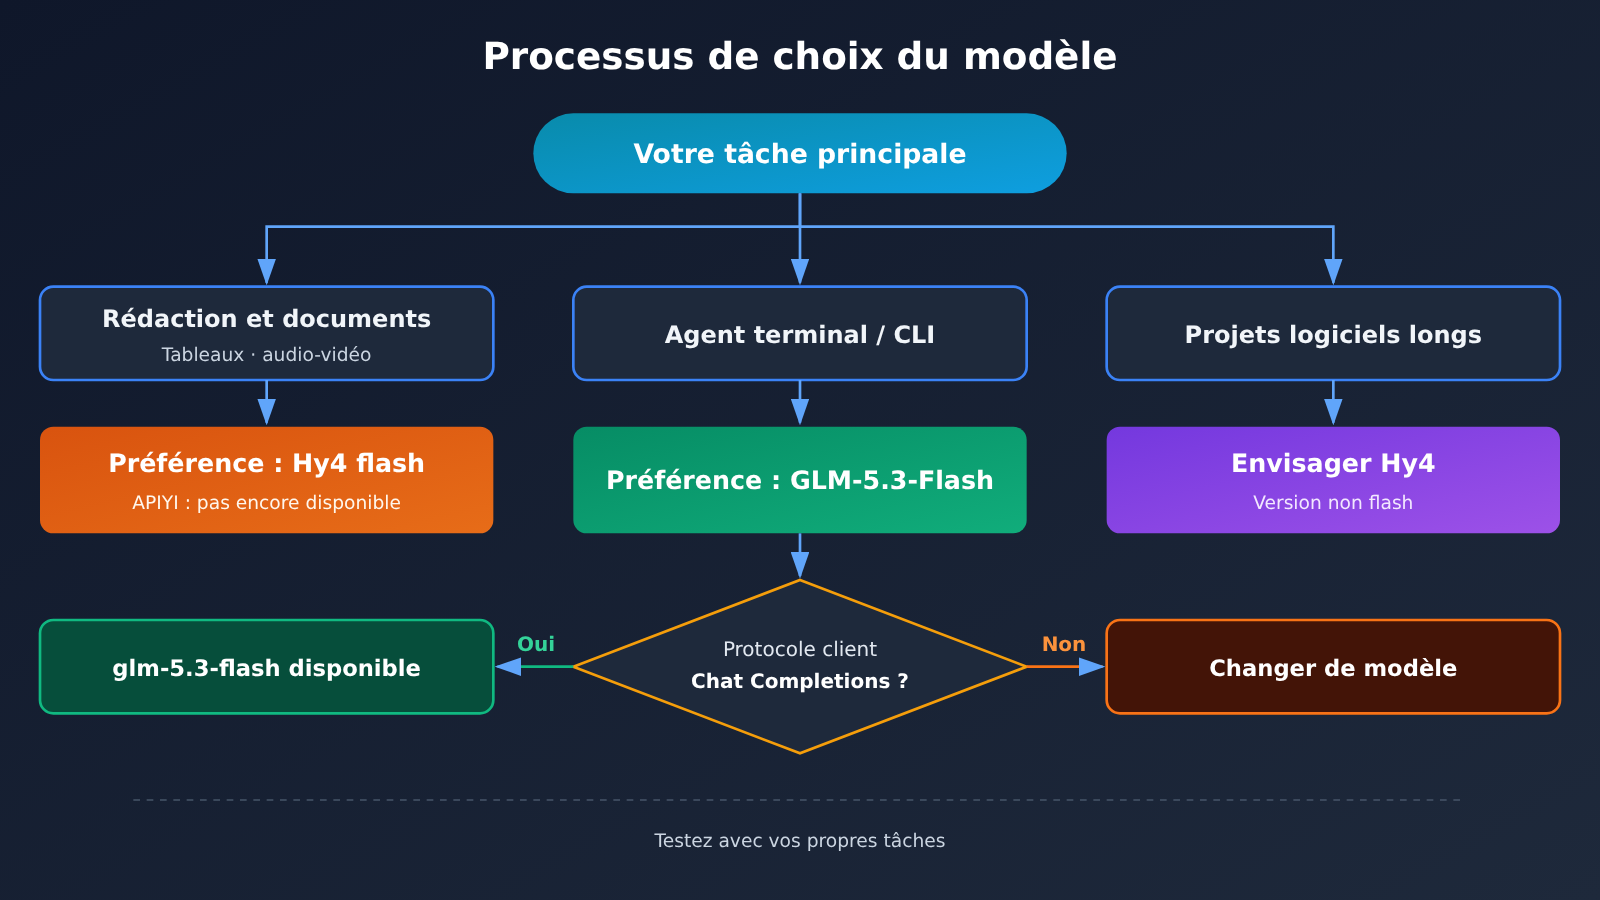
| Surtout de la rédaction, des documents, des tableaux, du traitement de médias | Attendez la disponibilité de Hy4 flash, ou testez d’abord via le canal officiel Tencent |
| Surtout des opérations en terminal, des agents en ligne de commande | Choisissez GLM-5.3-Flash |
| Besoin d’un lancement aujourd’hui sur APIYI | Choisissez glm-5.3-flash, via Chat Completions |
| Client compatible uniquement avec Anthropic Messages | glm-5.3-flash ne convient pas, prenez un modèle qui gère messages |
| Ingénierie logicielle de longue haleine | Ni l’un ni l’autre n’est le choix idéal ; la page de recherche recommande Hy4 |
💡 Conseil de choix : les tests à l’aveugle et les annexes pointent dans des directions différentes ; le plus sûr est de faire tourner un lot de vos propres tâches sur chacun des deux.
glm-5.3-flashpeut être vérifié dès maintenant sur APIYI apiyi.com ; quand Hy4 flash sera disponible, il suffira de changer le paramètremodelpour comparer dans le même code.
Questions fréquentes (FAQ)
Q1 : Que sont Hy4 flash et GLM-5.3-Flash ?
Hy4 flash est le modèle Hunyuan de Tencent destiné aux tâches quotidiennes, publié le 16 novembre 2026 : 224B de paramètres totaux, 12B activés et une fenêtre de contexte de 1M. Selon la fiche modèle d’APIYI, GLM-5.3-Flash est donné pour 320B de paramètres totaux, 18B activés et une fenêtre de contexte de 1M ; l’éditeur l’a publié le 26 août 2026.
Q2 : Entre Hy4 flash et GLM 5.3 Flash, lequel est le plus fort ?
Tout dépend du type de tâche. Dans le test à l’aveugle de Tencent, Hy4 flash obtient un score de satisfaction de 2,79, contre 2,53 pour GLM. Dans l’annexe, GLM est devant sur Terminal-Bench 4.0 et PPTFixBench, tandis que Hy4 flash est devant sur la co-rédaction en Markdown, les tableaux, l’audio/vidéo et ZeroBench. Toutes ces données sont déclarées par Tencent lui-même.
Q3 : Yuanbao affirme que le dialogue généraliste dépasse GLM-5.3-Flash de 2,52 %. Faut-il y croire ?
C’est une auto-évaluation de l’équipe produit Yuanbao, pas un classement public, et aucun détail méthodologique n’est publié. On peut y voir un indice que Hy4 flash pourrait avoir l’avantage sur les dialogues multi-tours, mais mieux vaut ne pas en faire une conclusion.
Q4 : Les 0,8 yuan, 0,23 yuan et 2,8 yuan indiqués pour GLM dans l’annexe sont-ils les prix d’APIYI ?
Non. Ce sont des hypothèses de prix fixes en yuans (RMB) retenues par Tencent pour construire le tableau en annexe. Sur la page des modèles d’APIYI, `glm-5.3-flash` est à 0,15 USD en entrée, 0,50 USD en sortie et 0,03 USD pour la lecture du cache, par million de tokens ; c’est la liste des modèles de la plateforme qui fait foi.
Q5 : Peut-on déjà appeler Hy4 flash sur APIYI ?
Hy4 flash n’est pas encore disponible ; nous ferons notre possible pour le mettre en ligne rapidement. Le modèle et le prix à retenir sont ceux de la liste des modèles de la plateforme. Pour l’instant, APIYI permet d’appeler `glm-5.3-flash` et `hy4` — attention, `hy4` n’est pas la version flash. Pour suivre les ajouts, consultez la liste des modèles sur apiyi.com.
Q6 : Peut-on utiliser glm-5.3-flash avec un client qui ne prend en charge que le format Anthropic ?
Non. Sur APIYI, `glm-5.3-flash` n’expose qu’un point de terminaison OpenAI Chat Completions ; il ne prend pas en charge Messages ni Responses. Le client doit pouvoir pointer `base_url` vers `/v1` et envoyer des requêtes Chat Completions.
Q7 : Quelles sont les limites connues des deux modèles ?
Hy4 flash n’obtient que 19,2 points sur Terminal-Bench 4.0 ; sa page de recherche reconnaît aussi qu’il est moins bon que Hy4 en ingénierie logicielle sur des tâches longues, et l’ouverture de ses poids n’est pour l’instant qu’un projet. GLM-5.3-Flash est en retrait sur la satisfaction au test à l’aveugle et sur la co-rédaction en Markdown, et il ne passe que par Chat Completions. Les données comparatives des deux modèles viennent toutes de Tencent.
Hy4 flash face à GLM 5.3 Flash : l’essentiel à retenir
- Hy4 flash l’emporte en test à l’aveugle : satisfaction 2,79 contre 2,53, 6,7 minutes contre 7,6 minutes, 0,26 yuan contre 0,81 yuan.
- GLM devant sur les benchmarks terminal : Terminal-Bench 4.0 affiche 35,4 contre 19,2, et GLM mène aussi sur PPTFixBench.
- Hy4 flash devant sur le bureautique du quotidien : meilleurs scores en écriture collaborative Markdown, réparation de tableaux, audio/vidéo et ZeroBench.
- Les témoignages ne sont que des autodéclarations : le « +2,52 % » de 元宝 vient de l’éditeur lui-même, ce n’est pas un classement public.
- Bien identifier l’origine des prix : les yuan de l’annexe sont une hypothèse de Tencent, les dollars de la page de recherche sont des prix catalogue ; ni les uns ni les autres ne correspondent au tarif affiché par APIYI.
- Ce qui est appelable dès aujourd’hui, c’est GLM :
glm-5.3-flashest déjà disponible sur APIYI apiyi.com, uniquement via Chat Completions.
En résumé
Les conclusions clés de la comparaison Hy4 flash / GLM 5.3 Flash :
- Pour les tâches courantes, regardez Hy4 flash : dans le test à l’aveugle de Tencent, il est plus satisfaisant, plus rapide et moins cher, et il devance aussi GLM sur les benchmarks de documents et de tableaux.
- Pour les tâches terminal, regardez GLM-5.3-Flash : l’écart sur Terminal-Bench 4.0 frôle le double, donc pour les tâches longues en ligne de commande, Hy4 flash n’est pas le bon choix.
- Pour le passage en production, regardez la disponibilité et le protocole : ce que vous pouvez appeler aujourd’hui sur APIYI, c’est
glm-5.3-flash, et uniquement via Chat Completions ; Hy4 flash n’est pas encore disponible.
Si vos tâches sont surtout de la rédaction et du document, surveillez la mise en ligne de Hy4 flash ; si elles penchent vers les opérations terminal, ou si vous avez besoin d’un déploiement immédiat, glm-5.3-flash est la option la plus directe. Mon conseil : profitez des crédits de test gratuits d’apiyi.com et faites tourner vos propres tâches réelles avant de trancher.
📚 Références
-
Page de recherche Tencent Hunyuan Hy4 flash : tableau des tests à l’aveugle, benchmarks en annexe, témoignages du côté produit et prix catalogue
- Lien :
hy.tencent.ai/research/hy4-flash - Description : tous les tests à l’aveugle, les scores en annexe et les témoignages cités dans cet article proviennent de cette page ; ils sont auto-déclarés par Tencent
- Lien :
-
Billet de publication officiel de Tencent Hunyuan : sortie de Hy4 flash et prix catalogue de l’API
- Lien :
x.com/TencentHunyuan/status/2122217770314301469 - Description : source de la « réduction de 18 fois du coût par tâche », dont le point de comparaison est Claude Haiku 5.5
- Lien :
-
Page du modèle GLM-5.3-Flash sur APIYI : paramètres, contexte, endpoint et prix
- Lien :
docs.apiyi.com/models/glm-5-3-flash - Description : les spécifications et le protocole de
glm-5.3-flashfont foi sur cette page
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous via la page d’accueil du site APIYI ; pour davantage de modèles et d’instructions de connexion, rendez-vous sur le centre de documentation docs.apiyi.com


