
Conclusion : le coût API d’un article IA, d’abord les appels, puis le produit fini
Selon les prix relevés dans cet article, avec 10 000 tokens en entrée et 3 000 en sortie, le coût théorique d’une génération est d’environ 0,0066 à 0,10 USD. Pour obtenir un article publiable, il faut encore additionner les coûts de révision, de vérification, d’appels d’outils et d’édition humaine.
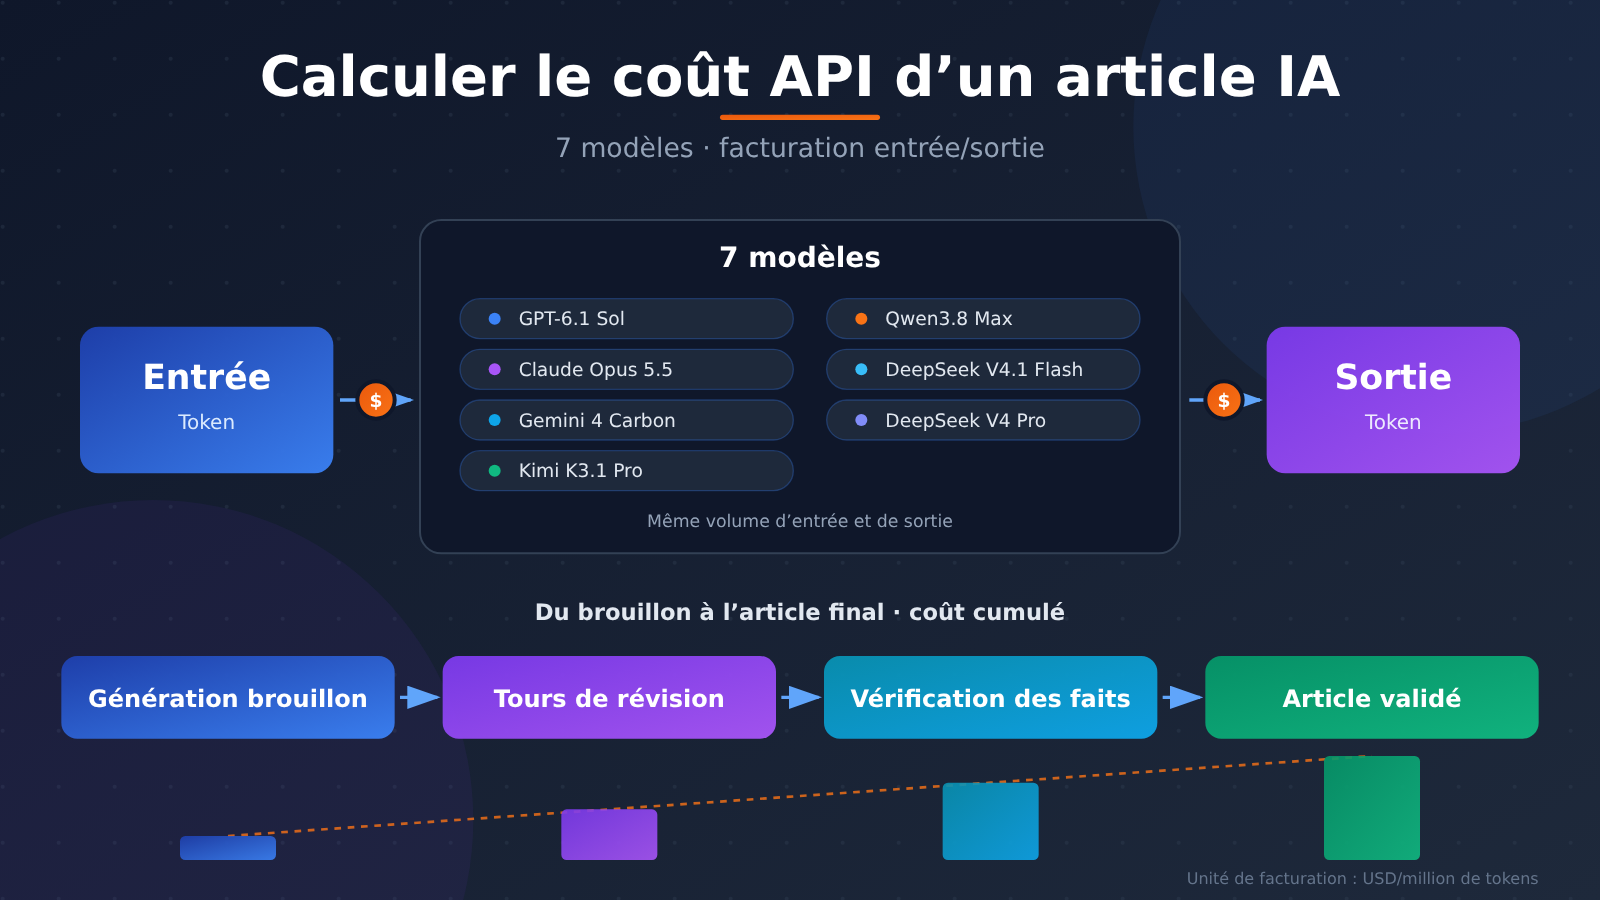
Ce qu’il faut vraiment comparer, c’est le « coût par article conforme ». Cet article compare 7 modèles avec le même volume d’entrée et de sortie, puis explique comment le canal, le cache, l’inférence et le nombre de cycles de révision font varier la facture.
Ce qui suit : la méthode de calcul des coûts API d’un article IA
- Comprendre les entrées, les sorties et la formule de facturation.
- Comparer le coût de 7 modèles sur trois volumes de tâche.
- Distinguer les prix affichés par la plateforme, les tarifs régionaux officiels et les règles selon la plage horaire.
- Utiliser l’historique des appels et le temps d’édition pour choisir une stratégie de production.
Conseil pour bien démarrer : vous pouvez tester le même corpus de documents via l’interface unifiée d’APIYI apiyi.com. Les nouveaux utilisateurs disposent d’un quota de test gratuit ; le quota exact et les conditions d’application sont ceux indiqués actuellement par la plateforme.
Le coût API d’un article généré par IA : commençons par un langage commun
Le Token est l’unité de mesure du texte pour une API, et il n’existe aucun taux de conversion fixe entre tokens et nombre de caractères chinois. Le dossier de référence, l’invite, le plan de l’article et l’historique des conversations soumis au modèle consomment tous des tokens d’entrée.
Les tarifs d’entrée et de sortie sont généralement exprimés en « dollars par million de tokens ». Toutes les simulations de cet article utilisent les prix d’entrée et de sortie standard, en excluant le cache, l’inférence supplémentaire, les remises sur volume et les frais d’outils.
La formule de calcul est la suivante :
$$
C=\frac{T_{\text{entrée}}}{1{,}000{,}000}P_{\text{entrée}}
+\frac{T_{\text{sortie}}}{1{,}000{,}000}P_{\text{sortie}}
$$
Prenons GPT-6.1 Sol comme exemple, avec 10 000 tokens en entrée et 3 000 en sortie :
$$
C=0.01\times2+0.003\times10=0.05\text{ dollars}
$$
Cette somme vous achète une génération. Reste à savoir si l’article peut être publié tel quel : cela dépend des faits, de la structure et du style. La facture, elle, ne signera pas à la place de l’éditeur.
Coût API des articles IA : comparatif des prix d’entrée et de sortie de 7 modèles
Le tableau ci-dessous s’appuie sur l’instantané tarifaire d’APIYI apiyi.com au 12 novembre 2026 à 10:45 (UTC+8). Les unités sont en dollars par million de tokens, avec une facturation au token consommé.
| Modèle | Prix d’entrée | Prix de sortie | Ratio prix sortie/entrée |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | ×5 |
| Claude Opus 5.5 | 4.00 | 20.00 | ×5 |
| Gemini 4 Carbon | 2.00 | 10.00 | ×5 |
| Kimi K3.1 Pro | 2.00 | 10.00 | ×5 |
| Qwen3.8 Max | 1.65 | 4.95 | ×3 |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | ×4 |
| DeepSeek V4 Pro | 1.32 | 3.96 | ×3 |
| Élément de comparaison | Notes d’accès |
|---|---|
| Plateformes disponibles | APIYI apiyi.com ; API officielle de l’éditeur, les règles de zone et de facturation doivent être vérifiées séparément |
Les tokens de sortie coûtent généralement plus cher, mais quand le corpus de référence est très long, les frais d’entrée peuvent aussi devenir le poste principal. Le choix doit donc se faire en regardant les deux colonnes de prix, et pas uniquement la longueur des articles.
Coût API des articles IA : quelles différences de prix en direct chez les éditeurs ?
Voici les règles officielles en connexion directe relevées au 12 novembre 2026. Elles servent à vérifier les écarts entre canaux et ne se substituent pas au tableau de prix de la plateforme ci-dessus.
| Modèle / canal | Prix ou règle officielle |
|---|---|
| GPT-6.1 Sol, Standard | entrée 2, sortie 10 |
| Claude Opus 5.5, appel standard | entrée 4, sortie 20 |
| Gemini 4 Carbon, appel standard | période de lancement jusqu’au 30 novembre : entrée 2, sortie 10 ; à partir du 1er décembre : entrée 4, sortie 20 |
| Qwen3.8 Max, Pékin / Virginie (États-Unis) Global | entrée 1.65, sortie 4.951 |
| Qwen3.8 Max, Singapour International | entrée 2, sortie 6 |
| Kimi K3.1 Pro, Alibaba Cloud Pékin / Singapour | respectivement 1.837 / 9.611 et 2 / 10 |
| DeepSeek, les deux modèles | prix en heure de pointe identiques aux valeurs du tableau ci-dessus, moitié prix hors pointe |
Le changement de tarif de Gemini s’applique à la connexion directe officielle de Google ; les canaux tiers doivent consulter leurs propres annonces. Le prix de sortie de 4.95 sur la plateforme et le 4.951 officiel de certaines zones pour Qwen doivent également être conservés séparément.
Les heures de pointe officielles de DeepSeek sont, les jours ouvrés, de 09:00 à 12:00 et de 14:00 à 18:00, heure de Pékin. Les autres plages horaires et les week-ends relèvent du régime hors pointe, et les jours fériés légaux sont calculés à part.
Aux tarifs officiels hors pointe, Flash est à 0.15 en entrée et 0.60 en sortie ; Pro à 0.66 en entrée et 1.98 en sortie. Le gain obtenu en planifiant les appels dépend de l’application effective de cette règle par le canal utilisé.
Coût API d’un article IA : comment calculer selon le volume de sources et trois tours de révision ?
Commençons par comparer deux volumes de sources. Les chiffres ci-dessous sont des simulations théoriques ; les tokens de sortie correspondent à l’unité de mesure du modèle, et non au nombre de caractères chinois.
| Modèle | 50 000 entrées + 5 000 sorties | 100 000 entrées + 10 000 sorties | Cumul sur trois tours |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Unité : dollars. Les trois colonnes utilisent l’instantané de la plateforme mentionné plus haut ; le cache et les autres frais ne sont pas comptés.
Prenons l’exemple d’une tâche GPT avec 50 000 entrées et 5 000 sorties :
$$
C=0.05\times2+0.005\times10=0.15\text{dollars}
$$
Dont 0.10 dollar pour les entrées et 0.05 dollar pour les sorties. Dans les tâches à forte densité documentaire, mieux vaut souvent commencer par organiser les matériaux d’entrée plutôt que par compacter quelques paragraphes de texte.
Le « cumul sur trois tours » repose sur le processus d’appels indépendants suivant :
- Première ébauche : 10 000 tokens en entrée, 3 000 tokens en sortie.
- Révision : le corpus plus la première ébauche, soit 13 000 tokens en entrée et 3 000 tokens en sortie.
- Version finale : le corpus plus la version précédente, soit 13 000 tokens en entrée et 3 000 tokens en sortie.
Au total : 36 000 tokens en entrée et 9 000 tokens en sortie. Pour GPT, le coût correspondant est :
$$
C=0.036\times2+0.009\times10=0.162\text{dollars}
$$
C’est 3.24 fois le coût de la première génération. Ce processus ne conserve que la version précédente ; si l’on joint tout l’historique à chaque tour, le volume d’entrée continuera d’augmenter.
Le graphique ci-dessous illustre bien l’écart de coût pour une même tâche ; les données proviennent des calculs de la formule ci-dessus et ne constituent pas une évaluation de la qualité.
Coûts API d’un article généré par IA : quatre catégories de frais souvent oubliées
Coûts API et tokens de réflexion, appels d’outils
Les tokens de réflexion correspondent au raisonnement produit par certains modèles avant de générer une réponse. Google inclut explicitement les tokens de raisonnement de Gemini dans les frais de sortie, et le raisonnement supplémentaire du mode Qwen Thinking fait lui aussi grimper la facture.
La recherche en ligne, l’extraction de pages et autres outils peuvent être facturés séparément. Mieux vaut tenir deux compteurs distincts : les tokens du modèle et les requêtes d’outils. Attention en particulier : une seule demande de rédaction peut déclencher plusieurs recherches.
Coûts API et cache d’invites, Batch API
Le cache d’invites réduit une partie des frais d’entrée en réutilisant un même préfixe. Le volume de hits, les frais d’écriture et la durée de validité déterminent l’économie réelle.
Côté officiel, l’entrée mise en cache de GPT-6.1 Sol est à 0,10 ; pour Claude Opus 5.5, la lecture du cache est à 0,20, et l’écriture du cache à 5 minutes et 1 heure respectivement à 5 et 8 — en dollars par million de tokens.
La Batch API sert au traitement asynchrone par lots. Le Batch officiel de Claude applique 50 % de remise en entrée comme en sortie ; le tarif Batch officiel de Gemini suit lui aussi l’ajustement du prix standard au 1er décembre.
Ces règles doivent être vérifiées canal d’accès par canal d’accès. Par exemple, Alibaba Cloud Kimi K3.1 Pro ne prend pas en charge le Batch Inference ; Qwen Pékin Batch File est à 0,825 / 2,475, avec une fenêtre de contexte plafonnée à 256K.
La méthode de base est simple : évaluer d’abord le cache pour les packs de documents stables, n’évaluer le Batch que pour les tâches dont la livraison n’est pas urgente, et toujours intégrer l’écriture du cache dans le total.
Coût API des articles générés par IA : mesurer les Tokens réellement consommés avec du code
Les exemples ci-dessous utilisent une interface compatible OpenAI. La clé est lue depuis une variable d’environnement pour éviter de l’écrire en dur dans le code ; la disponibilité des modèles et la prise en charge des paramètres sont à vérifier dans la documentation à jour.
Appel minimal :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Exemple complet d’estimation du coût des Tokens standard :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Ce code sert à estimer le coût des Tokens standard. Pour le détail du cache, la facturation du raisonnement et les frais d’outils, il faut recouper avec les champs d’usage fournis par le service et les journaux de facturation.
Coûts API des articles générés par IA : recommandations par scénario et conseils de décision
Pour une première ébauche classique et sensible au budget, on peut commencer par tester Flash, Pro et Qwen. Pour les blogs complexes et les articles de fond, on ajoutera GPT, Claude et consorts à la liste des candidats, puis on vérifiera grâce au temps d’édition si un prix unitaire plus élevé en vaut vraiment la peine.
Dans le classement anglophone mis à jour le 11 novembre 2026 par AI Writing Benchmark, GPT-6.1 Sol obtient un score global de 95.3 et un score de catégorie « article » de 98.5, tous deux servant de scores de référence.
Cet outil permet d’intégrer GPT aux tests de blogs en anglais. Les articles en chinois doivent toutefois être validés séparément : le test de longs articles financiers mené du 26 octobre au 3 novembre 2026 ne porte que sur 26 articles, avec un échantillon déséquilibré ; il vaut mieux l’utiliser comme piste de candidats.
Je recommande d’uniformiser le dossier de ressources, la longueur cible et les autorisations d’outils, de masquer le nom des modèles pendant l’évaluation, puis de consigner les erreurs factuelles, le nombre de cycles de révision, les minutes d’édition et le taux d’adoption final.
Le calcul final peut prendre la forme suivante :
$$
C_{\text{article validé}}
=C_{\text{total des appels API et frais associés}}
+C_{\text{révision humaine}}
$$
Les frais de main-d’œuvre peuvent être calculés en multipliant le coût horaire d’édition par le temps réellement passé. Si la vérification implique des API supplémentaires ou du travail humain, il faut également les intégrer aux postes correspondants afin d’éviter les doubles comptages.
FAQ sur les coûts API des articles IA : comment comparer équitablement 7 modèles ?
Lorsque vous changez de modèle via APIYI apiyi.com, gardez les mêmes ressources, exigences de rédaction et autorisations d’outils. En générant plusieurs fois et en enregistrant la consommation, il est plus facile de repérer la stabilité et les coûts de modification.
FAQ sur les coûts API des articles IA : les quotas gratuits peuvent-ils remplacer le calcul des coûts ?
Le quota de test gratuit d’APIYI apiyi.com est adapté pour valider l’interface et le style d’écriture. Pour le budget à long terme, il faut toujours calculer à partir du prix unitaire actuel et de la consommation réelle, en traitant les quotas promotionnels à part.
Conclusion : le coût API des articles IA, l’objectif final reste la productivité
Le tableau des prix unitaires sert à filtrer, les journaux d’appels à comptabiliser, les enregistrements d’édition à décider. Compresser les documents, réutiliser le cache et réduire les reprises peuvent s’avérer plus efficaces que la course au prix de sortie le plus bas.
Nous recommandons de valider les modèles candidats via APIYI apiyi.com, puis de choisir la solution capable de livrer de manière stable des articles conformes à un coût total raisonnable, afin de laisser aux éditeurs le temps de juger.
Références sur les coûts API des articles IA
- Prix des modèles et documentation d’interface APIYI : help.apiyi.com. L’instantané des prix de la plateforme pour cet article date du 12 novembre 2026.
- Prix des modèles Alibaba Cloud : alibabacloud.com/help/en/model-studio/model-pricing. Pour vérifier les tarifs par région.
- Annonce officielle de Google Gemini : blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark : aiwritingbenchmark.com. Cet article se base sur le classement anglophone du 11 novembre 2026.
- Test de rédaction longue et approfondie en chinois : omnitools.ai/evals/longform-writing. Les limites des échantillons et des tâches sont détaillées dans le corps du texte.
Auteur : l’équipe de contenu technique APIYI. N’hésitez pas à échanger via apiyi.com sur l’invocation des modèles et le calcul des coûts d’articles.


