
Note de l’auteur : décryptage du mécanisme Claude Dreaming dévoilé sur le blog d’ingénierie d’Anthropic. Cet article couvre la structure mémoire à 4 couches, les données expérimentales de CL-Bench et du Wiki, des cas de correction d’erreurs et les risques côté ingénierie. Il explique aussi comment s’inspirer de l’idée d’« organiser la mémoire entre les sessions » pour construire son propre système de mémoire d’agent.
Le 6 novembre 2026, Anthropic a publié sur son blog d’ingénierie l’article The components of agent memory. Pour la première fois, l’entreprise y explique de façon systématique comment Claude Dreaming corrige les erreurs, organise la mémoire et construit une base de connaissances entre les sessions. Le compte X officiel a relayé l’article, et la documentation de Claude Managed Agents propose déjà une interface Dreams en préversion de recherche.
Ce n’est pas une énième variante du « on ajoute une base vectorielle à l’agent ». À travers plusieurs séries d’expériences, Anthropic montre qu’un agent qui tourne longtemps ne peut pas se contenter de stocker l’historique. Il doit aussi vérifier, corriger, consolider et structurer sa mémoire en continu, sans quoi les anciennes informations n’aideront pas vraiment la tâche suivante.
Ce que vous allez y gagner : vous comprendrez la structure mémoire à 4 couches de Claude Dreaming et ses principales données expérimentales. Vous saurez aussi dans quels cas cette approche fonctionne, dans quels cas elle nuit, et comment vous en inspirer dans votre propre agent.
Claude Dreaming : l’essentiel en un coup d’œil
| Élément | Détails |
|---|---|
| Date de publication | 2026-11-06, blog Anthropic Engineering |
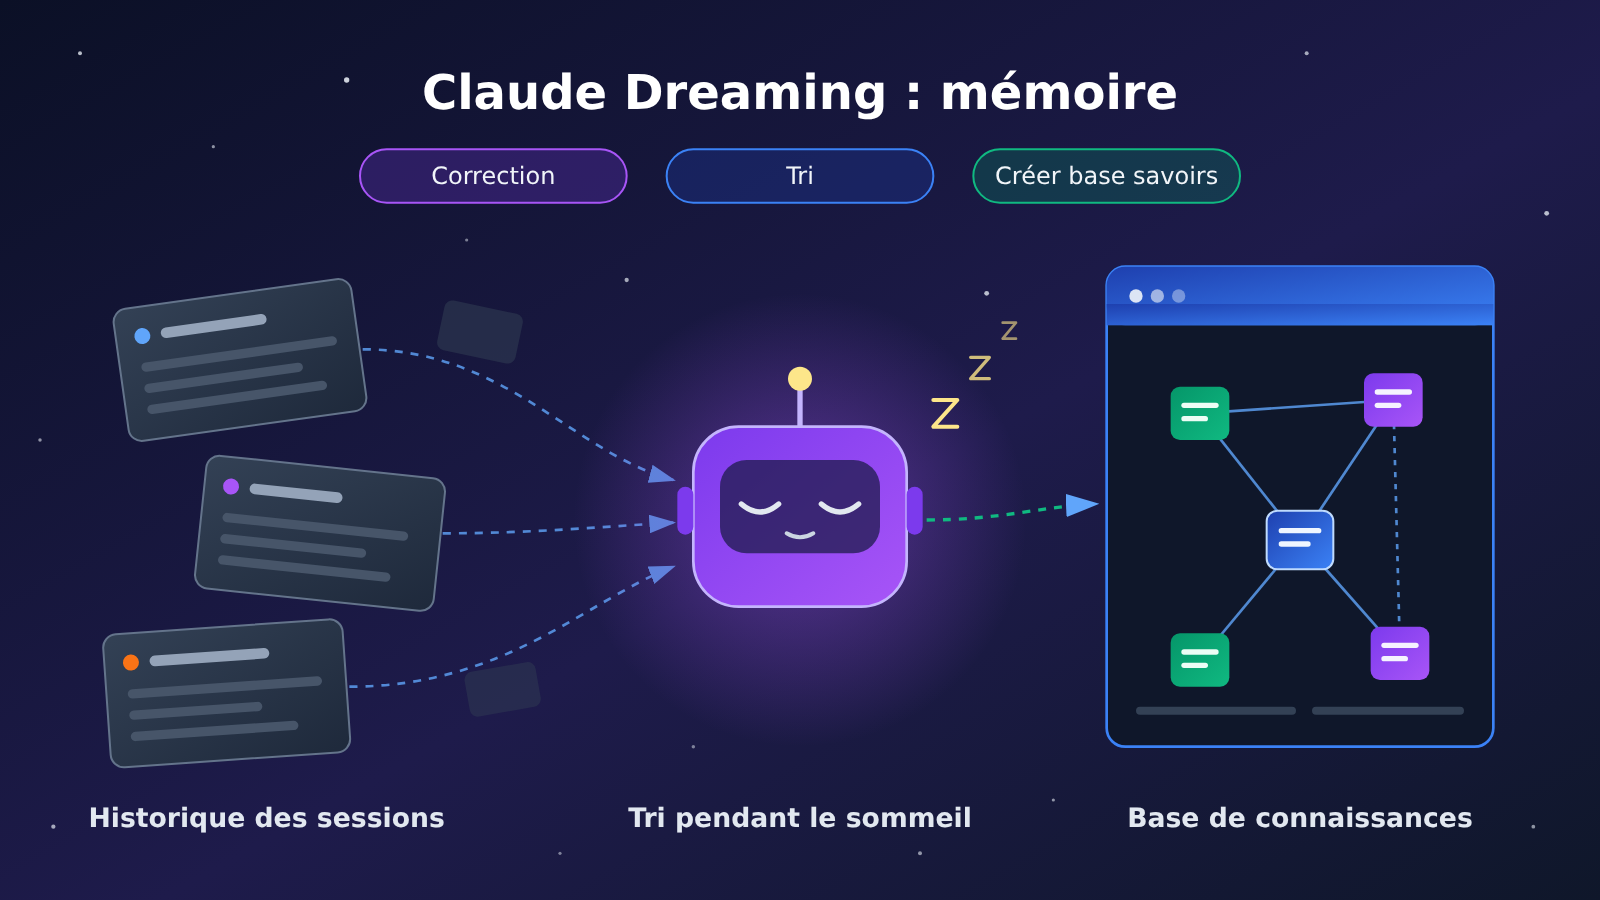
| Concept clé | Dreaming : un processus d’arrière-plan qui réorganise et entretient la mémoire entre les sessions à partir de l’historique |
| Couches de mémoire | 4 couches : Transcripts, Memory notes, Memory representations, Injected context |
| Forme produit | Dreams dans Claude Managed Agents, actuellement en Research Preview, accès sur demande |
| Ressource associée | Cookbook officiel « Dreaming with a dynamic workflow », publié le 2026-11-02 |
| Périmètre d’impact | Agents à longue durée d’exécution, tâches multi-sessions, construction de bases de connaissances internes en entreprise |
Avant de plonger dans Dreaming, posons quelques termes. Un Transcript, c’est l’enregistrement complet d’une session : les entrées de l’utilisateur, les sorties de l’agent, les appels d’outils et leurs résultats. Une Memory Note est un fait, une règle ou un enseignement durable, distillé à partir de l’expérience passée. Le Memory Store est l’espace de stockage persistant où sont conservés les fichiers de mémoire d’une session à l’autre. Dreaming s’inspire du Sleep-time Compute : on exploite la puissance de calcul disponible en dehors des interactions principales pour traiter le contexte existant.
Pourquoi la mémoire d’un agent ne peut pas se limiter à stocker l’historique des conversations
Beaucoup d’équipes qui conçoivent la mémoire d’un agent ont le même premier réflexe : tout enregistrer, puis rechercher dans l’historique au besoin. Le problème, c’est que les journaux d’historique, les résumés de session et les connaissances exploitables sont trois choses différentes. Un journal n’est qu’un empilement d’événements bruts, un résumé peut perdre des détails essentiels, et seules les connaissances vérifiées et bien organisées aident vraiment, de façon fiable, la tâche suivante.
Conserver l’intégralité des conversations entraîne trois risques : les doublons, les informations devenues obsolètes et l’accumulation d’erreurs. Une entrée mal rédigée sera relue session après session, et l’erreur finira par être traitée comme un fait établi. La conclusion d’Anthropic est sans détour : plus de mémoire ne veut pas dire mieux, il faut sélectionner, vérifier et organiser.
L’expérience Pokémon Red illustre très bien cette différence. Vers les 10 000 étapes, Sonnet 3.7 avait créé 413 fichiers et 225 dossiers, pour un seul badge obtenu. Fable 5, lui, n’avait créé que 9 fichiers de mémoire ordinaires, 2 dossiers et un global.md, et avait pourtant décroché 4 badges.
Tout se joue sur « ce qu’on retient ». Sonnet 3.7 sauvegardait massivement un état de jeu en perpétuelle évolution, des notes qui devenaient vite périmées. Fable 5 privilégiait les stratégies, les règles vérifiées et les plans d’action. On en tire un principe de conception : la mémoire à long terme doit surtout conserver les connaissances difficiles à retrouver depuis l’environnement actuel, alors que l’état en temps réel, lisible directement à chaque fois, n’a pas besoin d’être mémorisé.
Les 4 couches de la mémoire de Claude
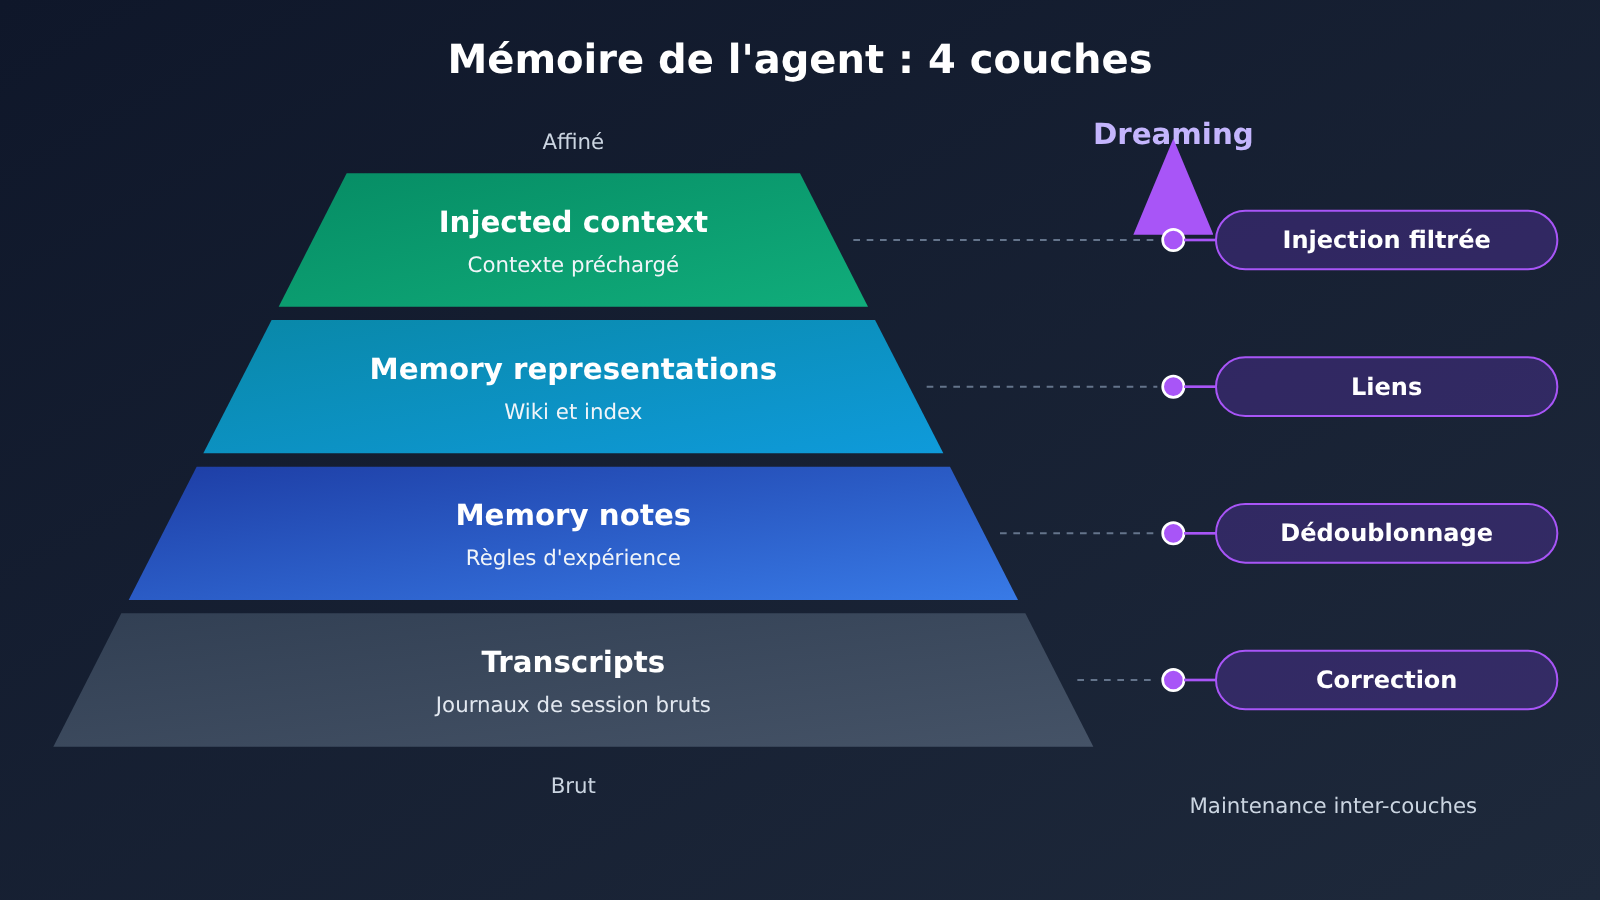
Anthropic découpe la mémoire d’un agent en 4 couches. Chacune a son rôle, sa fréquence d’écriture et son coût de lecture.
| Couche | Contenu | Rôle | Mode de lecture |
|---|---|---|---|
| Transcripts | Enregistrement complet des sessions | Journal d’événements consultable, preuve brute pour retrouver les faits | Recherche à la demande |
| Memory notes | Faits importants, retours d’expérience et règles notés pendant les tâches | Capitaliser les enseignements réutilisables | Lecture à la demande |
| Memory representations | Représentations structurées : wiki, index, liens, etc. | Organiser les relations entre les connaissances et permettre la recherche entre documents | Navigation et recherche |
| Injected context | Un petit nombre de souvenirs à forte valeur | Chargés à l’avance au démarrage d’une nouvelle session | Injection automatique |
Ces 4 couches forment un passage progressif du « brut » au « raffiné ». Le transcript est le plus complet, mais il est volumineux et bruité. L’injected context est le plus condensé : chacune de ses entrées occupe de la place dans la fenêtre de contexte de la nouvelle session, il faut donc le réserver aux informations dont la saillance (Salience) est la plus élevée.
Dreaming joue un rôle de maintenance transversale. Il revient dans les transcripts pour corriger d’anciennes entrées, fusionne les doublons dans les memory notes, construit le wiki et les index, puis décide quels contenus méritent d’être injectés à l’avance au début d’une nouvelle session (Context Injection).
Comment Claude Dreaming corrige les erreurs, organise et construit une base de connaissances
Correction par Dreaming : le cas de navigation à Mt. Moon
Anthropic a documenté une erreur de navigation. Un agent avait mal mémorisé l’emplacement du Pokémon Center près de Mt. Moon, et les sessions suivantes ont continué à retenter la même route erronée.
Après avoir réexaminé les transcriptions historiques, Dreaming a retrouvé l’entrée d’origine qui contenait l’erreur et corrigé le fichier de mémoire. L’agent, équipé de cette mémoire corrigée, est arrivé à Cerulean City à la 1 935ᵉ action. La version sans correction a échoué à plusieurs reprises, en répétant les mêmes erreurs, et n’a finalement jamais atteint son objectif.
Ce cas montre que Dreaming ne se contente pas de faire des résumés. Il sait revenir à l’expérience brute pour vérifier que la mémoire est toujours valide. Les transcriptions conservées acquièrent ainsi un nouvel usage : elles deviennent une base de preuves que l’on peut revérifier à volonté.
Efficacité de la mémoire de Claude : données expérimentales de CL-Bench
Anthropic a testé l’effet de la mémoire sur les tâches de base de données de CL-Bench 1.0. Le tableau ci-dessous reprend le mean reward publié officiellement.
| Modèle | Sans mémoire | Avec mémoire | Gain |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Attention : ces chiffres ne valent que pour cette tâche précise, ce n’est pas un score général de la capacité de mémoire d’un agent. Ce qui est plus intéressant, c’est une tendance : plus un modèle est performant, plus il a tendance à consigner des règles vérifiées, les causes des erreurs et les pièges qu’il pourrait rencontrer plus tard, plutôt que de recopier tel quel l’historique des conversations. Le gain très limité de Sonnet 4.6 montre que l’efficacité d’un système de mémoire dépend étroitement de la « qualité de prise de notes » du modèle lui-même.
Dreaming et construction d’une base de connaissances Wiki
L’expérience la plus ambitieuse portait sur environ 350 000 documents internes, soit près de 420 M de tokens. Anthropic a construit progressivement un wiki de connaissances au fil de 128 sessions Dreaming, puis évalué le résultat avec des tâches de questions-réponses.
| Méthode de recherche | Score | Remarques |
|---|---|---|
| Wiki seul (avant → après construction) | 13 % → 48 % | Gain net une fois le wiki bien structuré |
| Search seul | 53 % | Référence |
| Search + Wiki (avant → après construction) | 54 % → 61 % | Environ 20 000 tokens économisés par question en moyenne |
| Tâches de synthèse multi-fichiers (fusions-acquisitions) | Wiki 87 % vs Search seul 73 % | Avantage le plus marqué pour la synthèse inter-documents |
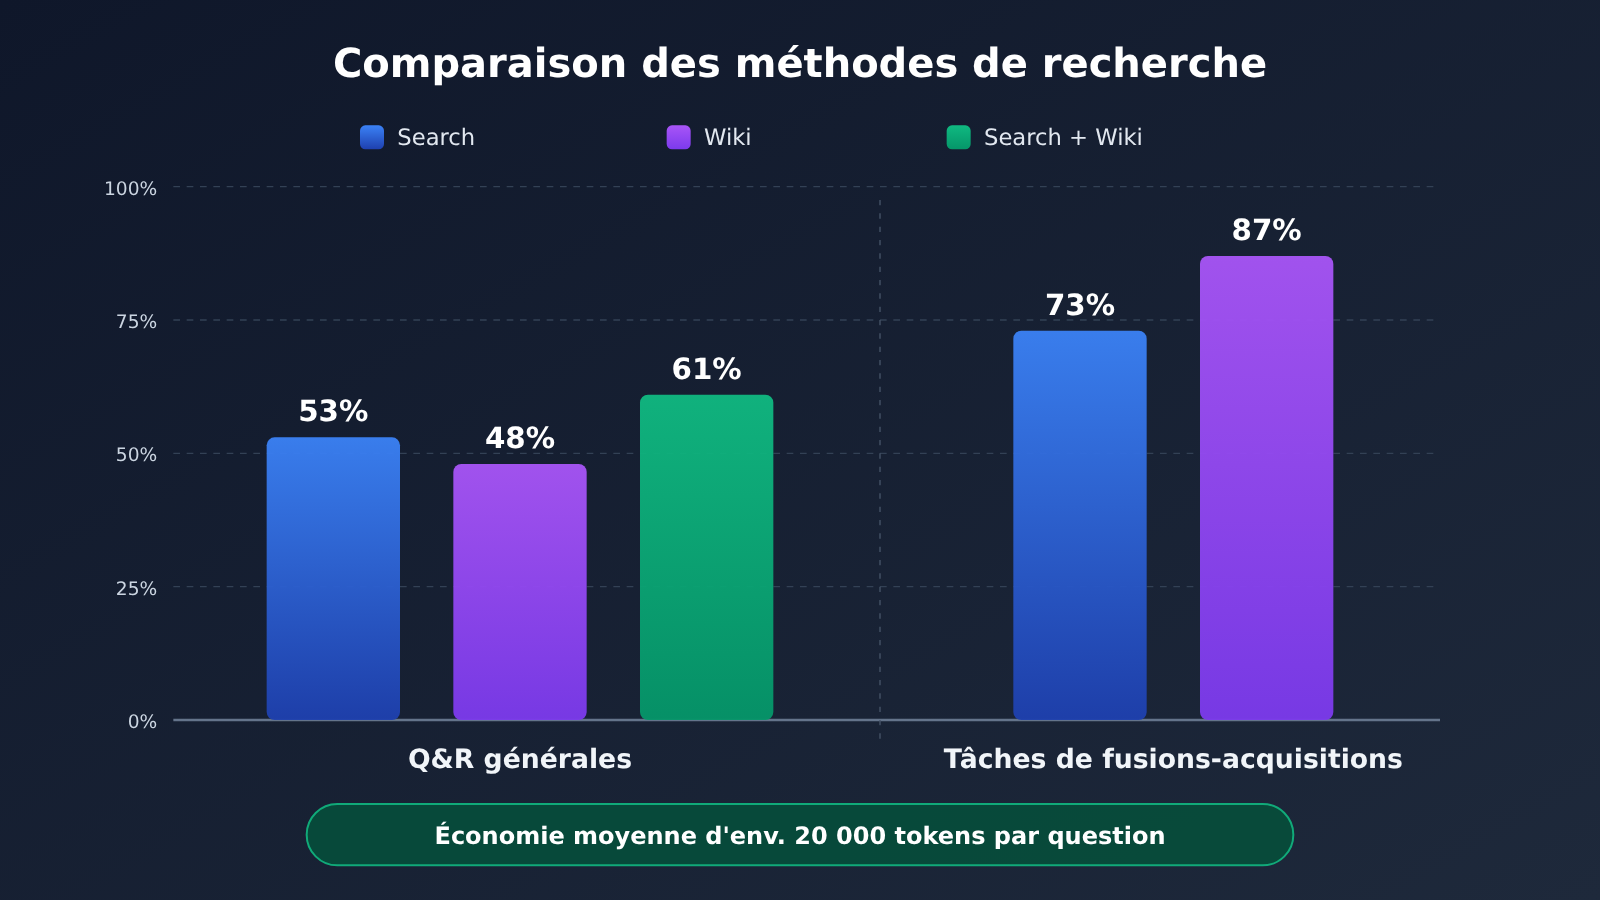
📊 À propos du graphique : toutes ces données proviennent d’expériences publiées sur le blog d’ingénierie d’Anthropic. Si vous voulez faire une petite validation du même genre sur votre propre corpus, vous pouvez appeler les modèles Claude via APIYI (apiyi.com) et comparer deux approches, « recherche seule » et « recherche + wiki organisé », sur les résultats comme sur la consommation de tokens.
La valeur d’une mémoire structurée tient surtout à deux choses. D’abord, la création de liens et d’index permet de synthétiser des informations réparties sur plusieurs fichiers. Ensuite, on réduit la quantité de texte brut à relire à chaque recherche, ce qui fait baisser le coût en tokens.
Analyse d’impact : pourquoi la consolidation de mémoire de Claude Dreaming est parfois utile, parfois nuisible
Anthropic ne présente pas Dreaming comme une solution miracle : l’article donne plusieurs contre-exemples. Pour la pratique d’ingénierie, cette partie est sans doute plus instructive que les chiffres favorables.
5 types de risques d’ingénierie liés à la consolidation de mémoire
- Surenregistrement : comme Sonnet 3.7, qui sauvegarde massivement des états volatils, la mémoire gonfle très vite et devient tout aussi vite obsolète.
- Informations périmées : l’environnement a changé, mais la mémoire reste figée sur l’ancienne version. Sans vérification des sources, elle continue d’induire l’agent en erreur.
- Écrasement lors des écritures partagées : dans l’expérience de consolidation de contrats, plusieurs agents écrivaient en même temps dans le même tableau récapitulatif, et seuls 41 des 57 faits clés ont été conservés, soit environ 72 %. En passant à une page indépendante par contrat, écrite par un seul agent et conservant les clauses d’origine, les 57 faits ont tous été préservés.
- Gonflement du wiki : lors d’un test, les fichiers sources ne pesaient que 115 Ko, mais le wiki généré est monté à 203 Ko. La consolidation a donc fini par produire plus d’information, pas moins.
- Aucun gain sur les tâches simples : quand la réponse se trouve directement dans un seul fichier, le wiki n’apporte pas d’amélioration notable et ne fait qu’alourdir la maintenance.
Ce que cela change pour les développeurs
- Organiser la mémoire en couches : journaux bruts, règles d’expérience, connaissances structurées et contexte préinjecté sont stockés séparément, chacun avec sa propre stratégie d’écriture et de lecture.
- Garantir la traçabilité des sources : chaque élément de mémoire doit pouvoir être relié au Transcript correspondant, condition indispensable pour corriger les erreurs.
- Sérialiser ou partitionner les écritures : évitez que plusieurs agents écrivent en parallèle dans le même fichier, et privilégiez une structure « une entité, une page ».
- Nettoyer régulièrement : le wiki et les Memory notes doivent eux aussi être dédupliqués, fusionnés et purgés, sinon leur taille ne fera qu’augmenter.
Ce que cela change pour le secteur
- Dans la recherche sur la mémoire des agents, l’accent se déplace de « retrouver avec précision » vers « la mémoire elle-même est-elle correcte et entretenue ».
- Le Sleep-time Compute pourrait devenir une architecture courante : on reporte le coût de la consolidation sur les périodes d’inactivité, ce qui allège la charge de contexte pendant l’interaction principale.
- La mémoire structurée convient mieux aux tâches qui s’étendent sur plusieurs fichiers, plusieurs tours et une accumulation à long terme. Pour une simple question ponctuelle, la recherche seule reste l’option la plus économique.
Comment les développeurs peuvent appliquer l’approche Claude Dreaming à leur propre agent
Conditions d’accès à la préversion de recherche des Dreams
D’après la documentation actuelle d’Anthropic, Dreams est une fonctionnalité de Claude Managed Agents, au statut Research Preview : il faut donc demander l’accès. Les appels doivent inclure deux en-têtes bêta : managed-agents-2026-04-01 et dreaming-2026-04-21.
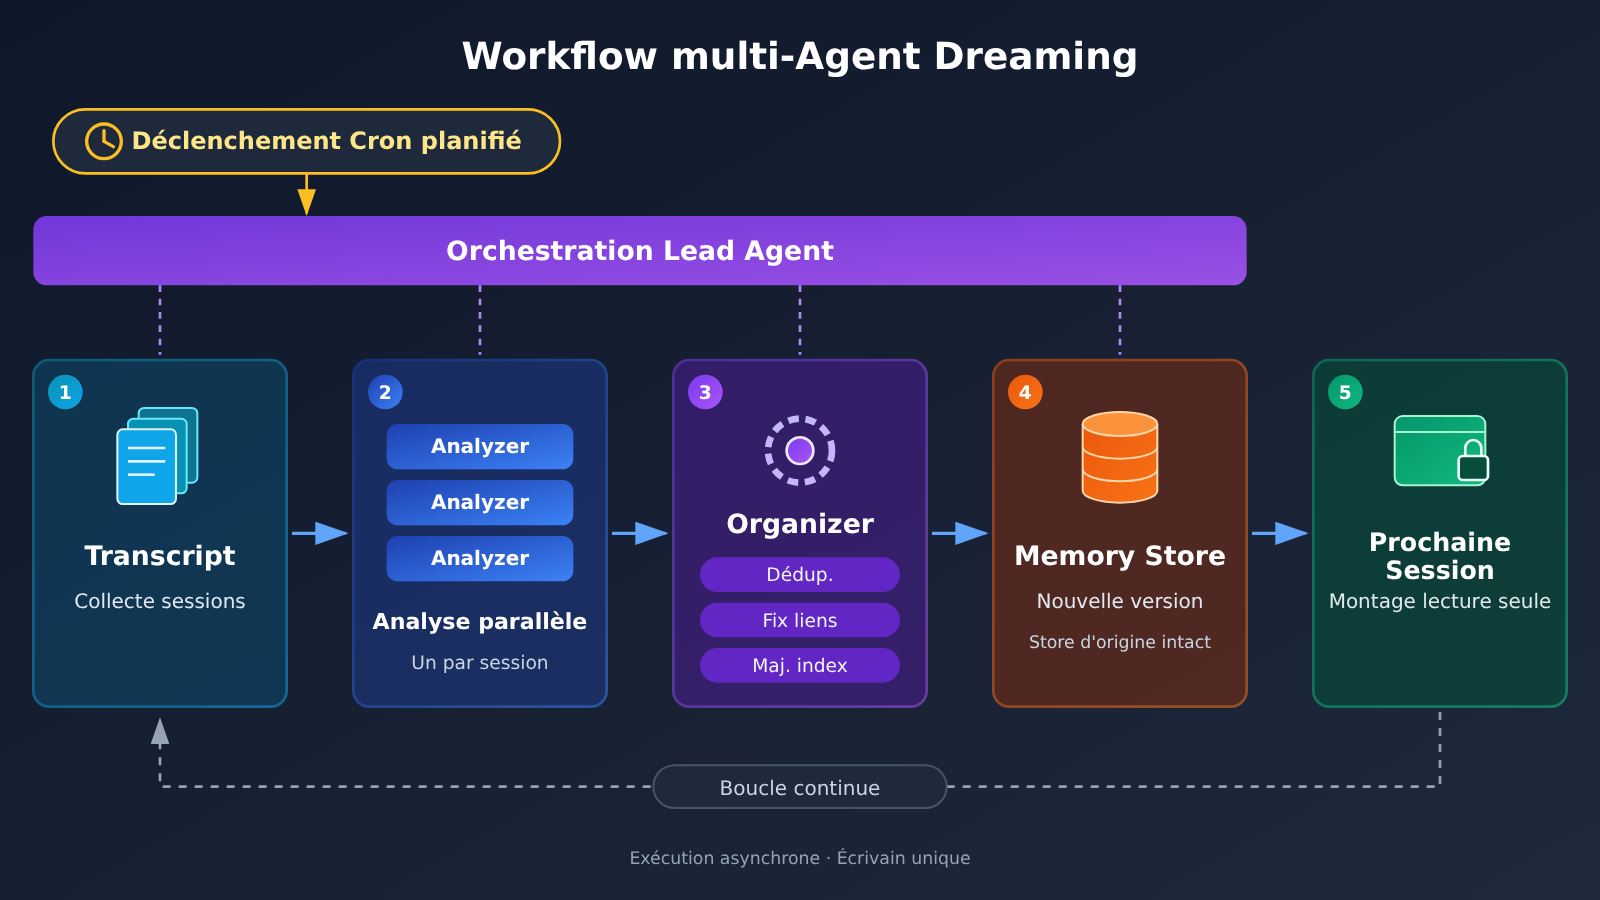
En entrée, il faut un Memory Store existant et entre 1 et 100 sessions passées. En sortie, vous obtenez un nouveau Memory Store, et le Store d’origine n’est jamais modifié. La tâche s’exécute de manière asynchrone, en général de quelques minutes à plusieurs heures, et elle est facturée au tarif standard en tokens du modèle choisi. Les modèles pris en charge sont principalement Opus 5.5 et Sonnet 5.5. Par ailleurs, la fonctionnalité n’est pour l’instant éligible ni au Zero Data Retention ni à HIPAA : évaluez donc ce point avant de traiter des données sensibles.
Conception du workflow dynamique dans le Cookbook
Le Cookbook officiel propose un workflow multi-Agent que vous pouvez monter vous-même. Par défaut, c’est un Lead Agent qui orchestre le processus : chaque Analyzer Agent traite un Transcript, et l’Organizer Agent se charge de dédoublonner, de réparer les liens et de tenir l’index à jour. Le Memory Store ainsi nettoyé est ensuite monté sur la Session suivante, en général en lecture seule. Vous pouvez aussi le déclencher avec un Cron, par exemple pour trier chaque soir les Sessions de la journée écoulée.
Le Cookbook fournit également des exemples de coûts. Pour 11 Transcripts d’exemple (283 Ko au total), comptez environ 2,5 minutes d’exécution et environ 0,36 $. Pour 50 Transcripts longs (environ 12 Mo), avec des réglages optimisés pour le coût, on arrive à environ 8 $ pour une durée d’environ 10 minutes. Ce ne sont que les résultats d’expériences précises, pas des tarifs fixes.
Mettre en place son propre flux de consolidation de la mémoire entre sessions avec les modèles Claude
Une précision d’abord : APIYI propose une interface d’invocation des modèles de la série Claude, ce qui ne veut pas dire qu’il fournit les Managed Agents, les Memory Stores ou l’API Dreams. Cela dit, l’idée centrale de Dreaming (« lire les transcriptions en arrière-plan, extraire les règles validées, puis confier le tout à un unique rédacteur pour la consolidation ») s’implémente très bien avec de simples appels de modèle. Voici un exemple minimal où Claude analyse une transcription de session et produit des souvenirs candidats.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # À remplacer par un modèle Claude disponible dans la liste des modèles
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Voir le code complet (Analyzer + Organizer à écriture unique)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Une page par thème, écrite en série par un seul flux pour éviter les écrasements concurrents
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Peut être déclenché chaque nuit par Cron ; la session suivante charge en lecture seule les pages d'index de memory_store
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Conseil pour démarrer vite : pour votre prototype, vous pouvez utiliser la même clé API sur APIYI (apiyi.com) pour tester différents modèles Claude comme Analyzer et comme Organizer. Comparez quelle combinaison extrait les règles les plus justes avec la consommation de tokens la plus faible, puis décidez de la configuration de production.
Les deux approches se résument dans le tableau suivant :
| Critère | Anthropic Managed Agents Dreams | Consolidation de la mémoire via l’API de modèles (solution maison) |
|---|---|---|
| Accès | Préversion de recherche, accès sur demande et en-tête Beta requis | Appel direct à l’interface des modèles Claude |
| Stockage de la mémoire | Memory Store officiel, produit un nouveau Store | À implémenter vous-même : fichiers, base de données ou Wiki |
| Planification et concurrence | Tâches asynchrones officielles | À implémenter vous-même : Cron, files d’attente et contrôle d’écriture unique |
| Correction et permissions | Intégrées au processus officiel | À concevoir vous-même : vérification des sources et permissions |
| Plateformes disponibles | Anthropic officiel | APIYI apiyi.com (invocation du modèle), API officielle |
FAQ sur Claude Dreaming
Q1 : Qu’est-ce que Claude Dreaming ?
Dreaming est un processus de maintenance de la mémoire en arrière-plan, proposé par Anthropic, qui s’exécute entre les sessions. Il s’appuie sur les transcripts historiques pour corriger les anciennes entrées, fusionner les informations en double, construire un Wiki et des index, puis sélectionner le contexte à forte valeur qu’il faut injecter à l’avance dans les nouvelles sessions.
Q2 : Quelle différence entre Dreaming, un simple résumé de session et la recherche vectorielle ?
Un résumé se contente de compresser l’information, et la recherche vectorielle se contente de la retrouver. Dreaming, lui, retourne aux transcripts d’origine pour vérifier que la mémoire est toujours valable : dans l’exemple de Mt. Moon, par exemple, il a corrigé une indication d’orientation erronée. Il se charge aussi de créer des liens entre les documents : sur les tâches de synthèse multi-fichiers, le Wiki obtient un score de 87 %, contre 73 % pour la recherche seule.
Q3 : Claude Dreaming est-il disponible dès maintenant ?
L’article d’ingénierie correspondant a été publié le 6 novembre 2026. Dreams est actuellement proposé en préversion de recherche (Research Preview) dans Claude Managed Agents : il faut demander l’accès et ajouter deux en-têtes Beta pour pouvoir l’appeler.
Q4 : Sans accès à Managed Agents, peut-on s’inspirer de l’approche Dreaming ?
Oui. En suivant le flux « collecte des transcripts, analyse en arrière-plan, consolidation à écriture unique, montage en lecture seule, maintenance périodique », vous pouvez bâtir une version simplifiée avec de simples invocations du modèle. Via APIYI apiyi.com, vous pouvez appeler les modèles Claude avec une interface compatible OpenAI pour réaliser l’analyse et la consolidation. En revanche, le stockage, la planification et les permissions restent à votre charge.
Q5 : APIYI propose-t-il directement la fonctionnalité Claude Dreaming ?
Non. APIYI apiyi.com fournit des interfaces d’invocation pour des modèles comme Claude, mais n’inclut ni les Managed Agents, ni les Memory Stores, ni l’API Dreams d’Anthropic. C’est un bon choix pour appeler les modèles et construire son propre flux de consolidation de la mémoire, et les nouveaux utilisateurs peuvent d’abord valider leur approche avec le crédit de test gratuit.
Q6 : Quelles sont les limites connues de Dreaming ?
Pour les questions simples auxquelles un seul fichier suffit à répondre, le Wiki n’apporte pas de gain notable. La consolidation peut aussi faire gonfler le volume : par exemple, 115 Ko de texte d’origine ont produit un Wiki de 203 Ko. Quand plusieurs agents écrivent en parallèle dans un espace partagé, des faits se perdent. Enfin, les Dreams officiels ne sont pas encore éligibles à la ZDR ni à HIPAA, et la durée des tâches varie de quelques minutes à plusieurs heures.
Claude Dreaming : l’essentiel à retenir
- La mémoire ne se résume pas au stockage : conserver toutes les conversations finit par accumuler des doublons, des informations périmées et des erreurs. Il faut donc les vérifier et les organiser.
- Une mémoire à 4 niveaux : Transcripts, Memory notes, Memory representations et Injected context ont chacun leur rôle.
- La correction d’erreurs repose sur les enregistrements d’origine : Dreaming retourne vérifier dans le Transcript et a ainsi corrigé une erreur d’orientation qui provoquait des échecs en boucle.
- Le Wiki excelle sur les tâches transverses à plusieurs documents : sur la tâche de fusions-acquisitions, le Wiki obtient 87 % contre 73 % pour la recherche seule, avec une économie moyenne d’environ 20 000 tokens par question.
- L’organisation a aussi ses effets secondaires : les écritures concurrentes font perdre des faits, le Wiki a tendance à gonfler, et les tâches simples n’en ont pas besoin.
- Le faire soi-même est possible : en invoquant les modèles Claude via APIYI (apiyi.com), vous pouvez mettre en place une version simplifiée de la consolidation de mémoire entre sessions.
Conclusion
Claude Dreaming nous apprend trois choses principales :
- L’essentiel de la mémoire à long terme, c’est sa maintenance : seule une mémoire vérifiée, dédoublonnée et organisée aide vraiment lors de la tâche suivante.
- Ce qu’on retient compte plus que la quantité : privilégiez les règles, les causes d’erreur et les pièges difficiles à retrouver dans l’environnement, et évitez de consigner des états qui changent vite.
- La mémoire structurée dépend du contexte : pour les tâches qui touchent plusieurs fichiers, s’étalent sur plusieurs tours et s’accumulent dans la durée, le Wiki vaut le coup. Pour de simples tâches de recherche, inutile d’alourdir la maintenance.
Si votre agent tourne déjà sur plusieurs sessions, vous pouvez commencer par la boucle minimale : « conserver les Transcripts, lancer une consolidation en série chaque nuit, monter la page d’index en lecture seule ». Pour valider rapidement ce fonctionnement, nous vous recommandons d’invoquer les modèles Claude via APIYI (apiyi.com) : la plateforme propose une interface compatible OpenAI et un crédit de test gratuit pour les nouveaux utilisateurs.
📚 Références
- The components of agent memory : article original du blog d’ingénierie d’Anthropic, qui présente la structure de mémoire à 4 couches et l’expérience Dreaming
- Lien :
anthropic.com/research/components-of-agent-memory -
Précisions : source d’origine des données expérimentales (CL-Bench, Pokémon, Wiki, organisation de contrats, etc.)
-
Dreaming with a dynamic workflow : Cookbook officiel de Claude
- Lien :
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Précisions : exemple de workflow multi-agents (Lead, Analyzer, Organizer) avec des repères de coût
-
Publication officielle d’Anthropic sur X : annonce de la sortie du billet d’ingénierie sur Dreaming
- Lien :
x.com/AnthropicAI/status/2118814753154064501 - Précisions : confirme la date de publication et le positionnement officiel
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Vous trouverez plus de ressources dans le centre de documentation : docs.apiyi.com


