
От автора: разбираем механизм Claude Dreaming, о котором Anthropic рассказала в инженерном блоге. В статье: 4-слойная структура памяти, данные экспериментов CL-Bench и Wiki, примеры исправления ошибок и инженерные риски. А ещё покажем, как разработчику перенять идею «наведения порядка в памяти между сессиями» и собрать собственную систему памяти для Агента.
6 ноября 2026 года Anthropic опубликовала в инженерном блоге статью The components of agent memory. Впервые в ней системно описано, как Claude Dreaming исправляет ошибки, наводит порядок в памяти и строит базу знаний между сессиями. Официальный аккаунт в X выложил статью одновременно с блогом, а в документации Claude Managed Agents уже появился интерфейс Dreams в режиме research preview.
Это не очередная концепция в духе «прикрутим к Агенту векторную базу». На серии экспериментов Anthropic показывает: долгоживущему Агенту мало просто хранить историю. Память нужно постоянно проверять, исправлять, объединять и организовывать, и только тогда старая информация реально помогает в следующей задаче.
Что вы получите: после прочтения вы узнаете, как устроена 4-слойная память Claude Dreaming, и увидите ключевые цифры из экспериментов. Поймёте, когда этот подход работает, а когда вредит, и как перенять его в собственном Агенте.
Claude Dreaming: ключевая информация
| Параметр | Подробности |
|---|---|
| Дата публикации | 2026-11-06, блог Anthropic Engineering |
| Основная идея | Dreaming — фоновый процесс, который между сессиями использует историю взаимодействий, чтобы заново организовывать и поддерживать память |
| Уровни памяти | 4 уровня: Transcripts, Memory notes, Memory representations, Injected context |
| Формат продукта | Dreams в Claude Managed Agents; сейчас Research Preview, доступ по заявке |
| Сопутствующие материалы | Официальный Cookbook «Dreaming with a dynamic workflow», опубликован 2026-11-02 |
| Для кого актуально | Долгоживущие агенты, задачи на несколько сессий, построение внутренних корпоративных баз знаний |
Прежде чем разбираться с Dreaming, определим несколько терминов. Transcript — полная запись сессии: ввод пользователя, ответы агента, вызовы инструментов и их результаты. Memory Note — устойчивые факты, правила и опыт, извлечённые из прошлых взаимодействий. Memory Store — постоянное хранилище, где файлы памяти сохраняются между сессиями. Идея Dreaming похожа на Sleep-time Compute: свободные вычислительные ресурсы используются не во время основного взаимодействия, а для обработки уже накопленного контекста.
Почему памяти агента недостаточно просто хранить историю диалогов
Первая реакция многих команд, когда они делают память для агента: сохранить все диалоги и искать по ним, когда понадобится. Но история логов, краткие саммари сессий и знания, по которым можно искать, — это три разные вещи. Лог — просто куча сырых событий. В саммари могут потеряться важные детали. И только проверенные, организованные знания надёжно помогают в следующей задаче.
Если сохранять диалоги целиком, возникают три проблемы: дублирование информации, устаревание прежних состояний и накопление ошибок. Неверная запись будет снова и снова считываться в последующих сессиях, и ошибка превратится в «факт», по которому агент продолжит действовать. Вывод Anthropic однозначен: память — это не «чем больше, тем лучше»; её нужно отбирать, проверять и организовывать.
Эксперимент с Pokémon Red хорошо показывает эту разницу. Примерно за 10 000 шагов Sonnet 3.7 создал 413 файлов и 225 папок, но получил всего 1 значок. Fable 5 создал лишь 9 обычных файлов памяти, 2 папки и один global.md — и получил 4 значка.
Всё упирается в то, что именно запоминать. Sonnet 3.7 сохранял массу постоянно меняющихся данных о состоянии игры, и эти записи быстро устаревали. Fable 5 больше внимания уделял стратегиям, проверенным правилам и планам действий. Отсюда принцип проектирования: в долговременной памяти стоит в первую очередь хранить знания, которые трудно заново получить из текущего окружения. Живое состояние, которое можно прочитать напрямую каждый раз, запоминать не нужно.
Четыре уровня системы памяти Claude
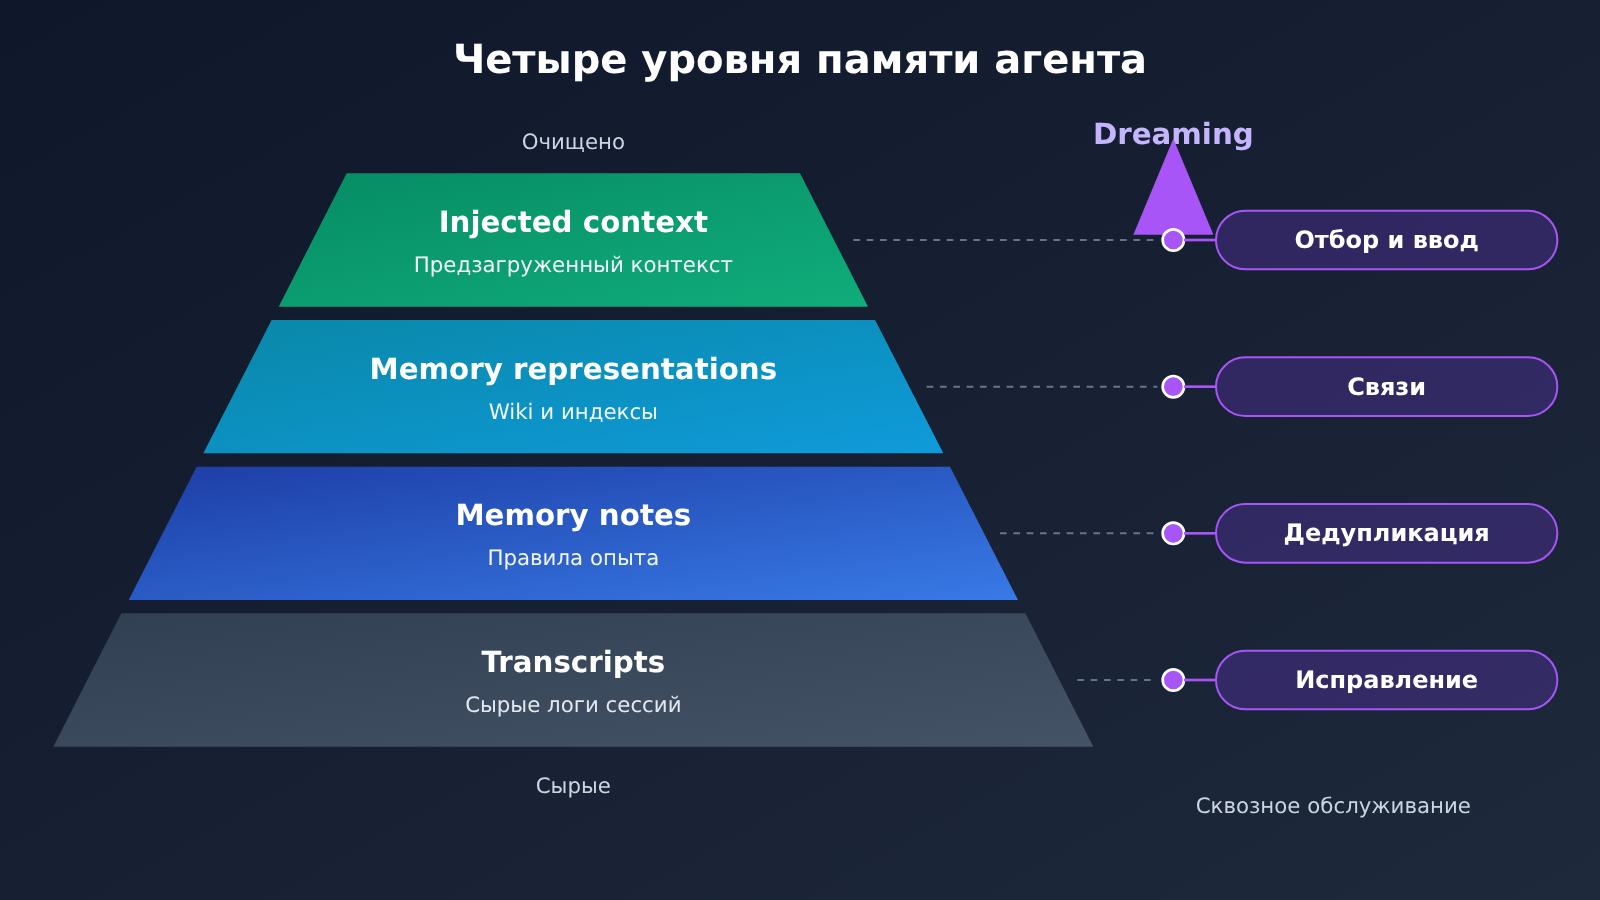
Anthropic делит память агента на 4 уровня. У каждого — своя зона ответственности, своя частота записи и своя стоимость чтения.
| Уровень | Что внутри | Зачем нужен | Как читается |
|---|---|---|---|
| Transcripts | Полная запись сессии | Журнал событий с поиском — первоисточник, к которому возвращаются за фактами | Поиск по запросу |
| Memory notes | Важные факты, выводы и правила, записанные по ходу задачи | Накопление опыта, который можно переиспользовать | Чтение по запросу |
| Memory representations | Структурированные формы: Wiki, индексы, ссылки | Выстраивает связи между знаниями, позволяет искать по разным документам | Навигация и поиск |
| Injected context | Немного самых ценных воспоминаний | Загружается заранее при старте новой сессии | Автоматическая инъекция |
Эти 4 уровня — путь от «сырого» к «отжатому». В Transcript информации больше всего, но объём там огромный и шума хватает. Injected context — самый отжатый уровень, только вот каждая его запись съедает контекстное окно новой сессии, поэтому туда попадает лишь то, у чего значимость (salience) максимальная.
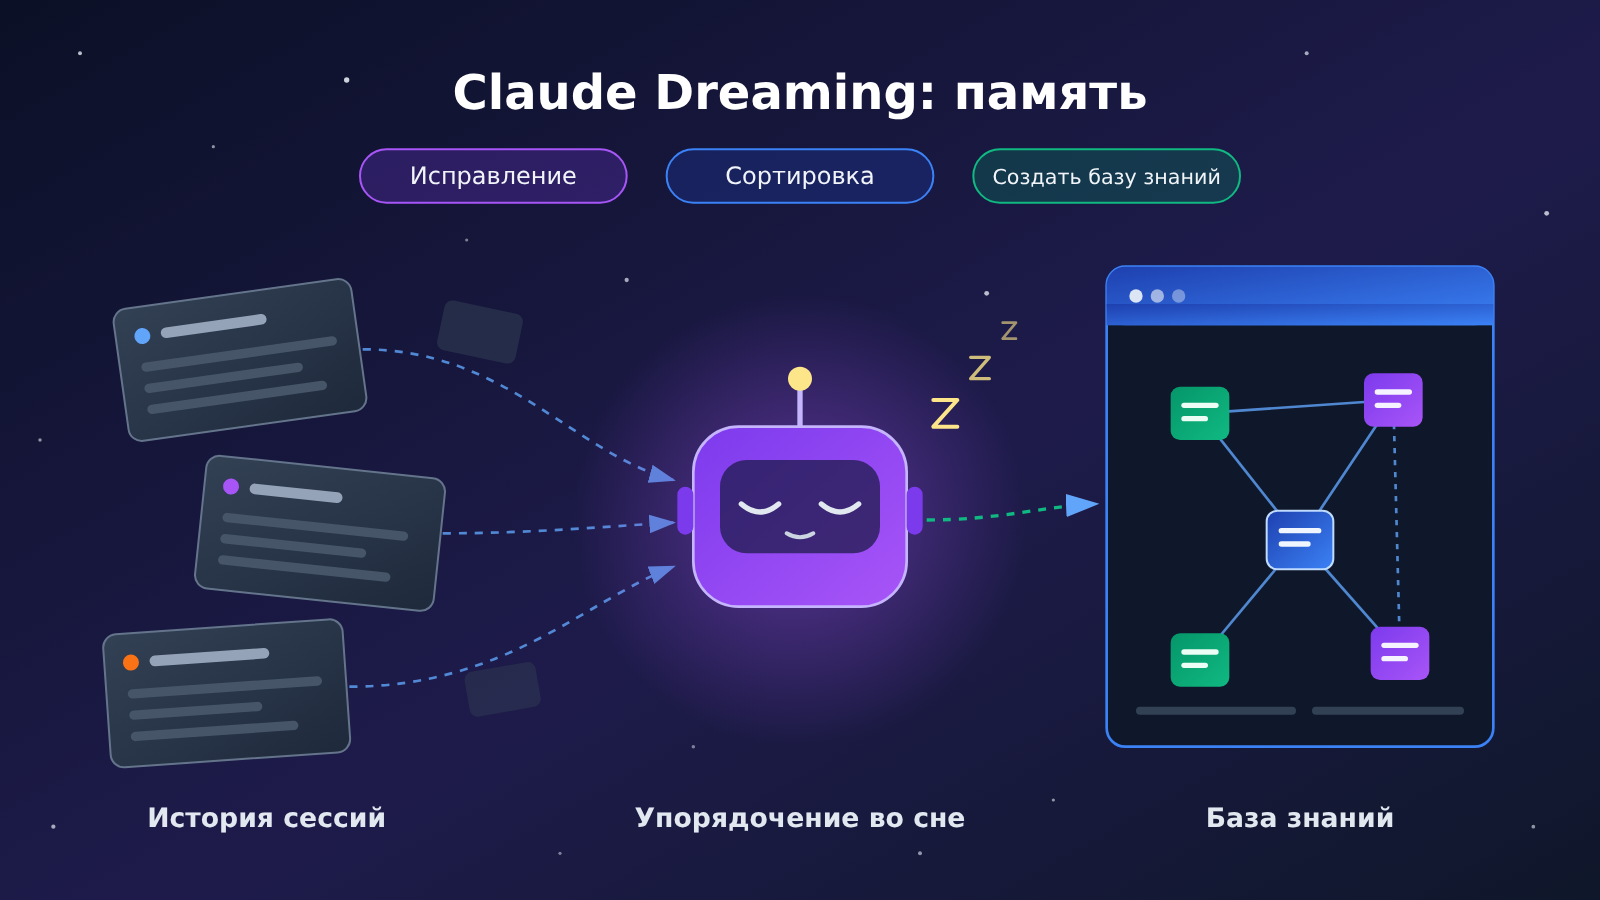
Роль Dreaming — обслуживать всё это сквозь уровни. Он возвращается в Transcript, чтобы поправить старые записи, сливает дубли в Memory notes, строит Wiki и индексы и решает, что стоит заранее подгружать в начале новой сессии (Context Injection).
Как Claude Dreaming исправляет ошибки, наводит порядок и строит базу знаний
Исправление ошибок в Dreaming: случай с навигацией у Mt. Moon
Anthropic описывала один случай с ошибкой навигации. Агент неправильно запомнил, где находится Pokémon Center рядом с Mt. Moon, и в следующих сессиях раз за разом шёл по ошибочному маршруту.
Dreaming заново проверил историю транскриптов, нашёл ту самую исходную неверную запись и исправил файл памяти. Агент с исправленной памятью добрался до Cerulean City на 1 935-м действии. Версия без исправления ошибок снова и снова терпела неудачу и в итоге так и не выполнила задачу.
Этот случай показывает, что Dreaming не сводится к составлению сводок. Он умеет возвращаться к исходному опыту и проверять, остаётся ли запись в памяти верной. Благодаря этому сохранённые транскрипты получили новое применение: теперь это база доказательств, к которой можно обращаться снова и снова
Эффект памяти Claude: экспериментальные данные CL-Bench
Anthropic проверила, как память влияет на результат, на задачах с базами данных из CL-Bench 1.0. В таблице ниже приведён mean reward из официального отчёта.
| Модель | Без памяти | С памятью | Прирост |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Важная оговорка: эти цифры относятся только к этой конкретной задаче и не являются универсальной оценкой памяти агента. Куда интереснее другая закономерность: чем сильнее модель, тем охотнее она записывает проверенные правила, причины ошибок и ловушки, с которыми можно столкнуться в будущем, а не просто копирует историю диалогов. У Sonnet 4.6 прирост совсем небольшой. Получается, что эффективность системы памяти тесно связана с тем, насколько качественно сама модель ведёт записи.
Эффективность Dreaming при построении Wiki-базы знаний
Самый масштабный эксперимент проводили на примерно 350 000 внутренних документов общим объёмом около 420M токенов. Anthropic за 128 сессий Dreaming постепенно собрала из них Wiki-базу знаний, а затем оценила результат на задачах вопросов и ответов.
| Способ поиска | Оценка | Примечание |
|---|---|---|
| Только Wiki (до построения → после) | 13% → 48% | По мере формирования Wiki качество заметно растёт |
| Только Search | 53% | Базовый уровень |
| Search + Wiki (до построения → после) | 54% → 61% | В среднем экономия около 20 000 токенов на вопрос |
| Задачи по сделкам слияния и поглощения, требующие синтеза из нескольких файлов | Wiki 87% vs чистый Search 73% | Преимущество в синтезе по нескольким документам видно лучше всего |
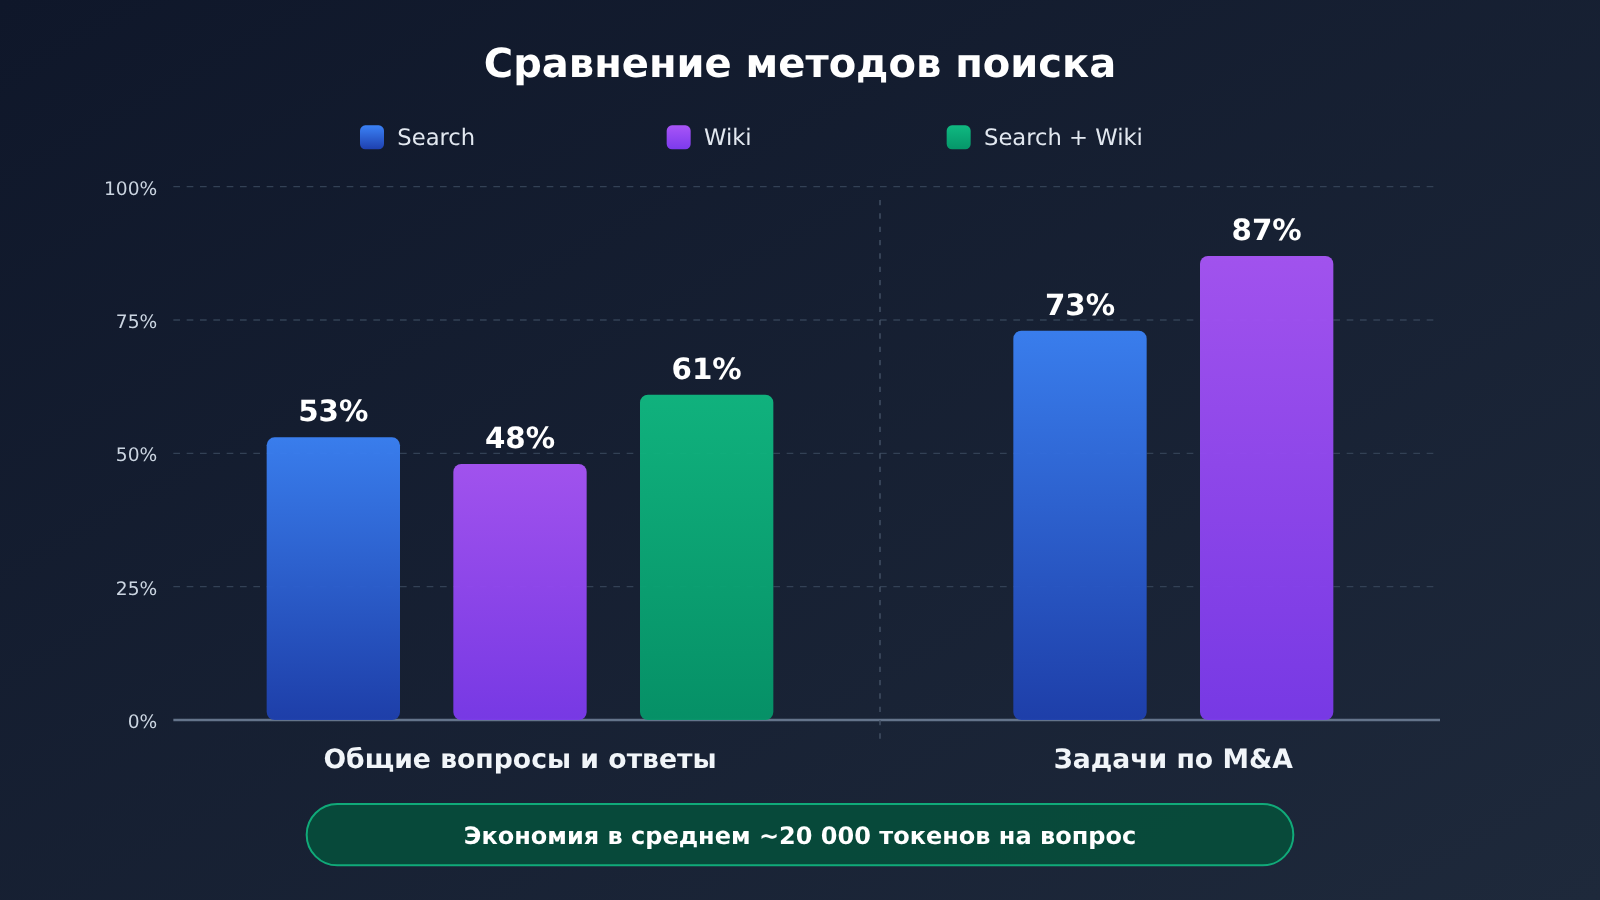
📊 Пояснение к диаграмме: все приведённые данные взяты из публичных экспериментов, описанных в инженерном блоге Anthropic. Если хотите провести похожую небольшую проверку на собственном корпусе, можно вызывать модели Claude через APIYI (apiyi.com) и сравнить два подхода: «чистый поиск» и «поиск + подготовленная Wiki» — как по качеству, так и по расходу токенов.
Ценность структурированной памяти сводится к двум вещам. Во-первых, ссылки и индексы позволяют собирать воедино информацию из многих файлов. Во-вторых, при каждом поиске не нужно заново перечитывать столько исходного текста, а значит, снижается стоимость в токенах.
Анализ влияния: почему консолидация памяти в Claude Dreaming иногда работает, а иногда вредит
Anthropic не подаёт Dreaming как универсальное решение — в статье приведено несколько контрпримеров. Для инженерной практики эта часть, пожалуй, ценнее, чем положительные результаты.
5 типов инженерных рисков при консолидации памяти
- Избыточная запись: когда в память сваливают много быстро меняющегося состояния, как это было у Sonnet 3.7, она раздувается очень быстро — и так же быстро устаревает.
- Устаревание информации: окружение изменилось, а память осталась на старой версии; без сверки с источником она продолжает вводить агента в заблуждение.
- Перезапись при совместном доступе: в эксперименте с обработкой договоров несколько агентов писали одновременно в одну сводную таблицу, и из 57 ключевых фактов уцелел лишь 41 — около 72%. После того как каждому договору выделили отдельную страницу, запись вёл один агент и исходные пункты сохранялись, в итоге сохранились все 57 фактов.
- Раздувание объёма Wiki: в одном из тестов исходный файл занимал всего 115 КБ, а сгенерированная Wiki разрослась до 203 КБ — то есть в результате «уплотнения» информации стало больше.
- Нет выгоды на простых задачах: если ответ находится прямым поиском в одном файле, Wiki не даёт заметного выигрыша — только добавляет расходы на поддержку.
Что это значит для разработчиков
- Память нужно разделять на уровни: сырые логи, эмпирические правила, структурированные знания и заранее подставленный контекст хранятся отдельно, и у каждого слоя свои стратегии записи и чтения.
- Источник должен быть прослеживаемым: каждый фрагмент памяти должен отсылать к соответствующей расшифровке (Transcript) — без этого ошибку не исправить.
- Запись нужно сериализовать или разделять по разделам: не допускайте, чтобы несколько агентов одновременно писали в один файл; лучше сразу брать структуру «одна сущность — одна страница».
- Регулярная чистка: Wiki и заметки памяти (Memory notes) тоже нужно дедуплицировать, объединять и выбрасывать лишнее, иначе объём будет только расти.
Что это значит для отрасли
- Центр тяжести исследований памяти агентов смещается с «точности поиска» на «правильность самой памяти и её поддержку в рабочем состоянии».
- Sleep-time Compute, вероятно, станет обычной частью архитектуры: работа по упорядочиванию уходит в простои, а нагрузка на контекст во время основного взаимодействия снижается.
- Структурированная память лучше подходит для задач, растянутых на много файлов, много раундов и долгое накопление. Для разовых простых вопросов чистый поиск по-прежнему экономнее.
Как разработчику перенести подход Claude Dreaming в собственного агента
Условия использования официального исследовательского превью Dreams
Согласно текущей документации Anthropic, Dreams — это функциональность Claude Managed Agents со статусом Research Preview; для доступа нужно подать заявку. При вызове необходимо передавать два бета-заголовка: managed-agents-2026-04-01 и dreaming-2026-04-21.
На вход подаётся уже существующий Memory Store плюс от 1 до 100 прошлых сессий (Session), а на выходе получается новый Memory Store — исходный при этом не изменяется. Задача выполняется асинхронно, обычно занимает от нескольких минут до нескольких часов и тарифицируется по стандартной цене токенов выбранной модели. Основные поддерживаемые модели — Opus 5.5 и Sonnet 5.5. Кроме того, сейчас функция не даёт гарантий Zero Data Retention и не подходит для сценариев HIPAA, так что перед обработкой чувствительных данных стоит всё взвесить.
Динамический воркфлоу из Cookbook
В официальном Cookbook описан многоагентный воркфлоу, который можно собрать самостоятельно. По умолчанию процессом управляет Lead Agent: каждый Analyzer Agent обрабатывает один Transcript, а Organizer Agent убирает дубликаты, чинит ссылки и поддерживает индекс. Готовое хранилище Memory Store подключается к следующей Session, обычно в режиме только для чтения. Можно также запускать всё по расписанию через Cron — например, каждую ночь разбирать Session за прошедшие сутки.
В Cookbook есть и примеры затрат. 11 тестовых Transcript общим объёмом 283 КБ обработались примерно за 2,5 минуты и обошлись около $0,36. 50 длинных Transcript объёмом около 12 МБ при настройках, оптимизированных по стоимости, стоили порядка $8 и обрабатывались около 10 минут. Это результаты конкретных экспериментов, а не фиксированные тарифы.
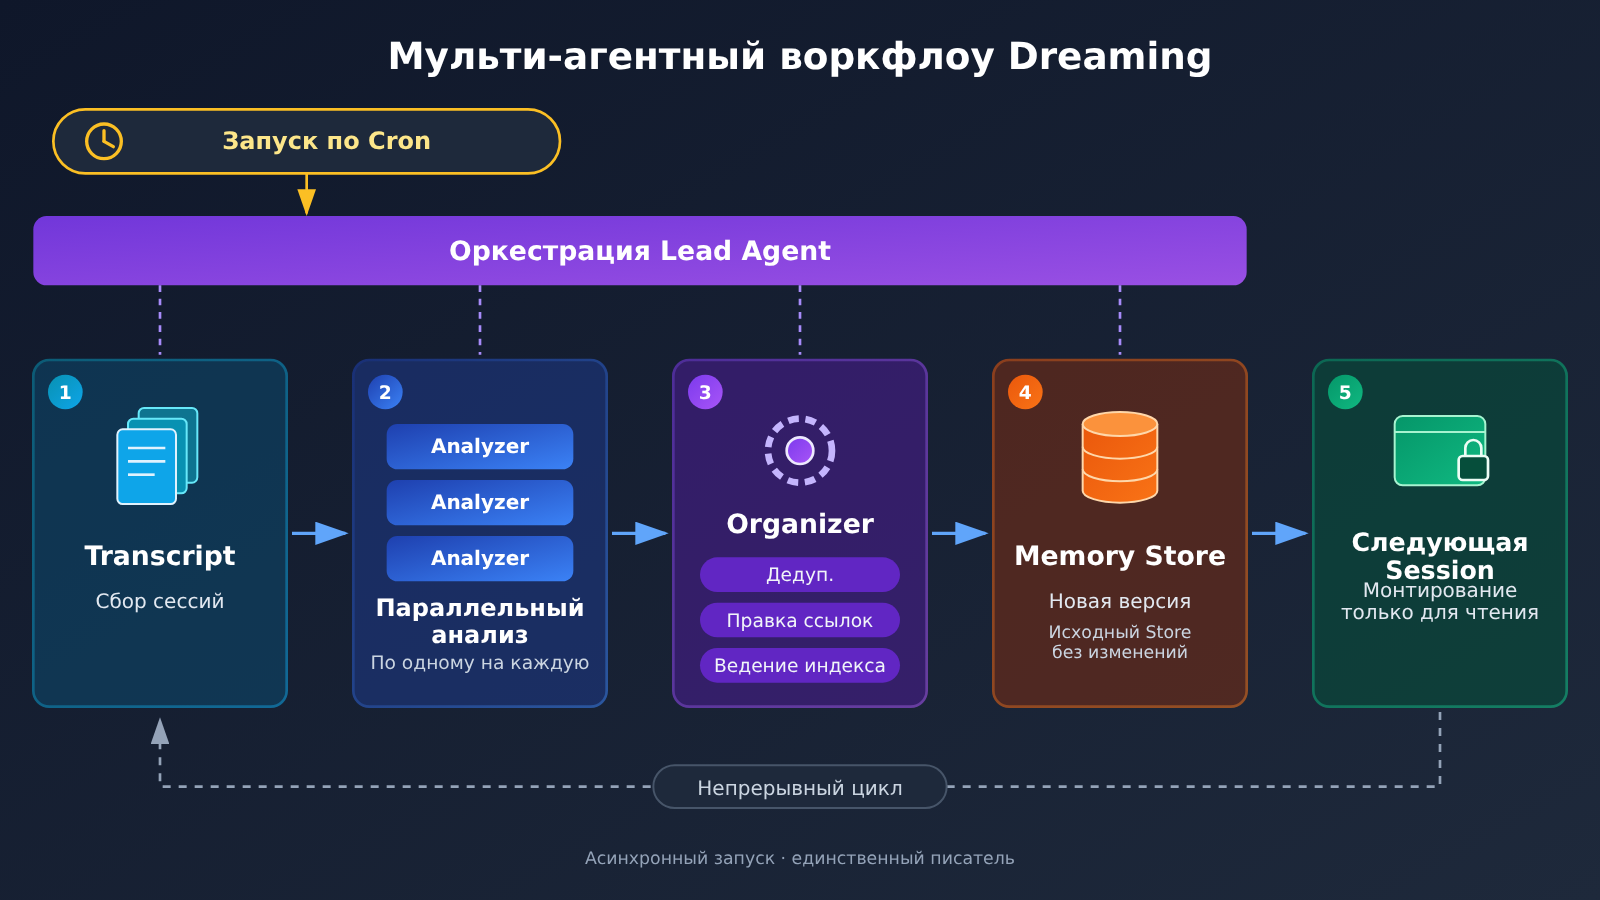
Собираем собственный процесс консолидации памяти между сессиями на моделях Claude
Сразу уточню: APIYI предоставляет интерфейс для вызова моделей серии Claude, но не Managed Agents, Memory Stores или Dreams API. Тем не менее основную идею Dreaming можно реализовать обычными вызовами модели. Она состоит в том, чтобы в фоне читать транскрипты, извлекать проверенные правила и передавать их на обработку единственному «писателю». Ниже минимальный пример: Claude анализирует запись сессии и выдаёт кандидатов в память.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # замените на доступную модель Claude из списка моделей
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Полный код реализации (Analyzer + Organizer с единственной записью)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Одна тема — одна страница, запись выполняет единый процесс последовательно, чтобы избежать перезаписи при параллельном доступе
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Можно запускать по Cron каждую ночь; следующая сессия только читает индексные страницы из memory_store
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Рекомендация для быстрого старта: когда собираете прототип, через APIYI (apiyi.com) можно с одним и тем же API-ключом протестировать разные модели Claude в ролях Analyzer и Organizer. Сравните, какая комбинация точнее выделяет правила и тратит меньше токенов, и только потом решайте, какую конфигурацию брать в продакшен.
Различия между двумя подходами можно коротко свести в таблицу:
| Критерий | Anthropic Managed Agents Dreams | Самостоятельная организация памяти на базе API моделей |
|---|---|---|
| Как получить доступ | Research preview: нужна заявка на доступ и Beta-заголовок | Прямой вызов API моделей Claude |
| Хранение памяти | Официальный Memory Store, на выходе создаётся новый Store | Файлы, база данных или вики: реализуете сами |
| Планирование и параллельность | Официальные асинхронные задачи | Cron, очереди и контроль единственного писателя: реализуете сами |
| Исправление ошибок и права доступа | Встроено в официальный процесс | Проверку источников и права доступа нужно проектировать самостоятельно |
| Доступные платформы | Официальная платформа Anthropic | APIYI (apiyi.com) для вызова моделей, официальный API |
Claude Dreaming — частые вопросы (FAQ)
Q1: Что такое Claude Dreaming?
Dreaming — это предложенный Anthropic фоновый процесс поддержания памяти между сессиями. Он работает с историческими Transcript: исправляет старые записи, объединяет дублирующуюся информацию, строит Wiki и индексы, а также отбирает контекст высокой ценности, который нужно заранее подгрузить в новую сессию.
Q2: Чем Dreaming отличается от обычного пересказа сессии и векторного поиска?
Пересказ только сжимает информацию, поиск только находит её. Dreaming же возвращается к исходному Transcript и проверяет, действительно ли воспоминание всё ещё верно, — например, в кейсе Mt. Moon он исправил неверное направление. Кроме того, он выстраивает связи между документами: на задачах со сквозным анализом нескольких файлов Wiki набирает 87%, а чистый поиск — 73%.
Q3: Claude Dreaming уже доступен?
Инженерный блог с описанием вышел 6 ноября 2026 года. Сейчас Dreams доступен в виде Research Preview внутри Claude Managed Agents: нужно подать заявку на доступ и передать два Beta Header, чтобы его вызвать.
Q4: Можно ли перенять идею Dreaming без доступа к Managed Agents?
Да. Если выстроить процесс «сбор Transcript → фоновая аналитика → консолидация с единственным писателем → монтирование только для чтения → регулярное обслуживание», упрощённую версию можно собрать на обычных вызовах модели. Через APIYI apiyi.com можно вызывать модели Claude по OpenAI-совместимому интерфейсу для анализа и консолидации. Хранилище, планировщик и права доступа придётся реализовать самостоятельно.
Q5: Предоставляет ли APIYI функцию Claude Dreaming напрямую?
Нет. APIYI apiyi.com даёт интерфейс для вызова моделей, включая Claude, но не включает Managed Agents, Memory Stores или Dreams API от Anthropic. Сервис подходит, чтобы вызывать модели и строить собственный процесс консолидации памяти; новички могут сначала проверить схему на бесплатном тестовом лимите.
Q6: Какие известные ограничения есть у Dreaming?
Для простых вопросов, на которые можно ответить по одному файлу, Wiki не даёт заметного выигрыша. Консолидация может раздувать объём: например, из исходных 115 КБ получилось 203 КБ Wiki. При совместной записи нескольких агентов факты теряются. Официальный Dreams пока не имеет статуса ZDR и соответствия HIPAA, а выполнение задачи занимает от нескольких минут до нескольких часов.
Claude Dreaming: ключевые выводы (Key Takeaways)
- Память — это не только хранилище: если сохранять все диалоги подряд, накопятся дубликаты, устаревшие и ошибочные данные. Их нужно проверять и упорядочивать.
- Четыре уровня памяти: Transcripts, Memory notes, Memory representations и Injected context — у каждого своя роль.
- Исправление ошибок опирается на исходные записи: Dreaming возвращается к Transcript и сверяется с ним. Так удалось исправить неверное указание местоположения, из-за которого агент раз за разом терпел неудачу.
- Wiki хорошо работает в задачах, где нужно связывать несколько документов: в задаче по слияниям и поглощениям Wiki набрала 87%, а чистый поиск — 73%. При этом в среднем на каждый вопрос уходит примерно на 20 тысяч токенов меньше.
- У упорядочивания есть побочные эффекты: при параллельной записи факты теряются, Wiki разрастается, а для простых задач она просто не нужна.
- Собрать такое самостоятельно реально: вызывая модели Claude через APIYI (apiyi.com), можно реализовать упрощённую версию упорядочивания памяти между сессиями.
Итоги
Из истории с Claude Dreaming можно вынести три главные мысли:
- Суть долговременной памяти — в её поддержании: только проверенная, очищенная от дубликатов и структурированная память стабильно помогает в следующей задаче.
- Важнее, что запоминать, чем сколько: в первую очередь фиксируйте то, что трудно заново получить из окружения: правила, причины ошибок и подводные камни. Не записывайте то, что быстро меняется, например текущее состояние.
- Структурированная память зависит от сценария: для задач, где много файлов, много итераций и знания копятся долго, Wiki стоит внедрять. Для простых задач на поиск лишние расходы на поддержку ни к чему.
Если ваш агент уже работает сразу в нескольких сессиях, начните с минимального замкнутого цикла: «сохраняем Transcript, раз в ночь последовательно запускаем упорядочивание, индексную страницу монтируем только для чтения». Чтобы быстро проверить этот процесс, рекомендуем вызывать модели Claude через APIYI (apiyi.com). Платформа предоставляет OpenAI-совместимый интерфейс и бесплатный тестовый лимит для новых пользователей.
📚 Источники
- The components of agent memory: оригинальная статья из инженерного блога Anthropic, в которой описаны 4 уровня памяти и эксперимент с Dreaming
- Ссылка:
anthropic.com/research/components-of-agent-memory -
Примечание: первоисточник данных экспериментов CL-Bench, Pokémon, Wiki и упорядочивания контрактов
-
Dreaming with a dynamic workflow: официальный Cookbook от Claude
- Ссылка:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Примечание: пример мультиагентного воркфлоу Lead, Analyzer, Organizer и ориентиры по стоимости
-
Официальный пост Anthropic в X: анонс инженерной статьи о Dreaming
- Ссылка:
x.com/AnthropicAI/status/2118814753154064501 - Примечание: подтверждает дату выхода и официальное позиционирование
Автор: техническая команда APIYI
Обратная связь: пишите нам на главной странице сайта APIYI, а больше материалов найдёте в центре документации docs.apiyi.com


