
Note de l’auteur : quels indicateurs de fiabilité faut-il vérifier avant de choisir un service proxy API ou d’agrégation d’API IA pour la production ? Cet article présente 10 indicateurs clés, un processus de validation sur 7 jours et une grille d’évaluation.
Beaucoup d’équipes choisissent d’abord un service proxy API ou d’agrégation d’API IA parce qu’il « fonctionne et ne coûte pas cher ». C’est une fois en production que les problèmes apparaissent : les erreurs 429 se multiplient aux heures de pointe, les réponses en streaming s’interrompent, les factures ne correspondent pas au nombre de tokens comptabilisés en interne et le comportement d’un modèle change du jour au lendemain. Voici 10 indicateurs de fiabilité à vérifier avant de choisir un service proxy API ou d’agrégation d’API IA pour la production, ainsi qu’un processus de validation sur 7 jours.
Ce n’est pas un énième comparatif qui recommande simplement le moins cher. Nous allons nous concentrer sur une seule question : le service peut-il absorber votre trafic en production et, en cas de problème, celui-ci peut-il être détecté, expliqué et compensé ?
Ce que vous allez y gagner : une checklist concrète pour évaluer la fiabilité d’un service proxy API et déterminer, chiffres à l’appui, s’il convient à la production avant de signer un contrat ou de lui confier votre trafic.
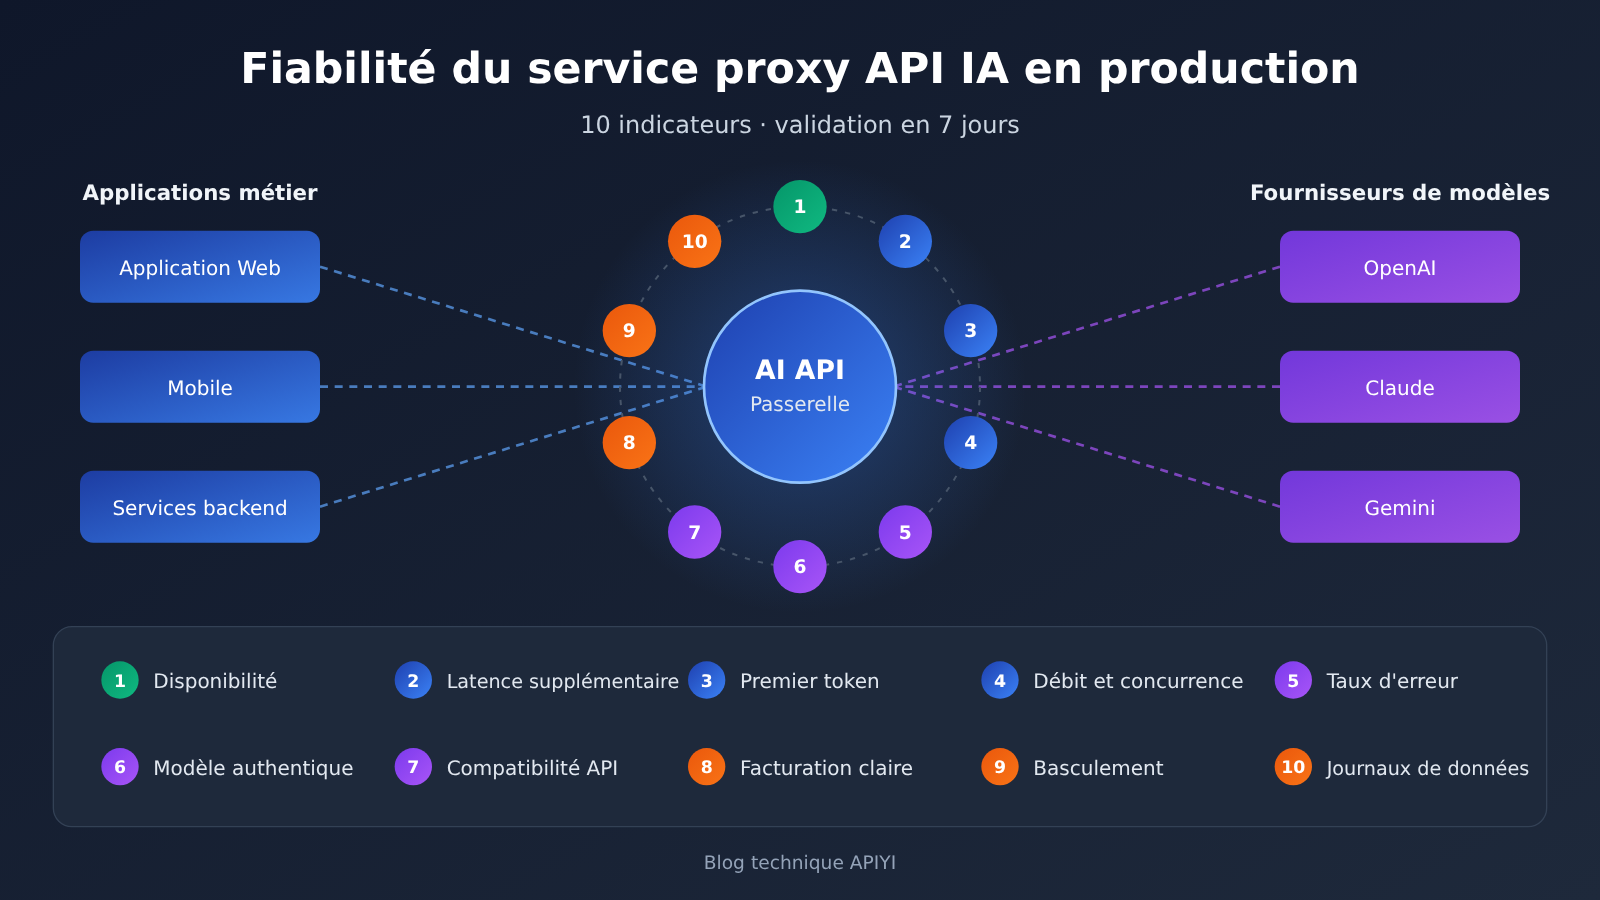
Points clés de la fiabilité d’un service proxy API d’agrégation d’API IA en production
Avant d’évaluer un service proxy API d’agrégation d’API IA, il faut distinguer les différents types d’indicateurs. La fiabilité ne se limite pas à savoir si le service est en panne : elle concerne aussi la prévisibilité de la latence, la qualité des résultats et la vérifiabilité de la facturation. Le tableau ci-dessous regroupe 10 indicateurs en quatre catégories pour faciliter la répartition de l’évaluation.
| Catégorie | Indicateurs clés | Points à examiner | Impact en production |
|---|---|---|---|
| Disponibilité | Historique des incidents, page de statut, engagements SLA | Fréquence des incidents, temps de rétablissement, publication de bilans | Détermine si le service peut rester accessible en continu |
| Performance | Latence supplémentaire, temps jusqu’au premier token, limitation du débit et concurrence | Surcoût introduit par le proxy, performances aux heures de pointe | Affecte directement l’expérience utilisateur et le taux de délais d’attente dépassés |
| Cohérence | Authenticité des versions de modèles, compatibilité des interfaces, transparence des codes d’erreur | Substitution éventuelle de modèles, prise en charge complète du streaming et des appels d’outils | Détermine la qualité des résultats et la stabilité du code |
| Gouvernance | Transparence de la facturation, basculement, politiques de données et de journalisation | Vérifiabilité des factures, redondance des fournisseurs en amont, conformité en matière de confidentialité | Détermine si le service peut être utilisé sereinement à long terme |
Les indicateurs de disponibilité d’un service proxy API IA en détail
La disponibilité est le premier critère à examiner pour choisir un service proxy API IA en production. Ne vous arrêtez pas aux pourcentages annoncés par la plateforme : vérifiez aussi si elle dispose d’une page de statut publique, si son historique d’incidents est consultable et si chaque incident fait l’objet d’un bilan. Une plateforme qui publie la chronologie de ses incidents inspire souvent plus confiance qu’une plateforme qui se contente d’afficher « haute disponibilité ».
Des sources tierces peuvent vous donner un point de comparaison. Par exemple, dans une évaluation d’OpenRouter en environnement de production, le blog Ofox.ai indique que trois incidents ont été documentés entre 2025 et 2026 et que le service introduit environ 25 à 40 ms de latence supplémentaire (source : Ofox.ai Blog, cité uniquement à titre de comparaison). L’intérêt de ces données n’est pas de juger une plateforme en particulier, mais de rappeler que toute couche proxy peut subir des incidents et ajouter une latence. L’essentiel est de savoir si leur ampleur est acceptable et si la plateforme fait preuve de transparence.
Performance et cohérence d’un service d’agrégation d’API IA en détail
Côté performance, il faut distinguer deux composantes de la latence ajoutée par le proxy : le surcoût fixe lié au réseau et à l’authentification, et le surcoût variable lié aux files d’attente pendant les pics de trafic. Le premier est généralement stable et mesurable ; le second est la principale source d’incidents en production. Faites donc vos tests pendant les heures de pointe de votre propre activité, plutôt que de tirer des conclusions d’un seul benchmark lancé en pleine nuit.
Côté cohérence, le risque le plus difficile à détecter est la « substitution » du modèle. Certaines plateformes peuvent, lorsque les ressources en amont sont sous tension, rediriger les requêtes vers un modèle moins coûteux ou une version quantifiée. L’interface renvoie toujours un code 200, mais la qualité des résultats baisse sensiblement. Vérifiez que le champ model de la réponse correspond à celui de la requête et effectuez régulièrement des tests de non-régression avec un jeu de questions fixe, afin de repérer les changements brusques de style ou de précision.
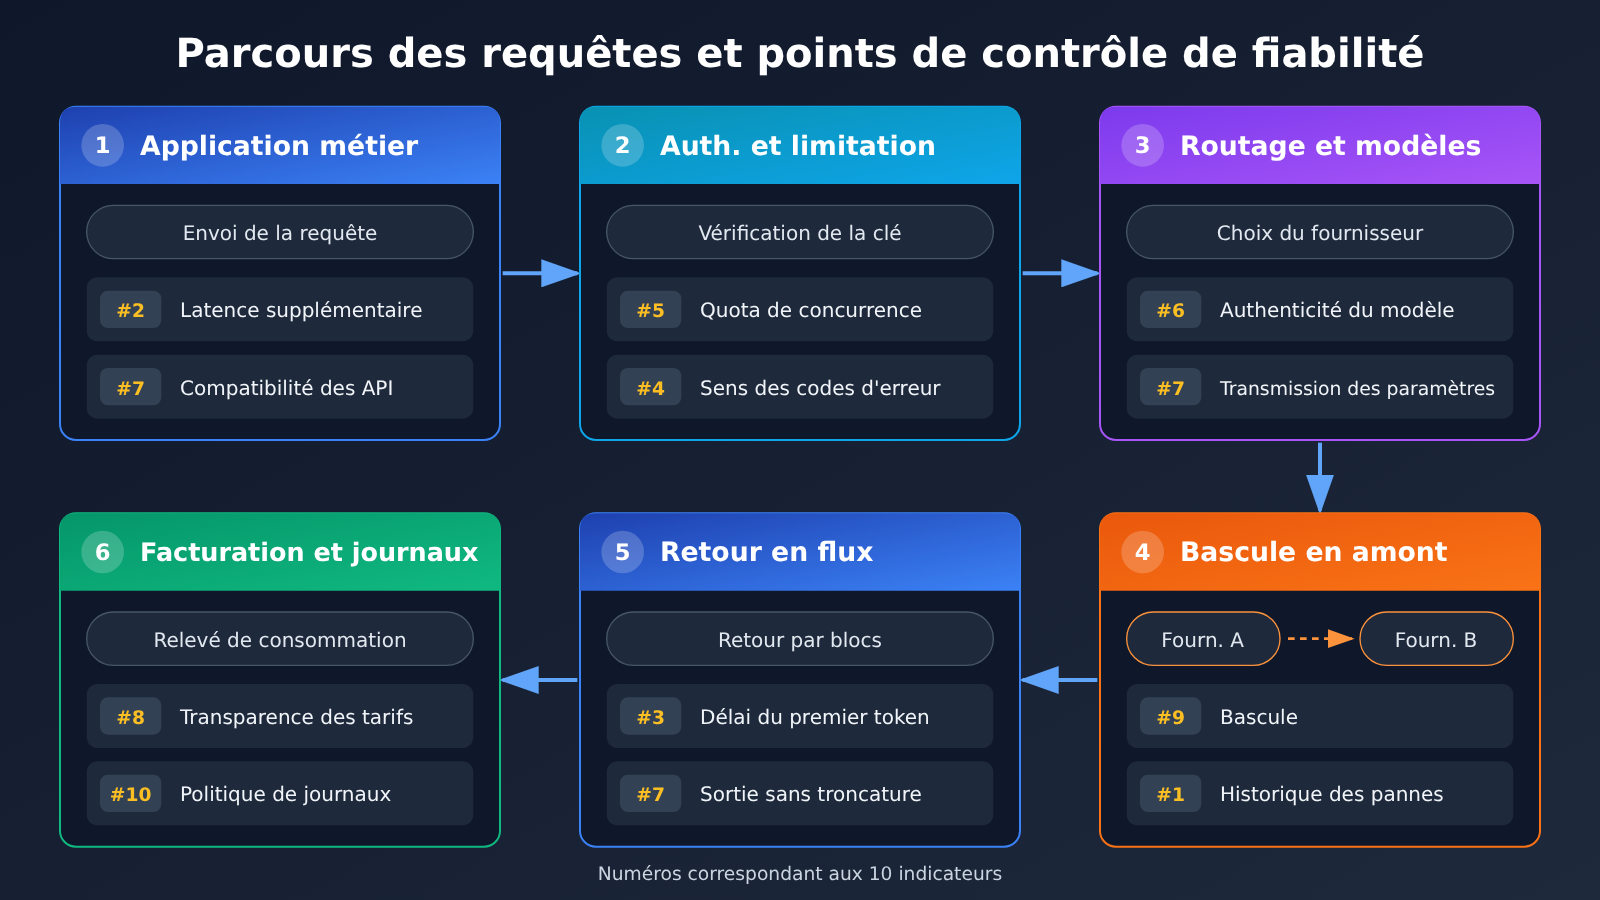
Vérifier les 10 indicateurs de fiabilité d’un service proxy API d’IA en production
Le tableau ci-dessous est la liste de contrôle centrale de cet article. Chaque indicateur est accompagné d’une méthode de vérification et d’un critère de validation recommandé. Vous pouvez le copier directement dans un document d’évaluation interne. Ces critères sont indicatifs : adaptez-les à la tolérance aux risques de votre activité.
| N° | Indicateur de fiabilité | Méthode de vérification | Critère de validation recommandé |
|---|---|---|---|
| 1 | Historique des incidents et page de statut | Consulter la page de statut publique et les comptes rendus d’incident | Une page de statut existe et les incidents majeurs font l’objet d’un compte rendu |
| 2 | Latence supplémentaire | Comparer une même requête en connexion directe et via le proxy | Le surcoût fixe reste stable, sans dégradation notable aux heures de pointe |
| 3 | Temps jusqu’au premier token | Consigner le délai d’arrivée du premier paquet pour les requêtes en streaming | Les percentiles sont stables et les délais extrêmes sont explicables |
| 4 | Taux d’erreur et codes d’erreur | Analyser la répartition des erreurs 4xx et 5xx | Les codes d’erreur sont explicites et permettent de distinguer les problèmes en amont de ceux de la plateforme |
| 5 | Limites de débit et quotas de concurrence | Augmenter progressivement la charge pour observer l’apparition des erreurs 429 | Les quotas sont clairement définis et une augmentation peut être demandée |
| 6 | Authenticité de la version du modèle | Vérifier le champ model et effectuer des tests de régression sur un jeu de questions fixe | Le modèle renvoyé correspond à celui demandé et les réponses ne présentent pas de dérive anormale |
| 7 | Compatibilité de l’interface | Tester le streaming, les appels d’outils, le multimodal et le cache | Les paramètres courants sont transmis intégralement, sans suppression silencieuse |
| 8 | Transparence de la facturation | Comparer son propre décompte de tokens aux factures de la plateforme | Les écarts sont explicables et les règles de facturation du cache sont publiques |
| 9 | Capacité de basculement | Examiner la stratégie de redondance des fournisseurs en amont et les mécanismes de basculement | La défaillance d’un seul fournisseur en amont ne rend pas l’ensemble du service indisponible |
| 10 | Politique de données et de journalisation | Lire les conditions de confidentialité et les indications sur la conservation des journaux | La conservation, sa durée et la possibilité de la désactiver sont clairement précisées |
Pourquoi la transparence de facturation d’un service proxy API d’IA est un indicateur de fiabilité
On voit souvent la facturation comme une simple question de coût. Pourtant, en production, son manque de transparence constitue en soi un risque pour la fiabilité. Une facture qui grimpe soudainement peut signaler des défauts d’accès au cache, un changement dans les règles de comptage des tokens ou des tentatives anormales répétées côté client : autant de problèmes qui touchent le système. Le blog Ofox.ai a rapporté qu’Anthropic avait confirmé une limitation du débit aux heures de pointe, ainsi que deux bugs de cache susceptibles de multiplier les factures de tokens par 10 à 20 (source : Ofox.ai Blog, cité à titre de comparaison). Même avec un fournisseur officiel, il reste donc important de vérifier sa facturation.
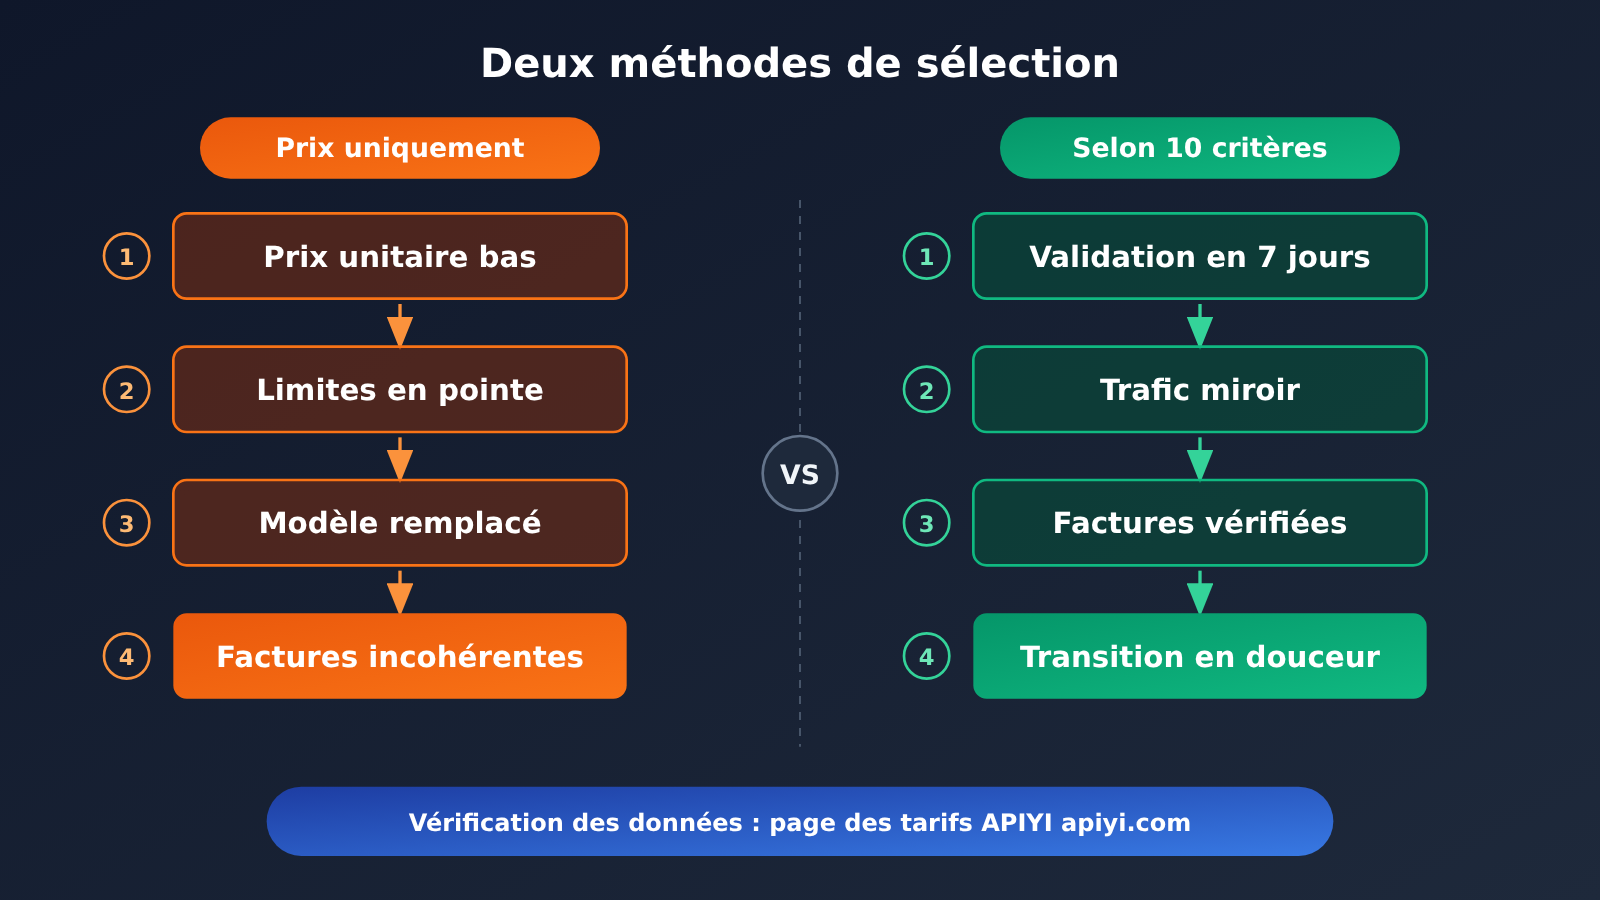
Cette même source indique que certaines plateformes d’agrégation prélèvent des frais de recharge, comme les 5,5 % de frais sur les crédits chez OpenRouter (source : Ofox.ai Blog, cité à titre de comparaison). Pour évaluer un service proxy API, mieux vaut intégrer les frais, le taux de change, le montant minimal de recharge et le prix du cache dans le « prix unitaire réel », plutôt que de regarder uniquement les tarifs d’entrée et de sortie affichés.
Les points de compatibilité à vérifier pour un service d’agrégation d’API d’IA
Les problèmes de compatibilité apparaissent rarement au stade du Hello World. Les situations les plus risquées sont plutôt celles-ci : une sortie en streaming interrompue par la couche proxy, une structure de paramètres d’appel d’outil modifiée, une limite sur la taille des images en entrée ou des champs de contrôle du cache au format Anthropic supprimés sans avertissement. Le mieux est de répertorier tous les paramètres réellement utilisés par votre application, puis de les tester un par un avec de vraies requêtes.
Si votre système utilise à la fois les formats d’interface OpenAI et Anthropic, vérifiez que le service proxy API prend en charge les deux formats nativement, au lieu de convertir les requêtes Anthropic au format OpenAI puis de les reconvertir. Plus les conversions sont nombreuses, plus le risque de perdre des champs ou d’obtenir des comportements incohérents augmente.
Prise en main d’un service proxy API d’IA en production : un processus de validation sur 7 jours
La liste de contrôle est prête : reste à valider le service. Nous recommandons de le tester pendant 7 jours avec un faible volume de trafic, afin de couvrir les pics en semaine et d’observer les variations du week-end. Pas besoin d’outils complexes : des journaux et un tableur suffisent.
| Étape | Période | Actions principales | Livrable |
|---|---|---|---|
| Préparation | Jour 1 | Recenser les modèles, les paramètres et le QPS maximal utilisés par l’application, puis préparer un jeu fixe de tests de non-régression | Liste des paramètres et jeu de tests |
| Tests de non-régression fonctionnelle | Jour 2 | Tester point par point le streaming, les appels d’outils, le multimodal et les champs de cache | Liste de contrôle de compatibilité |
| Test de charge | Jour 3 | Augmenter progressivement la charge jusqu’à 1,5 fois le pic et noter les seuils d’apparition des erreurs 429 et 5xx | Courbes de concurrence et de limitation du débit |
| Trafic miroir | Jours 4 à 6 | Copier une petite partie des requêtes réelles vers le service proxy API et comparer les résultats avec le parcours existant | Rapport sur la latence, le taux d’erreur et les différences de sortie |
| Rapprochement et bilan | Jour 7 | Comparer ses propres statistiques de tokens avec la facture de la plateforme et compiler les 10 indicateurs | Conclusion sur le choix du service et plan de bascule |
Points clés pour configurer un service proxy API pour l’IA
Lors de l’intégration, l’idéal est de modifier la configuration sans toucher au code. Si votre projet utilise le SDK officiel d’OpenAI, il suffit généralement de remplacer le base_url par l’adresse fournie par le service proxy API, puis de modifier l’api_key. Avec APIYI, par exemple, le base_url au format compatible OpenAI peut être défini sur https://api.apiyi.com/v1 ; pour le nom du modèle, utilisez l’ID indiqué sur la page des tarifs.
Si vous utilisez le SDK Anthropic ou un outil comme Claude Code, qui repose sur le format Anthropic, vérifiez que la plateforme propose un accès au format natif Anthropic. Configurez ensuite l’adresse de base et la variable d’environnement de la clé selon la documentation. APIYI est compatible avec les formats d’interface OpenAI et Anthropic ; pour les adresses et les paramètres exacts, consultez le centre de documentation docs.apiyi.com plutôt que de reprendre d’anciennes adresses trouvées dans des tutoriels tiers.
Lors de l’intégration, pensez aussi à ces trois points :
- Distinguer délais d’expiration et tentatives de nouvelle exécution : définissez un délai de connexion court et un délai de lecture plus long, adapté au modèle et à la longueur de la réponse. Limitez les nouvelles tentatives aux erreurs 429 et 5xx, avec un délai d’attente exponentiel.
- Consigner les champs clés : pour chaque requête, enregistrez l’ID de requête, le nom du modèle, les tokens d’entrée et de sortie, la durée et le code d’état. Ces données seront essentielles pour rapprocher les factures et résoudre les incidents.
- Prévoir une solution de repli : gardez au moins une voie de secours, par exemple un autre service proxy API ou une connexion directe au fournisseur officiel, et utilisez un paramètre de configuration pour basculer de l’une à l’autre.
🚀 Pour démarrer rapidement : si vous souhaitez d’abord tester le processus de 7 jours décrit ci-dessus avec un faible volume de trafic, vous pouvez vous inscrire sur APIYI apiyi.com pour obtenir un crédit de test. La plateforme propose une interface API unifiée, compatible avec les formats OpenAI et Anthropic : il suffit de modifier un base_url pour y rediriger le trafic miroir et comparer les résultats.
Couverture des modèles et vérification des prix des services d’agrégation d’API IA
Avant de choisir un service, vérifiez que les modèles dont vous avez besoin sont réellement disponibles et que les tarifs sont clairement indiqués. Le tableau ci-dessous présente une partie des modèles actuellement disponibles sur APIYI et les prix unitaires affichés sur sa page tarifaire. Les tarifs de référence sont ceux de la page https://docs.apiyi.com/models d’APIYI. Consultez-la pour connaître les unités de facturation et les dernières mises à jour : les chiffres ci-dessous sont fournis à titre indicatif.
| ID du modèle | Cas d’utilisation | Prix unitaire en entrée / sortie / cache (page tarifaire APIYI) | Plateforme disponible |
|---|---|---|---|
| claude-opus-5-5 | Raisonnement complexe, programmation sur de longues chaînes de tâches | $4 / $20 / $0.2 | APIYI apiyi.com |
| claude-sonnet-5-5 | Programmation quotidienne, modèle principal pour les agents | $2 / $10 / $0.1 | APIYI apiyi.com |
| kimi-k3.1-pro | Contextes longs, tâches en chinois | $2 / $10 / $0.2 | APIYI apiyi.com |
| deepseek-v4.1-flash | Traitement par lots à faible coût et à forte concurrence | $0.3 / $1.2 / $0.006 | APIYI apiyi.com |
| gpt-image-2.6-flare / sunburst | Génération d’images | Entrée texte $5, entrée image $8, sortie $30 | APIYI apiyi.com |
| Série qwen3.8 | Tâches générales en chinois | Voir la page tarifaire | APIYI apiyi.com |
À noter : si votre activité dépend de la série ERNIE de Baidu, ces modèles ne sont pas encore disponibles sur APIYI. Nous prévoyons de les proposer dès que possible ; en attendant, conservez votre mode d’accès actuel. Cette vérification vaut pour tout service proxy API : confirmez un par un que les modèles figurent bien dans la grille tarifaire, sans vous contenter d’une formule générale comme « prise en charge de centaines de modèles ».
💡 Conseil pour choisir : multipliez le prix unitaire du cache par votre taux réel de requêtes servies depuis le cache, puis ajoutez les frais d’entrée et de sortie pour obtenir le coût réel. Nous vous conseillons de tester les modèles Claude, Kimi, DeepSeek et autres sur APIYI apiyi.com avec le même lot de requêtes, puis de retenir celui qui offre la qualité requise au coût le plus bas, plutôt que de vous fier au seul prix unitaire.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un service proxy API pour l’agrégation d’API d’IA ?
C’est une passerelle située entre votre application et les fournisseurs de modèles. Elle regroupe les modèles de plusieurs fournisseurs sous une interface unique et gère l’authentification, le routage, la facturation et le basculement en cas de panne. L’intégration et le changement de modèle sont plus simples, mais cela ajoute une dépendance dont il faut évaluer la fiabilité.
Q2 : Un service proxy API d’IA est-il forcément moins fiable qu’une connexion directe à l’API officielle ?
Pas nécessairement. Avec une connexion directe, vous dépendez d’un seul fournisseur : s’il impose une limite de débit ou subit une panne, vous n’avez pas de solution de repli. Un service proxy API doté de plusieurs fournisseurs en amont peut, lui, basculer automatiquement si l’un d’eux rencontre un problème. La vraie différence tient à la qualité du proxy lui-même : mieux vaut donc la vérifier à l’aide des 10 indicateurs de cet article plutôt que de partir avec des idées préconçues.
Q3 : À quelle fréquence faut-il revoir les indicateurs de fiabilité d’un service proxy API d’IA ?
Nous recommandons une validation complète de 7 jours avant la mise en production, puis un examen mensuel du taux d’erreur, des percentiles de latence et des écarts de facturation. Relancez aussi les tests de régression fonctionnelle et de charge chaque fois que la plateforme met à jour une version de modèle, modifie ses prix ou que votre trafic augmente sensiblement.
Q4 : Quels scénarios de production exigent une attention particulière à la fiabilité d’un service d’agrégation d’API d’IA ?
Les principaux cas sont les suivants :
– **Conversations en temps réel avec les utilisateurs finaux** : le temps d’obtention du premier token et la stabilité du streaming influencent directement l’expérience.
– **Agents de programmation et workflows automatisés** : si les champs des appels d’outils sont modifiés, toute la chaîne peut échouer.
– **Traitement de données par lots** : les quotas de concurrence et l’exactitude de la facturation déterminent si les tâches peuvent être terminées dans les délais et le budget prévus.
Q5 : Comment vérifier rapidement par API qu’un service proxy répond aux exigences ?
Le plus simple est de commencer par connecter une plateforme prenant en charge plusieurs modèles, puis de comparer les résultats avec du trafic miroir :
1. Rendez-vous sur APIYI apiyi.com pour créer un compte et obtenir un crédit de test
2. Définissez base_url sur `https://api.apiyi.com/v1`, ou suivez la documentation docs.apiyi.com pour configurer le format Anthropic
3. Copiez une petite partie des requêtes réelles et comparez la latence, le taux d’erreur et les différences de réponse
APIYI permet d’invoquer par API les modèles mentionnés dans cet article, notamment Claude, Kimi, DeepSeek, GPT Image et Qwen, pour les comparer facilement à partir d’une même interface.
Q6 : Quelle source consulter pour connaître les prix d’un service proxy API ?
Fiez-vous à la page officielle des tarifs de la plateforme et conservez une capture d’écran ou notez la date de vérification. Pour APIYI, les tarifs d’entrée, de sortie et de cache de tous les modèles sont indiqués sur la page https://docs.apiyi.com/models. Les prix publiés sur des blogs tiers ne servent que de point de comparaison : leurs critères et dates de mise à jour peuvent différer.
Q7 : Quelles sont les limites incontournables d’un service proxy API d’agrégation d’API d’IA ?
Tout proxy ajoute un peu de latence et crée un point de défaillance supplémentaire. De plus, les nouveaux modèles arrivent généralement sur les plateformes proxy après leur lancement officiel, et certains paramètres propres aux fournisseurs peuvent nécessiter un délai d’adaptation. Pour y faire face, conservez une connexion directe au fournisseur officiel ou un second service comme solution de repli, et prévoyez un fonctionnement dégradé pour les activités critiques.
Fiabilité des services proxy API d’IA en production : points clés
- La fiabilité repose sur quatre piliers : disponibilité, performance, cohérence et gouvernance. Il ne suffit pas de vérifier si le service est hors ligne.
- Mesurez la latence aux heures de pointe : le surcoût de la couche proxy est stable et mesurable ; ce sont surtout les variations des files d’attente en période de pointe qui provoquent des incidents.
- Attention aux substitutions de modèles : vérifiez le champ
modelet effectuez des tests de non-régression sur un jeu de questions fixe pour détecter toute dégradation silencieuse. - La facturation fait aussi partie de la fiabilité : des anomalies de facturation peuvent révéler une défaillance du cache ou une tempête de tentatives. Vérifiez régulièrement les comptes.
- Testez chaque aspect de la compatibilité : validez le streaming, les appels d’outils et les champs de cache avec de vraies requêtes, sans vous limiter à un Hello World.
- Validez sur 7 jours avec du trafic miroir : comparez les résultats sur un faible volume de trafic plutôt que de décider à l’intuition ; vos conclusions seront plus fiables.
- Pour commencer : APIYI apiyi.com permet de comparer plusieurs modèles via une interface unifiée. Consultez la page des tarifs pour connaître les prix à jour.
Conclusion
Pour choisir un service proxy API ou un agrégateur d’API d’IA en production, retenez trois principes :
- Définissez les indicateurs avant de comparer les prix : utilisez les 10 indicateurs de fiabilité pour éliminer les plateformes qui ne répondent pas aux exigences, puis comparez les coûts des autres.
- Fiez-vous aux données plutôt qu’aux discours commerciaux : un processus de validation sur 7 jours vous donnera les données de latence, de taux d’erreur et de facturation propres à votre activité.
- Gardez toujours une solution de repli : toute liaison peut rencontrer un problème. Un canal de secours et un plan de dégradation font partie des indispensables en production.
Si vous envisagez d’ajouter une passerelle d’API d’IA à un service en ligne, utilisez le tableau d’évaluation de cet article pour commencer par une validation sur un faible volume de trafic. Vous pouvez tester rapidement avec APIYI apiyi.com : la plateforme est compatible avec les formats d’interface OpenAI et Anthropic. Vous pouvez vérifier les modèles et les tarifs sur https://docs.apiyi.com/models et consulter les détails d’intégration dans le centre de documentation docs.apiyi.com.
📚 Références
- Page des tarifs APIYI : liste des modèles et tarifs unitaires des entrées, des sorties et du cache
- Lien :
docs.apiyi.com/models -
Note : toutes les données tarifaires d’APIYI présentées dans cet article proviennent de cette page
-
Centre de documentation APIYI : instructions d’intégration aux formats OpenAI et Anthropic
- Lien :
docs.apiyi.com -
Note : comprend la configuration de base_url, les ID des modèles et les questions fréquentes
-
Blog Ofox.ai : évaluation de la fiabilité d’OpenRouter en production et article sur les problèmes de facturation de Claude
- Lien :
ofox.ai/blog/page/39 -
Note : source des données tierces sur le nombre de pannes, la latence supplémentaire et les frais, citées uniquement à titre de comparaison
-
Blog Ofox.ai : article sur la limitation du débit de Claude aux heures de pointe et les problèmes de facturation du cache
- Lien :
ofox.ai/blog/page/36 - Note : cité uniquement à titre de comparaison pour illustrer la nécessité de vérifier la facturation
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com, pour partager vos expériences sur le choix d’une passerelle API pour l’IA. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com.


