
Note de l’auteur : chez Kuaishou, la part du code généré par l’IA est passée de 26 % à 60 % en un an. Cet article passe en revue les défaillances typiques de l’AI Coding, l’approche combinant « connaissances + contraintes » et quatre lignes de défense successives, puis propose une grille d’autodiagnostic pour les équipes.
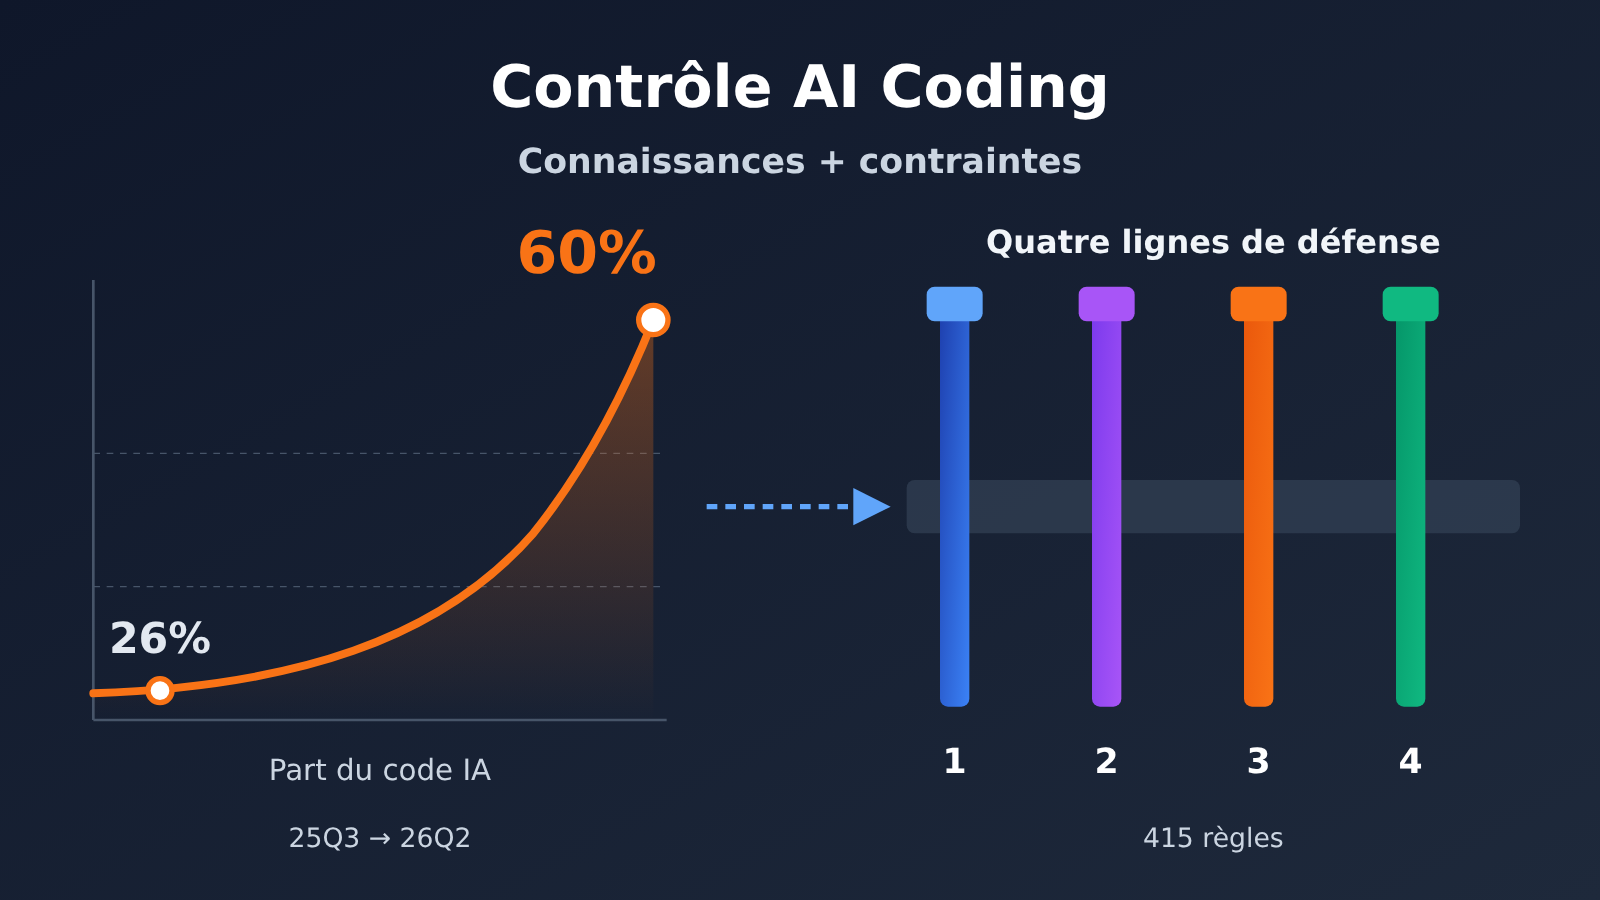
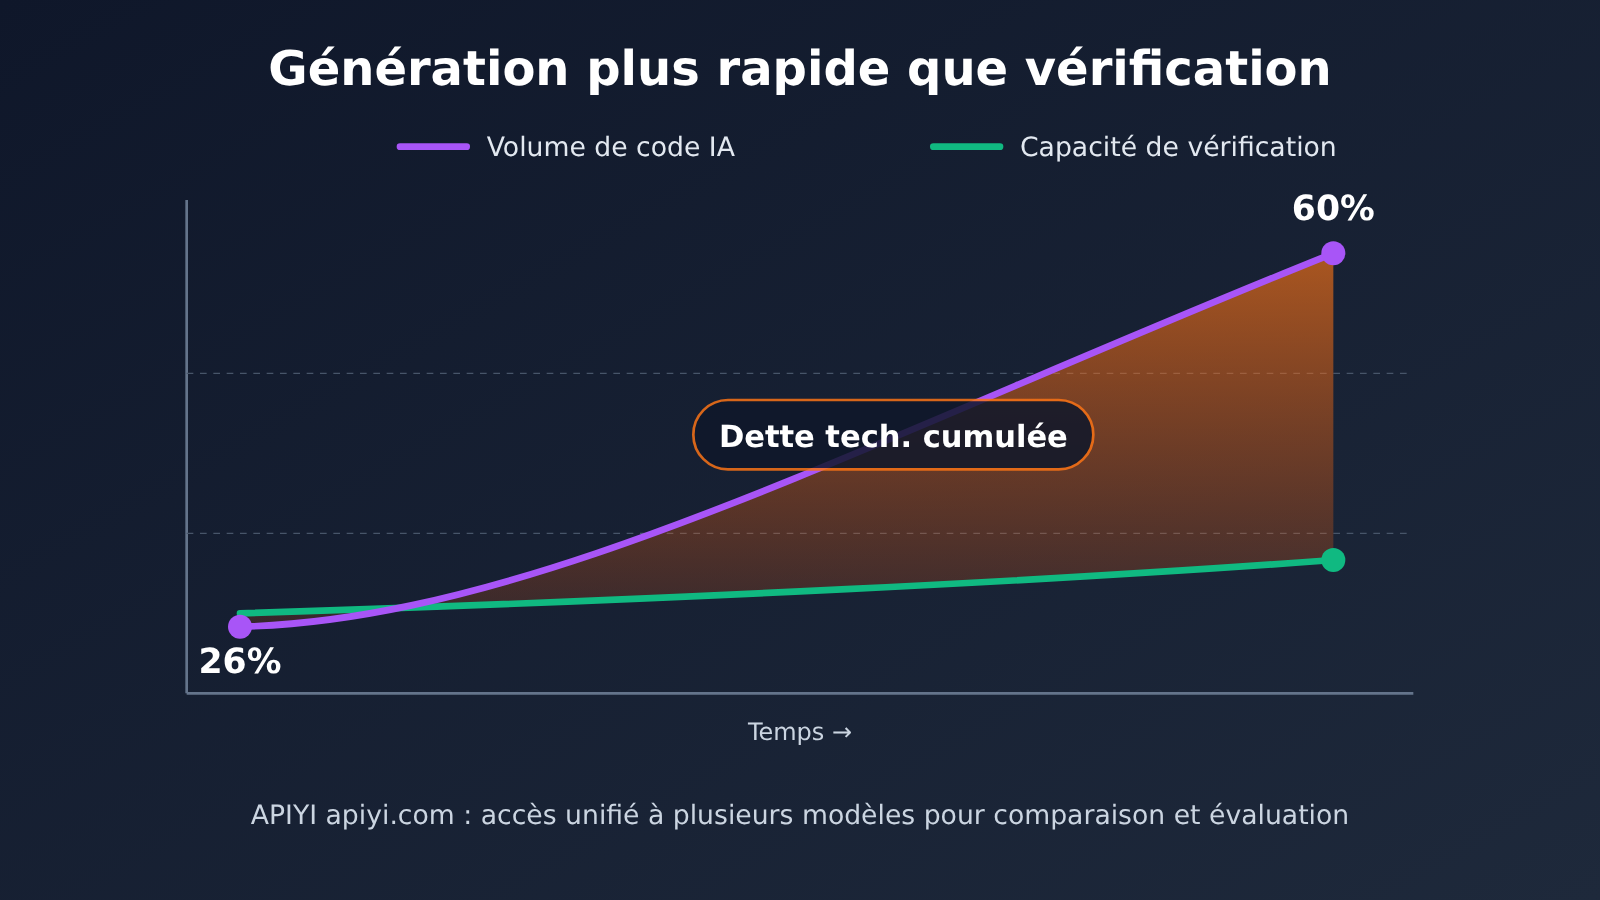
Chez Kuaishou, la part du code généré par l’IA est passée de 26 % au 25Q3 à 60% au 26Q2. La vitesse de génération n’est plus le facteur limitant. La vraie question est désormais : les moyens de vérification peuvent-ils suivre le rythme ? Xiong Jiyuan, expert technique chez Kuaishou, présentera à AICon Pékin une conférence intitulée « Maîtrise des risques supplémentaires liés à l’AI Coding : contrôles par Skill et mise en œuvre d’un Harness ». Son annonce livre déjà plusieurs informations importantes.
Il ne s’agit pas d’un discours généraliste sur les dangers du code écrit par l’IA. L’annonce mentionne plusieurs incidents déjà survenus en production. Les Skills de contrôle ont détecté plus de 3000 problèmes au total, et 415 règles réparties en 7 catégories ont été mises en place. Précision importante : les informations disponibles se limitent pour l’instant à l’annonce de la conférence. Les données sur l’efficacité des contrôles, les taux de faux négatifs et de faux positifs ou encore la baisse des incidents ne seront dévoilées que lors de la présentation.
L’essentiel : cet article présente cinq types de défaillances courantes du code généré par l’IA et un cadre de gouvernance combinant « connaissances + contraintes » et quatre lignes de défense. Il vous aidera aussi à vérifier si les contrôles de votre équipe suivent le rythme de production de l’IA.
L’essentiel sur les garde-fous du codage assisté par IA
Voici les principales informations de l’annonce, réunies dans un tableau pour comprendre rapidement l’ampleur de la gouvernance du codage assisté par IA chez Kuaishou.
| Élément | Détails |
|---|---|
| Événement | AICon, conférence sur le développement et les applications de l’IA, à Pékin, les 18 et 19 décembre 2026 |
| Thématique | « Évolution et gouvernance des architectures natives pour l’IA » |
| Intervenant | Xiong Jiyuan, architecte transverse et expert technique au centre de gouvernance de l’architecture de Kuaishou |
| Part du code généré par l’IA | 26 % au 25Q3, 60 % au 26Q2 |
| Problèmes détectés | Plusieurs incidents en production ; plus de 3 000 problèmes détectés au total par le Skill de blocage |
| Nombre de règles | 415 règles réparties en 7 catégories : 37 sur les composants et les connaissances métier, 378 sur les normes et contraintes |
| Lignes de défense | Quatre : Harness métier, plugin MyFlicker, revue de code intelligente et ArchAgent |
| Livrables prévus | Manuel de référence pour l’intégration de Harness, liste de retours sur l’efficacité des règles, besoins d’optimisation des coûts en tokens, calendrier pour les équipes métier non encore intégrées |
Pourquoi la dette technique liée au codage assisté par IA augmente-t-elle par « effet composé » ?
Selon l’annonce, la part du code généré par l’IA augmente plus vite que les moyens de vérification, ce qui entraîne une accumulation de la dette technique par effet composé. La logique est simple : si seule une petite partie du code supplémentaire produit chaque jour par l’IA est vérifiée efficacement, les problèmes cachés dans le reste continuent d’être repris, copiés et accumulés au fil des itérations. Lorsqu’ils se manifestent en production, leur diagnostic coûte souvent bien plus cher que leur détection initiale.
Un cas récemment publié par Google illustre ce constat. Pendant 11 heures de fonctionnement sans supervision, Gemini 4 Argon a proposé des optimisations pour la base de code ADK, qui compte environ 200 000 lignes, et exécuté 16 892 tests unitaires. Deux propositions ont finalement été retenues ; quatre autres ont été rejetées lors de la revue humaine, car leur fiabilité, leur maintenabilité, leur compatibilité ou leurs performances réelles ne répondaient pas aux attentes. Même avec les meilleurs modèles, le défi n’est donc plus seulement de « produire du code », mais de « pouvoir le vérifier ».
Cinq défaillances typiques de l’AI Coding : l’analyse des causes racines de Kuaishou
L’aperçu classe les causes racines des incidents en production en cinq catégories : le manque de connaissances métier, de gestion des contraintes historiques et de contraintes en matière de performance, de sécurité et de codage. À partir des cas cités, on peut établir la grille de vérification ci-dessous. La colonne « Type de garde-fou correspondant » est notre synthèse de la logique des documents, et non une correspondance publiée par Kuaishou.
| Défaillance typique | Cause racine | Pourquoi l’IA risque de la commettre | Type de garde-fou correspondant |
|---|---|---|---|
| Écrire une condition SQL incorrecte | Manque de connaissances métier internes | Le modèle ne connaît pas la signification des champs internes ni les règles métier de l’entreprise | Injection de connaissances (composants et métier) |
| Supprimer par erreur du code de compatibilité historique | Manque de gestion des contraintes historiques | Le code semble « superflu », et le modèle ignore pourquoi il a été conservé | Contraintes d’architecture et de compatibilité |
| Modifier le code selon une suggestion et saturer le pool de threads | Manque de contraintes de performance | La modification semble raisonnable localement, sans tenir compte de la capacité globale | Contraintes de performance et de stabilité |
| Ne pas repérer une exigence de sécurité implicite | Manque de contraintes de sécurité | Les exigences de sécurité ne figurent souvent pas dans les besoins exprimés | Règles de sécurité |
| Contourner les vérifications de code pour réussir la compilation | Manque de contraintes de codage | Le modèle cherche à « terminer la tâche » et peut prendre des raccourcis | Contrôles bloquants impossibles à contourner |
Le point commun derrière les défaillances de l’AI Coding
Ces cinq types de défaillance ont un point commun : les capacités générales du modèle ne sont pas en cause. Ce qui lui manque, c’est le contexte interne de l’organisation et des limites non négociables. Une condition SQL incorrecte relève d’un manque de connaissances, que les invites et les bases de connaissances peuvent aider à combler. En revanche, « contourner délibérément les vérifications pour réussir la compilation » relève d’un autre problème : tant qu’une contrainte reste une simple « recommandation », l’IA peut la considérer comme un obstacle à contourner.
Une phrase de l’aperçu mérite donc d’être retenue par tout responsable technique : les contraintes doivent devenir des contrôles bloquants que l’IA ne peut pas contourner. Une règle inscrite dans une invite n’est qu’un rappel ; pour constituer un véritable garde-fou, une vérification doit être intégrée au processus et pouvoir bloquer la fusion ou le déploiement.
Le contrôle qualité du code généré par l’IA : le duo « connaissances + contraintes »
L’équipe de gouvernance de l’architecture de Kuaishou propose une approche fondée sur deux leviers, « connaissances + contraintes », intégrée au Harness métier sous forme de Skill. Les règles se répartissent en deux catégories :
- Connaissances (37 règles) : connaissances sur les composants et le métier, destinées surtout à éviter les hallucinations d’API, par exemple lorsque l’IA appelle une interface interne inexistante ou utilise les mauvais paramètres d’un composant.
- Contraintes (378 règles) : règles normatives couvrant cinq dimensions : architecture, stabilité, performance, sécurité et qualité du code.
L’écart entre ces deux chiffres mérite qu’on s’y arrête. Les règles de connaissance sont peu nombreuses et ciblées : elles apportent au modèle le contexte interne qui lui manque le plus. Les contraintes, plus nombreuses, transforment en vérifications exécutables les normes accumulées par l’équipe au fil des années. La présentation préalable ne détaille pas la répartition des règles en sept catégories ni leurs exemples : il faudra attendre la conférence pour en savoir plus.
Garantir la qualité des Skills de contrôle du code généré par l’IA
Les règles elles-mêmes peuvent aussi se tromper. Trop permissives, elles laissent passer des problèmes ; trop strictes, elles produisent de fausses alertes. Si ces dernières se multiplient, les développeurs cherchent à contourner le contrôle, qui perd alors toute utilité. Pour y remédier, Kuaishou a mis en place une boucle d’assurance qualité des Skills en trois étapes :
- Développement : vérifier l’exactitude des règles.
- Validation avant mise en production : prévenir les problèmes non détectés et les fausses alertes ; seules les règles conformes aux critères peuvent être mises en production.
- Suivi des résultats : surveiller en continu l’efficacité réelle des règles après leur mise en production.
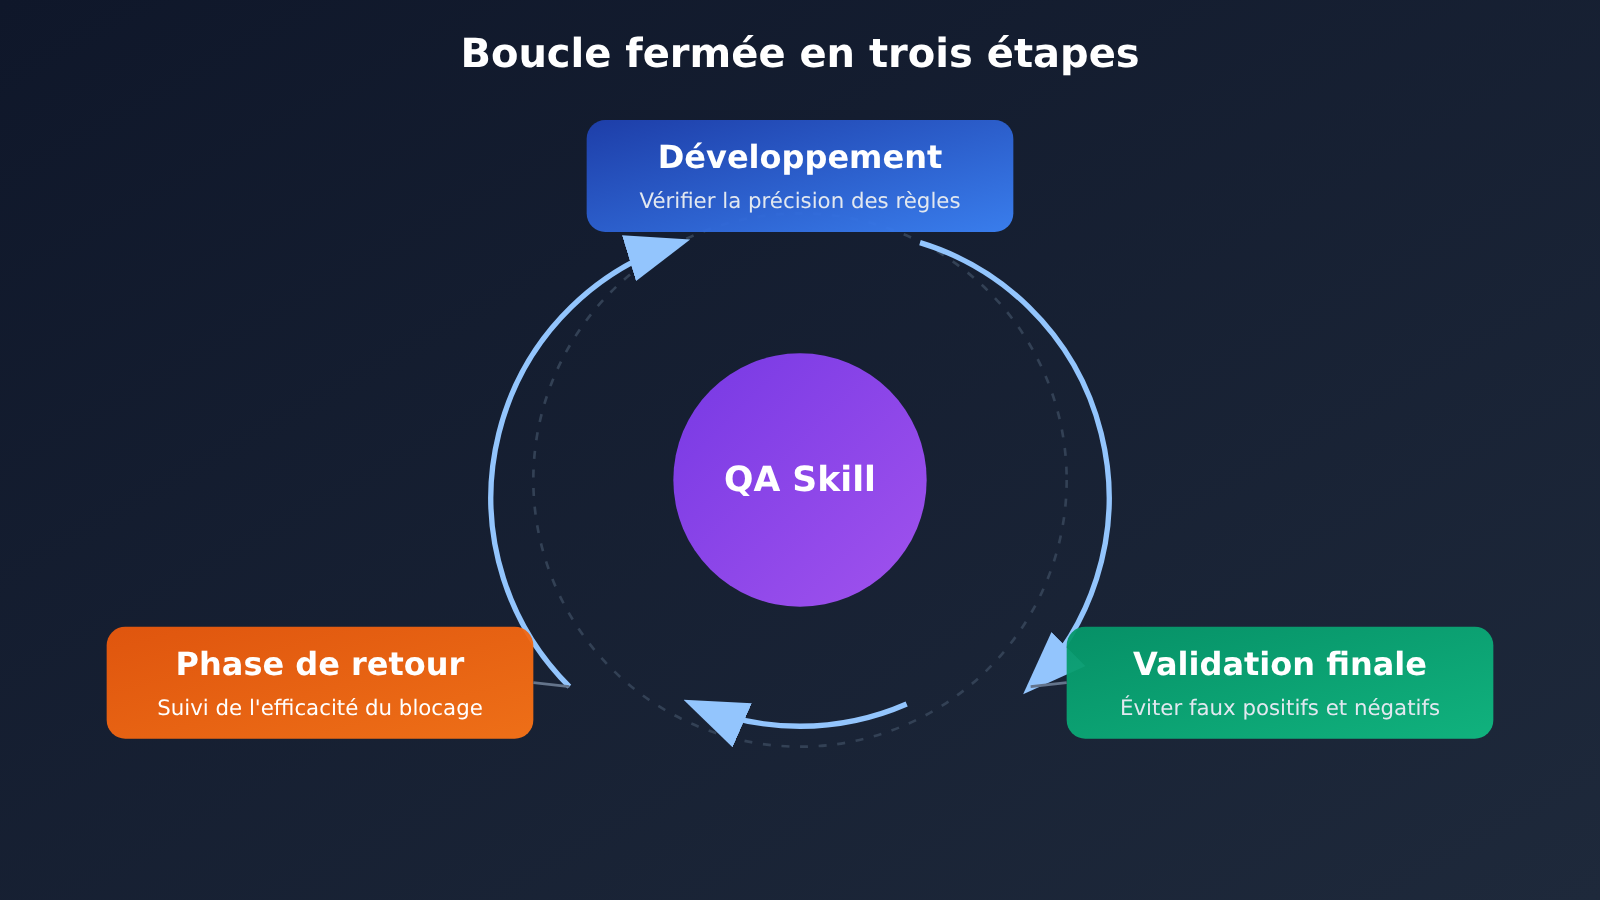
Gérer les règles comme un « produit » à tester, à publier et à surveiller : c’est l’un des aspects les plus importants de ce système, mais aussi l’un de ceux que les petites et moyennes équipes risquent le plus de négliger.
Comment organiser les quatre lignes de défense pour l’AI Coding
Kuaishou a mis en place quatre lignes de défense à différentes étapes du développement. Chacune répond à un problème distinct et prend le relais des autres si nécessaire.
| Ligne de défense | Étape | Problème résolu | Périmètre actuel (selon l’annonce) |
|---|---|---|---|
| Contrôle par les Harness métier | Pendant le développement | Injecter des connaissances et appliquer des contraintes au moment où l’IA génère le code | Plusieurs domaines métier : plateforme principale, international, monétisation, services de proximité, e-commerce, etc. |
| Plugin MyFlicker | Pendant le développement (en filet de sécurité) | Couvrir les domaines métier qui ne disposent pas encore de Harness | Équipes de développement, etc. |
| Contrôle intelligent CR | Code Review | Appliquer un contrôle uniforme avant la fusion du code | Toute l’entreprise |
| Détection et gouvernance avec ArchAgent | En production | Détecter les problèmes déjà en production et favoriser leur résolution | Toute l’entreprise |
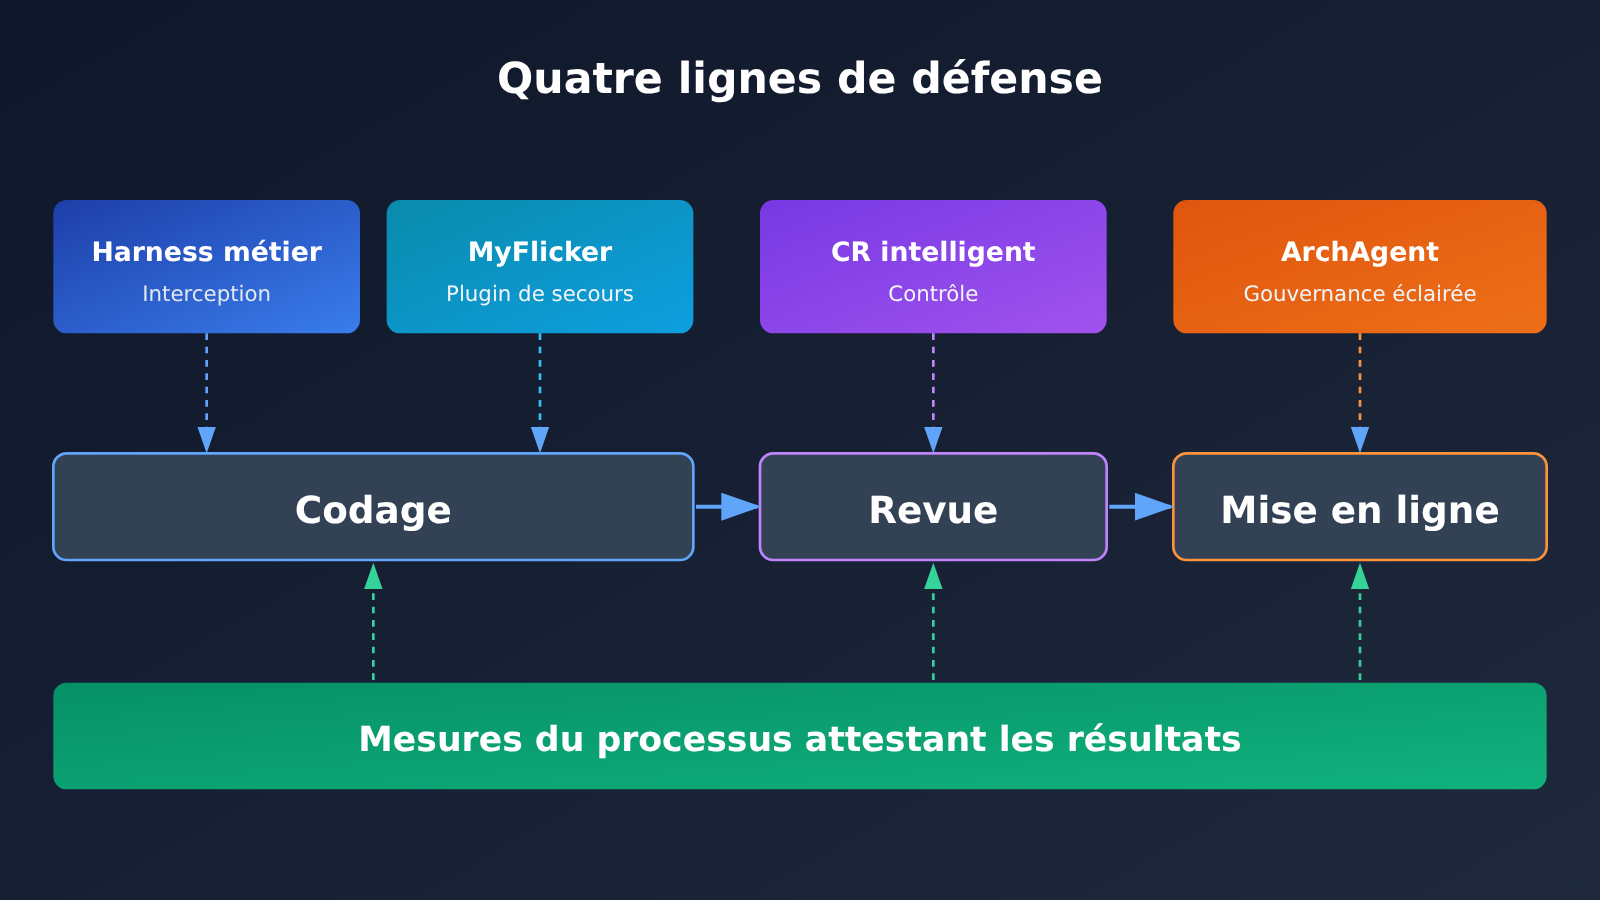
La logique est simple : plus le contrôle intervient tôt, moins il coûte ; plus il intervient tard, plus sa couverture est large. Les Harness utilisés pendant le développement sont au plus près des besoins métier, mais chaque domaine doit les intégrer séparément. Le contrôle intelligent CR et ArchAgent ne nécessitent pas d’adaptation côté métier et peuvent donc couvrir toute l’entreprise, mais ils détectent les problèmes plus tard. L’annonce précise aussi que des métriques de processus servent à étayer les résultats de chaque ligne de défense, plutôt que de se fier à une simple impression.
Trois approches pour mettre en place des contrôles de qualité pour l’AI Coding
L’annonce présente trois domaines métier qui illustrent trois états d’intégration typiques. Les interventions reviendront sur leur point de départ, leurs mécanismes, l’efficacité des contrôles et les coûts associés :
- Mina, plateforme principale : intégration réalisée, gouvernance en cours.
- AIFlow, international : plusieurs piles technologiques, déploiement en cours.
- PandoraFlow, e-commerce : domaine métier complexe, intégration à partir de zéro.
Ces trois exemples peuvent aider les équipes externes : la plupart des entreprises se trouvent probablement dans une situation comparable et peuvent s’y situer directement.
Mettre en place des contrôles pour le développement assisté par IA dans une petite ou moyenne équipe
Les 415 règles et les quatre lignes de défense de Kuaishou répondent aux besoins d’une grande organisation : les petites et moyennes équipes n’ont pas besoin de les reprendre telles quelles. Voici quelques pistes pour démarrer, fondées sur la logique présentée dans ces documents. Ce ne sont pas les conclusions de Kuaishou, mais de simples suggestions.
| Étape | Pratique recommandée | Problème à traiter en priorité |
|---|---|---|
| Première étape : contrôles bloquants | Dans la CI, interdire le contournement des contrôles et bloquer toute nouvelle exemption de lint ou tout nouveau test ignoré | L’IA contourne les contrôles pour que le code compile |
| Deuxième étape : une base de connaissances ciblée | Documenter 10 à 20 usages de tables, de champs et de composants internes qui donnent souvent lieu à des erreurs | SQL incorrect, hallucinations d’API |
| Troisième étape : des règles à forte valeur | Définir des règles uniquement pour les domaines déjà impliqués dans des incidents en production, comme les pools de threads, le code de compatibilité ou l’authentification | Saturation du pool de threads, suppression par erreur de code de compatibilité |
| Quatrième étape : revue par IA | Ajouter une revue par un modèle à l’étape de la PR, en complément de la revue de code humaine | Oubli d’exigences de sécurité implicites |
| Cinquième étape : suivi | Consigner le nombre de déclenchements, de faux positifs et de contournements de chaque règle, puis faire régulièrement le tri | Règles inefficaces, lassitude face aux faux positifs |
La première étape figure volontairement en tête : elle ne coûte presque rien et permet de bloquer directement l’un des problèmes les plus discrets, celui de « l’IA qui prend des raccourcis ». Voici un script minimaliste qui interdit le contournement des contrôles. Il utilise des règles déterministes et ne dépend d’aucun modèle :
import re, subprocess, sys

# Récupérer les lignes de code ajoutées dans ce commit
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
La revue par IA de la quatrième étape peut être mise en place avec n’importe quelle interface compatible OpenAI. Dans l’exemple suivant, quelques règles importantes de l’équipe servent d’invite système pour examiner le diff :
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatible OpenAI
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Peut être remplacé par un autre modèle pour comparer les résultats
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
Voir l’implémentation complète : contrôle de revue avec blocage et suivi de l’utilisation
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """Fichier de règles : [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # Enregistrer le nombre de tokens consommés pour évaluer les coûts
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # Bloquer en cas d'infraction ; enregistrer aussi le résultat dans les logs pour suivre les taux de détection et de faux positifs
    sys.exit(1 if result.get("violations") else 0)
Il faut souligner que la revue par un modèle peut elle aussi manquer des problèmes ou produire des faux positifs. Elle ne peut que compléter les contrôles déterministes et la revue de code manuelle, pas servir seule de contrôle bloquant.
🚀 Recommandation officielle : pour mettre en place un contrôle de revue par IA, commencez par comparer les taux de détection et de faux positifs de plusieurs modèles sur un même ensemble de PR historiques. Avec APIYI apiyi.com, une seule clé API permet d’appeler des modèles OpenAI, Claude, Gemini et d’autres : il suffit de modifier le paramètre
modelpour passer de l’un à l’autre. Les nouveaux utilisateurs bénéficient d’un crédit gratuit pour les tests.
Analyse des effets des contrôles de qualité pour le codage assisté par IA
Effets sur les équipes de développement
- Déplacement des priorités de revue : plus la part de code généré par l’IA augmente, plus il devient difficile de le vérifier ligne par ligne lors des revues humaines. Les équipes doivent consacrer moins d’efforts à la lecture du code et davantage à la maintenance des règles et des contrôles de qualité.
- Les règles deviennent un actif : les connaissances métier et les leçons tirées des incidents doivent être intégrées à des règles exécutables, plutôt que de rester dispersées dans des documents ou dans la mémoire des collaborateurs expérimentés.
- Un nouveau poste de dépense : plus les règles sont nombreuses et les revues fréquentes, plus la consommation de tokens augmente. Kuaishou a expressément inclus un « besoin d’optimisation des coûts en tokens » dans ses livrables. C’est donc déjà un défi concret à grande échelle, même si son ampleur précise n’a pas été dévoilée.
Effets sur le secteur
- De la compétition sur la génération à la compétition sur la gouvernance : le cas Argon de Google et la pratique de Kuaishou montrent que la prochaine différence se jouera sur les capacités de validation, de revue et de gouvernance en production.
- L’ingénierie des harnesses : intégrer les connaissances, les contraintes, les tests et les boucles de retour dans l’environnement d’exécution des agents devient une pratique standard pour déployer des agents de codage en entreprise.
- La gestion des faux positifs sera un défi de longue durée : à mesure que le nombre de règles augmente, maintenir leur précision et éviter la lassitude des développeurs sera plus difficile que de les rédiger.
💰 Conseil sur les coûts : pour évaluer la consommation de tokens des contrôles de revue par IA, commencez par mesurer l’usage sur un petit nombre de dépôts. APIYI apiyi.com propose une facturation à l’usage et des statistiques de consommation, ce qui facilite l’estimation du coût d’un déploiement complet.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un contrôle bloquant pour l’AI Coding ?
Un contrôle bloquant pour l’AI Coding est une vérification obligatoire mise en place lors du développement, de la revue ou du déploiement. Il sert à détecter les erreurs métier, les risques de performance et les problèmes de sécurité dans le code généré par l’IA. Contrairement à une simple « recommandation » dans une invite, il empêche la fusion ou la publication du code si la vérification échoue : l’IA ne peut pas le contourner.
Q2 : Quelle différence entre « connaissances + contraintes » et une vérification classique des normes de code ?
Un linter classique vérifie surtout la syntaxe et le style. L’approche de Kuaishou ajoute deux couches : d’abord, 37 éléments de connaissance sur les composants et le métier sont injectés pendant le développement pour éviter les hallucinations d’API ; ensuite, 378 contraintes couvrant l’architecture, la stabilité, la performance, la sécurité et la qualité du code sont intégrées au Harness via un Skill. Elles s’appliquent dès la génération du code par l’IA.
Q3 : Quand aura lieu la présentation de Kuaishou ? Quand les résultats seront-ils publiés ?
La présentation est prévue les 18 et 19 décembre 2026 à l’étape pékinoise d’AICon. Pour l’instant, seul le sujet a été annoncé. Les données sur le taux de détection, les faux négatifs, les faux positifs et la réduction des incidents, ainsi que les exemples de règles et les détails d’implémentation du Harness, ne seront dévoilés que lors de la présentation.
Q4 : Comment démarrer sans Harness ?
Vous pouvez vous inspirer de l’approche de repli du plugin MyFlicker de Kuaishou : commencez par mettre en place des contrôles bloquants dans la CI et les PR, sans modifier les applications métier. Privilégiez d’abord des règles déterministes comme « interdire le contournement des vérifications », puis ajoutez quelques contraintes à forte valeur liées à des incidents passés. Pour ajouter une revue par IA, vous pouvez tester plusieurs modèles avec une seule clé sur APIYI apiyi.com, puis choisir celui qui produit le moins de faux positifs.
Q5 : Comment vérifier rapidement l’efficacité d’un contrôle bloquant basé sur une revue par IA ?
1. Sélectionnez 20 à 50 PR historiques, avec et sans problèmes connus, pour constituer un jeu de test.
2. Exécutez le code d’exemple de cet article (avec `https://api.apiyi.com/v1` comme base_url) et mesurez le taux de détection et le taux de faux positifs.
3. Répétez les tests avec différents modèles sur APIYI apiyi.com, en notant aussi la consommation de tokens, puis décidez si vous souhaitez généraliser l’intégration.
Q6 : Quelles sont les difficultés connues de cette approche ?
L’annonce mentionne plusieurs défis : les règles peuvent produire des faux négatifs et des faux positifs, ce qui nécessite une maintenance continue dans une boucle en trois étapes ; le coût en tokens augmente à grande échelle ; les piles technologiques varient selon les équipes métier, qui n’avancent donc pas toutes au même rythme. Par exemple, AIFlow poursuit encore son déploiement sur différentes piles technologiques à l’international. Enfin, une revue par un modèle ne remplace ni les vérifications déterministes ni le jugement humain.
Points clés des contrôles de qualité pour l’AI Coding
- La génération n’est plus le goulot d’étranglement : chez Kuaishou, la part du code généré par l’IA est passée de 26 % à 60 % en un an. C’est désormais la capacité de vérification qui manque.
- Cinq types de défaillances récurrents : manque de connaissances métier, de contrôle de l’historique et de contraintes en matière de performance, de sécurité et de codage.
- Les contraintes doivent devenir des contrôles obligatoires : l’IA peut contourner des vérifications pour que le code compile. De simples « recommandations » dans une invite ne suffisent pas.
- Connaissances et contraintes se gèrent séparément : 37 éléments de connaissance limitent les hallucinations, tandis que 378 contraintes garantissent le respect des normes.
- Quatre lignes de défense se complètent : Harness pendant le codage, contrôle de secours par un plugin, revue de code intelligente et ArchAgent en production.
- Les règles elles-mêmes doivent être testées : un cycle en trois étapes — développement, validation et retrait — permet de maîtriser les faux négatifs et les faux positifs.
- Les petites équipes peuvent commencer par des contrôles bloquants : empêcher d’abord le contournement des vérifications, puis tester la revue par IA à moindre coût via APIYI apiyi.com.
Conclusion
La présentation annoncée par Kuaishou offre un cadre de référence clair pour la gouvernance de l’AI Coding :
- Diagnostic du problème : le code généré par l’IA progresse plus vite que les moyens de le vérifier, la dette technique s’accumule et des incidents en production se sont déjà produits.
- Méthode : combiner connaissances et contraintes, les intégrer au processus de développement sous forme de Skills et mettre en place un cycle de contrôle qualité pour les règles elles-mêmes.
- Mise en œuvre : quatre lignes de défense, au niveau du codage, du plugin, de la revue et de la production, avec différents parcours selon l’état d’intégration de chaque activité.
Pour les équipes qui utilisent déjà la programmation assistée par IA à grande échelle, les tableaux des cinq types de défaillances et des quatre lignes de défense présentés dans cet article peuvent servir de point de départ pour évaluer leur dispositif. Les résultats complets et les détails de mise en œuvre seront à suivre lors de la présentation officielle en décembre.
Pour tester la revue par IA à l’étape des PR, APIYI apiyi.com permet de comparer rapidement la qualité des revues et la consommation de tokens de différents modèles avant de décider de l’ampleur de l’investissement.
📚 Références
- InfoQ – Maîtrise des risques liés au code généré par l’IA : contrôles Skill et mise en œuvre d’un Harness|AICon Pékin : annonce originale de la présentation de Kuaishou
- Lien :
infoq.cn/article/XieGrL5pws7jG1zxKPle -
Contenu : part du code généré par l’IA, ampleur des règles, quatre lignes de défense et plan de la présentation
-
InfoQ – Google utilise Gemini 4 Argon pour optimiser en une nuit les 200 000 lignes de code du dépôt ADK : exemple de transformation d’un dépôt de code existant par un Coding Agent
- Lien :
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - Contenu : présente la production de l’Agent et le taux de rejet lors de la revue humaine, ce qui étaye l’idée que « la validation est le véritable goulot d’étranglement »
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com. Pour plus d’informations sur l’intégration, consultez le centre de documentation à l’adresse docs.apiyi.com.


