
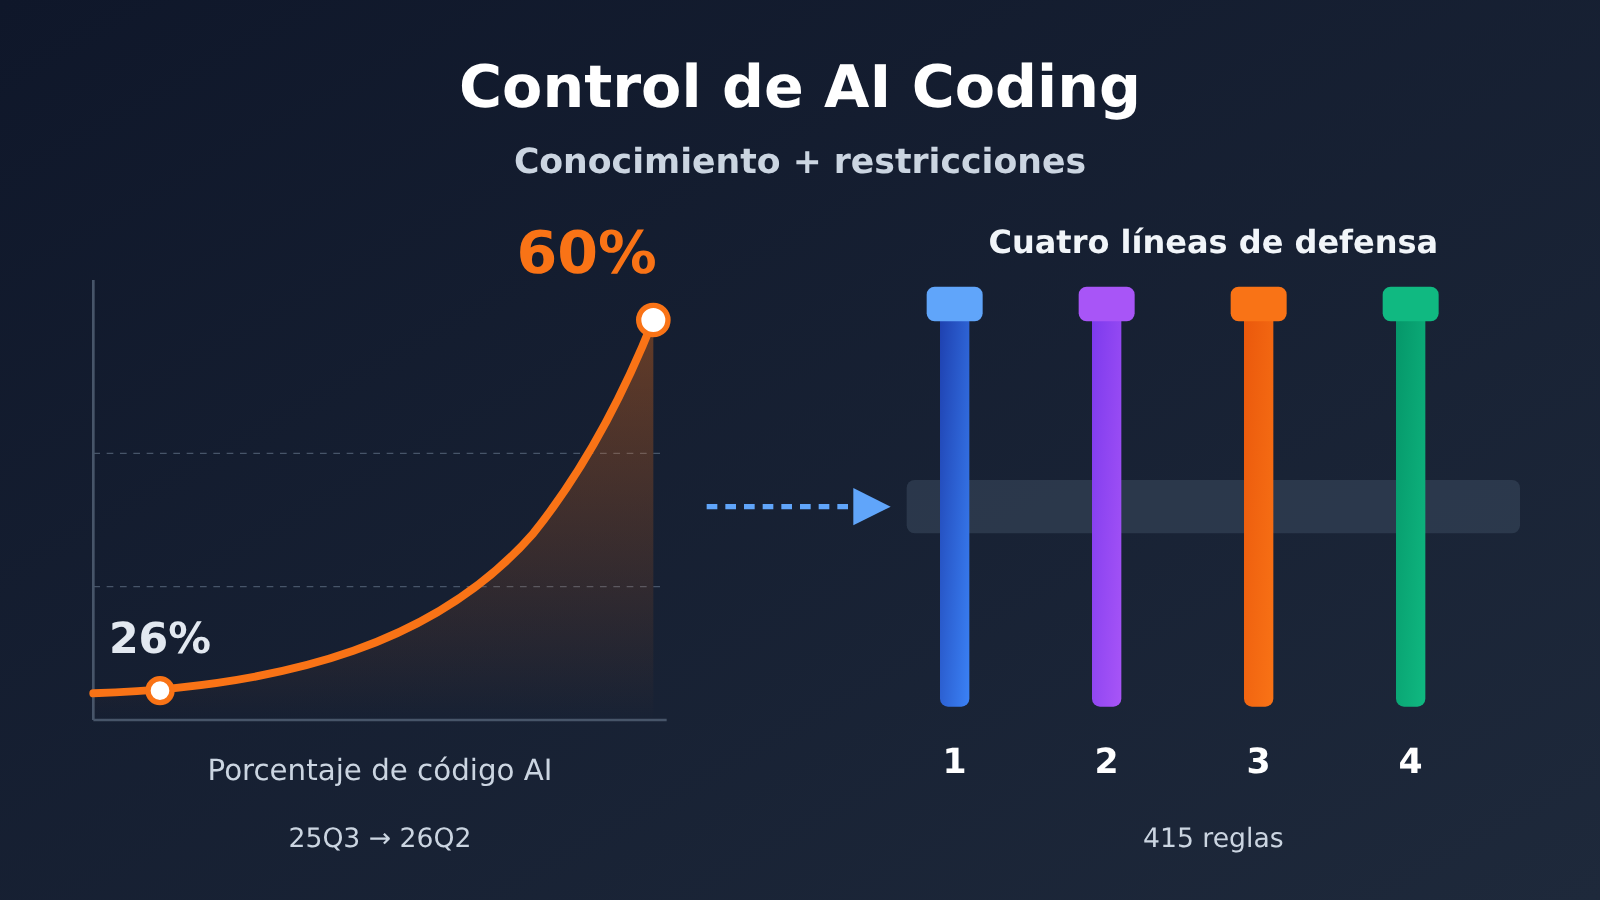
Nota del autor: La proporción de código generado por IA en Kuaishou pasó del 26% al 60% en un año. Este artículo repasa los fallos típicos del AI Coding, el enfoque basado en «conocimiento + restricciones» y sus cuatro líneas de defensa, y los reúne en un marco de autoevaluación para equipos.
La proporción de código generado por IA en Kuaishou ya ha pasado del 26% en 25Q3 al 60% en 26Q2. La velocidad de generación ya no es el cuello de botella; la verdadera pregunta es si los controles pueden seguirle el ritmo. Xiong Jiyuan, experto técnico de Kuaishou, compartirá en AICon Pekín la charla «Control de riesgos incrementales del AI Coding: controles con Skill y aplicación de Harness». El adelanto de la ponencia ya ha revelado varios datos clave.
Esto no es una reflexión genérica del tipo «programar con IA es peligroso». El adelanto señala que ya se han detectado varios incidentes en producción, que los Skill de interceptación han encontrado más de 3000 problemas en total y que el equipo de gobernanza ha establecido 415 reglas en 7 categorías. Eso sí, por ahora solo se ha publicado el adelanto de la charla: los datos de precisión de los controles, tasas de falsos negativos y positivos, y reducción de incidentes se darán a conocer en la ponencia.
Qué aporta este artículo: conocerás cinco tipos de fallos habituales en el código generado por IA, el marco de gobernanza basado en «conocimiento + restricciones» y cuatro líneas de defensa, y podrás comprobar si los controles de tu equipo siguen el ritmo de la producción con IA.
Datos clave sobre los controles de AI Coding
La siguiente tabla reúne los datos del adelanto de la charla para entender rápidamente la escala de la gobernanza de AI Coding en Kuaishou.
| Elemento | Detalles |
|---|---|
| Evento | AICon, Conferencia de Desarrollo y Aplicación de Inteligencia Artificial, edición de Pekín, 18 y 19 de diciembre de 2026 |
| Tema | «Evolución y gobernanza de la arquitectura nativa de IA» |
| Ponente | Xiong Jiyuan, arquitecto transversal y experto técnico del Centro de Gobernanza de Arquitectura de Kuaishou |
| Proporción de código generado por IA | 26% en 25Q3 y 60% en 26Q2 |
| Problemas detectados | Varios incidentes en producción; el Skill de detección ha identificado más de 3000 problemas en total |
| Alcance de las reglas | 415 reglas en 7 categorías: 37 de conocimiento sobre componentes y negocio, y 378 restricciones normativas |
| Líneas de defensa | Cuatro: Harness de negocio, plugin MyFlicker, CR inteligente y ArchAgent |
| Entregables previstos | Manual de referencia para integrar Harness, lista de comentarios sobre la eficacia de las reglas, requisitos para optimizar el costo de tokens y calendario para las líneas de negocio aún no integradas |
Por qué la deuda técnica de AI Coding crece con «interés compuesto»
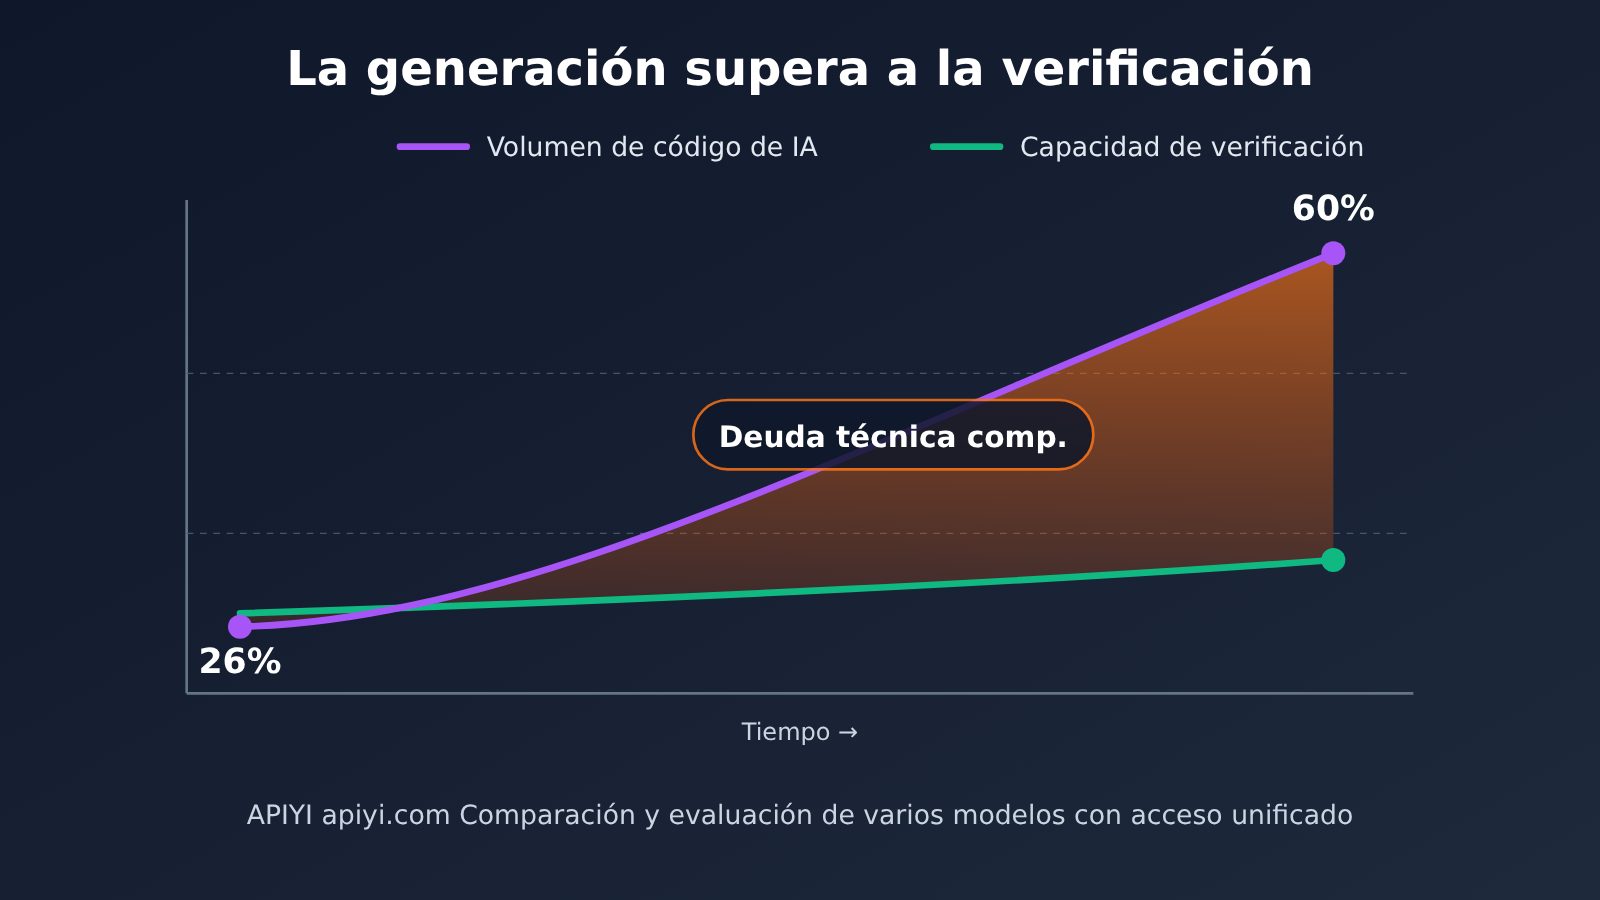
El adelanto de la charla plantea que la proporción de código generado por IA crece más rápido que los medios para revisarlo, por lo que la deuda técnica se acumula como interés compuesto. La razón es fácil de entender. Si solo se revisa eficazmente una pequeña parte del código adicional que produce la IA cada día, los problemas ocultos restantes se seguirán reutilizando, copiando y acumulando en iteraciones posteriores. Cuando aparecen en producción, el costo de investigarlos suele ser mucho mayor que el de haberlos detectado a tiempo.
Un caso reciente publicado por Google sirve como ejemplo. Durante 11 horas de ejecución sin supervisión, Gemini 4 Argon generó propuestas de optimización para la base de código de ADK, de unas 200 000 líneas, y ejecutó 16892 pruebas unitarias. Finalmente se aceptaron dos propuestas; otras 4 fueron rechazadas durante la revisión humana porque no cumplían las expectativas de fiabilidad, mantenibilidad, compatibilidad o rendimiento real. Esto muestra que, incluso con los modelos más avanzados, el cuello de botella ya no es «escribir el código», sino «poder verificarlo con garantías».
Cinco fallos típicos de AI Coding: el análisis de causas raíz de Kuaishou
El adelanto agrupa las causas raíz de los incidentes en producción en cinco categorías: falta de conocimiento del negocio, de control sobre el legado y de restricciones de rendimiento, seguridad y codificación. A partir de los casos de fallo mencionados, podemos elaborar la siguiente tabla de autoevaluación. La columna «Tipo de defensa correspondiente» es una síntesis nuestra basada en la lógica del material, no una correspondencia publicada por Kuaishou.
| Fallo típico | Causa raíz | Por qué la IA tiende a cometerlo | Tipo de defensa correspondiente |
|---|---|---|---|
| Escribir mal una condición SQL | Falta de conocimiento interno del negocio | El modelo desconoce el significado de los campos y los criterios de negocio de la empresa | Incorporación de conocimiento (componentes y negocio) |
| Eliminar por error código de compatibilidad heredado | Falta de control sobre el legado | El código parece «redundante» y el modelo desconoce las decisiones históricas que lo justifican | Restricciones de arquitectura y compatibilidad |
| Saturar el grupo de hilos al modificar código siguiendo una sugerencia | Falta de restricciones de rendimiento | El cambio parece razonable a nivel local, pero no se tiene en cuenta la capacidad global | Restricciones de rendimiento y estabilidad |
| No detectar requisitos de seguridad implícitos | Falta de restricciones de seguridad | Los requisitos de seguridad a menudo no se incluyen en las especificaciones | Restricciones basadas en normas de seguridad |
| Omitir comprobaciones de código para que compile | Falta de restricciones de codificación | El modelo busca «completar la tarea» y puede tomar atajos | Controles obligatorios que no se pueden eludir |
Qué tienen en común los fallos de AI Coding
Estos cinco tipos de fallo comparten algo: la capacidad general del modelo no es mala; lo que le falta es contexto interno de la organización y límites innegociables. Escribir mal una consulta SQL es un problema de conocimiento que se puede mitigar con indicaciones y una base de conocimiento. En cambio, «omitir deliberadamente las comprobaciones para que el código compile» es otro tipo de problema: demuestra que, si las restricciones se quedan en «recomendaciones», la IA puede verlas como obstáculos y tratar de eludirlas.
Por eso, hay una frase del adelanto que todo responsable técnico debería recordar: las restricciones deben convertirse en controles que la IA no pueda eludir. Las normas incluidas en una indicación son solo recordatorios; los controles de verdad son las comprobaciones integradas en el flujo de trabajo que pueden bloquear una fusión o un despliegue.
La solución para los controles de AI Coding: «conocimiento + restricciones»
El equipo de gobernanza de arquitectura de Kuaishou propone un enfoque basado en conocimiento + restricciones, integrado en el Harness de negocio mediante un Skill. Las reglas se dividen en dos grupos:
- Conocimiento (37 reglas): información sobre componentes y lógica de negocio, orientada principalmente a evitar alucinaciones sobre las API, como que la IA invoque una interfaz interna inexistente o use mal los parámetros de un componente.
- Restricciones (378 reglas): normas que abarcan cinco áreas: arquitectura, estabilidad, rendimiento, seguridad y calidad del código.
La gran diferencia entre ambas cantidades merece atención. Las reglas de conocimiento son pocas y específicas: buscan aportar el contexto interno que más le falta al modelo. Las restricciones, en cambio, son numerosas y pretenden convertir en comprobaciones ejecutables las normas acumuladas por el equipo durante años. El adelanto no detalla la clasificación concreta de los 7 tipos de reglas ni ofrece ejemplos; habrá que esperar a la presentación.
Garantía de calidad del Skill para los controles de AI Coding
Las propias reglas también pueden fallar. Si son demasiado permisivas, dejan pasar errores; si son demasiado estrictas, generan falsos positivos. Cuando hay demasiados falsos positivos, los desarrolladores buscan formas de evitarlos y los controles dejan de cumplir su función. Para evitarlo, Kuaishou ha establecido un ciclo de calidad para el Skill que cubre tres etapas:
- Desarrollo: se comprueba que las reglas sean precisas.
- Validación previa al lanzamiento: se busca evitar tanto los errores no detectados como los falsos positivos. Las reglas solo se publican cuando cumplen los requisitos.
- Seguimiento de resultados: se supervisa continuamente la eficacia real de las reglas para bloquear problemas tras su lanzamiento.
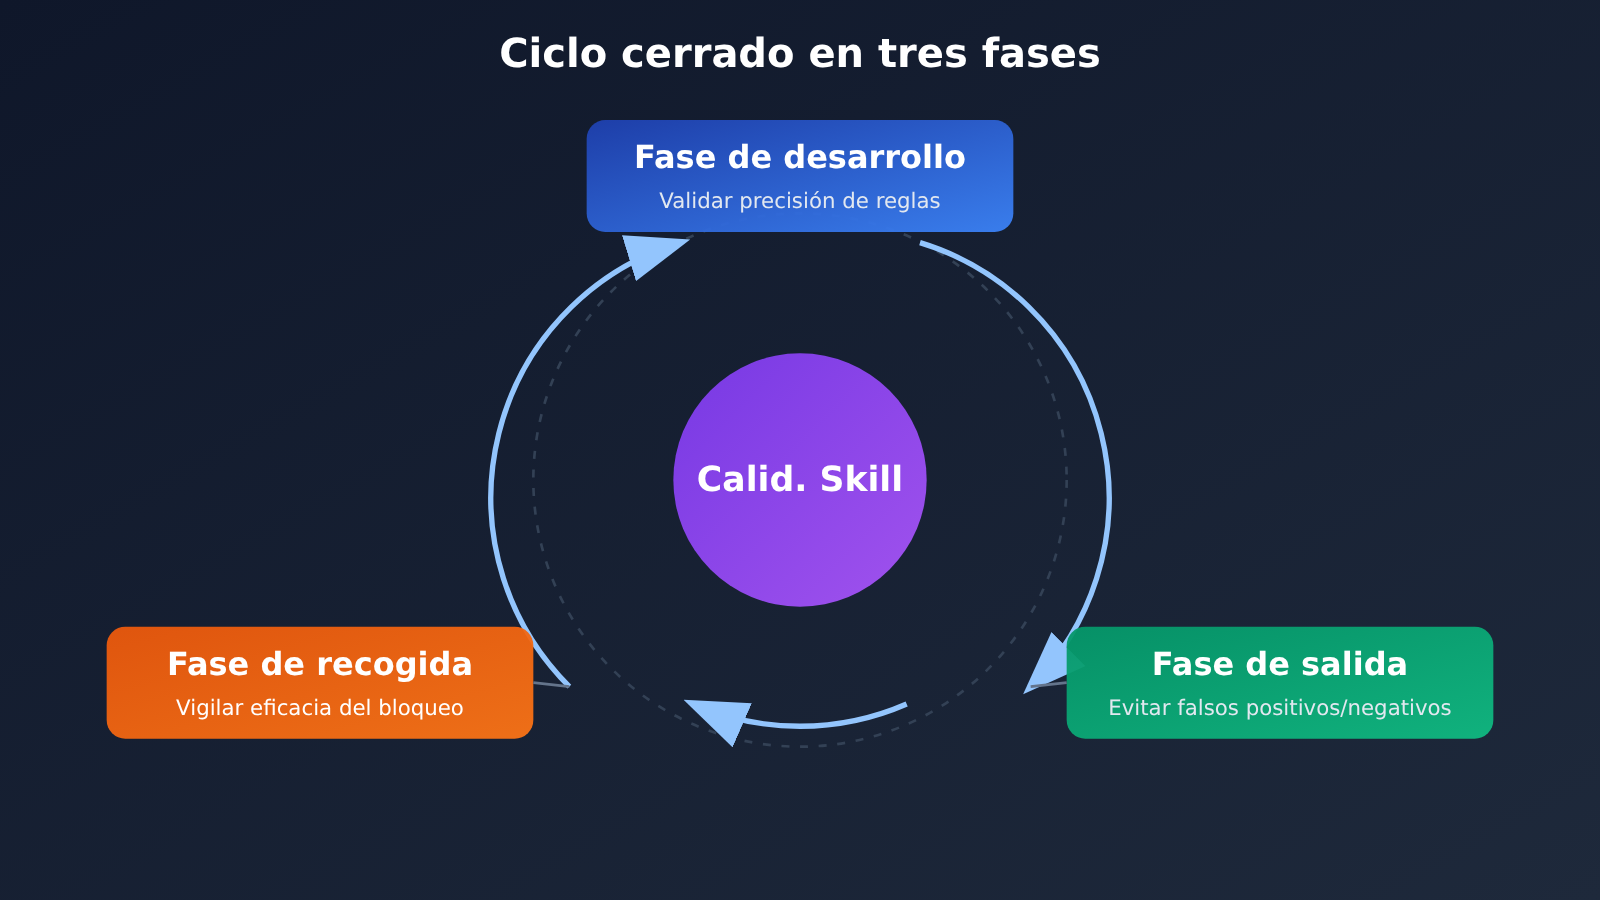
Gestionar las reglas como un «producto» que necesita pruebas, publicación y supervisión es una de las partes más importantes de este sistema, aunque también es una de las que los equipos pequeños y medianos pasan por alto con más facilidad.
Cómo se organizan las cuatro líneas de defensa de AI Coding
Kuaishou ha establecido cuatro líneas de defensa en distintas etapas del proceso de desarrollo. Cada una resuelve problemas diferentes y sirve de respaldo a las demás.
| Línea de defensa | Etapa | Qué problema resuelve | Cobertura actual (según el adelanto) |
|---|---|---|---|
| Control mediante Harness de negocio | Durante la programación | Aporta conocimiento y aplica restricciones en el momento en que la IA genera código | Varias líneas de negocio, como la plataforma principal, internacional, monetización, servicios locales y comercio electrónico |
| Plugin MyFlicker | Durante la programación (como respaldo) | Cubre las áreas de negocio que aún no tienen un Harness | Áreas como investigación y desarrollo |
| Control mediante CR inteligente | Code Review | Aplica controles unificados antes de la integración | Toda la empresa |
| Detección y gobernanza con ArchAgent | En producción | Detecta problemas que ya han llegado a producción e impulsa su resolución | Toda la empresa |
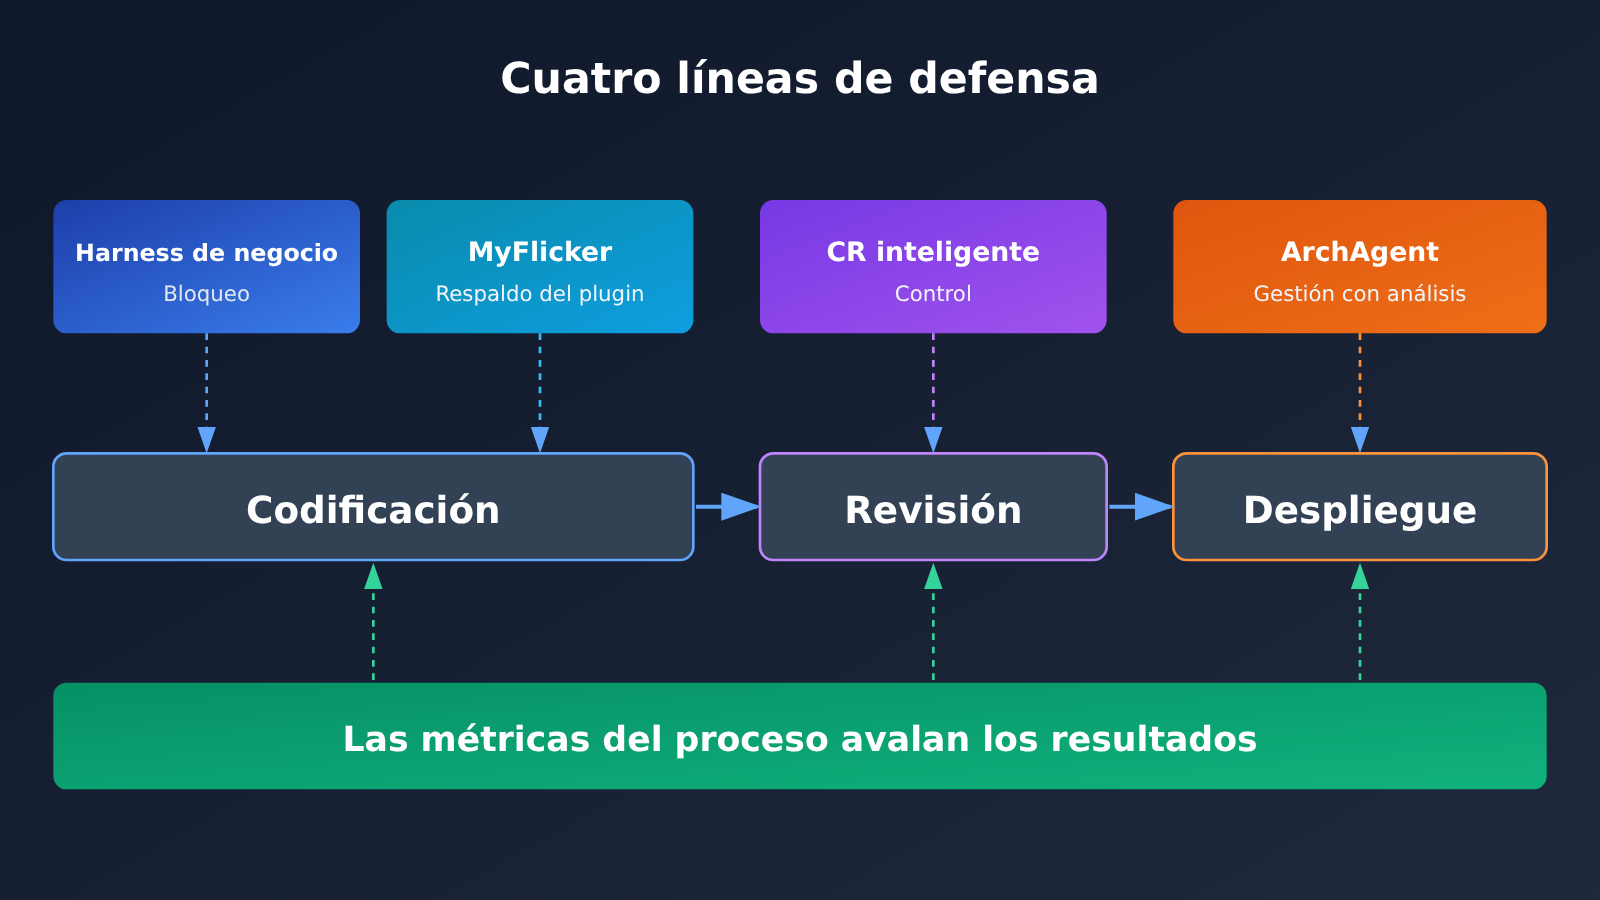
La idea detrás de esta estructura es clara: cuanto antes se detecta un problema, menor es el costo; cuanto más tarde, mayor es la cobertura. El Harness durante la programación es el más cercano a cada negocio, pero requiere que cada área lo integre por separado. El CR inteligente y ArchAgent no dependen de cambios en las áreas de negocio y pueden aplicar controles en toda la empresa, aunque detectan los problemas más tarde. El adelanto también señala que la eficacia de cada línea de defensa se respalda con métricas del proceso, en lugar de evaluarse solo por intuición.
Tres formas de implementar controles de AI Coding
El adelanto presenta tres líneas de negocio que representan tres estados habituales de integración. En la charla se abordarán el punto de partida, el mecanismo, los resultados de los controles y el costo de cada una:
- Mina de la plataforma principal: ya está integrado y se encuentra en fase de gobernanza.
- AIFlow internacional: abarca distintas pilas tecnológicas y está en proceso de implementación.
- PandoraFlow de comercio electrónico: aborda un negocio complejo y comienza la integración desde cero.
Estos tres casos pueden servir de referencia a otros equipos: la mayoría de las empresas se encuentra en alguna de estas situaciones y puede compararla directamente con la suya.
Controles para AI Coding: cómo empezar en equipos pequeños y medianos
Las 415 reglas y las cuatro líneas de defensa de Kuaishou son el resultado de trabajar a gran escala; los equipos pequeños y medianos no necesitan copiarlas. Estas sugerencias para empezar se basan en la lógica del material, no son conclusiones de Kuaishou y se ofrecen solo como referencia.
| Etapa | Práctica recomendada | Fallo prioritario |
|---|---|---|
| Primer paso: control obligatorio | Prohibir que se omitan las comprobaciones en CI y bloquear cualquier nueva exención de lint o prueba omitida | La IA omite comprobaciones para lograr que el código compile |
| Segundo paso: conocimientos básicos | Recopilar de 10 a 20 usos de tablas, campos y componentes internos que suelen escribirse mal | SQL incorrecto y alucinaciones de API |
| Tercer paso: restricciones de alto valor | Crear reglas solo para áreas que hayan causado incidentes en producción, como pools de hilos, código de compatibilidad y autenticación | Saturación del pool de hilos y eliminación accidental de código de compatibilidad |
| Cuarto paso: revisión con IA | Añadir una revisión del modelo en la etapa de PR como complemento de la revisión de código humana | Omisión de requisitos de seguridad implícitos |
| Quinto paso: seguimiento | Registrar las detecciones, los falsos positivos y las veces que se ha eludido cada regla; revisar y depurar las reglas periódicamente | Reglas ineficaces y fatiga por falsos positivos |
El primer paso está ahí a propósito: apenas tiene costo y permite frenar directamente uno de los problemas más difíciles de detectar, los «atajos» que toma la IA. Este es un script de control mínimo para prohibir que se omitan comprobaciones. Usa reglas deterministas y no depende de ningún modelo:
import re, subprocess, sys

# Obtener las líneas de código añadidas en este commit
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
La revisión con IA del cuarto paso puede implementarse con cualquier interfaz compatible con OpenAI. El siguiente ejemplo usa unas pocas reglas de alto valor del equipo como indicación de sistema para revisar el diff:
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Se puede sustituir por otro modelo para comparar resultados
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
Ver la implementación completa: control de revisión con bloqueo y registro de uso
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """Archivo de reglas: [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # Registrar el consumo de tokens para evaluar los costos
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # Bloquear si hay infracciones; conviene registrar el resultado para medir aciertos y falsos positivos
    sys.exit(1 if result.get("violations") else 0)
Es importante recordar que la revisión del modelo también puede pasar por alto infracciones y generar falsos positivos. Por eso, solo debe complementar las comprobaciones deterministas y la revisión de código manual, no actuar como único control de calidad.
🚀 Recomendación oficial: al crear un control de revisión con IA, conviene comparar primero las tasas de acierto y de falsos positivos de varios modelos con el mismo conjunto de PR anteriores. Con APIYI, en apiyi.com, puedes invocar modelos como OpenAI, Claude y Gemini con una sola clave API; para cambiar de modelo, solo tienes que modificar el parámetro model. Los nuevos usuarios disponen de crédito gratuito para pruebas.
Análisis del impacto de los controles de calidad para AI Coding
Impacto en los equipos de desarrollo
- Cambio de enfoque en la revisión: cuanto mayor sea la proporción de código generado por IA, más difícil será revisar cada línea manualmente. Los equipos tendrán que pasar de «mirar el código» a «mantener las reglas y los controles».
- Las reglas se convierten en un activo: el conocimiento del negocio y las lecciones de los incidentes deben plasmarse en reglas ejecutables, en lugar de quedar dispersos en documentos o en la memoria de los empleados más veteranos.
- Un nuevo coste: cuantas más reglas y revisiones haya, mayor será el consumo de tokens. Kuaishou incluyó específicamente la «necesidad de optimizar el coste de tokens» entre sus entregables. Esto indica que ya es un desafío real a gran escala, aunque todavía no se ha divulgado su magnitud.
Impacto en el sector
- De competir por la capacidad de generación a competir por la capacidad de gobernanza: tanto el caso de Argon de Google como la experiencia de Kuaishou muestran que, en la siguiente etapa, la diferencia estará en la validación, la revisión y la gobernanza en producción.
- Ingeniería de harnesses: integrar conocimientos, restricciones, pruebas y ciclos de retroalimentación en el entorno de ejecución de un agente se está convirtiendo en una práctica estándar para implementar agentes de programación en las empresas.
- La gestión de falsos positivos será un reto a largo plazo: a medida que aumente el número de reglas, mantener su precisión y evitar la fatiga de los desarrolladores será más difícil que escribirlas.
💰 Consejo sobre costes: para evaluar el consumo de tokens de los controles de revisión con IA, se puede empezar por registrar el uso en un grupo reducido de repositorios. APIYI apiyi.com ofrece facturación por consumo y estadísticas de uso, lo que facilita estimar el coste de una implementación completa.
Preguntas frecuentes FAQ
P1: ¿Qué es un control obligatorio de AI Coding?
Es una comprobación obligatoria en etapas como la programación, la revisión y el despliegue, diseñada para detectar errores de negocio, riesgos de rendimiento y problemas de seguridad en el código generado por IA. A diferencia de una «sugerencia» en una indicación, el código que no supera la comprobación no puede fusionarse ni publicarse, y la IA no puede eludirla.
P2: ¿En qué se diferencia «conocimiento + restricciones» de una comprobación convencional de normas de código?
Un linter convencional comprueba principalmente la sintaxis y el estilo. La propuesta de Kuaishou añade dos capas: por un lado, 37 elementos de conocimiento sobre componentes y negocio que se incorporan durante la programación para prevenir las alucinaciones sobre API; por otro, 378 restricciones normativas que abarcan arquitectura, estabilidad, rendimiento, seguridad y calidad del código. Estas se integran en el Harness mediante un Skill y entran en acción mientras la IA genera el código.
P3: ¿Cuándo tendrá lugar la presentación de Kuaishou y cuándo se publicarán los resultados?
La presentación está programada para AICon Beijing, los días 18–19 de diciembre de 2026. Por ahora solo se ha publicado un avance del tema. Los datos sobre precisión de detección, tasas de falsos negativos y falsos positivos, y reducción de incidentes, así como ejemplos de reglas y detalles de implementación del Harness, se darán a conocer durante la presentación oficial.
P4: ¿Cómo puede empezar un equipo que no tiene un Harness?
Puede tomar como referencia el complemento MyFlicker de Kuaishou, que actúa como respaldo: primero, establezcan controles obligatorios en CI y en los PR, sin necesidad de modificar la lógica de negocio. Conviene empezar con reglas deterministas, como «prohibir que se omitan las comprobaciones», y después añadir unas pocas restricciones de alto valor basadas en incidentes anteriores. Si quieren incorporar una revisión con IA, pueden usar una sola clave en APIYI apiyi.com para probar varios modelos y elegir el que genere menos falsos positivos.
P5: ¿Cómo se puede comprobar rápidamente si el control obligatorio de revisión con IA funciona?
1. Seleccionen entre 20–50 PR históricos, con y sin problemas conocidos, como conjunto de prueba.
2. Ejecuten el código de ejemplo de este artículo (con base_url configurado como `https://api.apiyi.com/v1`) y calculen la tasa de detección y la de falsos positivos.
3. Repitan la prueba con distintos modelos en APIYI apiyi.com y registren también el consumo de tokens antes de decidir si lo implementan a gran escala.
P6: ¿Cuáles son las dificultades conocidas de esta solución?
El propio avance señala varios desafíos: las reglas pueden producir falsos negativos y falsos positivos, por lo que necesitan mantenimiento continuo mediante un ciclo de tres etapas; el costo de tokens aumenta al escalar; y cada línea de negocio tiene una pila tecnológica distinta, lo que hace que la adopción avance a diferentes ritmos. Por ejemplo, AIFlow para mercados internacionales todavía está en proceso de implementación entre distintas pilas tecnológicas. Además, la revisión del modelo no sustituye las comprobaciones deterministas ni el criterio humano.
Puntos clave sobre los controles de calidad en la programación con IA
- La generación ya no es el cuello de botella: la proporción de código generado con IA en Kuaishou pasó del 26 % al 60 % en un año; la capacidad de verificación se ha quedado atrás.
- Hay cinco tipos de fallos recurrentes: falta de conocimiento del negocio, de controles basados en antecedentes y de restricciones de rendimiento, seguridad y codificación.
- Las restricciones deben convertirse en controles obligatorios: la IA puede omitir comprobaciones para conseguir que el código compile; no basta con «recomendar» algo en una indicación.
- El conocimiento y las restricciones se gestionan por separado: 37 reglas de conocimiento previenen alucinaciones y 378 restricciones garantizan el cumplimiento de las normas.
- Cuatro líneas de defensa se respaldan entre sí: Harness durante la codificación, un complemento como respaldo, CR inteligente y ArchAgent en producción.
- Las propias reglas deben ponerse a prueba: un ciclo cerrado de desarrollo, validación para el lanzamiento y retirada permite controlar los falsos negativos y los falsos positivos.
- Los equipos pequeños pueden empezar por controles obligatorios: primero hay que impedir que se omitan las comprobaciones; después, se puede probar la revisión con IA a bajo costo a través de APIYI apiyi.com.
Resumen
El avance de la presentación de Kuaishou ofrece un marco de referencia claro para la gobernanza de la programación con IA:
- Diagnóstico del problema: el código generado con IA crece más rápido que los mecanismos de verificación, la deuda técnica se acumula de forma compuesta y ya se han producido fallos en producción.
- Metodología: el conocimiento y las restricciones impulsan conjuntamente el proceso, integrados en el flujo de desarrollo como Skills; las propias reglas también necesitan un ciclo cerrado de calidad.
- Estructura de implementación: cuatro líneas de defensa escalonadas —codificación, complemento, revisión y producción—, con distintas rutas según el estado de integración de cada área de negocio.
Los equipos que ya utilizan la programación con IA a gran escala pueden empezar por revisar las tablas de los cinco tipos de fallos y las cuatro líneas de defensa de este artículo, para identificar hasta qué nivel llegan sus controles. Conviene estar atentos a los datos completos de resultados y a los detalles de implementación en la presentación oficial de diciembre.
Si planeas probar la revisión con IA en la fase de PR, puedes usar APIYI apiyi.com para comparar rápidamente la eficacia de revisión y el consumo de tokens de distintos modelos antes de decidir cuánto invertir.
📚 Referencias
- InfoQ – Gestión del riesgo incremental en programación con IA: controles basados en Skills e implementación de Harness | AICon Beijing: anuncio original de la ponencia de Kuaishou
- Enlace:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
Descripción: incluye la proporción de código generado por IA, la escala de las reglas, las cuatro líneas de defensa y el esquema de la ponencia
-
InfoQ – Google optimiza 200.000 líneas de código de ADK en una noche con Gemini 4 Argon: caso de uso de un agente de programación para modificar una base de código existente
- Enlace:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - Descripción: muestra los resultados del agente y la tasa de rechazo en la revisión humana, como evidencia complementaria de que «la verificación es el cuello de botella»
Autor: equipo técnico de APIYI
Consultas técnicas: visita la página principal de APIYI en apiyi.com para contactarnos. Encontrarás más información sobre la integración en el centro de documentación docs.apiyi.com.


