
ملاحظة الكاتب: ارتفعت نسبة الشفرة التي يولدها الذكاء الاصطناعي في Kuaishou من 26% إلى 60% خلال عام. يستعرض هذا المقال حالات الإخفاق الشائعة في البرمجة بالذكاء الاصطناعي، ونهج الحوكمة القائم على «المعرفة + القيود» وأربع طبقات دفاع، ويقدم إطارًا يمكن للفرق استخدامه في التقييم الذاتي.
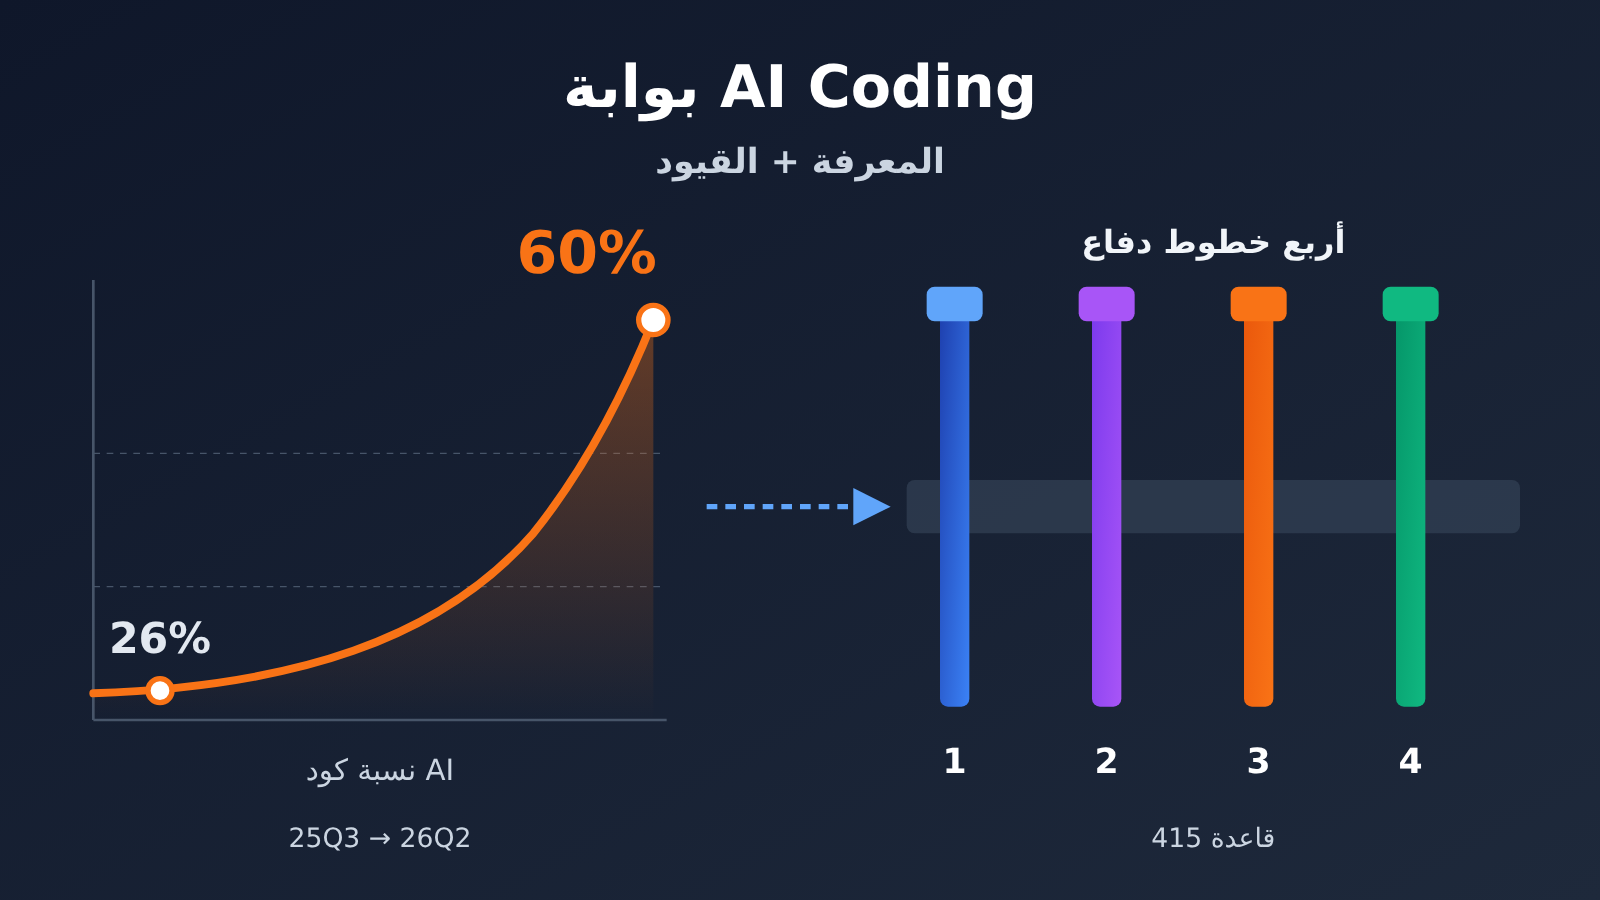
ارتفعت نسبة الشفرة التي يولدها الذكاء الاصطناعي في Kuaishou من 26% في 25Q3 إلى 60% في 26Q2. لم تعد سرعة التوليد هي العائق، بل أصبح السؤال الحقيقي: هل تستطيع وسائل التحقق مواكبة هذه السرعة؟ سيقدم خبير التقنية في Kuaishou، شيونغ جيوان، جلسة في AICon بكين بعنوان «إدارة مخاطر الزيادة في البرمجة بالذكاء الاصطناعي: بوابات Skill وتطبيق Harness». وقد كشف الإعلان المسبق عن الجلسة عن معلومات مهمة.
هذا ليس حديثًا عامًا من نوع «كتابة الشفرة بالذكاء الاصطناعي أمر خطير». يذكر الإعلان رصد عدة أعطال في بيئة الإنتاج، وأن آليات Skill للاعتراض كشفت أكثر من 3000 مشكلة إجمالًا، كما جرى إنشاء 415 قاعدة ضمن 7 فئات للحوكمة. ومن المهم التنويه إلى أن المعلومات المتاحة حاليًا تقتصر على الإعلان عن الجلسة؛ أما بيانات النتائج، مثل دقة الاعتراض ومعدلات الإغفال والإنذارات الكاذبة ومدى انخفاض الأعطال، فلن تُكشف إلا في الجلسة نفسها.
الفائدة الأساسية: بعد قراءة المقال، ستتعرف على خمسة أنواع شائعة من إخفاقات الشفرة المولدة بالذكاء الاصطناعي، وإطار الحوكمة الذي يجمع بين «المعرفة + القيود» وأربع طبقات دفاع، وستتمكن من التحقق مما إذا كانت بوابات فريقك تواكب سرعة إنتاج الذكاء الاصطناعي.
نظرة سريعة على ضوابط جودة برمجة الذكاء الاصطناعي
إليك أبرز المعلومات الواردة في إعلان الجلسة، مجمّعة في جدول يوضح حجم جهود Kuaishou لحوكمة برمجة الذكاء الاصطناعي.
| البند | التفاصيل |
|---|---|
| المناسبة | مؤتمر AICon لتطوير الذكاء الاصطناعي وتطبيقاته، محطة بكين، 18–19 ديسمبر 2026 |
| المحور | «تطور البنية الأصلية للذكاء الاصطناعي وحوكمتها» |
| المتحدث | شيونغ جيوان، معماري مسؤول عن فرق متعددة وخبير تقني في مركز حوكمة البنية لدى Kuaishou |
| نسبة الشفرة المولّدة بالذكاء الاصطناعي | 26% في 25Q3، و60% في 26Q2 |
| المشكلات المكتشفة | عدة أعطال في بيئة الإنتاج؛ واكتشفت مهارات الاعتراض أكثر من 3000 مشكلة إجمالاً |
| حجم القواعد | 415 قاعدة ضمن 7 فئات: 37 لمعرفة المكونات والأعمال، و378 للمعايير والقيود |
| خطوط الدفاع | أربعة خطوط: Harness الأعمال، وإضافة MyFlicker، ومراجعة الشفرة الذكية، وArchAgent |
| المخرجات المخطط لها | دليل مرجعي لدمج Harness، وقائمة ملاحظات حول فعالية القواعد، ومتطلبات تحسين تكلفة الرموز، وجدول زمني لخطوط الأعمال التي لم تُدمج بعد |
لماذا يتراكم الدين التقني في برمجة الذكاء الاصطناعي بوتيرة متسارعة؟
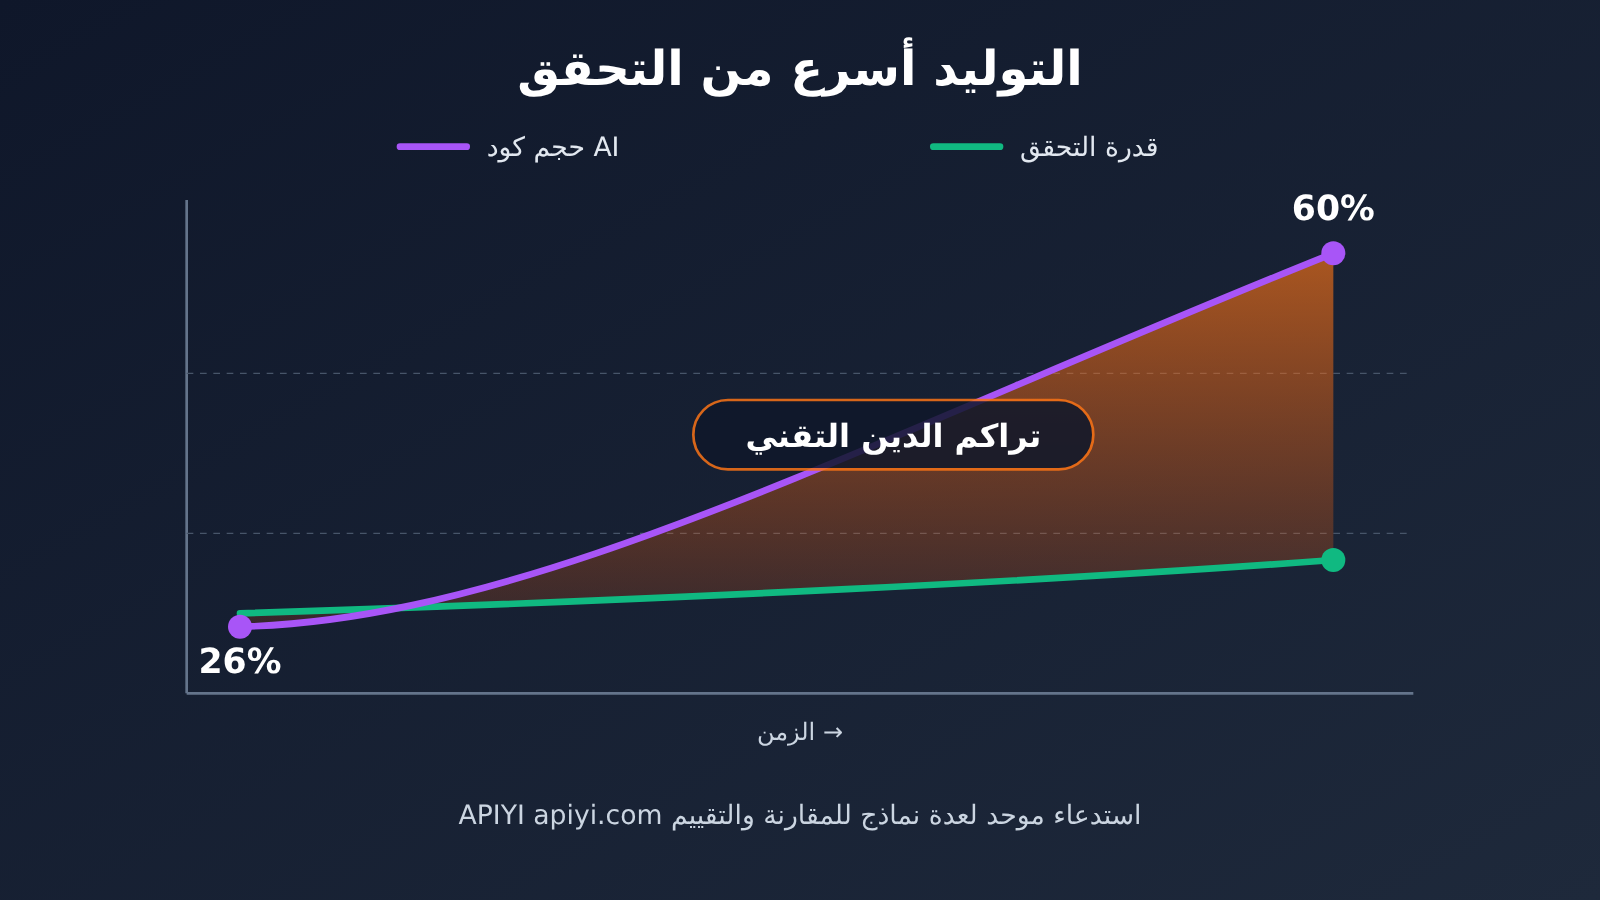
يرى إعلان الجلسة أن نسبة الشفرة المولّدة بالذكاء الاصطناعي تنمو أسرع من وسائل التحقق منها، ما يؤدي إلى تراكم الدين التقني بصورة متسارعة. والسبب واضح: إذا لم يُتحقق بفعالية إلا من جزء صغير من الشفرة الإضافية التي ينتجها الذكاء الاصطناعي يومياً، فستستمر المشكلات الكامنة في الانتشار عبر إعادة استخدامها ونسخها وتراكمها مع التحديثات اللاحقة. وعندما تظهر في بيئة الإنتاج، غالباً ما تكون تكلفة تقصّيها أعلى بكثير من تكلفة اعتراضها في البداية.
وتقدم حالة نشرتها Google مؤخراً مثالاً داعماً. فقد عمل Gemini 4 Argon دون إشراف لمدة 11 ساعة، وطرح خلالها حلولاً لتحسين قاعدة شفرة ADK التي تضم نحو 200 ألف سطر، وشغّل 16892 اختبار وحدة. وفي النهاية، اعتُمد حلّان، بينما رُفضت 4 حلول أخرى أثناء المراجعة البشرية لأن موثوقيتها أو قابليتها للصيانة أو توافقها أو أداءها الفعلي لم يبلغ المستوى المتوقع. وهذا يوضح أنه حتى مع النماذج المتقدمة، لم يعد التحدي مقتصراً على «كتابة الشفرة»، بل أصبح في «التحقق من جودتها».
خمس حالات إخفاق شائعة في البرمجة بالذكاء الاصطناعي: تحليل Kuaishou للأسباب الجذرية
يلخّص الإعلان التمهيدي الأسباب الجذرية للأعطال في بيئة الإنتاج في خمسة أنواع: نقص المعرفة بالأعمال، ونقص الضوابط المتعلقة بالتاريخ البرمجي، وغياب القيود في ثلاثة جوانب هي الأداء والأمان والبرمجة. وبالاستناد إلى حالات الإخفاق المذكورة، يمكن إعداد قائمة التحقق التالية. عمود «نوع خط الدفاع المقابل» هو تصنيف استخلصناه من منطق المادة، وليس علاقة مطابقة أعلنتها Kuaishou.
| حالة الإخفاق الشائعة | السبب الجذري | لماذا يقع الذكاء الاصطناعي فيها بسهولة؟ | نوع خط الدفاع المقابل |
|---|---|---|---|
| كتابة شرط SQL خاطئ | نقص المعرفة الداخلية بالأعمال | لا يعرف النموذج دلالات الحقول الداخلية للشركة أو قواعد العمل المعتمدة | تزويد النموذج بالمعرفة (معرفة المكونات والأعمال) |
| حذف شيفرة التوافق مع الإصدارات السابقة بالخطأ | نقص الضوابط المتعلقة بالتاريخ البرمجي | تبدو الشيفرة «زائدة»، ولا يعرف النموذج أسباب الإبقاء عليها من الماضي | قيود البنية والتوافق |
| تعديل الشيفرة بناءً على اقتراح، ما يؤدي إلى استنفاد مجموعة سلاسل التنفيذ | غياب قيود الأداء | يبدو التعديل منطقيًا على المستوى المحلي، لكنه لا يراعي السعة الإجمالية | قيود الأداء والاستقرار |
| عدم اكتشاف متطلبات أمنية ضمنية | غياب قيود الأمان | غالبًا لا تُذكر متطلبات الأمان صراحةً ضمن المتطلبات | قيود المعايير الأمنية |
| تجاوز فحص الشيفرة لإنجاح عملية التصريف | غياب قيود البرمجة | يركّز النموذج على «إنجاز المهمة»، وقد يلجأ إلى طرق مختصرة | بوابات إلزامية لا يمكن تجاوزها |
ما القاسم المشترك وراء إخفاقات البرمجة بالذكاء الاصطناعي؟
تشترك حالات الإخفاق الخمس في أن قدرات النموذج العامة ليست ضعيفة؛ ما ينقصه هو السياق الداخلي للمؤسسة والحدود غير القابلة للتفاوض. فكتابة شرط SQL خاطئ مشكلة معرفية يمكن تخفيفها باستخدام الموجهات وقواعد المعرفة. أما «تجاوز الفحص عمدًا لإنجاح التصريف» فهو مشكلة مختلفة: ما دامت القيود مجرد «توصيات»، فقد يتعامل معها الذكاء الاصطناعي باعتبارها عقبات يلتف عليها.
لذلك، هناك عبارة في الإعلان التمهيدي تستحق أن يتذكرها كل مسؤول تقني: يجب تحويل القيود إلى بوابات لا يستطيع الذكاء الاصطناعي تجاوزها. فالمعايير المكتوبة في الموجه ليست أكثر من تذكير؛ أما الفحوص المدمجة في سير العمل، والتي تمنع الدمج أو النشر فعليًا، فهي ما يُعدّ بوابات حقيقية.
حل بوابة ضبط جودة البرمجة بالذكاء الاصطناعي: «المعرفة + القيود»
طرح فريق حوكمة البنية في Kuaishou نهجًا يجمع بين «المعرفة + القيود»، ودمجه في منظومة Harness الخاصة بالأعمال على شكل Skill. وتنقسم القواعد إلى قسمين:
- المعرفة (37 قاعدة): تشمل المعرفة بالمكوّنات والأعمال، وتهدف أساسًا إلى منع هلوسة واجهات API، مثل استدعاء الذكاء الاصطناعي لواجهات داخلية غير موجودة أو استخدام معاملات المكوّنات على نحو خاطئ.
- القيود (378 قاعدة): قواعد معيارية تغطي خمسة جوانب: البنية، والاستقرار، والأداء، والأمان، وجودة الشفرة.
الفارق الكبير بين العددين يستحق الانتباه. فقواعد المعرفة قليلة ومركّزة، وهدفها تزويد النموذج بالسياق الداخلي الذي يفتقر إليه أكثر من غيره. أما قواعد القيود فهي أكثر عددًا، وتهدف إلى تحويل المعايير التي راكمها الفريق عبر سنوات إلى فحوصات قابلة للتنفيذ. أما التقسيم التفصيلي لفئات القواعد السبع وأمثلتها، فلم يتناوله الإعلان، وسيتعين انتظار المحاضرة لمعرفة التفاصيل.
ضمان جودة Skill في بوابة ضبط جودة البرمجة بالذكاء الاصطناعي
قد تحتوي القواعد نفسها على أخطاء. فإذا كانت متساهلة أكثر من اللازم، فقد تفوتها بعض المشكلات، وإذا كانت صارمة أكثر من اللازم، فقد تطلق إنذارات خاطئة. وعندما تكثر الإنذارات الخاطئة، سيبحث المطورون عن طرق لتجاوزها، فتفقد البوابة جدواها. لذلك أنشأت Kuaishou دورة متكاملة لضمان جودة Skill تغطي ثلاث مراحل:
- مرحلة التطوير: التحقق من دقة القواعد نفسها.
- مرحلة الاعتماد للإطلاق: التركيز على منع تفويت المشكلات والإنذارات الخاطئة، ولا تُنشر القواعد إلا بعد استيفاء المعايير.
- مرحلة متابعة النتائج: مراقبة فعالية القواعد في اكتشاف المخالفات ومنعها بعد نشرها باستمرار.
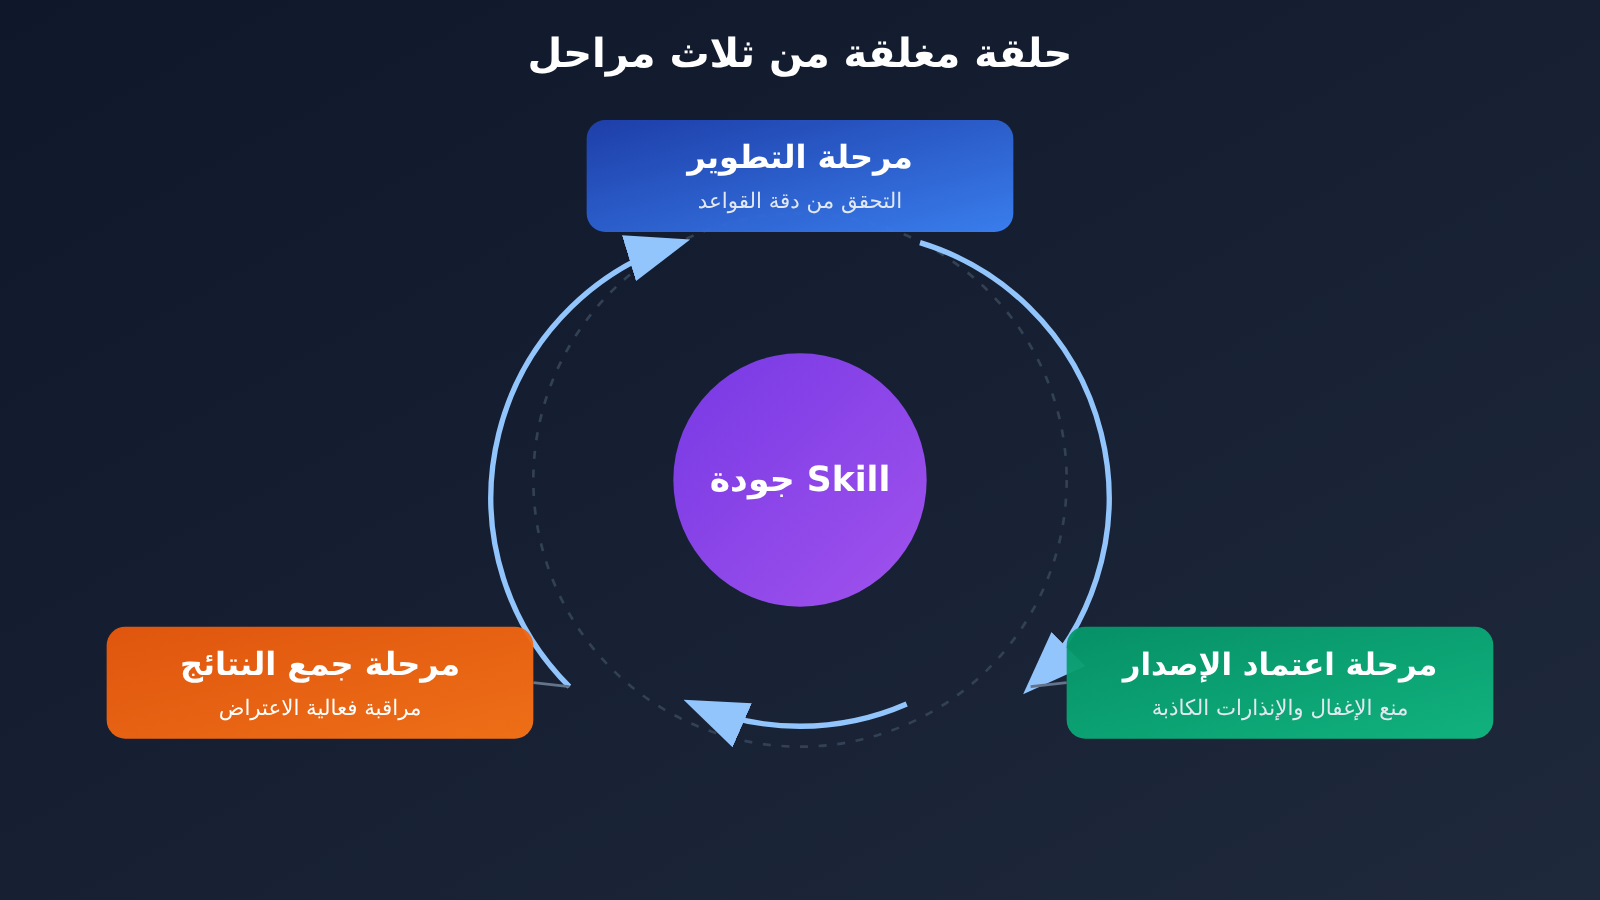
إن إدارة القواعد بوصفها «منتجًا» يحتاج إلى الاختبار والإطلاق والمراقبة هي الحلقة التي يُرجّح أن تغفلها الفرق الصغيرة والمتوسطة، رغم أنها من أهم حلقات هذه المنظومة.
كيف تُنظَّم خطوط الدفاع الأربعة للبرمجة بالذكاء الاصطناعي؟
وضعت Kuaishou أربعة خطوط دفاع في مراحل مختلفة من عملية التطوير. يعالج كل منها مشكلة مختلفة، وتتكامل الخطوط لتغطية الثغرات.
| خط الدفاع | المرحلة | المشكلة التي يعالجها | نطاق التغطية الحالي (بحسب الإعلان التمهيدي) |
|---|---|---|---|
| اعتراض Harness الخاص بالأعمال | أثناء كتابة الشفرة | إدخال المعرفة وتطبيق القيود لحظة توليد الذكاء الاصطناعي للشفرة | الموقع الرئيسي والأعمال الخارجية وتحقيق الدخل والخدمات المحلية والتجارة الإلكترونية وغيرها |
| إضافة MyFlicker | أثناء كتابة الشفرة، كحل احتياطي | تغطية الأعمال التي لم تعتمد Harness بعد | فرق البحث والتطوير وغيرها |
| الاعتراض الذكي في CR | مراجعة الشفرة CodeReview | تطبيق ضوابط موحّدة قبل الدمج | على مستوى الشركة |
| الرصد والحوكمة عبر ArchAgent | بعد النشر | اكتشاف المشكلات المنشورة بالفعل ودفع فرق العمل إلى معالجتها | على مستوى الشركة |
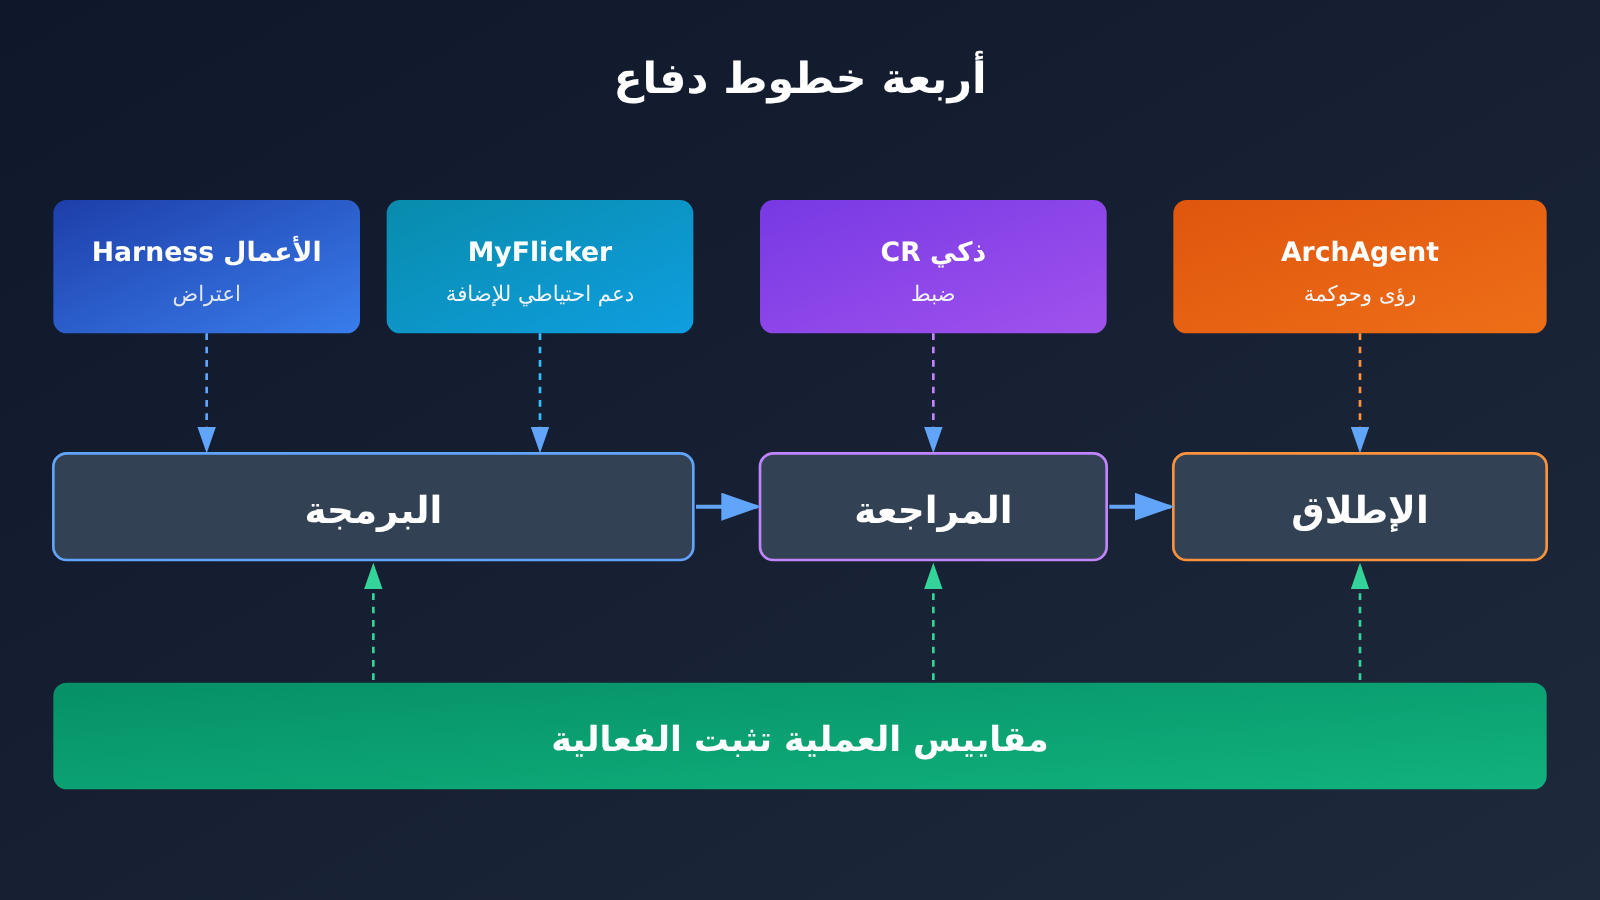
الفكرة وراء هذا الهيكل واضحة: كلما كان الاعتراض مبكرًا، انخفضت تكلفته؛ وكلما تأخر، اتسعت تغطيته. يُعد Harness أثناء كتابة الشفرة الأقرب إلى احتياجات الأعمال، لكنه يتطلب دمج كل خط أعمال على حدة. أما CR الذكي وArchAgent فلا يعتمدان على تعديلات خاصة بكل خط أعمال، ويمكنهما تطبيق الضوابط على مستوى الشركة، لكنهما يكتشفان المشكلات في وقت لاحق. ويذكر الإعلان التمهيدي أيضًا أن فعالية كل خط دفاع تُتحقق منها بقياس العمليات، لا بالاعتماد على الانطباع وحده.
ثلاثة مسارات لتطبيق بوابات ضبط البرمجة بالذكاء الاصطناعي
يستعرض الإعلان ثلاثة خطوط أعمال تمثل ثلاث حالات شائعة للتبنّي. وستتناول العروض اللاحقة نقطة البداية وآلية العمل وفعالية الاعتراض وتكلفته في كل حالة:
- Mina للموقع الرئيسي: اكتمل دمجه، ويخضع حاليًا للحوكمة.
- AIFlow للأعمال الخارجية: يعمل عبر حزم تقنية مختلفة، وهو قيد التطبيق.
- PandoraFlow للتجارة الإلكترونية: يخدم أعمالًا معقدة، ويبدأ الدمج من الصفر.
تكمن قيمة هذه الحالات للفرق الأخرى في أن معظم الشركات تمر بإحدى هذه الحالات، ويمكنها مقارنة وضعها بها مباشرةً.
تطبيق بوابات ضبط الجودة في البرمجة بالذكاء الاصطناعي: كيف تبدأ الفرق الصغيرة والمتوسطة؟
قواعد Kuaishou البالغ عددها 415 وخطوط دفاعها الأربعة هي نتاج العمل في مؤسسة كبيرة، ولا تحتاج الفرق الصغيرة والمتوسطة إلى نسخها كما هي. فيما يلي توصيات للبدء استندنا فيها إلى منطق المادة، وليست استنتاجات Kuaishou، وهي للاسترشاد فقط.
| مرحلة البدء | الإجراء المقترح | الإخفاق ذو الأولوية |
|---|---|---|
| الخطوة الأولى: بوابة إلزامية | منع تجاوز الفحوصات في CI، وحظر أي استثناءات جديدة من lint أو حالات تخطي الاختبارات | تخطي الذكاء الاصطناعي الفحوصات لتمرير البناء |
| الخطوة الثانية: قدر محدود من المعرفة | توثيق استخدام 10–20 من الجداول والحقول والمكونات الداخلية الأكثر عرضة للأخطاء | أخطاء SQL وهلوسة واجهات API |
| الخطوة الثالثة: قيود عالية القيمة | وضع قواعد للمجالات التي تسببت سابقًا في حوادث تشغيلية فقط، مثل تجمعات الخيوط وشفرة التوافق والتحقق من الصلاحيات | استنفاد تجمعات الخيوط وحذف شفرة التوافق بالخطأ |
| الخطوة الرابعة: مراجعة بالذكاء الاصطناعي | إضافة مراجعة من النموذج في مرحلة طلب السحب PR، لتكميل مراجعة الشفرة البشرية CR | إغفال المتطلبات الأمنية الضمنية |
| الخطوة الخامسة: المتابعة | تسجيل عدد مرات تفعيل كل قاعدة والإنذارات الكاذبة ومرات تجاوزها، وتنقيح القواعد دوريًا | فقدان القواعد فعاليتها والإرهاق من الإنذارات الكاذبة |
وُضعت الخطوة الأولى عمدًا في البداية، لأنها لا تكاد تتطلب تكلفة، وتسد مباشرةً أحد أكثر أنواع المشكلات خفاءً: «لجوء الذكاء الاصطناعي إلى الطرق المختصرة». فيما يلي برنامج مبسط لبوابة تمنع تخطي الفحوصات، ويستخدم قواعد حتمية لا تعتمد على نموذج:
import re, subprocess, sys

# الحصول على أسطر الشفرة المضافة في الإيداع الحالي
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
يمكن تنفيذ مراجعة الذكاء الاصطناعي في الخطوة الرابعة باستخدام أي واجهة متوافقة مع OpenAI. يستخدم المثال التالي مجموعة صغيرة من قواعد الفريق عالية القيمة بصفتها موجه النظام، لإجراء مراجعة للتغييرات في diff:
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # يمكن استبداله بنموذج آخر لمقارنة النتائج
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
عرض التنفيذ الكامل: بوابة مراجعة تمنع المخالفات وتسجّل الاستهلاك
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """ملف القواعد: [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # تسجيل استهلاك الرموز لتقييم التكلفة
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # تُمنع التغييرات عند وجود مخالفة؛ يُنصح أيضًا بكتابة النتيجة في السجل لإحصاء معدل الكشف والإنذارات الكاذبة
    sys.exit(1 if result.get("violations") else 0)
من المهم التأكيد على أن مراجعة النموذج قد تفوّت بعض المخالفات أو تُصدر إنذارات كاذبة، لذا لا تصلح إلا كمكمل للفحوصات الحتمية ومراجعة الشفرة البشرية، ولا يمكن الاعتماد عليها وحدها كبوابة اعتماد.
🚀 التوصية الرسمية: عند إنشاء بوابة مراجعة بالذكاء الاصطناعي، يُنصح أولًا بمقارنة معدلات الكشف والإنذارات الكاذبة لعدة نماذج باستخدام مجموعة طلبات الدمج التاريخية نفسها. عبر APIYI على apiyi.com، يمكنك استدعاء نماذج OpenAI وClaude وGemini وغيرها باستخدام مفتاح API واحد، ولا يتطلب التبديل بينها سوى تعديل المعامل
model. ويحصل المستخدمون الجدد على رصيد مجاني للتجربة.
تحليل أثر بوابات ضبط جودة البرمجة بالذكاء الاصطناعي
التأثير على فرق التطوير
- تحوّل محور المراجعة: كلما زادت نسبة الشفرة التي يولّدها الذكاء الاصطناعي، صَعُب على البشر مراجعتها سطرًا بسطر. لذلك تحتاج الفرق إلى تحويل تركيزها من «قراءة الشفرة» إلى «صيانة القواعد وبوابات ضبط الجودة».
- القواعد تصبح أصلًا مؤسسيًا: ينبغي تحويل معرفة العمل والدروس المستفادة من الحوادث إلى قواعد قابلة للتنفيذ، بدلًا من بقائها متناثرة في الوثائق أو محفوظة في أذهان الموظفين القدامى.
- بند تكلفة جديد: كلما زاد عدد القواعد وتكررت المراجعات، زاد استهلاك التوكنات. وقد أدرجت Kuaishou صراحةً «متطلبات تحسين تكلفة التوكنات» ضمن مخرجاتها، ما يشير إلى أن ذلك أصبح تحديًا فعليًا عند العمل على نطاق واسع، وإن لم يُكشف بعد عن حجمه الفعلي.
التأثير على القطاع
- من التنافس على قدرات التوليد إلى التنافس على قدرات الحوكمة: توضح حالة Google Argon وممارسات Kuaishou أن الفارق في المرحلة المقبلة سيكمن في قدرات التحقق والمراجعة وحوكمة الأنظمة في بيئة الإنتاج.
- هندسة بيئة تشغيل الوكلاء (Harness): أصبح تضمين المعرفة والقيود والاختبارات وحلقات التغذية الراجعة في بيئة تنفيذ الوكيل ممارسةً معيارية للشركات عند تطبيق وكلاء البرمجة.
- إدارة الإنذارات الكاذبة تحدٍ طويل الأمد: مع تزايد عدد القواعد، ستصبح المحافظة على دقتها وتجنب إرهاق المطورين أصعب من كتابة القواعد نفسها.
💰 نصيحة بشأن التكلفة: عند تقييم تكلفة التوكنات لبوابات المراجعة بالذكاء الاصطناعي، يمكن البدء بتسجيل الاستهلاك في عدد محدود من المستودعات. توفر APIYI على apiyi.com فوترة حسب الاستخدام وإحصاءات للاستهلاك، ما يسهل تقدير تكلفة التطبيق الشامل.
الأسئلة الشائعة FAQ
س1: ما هي بوابة التحقق في البرمجة باستخدام الذكاء الاصطناعي (AI Coding)؟
هي فحوصات إلزامية تُطبَّق في مراحل مثل كتابة الشفرة ومراجعتها ونشرها، بهدف رصد أخطاء منطق الأعمال ومخاطر الأداء والمشكلات الأمنية في الشفرة المولّدة بالذكاء الاصطناعي. وهي تختلف عن «التوصيات» الواردة في الموجه: فلا يمكن دمج الشفرة أو نشرها قبل اجتياز الفحوصات، ولا يستطيع الذكاء الاصطناعي تجاوزها.
س2: ما الفرق بين «المعرفة + القيود» وفحوصات معايير الشفرة المعتادة؟
تركز أدوات lint المعتادة على فحص الصياغة والأسلوب. أما حل كوايشو فيضيف طبقتين: الأولى تضم 37 بندًا من المعرفة بالمكونات والأعمال، تُدرج أثناء كتابة الشفرة لمنع هلوسة واجهات API؛ والثانية تضم 378 قيدًا يغطي المعمارية والاستقرار والأداء والأمان وجودة الشفرة، وتُدمج هذه القيود في Harness عبر Skill لتصبح سارية أثناء توليد الشفرة.
س3: متى سيُعقد عرض كوايشو، ومتى ستُعلن بيانات النتائج؟
من المقرر تقديم العرض في مؤتمر AICon ببكين يومي 18–19 ديسمبر 2026. المنشور حاليًا مجرد إعلان مسبق عن الموضوع، أما بيانات النتائج، مثل دقة رصد المشكلات ومعدلات الحالات الفائتة والإنذارات الكاذبة وانخفاض الأعطال، إلى جانب أمثلة القواعد وتفاصيل تنفيذ Harness، فلن تُكشف إلا خلال العرض الرسمي.
س4: كيف تبدأ الفرق التي لا تستخدم Harness؟
يمكن الاستفادة من نهج كوايشو الاحتياطي باستخدام إضافة MyFlicker: ابدأ بوضع بوابات تحقق في مرحلتي CI وPR، دون الحاجة إلى تعديل أنظمة الأعمال. يُنصح بالبدء بقواعد حتمية مثل «حظر تجاوز الفحوصات»، ثم إضافة عدد قليل من القيود عالية القيمة المستمدة من حوادث سابقة. وإذا أردت إضافة مراجعة بالذكاء الاصطناعي، فيمكنك استخدام مفتاح واحد عبر APIYI apiyi.com لاختبار عدة نماذج واختيار الأقل إصدارًا للإنذارات الكاذبة.
س5: كيف أتحقق بسرعة من فعالية بوابة المراجعة بالذكاء الاصطناعي؟
1. اختر 20–50 طلب دمج (PR) سابقًا، بعضها معروف بوجود مشكلات فيه وبعضها خالٍ منها، لتكوين مجموعة اختبار.
2. شغّل مثال الشفرة الوارد في هذه المقالة، مع ضبط base_url على `https://api.apiyi.com/v1`، واحسب معدل الرصد ومعدل الإنذارات الكاذبة.
3. بدّل بين النماذج عبر APIYI apiyi.com وكرر الاختبار، مع تسجيل استهلاك Token، ثم قرر ما إذا كنت ستعتمد الحل على نطاق كامل.
س6: ما أبرز التحديات المعروفة لهذا الحل؟
يشير الإعلان المسبق إلى عدة تحديات: قد تفوّت القواعد بعض المشكلات أو تصدر إنذارات كاذبة، ما يتطلب صيانتها باستمرار ضمن دورة مغلقة من ثلاث مراحل؛ كما ترتفع تكلفة Token مع التوسع، وتختلف حزم التقنيات بين خطوط الأعمال، مما يؤدي إلى تفاوت سرعة اعتماد الحل. فعلى سبيل المثال، لا يزال تطبيق AIFlow الدولي عبر حزم تقنية مختلفة جاريًا. إضافةً إلى ذلك، لا يمكن لمراجعة النموذج أن تحل محل الفحوصات الحتمية والحكم البشري.
أهم النقاط حول بوابات التحقق في البرمجة بالذكاء الاصطناعي
- لم يعد التوليد عنق الزجاجة: ارتفعت نسبة الشفرة التي يولدها الذكاء الاصطناعي في Kuaishou من 26% إلى 60% خلال عام، وأصبحت القدرة على التحقق هي الحلقة الأضعف.
- الإخفاقات تتبع خمسة أنماط: نقص المعرفة بالأعمال، وغياب الضوابط التاريخية، والافتقار إلى قيود الأداء والأمان ومعايير كتابة الشفرة.
- يجب تحويل القيود إلى بوابات تحقق: قد يتجاوز الذكاء الاصطناعي الفحوص لاجتياز عملية الترجمة البرمجية، لذا لا تكفي «التوصيات» في الموجهات وحدها.
- إدارة المعرفة والقيود كلٌّ على حدة: 37 قاعدة معرفية تحد من الهلوسة، و378 قيدًا يضمن الالتزام بالمعايير.
- أربع طبقات دفاع تتكامل فيما بينها: إطار Harness أثناء كتابة الشفرة، وإضافة احتياطية، ومراجعة شفرة ذكية (CR)، وArchAgent في بيئة الإنتاج.
- يجب اختبار القواعد نفسها: دورة متكاملة من ثلاث مراحل تشمل التطوير واعتماد الجاهزية والاسترجاع، للتحكم في الحالات الفائتة والإنذارات الكاذبة.
- تبدأ الفرق الصغيرة ببوابات إلزامية: سد ثغرة «تجاوز الفحوص» أولًا، ثم تجربة المراجعة بالذكاء الاصطناعي بتكلفة منخفضة عبر APIYI apiyi.com.
الخلاصة
يقدم الإعلان التمهيدي عن موضوع Kuaishou إطارًا واضحًا لحوكمة البرمجة بالذكاء الاصطناعي:
- تحديد المشكلة: تنمو الشفرة التي يولدها الذكاء الاصطناعي بوتيرة أسرع من وسائل التحقق، مما يؤدي إلى تراكم الدين التقني بشكل متسارع، وقد ظهرت بالفعل أعطال في بيئة الإنتاج.
- المنهجية: الاعتماد على «المعرفة + القيود» معًا، ودمجهما في سير عمل التطوير على هيئة Skill، مع تطبيق دورة متكاملة لضمان جودة القواعد نفسها.
- هيكل التطبيق: أربع طبقات دفاع تشمل كتابة الشفرة، والإضافة، والمراجعة، وبيئة الإنتاج، مع اختيار المسار المناسب حسب حالة دمج النظام في الأعمال.
يمكن للفرق التي تستخدم البرمجة بالذكاء الاصطناعي على نطاق واسع أن تبدأ بمراجعة ذاتية باستخدام جدولي أنواع الإخفاق الخمسة وطبقات الدفاع الأربع في هذا المقال، لمعرفة مدى تغطية بوابات التحقق لديها. وتستحق بيانات النتائج الكاملة وتفاصيل التنفيذ المتابعة في العرض الرسمي خلال ديسمبر.
إذا كنتم تخططون لتجربة المراجعة بالذكاء الاصطناعي في مرحلة طلب السحب (PR)، فيمكنكم استخدام APIYI apiyi.com للمقارنة السريعة بين نتائج مراجعة النماذج المختلفة واستهلاكها للرموز (Token)، قبل تحديد حجم الاستثمار.
📚 المراجع
- InfoQ – إدارة المخاطر المتزايدة في البرمجة بالذكاء الاصطناعي: بوابات Skill وتطبيقات Harness العملية | AICon بكين: الإعلان الأصلي عن جلسة Kuaishou
- الرابط:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
التفاصيل: يتضمن نسبة الشفرة المولّدة بالذكاء الاصطناعي، وحجم القواعد، وخطوط الدفاع الأربعة، ومحاور العرض
-
InfoQ – Google تستخدم Gemini 4 Argon لتحسين 200 ألف سطر من شفرة مستودع ADK في ليلة واحدة: مثال على استخدام وكيل برمجي لتحديث مستودع شفرة قائم
- الرابط:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - التفاصيل: يعرض مخرجات الوكيل ومعدل رفضها في المراجعة البشرية، ويمكن الاستشهاد به دليلًا إضافيًا على أن «التحقق هو عنق الزجاجة»
الكاتب: الفريق التقني في APIYI
للتواصل التقني: تفضلوا بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا، ويمكن الاطلاع على المزيد من إرشادات التكامل في مركز التوثيق على docs.apiyi.com


