
Nota do autor: a proporção de código gerado por IA na Kuaishou subiu de 26% para 60% em um ano. Este artigo apresenta falhas típicas do AI Coding, a abordagem baseada em “conhecimento + restrições” e quatro linhas de defesa em camadas. Também organiza essas informações em um roteiro de verificação para equipes.
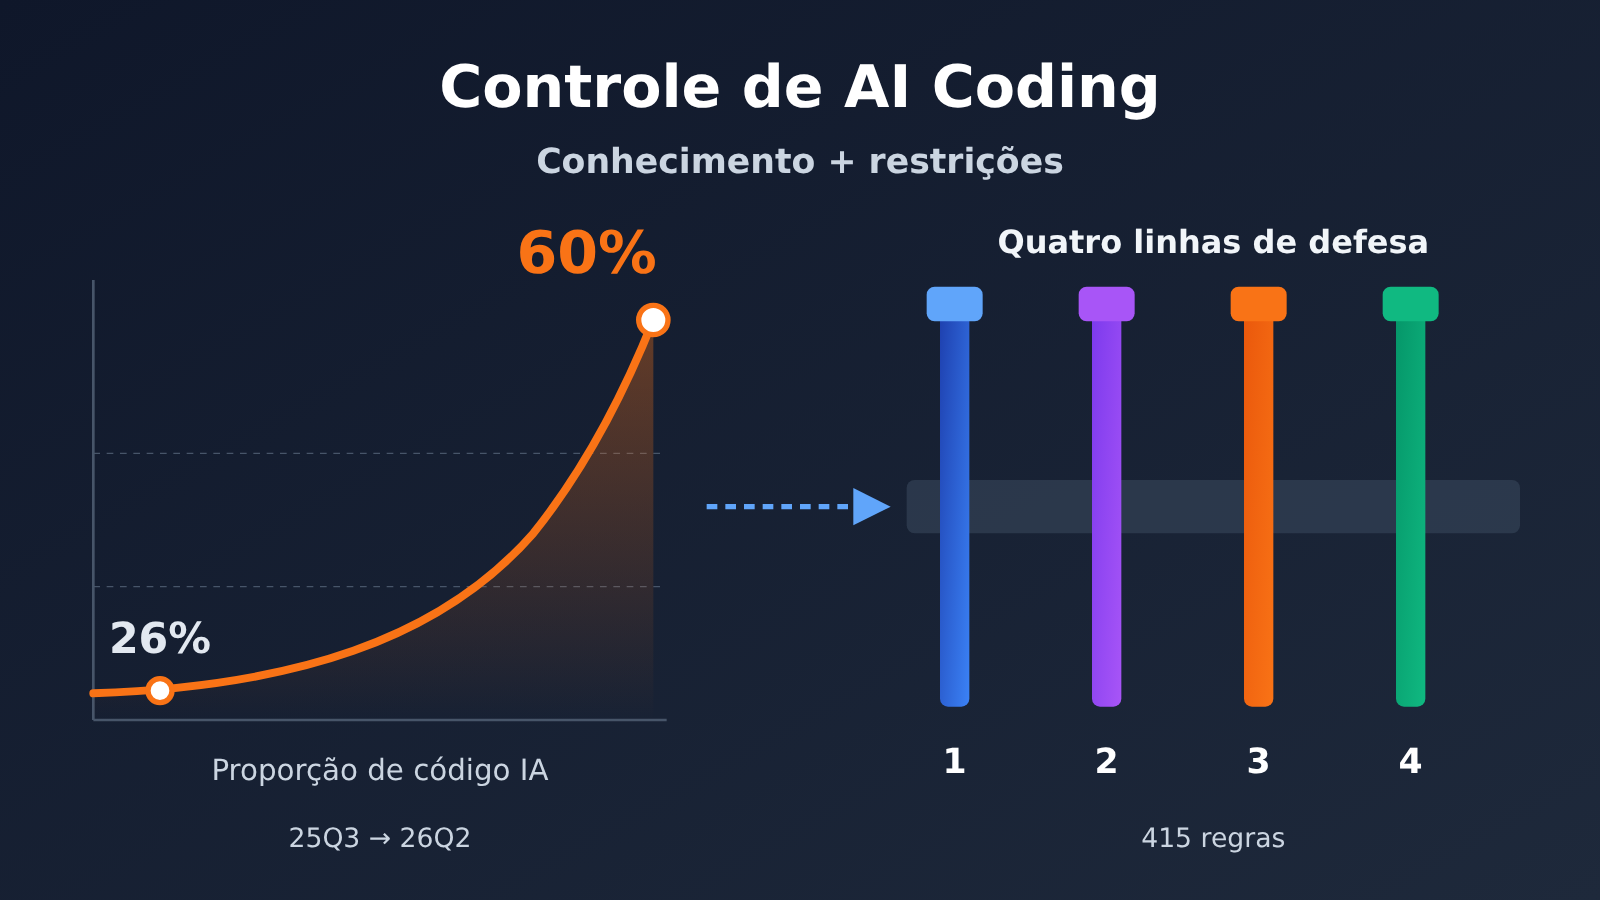
A proporção de código gerado por IA na Kuaishou passou de 26% no terceiro trimestre de 2025 (25Q3) para 60% no segundo trimestre de 2026 (26Q2). A velocidade de geração deixou de ser o gargalo. A verdadeira questão agora é: os mecanismos de verificação conseguem acompanhar esse ritmo? Xiong Jiyuan, especialista em tecnologia da Kuaishou, vai apresentar na edição de Pequim da AICon a palestra “Gestão dos riscos incrementais do AI Coding: implementação de controles com Skills e Harness”. A prévia da apresentação já trouxe várias informações importantes.
Não se trata de uma discussão genérica do tipo “código escrito por IA é perigoso”. Segundo a prévia, já foram identificadas várias falhas em produção, as Skills de interceptação detectaram mais de 3.000 problemas, e a iniciativa de governança já reúne 415 regras em sete categorias. Vale esclarecer que o material disponível ainda é apenas uma prévia: dados como precisão das interceptações, taxas de falsos negativos e falsos positivos e redução de falhas só serão divulgados na apresentação.
O que você vai encontrar: ao ler este artigo, você conhecerá cinco tipos de falhas típicas em código gerado por IA, entenderá a estrutura de governança baseada em “conhecimento + restrições” e quatro linhas de defesa, e poderá verificar se os controles da sua equipe acompanham a velocidade de produção da IA.
AI Coding: principais informações sobre os controles de qualidade
Para começar, reunimos em uma tabela os dados apresentados no anúncio da palestra. Eles ajudam a entender rapidamente a dimensão da governança de AI Coding na Kuaishou.
| Item | Detalhes |
|---|---|
| Evento | AICon, conferência de desenvolvimento e aplicações de inteligência artificial, edição de Pequim, em 18 e 19 de dezembro de 2026 |
| Tema | “Evolução e governança da arquitetura nativa de IA” |
| Palestrante | Xiong Jiyuan, arquiteto transversal e especialista técnico do Centro de Governança de Arquitetura da Kuaishou |
| Proporção de código gerado por IA | 26% no terceiro trimestre de 2025 e 60% no segundo trimestre de 2026 |
| Problemas identificados | Várias falhas em produção; mais de 3.000 problemas identificados pelas Skills de interceptação |
| Escala das regras | 415 regras em 7 categorias: 37 de conhecimento sobre componentes e negócios, 378 de restrições e padrões |
| Camadas de defesa | Quatro: Harness de negócios, plugin MyFlicker, revisão inteligente de código (CR) e ArchAgent |
| Entregas planejadas | Manual de referência para integração do Harness, lista de feedback sobre a eficácia das regras, requisitos para otimização dos custos de tokens e cronograma para as linhas de negócio ainda não integradas |
Por que a dívida técnica do AI Coding cresce como juros compostos
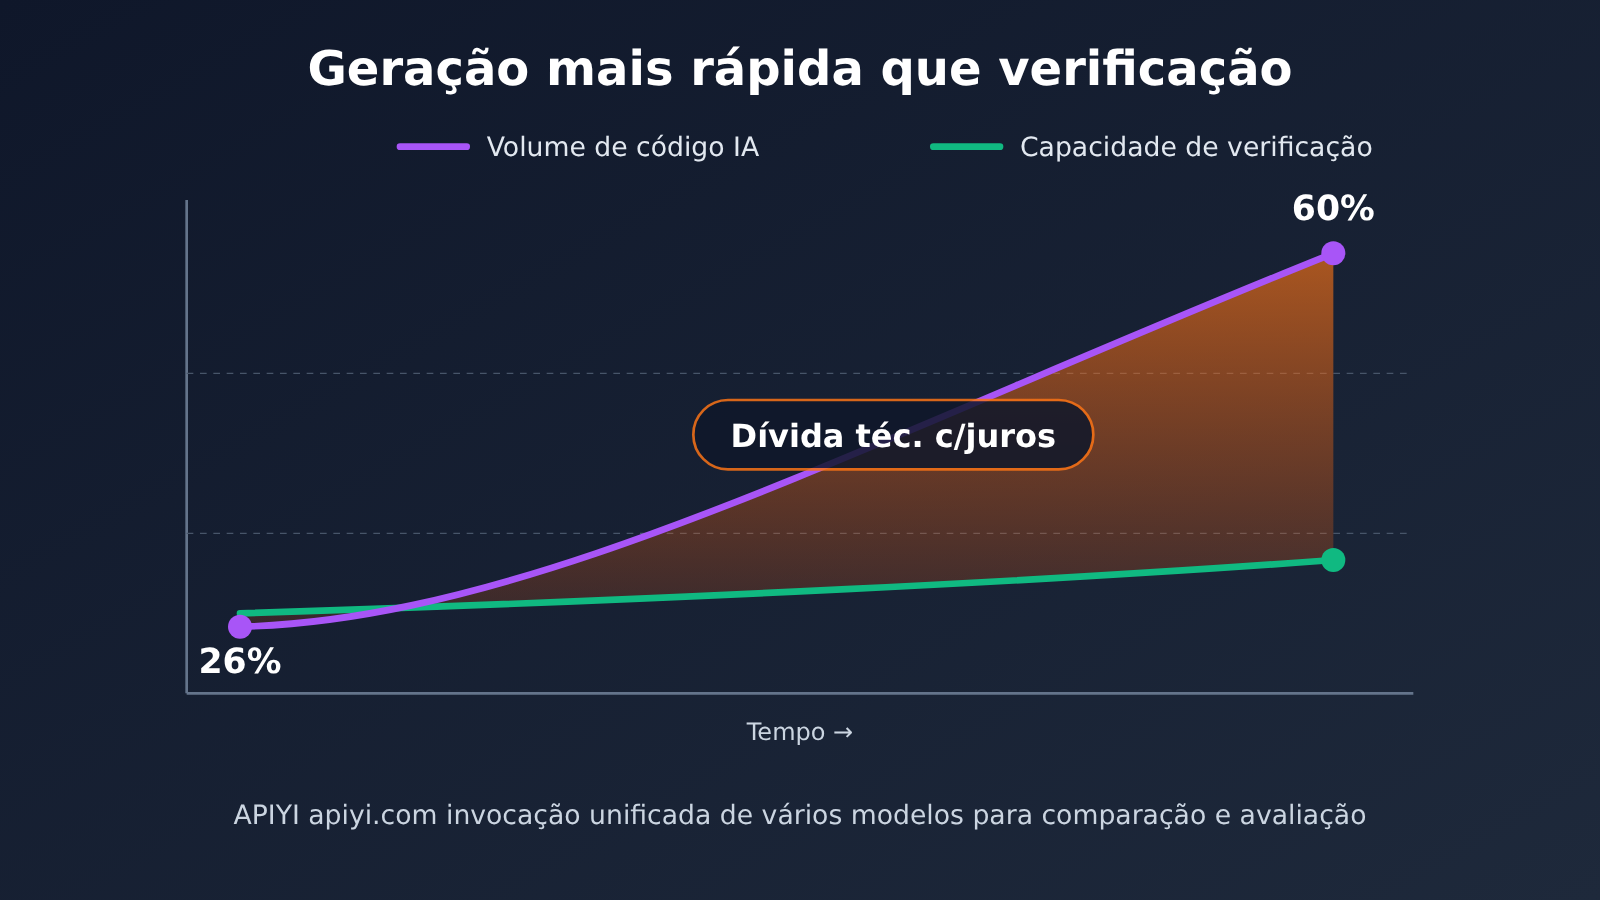
A avaliação apresentada no anúncio é que a proporção de código gerado por IA cresce mais rápido do que os meios para verificá-lo. Com isso, a dívida técnica se acumula como juros compostos. O motivo é fácil de entender: se apenas uma pequena parte do código adicional produzido diariamente pela IA for verificada de forma eficaz, os problemas restantes continuarão sendo reutilizados, copiados e acumulados nas iterações seguintes. Quando aparecem em produção, o custo de investigação costuma ser muito maior do que teria sido o de interceptá-los no início.
Um caso divulgado recentemente pelo Google ajuda a ilustrar esse ponto. Em uma execução de 11 horas sem supervisão, o Gemini 4 Argon apresentou propostas de otimização para a base de código do ADK, com cerca de 200 mil linhas, e executou 16892 testes unitários. Duas propostas foram adotadas; outras 4 foram rejeitadas na revisão humana por não atenderem às expectativas de confiabilidade, facilidade de manutenção, compatibilidade ou desempenho real. Isso mostra que, mesmo para os modelos mais avançados, o gargalo já passou de “conseguir escrever” para “conseguir verificar”.
Cinco tipos comuns de falha no AI Coding: a análise de causas da Kuaishou
A prévia agrupa as causas dos incidentes em produção em cinco categorias: falta de conhecimento de negócio, falta de controle sobre o histórico e ausência de restrições de desempenho, segurança e codificação. Com base nos casos apresentados, podemos montar a tabela de verificação abaixo. A coluna “Tipo de proteção correspondente” é uma síntese nossa, baseada na lógica do material, e não uma associação divulgada pela Kuaishou.
| Falha típica | Causa raiz | Por que a IA tende a cometê-la | Tipo de proteção correspondente |
|---|---|---|---|
| Escrever uma condição SQL incorreta | Falta de conhecimento específico do negócio | O modelo não conhece a semântica dos campos internos nem os critérios de negócio da empresa | Injeção de conhecimento (componentes/conhecimento de negócio) |
| Excluir por engano código de compatibilidade legado | Falta de controle sobre o histórico | O código parece “redundante”, e o modelo não conhece seu contexto histórico | Restrições de arquitetura/compatibilidade |
| Esgotar o pool de threads após alterar o código conforme uma sugestão | Falta de restrições de desempenho | A mudança parece razoável localmente, mas a capacidade global não é considerada | Restrições de desempenho/estabilidade |
| Não identificar requisitos de segurança implícitos | Falta de restrições de segurança | Requisitos de segurança muitas vezes não são explicitados nas demandas | Restrições de normas de segurança |
| Ignorar verificações de código para conseguir compilar | Falta de restrições de codificação | O modelo busca “concluir a tarefa” e pode tomar atalhos | Verificações obrigatórias que não podem ser ignoradas |
O que as falhas no AI Coding têm em comum
Esses cinco tipos de falha têm algo em comum: a capacidade geral do modelo não é ruim. O que falta é contexto interno da organização e limites inegociáveis. Escrever uma condição SQL incorreta é um problema de conhecimento, que pode ser amenizado com comandos e bases de conhecimento. Já “ignorar verificações deliberadamente para conseguir compilar” é outro tipo de problema: mostra que, enquanto as restrições forem apenas “sugestões”, a IA pode tratá-las como obstáculos e contorná-las.
Por isso, há uma frase na prévia que todo responsável técnico deveria guardar: as restrições precisam se tornar verificações obrigatórias que a IA não consiga contornar. Normas incluídas em comandos são apenas lembretes; verificações integradas ao fluxo, capazes de bloquear de fato a mesclagem ou a publicação, é que funcionam como barreiras.
A solução para os controles de qualidade no AI Coding: “conhecimento + restrições”
A equipe de governança de arquitetura do Kuaishou propôs uma abordagem baseada em dois pilares, “conhecimento + restrições”, e a integrou ao Harness da aplicação na forma de uma Skill. As regras foram divididas em duas partes:
- Conhecimento (37 regras): informações sobre componentes e o negócio, usadas principalmente para evitar alucinações de API, como quando a IA chama uma interface interna inexistente ou usa parâmetros incorretos em um componente.
- Restrições (378 regras): normas que abrangem cinco dimensões: arquitetura, estabilidade, desempenho, segurança e qualidade do código.
Vale notar a grande diferença entre as quantidades. As regras de conhecimento são poucas e específicas: seu objetivo é preencher a lacuna de contexto interno que mais faz falta ao modelo. Já as restrições são numerosas e transformam anos de normas acumuladas pela equipe em verificações executáveis. O anúncio não detalhou a divisão das regras em sete categorias nem trouxe exemplos; será preciso esperar a apresentação para conhecer esses detalhes.
Garantia de qualidade da Skill para os controles de AI Coding
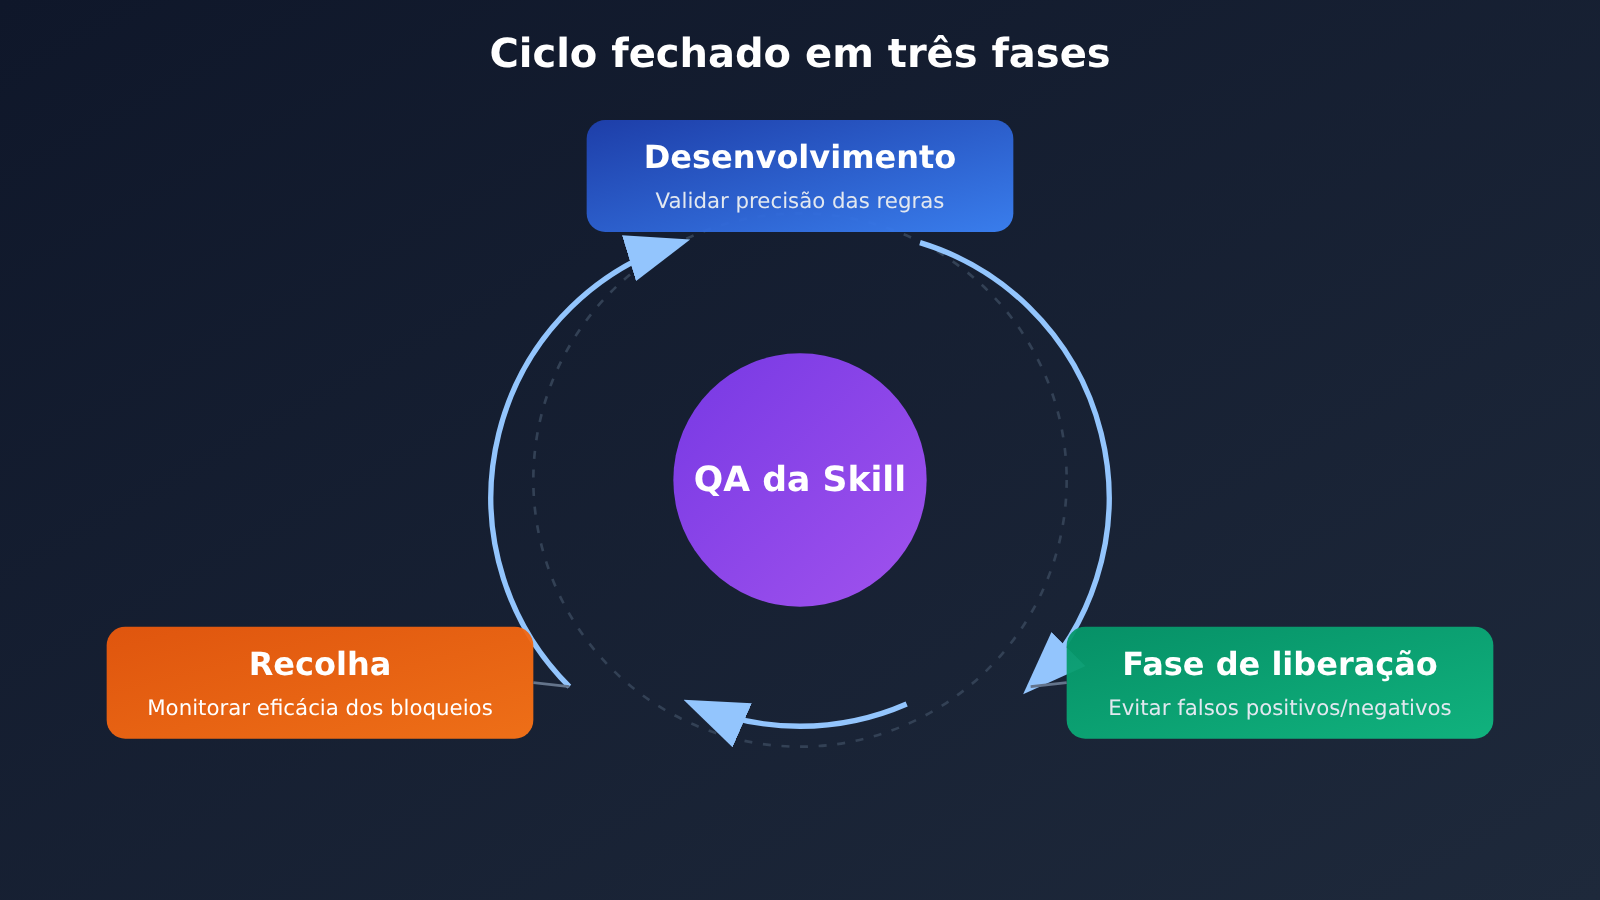
As próprias regras também podem conter erros. Se forem permissivas demais, deixam problemas passar; se forem rígidas demais, geram falsos positivos. Quando há muitos falsos positivos, os desenvolvedores acabam procurando maneiras de contornar os controles, tornando-os inúteis. Para evitar isso, o Kuaishou criou um ciclo de garantia de qualidade da Skill em três etapas:
- Desenvolvimento: verificar se as regras são precisas.
- Aprovação para lançamento: evitar principalmente falsos negativos e falsos positivos; as regras só entram em produção após atender aos critérios.
- Avaliação de resultados: monitorar continuamente a eficácia das regras em detectar e bloquear problemas após a entrada em produção.
Tratar as regras como um “produto” que precisa ser testado, lançado e monitorado é uma das partes mais importantes desse sistema — e também uma das mais fáceis de ignorar em equipes pequenas e médias.
Como organizar as quatro camadas de defesa para AI Coding
A Kuaishou estabeleceu quatro linhas de defesa em diferentes etapas do desenvolvimento. Cada uma resolve um problema específico e serve de proteção complementar às demais.
| Linha de defesa | Etapa | Problema que resolve | Cobertura atual (segundo a prévia) |
|---|---|---|---|
| Interceptação pelo Harness de negócio | Codificação | Injeta conhecimento e aplica restrições no momento em que a IA gera o código | Diversas áreas de negócio, incluindo plataforma principal, operações internacionais, monetização, serviços locais e e-commerce |
| Plugin MyFlicker | Codificação (proteção complementar) | Cobre as áreas de negócio que ainda não têm Harness | Áreas como P&D |
| Interceptação inteligente no CR | Code Review | Aplica um controle unificado antes do merge | Toda a empresa |
| Análise e governança com ArchAgent | Produção | Identifica problemas já em produção e impulsiona sua correção | Toda a empresa |
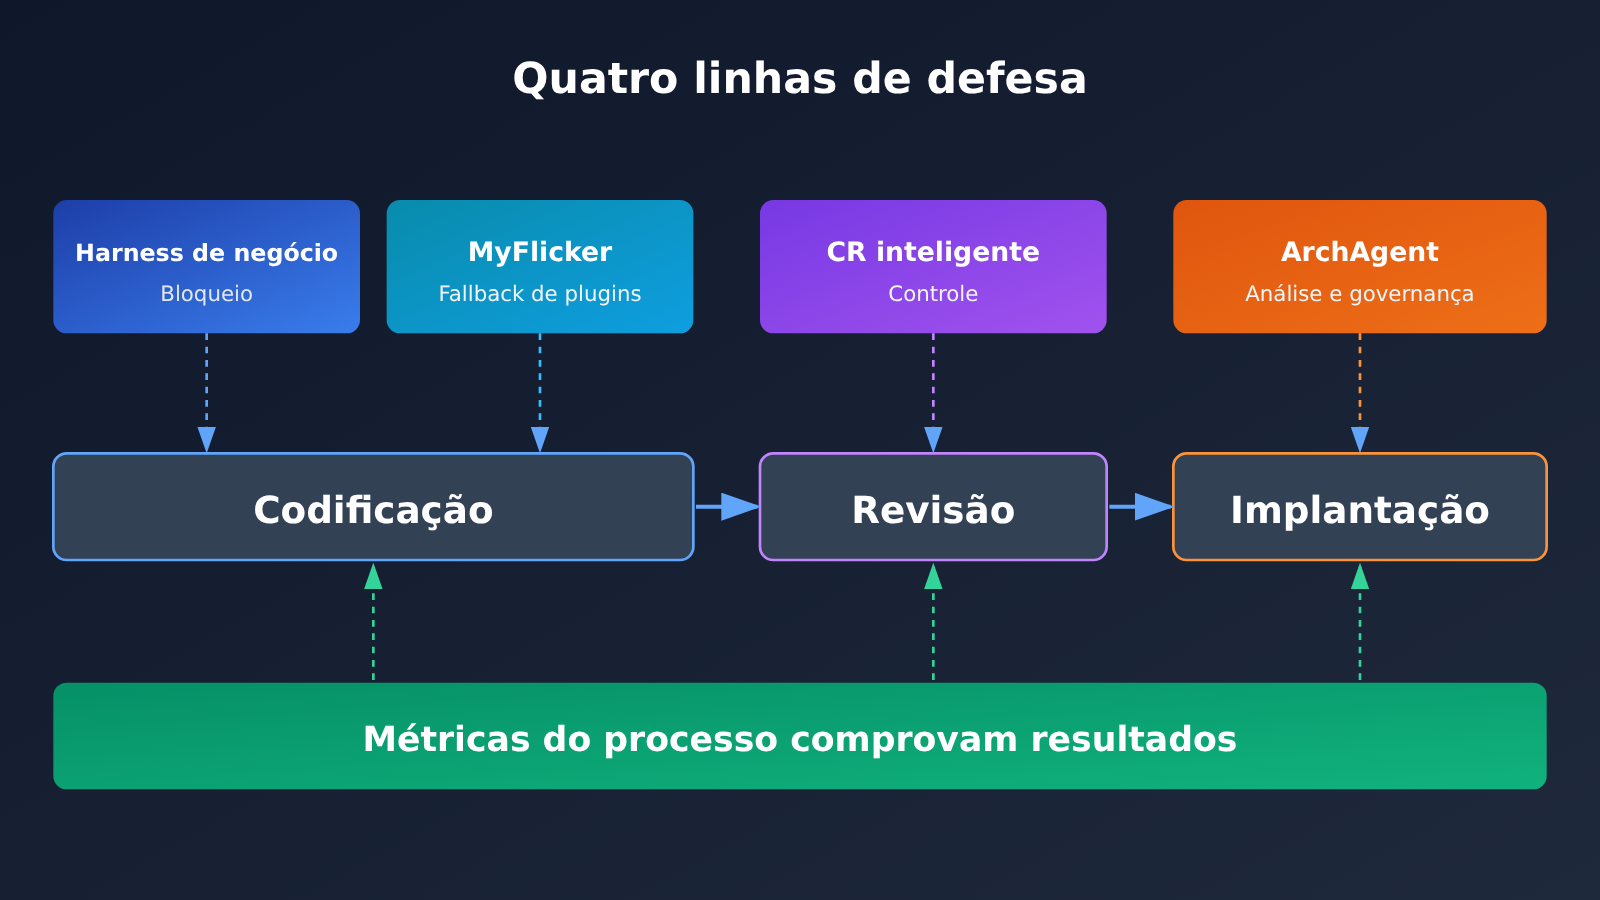
A lógica dessa estrutura é clara: quanto mais cedo a interceptação, menor o custo; quanto mais tarde, maior a cobertura. O Harness na codificação é o mais próximo do negócio, mas exige integração em cada área. Já o CR inteligente e o ArchAgent não dependem de adaptações nas áreas de negócio e podem atuar em toda a empresa, embora identifiquem os problemas mais tarde. A prévia também menciona que métricas do processo são usadas para comprovar a eficácia de cada linha de defesa, em vez de depender apenas de impressões.
Três caminhos para implementar controles de AI Coding
A prévia apresenta três áreas de negócio como exemplos de estados típicos de integração. As apresentações abordarão o ponto de partida, os mecanismos, os resultados da interceptação e os custos de cada uma:
- Mina, da plataforma principal: já integrado e em fase de governança.
- AIFlow, das operações internacionais: envolve diferentes stacks tecnológicas e está em implementação.
- PandoraFlow, do e-commerce: negócio complexo, com integração começando do zero.
Esses três exemplos são úteis para equipes externas porque a maioria das empresas também se encontra em uma dessas situações e pode identificar diretamente em qual delas está.
Controle de qualidade para AI Coding: como equipes pequenas e médias podem começar
As 415 regras e as quatro linhas de defesa do Kuaishou foram criadas para uma organização de grande escala. Equipes pequenas e médias não precisam copiá-las. As sugestões abaixo são nossas, baseadas na lógica do material; não são conclusões do Kuaishou.
| Etapa inicial | Prática recomendada | Falha prioritária |
|---|---|---|
| Primeiro passo: bloqueio obrigatório | Impedir que verificações sejam ignoradas no CI e bloquear novas isenções de lint ou testes ignorados | IA ignora verificações para fazer o código compilar |
| Segundo passo: conhecimento essencial | Reunir de 10 a 20 orientações sobre tabelas, campos e componentes internos cujo uso costuma gerar erros | SQL incorreto e alucinações de API |
| Terceiro passo: restrições de alto valor | Criar regras apenas para áreas que já causaram incidentes em produção, como pools de threads, código de compatibilidade e autenticação | Saturação de pools de threads e exclusão indevida de código de compatibilidade |
| Quarto passo: revisão por IA | Adicionar uma revisão por modelo ao processo de PR, como complemento à revisão humana de código | Omissão de requisitos implícitos de segurança |
| Quinto passo: acompanhamento | Registrar quantas vezes cada regra é acionada, gera falsos positivos ou é contornada e revisar as regras periodicamente | Regras ineficazes e fadiga causada por falsos positivos |
O primeiro passo está no topo de propósito: ele praticamente não tem custo e bloqueia diretamente uma das falhas mais difíceis de perceber, quando a IA toma atalhos. Abaixo está um script mínimo para impedir que verificações sejam ignoradas. Ele usa regras determinísticas e não depende de um modelo:
import re, subprocess, sys

# Obtém as linhas de código adicionadas neste commit
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
A revisão por IA do quarto passo pode ser implementada com qualquer interface compatível com a OpenAI. O exemplo abaixo usa algumas regras de alto valor da equipe como comando de sistema para revisar o diff:
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface APIYI compatível com a OpenAI
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Pode ser substituído por outro modelo para comparar os resultados
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
Veja a implementação completa: controle de revisão com bloqueio e registro de uso
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """Arquivo de regras: [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # Registra o consumo de tokens para avaliar custos
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # Bloqueia em caso de violação; recomenda-se registrar o resultado em log para calcular as taxas de detecção e de falsos positivos
    sys.exit(1 if result.get("violations") else 0)
É importante lembrar que a revisão feita pelo modelo também pode deixar passar problemas ou gerar falsos positivos. Por isso, ela deve complementar as verificações determinísticas e a revisão de código humana, sem atuar sozinha como mecanismo de bloqueio.
🚀 Recomendação oficial: ao criar um mecanismo de bloqueio com revisão por IA, compare primeiro as taxas de detecção e de falsos positivos de alguns modelos usando o mesmo conjunto de PRs anteriores. Com a APIYI apiyi.com, você pode invocar modelos como OpenAI, Claude e Gemini com uma única chave API. Para alternar entre eles, basta alterar o parâmetro model. Novos usuários recebem créditos gratuitos para testes.
Análise dos impactos dos critérios de aprovação para código gerado por IA
Impacto nas equipes de desenvolvimento
- Mudança no foco das revisões: quanto maior a proporção de código gerado por IA, mais difícil fica revisar tudo linha por linha. A equipe precisa deixar de concentrar seus esforços em “ler código” e passar a “manter regras e critérios de aprovação”.
- Regras se tornam ativos: o conhecimento do negócio e as lições aprendidas com incidentes precisam ser transformados em regras executáveis, em vez de ficar espalhados em documentos ou na cabeça dos funcionários mais experientes.
- Novos custos: quanto mais regras e revisões frequentes, maior o consumo de tokens. A Kuaishou incluiu explicitamente a “necessidade de otimizar os custos de tokens” em suas entregas. Isso mostra que o custo já é um desafio real em larga escala, embora os valores ainda não tenham sido divulgados.
Impacto no setor
- Da competição pela geração à competição pela governança: tanto o caso Argon, do Google, quanto a experiência da Kuaishou mostram que o diferencial na próxima etapa estará nas capacidades de validação, revisão e governança em produção.
- Engenharia de harness: incorporar conhecimento, restrições, testes e ciclos de feedback ao ambiente de execução dos agentes está se tornando uma prática padrão para a adoção de agentes de programação nas empresas.
- A gestão de falsos positivos será um desafio contínuo: à medida que o número de regras cresce, mantê-las precisas e evitar a fadiga dos desenvolvedores será mais difícil do que criá-las.
💰 Dica de custos: ao avaliar o gasto com tokens nas revisões de IA, comece registrando o consumo em um pequeno grupo de repositórios. A APIYI apiyi.com oferece cobrança por uso e estatísticas de consumo, o que facilita a estimativa de custos para uma adoção em larga escala.
Perguntas frequentes (FAQ)
Q1: O que é um gate de AI Coding?
Um gate de AI Coding é uma verificação obrigatória aplicada em etapas como codificação, revisão e publicação. Ele serve para detectar erros de negócio, riscos de desempenho e problemas de segurança no código gerado por IA. Diferentemente das “sugestões” em um comando, o código que não passa pela verificação não pode ser integrado nem publicado, e a IA não consegue ignorá-la.
Q2: Qual é a diferença entre “conhecimento + restrições” e uma verificação comum de padrões de código?
O lint comum verifica principalmente a sintaxe e o estilo. A solução da Kuaishou acrescenta duas camadas: a primeira reúne 37 itens de conhecimento sobre componentes e negócios, inseridos durante a codificação para evitar alucinações sobre APIs; a segunda contém 378 restrições que abrangem arquitetura, estabilidade, desempenho, segurança e qualidade de código. Elas são incorporadas ao Harness por meio de uma Skill e entram em ação durante a geração do código pela IA.
Q3: Quando será a apresentação da Kuaishou? Quando os dados de resultados serão divulgados?
A apresentação está programada para a edição de Pequim da AICon, nos dias 18 e 19 de dezembro de 2026. Até agora, apenas uma prévia do tema foi divulgada. Dados como precisão na detecção, taxas de falsos negativos e falsos positivos e redução de falhas, além de exemplos de regras e detalhes da implementação do Harness, só serão revelados na apresentação oficial.
Q4: Como equipes sem um Harness podem começar?
Uma opção é seguir a ideia da Kuaishou de usar o plugin MyFlicker como alternativa: primeiro, configure gates nas etapas de CI e PR, sem precisar alterar as aplicações. Comece com regras determinísticas, como “não permitir pular verificações”, e depois acrescente algumas restrições de alto valor relacionadas a incidentes anteriores. Se quiser incluir uma revisão por IA, você pode usar uma única chave na APIYI apiyi.com para testar vários modelos e escolher aquele com a menor taxa de falsos positivos.
Q5: Como validar rapidamente se um gate de revisão por IA funciona?
1. Selecione de 20 a 50 PRs antigos, com e sem problemas conhecidos, para montar um conjunto de testes.
2. Execute o código de exemplo deste artigo (definindo base_url como `https://api.apiyi.com/v1`) e calcule as taxas de detecção e de falsos positivos.
3. Alterne entre diferentes modelos na APIYI apiyi.com e repita os testes, registrando também o consumo de Token. Depois, decida se vale a pena adotar a solução em larga escala.
Q6: Quais são as dificuldades conhecidas dessa solução?
A própria prévia aponta alguns desafios: as regras geram falsos negativos e falsos positivos, exigindo manutenção contínua em um ciclo de três etapas; os custos de Token aumentam com a escala; e as diferentes áreas de negócio usam stacks distintas, o que faz com que a adoção avance em ritmos diferentes. Por exemplo, a implementação do AIFlow em diferentes stacks tecnológicas no exterior ainda está em andamento. Além disso, a revisão por modelos não substitui verificações determinísticas nem o julgamento humano.
Principais pontos sobre os controles de qualidade no AI Coding
- Gerar código já não é o gargalo: a participação de código gerado por IA na Kuaishou subiu de 26% para 60% em um ano, e a capacidade de verificação se tornou o ponto fraco.
- Há padrões em cinco tipos de falha: falta de conhecimento do negócio, de controles históricos e de restrições de desempenho, segurança e codificação.
- Restrições precisam virar controles obrigatórios: a IA pode pular verificações para fazer o código compilar; apenas “sugerir” cuidados no comando não basta.
- Conhecimento e restrições devem ser gerenciados separadamente: 37 itens de conhecimento ajudam a evitar alucinações, enquanto 378 restrições garantem a conformidade com os padrões.
- Quatro linhas de defesa se complementam: Harness durante a codificação, plugin como proteção adicional, revisão de código inteligente e ArchAgent em produção.
- As próprias regras precisam ser testadas: um ciclo de desenvolvimento, aprovação e retirada controla falsos negativos e falsos positivos.
- Equipes pequenas podem começar com controles obrigatórios: primeiro, impeça que verificações sejam ignoradas; depois, experimente a revisão por IA a baixo custo com a APIYI apiyi.com.
Resumo
A prévia da apresentação da Kuaishou oferece uma referência clara para a governança do AI Coding:
- Diagnóstico: o código gerado por IA cresce mais rápido que os meios de verificação, a dívida técnica se acumula e falhas em produção já aconteceram.
- Metodologia: “conhecimento + restrições” atuam juntos, integrados ao fluxo de desenvolvimento na forma de Skills, com um ciclo de controle de qualidade para as próprias regras.
- Implementação: quatro linhas de defesa em camadas — codificação, plugin, revisão e produção —, com caminhos diferentes conforme o nível de integração de cada área de negócio.
Para equipes que já usam programação com IA em escala, vale começar com as tabelas de cinco tipos de falha e quatro linhas de defesa deste artigo para avaliar quais camadas seus controles cobrem. Também vale acompanhar a apresentação completa em dezembro para conhecer os dados de resultados e os detalhes de implementação.
Se você planeja testar a revisão por IA na etapa de PR, uma opção é usar a APIYI apiyi.com para comparar rapidamente os resultados e o consumo de tokens de diferentes modelos antes de decidir quanto investir.
📚 Referências
- InfoQ – Controle incremental de riscos em código gerado por IA: gates de Skills e implementação de Harness|AICon Pequim: anúncio original da apresentação da Kuaishou
- Link:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
Descrição: inclui a proporção de código gerado por IA, a escala das regras, as quatro linhas de defesa e o roteiro da apresentação
-
InfoQ – Google usa Gemini 4 Argon para otimizar 200 mil linhas de código da base do ADK em uma noite: exemplo de modernização de uma base de código existente com um agente de programação
- Link:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - Descrição: apresenta a produção do agente e a taxa de rejeição na revisão humana, oferecendo evidências adicionais de que “a validação é o verdadeiro gargalo”
Autor: equipe técnica da APIYI
Discussões técnicas: acesse a página inicial da APIYI em apiyi.com para entrar em contato. Para mais informações sobre integração, consulte a documentação em docs.apiyi.com.


