
Nota del autor: si tu modelo va peor que la clasificación oficial, no te apresures a sacar conclusiones. Muchas veces lo que falla es que el nivel de razonamiento, la ventana de entrada o el ID del modelo no coinciden con la configuración usada en el benchmark. Este artículo explica el orden para verificar estas tres cosas; cuando termines, decide si realmente vale la pena cambiar de modelo.
Muchos desarrolladores se topan con la misma brecha. El anuncio oficial dice que cierto modelo obtuvo una puntuación alta en la clasificación; tú lo pruebas con problemas similares y el resultado queda claramente por debajo de lo esperado. Entonces empiezas a sospechar que el modelo “se volvió tonto” o que le “bajaron la configuración”. Este artículo propone un enfoque de diagnóstico más práctico: primero asegúrate de que coincidan el nivel de razonamiento, la ventana de entrada y el mismo ID de modelo, y luego determina si la diferencia existe de verdad.
Esto no es una fórmula mágica del tipo “toca tres interruptores y igualas la clasificación oficial”. Las diferencias descritas a continuación provienen todas de documentación pública. Solo sirven para confirmar si estás comparando lo mismo; no garantizan que, después de ajustar, obtengas la puntuación del ranking, ni implican que APIYI haya reproducido la clasificación oficial.
Valor principal: al terminar este artículo, sabrás en qué orden revisar estas tres cosas y qué documento consultar en cada paso. También sabrás, si después de verificarlas sigue habiendo diferencias, qué precios y endpoints comparar antes de cambiar de modelo.
Puntos clave cuando no coincide con el benchmark oficial
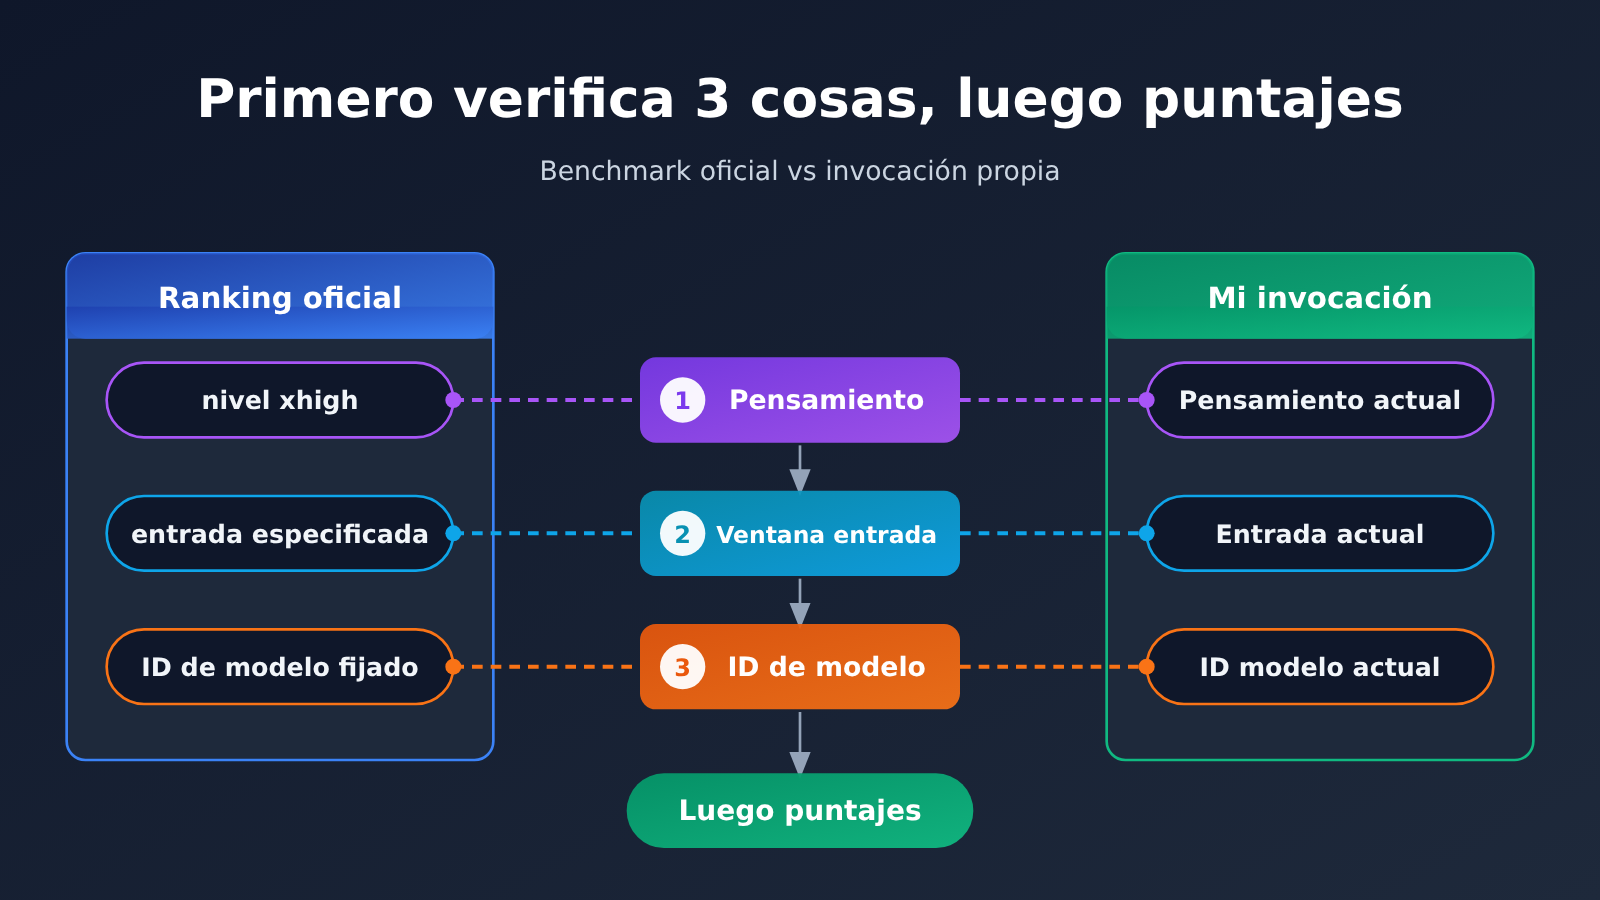
Primero, la conclusión. La puntuación de un ranking nunca es la puntuación del “nombre del modelo”, sino la de una combinación concreta: un ID de modelo + un nivel de razonamiento + una condición de endpoint. Si difiere cualquiera de esos tres, el resultado que obtengas no se puede comparar directamente con el ranking.
| Elemento a verificar | Diferencia típica (según documentación pública) | Qué pasa si no coincide | Prioridad |
|---|---|---|---|
| Nivel de razonamiento | Neon usa high por defecto en la API; además tiene low, medium y xhigh. Carbon usa medium por defecto y no tiene xhigh. |
La longitud de salida y la profundidad de razonamiento cambian, así que el resultado también cambia, como es lógico. | Primer paso |
| Ventana del endpoint | La ventana de Neon en la API es de 1,048,576 tokens, mientras que la documentación de Antigravity indica un máximo de 512K. |
Puede que tu endpoint no tenga suficiente ventana para el contexto largo que se evalúa en el ranking. | Segundo paso |
| ID del modelo | Gemini 4 tiene al menos cuatro ID: argon, carbon, hydrogen y neon; sus niveles de razonamiento y precios de lista no son iguales. |
Comparar el resultado de A con el ranking de B no es comparar la misma variante. | Tercer paso |
Por qué el nivel de razonamiento es lo primero que hay que verificar frente al benchmark oficial
El nivel de razonamiento es la variable que más fácilmente pasa desapercibida, porque a menudo tiene un valor predeterminado y puedes llamar al modelo sin configurarlo. El problema es que los valores predeterminados no son iguales entre modelos. Por ejemplo, en Gemini 4, Neon usa high por defecto en la API y Carbon usa medium. Con la misma indicación, un nivel distinto produce una longitud de salida y un resultado final diferentes.
El ranking normalmente indica el nivel usado en las pruebas. Las puntuaciones que citan los anuncios oficiales, como los 61 puntos de Neon en Artificial Analysis con el nivel xhigh, hay que leerlas junto con el nivel. Si comparas el high predeterminado con una puntuación obtenida en xhigh, ya no estás en la misma condición. Y ojo: Carbon no tiene el nivel xhigh, así que “subir Carbon al máximo” tampoco equivale al xhigh de Neon.
Distintos endpoints también pueden llamar de forma diferente al mismo nivel. En Antigravity, el nivel más alto de Neon aparece en la interfaz como Extra, y no coincide con el nombre xhigh de la documentación de la API. Al verificar, guíate por la correspondencia que indica la documentación, no solo por el texto literal.
Por qué la ventana del endpoint y el ID del modelo también son clave
La ventana del endpoint determina cuánto contexto puedes dar al modelo. Cuando llamas a Neon a través de la API, la ventana es de 1,048,576 tokens, mientras que la documentación de Antigravity indica un máximo de 512K. Si el ranking evalúa recuperación en documentos largos o comprensión de grandes bases de código, incluso usando el mismo modelo en un endpoint con una ventana más pequeña, podrías obtener peores resultados porque el contenido se trunca.
El ID del modelo es el elemento más inflexible. La generación Gemini 4 tiene al menos cuatro ID: argon, carbon, hydrogen y neon, y sus ajustes de nivel de razonamiento y sus precios de lista no son iguales. Comparar el resultado de Hydrogen con el ranking de Neon en el nivel xhigh: que haya diferencias es lo más normal. Antes de invocar, te recomendamos confirmar en la tabla general de modelos de APIYI (apiyi.com) cuál es exactamente el ID que escribes en la solicitud; no lo rellenes de memoria ni copiando la captura de pantalla de otra persona.
Pasos de inicio rápido para alinearte con el benchmark oficial
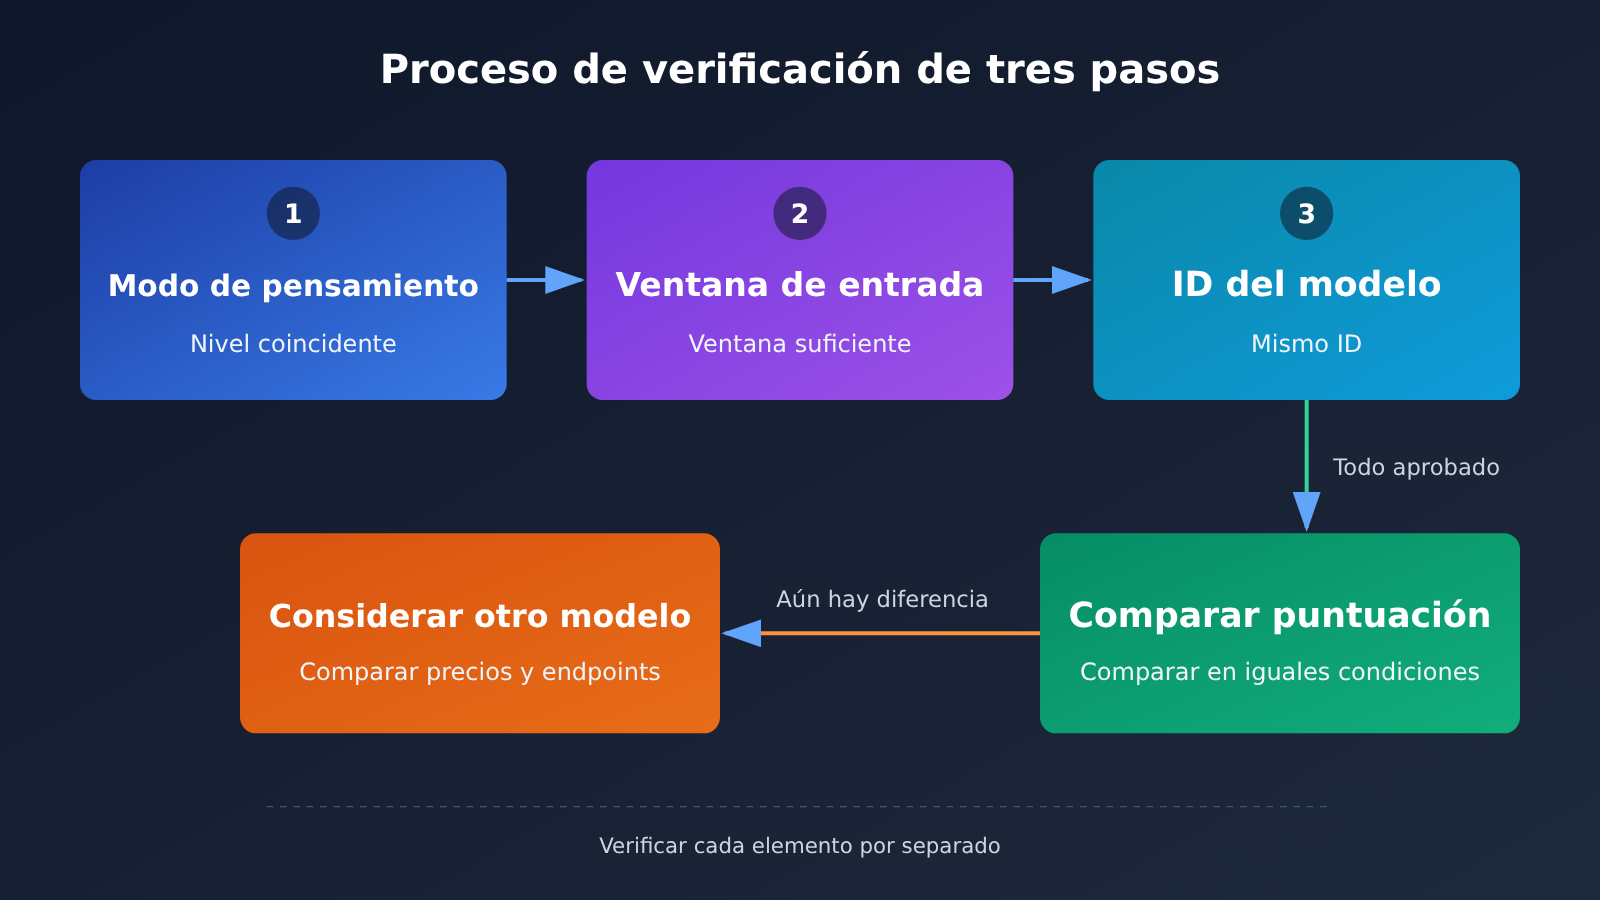
Esta sección lleva las tres verificaciones a acciones concretas. Para facilitar el copiado, los nombres de parámetros, los ID de modelo y las direcciones aparecen en código en línea; puedes revisar cada punto comparándolo con tu propia solicitud.
Primer paso: confirma el punto de entrada y el endpoint
Primero, aclara desde qué punto de entrada estás usando el modelo: interfaz web, extensión de IDE o llamada directa a la API. Los límites de ventana y la nomenclatura de niveles pueden variar según el punto de entrada. Si usas la interfaz compatible con OpenAI, configura base_url como https://api.apiyi.com/v1 y coloca en api_key la clave generada en la consola de APIYI. Así, cuando cambies de modelo más adelante solo tendrás que modificar el campo model; las condiciones del punto de entrada se mantienen iguales y la comparación tiene sentido.
Segundo paso: escribe el ID del modelo completo
En la solicitud, escribe model como ID completo, por ejemplo gemini-4-neon o gemini-4-carbon, y no uses un ambiguo “Gemini 4”. Cuando lo hayas escrito, vuelve a la tabla general de modelos y verifica que ese ID sea el mismo que se evaluó en el ranking. Si el ranking evalúa Neon y tú llamas a gemini-4-hydrogen, entonces todas las comparaciones posteriores carecen de sentido; primero corrige el ID.
Tercer paso: configura explícitamente el nivel de pensamiento
No dependas del valor predeterminado; especifica explícitamente el nivel de pensamiento en la solicitud. El nombre exacto del campo debe consultarse en la documentación oficial del modelo correspondiente. Al configurarlo, ten en cuenta tres puntos:
- Alinea el nivel con el medido en el ranking: si el ranking indica
xhigh, configuraxhigh; si indicahigh, configurahigh. - Confirma que el nivel existe: Carbon no tiene
xhigh; forzar la comparación con el rankingxhighde Neon no tiene sentido. - Presta atención al mapeo de nombres:
Extraen la interfaz de Antigravity corresponde al nivel más alto de Neon; al migrar a la API, debes cambiarlo al nombre del nivel que aparece en la documentación.
Cuarto paso: verifica si el contexto supera la ventana del punto de entrada
Si tu contenido de prueba es muy largo, estima primero la cantidad de tokens y compárala con el límite del punto de entrada. Al llamar a Neon mediante la API, el límite es de 1,048,576 tokens; en la documentación de Antigravity se indica un máximo de 512K. El contenido que supera el límite se truncará o provocará un error; en ese caso, la “mala calidad” en realidad se debe a que la entrada está incompleta.
🚀 Inicio rápido: Si quieres comparar varios ID de modelo bajo las mismas condiciones de entrada, puedes usar APIYI apiyi.com y llamar con una sola clave a modelos como Gemini, Claude y GPT. Los nuevos usuarios tienen crédito de prueba gratuito, ideal para alinear primero los niveles y los ID, y luego hacer comparaciones a pequeña escala.
Lista de verificación de las tres comprobaciones
| Elemento de verificación | Campo que debe revisarse en la solicitud | Criterio de conformidad | Error frecuente |
|---|---|---|---|
| Punto de entrada | base_url |
Fijar un único punto de entrada, como https://api.apiyi.com/v1 |
Probar una vez en la interfaz web y otra en la API, mezclando comparaciones |
| ID del modelo | model |
ID completo que coincida con el ranking | Usar hydrogen para comparar con el ranking de neon |
| Nivel de pensamiento | Parámetro de nivel de pensamiento (nombre del campo según la documentación) | Coincidir con el nivel medido en el ranking y que ese nivel exista | Depender del valor predeterminado; configurar xhigh en Carbon |
| Contexto | Cantidad de tokens de entrada | No superar el límite de la ventana del punto de entrada | Meter contenido de escala millón en una entrada de 512K |
Después de verificar con el benchmark oficial, si aún hay diferencias: precio y endpoint antes de cambiar de modelo
Cuando los tres puntos ya coinciden y la diferencia sigue siendo evidente, es entonces cuando vale la pena plantearse cambiar de modelo. Cambiar de modelo no es solo cambiar un nombre: hay que mirar a la vez el nivel de capacidad y el coste, porque los precios de las distintas ID de Gemini 4 varían bastante. Abajo están los precios de catálogo de APIYI verificados el 2026-11-20, todos en dólares por millón de tokens.
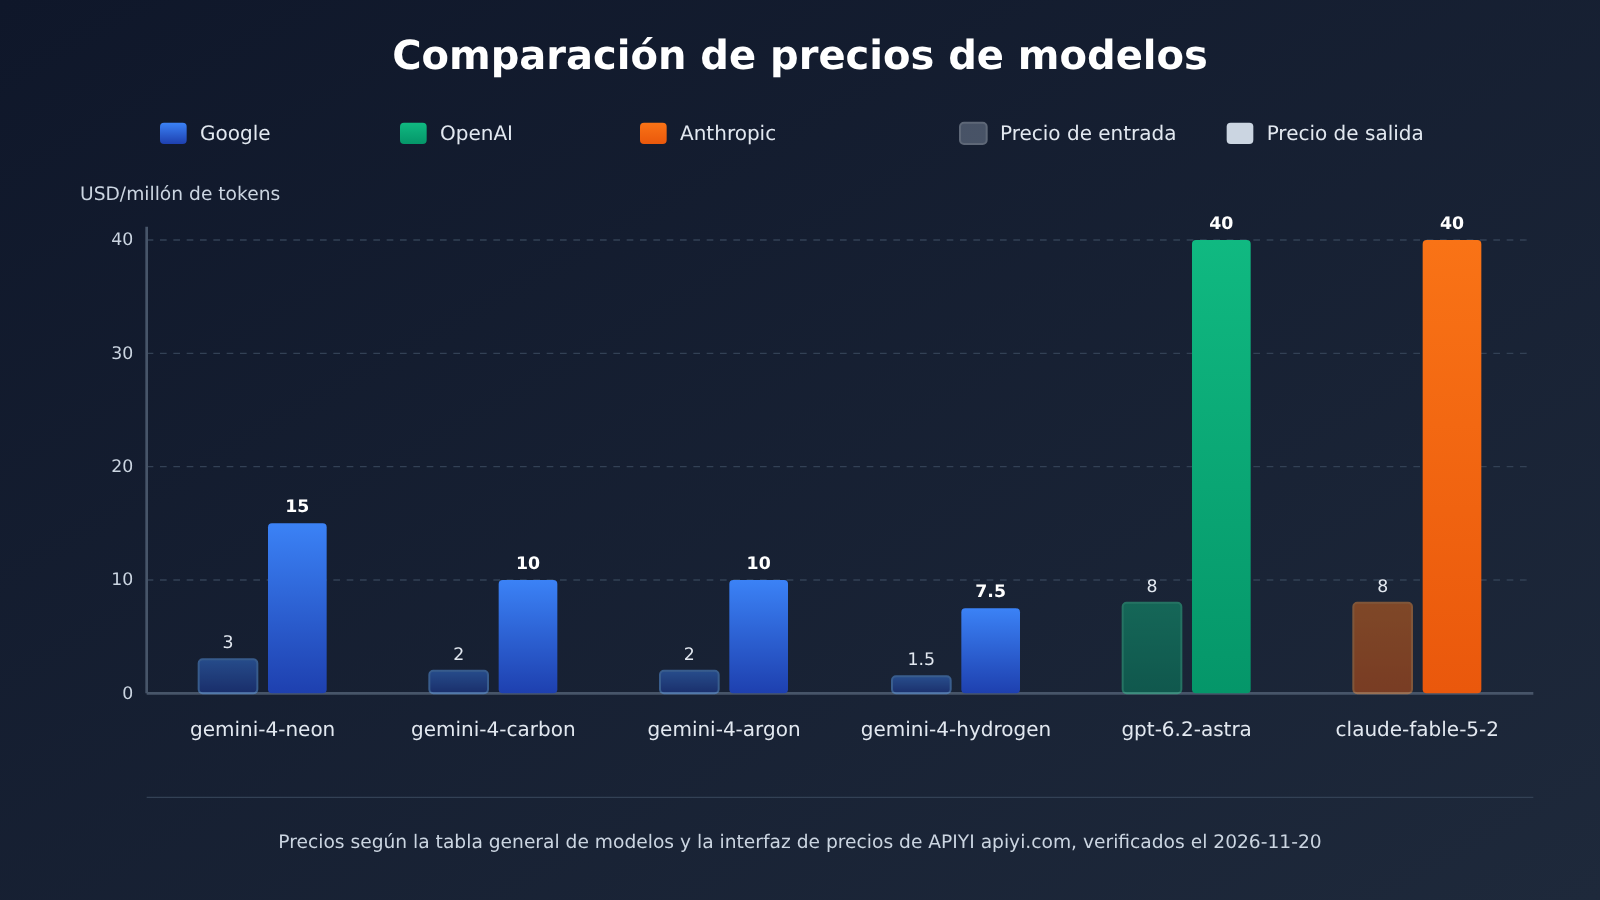
| ID del modelo | Entrada | Lectura de caché | Salida | Notas |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Según la interfaz de precios, coincide con el precio de Google |
gemini-4-carbon |
2 |
0.1 |
10 |
Corresponde al precio introductorio de Google hasta el 2026-11-30 |
gemini-4-argon |
2 |
0.1 |
10 |
Tomado de la tabla general de modelos |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
El precio unitario más bajo de los cuatro |
gpt-6.2-astra |
8 |
0.4 |
40 |
Al superar 272000 tokens, la entrada pasa a 16; ver detalles abajo |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Ambas ID tienen el mismo precio |
Hay varios puntos de esta tabla que conviene explicar por separado; de lo contrario, es fácil calcular mal el coste:
- El origen de gemini-4-neon: la versión de la tabla general de modelos actualizada el 2026-11-19 a las 10:59 (UTC+8) no lo incluía, pero sí aparece en la interfaz de precios. La interfaz de precios indica
model_ratio=1.5,completion_ratio=5ycache_ratio=0.05. Tomando como referencia quemodel_ratio=1equivale a una entrada de2dólares por millón de tokens, se obtiene una entrada de3, una salida de15y una lectura de caché de0.15. - Vigencia del precio de gemini-4-carbon: el precio actual corresponde al precio introductorio de Google vigente hasta el 2026-11-30. A partir del 1 de diciembre, el precio estándar de Google es entrada
4y salida20; hay que tener en cuenta este cambio al hacer presupuestos a largo plazo. - Los tramos de gpt-6.2-astra: la tabla general de modelos indica que el primer tramo tiene entrada
8, lectura de caché0.4y salida40, y que al superar los272000tokens la entrada pasa a16. La interfaz de precios, cuando se superan los272000tokens, calcula la salida como60y la lectura de caché como0.8. Conviene consultar ambas fuentes en conjunto.
💡 Recomendación de elección: al cambiar de modelo, pon las ID candidatas bajo el mismo
base_urly compáralas con el mismo nivel de razonamiento y la misma entrada; solo así las conclusiones se sostienen. Tanto la tabla general de modelos como la interfaz de precios de APIYI apiyi.com permiten consultar el precio actual de estas ID; se recomienda confirmarlo una vez más antes de la invocación y no depender solo de la tabla de este artículo.
Lista de verificación de endpoints y facturación al cambiar de modelo
| Punto de verificación | Dónde consultar | Por qué conviene consultarlo |
|---|---|---|
| Si existe el ID del modelo | Tabla general de modelos docs.apiyi.com/models.md |
La versión de la tabla general puede estar desfasada; algunos ID conviene verificarlos de nuevo en la interfaz de precios |
| Precio unitario actual y multiplicador | Interfaz de precios api.apiyi.com/api/pricing |
El multiplicador se puede convertir en precio unitario en dólares; el número de versión es shell-api-modelmak-v1 |
| Tramos de contexto largo | Contrastar la tabla general y la interfaz de precios | Por ejemplo, gpt-6.2-astra cambia de precio unitario al superar los 272000 tokens |
| Endpoint de invocación | https://api.apiyi.com/v1 |
Formato compatible con OpenAI; al cambiar de modelo solo se modifica model |
| Cambios de precio del upstream | Anuncio oficial de precios | Por ejemplo, el precio de introducción de Carbon finaliza el 2026-11-30 |
Preguntas frecuentes (FAQ)
P1: ¿A qué condiciones corresponden realmente las puntuaciones de referencia oficiales?
La puntuación del ranking corresponde a una combinación de «un ID de modelo concreto + un nivel de razonamiento concreto + un tipo de condición de acceso concreto», no a un nombre de modelo genérico. Por ejemplo, los 61 puntos de Neon son el resultado de Artificial Analysis obtenido con el nivel `xhigh`. Citar esa cifra por sí sola, sin indicar el nivel, genera malentendidos con mucha facilidad.
P2: El nivel de razonamiento, la ventana de acceso y el ID del modelo, ¿cuál conviene revisar primero?
El orden recomendado es: primero el nivel de razonamiento, luego la ventana de acceso y, por último, verificar el ID del modelo; solo cuando los tres coinciden tiene sentido comparar puntuaciones. En la práctica también puedes echar un vistazo rápido al ID primero, porque si el ID está mal, los otros dos ni hace falta mirarlos. La utilidad del orden está en descartar elemento por elemento, no en ejecutar los pasos de forma mecánica y rígida cada vez.
P3: ¿Basta con poner el nivel de razonamiento al máximo para alcanzar la referencia oficial?
No se puede prometer eso. Alinear el nivel solo garantiza que estás comparando con el ranking bajo la misma condición; factores como la distribución de las tareas, la forma de escribir la indicación o el método de muestreo pueden seguir introduciendo diferencias. Además, no todos los ID tienen un nivel máximo: Carbon, por ejemplo, no tiene `xhigh`, y subirlo a su nivel más alto no equivale al `xhigh` de Neon.
P4: ¿Por qué el mismo Neon rinde distinto en el IDE y al llamar directamente la API?
Porque las condiciones de acceso pueden ser diferentes. Cuando Neon se usa vía API, la ventana es de `1,048,576` tokens, mientras que la documentación de Antigravity indica un máximo de `512K`. Los nombres de los niveles tampoco coinciden: el nivel más alto en la interfaz de Antigravity se llama `Extra`. Que una tarea de contexto largo rinda peor en un acceso con ventana más pequeña se debe a la diferencia de condiciones, y no demuestra que el modelo haya empeorado.
P5: ¿Cómo comparar varios ID de modelo dentro del mismo acceso?
Puedes hacerlo en tres pasos:
1. Regístrate en APIYI apiyi.com y genera una clave API; los usuarios nuevos pueden recibir una cuota de prueba gratuita.
2. Configura `base_url` de forma uniforme en `https://api.apiyi.com/v1` y cambia solo el campo `model` para alternar entre ID.
3. Fija explícitamente el mismo nivel de razonamiento para cada ID y compara con el mismo lote de entradas.
Así, tanto el acceso como el nivel quedan fijados, y las diferencias provienen principalmente del modelo en sí.
P6: `gemini-4-neon` no aparece en la tabla general de modelos, ¿aún se puede llamar?
La versión de la tabla general actualizada el 2026-11-19 no incluye `gemini-4-neon`, pero la interfaz de precios sí tiene su multiplicador: tras el cálculo equivale a `3` de entrada, `15` de salida y `0.15` de lectura de caché en dólares por millón de tokens, en línea con el precio publicado por Google. Conviene tomar como referencia los resultados en tiempo real de la interfaz de precios de APIYI apiyi.com y confirmarlo una vez más antes de llamar.
P7: Al cambiar de modelo, ¿qué elemento se calcula mal con más frecuencia?
Los que más se equivocan son el escalonamiento por contexto largo y la vigencia de los precios. En `gpt-6.2-astra`, al superar los `272000` tokens el precio unitario de entrada pasa de `8` a `16`, y la interfaz de precios indica además que en ese caso la salida se factura a `60` y la lectura de caché a `0.8`. Carbon tiene ahora un precio de lanzamiento; a partir del 1 de diciembre, el precio estándar de Google será `4` de entrada y `20` de salida.
Puntos clave para contrastar con los benchmarks oficiales
- La puntuación del ranking tiene condiciones: corresponde a la combinación «ID del modelo + nivel de pensamiento + punto de acceso», no a la puntuación del nombre del modelo por sí solo.
- Revisa primero el nivel de pensamiento: Neon usa
highpor defecto; Carbon usamediumpor defecto y no tienexhigh; no confíes en los valores predeterminados. - Revisa después la ventana del punto de acceso: Neon en la API tiene
1,048,576tokens; la documentación de Antigravity indica un máximo de512K. - El ID debe ser el mismo: Gemini 4 tiene al menos cuatro ID; comparar los resultados de Hydrogen con el ranking de Neon no tiene sentido.
- Ajustar no garantiza igualar: alinear las condiciones solo hace que la comparación sea válida; no garantiza que la puntuación alcance la del ranking.
- Si cambias de modelo, compara el precio de lista: en APIYI apiyi.com, compara varios ID con un endpoint unificado y verifica a la vez los precios de la tabla general y de la API de precios.
Resumen
Cuando el rendimiento del modelo no alcanza el benchmark oficial, el orden para verificar tres cosas es:
- Coincidir con el nivel de pensamiento: establece explícitamente el mismo nivel usado en la prueba del ranking y confirma que ese ID tiene dicho nivel.
- Coincidir con la ventana del punto de acceso: confirma que tu punto de acceso puede contener el contenido de prueba y ten en cuenta que los nombres de nivel pueden variar según el punto de acceso.
- Coincidir con el ID del modelo: escribe el ID completo en la solicitud y vuelve a la tabla general de modelos para verificarlo palabra por palabra.
Una vez que los tres puntos coincidan, si la diferencia persiste, considera cambiar de modelo. Al cambiar de modelo, compara al mismo tiempo el nivel de capacidad, el precio unitario, los tramos de precios para contexto largo y la vigencia de los precios. En ese momento, la base para decidir son los resultados de comparación bajo las mismas condiciones, no un número de ranking citado fuera de contexto.
Recomiendo verificar varios ID de modelo en APIYI apiyi.com bajo el mismo endpoint https://api.apiyi.com/v1. Una vez fijados el punto de acceso y el nivel, las conclusiones de comparación serán mucho más fiables.
📚 Materiales de referencia
-
Tabla general de modelos de APIYI: resumen de IDs de modelo y precios de catálogo
- Enlace:
docs.apiyi.com/models.md - Descripción: la versión citada en este artículo es la actualizada el 2026-11-19 a las 10:59 (UTC+8); sirve para comprobar si un ID de modelo existe
- Enlace:
-
Interfaz de precios de APIYI: multiplicadores y precio unitario en tiempo real
- Enlace:
api.apiyi.com/api/pricing - Descripción: versión
shell-api-modelmak-v1; cuandomodel_ratiovale1, equivale a una entrada de2USD por millón de tokens, lo que permite convertir el precio unitario de cada modelo
- Enlace:
-
Documentación oficial y notas de precios de Google Gemini 4: nivel de pensamiento, ventana y precio de lista
- Enlace:
ai.google.dev - Descripción: consulta el nivel de pensamiento predeterminado de cada ID, los niveles disponibles, el límite de ventana de la API y las fechas de cambio de precios
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes ponerte en contacto con nosotros desde la página principal del sitio web oficial de APIYI; encontrarás más modelos y materiales de API en el centro de documentación de APIYI


