
作者注:自己用的模型比官方榜单差,先别急着下结论。很多时候是思考档、入口窗口或模型 ID 和榜测那一档没有对上。本文给出这三件事的核对顺序,核对完再决定是否换模型。
很多开发者会遇到同一种落差。官方公告写着某个模型在榜单上拿了高分,自己拿同类题目一试,结果明显不如预期,于是怀疑模型“变笨了”或者被“降配”了。本文介绍一个更务实的排查思路:先对上思考档、入口窗口和同一条模型 ID,再判断差距是否真实存在。
这不是一套“调三个开关就能打平官方榜”的秘籍。下面的差异全部来自公开文档。它们只能帮你确认自己比的是不是同一个东西,不能保证调完就拿到榜上的分数,也不代表 API易复现过官方榜单。
核心价值:读完本文,你会知道核对这三件事的先后顺序和每一步该看哪份文档。你还会知道核对完仍有差距时,换模型前该对哪些价格和端点。
官方基准对不上的核心要点
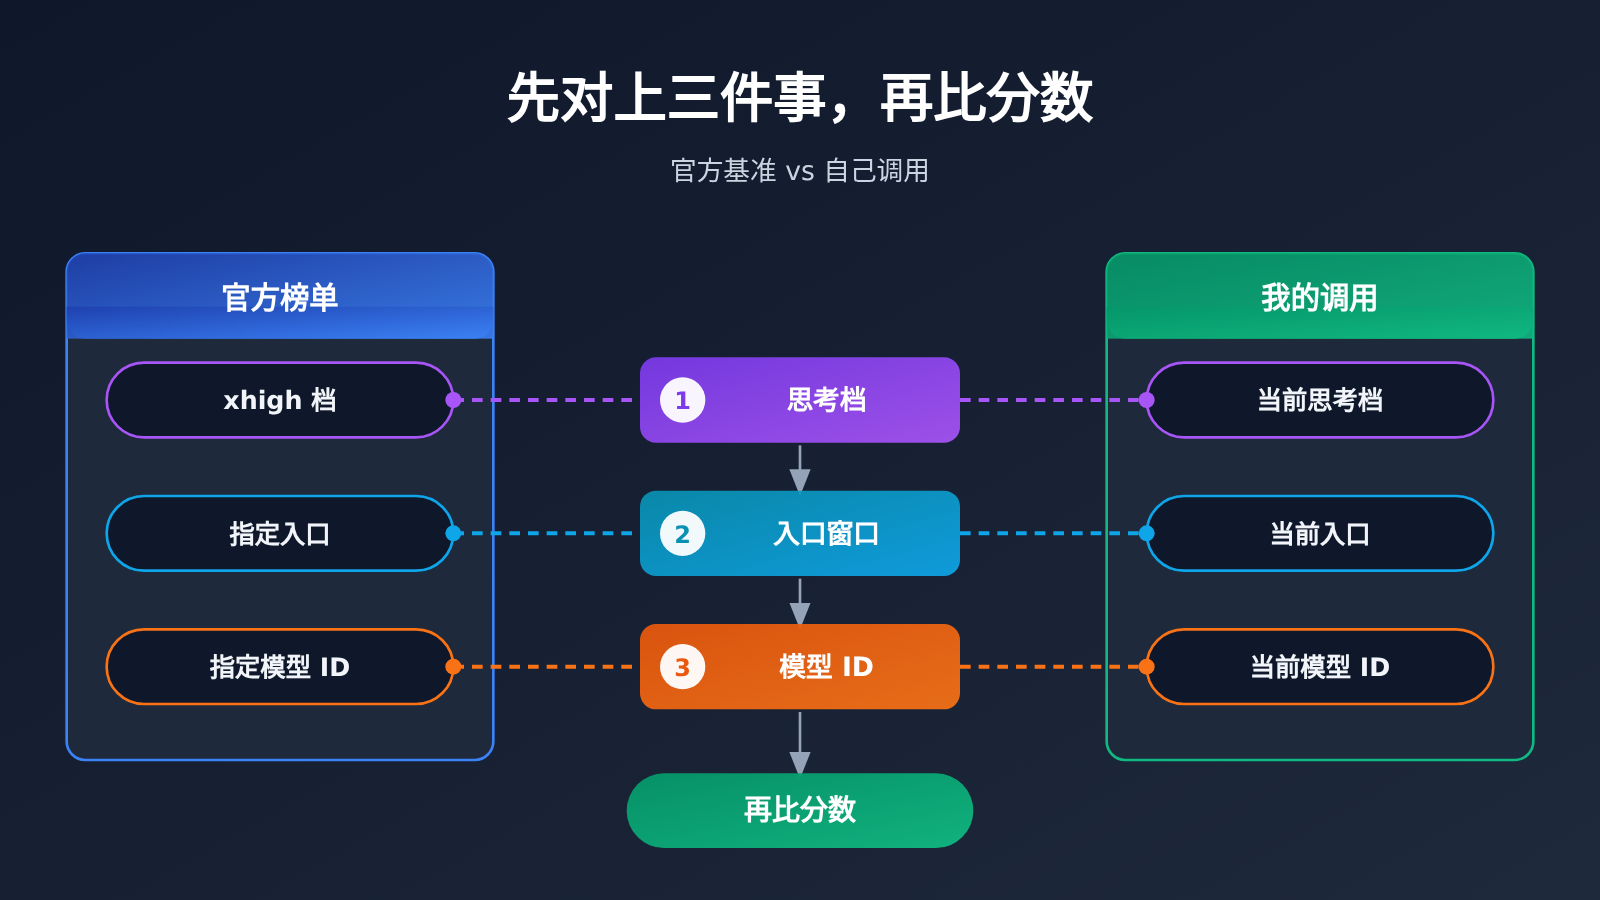
先给出结论。榜单分数从来不是“模型名”的分数,而是“某条模型 ID + 某个思考档 + 某个入口条件”下的分数。三者只要有一项不同,你拿到的结果就不能直接和榜单比。
| 核对项 | 典型差异(来自公开文档) | 对不上会怎样 | 优先级 |
|---|---|---|---|
| 思考档 | Neon 在 API 上默认 high,另有 low、medium、xhigh;Carbon 默认 medium,没有 xhigh |
输出长度和推理深度不同,结果自然不同 | 第一步 |
| 入口窗口 | Neon 的 API 窗口为 1,048,576 token,Antigravity 文档写的是最高 512K |
榜上的长上下文能力,你的入口不一定塞得下 | 第二步 |
| 模型 ID | Gemini 4 至少有 argon、carbon、hydrogen、neon 四条,思考档和标价都不一样 |
拿 A 的结果比 B 的榜,比的不是同一条 | 第三步 |
思考档为什么排在官方基准核对的第一位
思考档是最容易被忽略的变量,因为它往往有默认值,你不设置也能正常调用。问题在于,不同模型的默认值不一样。以 Gemini 4 为例,Neon 在 API 上默认是 high,Carbon 默认是 medium。同一句提示,档位不同,输出长度和最终结果都会不同。
榜单通常会写明测试档位。官方公告引用的分数,例如 Neon 在 xhigh 档下 Artificial Analysis 的 61 分,必须连档位一起读。如果你用默认的 high 去对比 xhigh 的分数,本身就不是同一个条件。更要注意的是,Carbon 根本没有 xhigh 这一档,所以“把 Carbon 调到最高”也不等于 Neon 的 xhigh。
不同入口对同一档位的叫法也可能不同。Antigravity 里 Neon 的最高档在界面上写成 Extra,和 API 文档里的 xhigh 名字不一样。核对时要按文档对应关系去找,不能只看字面。
入口窗口和模型 ID 为什么同样关键
入口窗口决定你能喂给模型多少上下文。Neon 通过 API 调用时窗口是 1,048,576 token,而 Antigravity 文档写的是最高 512K。如果榜单测的是长文档检索或大代码库理解,你在窗口更小的入口里就算换成同一个模型,也可能因为内容被截断而得到更差的结果。
模型 ID 则是最“硬”的一项。Gemini 4 这一代至少有 argon、carbon、hydrogen、neon 四条 ID,它们的思考档设置和标价都不一样。把 Hydrogen 的结果拿去对比 Neon 在 xhigh 档的榜单,差距再正常不过。调用前建议在 API易 apiyi.com 的模型总表里确认你写进请求的那条 ID 到底是哪一个,不要凭记忆或别人的截图填写。
对上官方基准的快速上手步骤
这一节把三项核对落到具体操作上。为了方便复制,参数名、模型 ID 和地址都写在行内代码里,你可以对照自己的请求逐项检查。
第一步:确认调用入口和端点
先弄清楚你是从哪个入口在用模型:网页界面、IDE 插件,还是直接调 API。不同入口的窗口上限和档位命名可能不一样。如果走 OpenAI 兼容接口,把 base_url 设为 https://api.apiyi.com/v1,api_key 填 API易控制台生成的 Key。这样后续换模型时只改 model 字段,入口条件保持一致,对比才有意义。
第二步:把模型 ID 写成完整的那一条
在请求里把 model 写成完整 ID,例如 gemini-4-neon 或 gemini-4-carbon,不要用含糊的“Gemini 4”。写完后回到模型总表核对一遍,确认这条 ID 就是榜单测的那条。如果榜单测的是 Neon,你调的却是 gemini-4-hydrogen,那后面所有对比都不用做了,先把 ID 改对。
第三步:显式设置思考档
不要依赖默认值,在请求里显式指定思考档。具体字段名请以对应模型的官方文档为准。设置时注意三点:
- 对齐榜测档位:榜单写
xhigh,你就设xhigh;写high,你就设high。 - 确认档位存在:Carbon 没有
xhigh,强行对标 Neon 的xhigh榜单没有意义。 - 留意名称映射:Antigravity 界面里的
Extra对应 Neon 的最高档,迁移到 API 时要换成文档里的档位名。
第四步:检查上下文是否超过入口窗口
如果你的测试内容很长,先估算 token 数,再和入口上限比较。走 API 调 Neon 时上限是 1,048,576 token,在 Antigravity 中文档写的是最高 512K。超过上限的内容会被截断或报错,这时候的“效果差”其实是输入不完整。
🚀 快速开始:如果想在同一入口条件下对比多条模型 ID,可以通过 API易 apiyi.com 用一个 Key 调用 Gemini、Claude、GPT 等模型。新用户有免费测试额度,适合先把档位和 ID 对齐,再做小规模对比。
三项核对的检查清单
| 检查项 | 请求里要看的字段 | 合格标准 | 常见错误 |
|---|---|---|---|
| 入口 | base_url |
固定一个入口,如 https://api.apiyi.com/v1 |
网页端测一次、API 测一次,混着比 |
| 模型 ID | model |
与榜单一致的完整 ID | 用 hydrogen 去比 neon 的榜 |
| 思考档 | 思考档参数(字段名以文档为准) | 与榜测档位一致且该档存在 | 依赖默认值;给 Carbon 设 xhigh |
| 上下文 | 输入 token 数 | 不超过入口窗口上限 | 在 512K 入口里塞百万级内容 |
官方基准核对后仍有差距:换模型前对价格和端点
三项都对上之后,差距如果仍然明显,这时才值得考虑换模型。换模型不只是换一个名字,还要同时看能力档位和成本,因为 Gemini 4 各条 ID 的标价差别不小。下面是 2026-11-20 核对的 API易货架价,单位均为美元/百万 token。
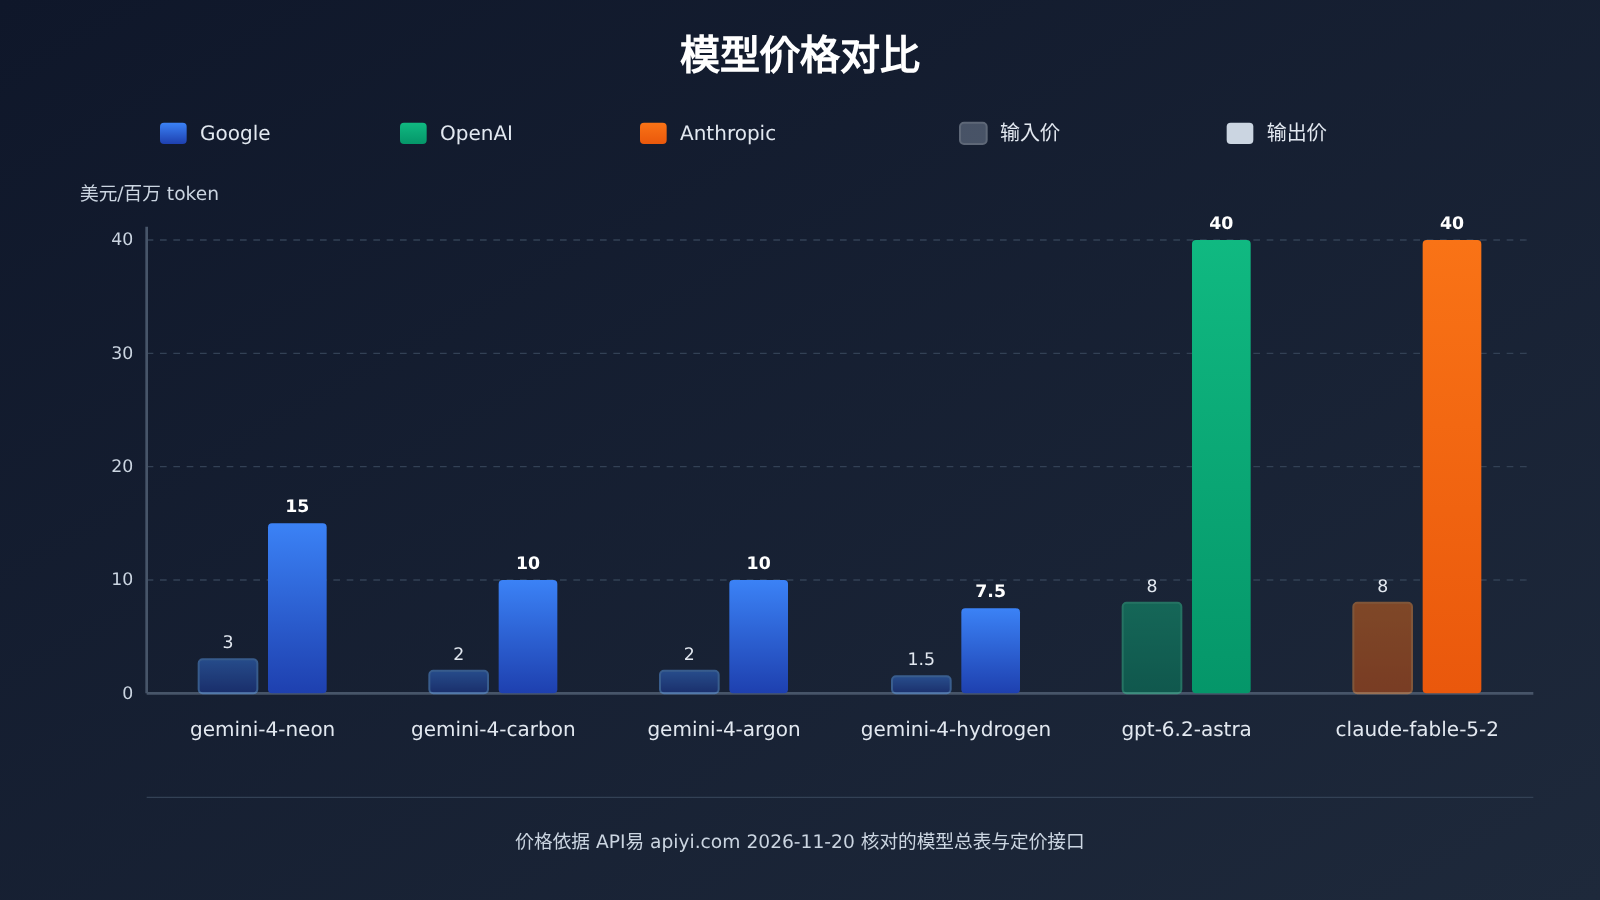
| 模型 ID | 输入 | 缓存读 | 输出 | 备注 |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
以定价接口为准,与 Google 标价一致 |
gemini-4-carbon |
2 |
0.1 |
10 |
对应 Google 到 2026-11-30 的介绍价 |
gemini-4-argon |
2 |
0.1 |
10 |
来自模型总表 |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
四条里单价最低 |
gpt-6.2-astra |
8 |
0.4 |
40 |
超过 272000 token 后输入为 16,详见下文 |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
两条 ID 价格相同 |
这张表有几处需要单独说明,否则容易算错成本:
- gemini-4-neon 的来源:2026-11-19 10:59(UTC+8)更新的那一版模型总表里没有收录它,但定价接口里有。定价接口给出的
model_ratio为1.5、completion_ratio为5、cache_ratio为0.05。按model_ratio为1等于输入2美元/百万 token 换算,得到输入3、输出15、缓存读0.15。 - gemini-4-carbon 的价格时效:当前价格对应 Google 截至 2026-11-30 的介绍价。从 12 月 1 日起,Google 的标准价是输入
4、输出20,做长期预算时要把这个变化算进去。 - gpt-6.2-astra 的分档:模型总表写的是首档输入
8、缓存读0.4、输出40,超过272000token 后输入为16。定价接口在超过272000token 时,输出按60、缓存读按0.8计算。两处信息请一起参考。
💡 选择建议:换模型时,把候选 ID 放在同一个
base_url下,用相同的思考档和输入做对比,结论才站得住。API易 apiyi.com 的模型总表和定价接口都可以查到这些 ID 的当前价格,建议调用前再确认一次,别只依赖本文这张表。
换模型时的端点与计费核对表
| 核对点 | 查哪里 | 为什么要查 |
|---|---|---|
| 模型 ID 是否存在 | 模型总表 docs.apiyi.com/models.md |
总表版本可能滞后,个别 ID 需再查定价接口 |
| 当前单价与倍率 | 定价接口 api.apiyi.com/api/pricing |
倍率可换算成美元单价,版本号为 shell-api-modelmak-v1 |
| 长上下文分档 | 总表与定价接口两处对照 | 如 gpt-6.2-astra 超过 272000 token 后单价变化 |
| 调用端点 | https://api.apiyi.com/v1 |
OpenAI 兼容格式,换模型只改 model |
| 上游价格变动 | 官方定价公告 | 如 Carbon 介绍价到 2026-11-30 结束 |
常见问题 FAQ
Q1:官方基准分数到底对应的是什么条件?
榜单分数对应的是“某条模型 ID + 某个思考档 + 某种入口条件”的组合,而不是一个笼统的模型名。比如 Neon 的 61 分是在 `xhigh` 档下的 Artificial Analysis 成绩。脱离档位单独引用这个数字,很容易产生误解。
Q2:思考档、入口窗口和模型 ID,应该先查哪个?
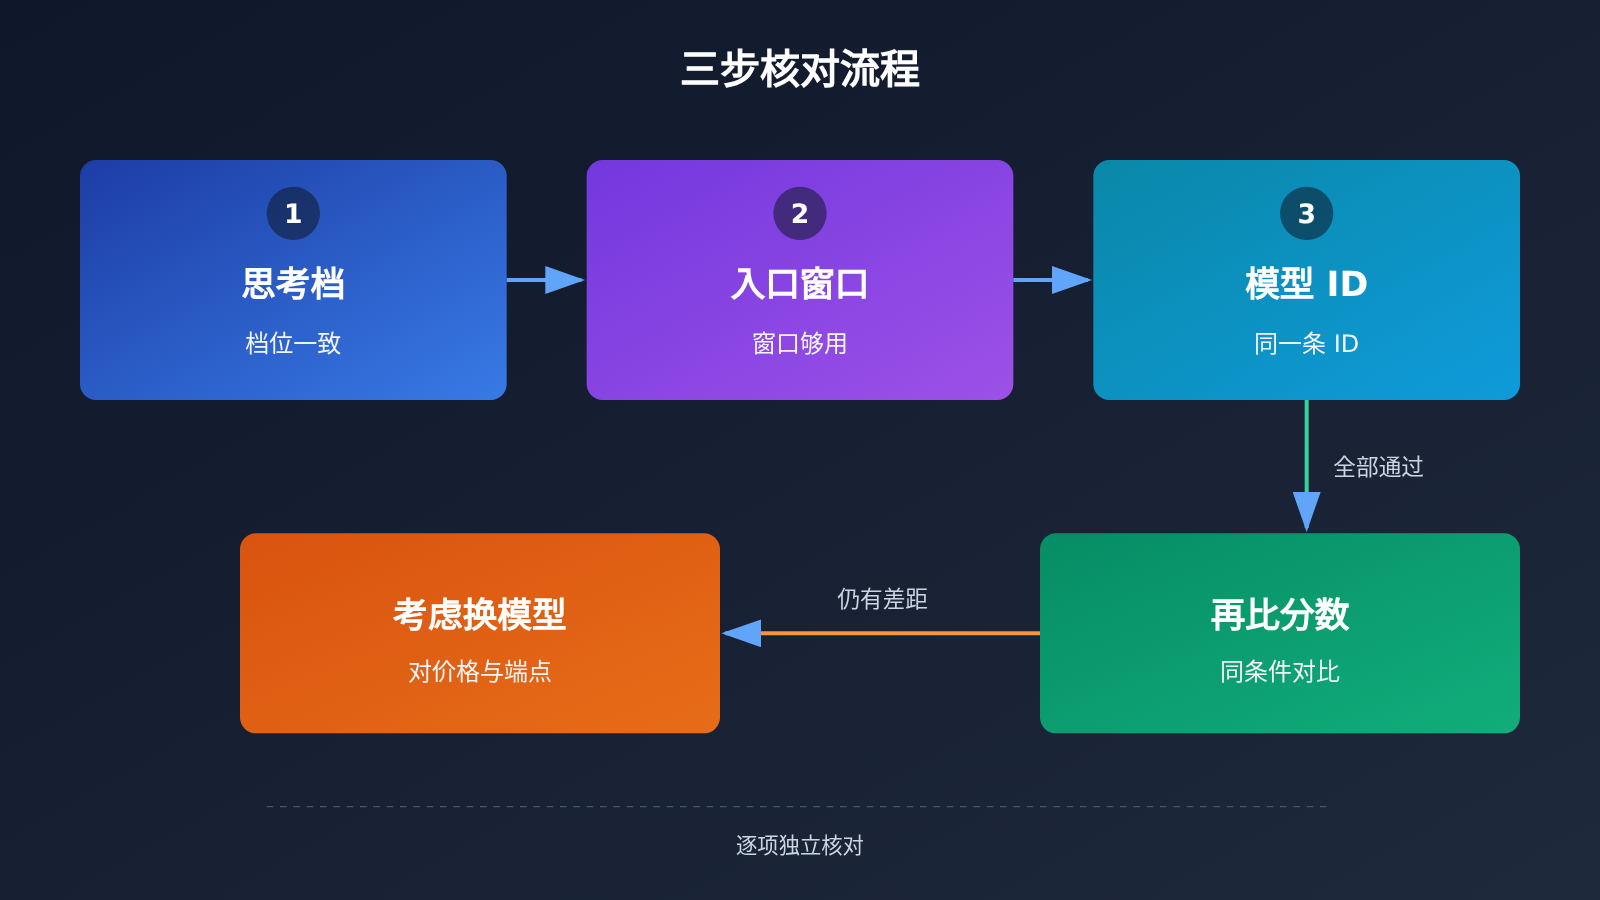
建议的顺序是先查思考档,再查入口窗口,最后核对模型 ID,三项都对上之后再比分数。实际操作中也可以先扫一眼 ID,因为 ID 错了,后面两项都不用看。顺序的意义在于逐项排除,不在于每次都按固定步骤机械执行。
Q3:把思考档调到最高,就能达到官方基准吗?
不能这样承诺。对齐档位只能保证你和榜单比的是同一个条件,题目分布、提示写法、采样方式等因素仍可能带来差异。另外并不是每条 ID 都有最高档,例如 Carbon 没有 `xhigh`,调到它的最高档也不等于 Neon 的 `xhigh`。
Q4:为什么同一个 Neon,在 IDE 里和直接调 API 效果不一样?
入口条件可能不同。Neon 走 API 时窗口是 `1,048,576` token,Antigravity 文档写的是最高 `512K`。两边的档位命名也不一样,Antigravity 界面里的最高档叫 `Extra`。长上下文任务在窗口更小的入口里表现变差,是条件差异导致的,不能说明模型本身退化。
Q5:如何在同一入口下对比多条模型 ID?
可以按下面三步操作:
1. 在 API易 apiyi.com 注册并生成 API Key,新用户可领取免费测试额度。
2. 把 `base_url` 统一设为 `https://api.apiyi.com/v1`,只改 `model` 字段切换 ID。
3. 对每条 ID 显式设置相同的思考档,用同一批输入做对比。
这样入口和档位都固定,差异就主要来自模型本身。
Q6:gemini-4-neon 在模型总表里找不到,还能调用吗?
2026-11-19 更新的那一版总表没有收录 `gemini-4-neon`,但定价接口里有它的倍率,换算后为输入 `3`、输出 `15`、缓存读 `0.15` 美元/百万 token,与 Google 标价一致。建议以 API易 apiyi.com 定价接口的实时结果为准,调用前再确认一次。
Q7:换模型时最容易算错的是哪一项?
最容易算错的是长上下文分档和价格时效。`gpt-6.2-astra` 超过 `272000` token 后输入单价从 `8` 变为 `16`,定价接口还写明此时输出按 `60`、缓存读按 `0.8`。Carbon 当前是介绍价,12 月 1 日起 Google 标准价为输入 `4`、输出 `20`。
官方基准核对 Key Takeaways
- 榜分带条件:基准分数对应“模型 ID + 思考档 + 入口”的组合,不是模型名本身的分数。
- 先查思考档:Neon 默认
high,Carbon 默认medium且没有xhigh,不要依赖默认值。 - 再查入口窗口:API 上的 Neon 有
1,048,576token,Antigravity 文档写的是最高512K。 - ID 必须同一条:Gemini 4 至少有四条 ID,用 Hydrogen 的结果去比 Neon 的榜没有意义。
- 调完不保证打平:对齐条件只是让对比成立,不承诺分数追平榜单。
- 换模型对货架价:在 API易 apiyi.com 用统一端点对比多条 ID,同时核对总表与定价接口的价格。
总结
模型表现不如官方基准时,三件事的核对顺序是:
- 对上思考档:显式设置与榜测一致的档位,并确认这条 ID 有这个档。
- 对上入口窗口:确认你的入口装得下测试内容,留意不同入口的档位命名。
- 对上模型 ID:请求里写完整 ID,回到模型总表逐字核对。
三项都对上之后,如果差距仍然存在,再考虑换模型。换模型时要同时比较能力档位、单价、长上下文分档和价格时效。这时候的判断依据是同条件下的对比结果,不是一个脱离条件引用的榜单数字。
推荐通过 API易 apiyi.com 在同一个 https://api.apiyi.com/v1 端点下验证多条模型 ID。固定入口和档位之后,对比结论会可靠得多。
📚 参考资料
-
API易模型总表:模型 ID 与货架价汇总
- 链接:
docs.apiyi.com/models.md - 说明:本文引用的是 2026-11-19 10:59(UTC+8)更新的版本,可用于核对模型 ID 是否存在
- 链接:
-
API易定价接口:实时倍率与单价
- 链接:
api.apiyi.com/api/pricing - 说明:版本
shell-api-modelmak-v1,model_ratio为1时等于输入2美元/百万 token,可换算各模型单价
- 链接:
-
Google Gemini 4 官方文档与定价说明:思考档、窗口与标价
- 链接:
ai.google.dev - 说明:查各条 ID 的默认思考档、可选档位、API 窗口上限和价格变动时间
- 链接:
作者:APIYI 技术团队
技术交流:欢迎在 API易官网首页联系我们,更多模型与接口资料可在 API易文档中心查阅


