
Autorenhinweis: Wenn das selbst genutzte Modell schlechter abschneidet als in der offiziellen Rangliste, sollte man nicht vorschnell Schlussfolgerungen ziehen. Oft stimmen Denkstufe, Einstiegskontext oder Modell-ID nicht mit der Stufe überein, die im Benchmark getestet wurde. Dieser Artikel beschreibt die Reihenfolge, in der man diese drei Dinge prüft – und erst danach entscheidet, ob ein Modellwechsel nötig ist.
Viele Entwickler erleben dieselbe Diskrepanz. In der offiziellen Ankündigung heißt es, ein Modell habe in der Rangliste eine hohe Punktzahl erzielt. Testet man dann selbst mit ähnlichen Aufgaben, fällt das Ergebnis deutlich schlechter aus als erwartet – und schon kommt der Verdacht auf, das Modell sei „dümmer geworden“ oder „heruntergestuft“ worden. Dieser Artikel stellt einen pragmatischeren Diagnoseansatz vor: Zuerst Denkstufe, Einstiegskontext und dieselbe Modell-ID abgleichen und erst dann beurteilen, ob die Lücke tatsächlich existiert.
**Das ist kein Trick, mit dem man „drei Schalter umlegt und schon die offizielle Rangliste erreicht“. ** Die folgenden Unterschiede stammen alle aus öffentlich zugänglicher Dokumentation. Sie helfen nur dabei, zu prüfen, ob man überhaupt dasselbe vergleicht; sie garantieren nicht, dass man nach dem Anpassen die Punktzahl aus der Rangliste erhält, und bedeuten auch nicht, dass APIYI die offizielle Rangliste reproduziert hat.
Der Kernnutzen: Nach dem Lesen dieses Artikels wissen Sie, in welcher Reihenfolge Sie diese drei Dinge prüfen und welche Dokumentation Sie bei jedem Schritt heranziehen sollten. Sie wissen außerdem, welche Preise und Endpunkte Sie abgleichen sollten, bevor Sie das Modell wechseln, falls nach der Prüfung weiterhin eine Lücke besteht.
Warum die offiziellen Benchmarks nicht übereinstimmen – die Kernpunkte
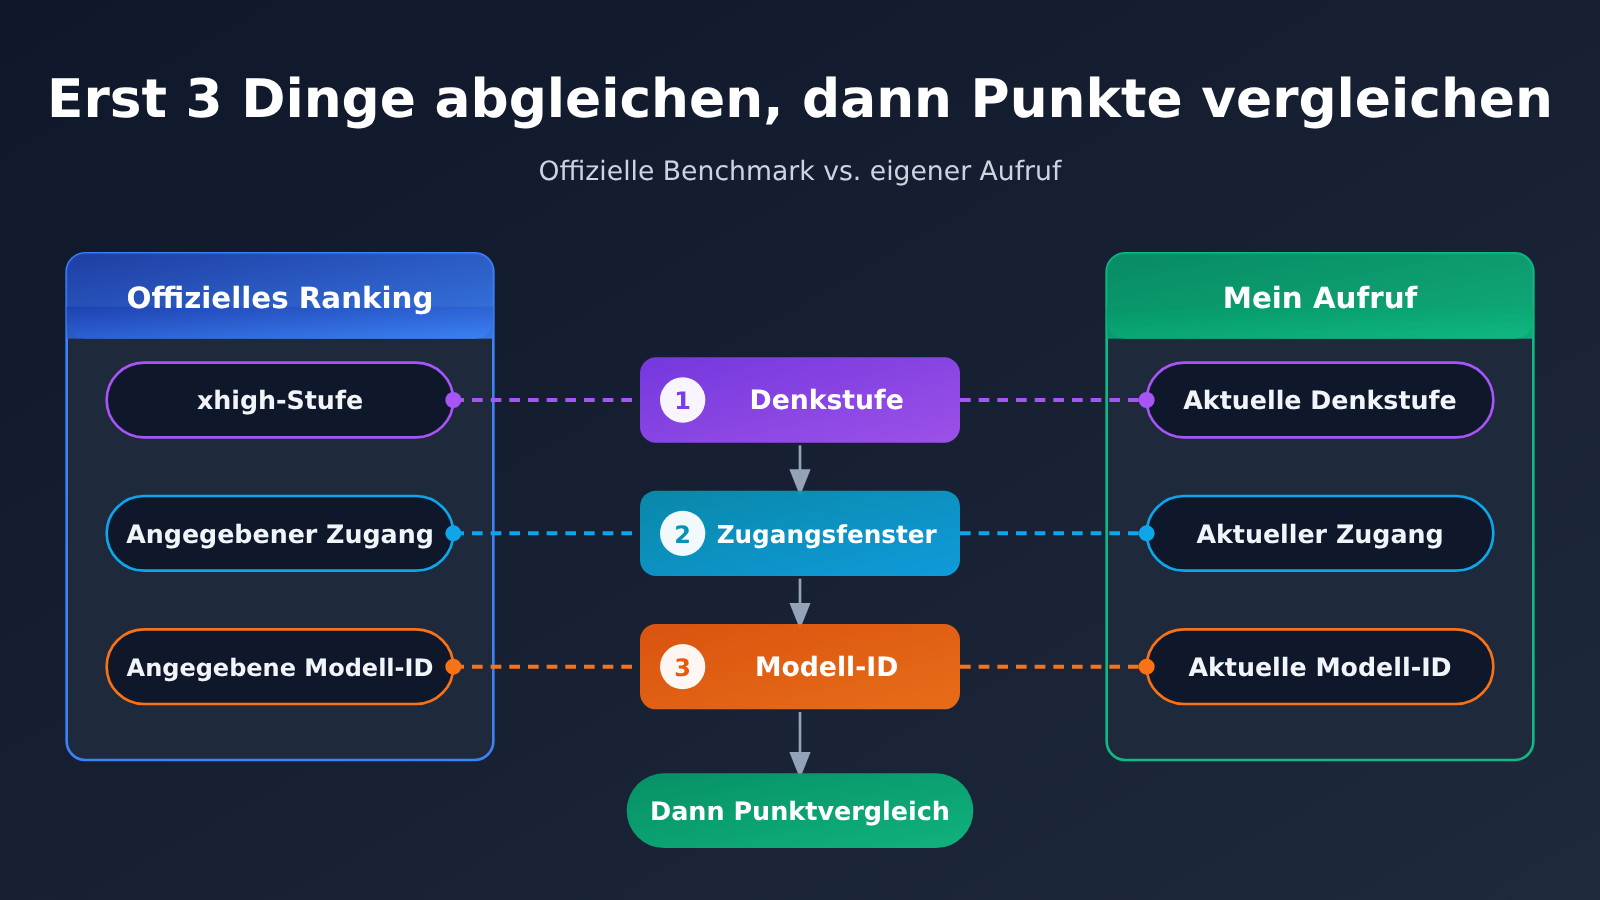
Zuerst die Schlussfolgerung: Eine Punktzahl im Ranking ist nie die Punktzahl „des Modells“, sondern die Punktzahl unter „einer bestimmten Modell-ID + einer bestimmten Reasoning-Stufe + einer bestimmten Zugangsbedingung“. Weicht nur einer dieser drei Faktoren ab, lassen sich Ihre Ergebnisse nicht direkt mit dem Ranking vergleichen.
| Prüfpunkt | Typische Abweichung (laut öffentlicher Dokumentation) | Was passiert, wenn es nicht übereinstimmt | Priorität |
|---|---|---|---|
| Reasoning-Stufe | Neon nutzt in der API standardmäßig high, daneben gibt es low, medium und xhigh; Carbon nutzt standardmäßig medium und kennt kein xhigh |
Unterschiedliche Ausgabelänge und Reasoning-Tiefe – die Ergebnisse weichen zwangsläufig ab | Schritt 1 |
| Eingangs-Kontextfenster | Das API-Fenster von Neon umfasst 1,048,576 Token, die Antigravity-Dokumentation nennt maximal 512K |
Die Long-Context-Fähigkeit aus dem Ranking passt nicht zwingend in Ihren Zugang | Schritt 2 |
| Modell-ID | Gemini 4 hat mindestens vier Varianten – argon, carbon, hydrogen und neon – mit jeweils eigenen Reasoning-Stufen und Preisen |
Wer die Ergebnisse von A mit dem Ranking von B vergleicht, vergleicht nicht dieselbe Variante | Schritt 3 |
Warum die Reasoning-Stufe beim Abgleich mit offiziellen Benchmarks an erster Stelle steht
Die Reasoning-Stufe ist die Variable, die am leichtesten übersehen wird, denn sie hat meist einen Default-Wert – ein Aufruf funktioniert auch, ohne dass Sie sie setzen. Das Problem: Bei verschiedenen Modellen sind die Defaults unterschiedlich. Bei Gemini 4 etwa ist Neon in der API standardmäßig auf high, Carbon auf medium. Bei derselben Eingabeaufforderung unterscheiden sich Ausgabelänge und Endergebnis je nach Stufe.
Rankings geben in der Regel die getestete Stufe an. Punktzahlen, die in offiziellen Ankündigungen zitiert werden – etwa die 61 Punkte, die Neon in der Stufe xhigh bei Artificial Analysis erreicht – müssen immer zusammen mit der Stufe gelesen werden. Wer den Standard high mit einem xhigh-Ergebnis vergleicht, vergleicht schlicht nicht dieselben Bedingungen. Noch wichtiger: Carbon kennt die Stufe xhigh überhaupt nicht. „Carbon auf Maximum stellen“ ist also nicht dasselbe wie xhigh bei Neon.
Verschiedene Zugänge können dieselbe Stufe zudem unterschiedlich benennen. In Antigravity heißt die höchste Stufe von Neon in der Oberfläche Extra – anders als xhigh in der API-Dokumentation. Beim Abgleich müssen Sie über die in der Dokumentation beschriebene Zuordnung gehen und dürfen sich nicht auf den Wortlaut verlassen.
Warum Einstiegsfenster und Modell-ID gleichermaßen entscheidend sind
Das Einstiegsfenster bestimmt, wie viel Kontext du dem Modell zuführen kannst. Beim Aufruf über die API beträgt das Fenster von Neon 1,048,576 Token, während die Antigravity-Dokumentation maximal 512K angibt. Wenn das Ranking Langdokument-Retrieval oder das Verständnis großer Codebasen testet, kannst du selbst mit demselben Modell in einem Einstieg mit kleinerem Fenster schlechtere Ergebnisse bekommen, weil die Inhalte abgeschnitten werden.
Die Modell-ID ist der „härteste“ Punkt. Die Gemini-4-Generation hat mindestens vier IDs – argon, carbon, hydrogen und neon –, deren Denkstufen-Einstellungen und Preise sich alle unterscheiden. Wenn du die Ergebnisse von Hydrogen mit dem Ranking von Neon auf der Stufe xhigh vergleichst, ist eine Abweichung völlig normal. Vor dem Aufruf solltest du in der Modelltabelle von APIYI apiyi.com prüfen, welche ID du tatsächlich in die Anfrage schreibst – verlass dich nicht auf dein Gedächtnis oder auf Screenshots von anderen.
Schnellstart zum Abgleich mit dem offiziellen Benchmark
In diesem Abschnitt werden die drei Prüfungen in konkrete Schritte übersetzt. Damit du alles bequem kopieren kannst, stehen Parameternamen, Modell-IDs und Adressen im Inline-Code; du kannst deine eigene Anfrage Punkt für Punkt dagegen prüfen.
Schritt 1: Einstiegspunkt und Endpunkt des Aufrufs prüfen
Kläre zuerst, über welchen Einstiegspunkt du das Modell nutzt: Weboberfläche, IDE-Plugin oder direkter API-Aufruf. Je nach Einstiegspunkt können das Limit des Kontextfensters und die Benennung der Stufen unterschiedlich sein. Wenn du die OpenAI-kompatible Schnittstelle nutzt, setze base_url auf https://api.apiyi.com/v1 und trage bei api_key den API-Schlüssel ein, den du in der APIYI-Konsole erzeugt hast. So änderst du beim späteren Modellwechsel nur das Feld model; die Bedingungen am Einstiegspunkt bleiben gleich, und nur dann ist ein Vergleich aussagekräftig.
Schritt 2: Die Modell-ID vollständig angeben
Schreibe in der Anfrage für model die vollständige ID, zum Beispiel gemini-4-neon oder gemini-4-carbon, und nicht das vage „Gemini 4“. Prüfe danach noch einmal in der Modellübersicht, ob genau diese ID die im Leaderboard getestete ist. Wenn im Leaderboard Neon getestet wurde, du aber gemini-4-hydrogen aufrufst, kannst du dir alle weiteren Vergleiche sparen – korrigiere zuerst die ID.
Schritt 3: Reasoning-Stufe explizit festlegen
Verlasse dich nicht auf Standardwerte, sondern gib die Reasoning-Stufe in der Anfrage ausdrücklich an. Den genauen Feldnamen entnimmst du der offiziellen Dokumentation des jeweiligen Modells. Beim Festlegen sind drei Punkte wichtig:
- An die im Leaderboard getestete Stufe angleichen: Steht dort
xhigh, setzexhigh; steht dorthigh, setzehigh. - Prüfen, ob die Stufe existiert: Carbon hat kein
xhigh; ein erzwungener Vergleich mit demxhigh-Leaderboard von Neon ergibt keinen Sinn. - Namenszuordnung beachten:
Extrain der Antigravity-Oberfläche entspricht der höchsten Stufe von Neon; beim Umstieg auf die API musst du den in der Dokumentation angegebenen Stufennamen verwenden.
Schritt 4: Prüfen, ob die Eingabe das Fenster des Einstiegspunkts überschreitet
Wenn dein Testinhalt sehr lang ist, schätze zuerst die Token-Anzahl und vergleiche sie mit dem Limit des Einstiegspunkts. Beim Aufruf von Neon über die API liegt das Limit bei 1,048,576 Token; in der Antigravity-Dokumentation steht maximal 512K. Inhalte über dem Limit werden abgeschnitten oder verursachen Fehler; die dann beobachtete „schlechte Leistung“ liegt in Wahrheit an einer unvollständigen Eingabe.
🚀 Schnellstart: Wenn du mehrere Modell-IDs unter denselben Bedingungen am Einstiegspunkt vergleichen willst, kannst du über APIYI apiyi.com mit einem API-Schlüssel Gemini, Claude, GPT und weitere Modelle aufrufen. Neue Nutzer erhalten ein kostenloses Testguthaben; das eignet sich gut dafür, zuerst Stufen und IDs abzugleichen und danach einen kleinen Vergleich durchzuführen.
Checkliste für die drei Prüfungen
| Prüfpunkt | Feld in der Anfrage | Erfüllungskriterium | Häufige Fehler |
|---|---|---|---|
| Einstiegspunkt | base_url |
Einen Einstiegspunkt festlegen, z. B. https://api.apiyi.com/v1 |
Einmal im Web-Frontend, einmal über die API testen und beides vermischen |
| Modell-ID | model |
Vollständige ID, die mit dem Leaderboard übereinstimmt | Mit hydrogen gegen das neon-Leaderboard antreten |
| Reasoning-Stufe | Parameter der Reasoning-Stufe (Feldname laut Dokumentation) | Mit der im Leaderboard getesteten Stufe übereinstimmen; die Stufe muss existieren | Sich auf Standardwerte verlassen; Carbon auf xhigh setzen |
| Kontext | Anzahl der Eingabe-Token | Überschreitet nicht das Fensterlimit des Einstiegspunkts | In einen 512K-Einstiegspunkt Inhalte im Millionen-Token-Bereich packen |
Trotz Abgleich mit den offiziellen Benchmarks bleibt eine Lücke: Vor dem Modellwechsel Preise und Endpunkte prüfen
Wenn alle drei Punkte übereinstimmen und die Lücke dann immer noch deutlich ausfällt, lohnt es sich erst dann, über einen Modellwechsel nachzudenken. Ein Modellwechsel heißt nicht nur, einen anderen Namen einzusetzen – man muss gleichzeitig die Fähigkeitsstufe und die Kosten im Blick behalten, denn die ausgewiesenen Preise der einzelnen Gemini-4-IDs unterscheiden sich deutlich. Unten stehen die am 20.11.2026 geprüften Listenpreise von APIYI, alle Angaben in US-Dollar pro Million Token.
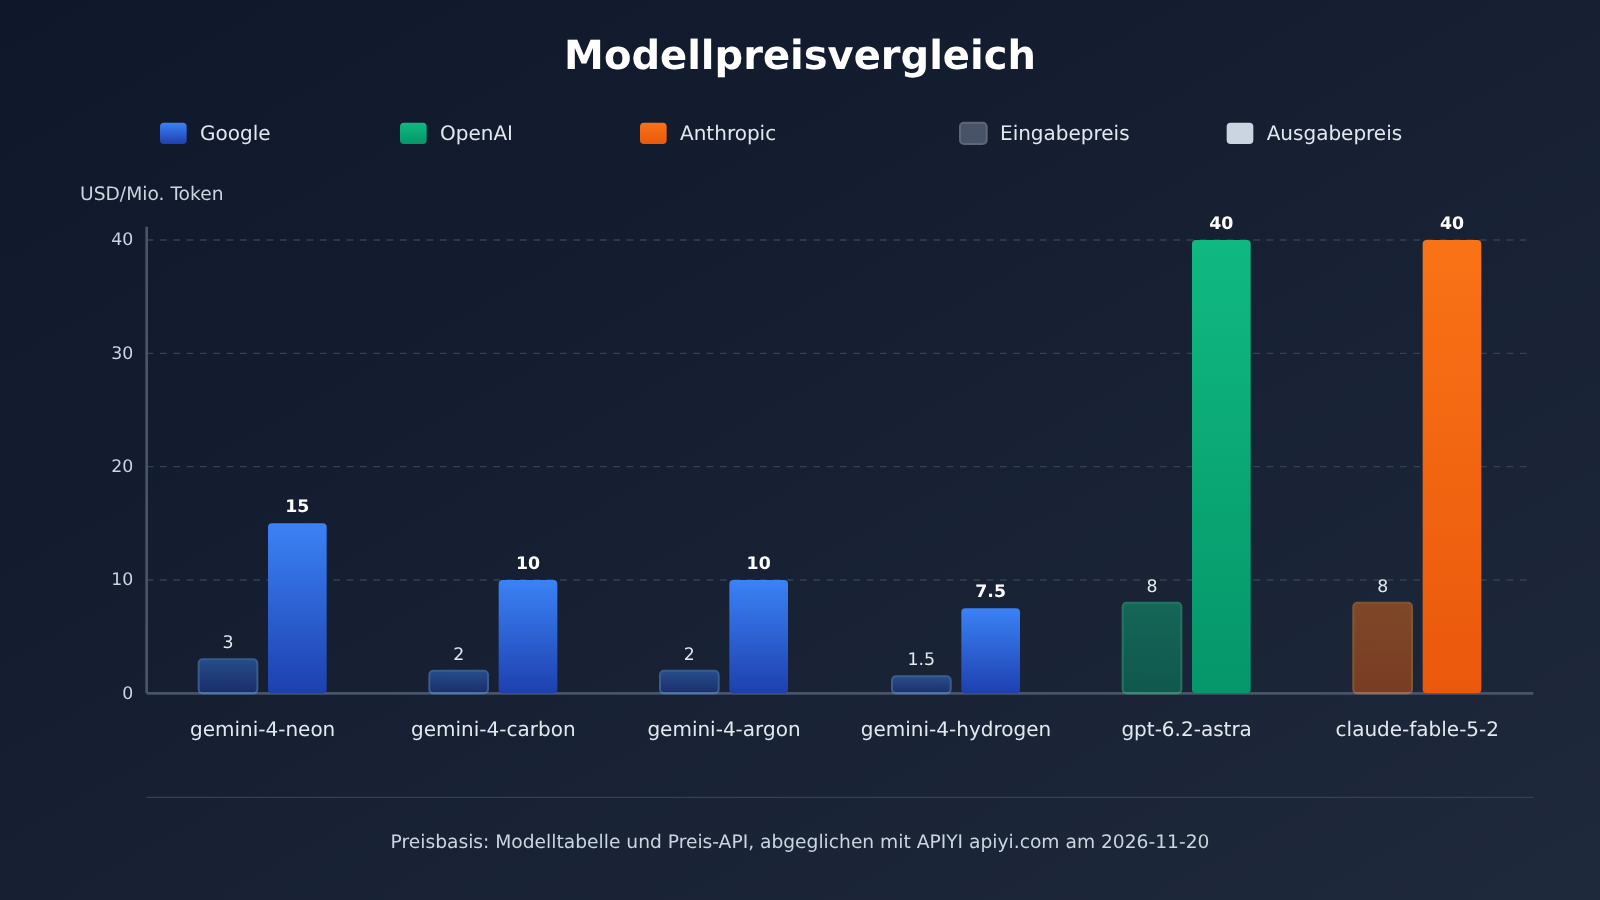
| Modell-ID | Eingabe | Cache-Lesen | Ausgabe | Anmerkung |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Maßgeblich ist die Preis-API, stimmt mit Googles Listenpreis überein |
gemini-4-carbon |
2 |
0.1 |
10 |
Entspricht Googles Einführungspreis bis zum 30.11.2026 |
gemini-4-argon |
2 |
0.1 |
10 |
Aus der Modellübersicht |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Niedrigster Stückpreis der vier |
gpt-6.2-astra |
8 |
0.4 |
40 |
Ab mehr als 272000 Token beträgt die Eingabe 16, siehe unten |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Beide IDs haben denselben Preis |
Zu dieser Tabelle gibt es einige Punkte, die man separat erklären muss – sonst rechnet man die Kosten leicht falsch:
- Herkunft von gemini-4-neon: In der Version der Modellübersicht, die am 19.11.2026 um 10:59 Uhr (UTC+8) aktualisiert wurde, ist es nicht enthalten, in der Preis-API aber schon. Die Preis-API gibt
model_ratiomit1.5,completion_ratiomit5undcache_ratiomit0.05an. Rechnet man damit, dassmodel_ratio1einer Eingabe von2US-Dollar pro Million Token entspricht, ergeben sich Eingabe3, Ausgabe15und Cache-Lesen0.15. - Gültigkeitsdauer des Preises von gemini-4-carbon: Der aktuelle Preis entspricht Googles Einführungspreis bis zum 30.11.2026. Ab dem 1. Dezember gilt bei Google der Standardpreis mit Eingabe
4und Ausgabe20; bei einer langfristigen Budgetplanung muss man diese Änderung einkalkulieren. - Staffelung bei gpt-6.2-astra: Die Modellübersicht nennt für die erste Stufe Eingabe
8, Cache-Lesen0.4und Ausgabe40; ab mehr als272000Token beträgt die Eingabe16. Die Preis-API berechnet bei mehr als272000Token die Ausgabe mit60und das Cache-Lesen mit0.8. Bitte ziehen Sie beide Angaben gemeinsam heran.
💡 Auswahl-Tipp: Wenn Sie das Modell wechseln, stellen Sie die Kandidaten-IDs unter dasselbe
base_urlund vergleichen Sie mit der gleichen Denkstufe und derselben Eingabe – nur dann ist die Schlussfolgerung belastbar. In der Modellübersicht und der Preis-API von APIYI apiyi.com lassen sich die aktuellen Preise dieser IDs nachschlagen; am besten vor dem Aufruf noch einmal bestätigen und sich nicht nur auf diese Tabelle hier verlassen.
Checkliste für Endpunkte und Abrechnung beim Modellwechsel
| Prüfpunkt | Wo nachschauen | Warum prüfen |
|---|---|---|
| Existiert die Modell-ID? | Modellübersicht docs.apiyi.com/models.md |
Die Version der Übersicht kann veraltet sein, einzelne IDs müssen zusätzlich über die Pricing-Schnittstelle geprüft werden |
| Aktueller Einzelpreis und Multiplikator | Pricing-Schnittstelle api.apiyi.com/api/pricing |
Der Multiplikator lässt sich in einen USD-Einzelpreis umrechnen, die Versionsnummer lautet shell-api-modelmak-v1 |
| Staffelung für langen Kontext | Abgleich in Übersicht und Pricing-Schnittstelle | Bei gpt-6.2-astra ändert sich der Einzelpreis zum Beispiel nach mehr als 272000 Token |
| Aufruf-Endpunkt | https://api.apiyi.com/v1 |
OpenAI-kompatibles Format, beim Modellwechsel ändert sich nur model |
| Änderungen der Upstream-Preise | Offizielle Preisbekanntmachung | Der Einführungspreis für Carbon endet zum Beispiel am 2026-11-30 |
Häufig gestellte Fragen (FAQ)
F1: Welchen Bedingungen entsprechen die offiziellen Benchmark-Punktzahlen eigentlich?
Die Punktzahl der Rangliste entspricht einer Kombination aus „einer bestimmten Modell-ID + einer bestimmten Denkstufe + einer bestimmten Zugangsbedingung“ und nicht einem pauschalen Modellnamen. Neons 61 Punkte etwa sind ein Ergebnis von Artificial Analysis auf der Stufe `xhigh`. Zitiert man diese Zahl losgelöst von der Stufe, entstehen leicht Missverständnisse.
F2: Denkstufe, Zugangsfenster und Modell-ID – was sollte man zuerst prüfen?
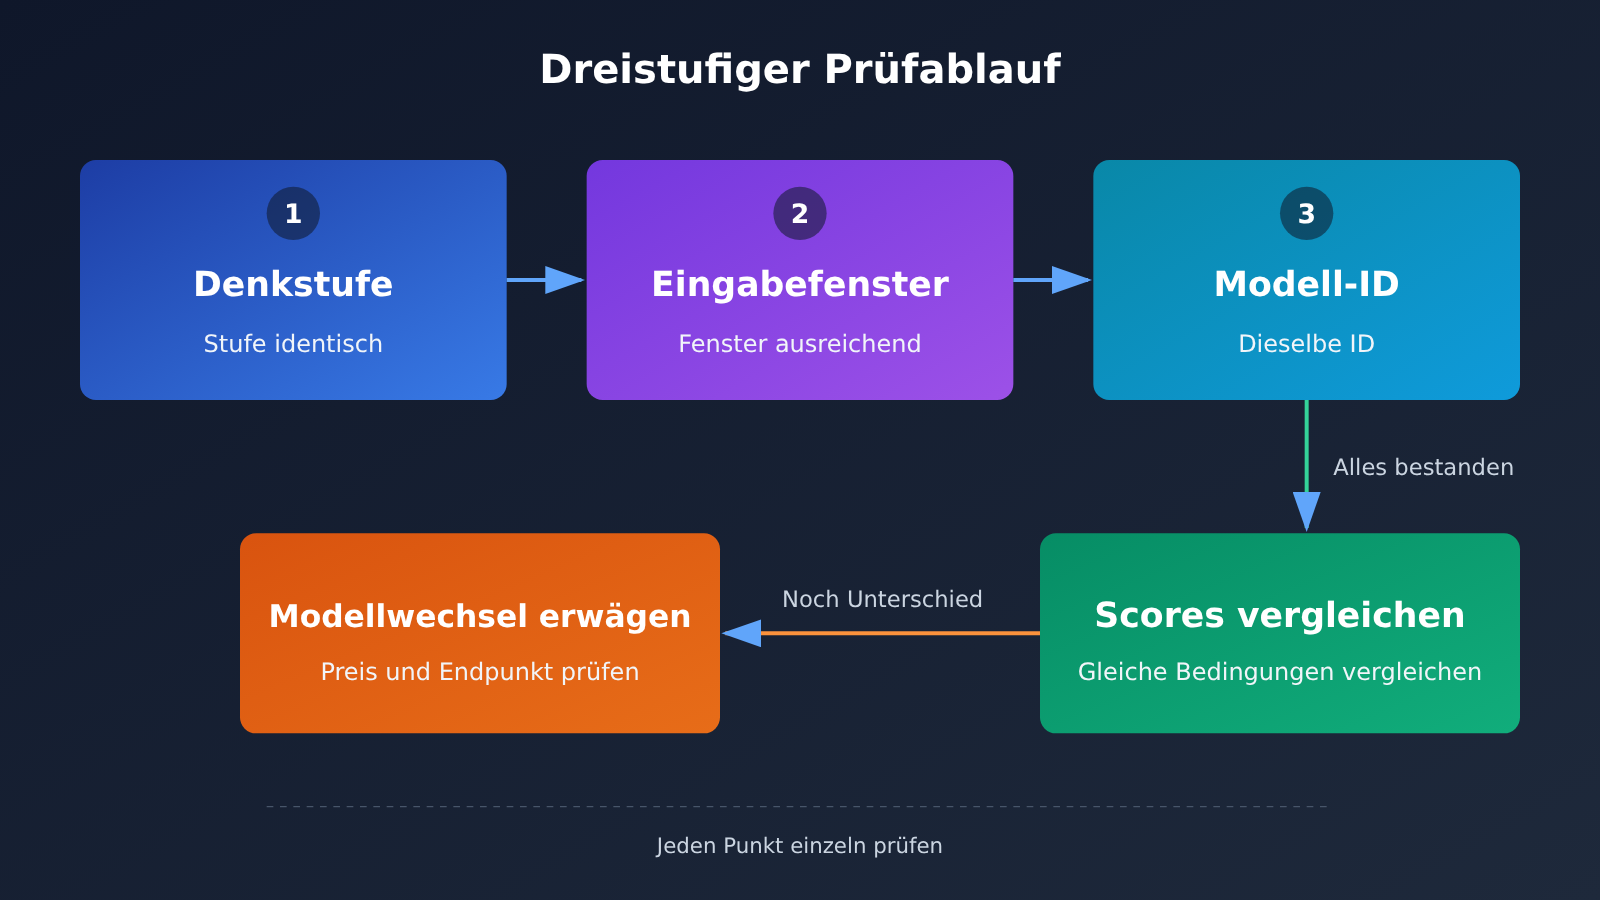
Die empfohlene Reihenfolge ist: zuerst die Denkstufe, dann das Zugangsfenster, und zuletzt die Modell-ID abgleichen. Erst wenn alle drei Punkte übereinstimmen, sollte man die Punktzahlen vergleichen. In der Praxis kann man auch zuerst einen Blick auf die ID werfen, denn ist die ID falsch, muss man die anderen beiden Punkte gar nicht mehr prüfen. Der Sinn der Reihenfolge liegt im schrittweisen Ausschließen, nicht darin, jedes Mal mechanisch nach festen Schritten vorzugehen.
F3: Reicht es, die Denkstufe auf das Maximum zu stellen, um den offiziellen Benchmark zu erreichen?
Das lässt sich nicht versprechen. Die Stufe anzugleichen garantiert nur, dass man unter derselben Bedingung wie die Rangliste vergleicht. Faktoren wie Aufgabenverteilung, Formulierung der Eingabeaufforderung und Sampling-Verfahren können weiterhin Unterschiede verursachen. Außerdem hat nicht jede ID eine höchste Stufe – Carbon etwa hat kein `xhigh`, und seine höchste Stufe zu wählen ist nicht dasselbe wie Neons `xhigh`.
F4: Warum verhält sich dasselbe Neon in der IDE anders als beim direkten API-Aufruf?
Die Zugangsbedingungen können unterschiedlich sein. Bei Neon über die API beträgt das Fenster `1,048,576` Token, während die Antigravity-Dokumentation maximal `512K` angibt. Auch die Benennung der Stufen unterscheidet sich: Die höchste Stufe in der Antigravity-Oberfläche heißt `Extra`. Dass Aufgaben mit langem Kontext bei einem Zugang mit kleinerem Fenster schlechter abschneiden, liegt an den unterschiedlichen Bedingungen und bedeutet nicht, dass das Modell selbst schlechter geworden ist.
F5: Wie vergleicht man mehrere Modell-IDs unter demselben Zugang?
In drei Schritten:
1. Bei APIYI apiyi.com registrieren und einen API-Schlüssel erzeugen; neue Nutzer erhalten ein kostenloses Testguthaben.
2. `base_url` einheitlich auf `https://api.apiyi.com/v1` setzen und zum Wechseln der ID nur das Feld `model` ändern.
3. Für jede ID explizit dieselbe Denkstufe einstellen und mit derselben Eingabemenge vergleichen.
So sind Zugang und Stufe festgelegt, und die Unterschiede stammen hauptsächlich vom Modell selbst.
F6: gemini-4-neon ist in der Modellübersicht nicht zu finden – kann man es trotzdem aufrufen?
Die am 2026-11-19 aktualisierte Version der Übersicht enthält `gemini-4-neon` nicht, aber die Preis-API führt den Multiplikator dafür: umgerechnet `3` für den Input, `15` für den Output und `0.15` für Cache-Lesen in US-Dollar pro Million Token, was mit Googles Listenpreis übereinstimmt. Es empfiehlt sich, den Echtzeit-Ergebnissen der Preis-API von APIYI apiyi.com zu vertrauen und vor dem Aufruf noch einmal zu prüfen.
F7: Welcher Punkt wird beim Modellwechsel am häufigsten falsch berechnet?
Am häufigsten falsch berechnet werden die Abstufung bei langem Kontext und die Aktualität der Preise. Bei `gpt-6.2-astra` ändert sich der Input-Stückpreis ab mehr als `272000` Token von `8` auf `16`; die Preis-API gibt außerdem an, dass in diesem Fall der Output mit `60` und das Cache-Lesen mit `0.8` berechnet werden. Carbon hat aktuell einen Einführungspreis; ab dem 1. Dezember liegt Googles Standardpreis bei `4` für den Input und `20` für den Output.
Offizieller Benchmark-Abgleich: Die wichtigsten Punkte
- Benchmark-Werte sind an Bedingungen geknüpft: Ein Benchmark-Ergebnis bezieht sich immer auf die Kombination aus „Modell-ID + Denkstufe + Einstiegspunkt“ – nicht auf die Punktzahl des Modellnamens allein.
- Zuerst die Denkstufe prüfen: Neon nutzt standardmäßig
high, Carbon standardmäßigmediumund kennt keinxhigh. Verlassen Sie sich nicht auf die Standardwerte. - Dann das Einstiegsfenster prüfen: Neon über die API bietet
1,048,576Token, während die Antigravity-Dokumentation maximal512Kangibt. - Die ID muss dieselbe sein: Gemini 4 hat mindestens vier IDs. Es ergibt keinen Sinn, die Ergebnisse von Hydrogen mit dem Neon-Ranking zu vergleichen.
- Anpassen garantiert keinen Gleichstand: Das Angleichen der Bedingungen macht den Vergleich erst gültig – es verspricht aber nicht, dass die Punktzahl das Ranking einholt.
- Modellwechsel heißt auch Listenpreis abgleichen: Vergleichen Sie bei APIYI apiyi.com mehrere IDs über einen einheitlichen Endpunkt und prüfen Sie gleichzeitig die Preise in der Gesamtübersicht und über die Preis-API.
Zusammenfassung
Wenn die Modellleistung hinter dem offiziellen Benchmark zurückbleibt, empfiehlt sich diese Prüfreihenfolge für drei Dinge:
- Denkstufe angleichen: Stellen Sie die Stufe explizit auf den Wert, der beim Benchmark verwendet wurde, und prüfen Sie, ob diese ID die Stufe überhaupt hat.
- Einstiegsfenster angleichen: Vergewissern Sie sich, dass Ihr Einstiegspunkt den Testinhalt aufnehmen kann, und achten Sie auf die unterschiedlichen Stufenbezeichnungen je Einstiegspunkt.
- Modell-ID angleichen: Schreiben Sie die vollständige ID in die Anfrage und gleichen Sie sie wortwörtlich mit der Modell-Gesamtübersicht ab.
Stimmen alle drei Punkte überein und bleibt die Lücke trotzdem bestehen, denken Sie erst dann über einen Modellwechsel nach. Beim Wechsel sollten Sie gleichzeitig die Fähigkeitsstufe, den Stückpreis, die Abstufungen beim langen Kontext und die Aktualität der Preise vergleichen. Die Entscheidungsgrundlage sind dann Vergleichsergebnisse unter gleichen Bedingungen – nicht eine Ranking-Zahl, die ohne ihre Bedingungen zitiert wird.
Empfohlen: Verifizieren Sie bei APIYI apiyi.com mehrere Modell-IDs über denselben Endpunkt https://api.apiyi.com/v1. Sobald Einstiegspunkt und Stufe festgelegt sind, werden die Vergleichsschlüsse deutlich verlässlicher.
📚 Referenzmaterialien
-
APIYI-Modellübersicht: Zusammenfassung der Modell-IDs und Listenpreise
- Link:
docs.apiyi.com/models.md - Hinweis: Im Artikel wird die am 2026-11-19 10:59 (UTC+8) aktualisierte Version referenziert; damit lässt sich prüfen, ob eine Modell-ID vorhanden ist
- Link:
-
APIYI-Preisschnittstelle: Echtzeit-Multiplikatoren und Stückpreise
- Link:
api.apiyi.com/api/pricing - Hinweis: Version
shell-api-modelmak-v1; einmodel_ratiovon1entspricht einem Input von 2 US-Dollar pro Million Token, worüber sich der Stückpreis der einzelnen Modelle umrechnen lässt
- Link:
-
Offizielle Dokumentation und Preisseite zu Google Gemini 4: Denkstufen, Fenster und Listenpreise
- Link:
ai.google.dev - Hinweis: Hier finden sich die Standard-Denkstufe, die wählbaren Stufen, das API-Fensterlimit und der Zeitpunkt von Preisänderungen für die einzelnen IDs
- Link:
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Modell- und Schnittstelleninformationen finden Sie im APIYI-Dokumentationszentrum


