
Respuesta directa: la API Batch de OpenAI encaja con tareas en las que «el resultado puede llegar un poco más tarde, las solicitudes son independientes entre sí y el volumen es muy grande». Su precio es la mitad del de la API sincrónica y usa un pool de límites de velocidad independiente. Su restricción es una ventana de procesamiento de 24 horas, y esa ventana no garantiza que el resultado se entregue en un momento concreto. Trabajos offline como la clasificación con reglas predefinidas, el procesamiento de bases de conocimiento o la evaluación de modelos pueden considerar Batch en primer lugar. La atención al cliente en tiempo real, las interacciones que necesitan respuesta inmediata y los flujos con dependencias en los que el resultado de un paso determina el contenido del siguiente no deberían delegarse a la API Batch.
¿Qué aprenderá al leer este artículo?
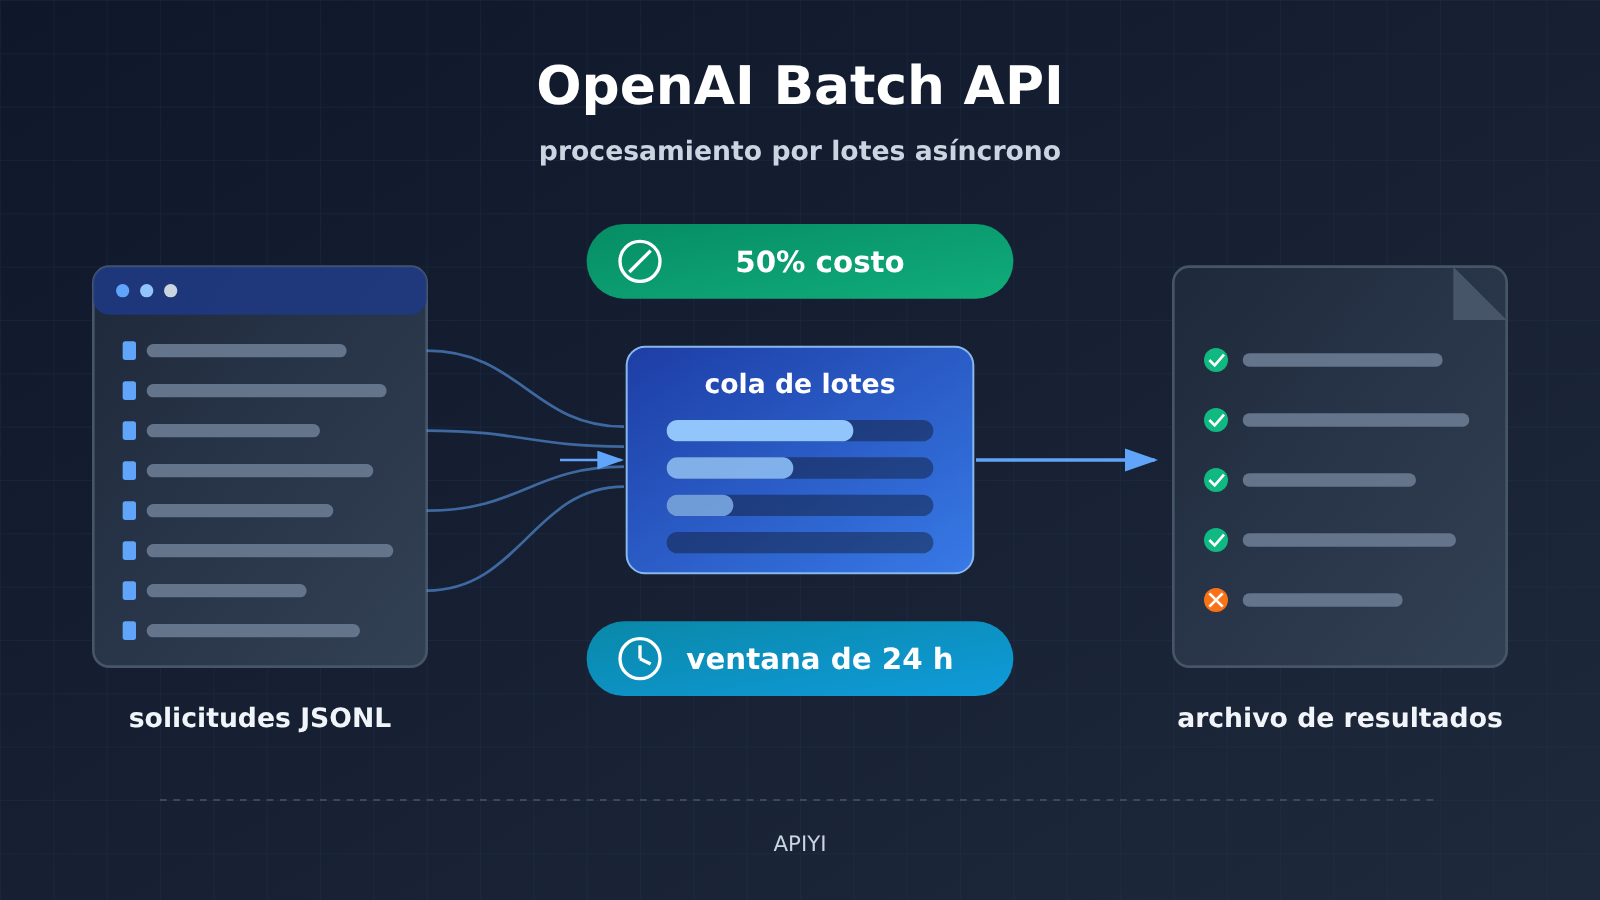
- Las reglas clave de la API Batch de OpenAI: descuento, límites de velocidad, ventana, formato de archivo y límites de cantidad.
- La diferencia entre que el envío se complete correctamente, que la generación se complete correctamente y que la entrega llegue a tiempo.
- Cómo se factura un lote caducado y cómo volver a ejecutar solo las solicitudes fallidas.
- Qué parte del coste se ahorra exactamente con el descuento del 50 % y qué costes no se reducen a la mitad.
- Un método práctico para decidir si una tarea encaja con Batch.
Índice: antes del cuerpo del artículo, una tabla conceptual y un resumen de impactos le ayudarán a construir una base de conocimiento. La sección «Hechos objetivos» ordena una por una las reglas de la documentación oficial; la sección «Análisis y juicio» analiza qué significan esas reglas para la selección de tareas, el cálculo de costes y el diseño de la ingeniería, e indica qué tipos de tareas son adecuados y cuáles no.
Cabe aclarar que este artículo se basa en la guía Batch que OpenAI mantiene actualizada de forma continua, verificada el 17/11/2026. Este documento no tiene una fecha de publicación inicial clara, así que no lo tratamos como una funcionalidad nueva lanzada ese día, sino como una interpretación de las reglas de una capacidad ya existente.
Lo que hay que saber: conceptos clave para entender la OpenAI Batch API
| Concepto | Explicación breve |
|---|---|
| API síncrona | La forma habitual de llamada en la que envías una solicitud y esperas a que te devuelva el resultado de inmediato |
| Batch API | Una interfaz en la que envías muchas solicitudes de una vez, se procesan de forma asíncrona y recoges los resultados más tarde en conjunto |
| JSONL | Un formato de texto en el que cada línea es un objeto JSON independiente; en Batch, cada línea corresponde a una solicitud |
| custom_id | Un identificador único que tú asignas a cada solicitud, para poder asociar los resultados con la solicitud original |
| Grupo de límites de velocidad independiente | El límite de velocidad de las solicitudes Batch se calcula por separado del de las solicitudes síncronas, de modo que no se ocupan mutuamente |
| Ventana de procesamiento de 24 horas | El plazo máximo de procesamiento de un lote; una vez superado, las solicitudes que no se hayan completado se cancelan |
| Lote caducado | Un lote que, pasada la ventana de procesamiento, todavía no se ha completado por entero |
Panorama rápido del impacto de la OpenAI Batch API
- Desarrolladores: Para tareas por lotes fuera de línea, se puede calcular el coste de API como la mitad del precio síncrono, y además no se consume la cuota de límite de velocidad de los servicios en línea. Sin embargo, hay que implementar por cuenta propia la asociación por custom_id, el reenvío de fallidos y la validación de resultados.
- Equipos de contenido y datos: Tareas de clasificación, resumen y limpieza de bases de conocimiento a gran escala salen más rentables. El precio es renunciar al «resultado al instante», así que hay que dejar margen en los plazos de entrega.
- Evaluación e investigación: Ejecutar conjuntos de pruebas a gran escala es ideal para Batch. Eso sí, hay que tener en cuenta que cada archivo solo puede usar un modelo; si quieres comparar varios modelos, tendrás que dividirlo en varios archivos.
- Responsables de producto y operaciones: No se debe interpretar «24 horas» como «entrega garantizada mañana por la mañana». A la hora de prometer plazos al exterior, conviene tratar Batch como un canal de mejor esfuerzo.
Hechos objetivos sobre la API Batch de OpenAI
Reglas de facturación y límites de velocidad de la API Batch
Según la guía oficial de Batch (documentación oficial de OpenAI: developers.openai.com/api/docs/guides/batch), la API Batch tiene tres características clave:
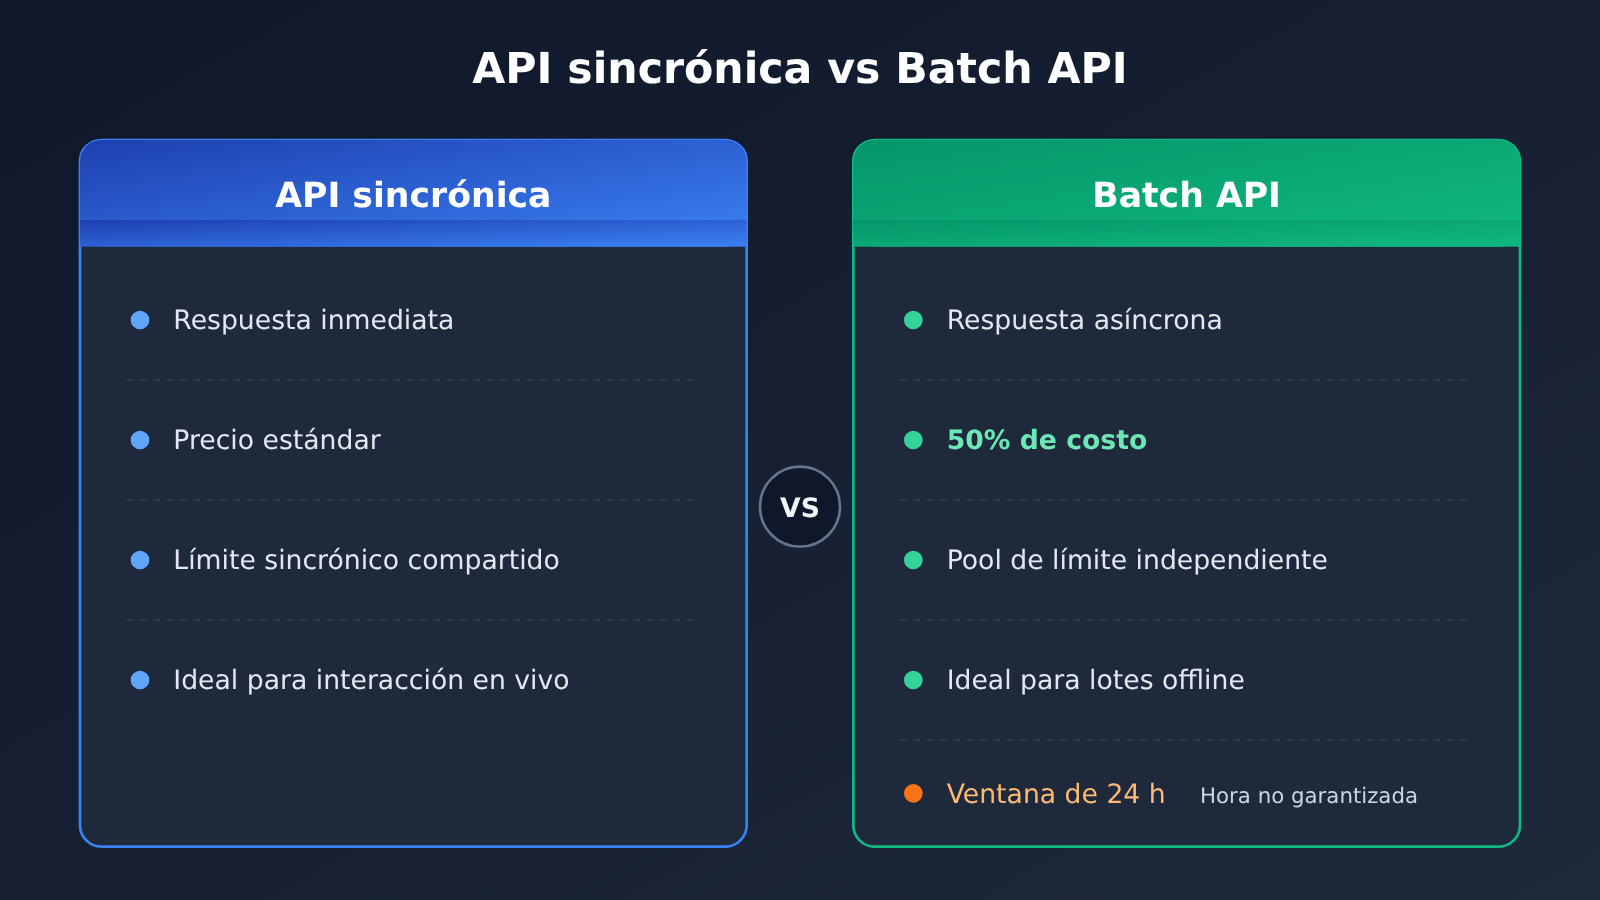
- Descuento de coste: ofrece un 50% de descuento en comparación con la API sincrónica.
- Límite de velocidad independiente: usa un grupo de límites propio, que no comparte cuota con las solicitudes sincrónicas.
- Ventana de procesamiento: el lote se procesa dentro de una ventana de 24 horas.
Qué modelos y endpoints están disponibles depende de lo que indique la documentación oficial. Por ahora no se puede afirmar sin más que «todos los modelos admiten Batch».
Formatos de archivo y límites de cantidad de la API Batch
| Aspecto de la regla | Requisito oficial | Significado práctico |
|---|---|---|
| Formato de archivo | JSONL, una solicitud por línea | Cada línea es una tarea independiente |
| Identificador de solicitud | Cada solicitud tiene un custom_id único | Es la clave para emparejar los resultados |
| Restricción de modelo | Un solo modelo por archivo | Las tareas con varios modelos deben dividirse en varios archivos |
| Límite de cantidad | Máximo 50.000 solicitudes por lote | Si se supera, hay que enviar por partes |
| Límite de tamaño | Archivo de hasta 200MB por lote | Las tareas de contexto largo pueden chocar antes con este límite |
| Orden de salida | No se garantiza que coincida con el orden de entrada | No se pueden emparejar resultados por número de línea |
A continuación se muestra una estructura de ejemplo de una línea de solicitud, para indicar dónde va el custom_id. Los endpoints y parámetros concretos dependen de la lista de compatibilidad de la documentación oficial:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Reglas de caducidad y facturación de la API Batch
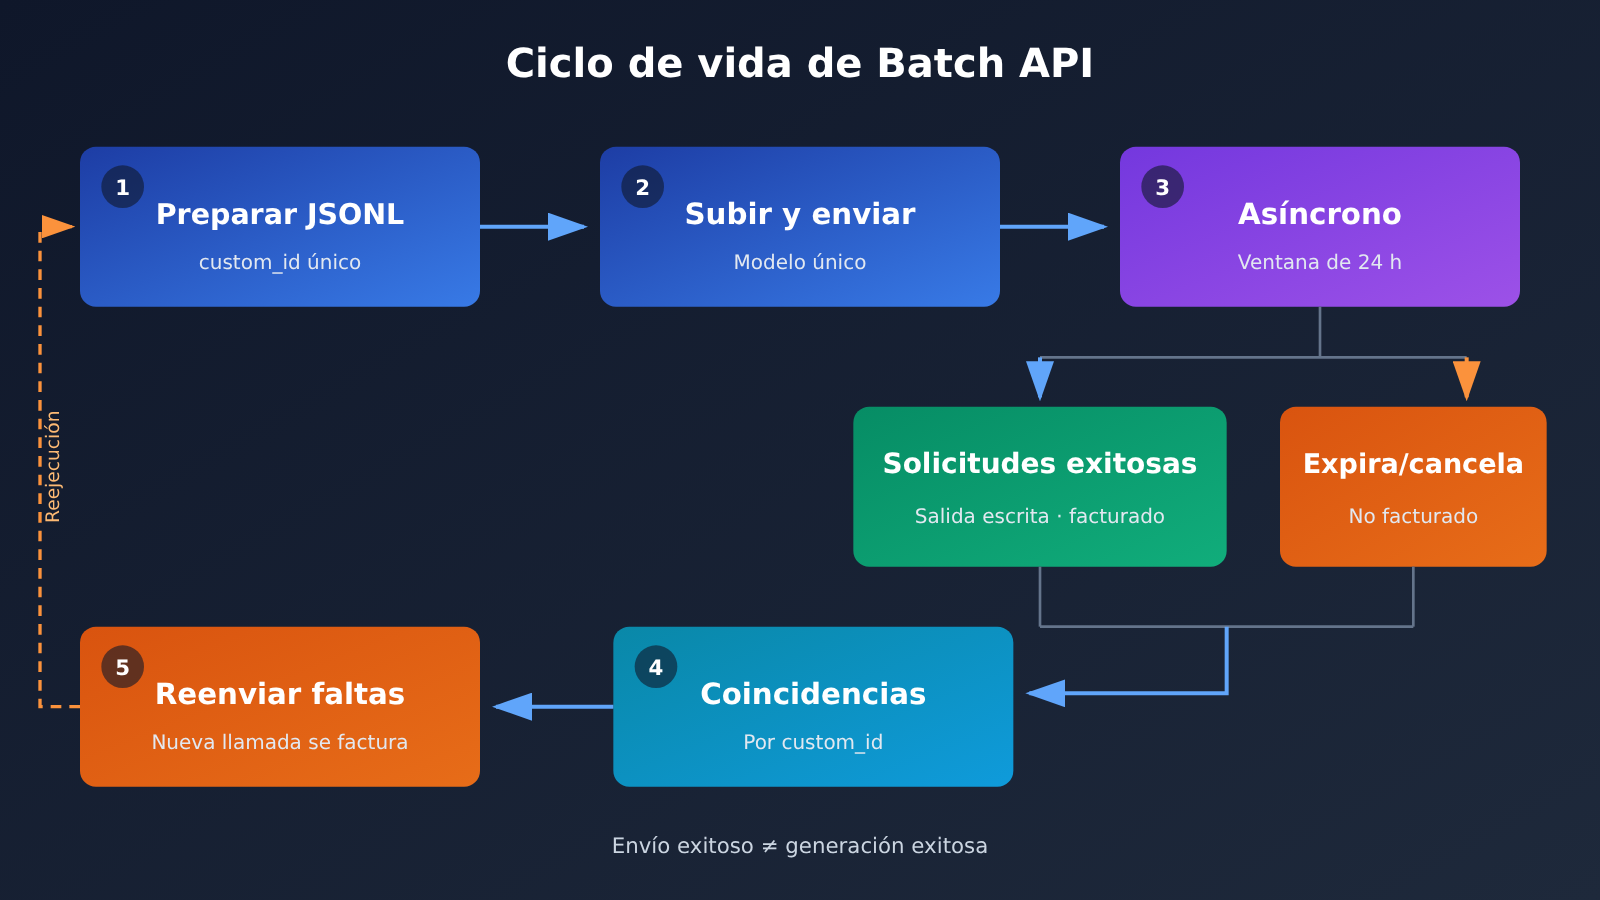
Si el lote supera la ventana de procesamiento, las solicitudes que aún no se han completado se cancelan. Los resultados ya completados se pueden seguir descargando, y la facturación solo se aplica a las solicitudes exitosas.
La documentación también advierte algo: enviar con éxito no es lo mismo que generar con éxito. Que se acepte el lote solo significa que ha entrado en el procesamiento; no garantiza que cada línea vaya a producir un resultado. La ventana de 24 horas tampoco es la promesa de «mañana por la mañana a tal hora estarán listos».
Análisis y valoración de la Batch API de OpenAI
El descuento del 50%: ¿en qué parte se ahorra realmente?
El «50% de descuento» se aplica al coste de invocación del modelo del propio procesamiento Batch. A continuación lo explico con un ejemplo ilustrativo; las cifras no son datos medidos.
Supongamos que una tarea, facturada como solicitudes síncronas, cuesta 100 yuanes; entonces el mismo conjunto de solicitudes por Batch tendría un coste ilustrativo de 50 yuanes. Pero el coste total del proyecto no necesariamente se reduce a la mitad, porque hay varios tipos de costes que no se descuentan automáticamente:
| Concepto de coste | ¿Aplica el 50% de Batch? | Explicación |
|---|---|---|
| Coste de invocación del modelo en las solicitudes por lotes | Sí | Ilustrativo: 100 yuanes en síncrono equivalen a 50 yuanes en Batch |
| Llamadas a herramientas para la investigación previa | No | Por ejemplo, buscar y investigar antes de decidir qué escribir |
| Revisión humana | No | El coste de personal no depende del modelo de facturación |
| Reintentos adicionales | No, hay que calcularlos aparte | Volver a ejecutar tras un fallo o una expiración genera nuevas invocaciones |
| Desarrollo y mantenimiento de ingeniería | No | La generación de archivos, el emparejamiento de resultados y la lógica de reenvío requieren trabajo |
Por eso, al elaborar el presupuesto, conviene aplicar el 50% solo a «la parte de las invocaciones que se puede procesar por lotes», y no recortar directamente a la mitad el presupuesto total del proyecto. Si en un proyecto la investigación y la revisión ocupan una proporción muy alta, el ahorro global que aporta Batch será claramente inferior al 50%.
Cómo entender la ventana de 24 horas
La ventana de 24 horas describe un plazo de procesamiento, no una promesa de entrega. Lo más prudente es tratar los resultados de Batch como una salida “muy probable dentro de la ventana, pero que puede estar parcialmente incompleta”, y reservar tiempo en la planificación para volver a ejecutar lo que falte.
Si el equipo de negocio exige “tener todos los resultados antes de las 9 de la mañana de mañana”, depender de un único envío Batch es riesgoso. Para tareas con requisitos de tiempo rígidos, se puede enviar con anticipación, reservar una ventana para re-ejecuciones o derivar la parte crítica a solicitudes síncronas.
custom_id es el núcleo del diseño de ingeniería de Batch
Como la salida no garantiza el orden, la recuperación de resultados debe depender por completo de custom_id. Esto exige que custom_id tenga significado de negocio desde la fase de diseño y sea globalmente único, por ejemplo, “tipo de tarea-número de lote-secuencia”.
El siguiente ejemplo de diseño tampoco es una prueba real: para generar 20 artículos independientes entre sí con el mismo modelo, se pueden escribir 20 líneas de JSONL. Si al final 18 tienen éxito y 2 se cancelan por expiración, basta usar custom_id para identificar los 2 faltantes y volver a enviarlos, sin tener que reejecutar los 20. Los 18 artículos exitosos se facturan como solicitudes exitosas; los 2 cancelados no se facturan.
Los puntos clave de este flujo se pueden resumir así:
- Antes de enviar, validar que cada línea tenga un custom_id único.
- Después de recuperar los resultados, tomar el conjunto de custom_id de entrada y restarle el conjunto de custom_id de salida para obtener la lista de faltantes.
- Generar un nuevo JSONL solo para la lista de faltantes y volver a enviarlo.
- Las re-ejecuciones generan nuevos costos de invocación, que deben incluirse en el presupuesto.
El manejo de múltiples modelos y de flujos con dependencias debe separarse
Un único archivo solo puede usar un modelo. Si en un mismo proyecto quieres que el modelo A haga clasificación y el modelo B haga resúmenes, tendrás que preparar dos archivos por separado, enviarlos y recuperar los resultados de cada uno de forma independiente.
Merece especial atención el tema de las dependencias. Si el flujo consiste en «primero investigar material y luego, a partir de las conclusiones de la investigación, decidir qué escribir», el segundo paso depende de la salida del primero. En ese caso, Batch no orquestará ambos pasos por ti de forma automática. Tendrás que esperar a recuperar los resultados del primer lote y, después, generar las solicitudes del segundo lote desde tu propio programa y enviarlas. Esto también significa que el tiempo total de toda la cadena puede acumular varias ventanas de procesamiento.
Qué tareas encajan bien con OpenAI Batch API
| Tipo de tarea | ¿Adecuada para Batch? | Motivo |
|---|---|---|
| Clasificación por lotes según reglas establecidas | Sí | Reglas fijas, elementos independientes y no se necesita una respuesta en tiempo real |
| Procesamiento de bases de conocimiento (resumen, limpieza, estructuración) | Sí | Gran volumen de datos y puede hacerse offline |
| Evaluación de modelos e inferencia por lotes sobre conjuntos de prueba | Sí | Es naturalmente por lotes y no es sensible a los plazos |
| Generación masiva de contenido independiente con el mismo modelo | Sí | Cada línea es independiente; si algo falla, se puede reintentar usando custom_id |
| Atención al cliente en tiempo real e interacción conversacional | No | El usuario necesita una respuesta inmediata; conviene usar llamadas síncronas u otras opciones |
| Tareas con plazos de entrega estrictos | Precaución | La ventana de 24 horas no garantiza un momento específico |
| Flujos de varios pasos en los que primero se investiga y luego se decide el contenido | Requiere orquestación propia | Batch no gestiona automáticamente las dependencias entre pasos |
Una forma sencilla de decidirlo es plantear tres preguntas seguidas: ¿puedo obtener los resultados un poco más tarde? ¿Cada solicitud es independiente de las demás? ¿El volumen es lo bastante grande como para justificar escribir archivos y lógica de recuperación? Si las tres respuestas son «sí», normalmente Batch será la opción más rentable. Si al menos una respuesta es «no», primero hay que dividir la tarea o mantener una llamada síncrona.
Cambios que vale la pena seguir de cerca
Como se trata de una documentación oficial que se mantiene actualizada de forma continua, tanto los modelos y endpoints compatibles como los límites de cantidad y tamaño pueden cambiar. Lo que sigue son conjeturas: a medida que se incorporen más modelos y endpoints a Batch, los flujos de trabajo de evaluación offline y de procesamiento de datos adoptarán cada vez más el procesamiento por lotes como opción predeterminada. A la hora de integrar de verdad, conviene guiarse por las reglas que figuren en la documentación en ese momento y no reutilizar directamente los valores de la fecha de verificación de este artículo.
El valor de la Batch API está en obligarte a pensar con claridad qué cosas pueden esperar. Las tareas que pueden esperar se llevan la mitad del precio y una cuota de límite de velocidad sin interrupciones; las tareas que necesitan una respuesta inmediata siguen en manos de las solicitudes síncronas.
«No busques la rapidez ni te fijes en pequeñas ganancias. Quien busca la rapidez no llega; quien se fija en pequeñas ganancias no logra grandes cosas». — Analectas · Zi Lu


