
Respuesta directa: en condiciones ideales, la caché de indicaciones predeterminada de 30 minutos de OpenAI ya resulta más barata que no usar caché a partir del segundo uso, mientras que la caché de 12 horas empieza a ser rentable a partir del tercer uso. Las condiciones ideales aquí son: un mismo prefijo fijo se escribe completo una vez en la caché, todas las solicitudes posteriores aciertan en caché y durante ese periodo no hay escrituras repetidas. Según los precios oficiales de gpt-6-luna para el nivel estándar de contexto corto, cuando un prefijo fijo de 10000 tokens se usa un total de 10 veces, la caché de 30 minutos ahorra aproximadamente 78.5 % frente a no usar caché, y la caché de 12 horas ahorra aproximadamente 66 %. Pero esto solo contabiliza la parte del prefijo fijo; no significa que toda la solicitud tenga descuento.
¿Qué puede aprender al leer este artículo?
- Las condiciones reales para que se produzca un acierto de caché de indicaciones y en qué se diferencia de la «similitud semántica».
- Cómo se calculan las dos tarifas de escritura, de 30 minutos y 12 horas, y por qué no se puede sumar además la tarifa estándar de entrada.
- Una serie de ejemplos verificables con 1, 2, 3 y 10 usos, y una fórmula del punto de equilibrio válida para cualquier longitud de prefijo.
- Qué implican estas reglas para los desarrolladores a la hora de diseñar la estructura de las indicaciones y organizar tareas por lotes.
Índice: Primero, una tabla de conceptos y un resumen de impactos para alinear términos y personas afectadas; la sección «Hechos objetivos» reúne las reglas de caché, los precios y los datos de ejemplo de la documentación oficial; la sección «Análisis y valoración» explica la relación matemática que hay detrás del punto de equilibrio y analiza la estructura de las indicaciones, la organización por lotes y algunos malentendidos frecuentes.
OpenAI Prompt Caching: lo que debes saber — explicación de conceptos
| Concepto | Explicación breve |
|---|---|
| Caché de prompts (Prompt Caching) | OpenAI cachea prefijos de prompts que se repiten; cuando una solicitud posterior acierta en la caché, se cobra a un precio menor de «lectura de caché». |
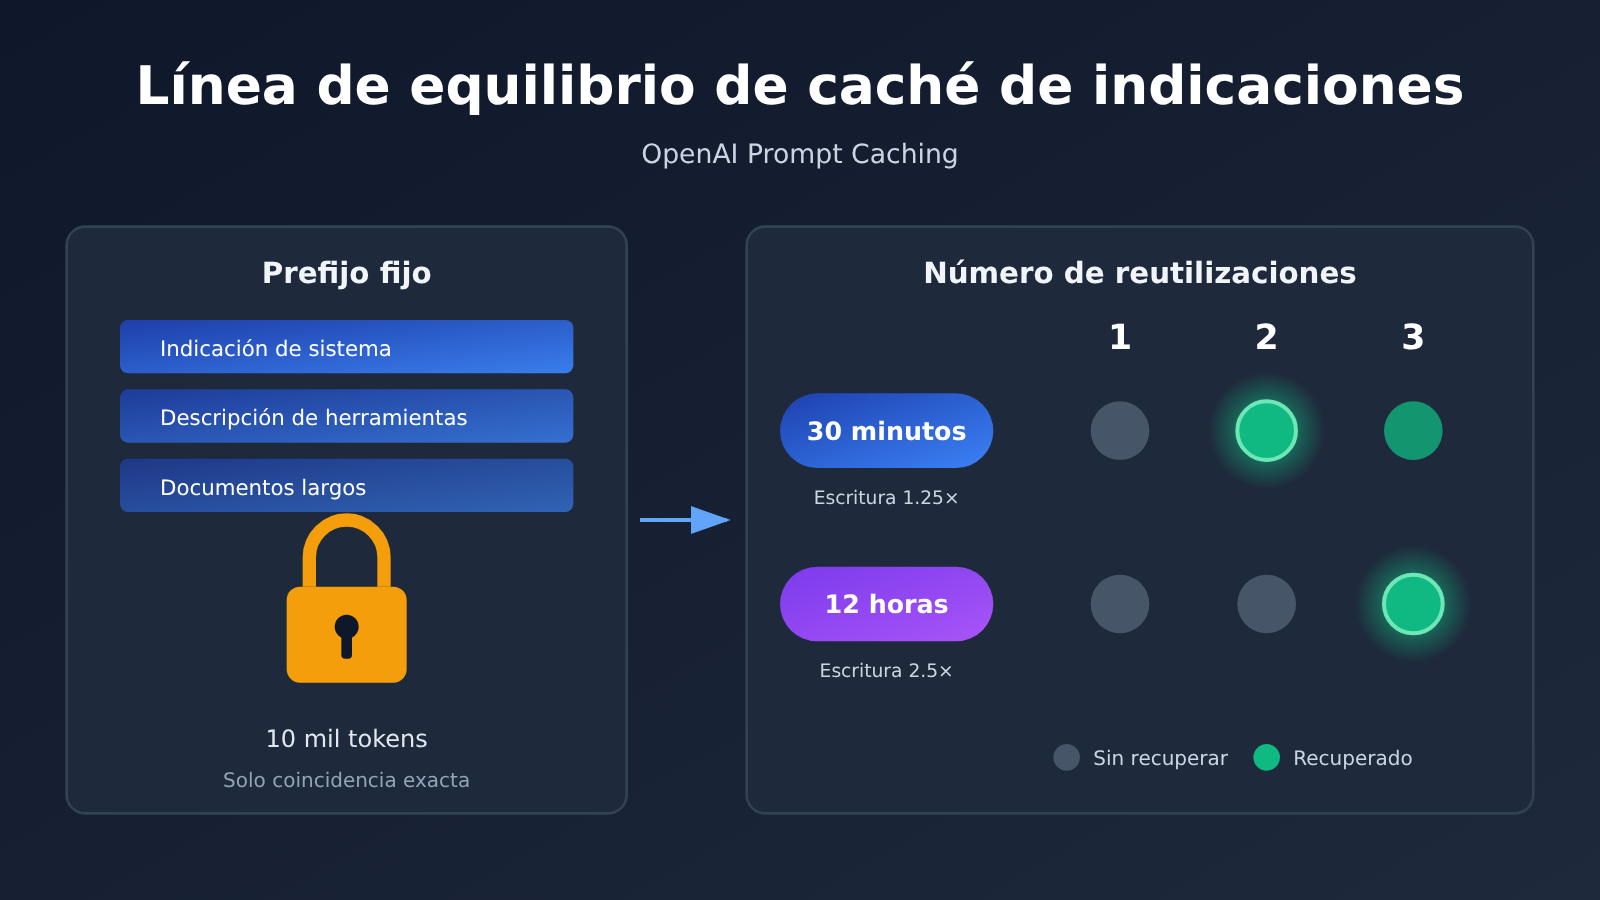
| Prefijo del prompt | El contenido continuo desde el inicio de la entrada de una solicitud. La caché coincide con el prefijo exactamente igual, no con contenido de significado similar. |
| Tokens de entrada visibles | Tokens de entrada que cuentan para el umbral de caché. Los modelos GPT-5.6 y posteriores exigen al menos 1024 para poder usar la caché. |
| Escritura en caché | Cobro la primera vez que se guarda el prefijo en la caché; se calcula como múltiplo del precio de entrada normal y es una tarifa total de escritura. |
| Lectura de caché | Cobro cuando solicitudes posteriores aciertan en la caché; el precio es mucho menor que el de la entrada normal. |
| Caché de 30 minutos / 12 horas | Dos niveles de vigencia de caché; el predeterminado es 30 minutos. El nivel de 12 horas está disponible en Responses API y la escritura cuesta más. |
| Nivel de procesamiento Standard | Nivel de procesamiento estándar en la tabla de precios oficial; los distintos niveles de procesamiento tienen precios diferentes y no se pueden mezclar. |
| Nivel Short context | La tabla de precios oficial distingue niveles según la longitud del contexto; este artículo solo usa el precio del contexto corto. |
Vista rápida del impacto del almacenamiento en caché de indicaciones de OpenAI
- Desarrolladores de API: que el caché te ahorre dinero depende del número de reutilizaciones y de la tasa de aciertos dentro del tiempo de validez, no de «lo enciendo y ya ahorro». Con el nivel de 30 minutos, basta con un uso total de 2 veces (primera escritura más un acierto) para que salga más barato que sin caché; el nivel de 12 horas tiene un coste de escritura más alto y necesita más reutilizaciones para amortizarse.
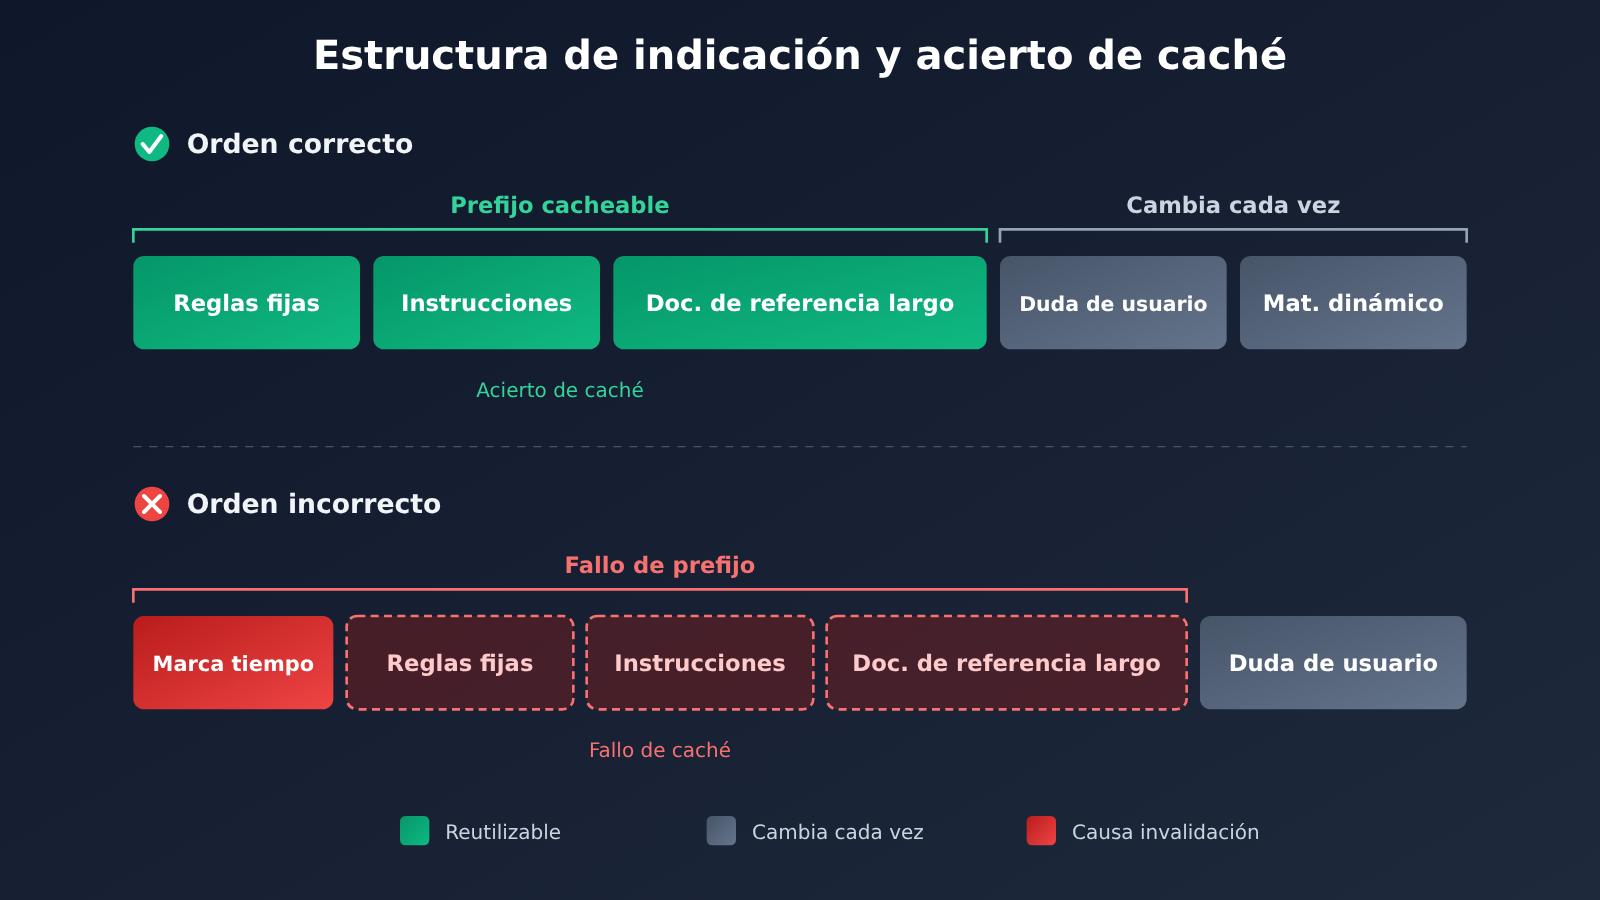
- Equipos que crean agentes o indicaciones de sistema largas: pon las reglas fijas, las descripciones de herramientas y los documentos largos al principio, y el contenido variable al final, para que el prefijo acierte de forma estable. Esto es un problema de diseño de estructura, no de parámetros.
- Equipos con tareas de procesamiento por lotes: concentra las solicitudes con el mismo prefijo y envíalas dentro del tiempo de validez del caché; así aumentarás notablemente la tasa de aciertos. Si las tareas están repartidas a lo largo de todo el día, conviene evaluar si merece la pena el nivel de 12 horas.
- Personas responsables de calcular costes: el caché solo afecta a la parte del coste de entrada correspondiente al prefijo fijo; la salida, los materiales nuevos, las invocaciones de herramientas y los reintentos no entran en esa cuenta. En la hoja de presupuesto no puedes aplicar directamente el porcentaje de ahorro del caché al total de la factura.
Hechos objetivos sobre el almacenamiento en caché de indicaciones de OpenAI
Fuentes de información y vigencia
Este artículo se basa en información verificada el 2026-11-17, procedente de la documentación oficial que OpenAI mantiene actualizada: la guía de caché de indicaciones developers.openai.com/api/docs/guides/prompt-caching y la página de precios developers.openai.com/api/docs/pricing.md. Estos documentos se actualizan en cualquier momento; no hemos verificado la fecha de primera publicación de las reglas correspondientes, por lo que este artículo no es una noticia del día, sino una recopilación y un cálculo de las reglas vigentes.
Reglas de coincidencia de la caché de indicaciones
La caché de indicaciones de OpenAI busca coincidencias con el mismo prefijo de indicación. Aunque dos indicaciones tengan un significado casi idéntico, si el contenido del inicio es distinto no habrá coincidencia; no se trata de una búsqueda por similitud semántica. Esto implica que cualquier cambio de un solo carácter en el prefijo, por ejemplo, insertar la hora actual al principio de la indicación del sistema, puede hacer que todo el contenido posterior deje de coincidir.
Para los modelos GPT-5.6 y posteriores, el umbral de la caché es de al menos 1024 tokens de entrada visibles. Las reglas de los modelos anteriores son distintas; las conclusiones sobre precios y umbrales de este artículo solo se aplican a las nuevas reglas descritas en la documentación oficial y no pueden trasladarse directamente a los modelos anteriores.
Dos tarifas de escritura de caché
| Nivel de caché | Tarifa de escritura (respecto a la entrada normal) | Descripción |
|---|---|---|
| 30 minutos (predeterminado) | 1,25× | Tiempo de validez de caché predeterminado |
| 12 horas | 2,5× | Disponible en la API Responses |
La documentación oficial deja claro que ambos multiplicadores representan la tarifa total de escritura: la primera escritura se factura a esa tarifa y no se le suma encima otra vez el costo de entrada normal. Conviene tener en cuenta también que las 12 horas se refieren al tiempo de validez de la caché, no a un plazo de eliminación de datos; son dos conceptos distintos que no deben confundirse.
Precios oficiales de gpt-6-luna
Los siguientes son los precios que figuran en la página oficial de precios de OpenAI para gpt-6-luna, en el nivel de procesamiento Standard y en el tramo de contexto corto (Short context), expresados por millón de tokens. Este conjunto de precios no puede aplicarse a contextos largos ni a otros niveles de procesamiento, y tampoco corresponde a la oferta de ninguna plataforma de terceros.
| Concepto de facturación | Precio (USD / millón de tokens) |
|---|---|
| Entrada normal | $0.10 |
| Salida | $0.50 |
| Lectura de caché | $0.01 |
| Escritura de caché de 30 minutos | $0.125 |
| Escritura de caché de 12 horas | $0.25 |
Como se puede ver, el precio de escritura de 30 minutos ($0.125) equivale exactamente a 1,25 veces la entrada normal, y el de 12 horas ($0.25) a 2,5 veces, lo que encaja con la regla de multiplicadores descrita en la documentación. La lectura de caché cuesta apenas una décima parte de la entrada normal.
Nota: antes de usar estas cifras en una estimación de costos, conviene contrastarlas con la página oficial de precios de OpenAI, ya que las tarifas y los nombres de modelo cambian con frecuencia.
Ejemplo de cálculo de reutilización
Los siguientes ejemplos son cálculos teóricos derivados de los precios oficiales, no mediciones reales. Los supuestos son: un prefijo fijo de 10000 tokens facturables, que se escribe completo en la caché durante el primer uso, y que cada uso posterior acierta en la caché, sin escrituras repetidas durante ese período.
| Total de usos | Sin caché | Caché de 30 minutos | Caché de 12 horas |
|---|---|---|---|
| 1 vez | $0.001 | $0.00125 | $0.0025 |
| 2 veces | $0.002 | $0.00135 | $0.0026 |
| 3 veces | $0.003 | $0.00145 | $0.0027 |
| 10 veces | $0.010 | $0.00215 | $0.0034 |
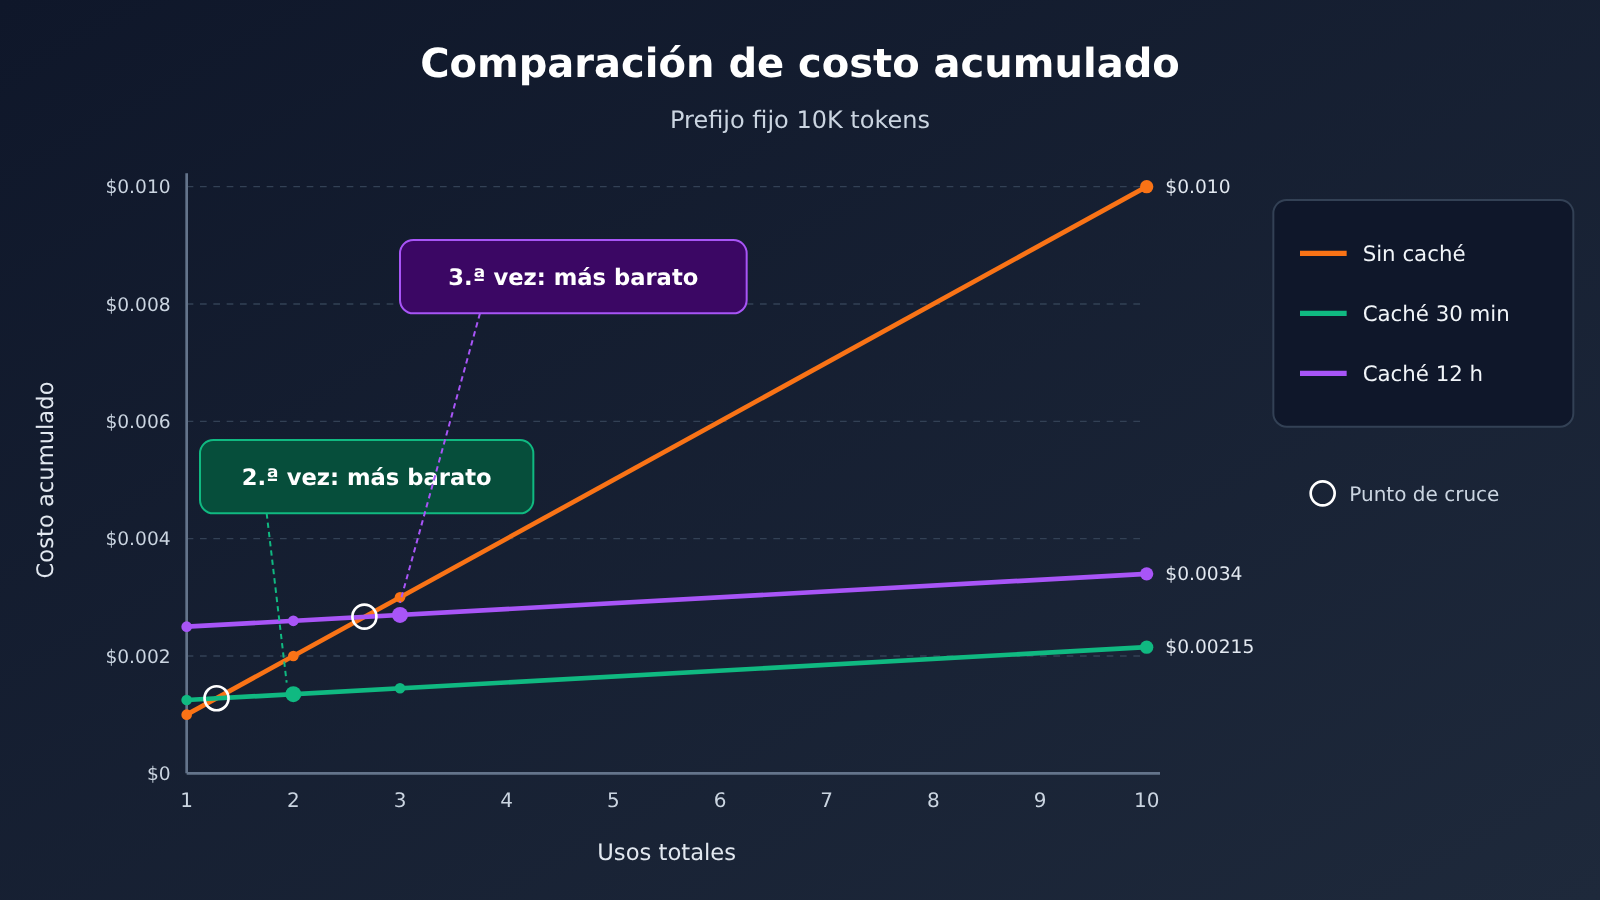
Bajo este conjunto de supuestos, la caché de 30 minutos resulta más barata que no usar caché a partir del segundo uso total, y la caché de 12 horas a partir del tercero. Si solo se usa una vez, ambas cachés son más caras que no usar caché, porque se paga la prima de escritura sin disfrutar del descuento de lectura.
Límites de aplicabilidad del ejemplo de cálculo
Estas cifras solo contabilizan la parte de prefijo fijo. Los materiales nuevos añadidos en cada solicitud, las salidas del modelo, las llamadas a herramientas y los reintentos tras fallos quedan fuera del cálculo, así que no representan el descuento de toda la solicitud. Si el intervalo entre dos usos supera el tiempo de validez de la caché, las solicitudes posteriores ya no pueden calcularse como «acierto total» y hay que volver a sumar el coste de reescritura.
Análisis y evaluación de la caché de indicaciones de OpenAI
Por qué el punto de equilibrio está en 2 y 3 usos
Si generalizamos el ejemplo a cualquier número de usos N, podemos trazar tres líneas de coste (en dólares por millón de tokens de prefijo):
- Sin caché: 0.10 × N
- Caché de 30 minutos: 0.125 + 0.01 × (N − 1)
- Caché de 12 horas: 0.25 + 0.01 × (N − 1)
Para que el coste con caché sea menor que el coste sin caché, el nivel de 30 minutos necesita N mayor que aproximadamente 1,28, es decir, sale rentable a partir del segundo uso; el nivel de 12 horas necesita N mayor que aproximadamente 2,67, o sea, a partir del tercer uso. Esta conclusión no depende de la longitud del prefijo, porque las tres líneas de coste son proporcionales al número de tokens: da igual que el prefijo pase de 2000 tokens a 50000 tokens, el número de usos necesarios para amortizar no cambia; lo único que cambia es el importe absoluto que se ahorra. Eso sí, siempre que el prefijo cumpla el umbral de 1024 tokens y el nivel de precios sea el mismo.
Visto desde su estructura, la prima de escritura es un coste único, mientras que el ahorro que aporta cada acierto es la diferencia entre el precio de entrada normal y el precio de lectura de caché, esto es, $0.09 de ahorro por millón de tokens. La prima del nivel de 30 minutos es de solo $0.025, que se cubre con un único acierto; la prima del nivel de 12 horas es de $0.15, y hacen falta dos aciertos para cubrirla. Esa es la razón por la que las dos líneas de equilibrio se llevan un uso de diferencia.
Un script reutilizable para calcular el punto de equilibrio
El siguiente script reproduce el ejemplo de cálculo con las suposiciones de este artículo; puedes sustituir los precios y el número de usos para evaluar rápidamente tu propio escenario. Para los parámetros de precio, toma como referencia los valores más recientes de la página oficial de precios.
# Según los precios oficiales de gpt-6-luna Standard / Short context (USD / millón de tokens)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Calcula solo el costo del prefijo fijo; asume una escritura completa inicial, luego todos los aciertos de caché, sin escrituras repetidas"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
El resultado de la ejecución coincide con la tabla de ejemplos anterior. Si en tu caso real algunas solicitudes no aciertan la caché, puedes contar esas solicitudes como una «reescritura»; el punto de equilibrio se desplazará en consecuencia.
La estructura de la indicación importa más que el interruptor
Como la caché solo reconoce prefijos exactamente iguales, el orden de las indicaciones determina directamente la tasa de aciertos. Lo más seguro es colocar al principio las reglas fijas del sistema, la configuración de rol, las definiciones de herramientas y los documentos de referencia, y dejar al final la pregunta del usuario, los resultados de recuperación, las marcas de tiempo y cualquier material que cambie en cada llamada. Si un campo variable se cuela al inicio del prefijo, por mucho contenido fijo que venga después, ya no se podrá reutilizar.
También hay un error frecuente que merece una mención aparte: no compensa rellenar la indicación con contenido irrelevante solo para alcanzar el umbral de 1024 tokens. Los tokens de relleno se pagan primero al precio de escritura y después, en cada llamada, al precio de lectura de caché; además, pueden interferir con la comprensión de las instrucciones reales por parte del modelo. El umbral existe para dejar claro que las indicaciones cortas no necesitan caché, no para animarnos a alargar las indicaciones cortas.
La programación por lotes determina si se puede «acertar todo»
Otro supuesto clave del ejemplo de cálculo es que todas las solicitudes posteriores aciertan en la caché. En la práctica, si las solicitudes que comparten el mismo prefijo se reparten de forma dispersa a lo largo del día, es muy probable que la ventana de 30 minutos caduque entre una solicitud y la siguiente; entonces hay que reescribir el prefijo cada vez, y eso termina saliendo más caro que no usar caché.
Para eso hay dos enfoques: agrupar las tareas del mismo tipo en lotes y enviarlas de forma continua dentro de esos 30 minutos, o bien evaluar la ventana de 12 horas, pagando una escritura inicial más cara a cambio de una vigencia más larga.
La elección se puede reducir a una regla práctica: si las solicitudes son densas y los intervalos cortos, usa la ventana predeterminada de 30 minutos; con solo 2 usos totales ya sale más barato que no cachear. Si las solicitudes son dispersas pero el mismo prefijo se reutiliza varias veces dentro de un mismo día, y el número total de usos alcanza de forma estable 3 o más, entonces la ventana de 12 horas tiene sentido. Y si es muy probable que un prefijo se use solo 1 vez dentro de su vigencia, no cachear es la opción más barata.
Los puntos que se suelen sobreestimar en el cálculo de costos
La cifra de un ahorro de aproximadamente 78.5% con 10 usos llama la atención, pero solo se refiere al costo de entrada de un prefijo fijo. En la estructura de precios de gpt-6-luna, el precio de salida es 5 veces el de la entrada normal. Si la salida de una aplicación es muy larga, o si cada solicitud trae consigo mucho material de recuperación nuevo, puede que el dinero ahorrado por la caché de prefijos no ocupe una porción alta de la factura total. A la hora de presupuestar, un enfoque más razonable es dividir la solicitud en bloques —«prefijo fijo», «entrada dinámica», «salida» y «herramientas y reintentos»— y estimarlos por separado, aplicando la fórmula de la caché solo al primero.
Además, la regla del multiplicador de escritura descrita en este artículo se aplica a los modelos GPT-5.6 y posteriores; los precios concretos del ejemplo corresponden únicamente al nivel de procesamiento Standard y al nivel Short context de gpt-6-luna. Si cambias a modelos más antiguos, a niveles de contexto largo o a otros niveles de procesamiento, tendrás que consultar los precios de nuevo y recalcular; el número de usos necesario para amortizar también puede cambiar. La documentación oficial se mantiene actualizada de forma continua y, si las reglas se ajustan más adelante, las conclusiones deberán basarse en la documentación vigente en ese momento. Esto es una variable que requiere atención constante, no un cambio que ya haya ocurrido.
Xunzi escribió en su «Quan Xue» («Anotaciones sobre el aprendizaje»): «Acumulando tierra se forma una montaña, y de ahí surgen el viento y la lluvia; acumulando agua se forma un abismo, y de ahí nace el dragón.» Las cuentas de la caché de indicaciones funcionan igual: una sola escritura es solo un gasto; el ahorro de verdad llega cuando el mismo prefijo se reutiliza de forma estable, una y otra vez, dentro de su vigencia.


