
Resumen: Este artículo utiliza un mismo conjunto de cargas de trabajo para calcular el costo de Prompt Caching en sus cuatro partes —escritura en caché, lectura de caché, entrada dinámica y salida— y explica cómo la tasa de aciertos, el TTL y el ritmo de llamadas afectan el ahorro real.
Conclusión: La carga de trabajo definida en este artículo es un prefijo fijo de 20K tokens, una entrada dinámica de 500 tokens y una salida de 1K tokens, con 100 llamadas diarias. En la condición ideal de “escritura inicial y acierto en las siguientes 99 llamadas”, la factura diaria completa de GPT-6.1 Sol baja de $5.10 a $1.348, una reducción de aproximadamente 73.57%. El resultado de Claude Sonnet 5.5 es idéntico; GPT-6 Astra pasa de $25.50 a $7.73, una reducción de aproximadamente 69.69%; y Gemini 3.8 Flash pasa de $1.9125 a $0.576, una reducción de aproximadamente 69.88%. Si se considera solo el elemento de prefijo fijo, la proporción de ahorro está entre 88% y 94%. La reducción de la factura completa es menor porque los tokens de salida y la entrada dinámica no reciben el descuento de caché. Las cifras anteriores son una simulación presupuestaria basada en los precios unitarios oficiales, no facturas reales. Los precios usan de forma uniforme la tarifa estándar de contexto corto, con fecha de verificación 2026-11-13.
Vista previa del contenido: La sección 1 explica qué parte de la solicitud reutiliza la caché y qué parte de la factura afecta. La sección 2 compara las reglas de caché de OpenAI, Claude y Gemini. La sección 3 enumera una por una las fórmulas de cálculo de los cuatro modelos, para que los lectores puedan recalcular por su cuenta. La sección 4 usa cálculos de TTL y ritmo de llamadas para explicar por qué disminuye la tasa de aciertos. La sección 5 presenta formas de organizar las indicaciones, selección de TTL, ejemplos de código y métodos para monitorear la tasa de aciertos. La sección 6 analiza los criterios para controlar el costo de tokens en escenarios de producción masiva con IA.
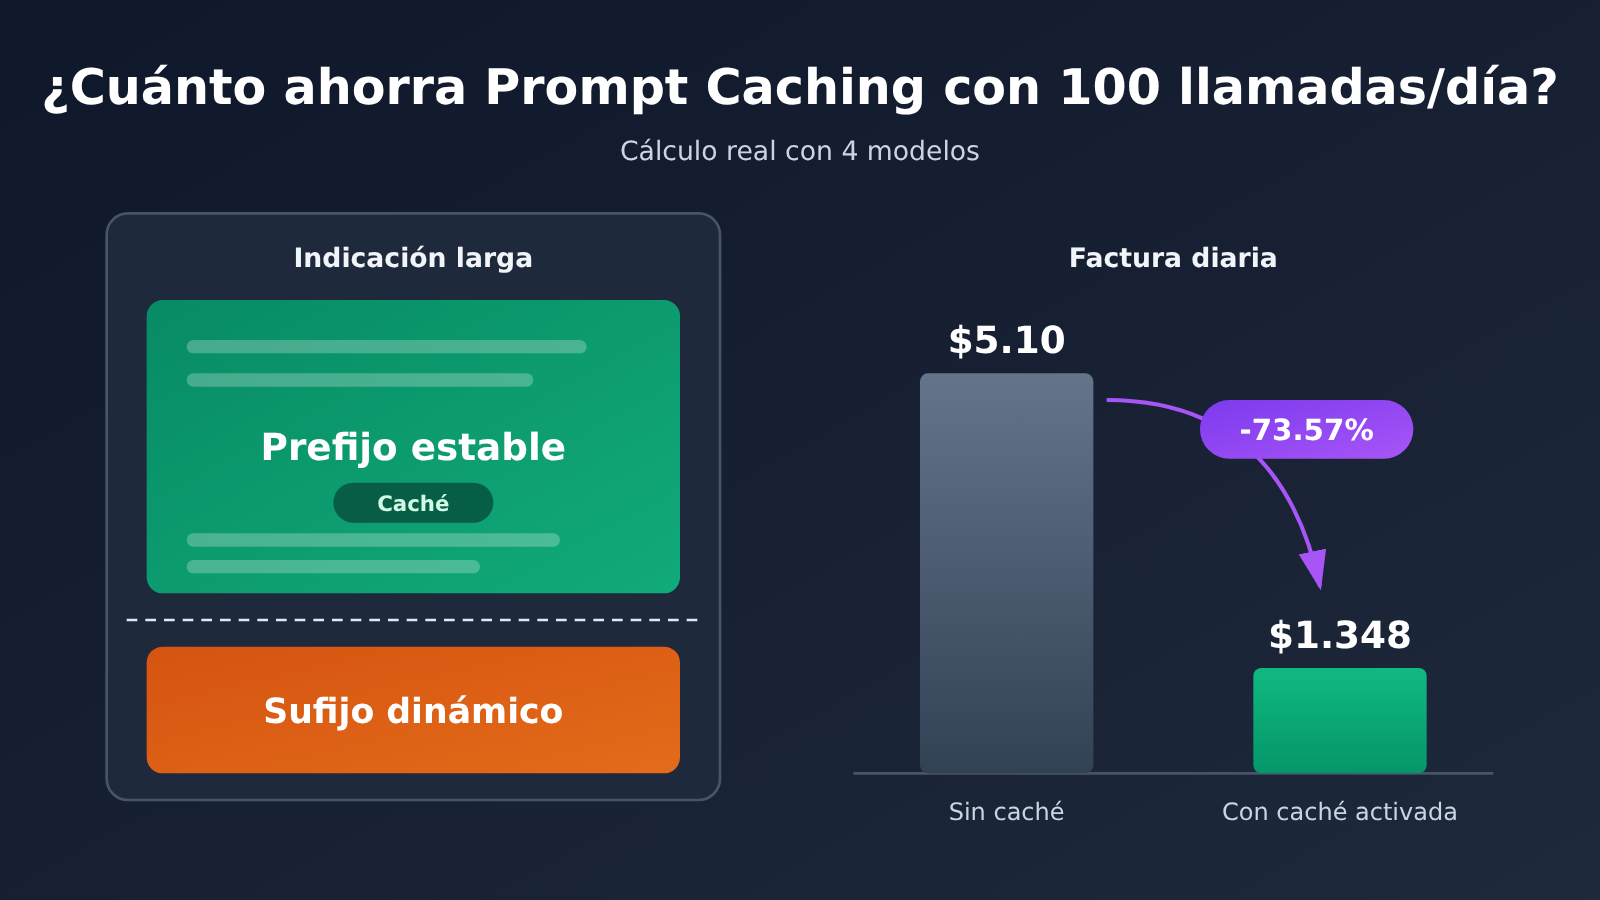
Para saber: terminología básica de Prompt Caching
| Término | Explicación |
|---|---|
| Token | Unidad con la que el modelo mide el texto; la API factura según la cantidad de tokens, y el precio unitario suele expresarse en «dólares / millón de tokens (MTok)» |
| Prompt Caching | Guarda en caché el prefijo de la indicación ya procesado; cuando una solicitud posterior encuentra el mismo prefijo, lo reutiliza directamente y reduce así el costo de reprocesarlo |
| Prefijo estable | La parte inicial de la indicación que es idéntica carácter por carácter en varias solicitudes, por ejemplo, la descripción del rol, las reglas de redacción, los textos de ejemplo o la base de conocimiento |
| Entrada dinámica | Contenido que cambia en cada solicitud, como el material de noticias del día, el título del artículo o las peticiones del usuario |
| Escritura en caché | La primera vez que se procesa el prefijo estable y se almacena en caché; el precio unitario suele ser superior al de una entrada normal |
| Lectura de caché | Las solicitudes posteriores aciertan una caché existente y se facturan a un precio unitario muy inferior al de una entrada normal |
| Acierto de caché | El prefijo de la nueva solicitud coincide token por token con una caché disponible y la reutilización se realiza con éxito |
| TTL | Tiempo de vida de la caché. OpenAI lo define como tiempo de vida mínimo y no garantiza un momento exacto de eliminación |
| Punto de corte de caché | Marca en la indicación el punto en el que «el prefijo que se puede cachear termina aquí» |
| Caché implícita / explícita | La caché implícita la determina y reutiliza el sistema automáticamente; la caché explícita la declara el desarrollador de forma activa mediante puntos de corte o la creación de objetos de caché |
| Costo total de la tarea | La suma de los costos de entrada, salida y herramientas aplicables de una llamada; es el denominador real para medir el porcentaje de ahorro |
1 Prompt Caching ahorra dinero, pero ¿dónde exactamente?
1.1 ¿Qué reutiliza Prompt Caching?
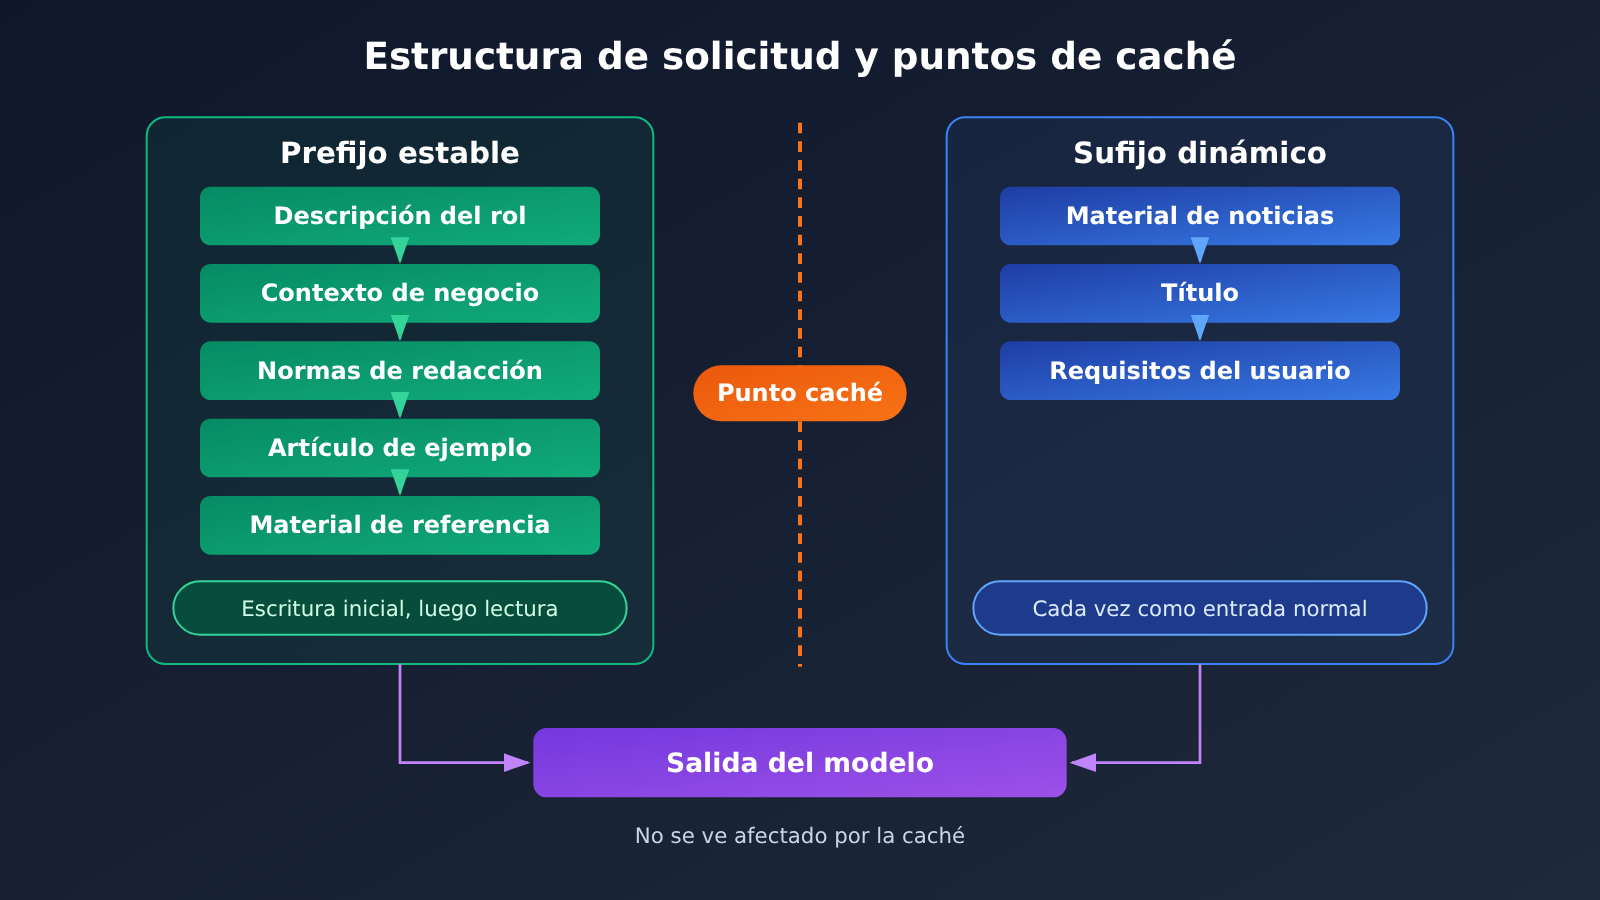
Tomemos como ejemplo una plataforma de escritura con IA. Cada vez que se genera un artículo, la solicitud se compone de dos partes. La primera es contenido fijo: descripción del rol, contexto de negocio, pautas de escritura, artículos de ejemplo, terminología y materiales de referencia. La segunda es contenido dinámico: los materiales de noticias del día, el título del artículo y los requisitos concretos del usuario.
Prompt Caching reutiliza la primera parte, es decir, el prefijo idéntico token a token. La coincidencia de caché exige que la secuencia de tokens sea exactamente la misma; que el significado se parezca no cuenta como acierto. Cambiar una palabra, alterar el orden de los párrafos o reordenar la definición de las herramientas puede convertir el prefijo en contenido nuevo, y la caché deja de servir.
Por eso hay un principio básico a la hora de optimizar la caché: el contenido estable va delante y el contenido cambiante va detrás.
1.2 ¿Qué parte del costo ahorra Prompt Caching?
La factura de una llamada se puede desglosar en cinco partidas, y solo el costo del prefijo fijo cambia gracias a la caché:
| Partida de costo | Sin caché | Con caché activada |
|---|---|---|
| Prefijo fijo | Se factura como entrada normal cada vez | Se escribe la primera vez; tras un acierto, se factura como lectura |
| Entrada dinámica | Precio de entrada normal | Precio de entrada normal, sin cambios |
| Salida del modelo | Precio de salida | Precio de salida, sin cambios |
| Costo de herramientas | Según las reglas de la herramienta | Según las reglas de la herramienta, sin cambios |
| Almacenamiento explícito de caché (Gemini) | No existe | Se factura aparte según el tiempo de almacenamiento |
Esta tabla muestra una diferencia clave: la tasa de ahorro del prefijo fijo y la tasa de ahorro de la factura completa son dos métricas distintas. La primera mide solo la reducción de la parte cacheada; la segunda mide la reducción sobre toda la factura. Cuanto más larga es la salida, más baja es la segunda.
2 ¿Qué diferencias hay entre las reglas de Prompt Caching de GPT, Claude y Gemini?
2.1 OpenAI Prompt Caching: 30 min y 12 h
La documentación de OpenAI para GPT-5.6 y modelos posteriores establece que la longitud mínima del prefijo de caché suele ser de 1,024 tokens de entrada visibles, y que se admiten dos modos: implícito (implicit) y explícito (explicit). En el modo explícito, el desarrollador marca prompt_cache_breakpoint en el bloque de contenido del mensaje correspondiente, definiendo así el límite del prefijo de caché.
El TTL predeterminado es de 30 minutos. En la Responses API, se puede usar prompt_cache_options.ttl = "12h" para optar por una vida útil mínima de 12 horas. La facturación se divide entre escritura y lectura:
- Escritura de 30 minutos: 1.25 veces la entrada normal
- Escritura de 12 horas: 2.5 veces la entrada normal
- Lectura de caché: 0.1 veces la entrada normal en la mayoría de los modelos nuevos; 0.05 veces en GPT-6.1 Sol y GPT-6.1 Terra
prompt_cache_key se puede usar para distinguir la facturación de caché entre distintos usuarios o espacios de trabajo. En GPT-5.6 y modelos posteriores, el enrutamiento de caché ya lo gestiona automáticamente OpenAI.
2.2 Caché de indicaciones de Claude: 5m y 1h
Claude admite el caché automático o explícito mediante cache_control. La vigencia predeterminada es de 5 minutos, y cada acierto de caché renueva el período de vigencia. Los 5 minutos se cuentan desde que se inicia la solicitud de escritura o lectura del caché, y el tiempo empleado en generar la respuesta también cuenta. Así que, en tareas con salidas largas, el intervalo realmente disponible es más corto que 5 minutos.
Los multiplicadores de facturación son: escritura de 5 minutos 1.25x, escritura de 1 hora 2x, lectura normal 0.1x. En Claude Sonnet 5.5 y Claude Opus 5.5, la tarifa de lectura baja a 0.05x. El precio unitario estándar de Sonnet 5.5 es: entrada $2, escritura de 5 minutos $2.50, escritura de 1 hora $4, lectura $0.10, salida $10 (todos en USD por millón de tokens).
2.3 Caché de contexto de Gemini: implícito y explícito
Los modelos Gemini 2.5 y posteriores habilitan por defecto el caché implícito, sin necesidad de configuración adicional. El requisito mínimo de entrada varía según el modelo: Gemini 3.8 Flash requiere 4,096 tokens, y Gemini 2.5 Flash y 2.5 Pro, 2,048 tokens. Google recomienda colocar el contenido compartido al principio de la indicación y reutilizar el mismo prefijo en un intervalo de tiempo relativamente corto.
El caché explícito requiere que el desarrollador cree de forma proactiva un objeto de caché y defina su tiempo de vida. El costo incluye tres partes: el contenido en caché, las lecturas posteriores y la duración del almacenamiento. La API Gemini Interactions actualmente solo admite caché implícito; cuando necesites un objeto de caché explícito, usa la API generateContent.
Los precios de Gemini 3.8 Flash, válidos hasta el 31 de diciembre de 2026, son: entrada $0.75, salida $3.75, lectura de caché $0.075, almacenamiento de caché explícito $0.50 por millón de tokens por hora. El plan oficial prevé ajustarlos a partir del 1 de enero de 2027 a $1.50, $7.50, $0.15 y $1.00. Los cuatro precios se duplican en la misma proporción, por lo que los porcentajes de ahorro calculados más adelante no cambian; los importes absolutos se duplican.
2.4 Comparación de las reglas de Prompt Caching en las tres plataformas
| Dimensión | OpenAI | Claude | Gemini |
|---|---|---|---|
| Modo de caché | Implícito / punto de interrupción explícito | cache_control automático / explícito |
Implícito (por defecto) / objeto de caché explícito |
| TTL por defecto | 30 minutos (tiempo de vida mínimo) | 5 minutos, se refresca en cada acierto | Implícito: lo gestiona el sistema; el explícito lo define el usuario |
| Opción de TTL largo | 12 horas (Responses API) | 1 hora | Personalizado en la caché explícita |
| Tarifa de escritura | 30 min: 1.25x; 12 h: 2.5x | 5 min: 1.25x; 1 h: 2x | La primera vez (implícita) se cobra como entrada normal |
| Tarifa de lectura | 0.1x (Sol / Terra: 0.05x) | 0.1x (Sonnet / Opus 5.5: 0.05x) | 3.8 Flash: $0.075 / MTok |
| Costo adicional | Sin cargo por almacenamiento | Sin cargo por almacenamiento | La caché explícita cobra almacenamiento por horas |
| Prefijo mínimo | Normalmente 1,024 Token | Según la documentación oficial | 3.8 Flash: 4,096 Token |
3 Si llamas 100 veces al día, ¿cuánto puedes ahorrar realmente con Prompt Caching?
3.1 Condiciones de cálculo unificadas
A continuación se muestra un cálculo teórico basado en los precios unitarios oficiales; no es una factura real de usuario. Los supuestos unificados son los siguientes:
- En cada llamada, el prefijo fijo es de 20,000 tokens, la entrada dinámica de 500 tokens y la salida de 1,000 tokens.
- Se realizan 100 llamadas al día, usando siempre el mismo modelo.
- Todo el contenido dinámico está ubicado después del prefijo estable.
- Escenario con caché: la primera llamada realiza la escritura y las 99 siguientes aciertan por completo; todas las llamadas se completan dentro del TTL, o la vigencia se refresca de forma continua cada vez que hay un acierto.
- No se tienen en cuenta recargos de terceros, descuentos por volumen ni costos de herramientas.
- El prefijo de 20K no activa el cobro adicional por contexto largo de GPT-6 Astra cuando se superan los 272K tokens.
La fórmula de cálculo unificada es:
Costo por partida = cantidad de tokens × cantidad de llamadas ÷ 1,000,000 × precio unitario (USD / MTok)
Costo del prefijo con caché = 20,000 × 1 ÷ 1,000,000 × precio de escritura + 20,000 × 99 ÷ 1,000,000 × precio de lectura
3.2 La fórmula completa de GPT-6 Astra
Precios unitarios de GPT-6 Astra: entrada estándar $10, salida $50, escritura de 30 minutos $12.50, lectura de caché $1.
Sin caché:
- Prefijo fijo: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- Entrada dinámica: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- Salida: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- Total diario: $25.50
Caché de 30 minutos:
- Primera escritura: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 lecturas: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- Entrada dinámica: $0.50; salida: $5
- Total diario: $7.73
El ahorro en la factura total es de $17.77, aproximadamente 69.69%. El prefijo fijo baja de $20 a $2.23, con un ahorro de aproximadamente 88.85%.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash
GPT-6.1 Sol (entrada $2, salida $10, escritura de 30 minutos $2.50, lectura $0.10):
- Sin caché: prefijo $4 + entrada dinámica $0.10 + salida $1 = $5.10
- Con caché: escritura $0.05 + lectura $0.198 + entrada dinámica $0.10 + salida $1 = $1.348
- Ahorro de $3.752, aprox. 73.57%; el prefijo baja de $4 a $0.248, un ahorro de aprox. 93.8%
Claude Sonnet 5.5 (caché de 5 minutos) tiene el mismo precio unitario que GPT-6.1 Sol, y el cálculo y el resultado también coinciden: de $5.10 a $1.348. La condición es que el intervalo entre invocaciones mantenga de forma sostenida la vigencia de 5 minutos.
Gemini 3.8 Flash (caché implícita; la primera vez se cobra como entrada normal a $0.75):
- Sin caché: prefijo $1.50 + entrada dinámica $0.0375 + salida $0.375 = $1.9125
- Con caché: prefijo inicial $0.015 + 99 lecturas $0.1485 + entrada dinámica $0.0375 + salida $0.375 = $0.576
- Ahorro de $1.3365, aprox. 69.88%; el prefijo baja de $1.50 a $0.1635, un ahorro de aprox. 89.1%
- Este resultado supone que la caché implícita acierta en su totalidad y no incluye la tarifa de almacenamiento de caché explícita
3.4 Diferencia entre la proporción de ahorro y el importe absoluto en Prompt Caching
| Modelo | Sin caché / día | Con caché / día | Ahorro diario | Ahorro a 30 días (extrapolado) | Tasa de ahorro del prefijo | Tasa de ahorro de la factura completa |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
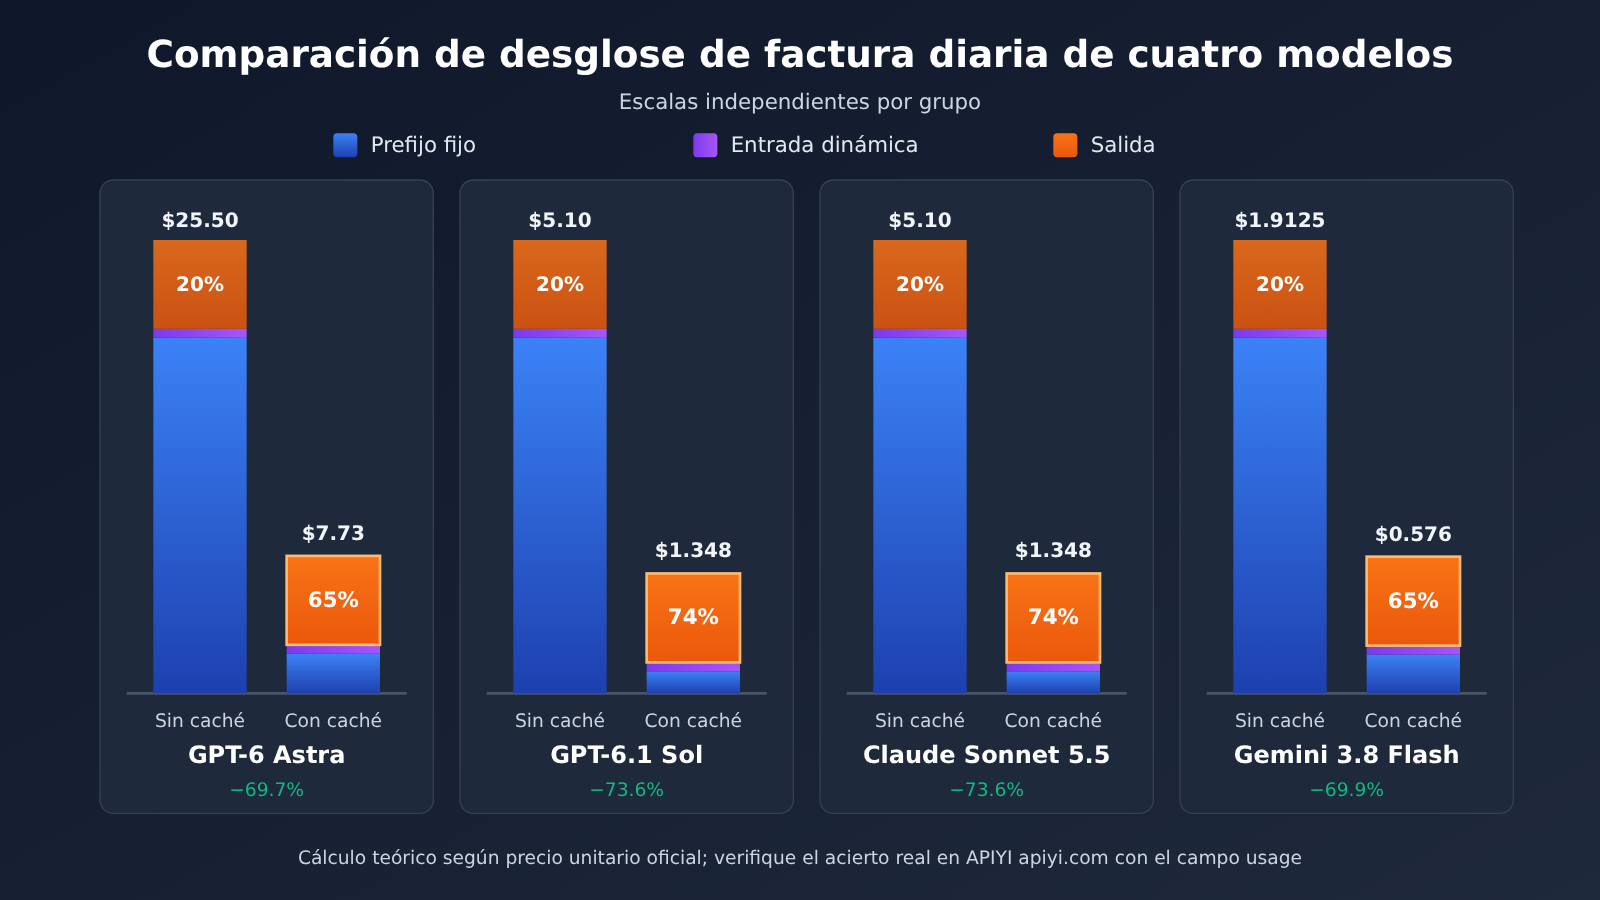
De la tabla se desprenden dos puntos:
- La proporción depende del descuento de lectura. El precio de lectura de GPT-6.1 Sol y Claude Sonnet 5.5 es 0.05 veces el de la entrada normal, y su tasa de ahorro del prefijo alcanza el 93.8%, por encima de Astra y Gemini, cuyo precio de lectura es 0.1 veces.
- El importe depende del precio unitario de base. Astra tiene la proporción de ahorro más baja, pero ahorra $17.77 al día, más de 13 veces lo que ahorra Gemini 3.8 Flash. Cuanto más alto el precio unitario del modelo, mayor el beneficio absoluto de activar la caché.
Tras activar la caché, el peso de la salida en la factura de GPT-6 Astra sube de ~20% a ~65% ($5 ÷ $7.73). En ese momento, el foco para seguir reduciendo costes pasa a ser controlar la longitud de salida. Cabe señalar que el uso del mismo número de tokens en los cuatro modelos es solo para facilitar la comparación. Al completar una misma tarea, la longitud real de salida y la tasa de acierto no son iguales entre los modelos.
💡 Consejo para elegir el modelo: cuando las proporciones son parecidas, prima el equilibrio entre el ahorro absoluto diario y la calidad de la tarea. Se recomienda llamar primero a varios modelos candidatos con la misma plantilla en APIYI apiyi.com, registrar la longitud real de salida y los tokens de caché, y luego introducirlos en la fórmula anterior para estimar el presupuesto mensual.
4 ¿Por qué repetir la misma indicación todos los días puede seguir generando una factura alta de caché de indicaciones?
4.1 El TTL y la frecuencia de llamadas determinan la tasa de aciertos
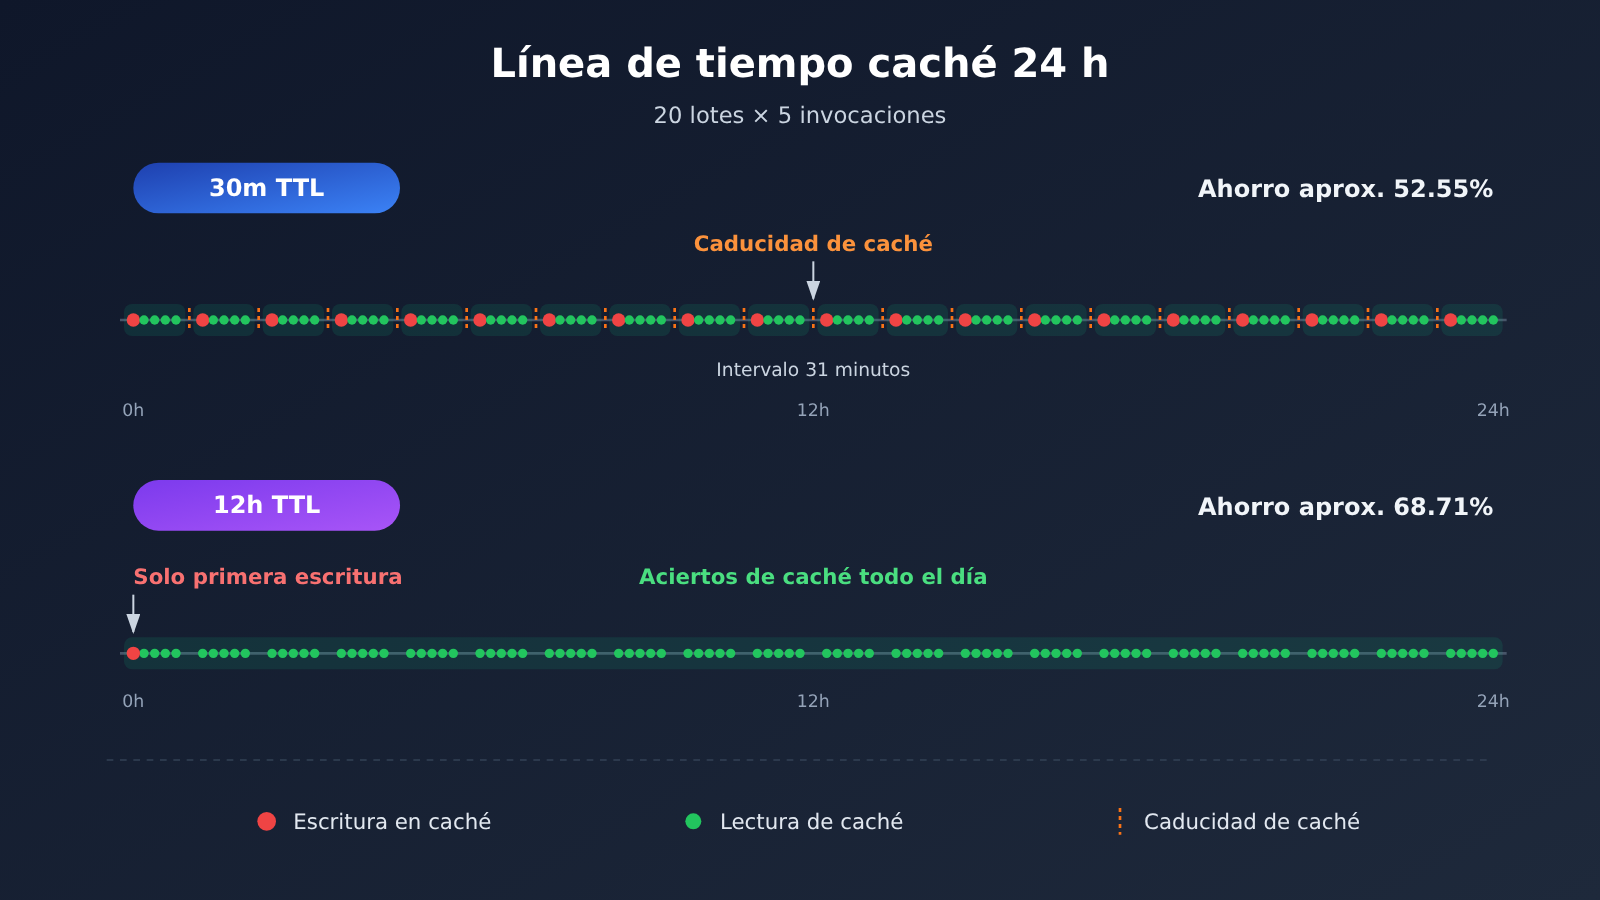
Llamar 100 veces al día no significa que una sola escritura cubra todo el día. A continuación, tomemos como ejemplo GPT-6 Astra: se divide en 20 lotes por día, cada lote con 5 llamadas consecutivas, con un intervalo de 31 minutos entre lotes.
| Escenario | Número de escrituras y costo | Número de lecturas y costo | Costo del prefijo | Añadir entrada dinámica y salida | Total diario | Tasa de ahorro |
|---|---|---|---|---|---|---|
| Sin caché | — | — | $20 | $5.50 | $25.50 | — |
| A: caché de 30 min | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | ~52.55% |
| B: caché de 12 h (dentro de la misma ventana) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | ~68.71% |
En el escenario A, el intervalo entre lotes supera los 30 minutos, por lo que cada lote debe reescribirse, y la tasa de ahorro baja del ideal 69.69% al 52.55%. El precio de una sola escritura en el escenario B es el doble del de 30 min, pero solo se escribe una vez al día, por lo que resulta más rentable para llamadas dispersas. La solución de 12 h solo cubre la misma ventana; no hay garantía de que se pueda reutilizar la misma caché al día siguiente. Para tareas que se llaman solo una o dos veces al día, no se puede lograr caché entre días solo con la misma indicación.
El punto de equilibrio para cada tipo de TTL se puede calcular considerando solo el prefijo estable, tomando la entrada normal como 1 vez:
| Solución | Multiplicador de escritura | Multiplicador de lectura | Escritura 1 + lectura 1 vs. sin caché 2 veces | Escritura 1 + lectura 2 vs. sin caché 3 veces | Lecturas efectivas necesarias para amortizar |
|---|---|---|---|---|---|
| OpenAI 30 min | 1.25 | 0.1 | 1.35 < 2 | — | 1 vez |
| OpenAI 12 h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2 veces |
| Claude Sonnet 5.5 · 5 min | 1.25 | 0.05 | 1.30 < 2 | — | 1 vez |
| Claude Sonnet 5.5 · 1 h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2 veces |
La conclusión es directa: un TTL corto se amortiza con un solo acierto; un TTL largo necesita al menos dos aciertos dentro de su período de validez.
4.2 Puntos de interrupción de caché y orden de las indicaciones
La causa más común de fallos es que se modifica el prefijo estable. Si colocas marcas de tiempo, ID de usuario, títulos de tareas o material en tiempo real al inicio de la indicación, el prefijo de cada solicitud se convierte en contenido nuevo y la caché nunca acertará.
En el modo implícito de OpenAI, si la primera solicitud incluye contenido dinámico dentro del alcance de la caché, cuando ese contenido dinámico cambie después, es posible que no se acierte el prefijo estable esperado. La solución es establecer un punto de interrupción de caché explícito al final del contenido estable.
Otras causas comunes son:
- Se cambió el modelo, el proveedor, la organización de servicio o algunos parámetros
- El agente realiza compresión de la conversación, reordena las definiciones de herramientas o modifica los mensajes del historial, lo que hace que se reescriba el prefijo reutilizable
- El gateway de terceros no reenvía los parámetros de caché o no aplica el descuento de caché en la factura
4.3 Impacto de los tokens de salida y de los costos de herramientas
La caché solo actúa sobre el prefijo de entrada. En el ejemplo de cálculo de Astra del apartado 3.2, aunque el costo del prefijo se reduzca a cero, la factura no bajará de $5.50 (entrada dinámica más salida). En tareas con salidas largas y muchas llamadas a herramientas, la reducción de la factura total será claramente menor que la tasa de ahorro del prefijo. Por eso, después de activar la caché, también hay que controlar la longitud de salida y simplificar las llamadas a herramientas.
5 ¿Cómo configurar y monitorear Prompt Caching en aplicaciones de IA?
5.1 Organizar prefijos estables y sufijos dinámicos
Ordena el contenido de «menor a mayor frecuencia de cambio»:
- Definición de herramientas: mantén un orden fijo y descripciones fijas; no las aumentes ni las elimines dinámicamente según cada petición
- Reglas del sistema y normas de escritura: descripción del rol, normas de marca, requisitos de estilo
- Ejemplos de referencia y base de conocimiento: bloques grandes de documentos de referencia, que se reemplazan por completo cuando se actualiza la versión
- (Punto de corte de caché)
- Material dinámico: noticias del día, resultados de búsqueda, entrada del usuario
- Instrucciones de la tarea actual: título, número de palabras, requisitos específicos
El siguiente ejemplo realiza la llamada mediante la interfaz compatible con OpenAI y lee los tokens de caché que devuelve la respuesta:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # Prevalece el nombre real en la lista de modelos de la plataforma
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # El prefijo estable va primero
        {"role": "user", "content": "今日材料:……\n标题:……"},  # El contenido dinámico va después
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
Ver el código completo: calculadora de costos + estadísticas de tasa de aciertos
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Calcula el costo diario (USD) con los precios unitarios oficiales; devuelve (prefijo, entrada dinámica, salida, total)."""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # Nombre: (entrada, salida, escritura, lectura) USD / millón de tokens, fecha de verificación 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # La caché implícita se cobra como entrada normal la primera vez
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# Escenario A: Astra 30m, 20 lotes requieren reescritura cada uno
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- Estadísticas de tasa de aciertos en línea ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 Consejo para empezar rápido: primero usa el calculador de arriba para estimar el presupuesto; luego ejecuta entre 10 y 20 llamadas con una plantilla real y observa si
cached_tokensaparece de forma estable a partir de la segunda llamada. Los nuevos usuarios pueden reclamar crédito de prueba gratuito en APIYI (apiyi.com) para completar esta verificación y, una vez confirmados los aciertos, aumentar el volumen.
5.2 Elegir el TTL de la caché de indicaciones y el modo de caché
- Invocaciones frecuentes y consecutivas (con intervalos estables de unos minutos): usa el TTL corto predeterminado, es decir, 30m en OpenAI y 5m en Claude. Con un solo acierto ya se amortiza, y la prima de escritura es la más baja. En Claude, hay que contar el tiempo de generación de la respuesta dentro de la ventana de 5 minutos.
- Invocaciones repartidas a lo largo del día (con intervalos entre lotes superiores a 30 minutos): evalúa OpenAI 12h o Claude 1h. Siempre que puedas acertar dos veces o más dentro de la ventana, un TTL largo resulta más barato que escribir una y otra vez; el escenario B de 4.1 es buen ejemplo.
- Tareas de Gemini con prefijos muy largos que deben reutilizarse durante periodos relativamente largos: evalúa la caché explícita y suma también el costo de almacenamiento. Con Gemini 3.8 Flash como ejemplo, almacenar 20K tokens durante 12 horas cuesta 0.02 × $0.50 × 12 = $0.12. Con la carga de trabajo de este artículo, ese costo ya resulta bastante significativo frente a una factura diaria de $0.576. Si la caché implícita está dando buenos aciertos, mantén la configuración predeterminada.
- El prefijo cambia con frecuencia: primero estabiliza el prefijo y después piensa en el TTL. Con un prefijo inestable, ningún TTL te dará aciertos.
5.3 Consultar la tasa de aciertos real y la facturación de la caché de indicaciones
Los campos usage de los tres proveedores son:
- OpenAI (Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: los campos usage de la API correspondiente, por ejemplo
total_cached_tokens; la caché explícita suma aparte el costo de almacenamiento de objetos
Conviene hacer seguimiento continuo de dos métricas:
实际缓存命中率 = 缓存读取 Token ÷ 总输入 Token
实际节省金额   = 未缓存基准成本 − 实际 API 账单成本
El costo base sin caché debe calcularse con el mismo modelo, la misma carga de trabajo y el mismo tamaño de salida; de lo contrario, el ahorro no es comparable. Al revisar la facturación en la consola de APIYI apiyi.com, puedes comparar línea por línea el resumen de usage del mismo periodo con el detalle de los cargos y confirmar que los tokens en caché se facturen al precio de caché.
6 Escenarios de APIYI: ¿Cómo controlar costos con Prompt Caching en plantillas fijas y producción masiva con IA?
Los típicos escenarios de negocio que se benefician de Prompt Caching incluyen: plataformas de escritura con IA que ejecutan plantillas de artículos fijas todos los días, Agents que cargan repetidamente la misma definición de herramientas, sistemas de análisis de información que citan múltiples veces el mismo documento de referencia de gran tamaño, y generación de contenido masivo que comparte directrices de marca y descripciones de estilo de escritura. Estas tareas tienen un punto en común: prefijo largo, alta tasa de repetición y gran volumen de invocaciones, justo en el rango donde el beneficio del caché es mayor.
Para tomar decisiones de costos en este tipo de escenarios, puedes evaluar según tres criterios:
- Si el modelo soporta la capacidad de caché requerida. Esto incluye la longitud mínima del prefijo, el TTL opcional y el multiplicador de descuento de lectura. Los modelos con lectura a 0.05x tienen una tasa de ahorro de prefijo más alta en tareas con prefijos largos.
- Si la indicación y el TTL coinciden con la carga de trabajo. El procesamiento por lotes continuo usa TTL cortos; las tareas ejecutadas de forma dispersa según un programa deben evaluar TTL largos y usar la fórmula de la sección 4.1 para calcular el número de invocaciones necesarias para recuperar la inversión.
- Si el proveedor de API soporta completamente el caché y factura según el costo real del caché. Que el upstream soporte caché es solo una condición necesaria para reducir costos. La pasarela también debe transmitir correctamente los parámetros de caché, reportar los Tokens de caché en usage y reflejar el precio del caché en el cargo.
Al llamar a través de APIYI apiyi.com, se recomienda convertir el punto 3 en un paso de aceptación fijo: llamar varias veces consecutivas con la misma plantilla de 20K, verificar los campos de caché en usage y luego contrastar con el cargo en la factura. Después de confirmar tanto el acierto técnico como la implementación de la facturación, usa el resultado del cálculo anterior como base para el presupuesto mensual.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es Prompt Caching?
Consiste en guardar en caché el prefijo idéntico que ya se procesó en una indicación; cuando una solicitud posterior acierta, se factura a un precio muy inferior al de la entrada normal. La coincidencia exige que los tokens sean idénticos uno a uno, por eso encaja en escenarios como plantillas fijas, bases de conocimiento fijas y definiciones de herramientas fijas.
Q2: ¿Por qué, aunque el prefijo ahorra más del 90%, la factura total solo baja alrededor del 70%?
El caché solo actúa sobre el prefijo fijo; la entrada dinámica y la salida se siguen facturando al precio original. Por ejemplo, con GPT-6.1 Sol, en una factura diaria de $1.348 tras aplicar caché, la salida representa $1 y la entrada dinámica $0.10. Cuanto más larga sea la salida, menor será el porcentaje de ahorro en la factura completa.
Q3: ¿Vale la pena activar el caché si solo llamas una o dos veces al día?
El beneficio es mínimo. OpenAI 12h y Claude 1h necesitan al menos dos aciertos dentro del periodo de validez para amortizarse, y no hay garantía de reutilización de un día para otro. Una práctica más eficaz es concentrar tareas del mismo tipo en la misma franja horaria y ejecutarlas en lote, para aumentar los aciertos dentro de la ventana.
Q4: ¿30m o 12h?
Depende del intervalo entre llamadas. Si el intervalo se mantiene estable por debajo de 30 minutos, usa 30m: con un solo acierto ya se amortiza. Si los lotes están más espaciados y repartidos a lo largo del día, usa 12h. Por ejemplo, con GPT-6 Astra dividido en 20 lotes de llamadas, el coste diario con 12h es $7.98 y con 30m es $12.10.
Q5: ¿El caché sigue funcionando si llamo a través de una plataforma de agregación de API?
Depende de cómo la plataforma transmite los parámetros de caché y de cómo implementa la facturación. Se recomienda usar los créditos de prueba gratuitos de APIYI apiyi.com para llamar de forma consecutiva a la misma plantilla, revisar campos como `cached_tokens` en usage y contrastarlos con el detalle de cargos. Confirma que el caché acierte y que se cobre al precio de caché antes de usarlo en lote.
Q6: ¿La tasa de aciertos del caché cae de repente: qué revisar primero?
Revisa en este orden: si el prefijo incluye contenido dinámico como marcas de tiempo o IDs; si cambió el orden de las definiciones de herramientas; si el Agent comprimió o reescribió los mensajes históricos; si se cambió de modelo o de parámetros; si el intervalo entre llamadas superó el TTL. Usar la fórmula de tasa de aciertos de la sección 5.3 para contar por horas permite localizar con rapidez el momento en que se produjo el cambio.
Q7: ¿Cómo elegir entre el caché implícito y el explícito de Gemini?
El caché implícito está activado por defecto, no tiene coste de almacenamiento y se usa de forma preferente cuando el prefijo supera la longitud mínima del modelo (4,096 tokens en 3.8 Flash). El caché explícito es adecuado para contenido muy largo que necesita reutilización determinista, pero implica pagar almacenamiento por hora y usar la API generateContent. La API Interactions por ahora solo admite caché implícito.
Resumen
Puntos clave de Prompt Caching:
- Dónde se ahorra: solo reduce el costo del prefijo fijo. Con la carga de trabajo de este artículo, la tasa de ahorro del prefijo va del 88.85% al 93.8%, y la tasa de ahorro sobre la factura completa, del 69.69% al 73.57%.
- Cuánto se ahorra: GPT-6.1 Sol y Claude Sonnet 5.5 pasan de $5.10 a $1.348 diarios; GPT-6 Astra, de $25.50 a $7.73. Cuanto más alto el precio unitario, mayor el ahorro absoluto.
- Qué frecuencia resulta más rentable: invocaciones de alta frecuencia, continuas y con prefijo largo. Con TTL corto basta un acierto para amortizar; con TTL largo hacen falta 2 aciertos.
- Cómo implementarlo: contenido estable primero y dinámico después, con un punto de ruptura al final del contenido estable; elegir el TTL según el ritmo de invocación; monitorear de forma continua la tasa de aciertos con el campo usage.
- Condición para que se cumpla: la caché debe acertar técnicamente y, además, facturarse al precio de caché.
Recomendación: primero calcula el presupuesto con la calculadora del artículo y luego valida la tasa de aciertos y la facturación con plantillas reales en APIYI apiyi.com; solo después de confirmar ambos puntos, escala.
📚 Referencias
- Guía de Prompt Caching de OpenAI: modos de caché, breakpoints, TTL y multiplicadores de facturación
- Enlace:
developers.openai.com/api/docs/guides/prompt-caching -
Descripción: parámetros
prompt_cache_optionsyprompt_cache_breakpoint -
Modelos y precios de OpenAI: precios unitarios de GPT-6 Astra y GPT-6.1 Sol
- Enlace:
developers.openai.com/api/docs/pricing - Enlace:
developers.openai.com/api/docs/models/gpt-6-astra - Enlace:
developers.openai.com/api/docs/models/gpt-6.1-sol -
Descripción: tarifas estándar de contexto corto, fecha de verificación 2026-11-13
-
Documentación de Prompt Caching de Claude:
cache_control, multiplicadores de escritura y lectura de 5m / 1h - Enlace:
platform.claude.com/docs/en/build-with-claude/prompt-caching - Enlace:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Descripción: Sonnet 5.5 con tasa de lectura de caché de 0.05×
-
Context Caching y precios de Gemini: caché implícita / explícita, costo de almacenamiento y ajuste de precios en 2027
- Enlace:
ai.google.dev/gemini-api/docs/caching - Enlace:
ai.google.dev/gemini-api/docs/pricing - Descripción: longitud mínima de caché por modelo y alcance de soporte de la API
Autor: equipo técnico de APIYI
Contacto técnico: contáctanos desde la página principal del sitio oficial de APIYI; para más material de integración, visita el centro de documentación docs.apiyi.com


